Cailyn Yong

Cailyn Yong님의 아티클

Cailyn Yong

Cailyn Yong

솔로프리니어의 인생 첫 B2B Sales 과정과 후기: 생성AI 챗봇

최근에 10X AI Club 1기 운영을 하면서 많이 바빠진 관계로 글을 못 올리고 있었습니다. 이 외에도 유투브 채널을 운영하고 있었는데 가장 놀랐던 부분은 1기 모집을 할때 정말 많은 분들께서 유투브를 통해 유입됐다는 것이었습니다. 실제로 여러 개발 문의가 유투브 채널을 통해서 들어왔고, 오늘 글에서는 다소 험난했던(?) 이 과정에 대해 생각을 정리하고자 씁니다.

커뮤니티 Growth부터 B2B 세일즈까지

가장 먼저 커뮤니티부터 설명을 시작해야할 것 같아요. 스타트업을 시작하는 계기와 전략은 정말 다양하지만, 저는 처음에 10X AI Club을 만들면서 얘로 창업을 해야겠다, 돈을 벌어봐야겠다로 시작한건 아니었습니다. 많은 분들께서 처음에 커뮤니티 운영을 한다고 했을때 "수익이 잘 안날텐데 왜하는지?," "이걸로 사업을 할건가요?"의 질문을 꽤 받았었어요. 그럼에도 불구하고 전 계속 했습니다. 제가 처음으로 너무 재미있게 느꼈던 일들이라. 전에는 하루에 12시간씩 일하라 그러면 절대로 하지 못했던 것을 이제는 자의로 하게 되더라구요.

그래서 10X AI Club에 인사이트 글과 생성AI 프로젝트 개발 방법 글들을 꾸준히 올리면서 계속 키웠고, 운영한지 이제 3개월 정도가 됐습니다. 10X AI Club를 더욱 키우기 위해 9월 25일에 올렸던 목표들입니다:

어떻게 될진 저도 잘 모르긴한데 이미 머릿속으로는 세워놓은 계획들이 몇개 있어서.. 이렇게 갈 것 같네요.

  1. 10X AI Club은 국내 최대 AI 커뮤니티가 된다. 단순히 사이즈보다는 정말로 사람들에게 도움이 되는 커뮤니티가 될 것이다.

  2. 10X AI Club의 Substack, Twitter, LinkedIn 뉴스레터와 Youtube podcast/개발 과정 동영상 업로드

  3. 10X AI University를 통해 라면 수익성을 얻고 모든 사람들이 한번이라도 AI 개발을 해보게 한다. 한번이라도 직접 자신의 업무에 AI 툴을 활용할 수 있게 한다.

2번째 목표가 조금 바뀌었는데, 여러개를 동시에 하기에 너무 힘들었어요.

그래서 유투브에 올인하기로 하고, 9월 17일에 '에라 모르겠다' 생각하고 첫 동영상을 올린 후 지금은 총 14개의 영상을 업로드했고, 구독자 2400명 달성, 그리고 가장 많은 조회수는 1.7만회를 찍었습니다.

이제 12월이 됐는데, 10X AI University를 런칭한 첫 달(10월)에 라면 수익성을 달성했습니다.

현재 운영하고 있는 10X AI Club 1기를 통해서 저는 첫 달에 달성한 라면 수익성을 10X 키웠어요.

이렇게 커뮤니티가 커지고, 수익이 발생하면서 더 다양한 BM들을 시도해보고 싶었어요. 그 중 하나는 유투브에 "챗봇 개발하는 방법"을 올리면서 설명란에 따로 자신의 서비스에 도입하고 싶으신 분들은 탈리 폼으로 신청을 받게 했습니다. 이런식의 B2B Sales는 인생 첫 경험이었고, 어떻게 하는지 전혀 모르는 상태에서 시작했어요.

영상을 업로드하고 나서 3일만에 첫 고객이 신청서를 제출했고, 그날 밤에 심장을 부여잡은 채 전화를 걸었습니다. 질문 드릴것도 옆에 메모장에 다 적고 준비했는데 생각보다 원하시는게 명확해서 쉽게 통화를 진행했고, 어떤 기능들을 구현할 수 있는지 설명 드린 후, 견적을 전달드리고 통화 마무리를 했습니다.

그 뒤로 다른분께서도 문의를 주셔서 두번째 분부터는 좀 더 쉽게 진행할 수 있었어요. 그분이 원하셨던 것은 사내에서 직원들끼리 사용해볼 수 있는 서비스 매뉴얼 챗봇이었습니다. 전화를 끊고 그날 바로 학습시킬 데이터를 받고, 챗봇을 만들기 시작했습니다.

챗봇 만드는 과정

여기서부터는.. ㅎ 험난했던 개발 과정입니다.

사실 가장 놀랐던 부분은 문의 주신 분들께서 제 영상들을 보며 프로젝트들을 만들어보신 경험이 있었고, GPTs에도 프롬프트 엔지니어링을 직접 하시면서 정말 많은 시도들을 해보셨더라구요. 그래서 프롬프트 자체도 직접 만드신걸 따로 받아서 학습을 시켰어요.

제가 개발하면서 가장 많이 배웠던 팁들을 공유드리자면

  1. 파이썬으로 만들면 보통 streamlit을 사용하는데 Streamlit에 앱 배포 절대하면 안됨. 클라우드 위에서 앱이 돌아가는 형식인데 한 유저당 사용할 수 있는 양의 한계가 있음. 이 한계치가 넘어가면 streamlit에서 앱 서버를 맘대로 다운시켜버림 😨

  2. OpenAI 통해서 답변들을 생성하는데 custom prompt를 추가하면 오히려 결과물의 퀄리티가 떨어짐. 할루시네이션을 훨씬 더 많이 함. 프롬프트 없이 데이터베이스에 데이터 업로드 하고 그걸 불러올 수 있는 Conversational Retrieval Chain, 혹은 Retrival QA chain만 사용하는게 더 잘 불러옴. 대신 원하는 답변을 계속 학습 데이터에 매뉴얼로 추가해야됨.

저는 개발자의 입장으로써 답변 퀄리티가 너무 마음에 안들어서 돌아버릴 것 같았어요. 하하. 실제로 상용화 시키기엔 할루시네이션을 잡는게 가장 어렵다는걸 몸소 체험했고, 프롬프트를 수정할때마다 답변이 달라져서 시간도 많이 걸렸습니다. Streamlit에 배포했는데 결국 다 crash해서 다시 처음부터 Next js로 짜고 Vercel로 배포를 했습니다..

챗봇 사용자들의 후기

문의 주신 분께서 정말 감사하게도 사용자들의 피드백을 따로 받아서 저한테 전달해주셨어요.

좋았던 점

  • 단순응대는 능률향상에 좋을 것으로 보임. 실제로 사업관련업무 문의가 올 시, 담당자들도 책자를 보고 안내하거나 홈페이지 규정 및 서식을 안내하는 경우가 대부분임.

  • 습득한 정보에 대해서는 질문 수준에 따라 정보를 제공하고 있음. 관련 정보 외에는 모른다고 답변됨

  • 공통적으로 궁금해하고 질문하는 민원에 대해서 쉽게 대응할 수 있어 업무 부담이 줄어들 수 있을 것 같다.

  • 시도 자체가 가장 맘에 듭니다.

  • 관련 규정을 직접 찾아보지 않고 쉽게 찾을 수 있어 업무에 도움이 됨

  • 찾아보지않고도 궁금한사항을 즉답받을수있는점

  • 질문을 간략하고 짧게 입력해도 자체적으로 질문을 변환하여 답변이 가능

  • 기초적인 민원 응대 가능으로 불필요한 시간 낭비를 줄임

  • 기본적인 질문을 사용자가 직접 입력하여 궁금증 해소 가능 (단순 자주묻는 질문을 클릭하여 사용자가 답변을 얻는 방식이 아닌 사용자가 궁금한점을 입력하고 답변을 얻을 수 있다는 점)

  • 반응이 즉각적이기 때문에 업무시간 외 빠른 질문 해소 가능

  • 답변의 속도 및 간단한 질문에 대한 답변 내용

  • 관련 문의가 많은 특정 기간에 전화상담을 대체하면서 사업담당자의 업무가중을 줄일 수 있을 것이다.

  • 빈번하게 들어오는 문의에 대한 답변이 잘 되어 있다

  • 관련부서가 아니더라도 궁금한 점이 생기면 편하게 질의가 가능한 점

  • 최근 트렌드를 반영한 새로운 도전. 그 어떤 분야보다도 시도가 중요합니다.

  • 담당자 부재시, 전화 응대가 어려울 경우에 담당자를 대신하여 1차적인 답변, 기본 개념에 대한 답변이 가능하다.

  • 간단하게 알고 싶을 정보가 있을 때 사용하면 좋을 것 같습니다.

아쉬운 점

  • 아직은 자료로 인한 답이 부족하다보니, 질문을 응대할 수 있는 정보를 불러왔으면 좋겠음.

  • 프롬프트 등 맞춤형 질문 작성법 교육이 필요.

  • 디테일한 답변이 부족함

  • 대부분 답변을 모른다고 답하거나, 답변을 하더라도 오답이 많아 학습이 더 필요할 것으로 보입니다.

  • 공개되어 있는 자료를 통해 정보를 획득할 수 있었으면 좋겠어요.

  • 일부 오타, 안내 절차 다름, 사업 담당자 안내 오류 등 일부 개선이 필요할 것 같습니다.

  • 답변이 정확하지 않는 부분 등 개선이 필요할 것 같음

  • 일부 내용이 다르며, 추상적으로 답변함에 따라 공신력이 떨어져보입니다. 다만, 이런 내용들은 지속 학습시키면 되는 사항이고, 매우 유용하게 사용될 것으로 예상됩니다. 만드느라 고생많으셨습니다.

  • 사람이 질문하는 의도를 명확히 알아차리지 못함. 너무 고생하셨습니다 !

  • 답변에 대한 검증이 필요함

  • 현재 초기단계이다보니 정보가 많지 않고, 지속적으로 사용하기 위해서는 주기적인 정보 최신화가 필요해보인다

  • 답변의 내용이 좀 더 구체적으로 제공되어야 한다. 빈번하게 문의하는 내용의 키워드만을 추출하여 답변을 낼 수 있도록 구축해 놓으면 더 활용성이 높을 것 같다.

  • 챗GPT와 같은 수준의 툴을 만드시려 한다면, 딥러닝을 통한 인공지능 학습이 선행되지 않는한 매우 어려운 작업이라 생각합니다. 적어도 크롤링 수준에서라도 관련 자료를 긁을 수 있으면 좋은텐데 해당 작업 또한 쉬운 것은 아닙니다.

  • 같은 질문에 다른 답변으로 자료의 신뢰도 부족

총 21명이 피드백을 주셨는데, 역시나 예상했던대로 할루시네이션 관련 문제가 가장 많았습니다.

하지만 반대로 업무향상에 많은 도움이 됐다는 후기를 보고 개인적으로 너무 뿌듯했어요. 실제로 OpenAI를 활용한 생성AI 챗봇이 이렇게 업무에 쓰이면서 긍정적인 반응이 보여서 정말 설레고 두근거렸습니다. (이게 스타트업하는 맛인가?)

21명 중 20명은 이 챗봇이 필요하다고 답변을 주셨습니다. 개발 측면에서 잘 안돼서 힘들었는데 제가 예상한거와 달리 많은 분들께서 필요하다고 하셔서 놀랐습니다.

마무리

이제 이 과정을 겪은 제 솔직한 장단점을 나열해볼게요.

장점:

  • 내가 만든 제품이 사용자들에게 도움이 된다는게 정말 뿌듯하다. 인생의 의미를 찾아야한다면 여기서 찾을 수 있지 않을까?

단점:

  • 솔직하게 말하자면 개발 과정이 재밌고 설레지 않았음. 그치만 어떤 것이든 그 과정은 험난할 수 밖에 없지 않을까? 실제 사용자들이 생겼을때 나오는 반응들과 거기서 느끼는 감정들이 중요하지 않을까?

  • 상용화수준까지 만들려고 하다보니 개발에 노력을 많이 들여야했음. 생각보다 많은 시간 소요. -> 추후에 이걸 시스템화 시키면 시간 소요가 덜 되지 않을까?
28
9
Cailyn Yong

Cailyn Yong

사랑을 잘 하는 법

요즘 제 주위에서 미친듯이 사랑 얘기를 많이 하는 것 같아요. (연말이라 그런가?)

월요일 밤 새벽에 갑자기 도언님한테 전화가 와서 큰일난줄 알았더니 대뜸 저에게 "혜림님 사랑이 뭐라고 생각하세요?" 물어보시는거에요.

순간 너무 어려운 질문을 받아서 뭐라고 대답했는지 기억도 안나지만 도언님도 얼핏 얘기하셨듯이 사랑에는 다양한 종류가 있는 것 같아요. 이성적인 사랑, 가족에 대한 사랑, 친구에게 느끼는 사랑, 스타트업 공동창업자에게 느끼는 사랑... 등. 이렇게 사랑을 느끼는 대상이 다르기도 하지만, 나이대별로도 사랑에 대한 의미가 또 달라지는 것 같아요. 아무것도 모르던 학창시절에 한 사랑, 더 나이를 먹고 나서 새롭게 빌딩된 가치관으로 바라보는 사랑, 책임져야할 것들이 더 많아진 나이에서 하는 사랑.

어제도 제가 존경하는 멘토님과 세시간 가량 차 안에서 많은 얘기를 다 나누다가 또 사랑에 대한 얘기가 나와서 물어봤습니다. "어떻게 하면 좋은 사랑을 하나요?" 멘토님께서는 "책임을 질 줄 아는 사람"을 만나야한다고 하시더라구요.

이 "책임"이 정확이 뭔지 생각해봤습니다. 내가 상대방과 하는 약속들에 대한 책임, 내 말에 대한 책임, 내 행동들에 대한 책임. 상대방과의 관계에 있어서 이렇게 책임을 진다는 것은 내 자신뿐만 아니라 상대방까지도 책임을 진다는 뜻입니다.

오늘 점심을 먹으면서 도언님한테 들었던 가장 놀랐던 부분은 점점 사람들이 사랑을 하지 않는다는 추세였다는 것이었습니다. 10명 중 7명은 연애를 하지않고 있고, 그 이유는 사회적으로 점점 individualism, 개인주의 문화가 극대화되기 있기 때문이죠. 그럼 사람들은 이런 개인주의 때문에 상대방까지도 책임지기 버거워서 연애를 하지 않는 것일까? 아님 기술의 발전으로 인해 삶의 질이 높아져서 더 이상 누군가에게 물질적인/감정적인 의존을 하지 않아도 돼서? 특히나 감정적인 부분은 생성AI 캐릭터들이 점점 고도화되면서 인간의 감정 교류 경험을 충분히 대체할 수 있을거라 믿습니다.

그렇다면 지금 이 시대에 연애와 사랑을 한다는 것은 오히려 더 진실된.진정한 사랑이지 않을까요? 그럼에도 불구하고 하는 것이니까.

많은 사람들이 사랑을 하고 있지 않음에도 불구하고, 사람들은 외로움을 느낍니다. 본능적으로 사람은 그렇게 태어났기 때문에. 본능적으로 내 유전자를 이어 나가야한다는 것이 engrain돼있기 때문에 어쩔 수 없는 감정인 것 같습니다. 그럼 이제 사랑은 더 이상 "Why"가 아닌 "How"인 것 같아요.

어떻게 하면 사랑을 더 잘하고, 나와 맞는 사람, 내가 책임질 수 있는 사람을 만날 수 있을까요? 이걸 AI로 해결할 수 있습니다.ㅋㅋㅋㅋㅋㅋ나를 AI 에이전트로 만들어서 상대방의 에이전트와 대화시켜서 잘맞는 compatibility 퍼센트를 측정하는 것입니다. 만약 서로와의 AI 에이전트가 잘 맞는다면 미리 검정할 수 있지 않을까요? 만들어주세요. ㅎㅎ

26
20
Cailyn Yong

Cailyn Yong

진지하게 고민하고 있는 번아웃 사이클 (나의 뽀로로 유전자)

몇주..혹은 몇일 단위로도 번아웃이 오시는 분들 계신가요?

도언님이 예전에 올리신 "뇌를 초감각 상태로 만드는 법" 글을 오늘 3-4번 읽었는데, 문득 저는 어떻게 뇌를 초감각으로 유지시키는지 궁금해졌습니다.

  • 나는 평소에 반고흐처럼 하냐, 아님 수도승처럼 하냐?

    • 일단 저는 건강한 수도승보다는 반고흐에 가까운 것 같네요..?

  • 나는 내 생산성을 어떻게 측정을 하는지?

    • 자기개발 톡방에 매일 오늘한일, 내일할일, 내 삶의 목표 적었는지 체크업해서 올림

  • 나는 왜 무조건 일한만큼 놀아야하는 시간이 중요한지?

    • 그러게요..? 일한만큼 노는것도 중요하지만, 그냥 평소에도 신나게 인생을 즐기고 다양한 곳을 탐색하는 것도 저에겐 정말 중요한 것 같아요. 매번 새로운 곳을 탐색해야하고, 새로운 나라로 여행을 가고, 새로운 언어와 음식, 문화를 배우는게 저에겐 정말정말 인생에서 없으면 안되는 것들입니다. 예전에 친구랑 진지하게 이거에 대해서 대화를 나눈적이 있는데, 그때 깨달았던 것은 저는 오히려 놀때 뇌가 더 창의적으로 활성화되면서 백엔드에서 제가 프로세싱하던 업무들이 자동으로 정리되는 것 같더라구요! 오히려 더 좋은 아이디어들이 샘솟고 노는동안 앞으로 더 나아갈 힘이 생기는 것 같습니다.

    • 그래서 저는 오랜 시간 동안 일을 못합니다. 스포츠에 비유하자면 저는 농구, 축구보다는 짧은 스프린트 단위로 burst할 수 있는 플래그 풋볼을 좋아합니다. ㅎㅎ 🏈 올해 7월에 전 스타트업을 창업하면서 '왜 나는 성공한 창업가들처럼 12-16시간씩 일을 못하지? 스타트업은 일주일에 100시간 채워야하는데 왜 난 안되지?' 라는 질문을 계속 던지면서 죄책감을 느꼈는데 그냥 신체적으로, 뇌구조상 안되는걸로 결론 지었습니다. 제 뇌는 그렇게 작동이 안되더라구요.

    • 강제로 해보니까 제 건강이 완전 망가져버렸습니다. 체력, 면역력도 그렇고 하루도 건강했던 날이 없었던 것 같아요. 신체/뇌 리듬이랑 안맞는 리듬에 제 자신을 끼워맞추려고 하다보니 역효과가 났습니다.

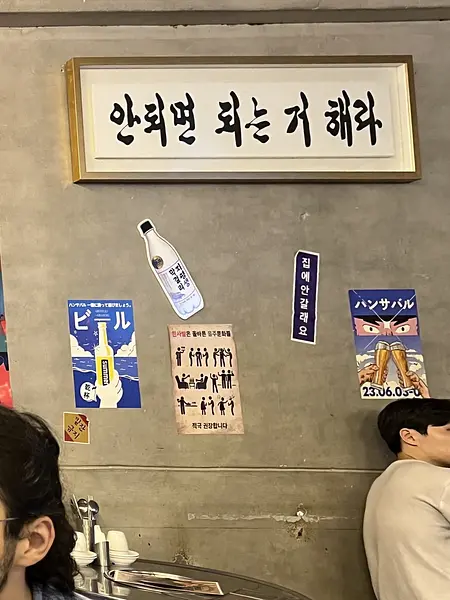
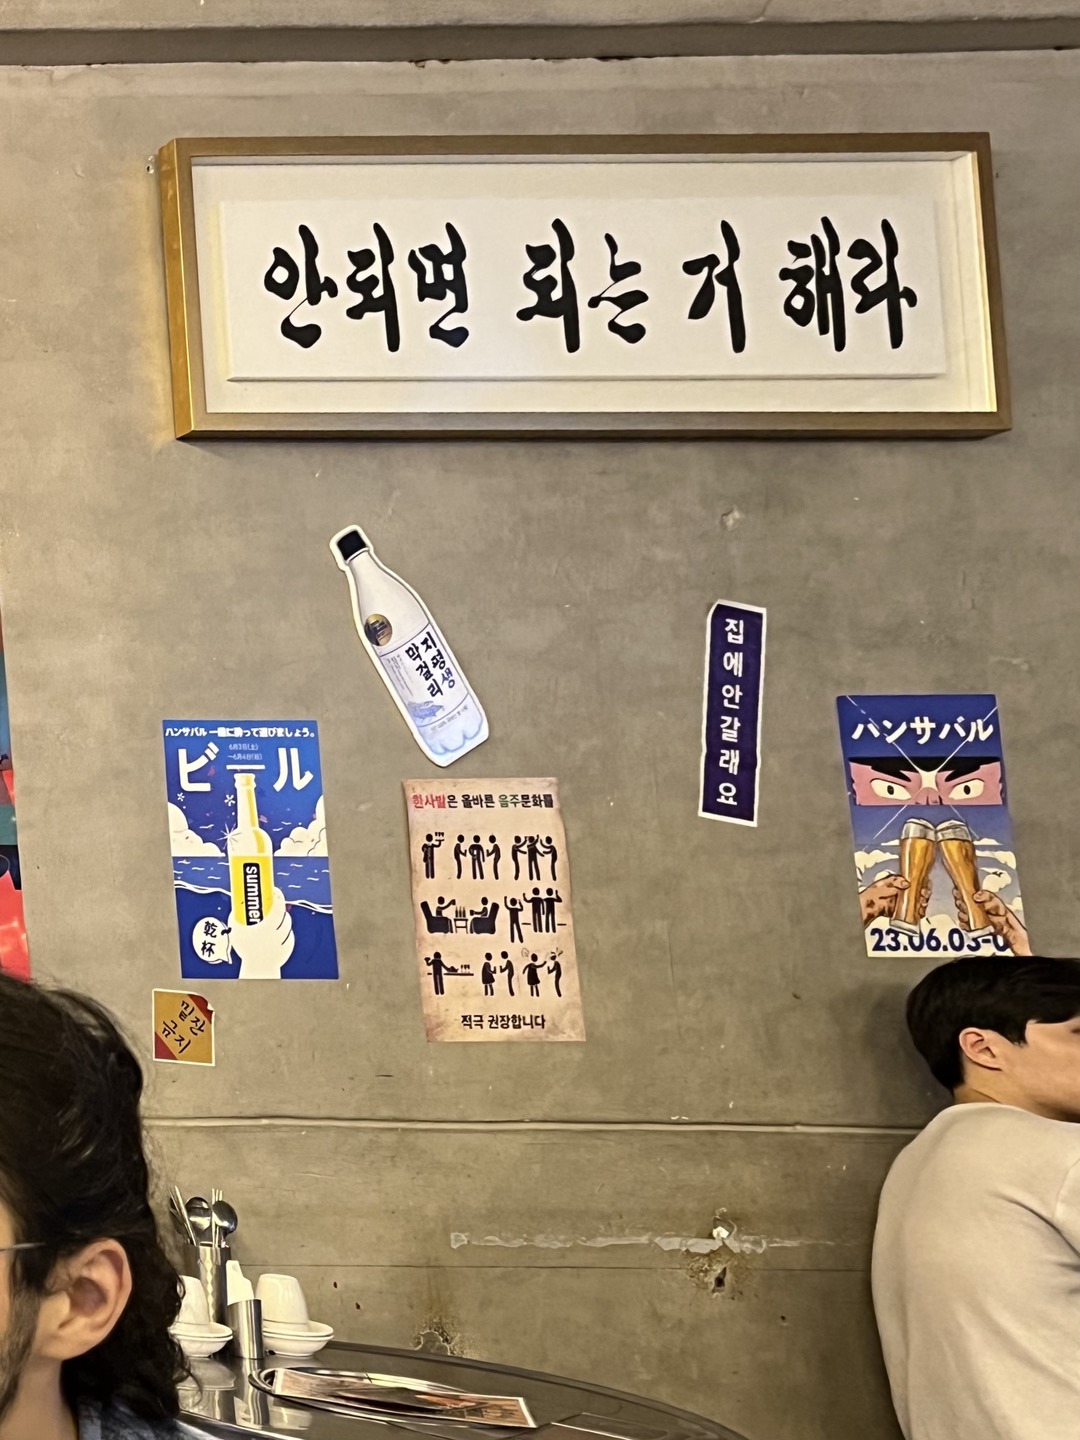
    • 전 스타트업을 겨우 나오고 나서 제 친구랑 닭도리탕 맛집을 갔는데 거기 간판에 "안되면 되는 거 해라" 라는 액자를 보고 그때부터 생각의 회로를 바꿨어요. 그냥 내 페이스대로 되는거 하면 되는걸 제 자신을 너무 푸시했더라구요. (현재 자기개발 톡방 배사)

      KakaoTalk_Photo_2023-11-20-21-00-06.jpeg

그래서 8월부터 지금까지 쭉 나만의 페이스대로, 건강하게 가고 있었는데 2주 전부터 하루도 놀지 않고 일을 매일매일 장기간동안 했더니 바로 또 건강/면역력이 반토막났습니다. 저는 평소에 스프린트 단위로 극도로 뇌집중을 하면서 일을 하다보니 그만큼 번아웃도 엄청 자주오고 크게 옵니다. 제 뇌가 딱 어떤 느낌이냐면,, 탭 100개 틀어놓고 계속 뒤에서 multiprocessing 하고 있는 느낌입니다. 그래서 멍 때릴 때에는 이 탭들을 프로세싱하는 중입니다.

그치만 자꾸만 제 뽀로로 유전자가 너 안놀면 건강 망쳐버린다 협박하고 있는 것 같아요.

헬스장도 일주일에 3-4번씩 꾸준히 가고 있는데 이건 체력문제일까요, 아님 정말로 멘탈/뇌의 문제일까요?

어떻게 해결하죠?

궁금합니다.

17
13
Cailyn Yong

Cailyn Yong

만들어볼 GPTs 아이디어 리스트업

  • 식단 짜주는 GPT (인바디 결과 업로드하고 필요한 식단/운동 루틴 추천)

  • 아이언맨/로다주랑 대화할 수 있는 캐릭터 GPT

  • 운동 루틴 추천해주는 GPT

  • 타로 GPT (오.....!재밌겠다)

이미 만든 GPTs

13
10
Cailyn Yong

Cailyn Yong

한국 NVIDIA 전 지사장 이용덕 캡틴과 나눈 대화: 앞으로 AI의 미래는?

오늘 아침에 출근하면서 갑자기 한국 NVIDIA 전 지사장 이용덕 캡틴한테서 전화가 걸려왔습니다.

이용덕 캡틴은 NVIDIA를 나오고 나서 현재 드림앤퓨처스랩이라는 스타트업 인큐베이터/멘토링 프로그램을 운영하고 계십니다. 제가 한참 인생의 방향에 대해 고민하던 21살때 처음 뵀었는데, 영화계 전공을 할까 아예 다른 도전인 컴퓨터공학과를 할까 고민할때 결국 컴퓨터공학을 선택하는데 많은 조언과 응원을 해주신 분입니다.

모든게 그 결정부터 시작된 것 같아요. 캡틴 덕분에 컴퓨터공학과라는 길을 걷고 나서는 22살때 첫 IT 스타트업 창업을 하고, 23살에는 암호학을 배워서 블록체인 스타트업에서 일할 수 있었고, 24살에는 두번째 생성AI 스타트업을 한 다음 현재는 10X AI Club 커뮤니티를 운영하고 있습니다.

그렇게 4년이 흐른 후 다시 오랜만에 연락이 갑자기 왔습니다. 어제 새벽에 유트브로 샘 알트먼의 OpenAI devday 영상을 보고 계셨는데, 다른 요점 정리 영상들을 보다가 제 영상을 보고서는 "얘 혜림이 아니야?"하고 오늘 아침에 전화를 주셨습니다.

30분가량 통화를 하면서 정말 많은 인사이트들을 얻게 됐어요. 그 중에서 몇개를 여러분과 공유드리고 싶어서 글로 작성하게 됐습니다.

정보 검색의 시대에서 답변의 시대로 변했다

계속 강조하셨던 부분입니다. 예전에는 구글, 네이버, 다음과 같이 유저가 원하는 정보를 검색하고 나서 일일이 원하는 답변을 찾아야하는 시대였다면, 샘 알트먼의 OpenAI GPT가 나오고 나서부터는 유저가 원하는 답변을 제공해주는 시대로 바뀌었다고 하더라구요.

그래서 앞으로 구글과 같은 큰 검색 엔진들은 유저가 원하는 답변들을 빠르고 정확하게 도출해내지 않으면 점점 쇠퇴할 것입니다. 아마 구글이 특히나 더 고려해야할 것은 검색에 대한 결과값들의 퀄리티가 구글 ads로 인해서 떨어지고 있는데, 구글의 광고 수익구조를 유지시키면서 이 문제를 어떻게 해결할지 궁금해졌습니다.

현재 많은 생성AI 스타트업들이 가장 많은 고민을 하고 있는 부분도 어떻게하면 답변의 퀄리티를 높일지, 어떻게 할루시네이션 (잘못된 결과물 도출)을 최소한으로 줄일수 있는지이죠.

이용덕 캡틴께서 주의깊게 바라보고 있는것은 이제 답변 이후의 다음 스텝이 무엇이냐?입니다. 그건 아마도 그 답변들이 주는 밸류, 즉 가치가 되겠죠. 제가 항상 강조했던 것은 어떤 LLM 제품이든 그 경쟁력/차별점은 그 모델을 학습시키는 데이터셋의 양과 퀄리티에 따라 가치가 매겨진다는 것이었습니다. 앞으로 어떤 GPTs, LLM 에이전트들이 우위를 가져가게 될지 궁금해집니다.

Laptop PC는 사라지게 될 것이다 + Lifi 시대

NVIDIA에서 지사장을 맡으시면서 하드웨어적인 부분은 이분만큼 잘 아시는 분은 안계실 것입니다. 그래서 처음에 데스크탑 PC가 앞으로 사라질수도 있겠다라는 말을 듣고 처음에 이해가 안됐어요. 제가 상상했던 것은 수많은 LLM 모델들을 한개의 PC/GPU로도 프로세스 할 수 있는 AI 슈퍼컴퓨터들이 나올거라 생각했는데 캡틴께서는 아예 그냥 손 안에 들어가는 슈퍼컴퓨터가 나올거라고 하시더라구요.

즉, 내 손바닥 크기만한 디바이스에서 키보드도 필요없이 그냥 말로만 AI 비서한테 "이거 해줘"하면 바로 호스트 서버와 커넥트해서 프로세싱 해준다는 것입니다.

그 외 앞으로는 Wifi가 아닌 Lifi, 즉 lightning의 속도로 wifi보다 천배빠른 네트워크 속도의 시대가 올 것이라고 하셨는데, 내년에 GPT5가 나오고 이 속도로 LLM들을 학습시킬 수 있다면 정말 기하급수적으로 기술이 발전하고 시장이 점점 더 커질 것 같습니다.

그래서 스타트업들은 무엇을 해야하는가?

현재도 캡틴께서는 많은 스타트업 자문을 하고 계시고 멘토링을 해주고 계십니다. 몇년동안 스타트업들을 보면서 가장 중요하다고 생각하시는 것이 "시장을 바라보고 작은 아이디어로 나아가야하는 방법을 찾아야 한다. 시장의 가려운 부분을 긁어주고 빨리 치고 나가는 곳이 성공한다" 라고 하셨습니다. 즉 기술에 집중하는게 아니라, 유저들과 시장에 집중하라는 것입니다.

GPTs store가 나온다는 말을 듣고 굉장히 무섭다고 하셨어요. 이게 앞으로 모든 판도를 뒤집을거라고 하셨습니다. 처음에 앱스토어가 나왔듯이 앞으로 이젠 AI store가 생길거고, 이런 빠른 시장 변화들을 계속 추적하면서 기회를 잡아가야 한다고 했습니다. OpenAI devday이후로 자신의 스타트업 방향을 어떻게 잡아야하는지 고민하는 분들이 많이 계셨을 것 같은데, 이 일을 기회라 생각하고 빠르고 치고 나가라고 하시더라구요.

이런 변화때문에 앞으로 스타트업들은 어떤 기술을 고도화시켜서 개발시키느냐가 중점이 아닌, 이 기술을 어떻게 "적용" 시킬거냐가 정말 중요해질 것이라고 하셨습니다. 기술이 아닌 아이디어의 시대가 될 것입니다.

다들 정말 화이팅입니다!!!

33
12
Cailyn Yong

Cailyn Yong

10X AI Club 1기 참여하고 생성AI 프로덕트 런칭하기 (댓글달면 프로모션 코드 드립니다!!)

Aesthetic Twitter Header.png

AI를 10X로 배우고 싶은 사람들의 모임, 10X AI Club 1기 멤버분들을 모집합니다! (~11/24)

매주 AI에 대한 트렌드를 빠르게 습득하고 자신이 만들어보고 싶었던 AI 프로젝트를 직접 만들어보세요.

프로그래밍에 대해 아무것도 모르더라도 만들어볼 수 있도록 도와드립니다.

빠르게 내용 확인하고 싶은 분들은 이 링크에서 확인해주세요👉

이런 분들을 위해 모임을 만들었어요.

  • 생성AI 기술에 대해 배우고 전문가 분들과의 네트워킹 하고 싶은 분

  • 함께 재밌는 생성AI 사이드프로젝트를 만들어보고 싶은 분

  • LLM, prompt engineering 등 노하우를 공유받고 싶은 분

👀10X AI Club에서는 무엇을 하나요?

7주간 아래 세 가지의 활동들을 같은 기수 멤버들과 함께해요

Study Session

AI를 함께 배워요.

  • AI 최신 기술 트렌드를 서로 공유하며 배우고, 직접 만들어볼 수 있도록 가르쳐드립니다.

  • 이런 기술이 사업적 측면에서 어떻게 활용될 수 있는지 인사이트를 나눠요.

Dev Session

AI 사이드프로젝트들을 함께 만들어요.

  • 개인 혹은 팀 단위로 최신 AI 기술을 활용한 프로젝트를 만들어요.

  • AI로 풀고 싶은 문제를 직접 해결해봐요.

Networking

서로 친해지고 네트워킹을 해요.

  • 온라인/오프라인 모임을 통해 다양한 대화를 해요.

  • 각자의 AI 개발 노하우와 사업적 경험을 서로 나누며 조언을 받고, 도움을 주면서 네트워크를 쌓을 수 있어요.

🚀현재 10X AI Club 1기를 모집중이에요!

총 7주간 프로그램이 진행됩니다.

2주 단위로 첫주에는 스터디세션을 하고 둘째주에는 배운 것들을 바탕으로 팀원들과 직접 프로젝트들을 만들어 볼 예정입니다.

11월 29일(수)부터 1월 10일(수)까지 매주 수요일 오후 19:00 - 21:00에 진행됩니다.

📚 커리큘럼

1주차

프리네트워킹 모임

2주차 Study Session (업무 자동화): 온라인

업무 자동화 관련 스터디 세션, 만드는 법 공유

3주차 Dev Session (업무 자동화): 오프라인

팀 단위로 업무 자동화 툴 만들어보기

4주차 Study Session (생성AI): 온라인

생성AI 관련 스터디 세션, 만드는 법 공유

5주차 Dev Session (생성AI): 오프라인

팀 단위로 생성AI 프로젝트 만들어보기

6주차 Study Session (파이널 리서치): 온라인

다 같이 해커톤 열 수 있는 주제 선정하기

7주차 Dev Session (미니 해커톤): 오프라인

미니 해커톤 열기! (1등한 팀 멤버분들에겐 멤버십 비용(10만원)을 제외한 금액을 환급해드립니다.)

🌟1기 멤버 신청하기 (프로모션 코드 받기)

10X AI Club은 유료 멤버십입니다. 디스콰이엇과 함께 협업하여 프로모션 코드를 발급하고 있으니 할인 코드를 받고 싶으신 분들께선 댓글로 "신청합니다!" 달아주세요! 커피챗 메세지로 코드를 보내드리겠습니다.

신청하는 폼은 다음 링크에서 확인하실 수 있으세요!

👩‍🎤모임장 지원하기

멤버분들 뿐만 아니라 현재 모임장들도 신청받고 있어요. 이번에는 @연주환 님께서 함께 모임장을 맡으시면서 오퍼레이션을 진행할 예정입니다!

10X AI Club의 모임장이 되면?

  • 모임원일때보다 다양한 사람들과 더욱 넓고 깊은 관계를 맺을 기회가 많아져요.

  • 모임이 성공적으로 진행되면 성취감과 보람을 얻을 수 있어요.

  • 팀원들을 리드하며 더 자세한 공부를 하며 깊은 인사이트를 얻을 수 있어요.

  • 리워드 등 다양한 혜택이 주어집니다.

모임장 지원하기

51
266
Cailyn Yong

Cailyn Yong

OpenAI Devday 주요 기술 업데이트 (GPTs, Assistant)

이번에 Sam Altman이 공개한 새로운 OpenAI 업데이트에 왜 그렇게 다들 열광하는걸까요?

개인적으로 가장 중요하게 생각했던 두가지, GPTs와 Assistant API를 소개해드릴게요.

GPTs

개인적으로 가장 기대되는 것은 GPTs입니다.

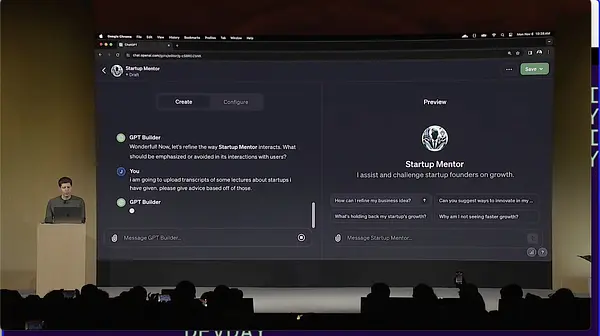
스마트폰이 처음 출시되고 나서 앱스토어가 처음 생겼을때와 비슷하게 이번에는 AI native 앱들을 올릴 수 있는 AI store라는 것을 발표했어요. 샘 알트먼은 AI store에 올라오는 GPT들 중에서 인기가 많고 가장 활용성이 높은 GPT들에겐 일부 수익 공유를 한다고 하더라구요.

image.png여기서 말하는 GPTs들은 어떤걸까요?

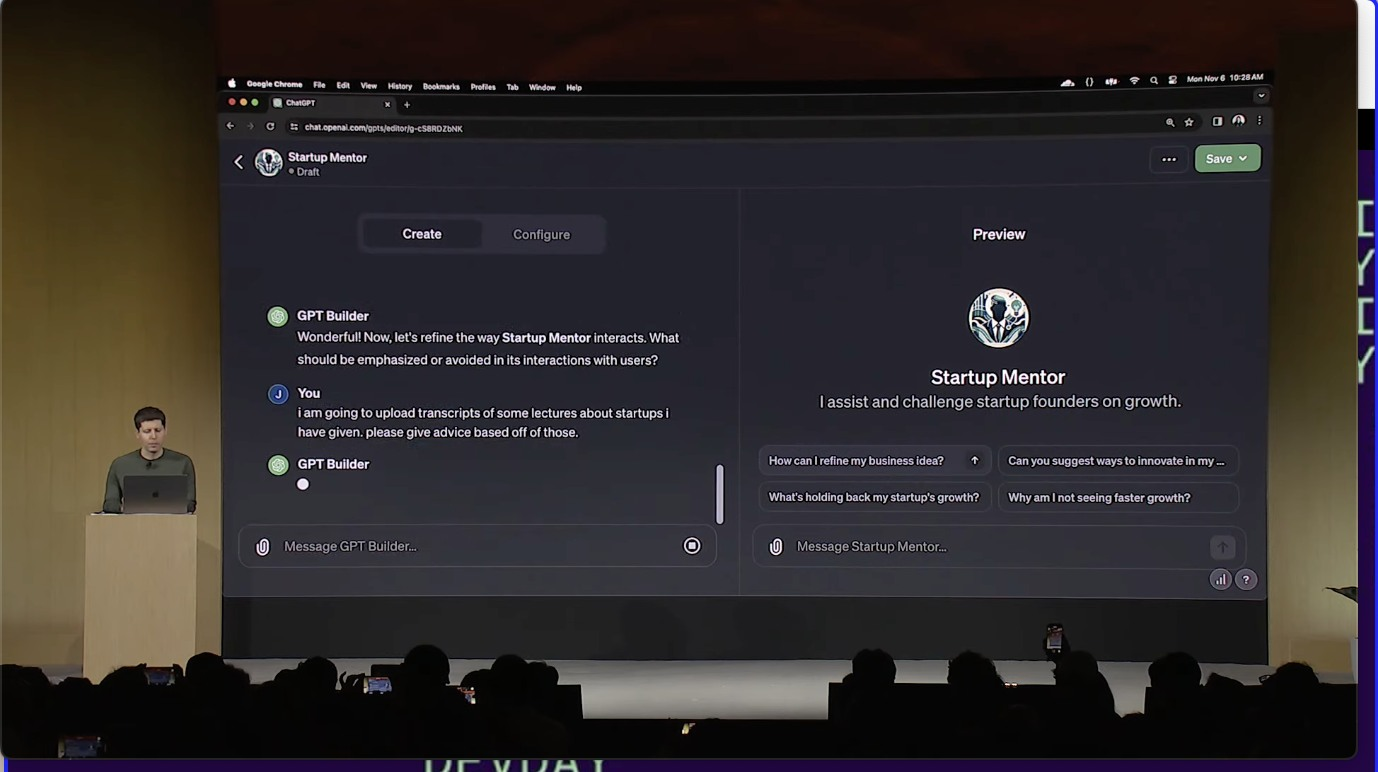
저희가 커스텀으로 만들 수 있는 챗GPT입니다. 샘 알트먼이 예시로 든 것은 Startup Advisor라는 것인데, YC에 있을 당시 스타트업 파운더들에게 해줬던 조언들을 바탕으로 자신의 lecture 내용을 GPT에게 학습시켜서 누구든 이 샘 알트먼의 "복제" 클론인 GPT에게 질문을 할 수 있게끔 만든겁니다.

가장 놀라웠던 것은 OpenAI가 최대한 제품을 코딩을 할 줄 모르는 분들을 고려해서 만들었다는 점이었습니다. 이 모든 것을 코딩 없이도 바로 자연어 프롬프트와 클릭 몇번으로 바로 만들 수 있다는 것입니다. 학습시킬 파일도 그냥 클릭 한번으로 업로드하면 GPT가 바로 학습하고 그거에 맞는 질문을 할 수 있게 만들었어요.

데모에서 보여줬던 다른 예시들은 GPT를 슬랙이나 구글 캘린더와 연결해서 나만의 개인 비서를 만드는 것이었습니다. Canva를 연결해서 원하는 포스터나 피피티를 바로 텍스트로 이미지생성을 할 수 있고, Zapier를 연결해서 내가 원하는 업무 자동화 플로우를 바로 할 수 있는거죠.

Assistant API

두번째로 가장 중요하게 봤던 업데이트는 Assistant API입니다.

이게 어떤 기능인지 한번에 이해시켜주는게 DevDay때 데모로 보여준 여행 AI Assistant입니다.

새롭게 나온 기능들이 3가지가 있는데, code interpreter, knowledge retrieval, function calling 입니다.

Code Interpreter

May be an image of 3 people and textCode interpreter는 예를 들어서 내가 AI한테 내 비행기 티켓과 에어비앤비 예약완료 파일을 업로드 한 다음에, 총 4명의 친구와 함께 여행을 간다고 한다면 1인당 드는 비용이 얼만지 계산해달라고 했을때 AI가 바로 계산을 해주는 기능입니다. 예전에는 이걸 계산하기 위해서 개발자가 일일이 코드를 짰어야하는데, 이제는 AI가 어떻게 계산을 해야하는지 이해를 해서 그에 맞는 계산 함수를 짜서 대신 해준다는 것입니다.

Knowledge Retrieval

May be an image of map and text that says 'GoegleChreme : Wanderlust Let's annotate these locations Discover ® Annotated map map. Assistant annotated Paris location arked with epresenting Enjoy planning your visitt these RomainHuet 0 flights.pdf map for type attraction. Read ង Displayedflightinformation Outbound � Your flight information Ûars displayed. Have great need any more assistance details, feel ask. Francisco SFO Mar102024 Paris CDG 12024 Starttyping or upload file... United Airlines 641.00 USD Checkin Sharetinerary'Knowledge retrieval은 말그대로 어떠한 형식의 파일을 올려도 AI가 필요한 정보들을 긁어와서 그에 맞는 질문을 할 수 있다는 것입니다. 예를 들어 제가 전 글에서 만들었던 고객 서비스 상담 챗봇을 만들기 위해 .html파일을 올렸던 것처럼, 이것도 올리면 바로 Q&A 챗봇을 만들 수 있다는 것입니다.

기존과 달라진게 있다면 일단 저는 주로 랭체인을 사용했기 때문에, .txt 파일을 불러올때랑 .pdf 파일 내용을 불러올때랑 다른 함수를 써서 귀찮았었는데, 이제는 그거와 별개로 그냥 바로 아래 코드블록으로 불러올 수 있어요.

# Upload a file with an "assistants" purpose
file = client.files.create(
  file=open("knowledge.pdf", "rb"),
  purpose='assistants'
)

엄청 다양한 파일들을 지원하게 돼서 편하더라구요. 어떤 파일들을 지원하는지는 platform.openai.com/docs/assistants/tools/supported-files에서 확인하세요!

Function Calling

May be an image of 6 people, map and text that says 'Wanderlust Triomphe. Discover Discover Assistant atmosphere Co“ur. RomainHuet Basilica ofthe 6. Relax Luxembourg Gardens. 7. stunning Palace Versailles and 8 Take boat cruise River Seine. Admire Musée d'Orsay. 10 the modern Centre Pompidou. gardens. Let's these locations � Annotating map the Start typing orupload file... Map'마지막으로 function calling은 여러 use case가 있는데, 내가 만드는 Assistant에 다른 챗GPT 플러그인 api를 사용하고 싶거나, 아님 비정형화된 데이터를 정형화된 데이터로 변환해주는 기능 등이 있습니다.
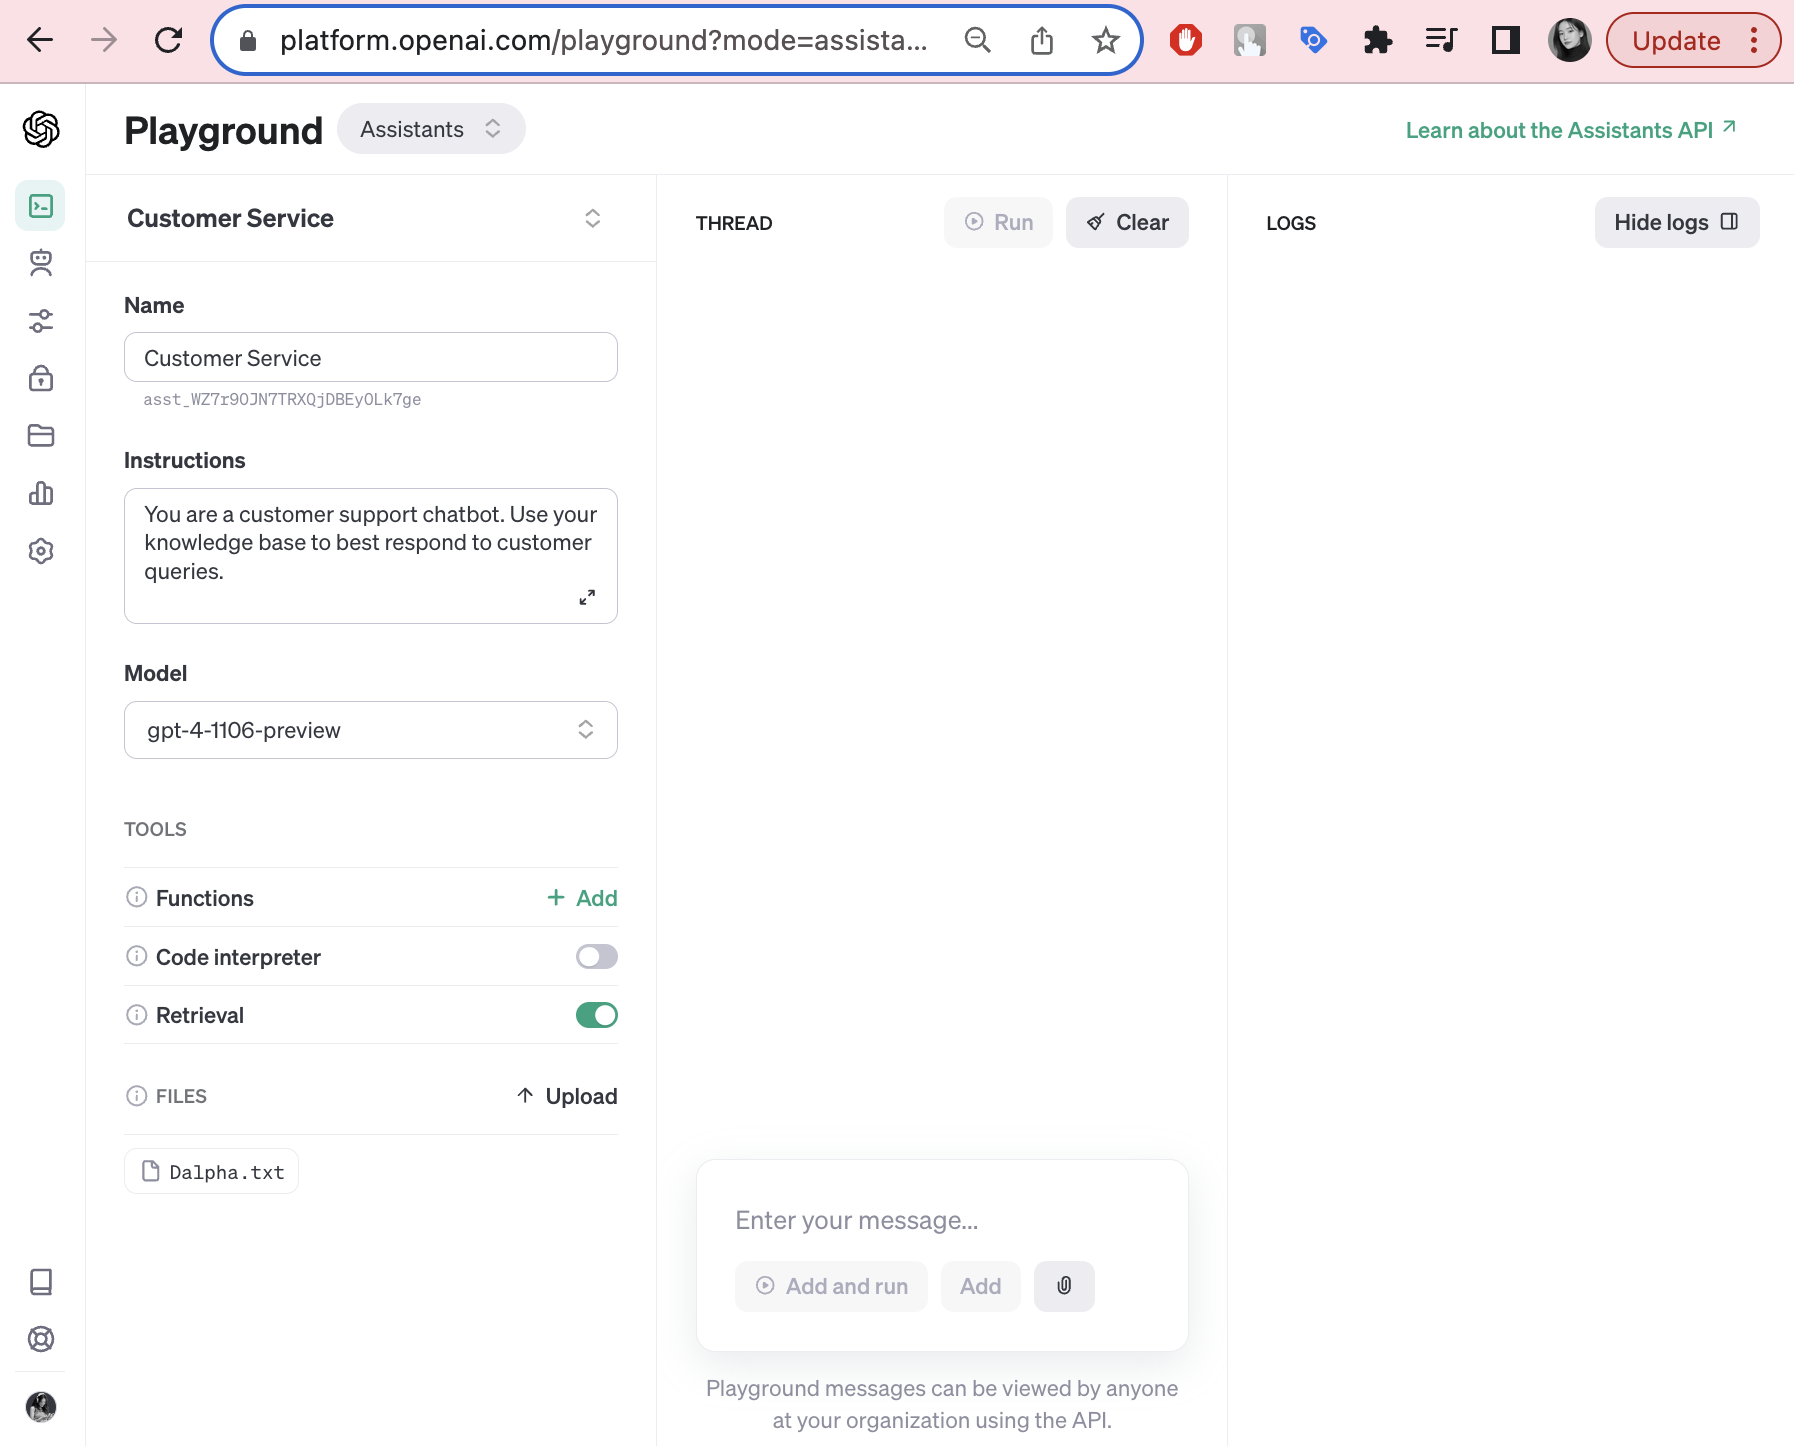
위 사진에서는 파리 여행을 갈때 꼭 들려야하는 명소들을 오른쪽의 지도에 바로 표시해주는 함수를 따로 만들었더라구요.

Assistant는 어떻게 구현하는지?

OpenAI documentation도 새롭게 업데이트가 됐어요. Assistant라는 섹션을 가면 어떻게 이 api를 활용하는지 쉽게 설명해주고 있습니다. 단계별로 어떻게 구현하는지 빠르게 설명드릴게요.

#1 Assistant 만들어주기

처음에는 Assistant를 셋업해줍니다. 랭체인과 사뭇 비슷한 형식인데, 셋업하는 코드 양이 훨씬 줄었어요. name에는 assistant 이름을 넣어주고, instructions에는 랭체인에서 프롬프트 셋업을 할때와 비슷하게 여기에 어떤 assistant인지 설명해주고 있습니다.

특히나 tools에서는 위에서 설명한 code_interpreter를 쓸건지, retrieval을 쓸건지, function_calling을 쓸건지에 따라 바꿔주면 되고, model에는 사용하고 싶은 gpt 모델을 알려주면 됩니다.

assistant = client.beta.assistants.create(
    name="Math Tutor",
    instructions="You are a personal math tutor. Write and run code to answer math questions.",
    tools=[{"type": "code_interpreter"}],
    model="gpt-4-1106-preview"
)

#2 Thread 만들기

저번 글에서 AI 에이전트와 대화를 할때 대화 내용을 기록할 수 있게 하는 memory 변수를 세팅해준 것 기억하시나요? 이젠 그런 셋업도 필요없이 그냥 쓰레드 하나 만들어서 유저가 질문할때마다 메세지를 그 쓰레드에 하나씩 추가하는 형식으로 구현하고 있습니다.

thread = client.beta.threads.create()

#3 Thread에 메세지 추가하기

위에서 만든 Thread에 이제 이 메세지가 추가되고, 대화 내용들이 다 기록되기 시작합니다.

message = client.beta.threads.messages.create(
    thread_id=thread.id,
    role="user",
    content="I need to solve the equation `3x + 11 = 14`. Can you help me?"
)

#4 Assistant 실행하기

마지막으로 그냥 실행시켜주면 끝!

run = client.beta.threads.runs.create(
  thread_id=thread.id,
  assistant_id=assistant.id,
  instructions="Please address the user as Jane Doe. The user has a premium account."
)

#5 메세지 결과 보여주기

다음 블록들을 하나씩 실행해주면 결과가 보입니다.

run = client.beta.threads.runs.retrieve(
  thread_id=thread.id,
  run_id=run.id
)
messages = client.beta.threads.messages.list(
  thread_id=thread.id
)

Playground에서 테스트해보기

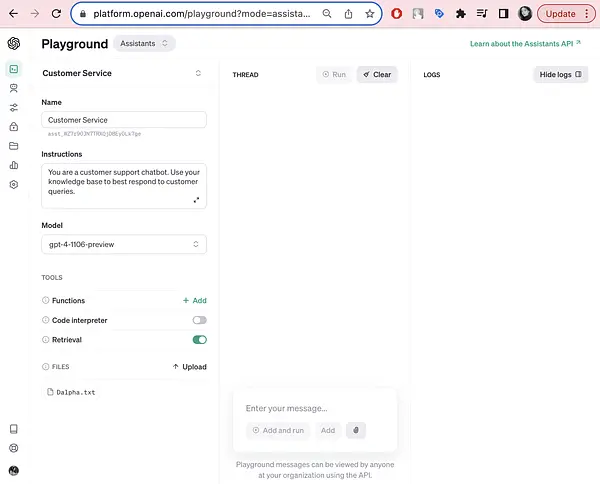
이제 위에서 방금 만든 Assistant는 실제로 platform.openai.com/assistants로 가면 새롭게 생성된게 보이고, 직접 얘를 테스트해볼 수 있어요. 코드에서 만든대로 Assistant가 셋업 된걸 확인할 수 있습니다. 오른쪽에는 Log들도 확인할 수 있어요!

Screenshot 2023-11-08 at 9.15.52 PM.png

앞으로의 사업 방향?

이런식으로 좀 빠르게 업데이트가 된 기술들이랑 documentation을 확인해봤어요.

사실 가장 우려되는 점들은 앞으로 스타트업들이 어떻게 살아남아야할지와, 이런식으로 foundation model들이 계속 업데이트를 하면 내가 만들고 있던 제품이 하루아침에 경쟁력을 아예 잃어버릴 수도 있는데 뭘 해야할지 고민하게 될 것 같아요.

제가 전 글들에서 우려했던게 현실이 된 것 같기도 하고요.

계속 이것에 대해서 고민을 하고 더 많은 분들한테서 얘기를 듣고 싶습니다. 댓글 달아주시거나 10X AI Club 오픈채팅방에서도 많은 얘기를 나누고 있으니 클럽 참여하시면 초대링크 보내드리겠습니다!

다음 글..

두둥. 다음글은 이제 새롭게 추가된 Assistant API를 사용해서 실제 개발까지 해보는걸 다룰 예정입니다! 많은 기대 부탁드리겠습니다 :)

34
5
Cailyn Yong

Cailyn Yong

[Part 2] 코드 100줄로 쏘카 팀이 만든 고객 서비스 챗봇 10분 안에 만들어보기 (RAG, 할루시네이션 처리)

저번 포스트에 이어서 올리는 "고객 상담 챗봇 만들기" 개발글 Part 2 입니다.

쏘카 팀이 고객 서비스 챗봇을 만들었다고 했는데, 만든 방법은 시나리오 기반 LLM 봇 입니다. (아래 글에서 더 자세히 확인하세요)

조금 더 자세히 쏘카 팀의 개발 디자인에 대해 살펴봅시다.

  1. 먼저 유저의 텍스트 인풋에 따라 상담의 의도를 바로 LLM이 파악하기

  1. RAG (Retrieval Augmented Generation), vector search를 같이 사용해서 LLM 에이전트가 상담 매뉴얼 DB에서 더욱 정확한 결과를 검색해서 뱉어내도록 하기

  2. 할루시네이션이 나오면 미리 후처리해서 LLM이 답하는 것보다 인간 상담원에게 바로 연결을 할 수 있도록 디자인 하기

Part 1에서는 정말 간단하게 ChatGPT와 같은 챗봇을 만들었었고, 이번 파트에서는 RAG와 vector store을 이용한 대화형 LLM 챗봇을 만들고, 할루시네이션까지 전처리 할 수 있는 방법에 대해 살펴보겠습니다.

프로젝트를 만들면서 참고한 Langchain documentation 입니다.

구현하는 법

Screenshot 2023-11-06 at 3.10.41 PM.png기본적으로 이 프로젝트가 어떤 로직으로 구현됐는지 설명드릴게요. 저번 파트에서 만들었던 대화 내용을 기억하는 대화형 챗봇 위에 추가적인 기능(RAG, vector store)을 더했습니다.
  1. 백엔드에서 고객 서비스 매뉴얼 파일 업로드

  2. 로딩한 파일 vector store 데이터베이스에 업로드하기

  3. 유저가 제품 관련 질문하면 데이터베이스에 저장돼있는 정보 내에서 관련 답변을 검색한 후 내용 정리해서 내뱉기 (RAG, vector search)

  4. 제품과 관련되지 않은 질문하면 할루시네이션 처리 ("이 정보에 대해서 모른다고 대답")

프로젝트 셋업

  1. 새로운 폴더 만들기

  2. 터미널에서 가상환경 만들기 : python3 -m venv venv

  3. .env 파일 만들고 그 안에 OPENAI_API_KEY = "sk- <나만의 openai api key>" 저장하기

  4. 가상환경 실행시키기: source venv/bin/activate

  5. 필요한 패키지들 다운받기:

pip3 install openai langchain tiktoken python-dotenv chromadb streamlit bs4
  1. 파이선 파일 만들기: chatbot.py

백엔드 코드

고객 서비스 매뉴얼 업로드 하고 벡터스토어에 저장하기

가장 먼저 필요한 모듈들을 불러오세요.

import dotenv
dotenv.load_dotenv()
from langchain.document_loaders import WebBaseLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.embeddings import OpenAIEmbeddings
from langchain.vectorstores import Chroma
from langchain.chat_models import ChatOpenAI
import streamlit as st
import time

그 다음 저희가 할것은 고객 서비스 응대 매뉴얼을 로딩해야합니다.

이건 .txt 파일일수도 있고, .pdf 파일일수도 있어요. 저희는 이번 프로젝트 예시 시나리오를 위해 웹에서 scraping한 정보들을 토대로 챗봇을 만들 예정입니다. 달파 AI store 페이지에서 어떤 식으로 제품이 만들어지는지 자세히 설명돼있어서 예시로 썼어요!

이 웹사이트에 있는 텍스트 정보들을 scraping 하려면 다음 코드를 사용하면 됩니다. 코드에 대한 설명은 각 라인의 #주석을 확인해주세요.

# LLM 셋업하기 
llm = ChatOpenAI(temperature=0)

# WebBaseLoader 함수가 " " 안에 있는 웹사이트 텍스트들을 불러옵니다.
loader = WebBaseLoader("https://dalpha.so/ko/howtouse?scrollTo=custom")
# 데이터 로딩하기
data = loader.load()

# 불러온 데이터 스플릿하기 
text_splitter = RecursiveCharacterTextSplitter(chunk_size = 500, chunk_overlap = 0)
all_splits = text_splitter.split_documents(data)

# 불러온 데이터 Chroma라는 vector store에 저장하기. 
# LLM 에이전트가 이 데이터베이스에 저장돼 있는 내용을 검색할 수 있도록 해주는 겁니다. 
vectorstore = Chroma.from_documents(documents=all_splits, embedding=OpenAIEmbeddings())

# LLM 에이전트가 사용할 수 있도록 retriever 라는 툴로 만들어줍니다. 
retriever = vectorstore.as_retriever()

에이전트가 사용할 툴 만들기

그 다음 할 것은 vector store에 저장돼있는 내용을 LLM이 필요할때 검색할 수 있는 툴로 만들어주는 것입니다. 보통 LLM 에이전트를 만들때 에이전트가 사용할 수 있는 툴들을 여러개 만들어 줄 수 있어요. 그게 구글 검색일수도 있고, 이런식으로 내가 업로드한 다큐멘트 파일에 대한 내용 검색을 하는 툴일수도 있어요. 이렇게 검색을 해서 정확한 결과들을 불러오는 기술을 RAG (Retrieval augmented generation) 이라고 합니다.

from langchain.agents.agent_toolkits import create_retriever_tool

tool = create_retriever_tool(
retriever,
"cusomter_service",
"Searches and returns documents regarding the customer service guide.",
)

tools = [tool]

이제 LLM 에이전트가 만약 유저가 내가 업로드한 다큐멘트에 관련된 질문을 하면 이 tool 을 사용해서 검색을 하게 될 것입니다.

대화 내용 기억할 수 있는 메모리 부여하기

다음 에이전트가 대화 내용들을 기록하고 기억할 수 있도록 memory라는 변수를 셋업해주세요.

memory_key = "history"

from langchain.agents.openai_functions_agent.agent_token_buffer_memory import (
    AgentTokenBufferMemory,
)

memory = AgentTokenBufferMemory(memory_key=memory_key, llm=llm)

에이전트 만들기 (할루시네이션 전처리)

이제 에이전트를 만들어줄게요. 자세한 설명은 각 코드 라인의 주석을 확인해주세요.

from langchain.agents.openai_functions_agent.base import OpenAIFunctionsAgent
from langchain.schema.messages import SystemMessage
from langchain.prompts import MessagesPlaceholder

# LLM이 어떤 행동을 해야하는지 알려주는 프롬프트 
system_message = SystemMessage(
    content=(
        # 여기서는 챗봇에게 너는 어떤 챗봇인지 설명해주고, 위에서 만든 툴을 활용해서 답변을 하라고 해줍니다
        "You are a nice customer service agent."
        "Do your best to answer the questions."
        "Feel free to use any tools available to look up "
        "relevant information, only if necessary"
        # 할루시네이션 전처리 과정입니다. 프롬프트로 "만약 서비스 매뉴얼과 관련되지 않은 질문이면 거짓된 답변을 생성하지 말아줘" 라고 처리합니다.
        "Do not generate false answers to questions that are not related to the customer service guide."
        "If you don't know the answer, just say that you don't know. Don't try to make up an answer."
        # 챗봇이 한국어로 대답하게 합니다.
        "Make sure to answer in Korean."
    )
)

# 위에서 만든 프롬프트를 바탕으로 LLM에게 줄 프롬프트 형식 셋업 
prompt = OpenAIFunctionsAgent.create_prompt(
    system_message=system_message,
    extra_prompt_messages=[MessagesPlaceholder(variable_name=memory_key)],
)

# 위에서 만든 llm, tools, prompt를 바탕으로 에이전트 만들어주기 
agent = OpenAIFunctionsAgent(llm=llm, tools=tools, prompt=prompt)

코드를 자세히 보시면 프롬프트 내에서 할루시네이션 전처리 과정을 한것을 볼 수 있습니다. 서비스 매뉴얼과 관련되지 않은 질문을 하면 거짓된 답변을 생성하지 말라고 명시해줍니다. 그냥 모른다고 대답하라고 처리해줍니다. 그래야만 할루시네이션 값들을 최소한으로 줄일 수 있게 됩니다. (이 방식은 100% 할루시네이션을 없애진 않습니다.)

에이전트 실행하기

마지막으로 에이전트를 실행시킬 수 있는 AgentExecutor 코드를 만들고, 테스트를 해보세요.

from langchain.agents import AgentExecutor

agent_executor = AgentExecutor(
agent=agent,
tools=tools,
memory=memory,
verbose=True,
return_intermediate_steps=True,
)

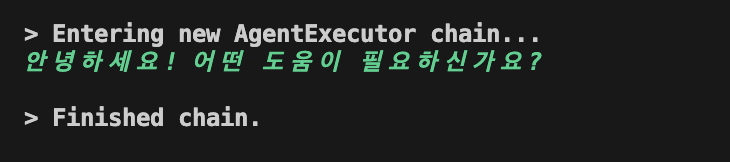
result = agent_executor({"input": "안녕하세요"})
print(result)

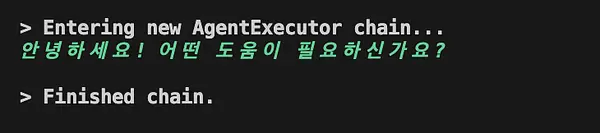
테스트를 해볼때에는 터미널에 python3 chatbot.py를 실행시키면 됩니다. 그럼 이런식으로 답변이 생성돼요.

Screenshot 2023-11-06 at 6.39.43 PM.png

저희가 테스트해봐야하는 케이스는 두가지인데,

  1. 업로드한 서비스 매뉴얼 관련 답변을 잘 하는지

  2. 할루시네이션 값들을 전처리해주는지

확인해야합니다.

첫번째 케이스를 테스트해볼게요.

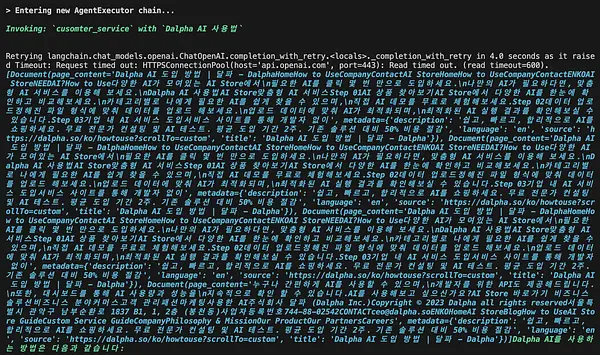
result = agent_executor({"input": "어떻게 Dalpha AI를 사용하나요?"})
print(result)

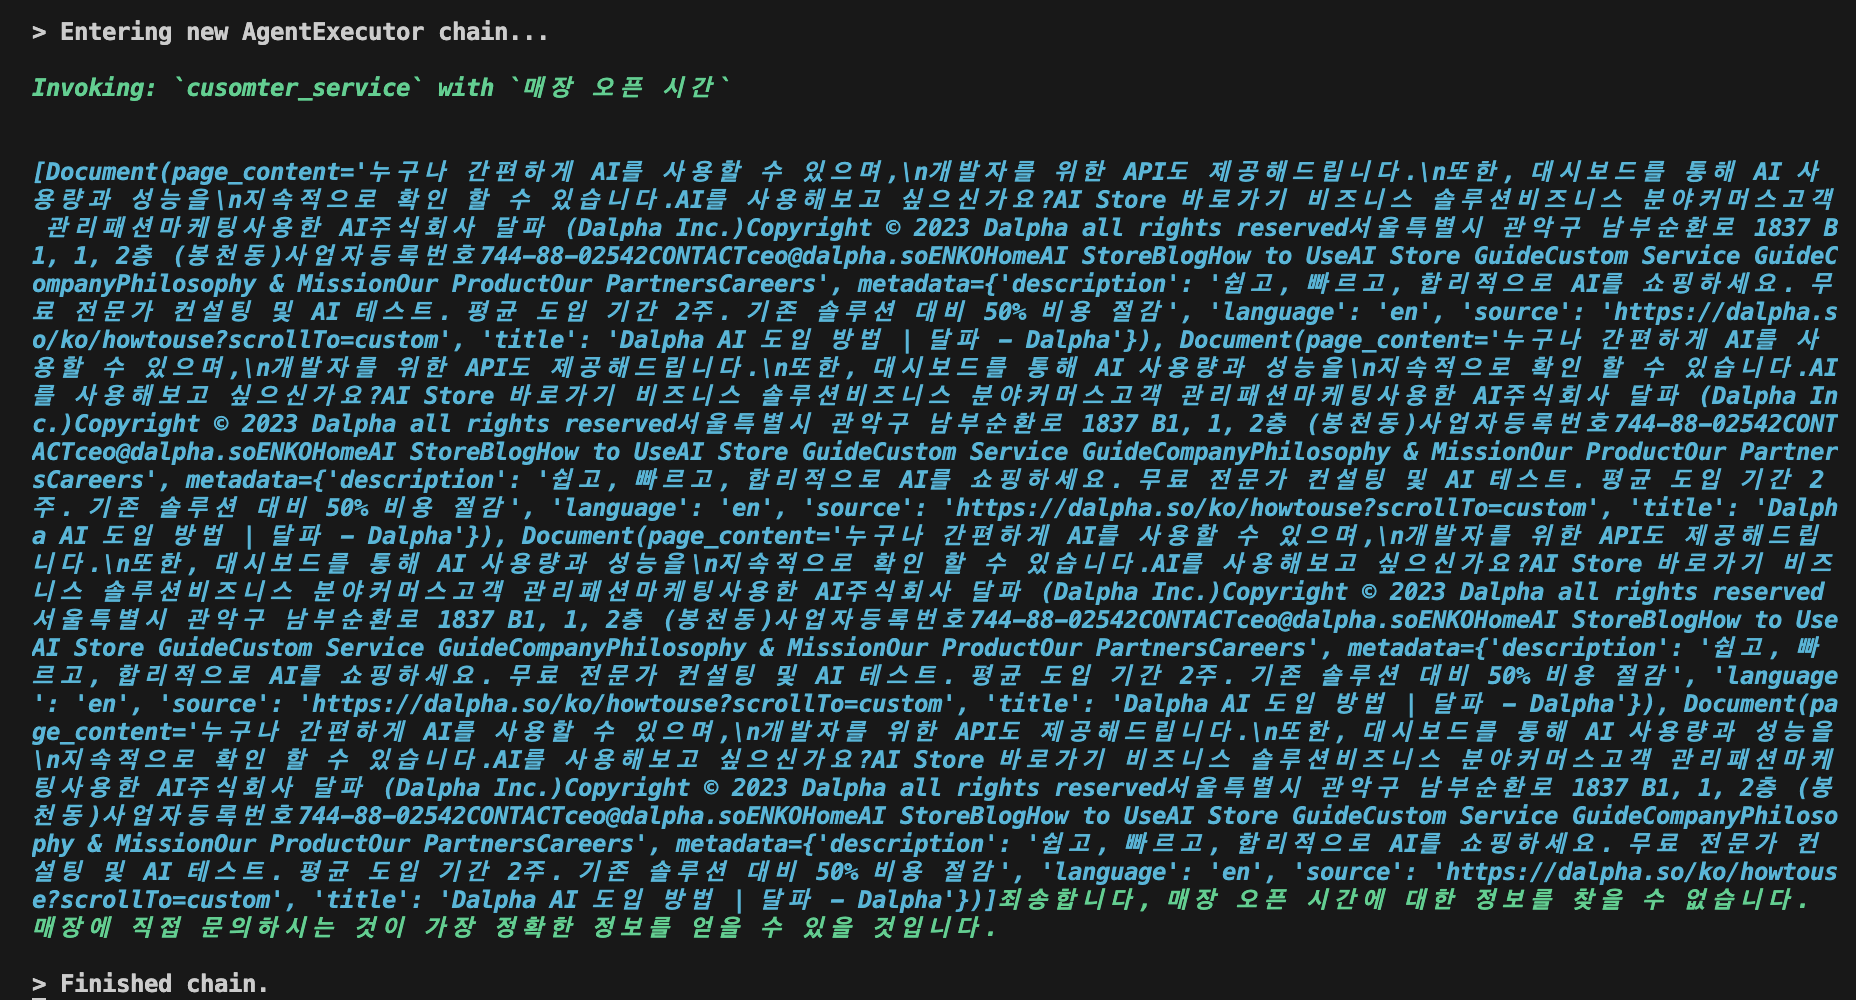
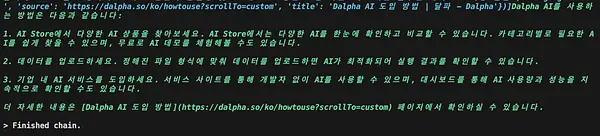
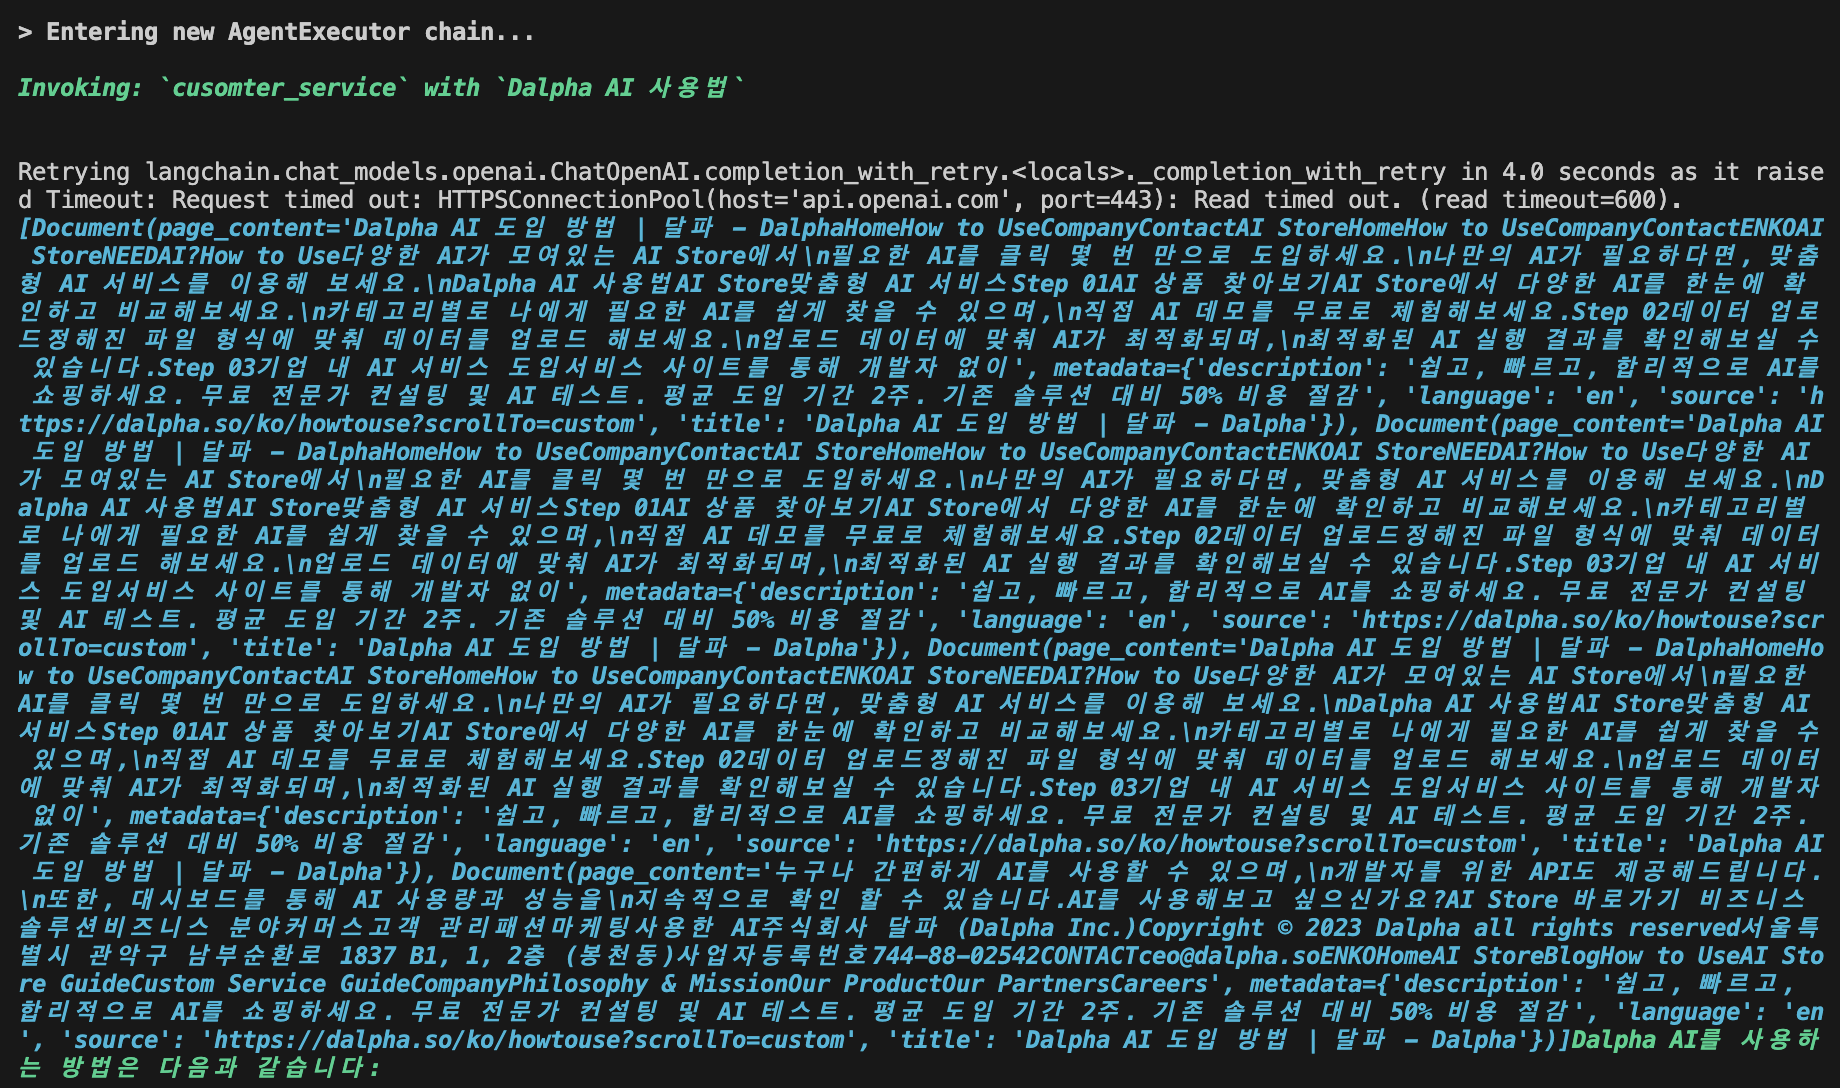
그럼 답변이 생성됩니다. 일단 먼저 아래 이미지에서 "Invoking: 'customer_service' with 'Dalpha AI 사용법'" 보이시죠? 이게 바로 위에서 만든 retriever tool을 제대로 사용했음을 볼 수 있어요. 저희가 vector store에 업로드한 웹사이트 내용을 에이전트가 제대로 검색하고 있는 것을 확인할 수 있습니다.

그 다음 파란색 부분은 웹사이트에 있는 내용들을 실제로 불러온 것입니다.

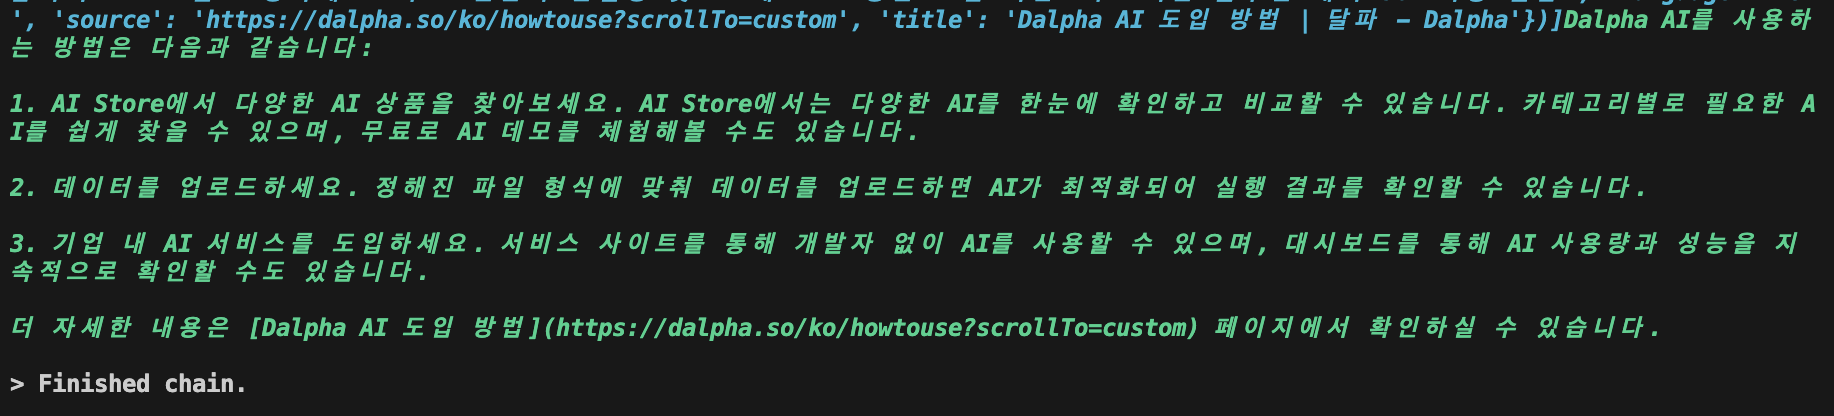
Screenshot 2023-11-06 at 6.41.07 PM.png그러고 에이전트가 최종 답변을 생성합니다. 1-3번까지 내용을 간추려서 리스트업한걸 확인할 수 있고, 더 추가 내용은 실제 웹사이트에 가서 확인하라는 메세지도 생성합니다.
Screenshot 2023-11-06 at 6.42.40 PM.png

그 다음 두번째 케이스를 테스트해볼게요.

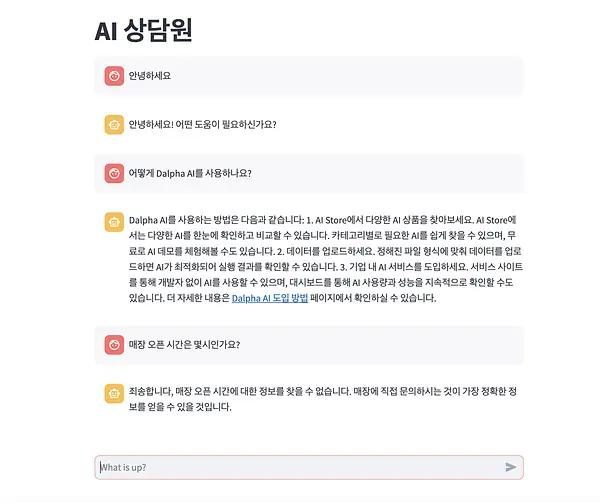
result = agent_executor({"input": "매장 오픈 시간은 몇시인가요?"})
print(result)

상품과 관련없는 질문을 했을때 거짓된 답변을 생성하는 것이 아닌, 모른다고 답변을 해야합니다. 쏘카와 같은 경우에는 인간 상담원에게 바로 연결할 수 있도록 했어요.

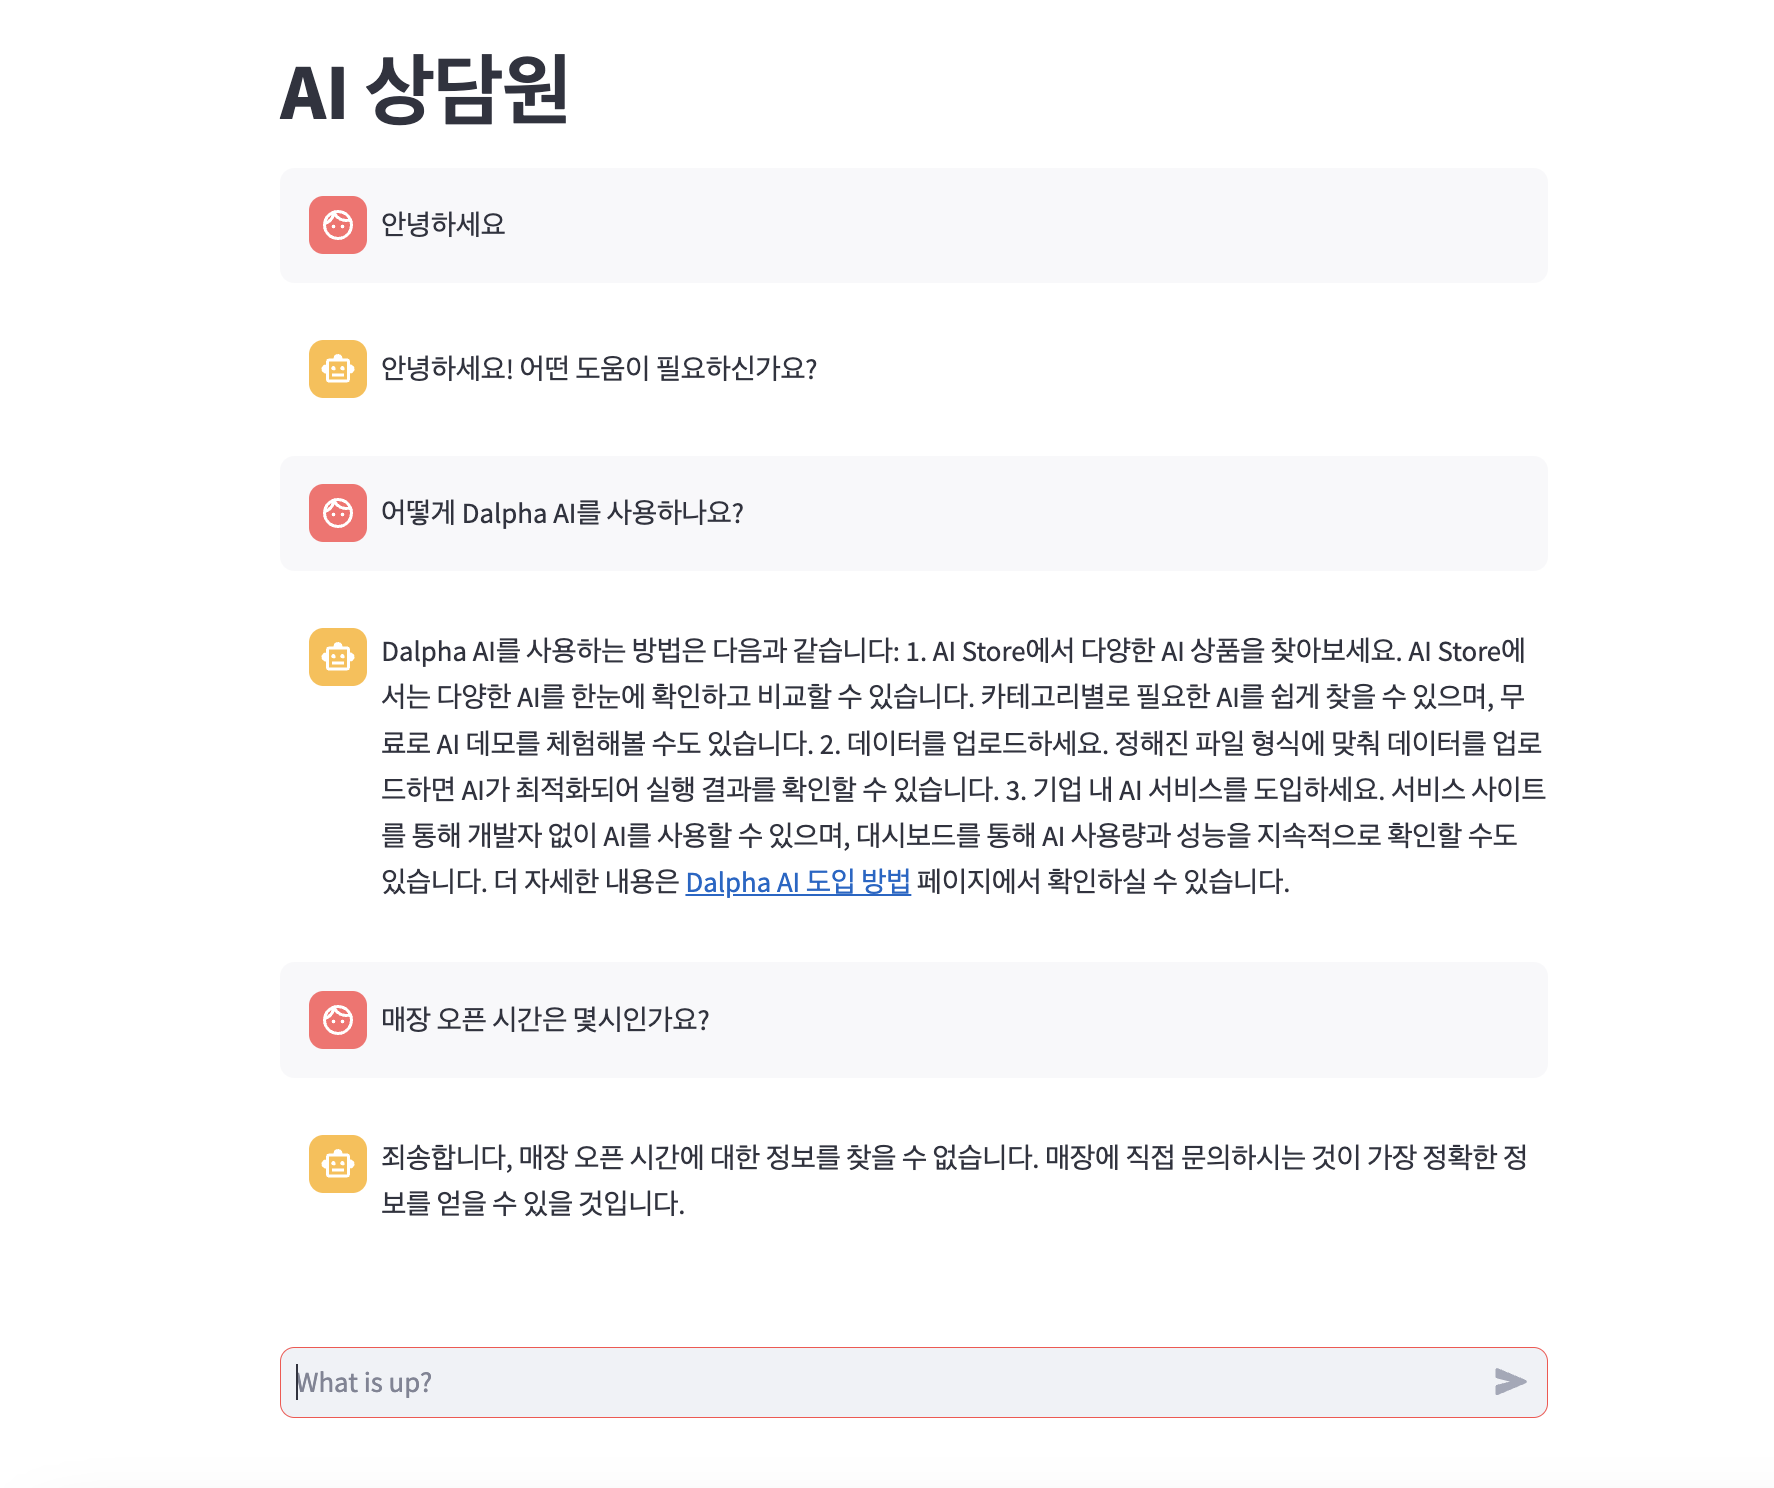
Screenshot 2023-11-06 at 6.45.56 PM.png위 이미지를 보면 마찬가지로 웹사이트 내용을 긁어왔고, 그 내용을 토대로 질문에 대한 답변을 검색한 결과 관련된 답변이 없어서 "죄송합니다, 매장 오픈 시간에 대한 정보를 찾을 수 없습니다." 라고 답변했습니다. 할루시네이션이 제대로 처리가 됐어요.
이렇게 백엔드 코드가 완성됐습니다!!

프론트엔드 코드

프론트엔드는 저번 Part 1과 똑같은 형식으로 갈거기때문에 추가 설명은 하지 않을게요.

이 부분만 주석 처리해주세요.

result = agent_executor({"input": "매장 오픈 시간은 몇시인가요?"})
print(result)

그 다음 코드 블록을 밑에 복붙해주세요.

st.title("AI 상담원")

if "openai_model" not in st.session_state:
    st.session_state["openai_model"] = "gpt-3.5-turbo"

if "messages" not in st.session_state:
    st.session_state.messages = []

for message in st.session_state.messages:
    with st.chat_message(message["role"]):
        st.markdown(message["content"])

if prompt := st.chat_input("What is up?"):
    st.session_state.messages.append({"role": "user", "content": prompt})
    with st.chat_message("user"):
        st.markdown(prompt)

    with st.chat_message("assistant"):
        message_placeholder = st.empty()
        full_response = ""
        # 여기서 위에서 만든 LLM 에이전트를 실행시킵니다. 유저 prompt가 인풋으로 들어갑니다. 
        result = agent_executor({"input": prompt})
        for chunk in result["output"].split():
            full_response += chunk + " "
            time.sleep(0.5)
            message_placeholder.markdown(full_response + "▌")
        message_placeholder.markdown(full_response)
    st.session_state.messages.append({"role": "assistant", "content": full_response})

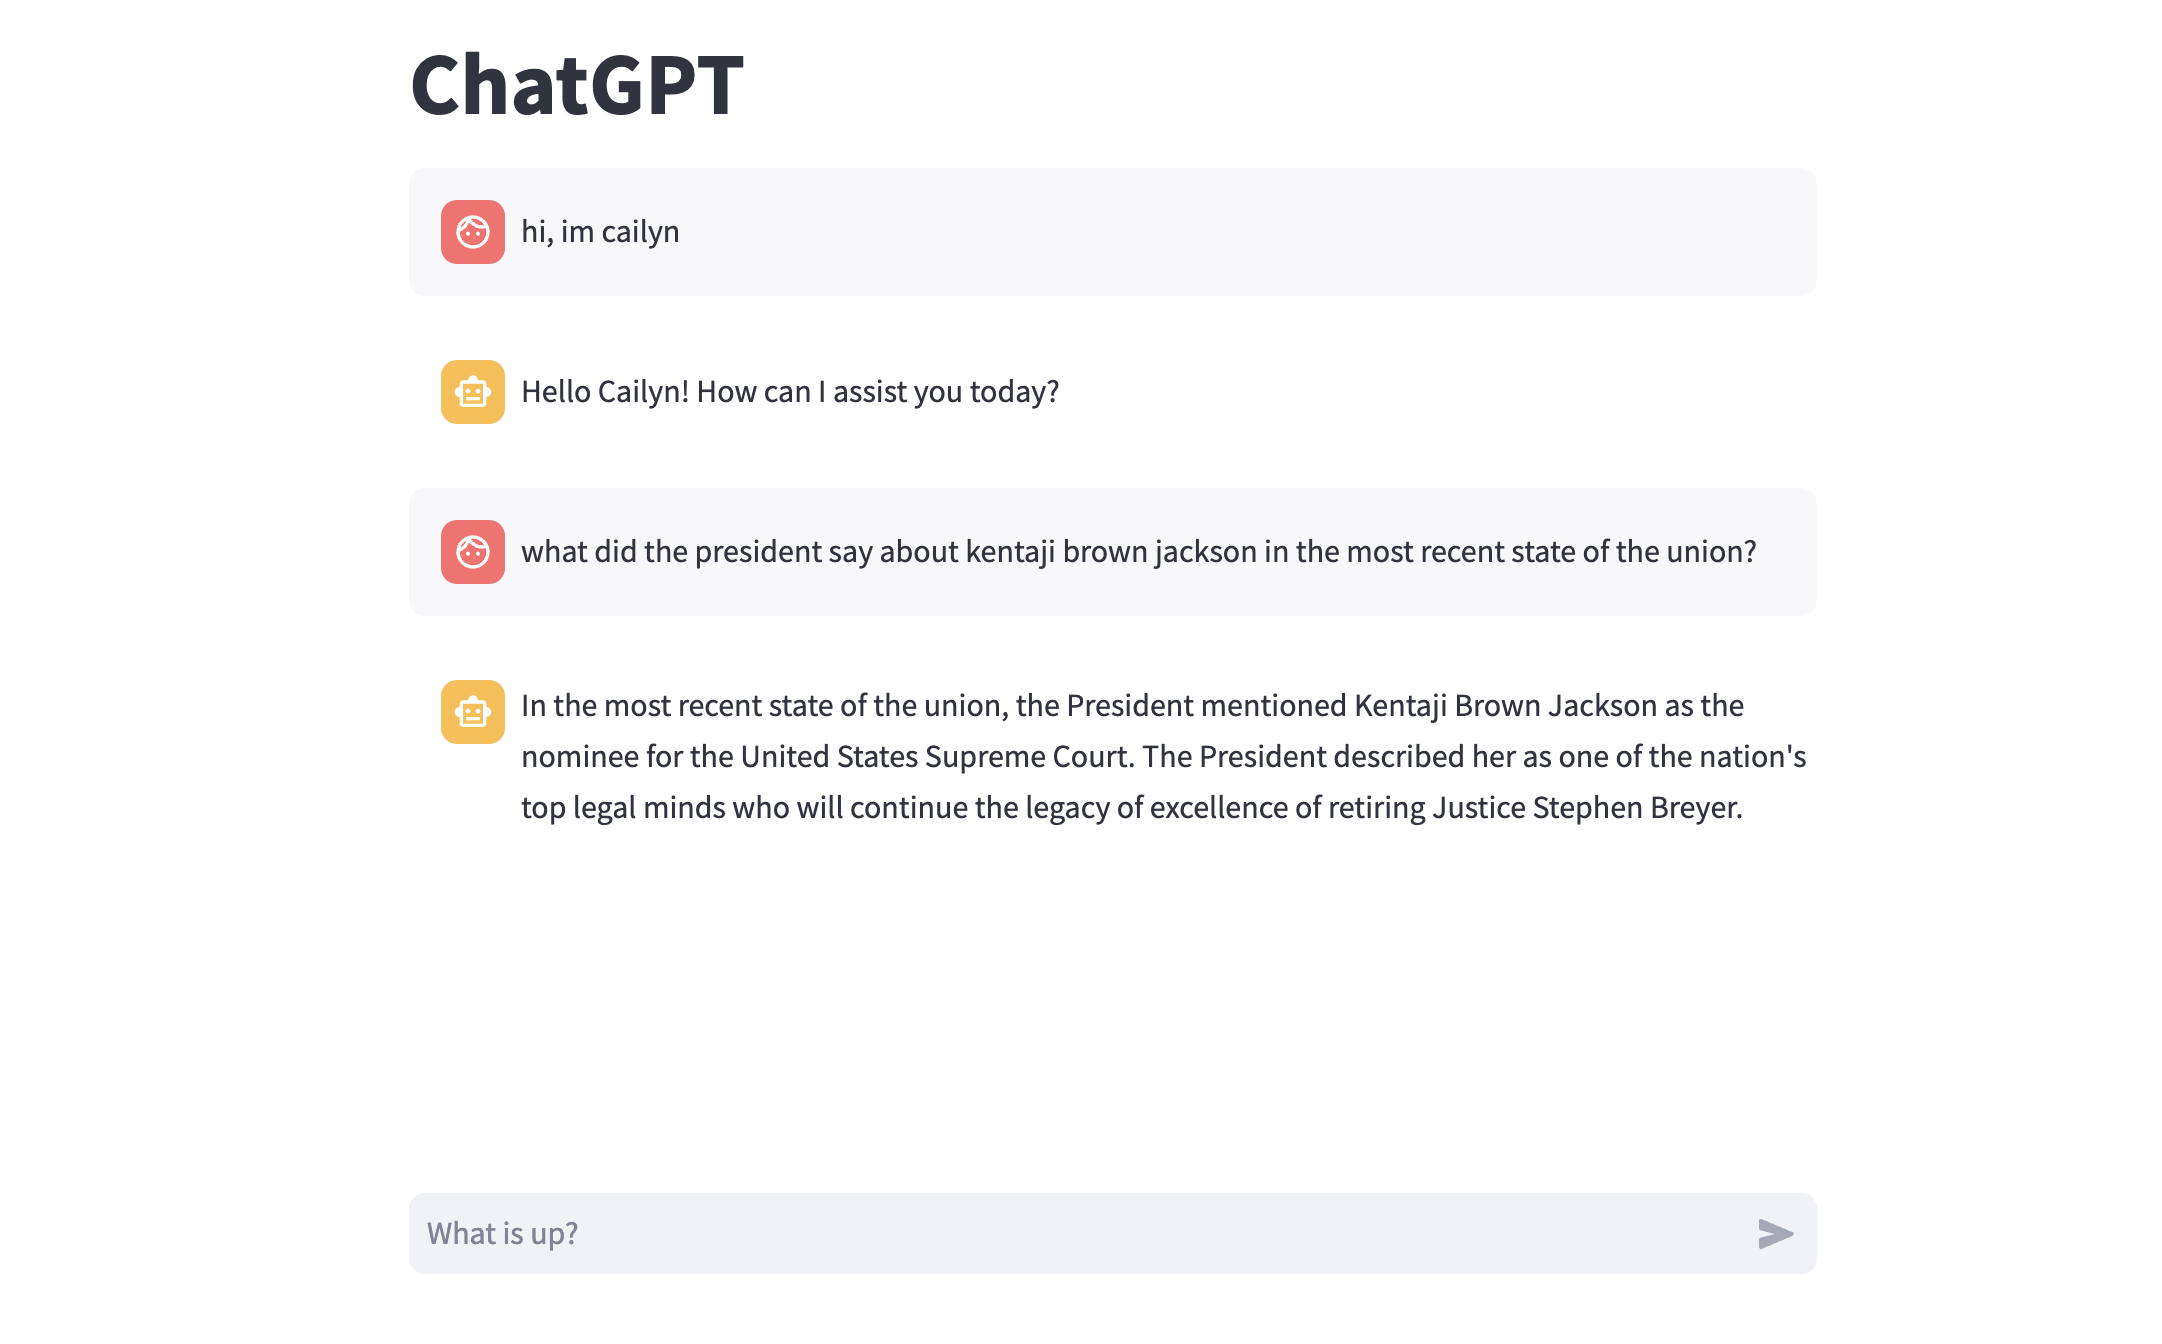
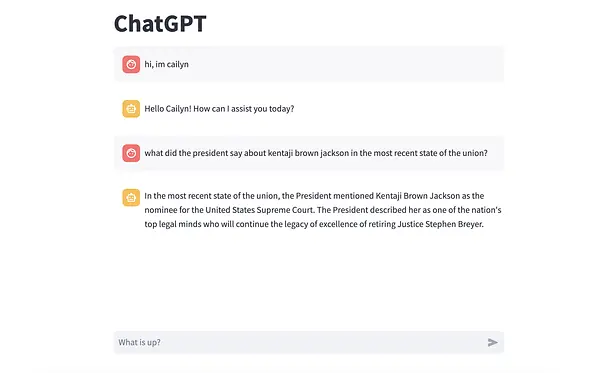
다 저장후 터미널에서 streamlit run chatbot.py를 하시면 다음 화면이 뜨고 바로 테스트해볼 수 있습니다!

Screenshot 2023-11-06 at 3.10.41 PM.png

마무리

이렇게 RAG를 활용한, 할루시네이션까지 처리해주는 고객 상담 챗봇을 만들어봤어요.

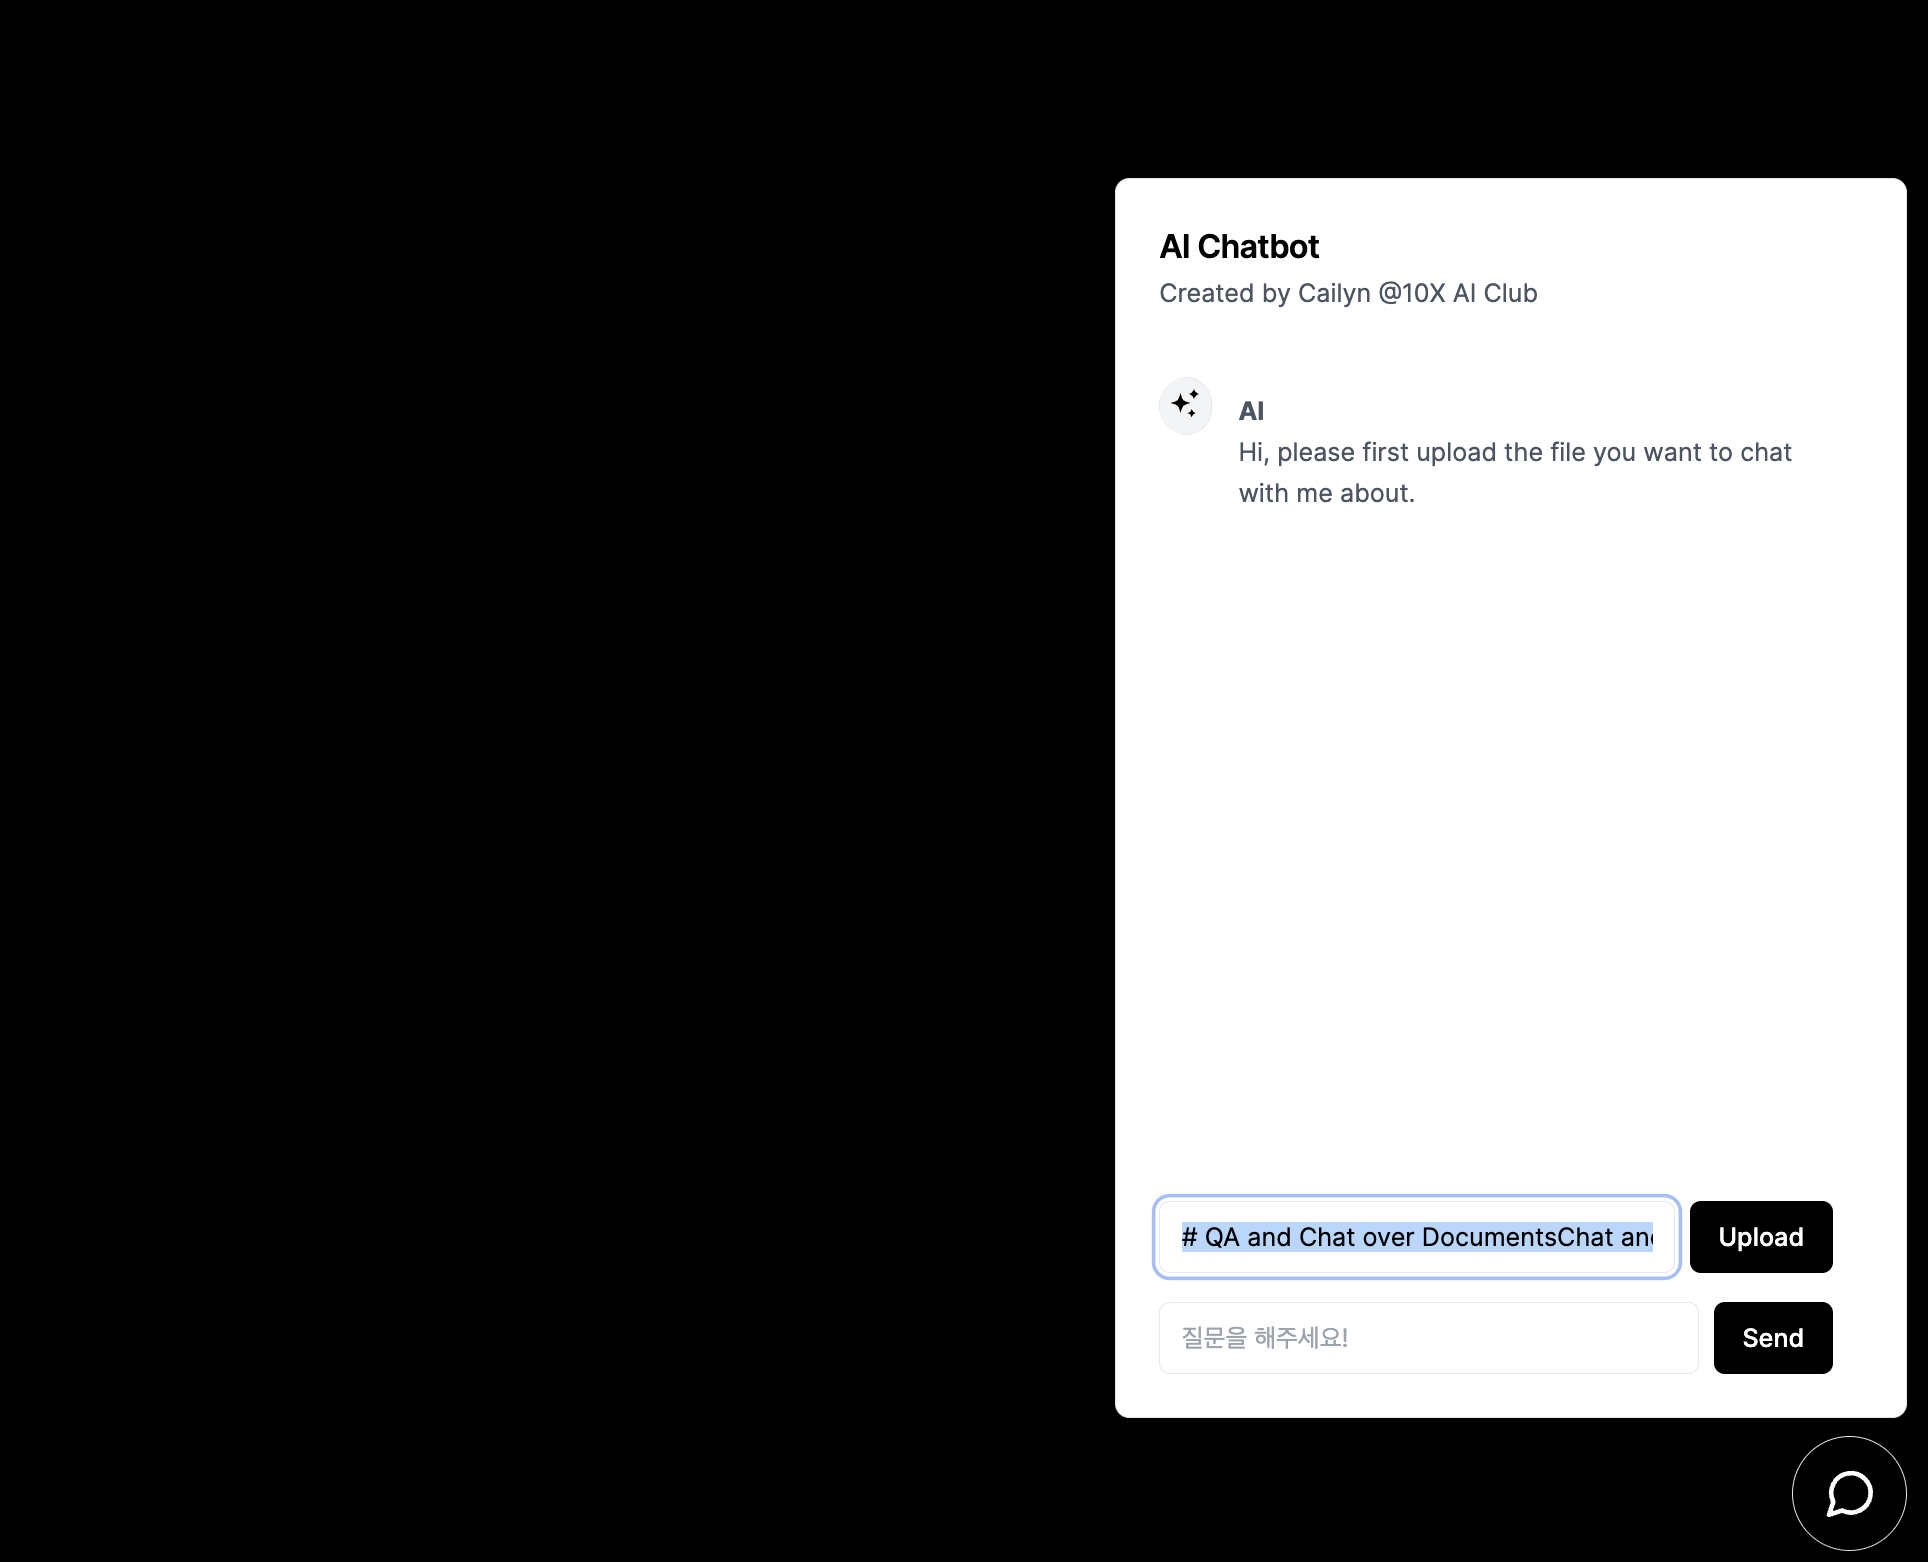
조금 더 예쁜 프론트엔드로 된 챗봇 코드를 받아보고 싶다면 위 링크에서 Week 3 챗봇만 따로 수강하실 수 있습니다! 프론트엔드가 더 잘 구현된 챗봇은 아래 이미지처럼 생겼습니다. 챗봇 아이콘을 누르면 대화 창이 팝업이 되고 다른 곳을 누르면 팝업이 사라지는 UX입니다. 원하는 다큐먼트 텍스트를 업로드하고 그와 관련된 Q&A를 할 수 있는 챗봇이에요!

Screenshot 2023-11-04 at 2.34.45 AM.png

마지막으로 따로 자신의 비즈니스에 이런 고객 서비스 챗봇을 연동시키고 싶으면 아래 Tally form에서 문의 받습니다.

오늘도 긴글 읽어주셔서 감사합니다!

27
10
Cailyn Yong

Cailyn Yong

[Part 1] 쏘카 팀이 만든 고객 서비스 챗봇 10분 안에 만들어보기

이번 개발글은 저번 Microsoft's "Generative AI Roadshow" 토크에서 발표한 쏘카팀에게 영감을 받은 프로젝트입니다. 쏘카 팀이 고객 서비스 챗봇을 만들었다고 했는데, 만든 방법은 시나리오 기반 LLM 봇 입니다.

조금 더 자세히 쏘카 팀의 개발 디자인에 대해 살펴봅시다.

  1. 먼저 유저의 텍스트 인풋에 따라 상담의 의도를 바로 LLM이 파악하기

  1. RAG (Retrieval Augmented Generation), vector search를 같이 사용해서 LLM 에이전트가 상담 매뉴얼 DB에서 더욱 정확한 결과를 검색해서 뱉어내도록 하기

  2. 할루시네이션이 나오면 미리 후처리해서 LLM이 답하는 것보다 인간 상담원에게 바로 연결을 할 수 있도록 디자인 하기

이번 개발 프로젝트는 두 파트로 나눴습니다.

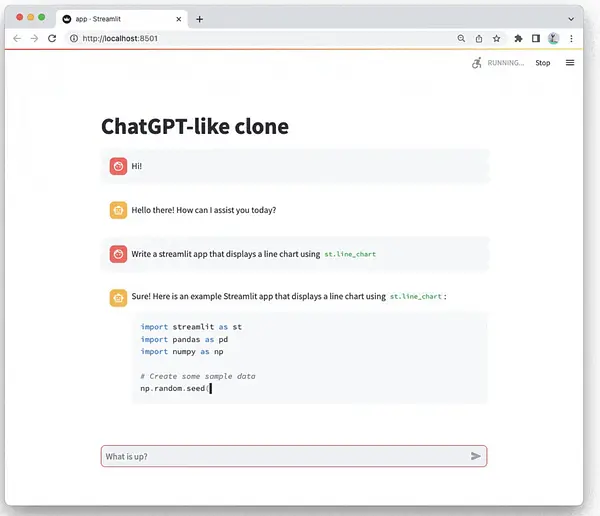
Part 1에서는 정말 간단한 ChatGPT와 같은 형식의 캐쥬얼한 대화를 할 수 있는 봇을 만들 것입니다. 아래 사진과 같이 유저 인터페이스도 바로 만들어줄거에요.

chatbot.png

Part 2에서는 쏘카 팀이 사용한 RAG (Retrieval Augmented Generation) 기술을 사용해서 특정 다큐멘트 (예를 들어 고객 상담 서비스 매뉴얼)에 대해 대화를 나눌 수 있는 챗봇을 만들겠습니다. 마찬가지로 아래 이미지와 같게 유저 인터페이스를 만들어줄거에요.

retrieval.png

백엔드 코드는 Langchain docs를 참고 했고, 프론트엔드 코드는 streamlit docs를 참고했습니다.

만약 전체 코드를 받아보고 싶다면 제 Github에 공개로 올려놨으니 참고해보세요:

VSCode 프로젝트 셋업

가장 먼저 VSCode를 열어서 새로운 폴더를 만들어주고, 안에 가상환경을 만들어주세요. (python3 -m venv venv)

가상 환경을 실행시켰다면 (source venv/bin/activate) 가상 환경 안에서 필요한 패키지들을 다운받아줍니다.

pip3 install langchain openai tiktoken python-dotenv faiss-cpu streamlit

모든 패키지들을 다운받았다면 폴더 내에 .env 파일을 만들고, 그 안에 OPENAI_API_KEY = "sk-...내 openai 비밀번호" 를 저장해주세요.

이 셋업에 대해 더 자세하게 다룬 글은 여기서 확인하거나 영상을 확인해주세요!

백엔드 코드

폴더 내에 chatbot.py라는 파이선 파일을 만들어주고, 다음 코드 블록을 복붙해주세요. 코드에 대한 더 자세한 설명은 인라인에 있습니다. # 주석을 읽어주세요!

# 필요한 모듈들 불러오기 
from langchain.prompts import (
    ChatPromptTemplate,
    MessagesPlaceholder,
    SystemMessagePromptTemplate,
    HumanMessagePromptTemplate,
)
from langchain.chains import LLMChain
from langchain.memory import ConversationBufferMemory
from langchain.chat_models import ChatOpenAI

#.env 파일에 저장돼있는 OPENAI_API_KEY 불러오기
import dotenv
dotenv.load_dotenv()

# LLM 셋업하기 
llm = ChatOpenAI()

# LLM을 위한 커스텀 프롬프트 만들어주기 
prompt = ChatPromptTemplate(
    messages=[
        SystemMessagePromptTemplate.from_template(
            "You are a nice chatbot having a conversation with a human."
        ),
        # `variable_name`에 저장돼있는 건 'memory' 변수 안에 저장된것과 같아야함
        MessagesPlaceholder(variable_name="chat_history"),
        HumanMessagePromptTemplate.from_template("{question}"),
    ]
)

# memory는 대화 기록들을 저장할 수 있게 합니다. 유저가 새로운 질문을 했을때 전에 했던 대화 내용들을 바탕으로
# 대답할 수 있게 하는거에요. 
memory = ConversationBufferMemory(memory_key="chat_history", return_messages=True)
conversation = LLMChain(llm=llm, prompt=prompt, verbose=True, memory=memory)

# LLM을 실행하기 위해 conversation({"question": "hi"})를 돌립니다. 
# 유저의 인풋은 "hi"대신 다른걸로 대체해서 한번 실행해보세요! 
result = conversation({"question": "hi"})
print(result['text'])

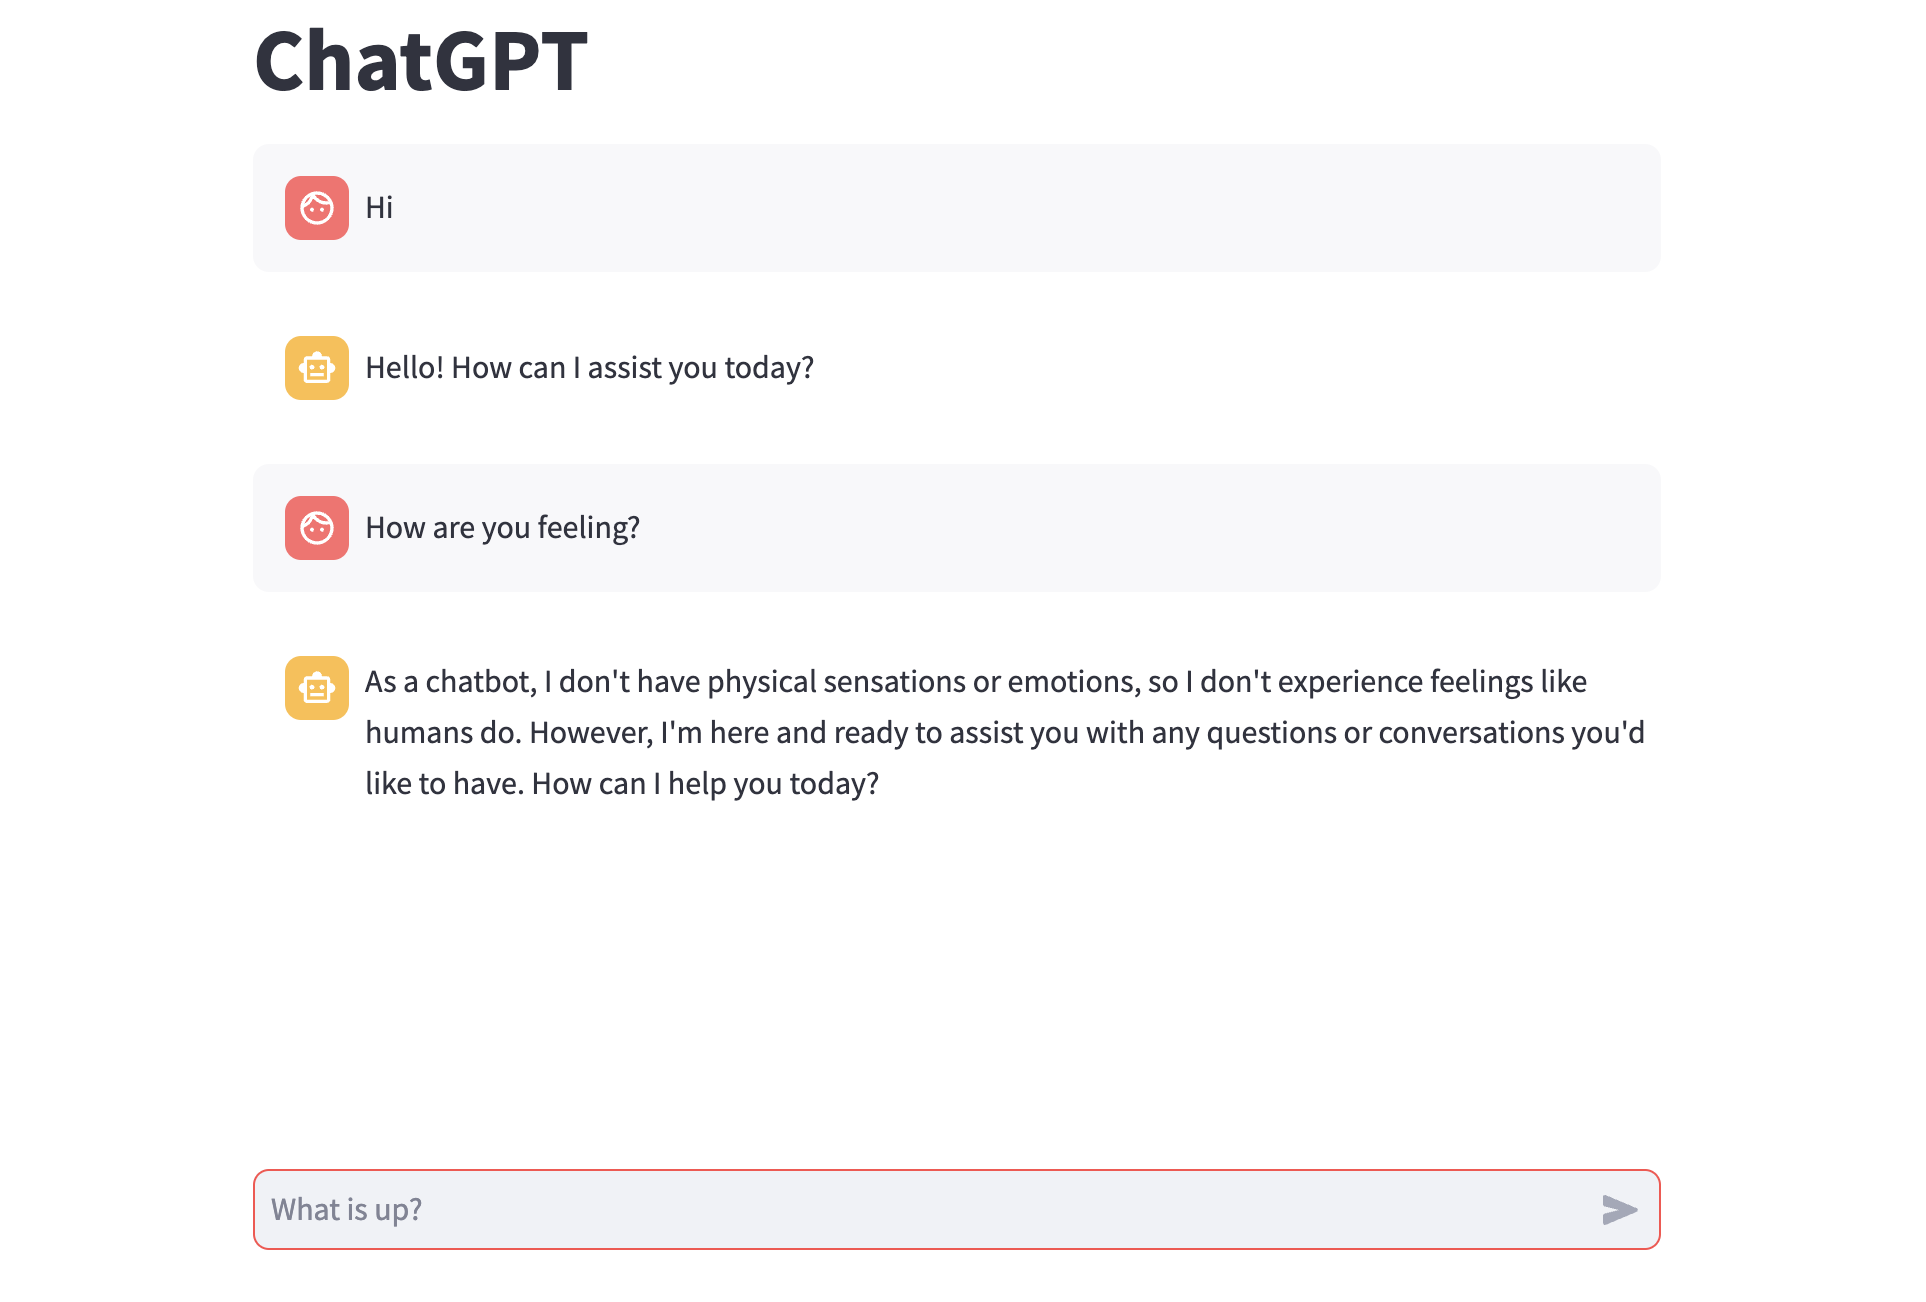
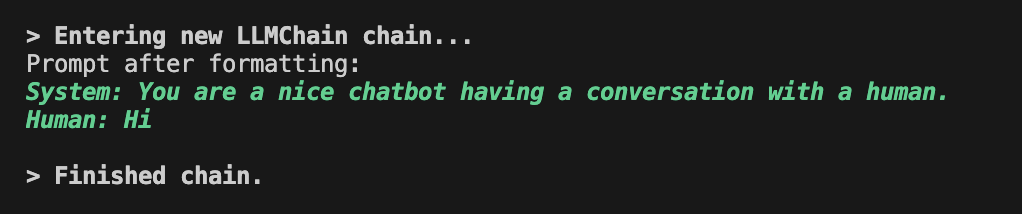
이 블록을 복붙했다면 파일 저장을 하고 터미널에 python3 chatbot.py를 실행하면 다음과 같은 결과값이 나옵니다. 그러고 LLM의 답변도 함께 프린트가 됩니다.

Screenshot 2023-11-01 at 4.41.17 PM.png이로써 백엔드 코드가 완성이 됐어요! 바로 이제 다음 단계인 프론트엔드 인터페이스를 만들어줄게요.
프론트엔드 코드

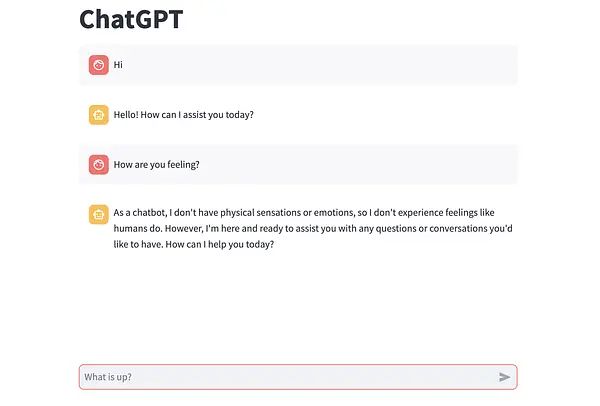
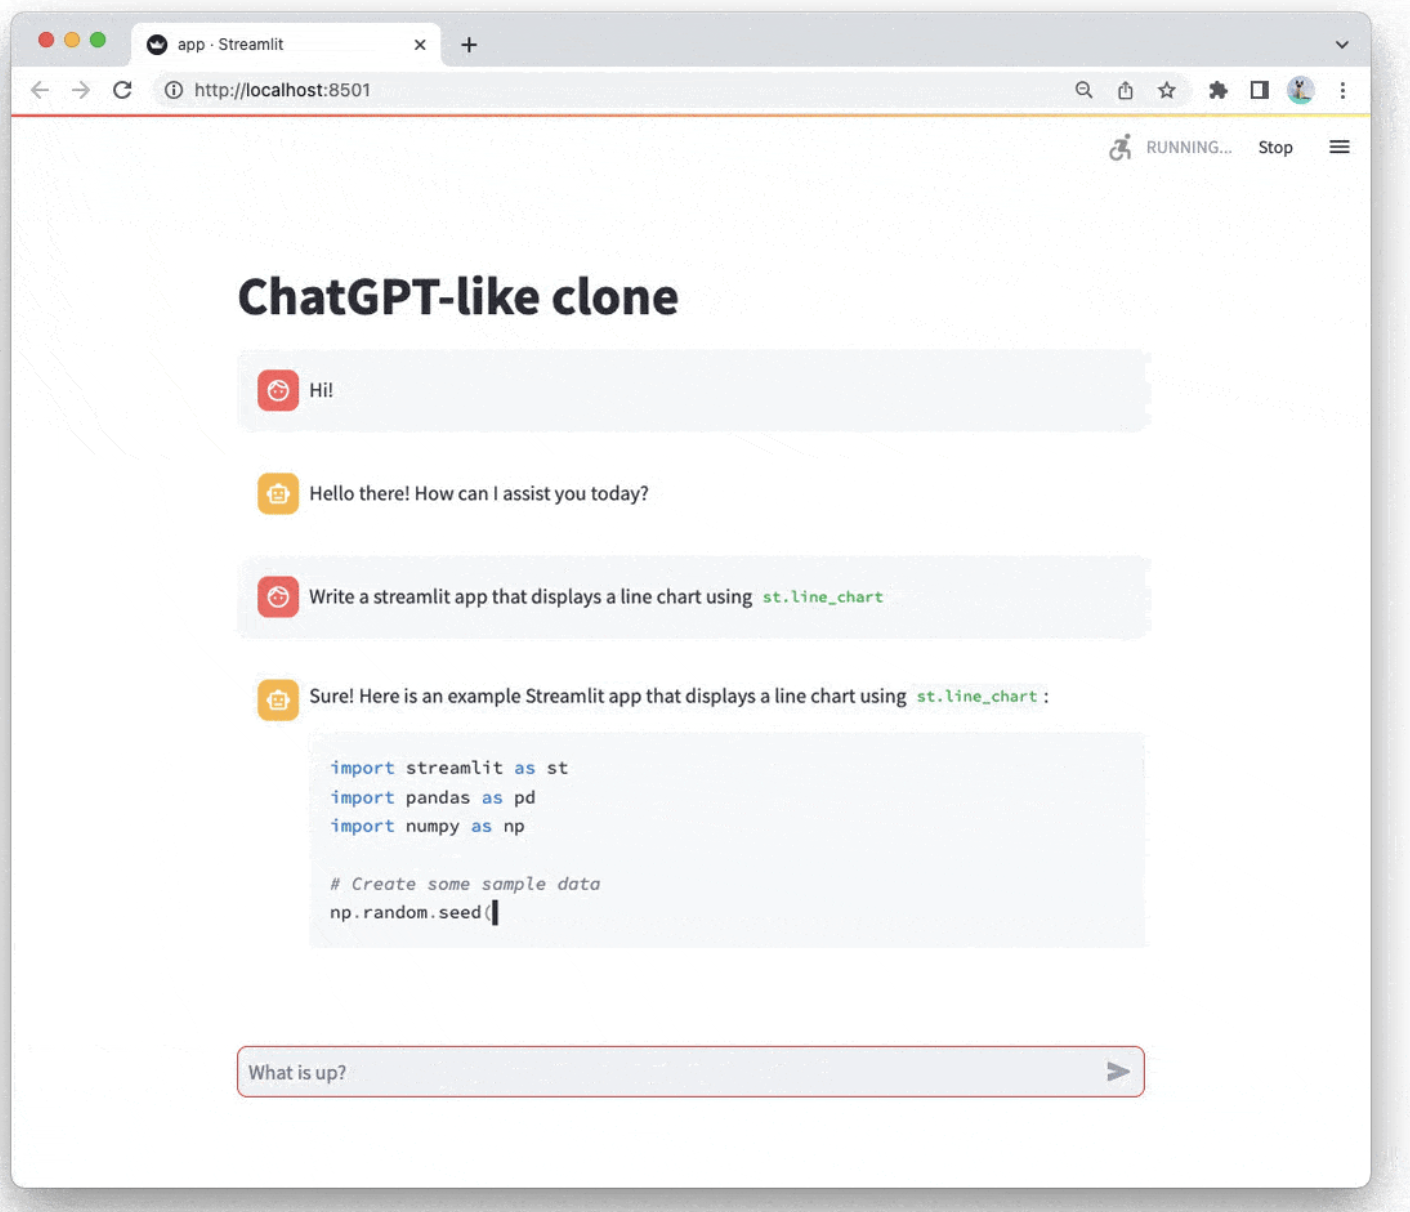
Streamlit docs를 보면 아래 이미지처럼 구현할 수 있는 코드가 마련돼있어요. 저희는 이 코드를 그대로 사용할 예정입니다.

Screenshot 2023-11-01 at 4.42.55 PM.png위에서 만든 백엔드 코드를 프론트엔드 코드와 합쳐줄거에요. 방금 만들었던 코드를 삭제하고 대신 아래 코드 블록을 복붙해주세요.
from langchain.prompts import (
    ChatPromptTemplate,
    MessagesPlaceholder,
    SystemMessagePromptTemplate,
    HumanMessagePromptTemplate,
)
from langchain.chains import LLMChain
from langchain.memory import ConversationBufferMemory
from langchain.chat_models import ChatOpenAI
import streamlit as st
import time

import dotenv
dotenv.load_dotenv()

#웹사이트 메인 헤더
st.title("ChatGPT")

# Set a default model
if "openai_model" not in st.session_state:
    st.session_state["openai_model"] = "gpt-3.5-turbo"

if "messages" not in st.session_state:
    st.session_state.messages = []

for message in st.session_state.messages:
    with st.chat_message(message["role"]):
        st.markdown(message["content"])

# 유저의 인풋이 있으면
if prompt := st.chat_input("What is up?"):
    # 유저가 보낸 내용은 내용 그대로 사람 아이콘과 함께 화면에 출력하기 
    st.session_state.messages.append({"role": "user", "content": prompt})
    with st.chat_message("user"):
        st.markdown(prompt)
    
    # AI가 답변할 내용: 유저 인풋을 LLM에게 보내서 실행시키고, 받은 답변 실시간으로 출력하기 
    with st.chat_message("assistant"):
        message_placeholder = st.empty()
        full_response = ""
        # 여기서부턴 위에서 만든 백엔드 코드가 들어갑니다! 
        # LLM
        llm = ChatOpenAI()

        # Prompt
        custom_prompt = ChatPromptTemplate(
            messages=[
                SystemMessagePromptTemplate.from_template(
                    "You are a nice chatbot having a conversation with a human."
                ),
                MessagesPlaceholder(variable_name="chat_history"),
                HumanMessagePromptTemplate.from_template("{question}"),
            ]
        )

        memory = ConversationBufferMemory(memory_key="chat_history", return_messages=True)
        conversation = LLMChain(llm=llm, prompt=custom_prompt, verbose=True, memory=memory)
        
        # 여기서 {"question": prompt}는 유저의 인풋 프롬프트를 LLM에게 보낸다는 뜻
        result = conversation({"question": prompt})
        # 실시간으로 텍스트가 로딩되는 효과를 보여주기 위해 결과값을 단어 단위로 쪼개주기
        for chunk in result['text'].split():
            full_response += chunk + " "
            time.sleep(0.05)
            message_placeholder.markdown(full_response + "▌")
        message_placeholder.markdown(full_response)
    st.session_state.messages.append({"role": "assistant", "content": full_response})

코드를 자세히 보면 message["role"]에 따라 웹사이트에 보여지는 결과가 달라집니다. 예를 들어 "role": "user"라면 인풋 박스에 저장된 유저의 인풋이 그대로 사람 아이콘과 함께 내용물이 출력됩니다. 반면 "assistant", 즉 AI라면 로봇 아이콘과 함께 유저 인풋을 LLM에게 보내고 나서 받은 결과물을 실시간으로 출력합니다.

코드에 대한 더 자세한 설명은 # 주석을 확인해주세요!

실행하기

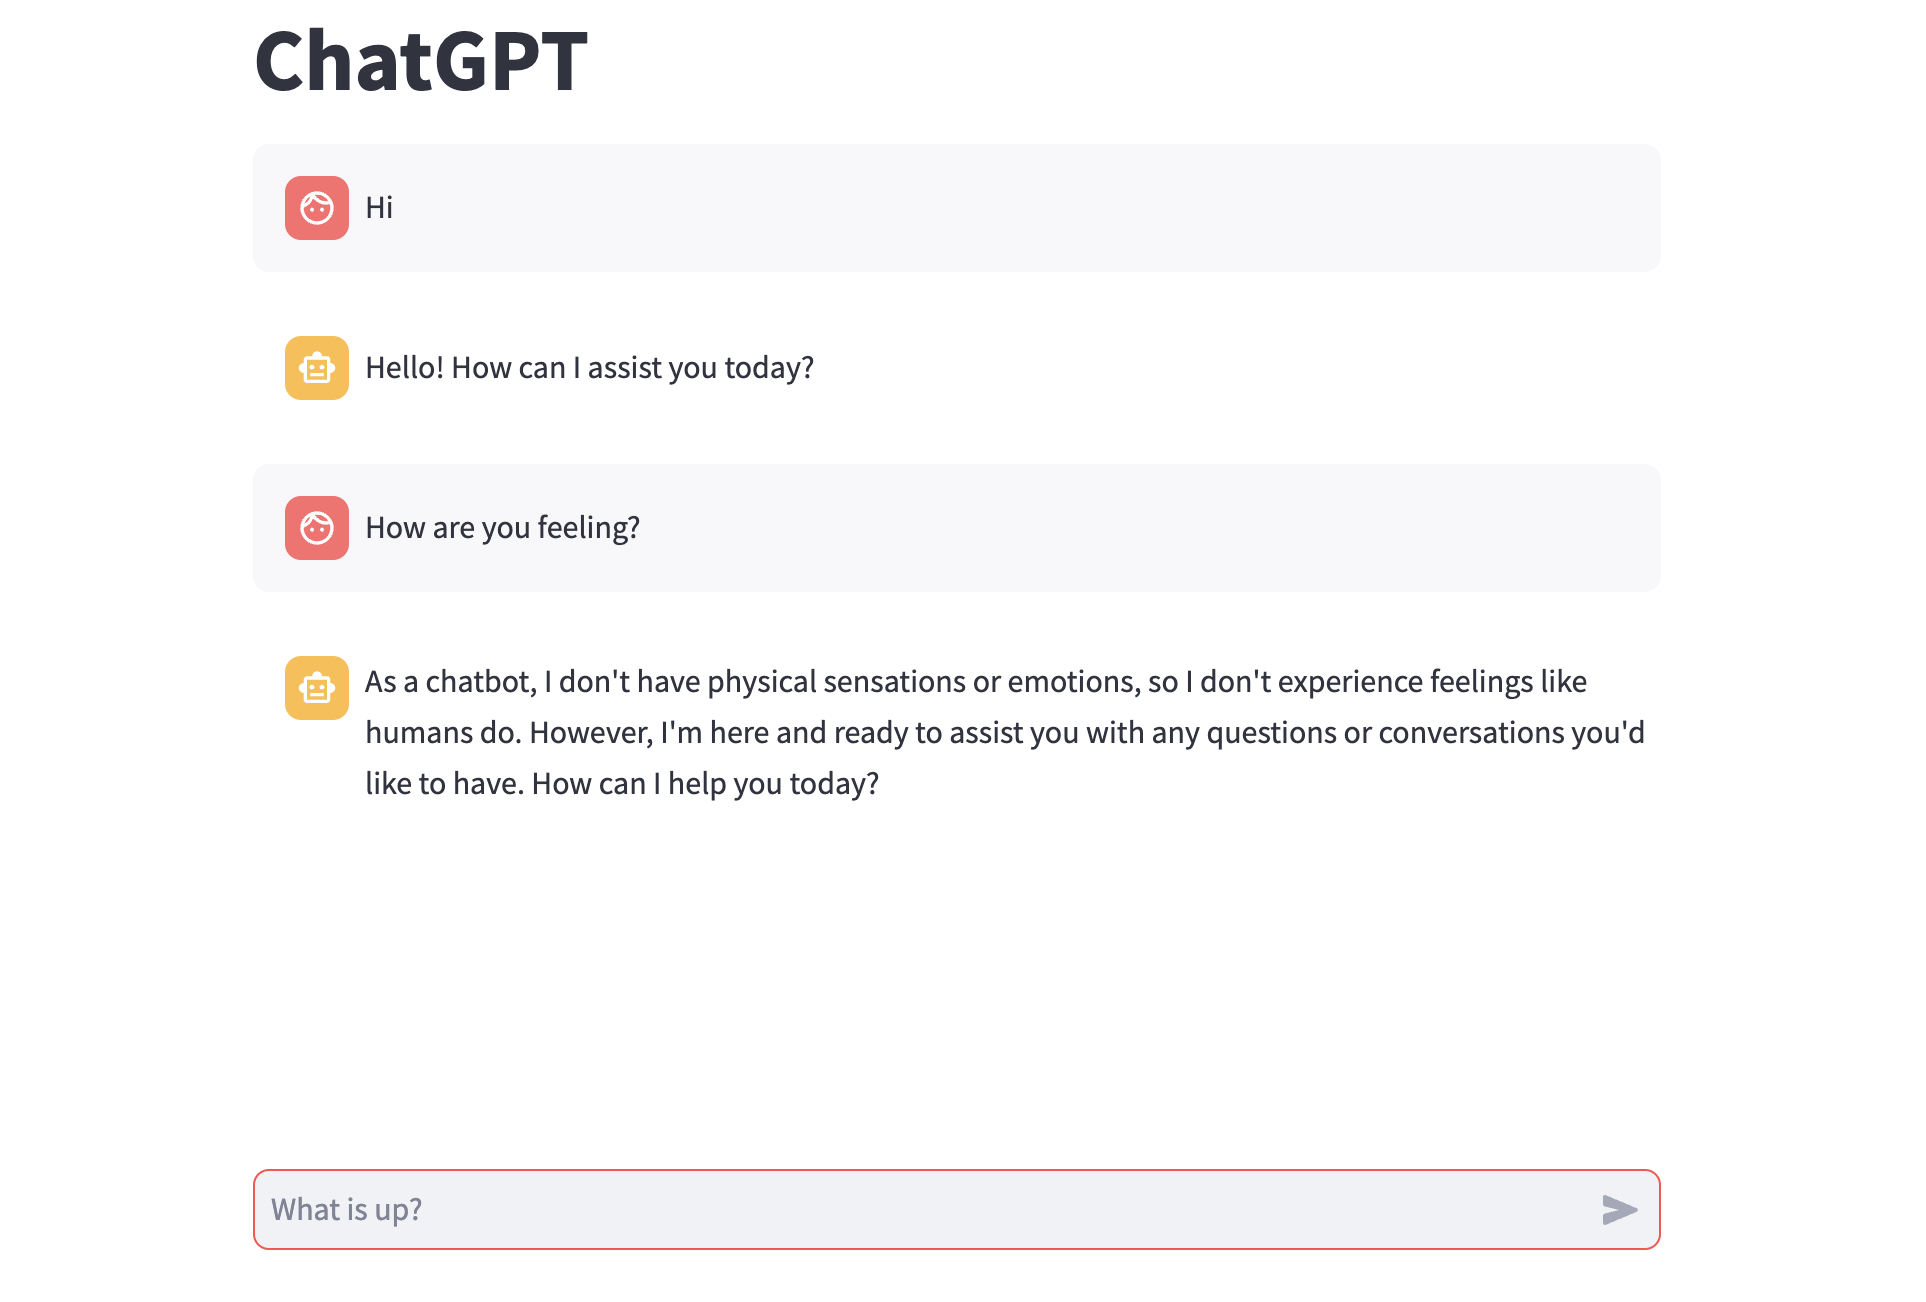
이제 코드가 완료됐어요. 터미널에서 가상환경을 실행시켜줬다면 streamlit run chatbot.py를 돌려주세요.

그럼 새로운 윈도우가 팝업이 되고 내가 만든 LLM으로 대화할 수 있는 챗봇이 만들어집니다.

chatbot.png

마무리

이로써 Part 1이 마무리 됐습니다! 진짜 쉬웠죠? 이제 다음 파트에서는 비슷한 구조의 코드로 RAG를 사용하여 특정 문서에 대해 대화할 수 있는 챗봇을 만들어볼게요.

하면서 어렵거나 잘 안되는 부분이 있으면 댓글 달아주세요! 감사합니다. :)

더 많은 개발 프로젝트들을 해보고 싶으시다면 10X AI University에서 현재 업무 자동화, 캐릭터 AI, 이미지 생성AI 등을 주제로 비슷한 컨텐츠들을 확인하실 수 있습니다!

31
18
Cailyn Yong

Cailyn Yong

Microsoft's "Generative AI Roadshow": 국내 주요 기업들이 생성AI를 쓰는 법 한번에 이해하기

10X ai club (7).png이틀전 마이크로소프트에서 주최한 Generative AI Roadshow가 열렸습니다. 우아한형제들, 원지랩스, 핀다, 효돌, 야놀자, 쏘카, 정육각, 콕스웨이브, 토스, 뤼튼, 뤼이드, 두나무에서 각 연사분들이 오셔서 어떻게 자신의 제품에 생성AI를 쓰고 있는지 공유하셨어요.
되게 좋았던 점은 정말 다양한 업계/분야에서 어떻게 LLM을 사용하는지 알 수 있었고, 단순히 "지금 우리가 생성AI를 이렇게 쓰고 있다"가 아닌 어떤 문제가 있어서 어떻게 해결하고자 접근했는지, 솔루션의 기술 디자인은 어떻게 구성돼있는지 그 과정을 정말 상세하게 알려줘서 놀랐어요. 기본적으로 각 팀이 얼마나 강력한 문제해결 능력을 갖고 있는지 체감할 수 있었습니다.

각 기업별로 바로 내용정리를 하는것보다, 조금 더 큰 주제들로 묶어서 정리하고자 했습니다.

  • 어떻게 문제를 접근하고 어떻게 생성AI로 해결하는지

  • 생성AI를 쓰면서 겪고 있는 기술적 문제점/한계점과 해결책

  • 생성AI의 장단점

어떻게 문제를 접근하고 어떻게 생성AI로 해결하는지

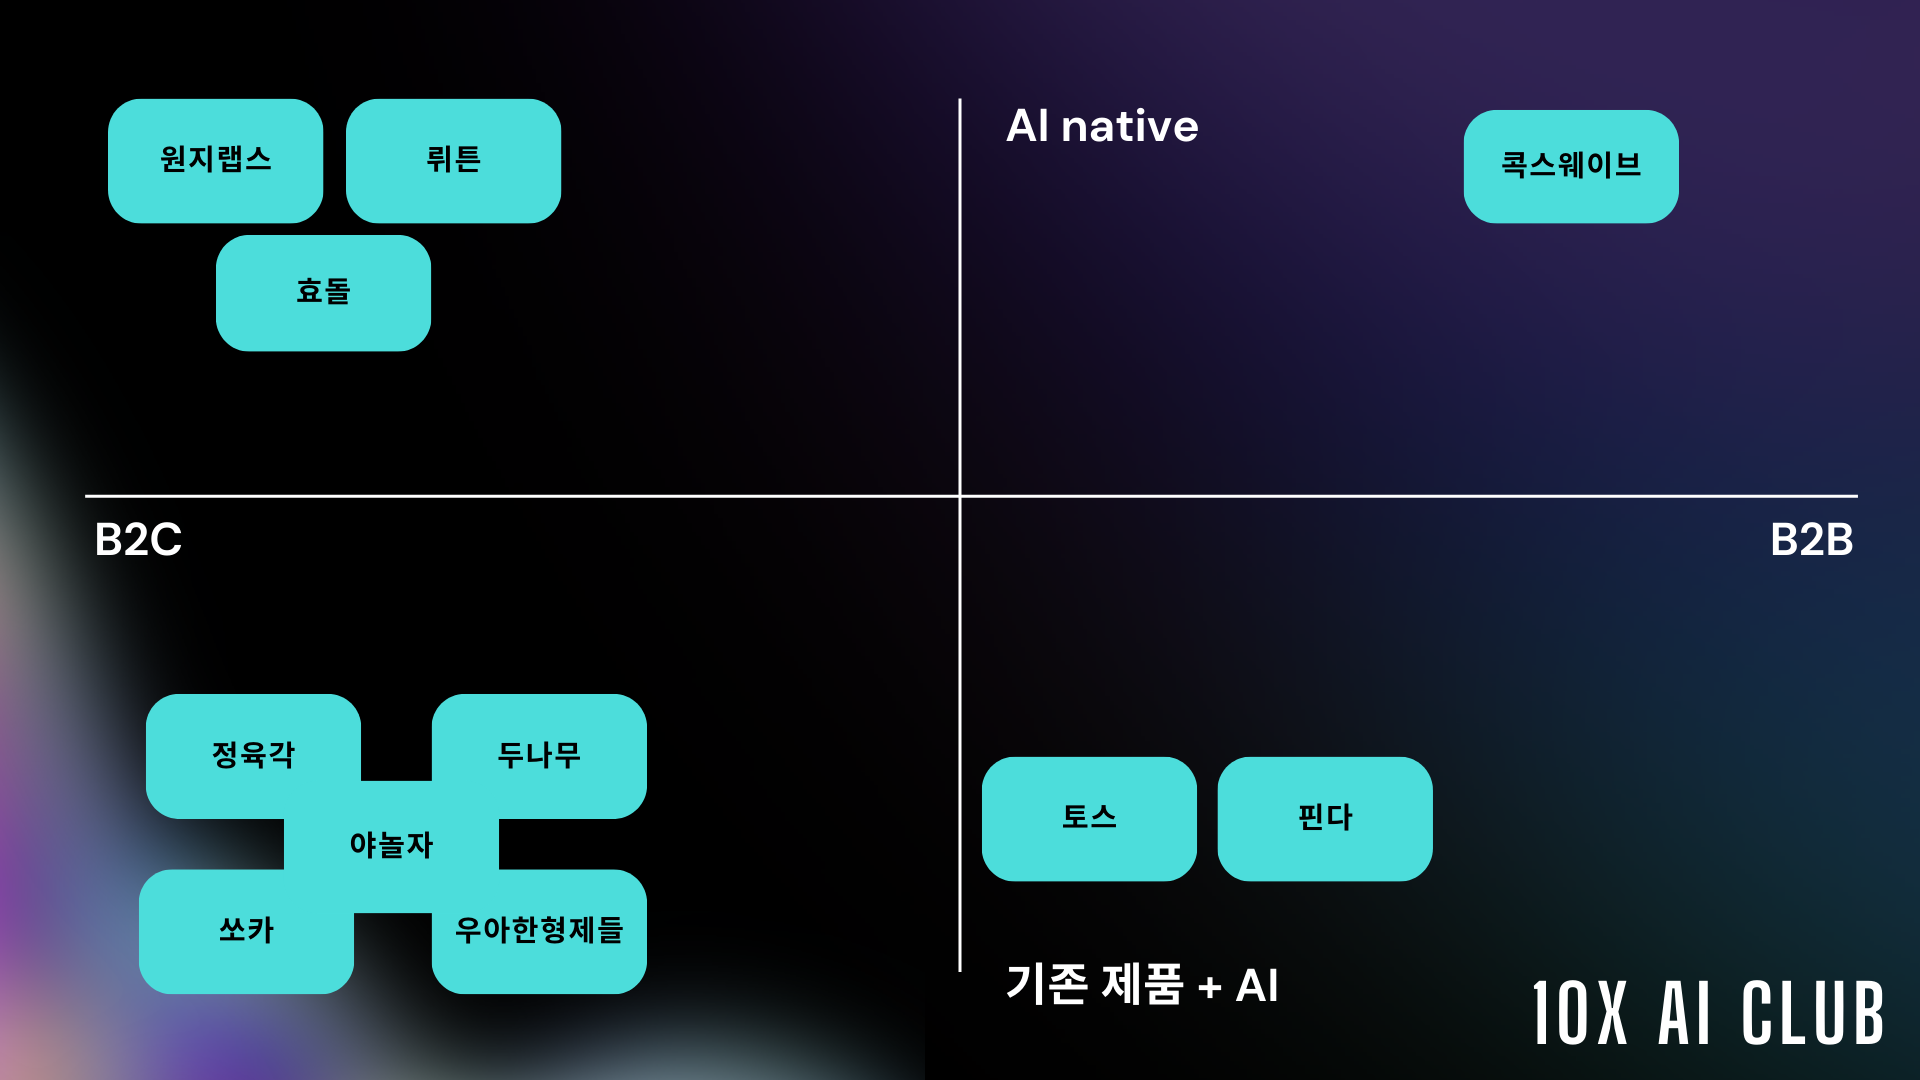
Support t with a brief explanation..png일단 먼저 10+개 회사들의 랜드스케이프를 그려볼게요.

원지랩스, 뤼튼, 효돌은 AI native 제품들과 가깝고 B2C 대상으로 하고 있고, 반대로 콕스웨이브는 impaction.ai를 통해 AI native 제품을 B2B 대상으로 하고 있습니다.

x 축 밑의 회사들을 보면 정육각, 야놀자, 두나무, 쏘카, 우아한형제들은 B2C 대상으로 하고 있는 제품들이고, 원래는 AI native가 아닌 기존의 서비스 위에 AI를 탑재한 형식으로 가고 있습니다. 마지막으로 토스와 핀다는 B2B2C로 마찬가지로 기존 제품에 생성AI를 입히고 있습니다.

공통적으로 이 모든 곳들에서 가장 중요하게 생각했던 질문은 "우리 제품에 정말로 생성AI가 필요한가?"입니다. 우아한형제들 CPO, 이기호님이 패널토크에서 "저희는 새로운 기술을 도입할때마다 항상 돌다리를 엄청 두들기고 나서 도입합니다"라고 말하신게 가장 와닿었어요. B2C 특성상 새로 도입한 기술 때문에 에러가 나서 조금이라도 배달이 늦어지거나 다른 주소지로 배달된다면 고객 경험이 급격하게 떨어지면서 감당해야할 리스크가 너무 커지기 때문입니다. 마찬가지로 쏘가 박재욱 대표님께서도 언급하신건 고객센터에 생성AI를 탑재했는데 차량 사고가 났을때 AI 상담원이 원하지 않는 방향으로 대처를 하게 된다면 정말 큰일이 난다는 것입니다.

이건 B2B도 마찬가지죠. 엔드유저가 받아야하는 정보들이 정말 명확하게 한치의 오차도 없으려면 생성AI를 과연 쓰는게 정답인가 생각해봐야합니다. 이걸 고치지 못하고 해결하지 못한다면 자신의 제품에는 치명적인 버그가 생기는거에요.

이 파트에서 소개시켜드릴 기업들은 단순히 생성AI를 무조건 우리회사에 툴로 써야겠다가 아닌, 실제로 해결해야하는 문제가 명확해서 이걸 해결하고자 했을때 생성AI가 더 나은 해결 방안이 될 수 있을 것 같아 활용한 기업들입니다.

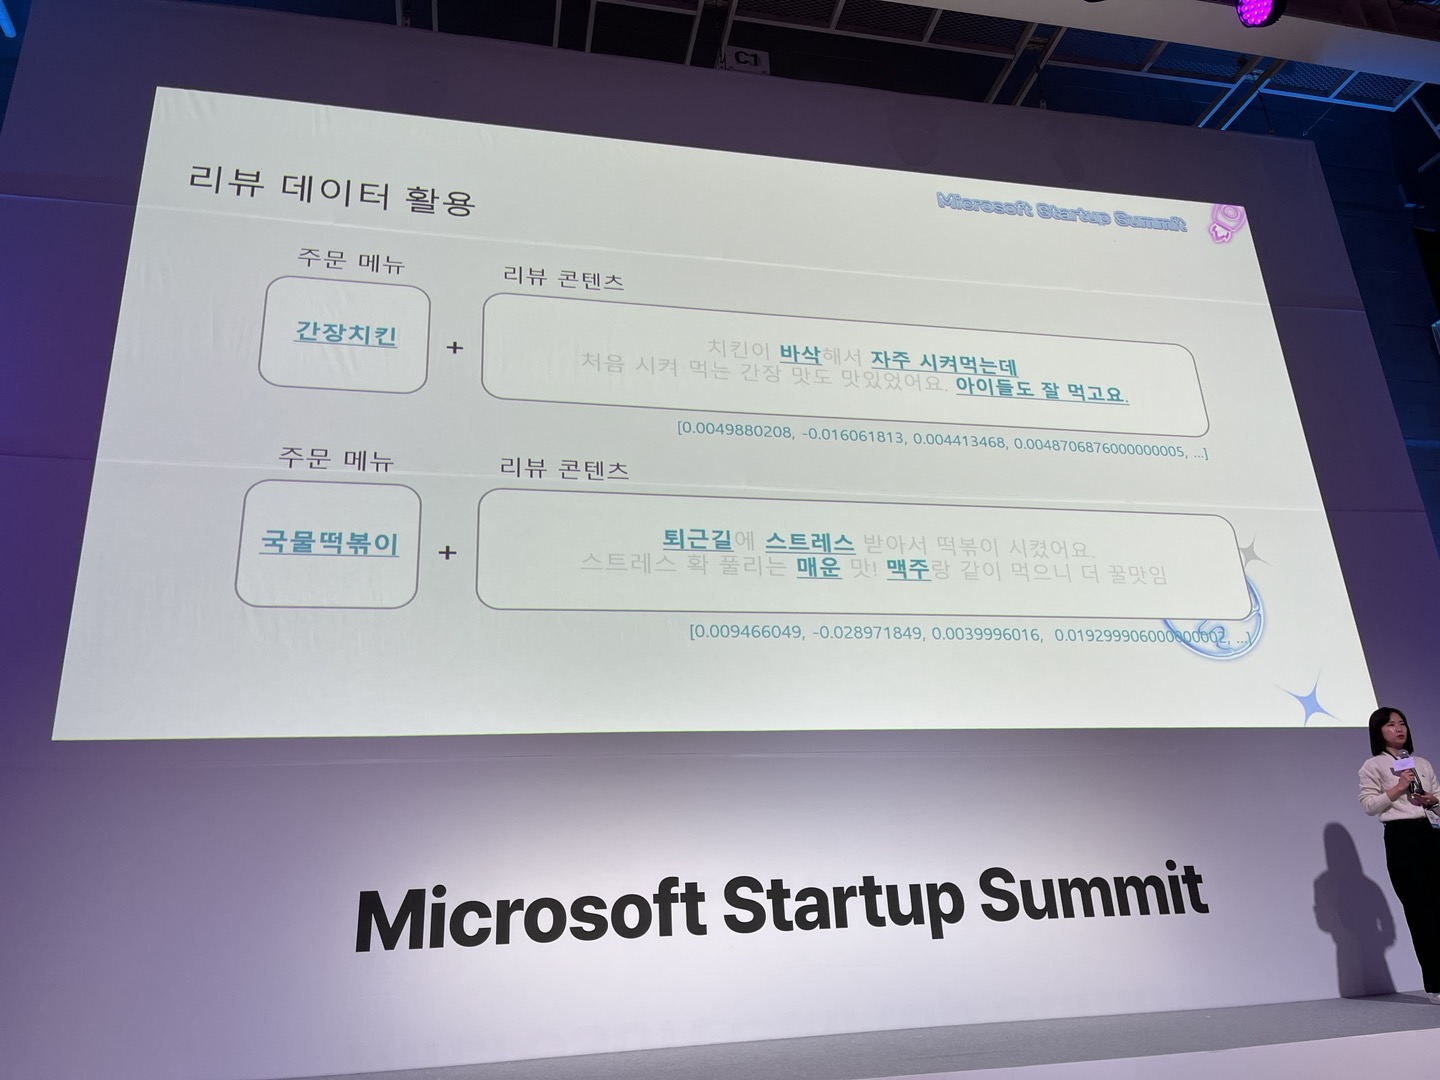
배민: 리뷰 데이터를 학습시킨 검색 추천 시스템

KakaoTalk_Photo_2023-10-27-19-39-34.jpeg

우아한형제들과 같은 경우에는 처음에 실시간 채팅 기능을 생성AI로 도입하려고 했는데, LLM의 할루시네이션이 발생하면 사용자들이 바로 배민 서비스로 받아들일까봐 걱정을 했었고, 배민은 특정 시간에 대량 트래픽이 몰리는데 그걸 GPT가 감당하지 못할 것을 우려해 과감히 포기했습니다.

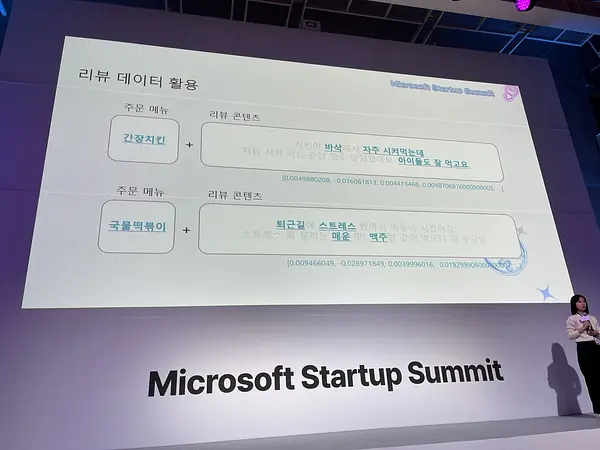
대신 배민은 생성AI가 키워드를 통해 더 빠른 검색을 해줄 수 있는 기능을 만들었어요. 기존의 문제점은 대부분의 사람들이 처음에 배민을 접속했을때 어떤 메뉴를 어디서 사야할지 고르지 않고 들어와서 검색만 하는데 시간이 오래 걸린다는 것이었습니다. 그걸 해결하기 위해서 사람들의 리뷰 데이터를 모은 다음, 각 리뷰에서 식감, 빈도성, 그리고 누구와 함께 먹었는지에 대한 키워드들을 추출해서 생성AI에게 학습시켰습니다. 즉 예를 들어 "가족과 함께, 바삭" 이런식으로 검색하면 간장치킨에 대한 검색 결과값들이 리스트업됩니다.

정육각: GPT를 활용한 리뷰 작성 도우미

정육각은 배민과 비슷하게 리뷰 데이터를 학습시켰지만 조금 다른 문제점을 겪고 있었습니다. 사람들이 고기를 먹고 나서 리뷰를 쓸 생각을 안한다거나 나중에 쓰기 귀찮아져서 리뷰의 퀄리티가 떨어진다는 점이었습니다. 이 문제를 해결하기 위해서 사용자들의 후기와 제품 정보, 리뷰에 있는 키워드를 바탕으로 프롬프트를 생성해서 OpenAI가 리뷰를 대신 작성하게끔 계속 질문을 던지는 파이프라인을 만들었습니다.

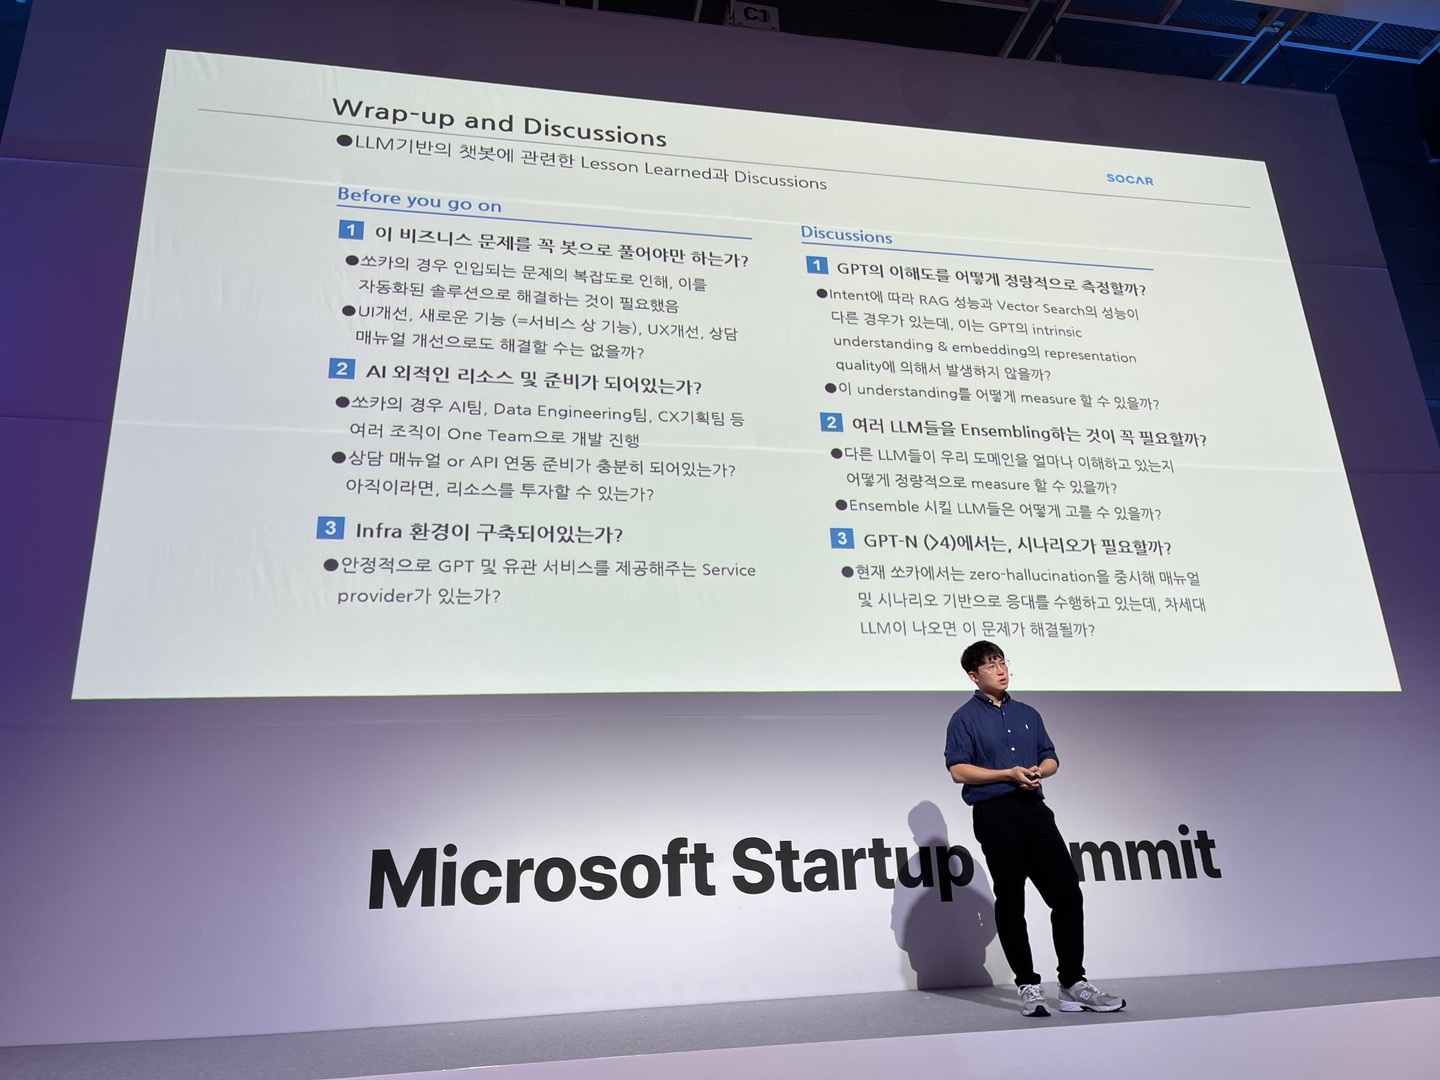
쏘카: 고객센터 생성AI 챗봇

KakaoTalk_Photo_2023-10-28-18-01-02.jpeg(개인적으로 제 최애 발표였어요..진짜 너무 논리정연하게 설명해주심)
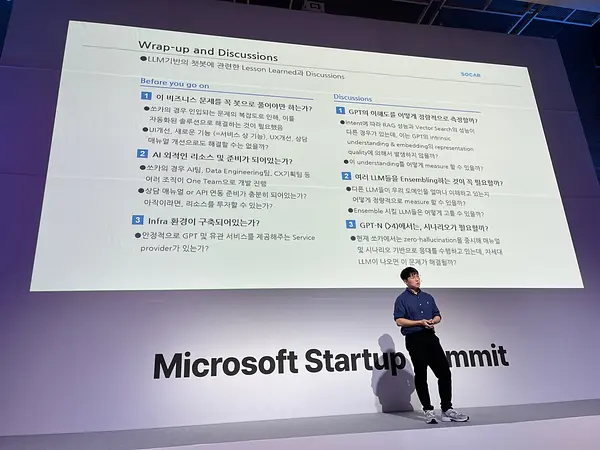
쏘카와 같은 경우에는 고객센터가 365일 24/7 돌아가고 있었고, 쏘카 특성상 상담을 할때 상황 이해에 들어가는 노력이 많이 필요해서 시간 소요가 어마무지하게 들어가고 있었습니다. 쏘카가 커지면서 생긴 문제는 운영비용 증가, 길어지는 문제해결 시간, 늘어나는 고객의 대기시간, 상담 퀄리티의 비일관성였습니다.

해결하기 위해서 1) 제품 퀄리티 높여서 애초에 상담 인입량 감소, 2) 상담 연결에 소요되는 시간 줄이기, 3) 고객 상황을 이해하는데 필요한 시간 줄이기 등이 있었고, 최대한 고객이 스스로 해결하고 특정 영역의 문제만 사람이 응대, 그리고 균일한 상담 매뉴얼을 적용하면서 전화 대신 채팅을 계속 유도하고 있었기 때문에 챗봇 에이전트를 만들고자 했대요.

해결방안을 무려 5가지 경우의 수로 나눠서 판단을 했습니다.

  1. 시나리오 기반 버튼형 봇: 시나리오 개수에 따라 눌러야하는 버튼 너무 많음. 유저 경험 저하.

  2. 시나리오 기반 supervised 봇: 정확하게 인식 못함.

  3. 시나리오 기반 LLM 봇: Zero hallucination 못 피함.

  4. Prompt 기반 LLM 봇: Zero hallucination 못 피함.

  5. Fine-tuned LLM 봇: Zero hallucination 못 피함.

그 중에서 시나리오 기반 LLM 봇을 하기로 하고, 유저의 텍스트 인풋에 따라 상담의 의도를 바로 LLM이 파악하면 RAG, vector search를 같이 사용해서 상담 매뉴얼 DB에서의 검색 결과를 높이고, 할루시네이션이 나오면 미리 후처리해서 LLM이 답하는 것보다 인간 상담원에게 바로 연결을 할 수 있도록 디자인했습니다.

이렇게 우아한형제들, 정육각, 쏘카 예시를 정리했는데, 이 세가지 기업의 공통점은 전부 기존의 프로덕트 위에서 생성AI를 결합했다는 것입니다. 그렇기 때문에 생성AI를 중심으로 만들어진 AI native 제품들과 달리 생성AI에 많이 의존하고 있지 않은 대기업들에서는 어떻게 기존의 제품 문제해결을 이번에 생성AI로 했는지 잠시 엿볼 수 있었습니다.

생성AI를 쓰면서 겪고 있는 기술적 문제점/한계점과 해결책

이 섹션은 많은 기업들에서 공통적으로 언급한 생성AI의 기술적인 문제점과 그에 따른 각 기업만의 해결책을 정리하고자 합니다. 일단 기본적으로 가장 많이 언급됐던 생성AI의 한계점은 할루시네이션과 운영 비용입니다.

다음으로 많이 언급된 기술은 RAG (Retrieval Augmented Generation)이었습니다. RAG는 LLM이 더 정확한 정보들을 내뱉을 수 있게 하는 기술입니다. 예를 들어 LLM에 구글 검색 엔진을 붙여서 실시간 정보들을 불러올 수 있게 하거나, 필요한 정보들이 담겨져 있는 PDF 파일 등을 넣어줘서 내가 원하는 데이터베이스 내에서만 답변을 생성하도록 하는 것입니다.

할루시네이션 문제

각 기업에서 언급한 할루시네이션 문제입니다.

  • 배민: 회사에서 만든 실시간 채팅 기능에서 발생한 할루시네이션이 배민 서비스라고 받아들이면 큰 문제가 됨.

  • 야놀자: LLM이 어떻게 대답할지 예상하지 못하고, 100% 정확한 대답을 내뱉는다는 장담 못함, 항상 원하는 대답을 도출하도록 컨트롤 하지 못함

  • 쏘카: zero hallucination 방지 어려움

  • 두나무: 실시간 증권 정보 검색 서비스의 답변에 대한 신뢰도 부족.

  • 토스: 디자이너가 만든 UI/UX wireframe 초벌코드를 생성AI가 대신 짤 수 있도록 파이프라인 짜려고 함. 실제로 해보니 생성된 코드가 어디로 튈지 몰라서 에러체킹하는데 시간이 더 많이 걸림.

할루시네이션 해결책

  1. 야놀자

    • rule-based filtering으로 해결해줄 수 밖에 없음. "이건 괜찮고 이건 절대 안돼" 이런식으로 최대한 할루시네이션 결과물들을 걸러줘야함.

    • 어떤 프롬프트가 좋은지 evaluation 체크를 해줘야함.

    • 인풋 필터링 (전처리)를 해주고, 아웃풋 필터링 (후처리)도 해주고 있음. 아웃풋이 원하는 결과물이라면 그 결과물들을 계속 학습시키면서 모델을 고도화시키기.

    • Evaluation을 GPT-4를 사용해서 함. 사람보다 싸고 scalable함.

    • 100% 정확한 정보들만 추출하기 위해 RAG 사용

  2. 쏘카

    • 별도의 isolation: LLM에게 모르는 데이터가 들어오면 바로 인간 상담사에게 연결

    • 파인튜닝한 여러 LLM들을 통해 시나리오 기반으로 응대하기 때문에 zero hallucination 달성

    • RAG와 vector search로 응대 로직을 짜서 최대한 정확한 정보들만 추출

  3. 두나무

    • 답변에 대한 신뢰도를 향상시키기 위해 생성AI가 내뱉은 답변에 대한 근거 document 사용자에게 제시. (사용자가 LLM의 오류를 서비스로 그대로 받아들이는 것을 방지하기 위해)

  4. 원지랩스

    • 후처리 Learning GPT 만듦. 방금 나눈 대화를 학습해야하는지 아닌지 판단하고 좋은 데이터만 계속 학습시켜서 모델을 똑똑하게 만들기.

즉 할루시네이션을 해결하고자 대부분은 전처리, 후처리를 통해서 최대한 방지를 하고, 원하는 결과물들이 나왔을때 그것들을 계속 모델에 반복 학습시키면서 고도화하는 작업을 거쳤습니다.

그 외 이번 이벤트를 통해서 개인적으로 신기했던 문제점/해결책은 콕스웨이브에서 현재 만들고 있는 impaction.ai인데요, 콕스웨이브에서 찾은 생성AI 시대의 기회/문제점은 점점 사람들이 웹 어플리케이션를 사용하는 방식이 기존 UX에서의 버튼 클릭이나 드래그와는 다르게 이제 프롬프트, 즉 대화형으로 바뀌었다는 것입니다. 앞으로 AI native 기업들은 사용자들이 내 서비스를 어떻게 쓰는지 알기 위해서는 어느 버튼을 얼마나 많이 클릭했는지가 아닌, 어떤 프롬프트를 몇번 사용해서 원하는 결과물까지 도달했는지 알아야해서 새로운 검색 서비스를 만들고 있다고 하더라구요.

이건 원지랩스에서도 잠깐 언급한, 현재 Azure cognitive search의 한계점이었습니다. 유저가 맨 처음에 프롬프트를 입력하고 그 프롬프트에 필요한 정보를 불러오기 위해 데이터베이스 검색을 할때 검색엔진이 GPT를 위해 만든게 아니여서 이상한 결과를 불러올때가 많다고 했습니다. 원지랩스에서는 이를 해결하기 위해 실제 데이터베이스 검색을 하기 이전에 먼저 거치는 orchestrator 모델, 즉 어떻게 답변을 해야할지 전략을 짜주는 GPT를 만들었습니다.

생성AI 장단점

단점은 위에서와 같이 할루시네이션과 운영비용이 크게 든다는 것이 있지만, 생성AI가 데이터 가공을 할때 많은 업무 향상을 해준다는 장점도 여러번 언급됐습니다.

핀다에서는 특히 기존에 고객 데이터를 관리하고 이해해야 할때 NLP를 사용했었는데, 데이터를 가공하고 키워드를 뽑아내고 하나하나 이해시키는데 많은 시간이 들어간다는 단점이 있었습니다. 높은 난이도의 개발자가 필요한건 물론이고 키워드를 뽑아내고 나서는 모델링, 분석을 해야하는데 매우 어려운 프로세스라고 했습니다.

이를 해결하고자 생성AI를 사용했더니 높은 기술 지식이 필요없어도 고객을 이해할 수 있는 분석 테스트를 퀄리티 높게 뽑아냈습니다. 예를 들어 예전에는 고객 피드백 중 "폭이 더 넓었으면 좋겠다"라는게 들어오면 어떤 "폭"을 말하는지 머신러닝 모델이 알기 어려웠는데, 핀다가 학습시킨 생성AI에게 넣어주면 "더 넓은 폭의 대출상품을 제공해줬으면 좋겠어요" 식으로 이해를 하고 내뱉어준다고 했습니다. 또 다른 예시는 예전에는 감정분류에 대한 키워드가 너무 많아서 리뷰가 긍정인지 부정인지 알기가 매우 어려웠었는데, 이제는 생성AI가 키워드를 바탕으로 문장을 생성해줘서 담당자들이 더 쉽게 데이터를 이해할 수 있다고 했습니다.

토스와 같은 경우에도 기존 서비스에서는 간편 결제, 대출, 카드 발급 등 엄청나게 많은 카테고리가 있고 팀별로 쌓이는 데이터가 달라서 이걸 다 합치고 레이블링하는데 초반에 매우 시간 소요가 많다고 했습니다. 더 빠르게 하려면 더 많은 사람들을 채용했어야 했는데 이젠 생성AI가 훨씬 빠르고 퀄리티 높게 데이터 레이블링을 한다고 하더라구요.

그래서 아직까지 조금은 '치명적인?' 단점이 존재하지만, 이런식으로 비정형화된 데이터를 정형화시키거나 레이블링하는 업무들은 생성AI가 확실한 장점을 갖고 해결해나가는 것 같았습니다.

마무리

이번 이벤트를 통해서 배운 점들입니다.

  • 할루시네이션 문제를 어떻게 각자 해결하고 있는지

  • 기존 대기업/incumbent들은 어떤 문제들을 생성AI로 해결하는지 (고객센터 봇, 검색 추천 서비스 향상, 리뷰 작성 도우미)

  • AI native 제품들은 확실히 다른 비즈니스 모델과 접근 방식을 갖고 있음 (너무 재밌다...)

확실히 아직까진 기술 발전이 더욱 필요하고, 운영 비용들이 빨리 내려가길 바라고 있습니다. 하지만 토스와 핀다를 통해서 잠깐 볼 수 있었던 생성AI의 장점은, 인간이 기존에 했어야 했던 시간이 오래 걸리는 반복적인 업무들을 생성AI가 대신 몇시간 안에 해결하는걸 보면서 앞으로 우리는 좋은 제품 빌딩을 하는데 필요한 "더 중요한" 업무들에 집중할 수 있는 시간들이 점점 생길거라는 것입니다. 그래서 더욱 기대되기도 하네요.

오늘도 긴글 읽어주셔서 감사합니다!

45
7
Cailyn Yong

Cailyn Yong

스타트업 성공 법칙은 존재하는가? 기업가치 $1.4B FiscalNote 대표님에게 배운 것.

어제 감히 제 인생의 turning point라고 불러도 될만큼 너무 역대급 인사이트들을 배워서 공유하고자 합니다. 아직도 머리를 하도 얻어맞아서 뇌가 얼얼한 느낌인데 글을 쓰면서 생각 정리를 해볼게요.

다음 내용들은 FiscalNote의 CEO, Tim Hwang 대표님과 커피챗을 나누며 배운 인사이트들입니다. 이분에 대한 영상은 EO 채널에서 확인하실 수 있어요. (다시 한번 정말 감사합니다..)

스타트업이 무조건 성공하는 법

오바라고 생각할 수 있겠지만 Tim Hwang 대표님에게는 무조건 성공하게끔 만드는 자신만의 formula가 있는 것 같습니다. 여태까지 제가 잘못된 방식으로 창업을 한 것 같아요. 이 방법은 직감보다는 무조건 hard facts, 나에게 제시된 팩트. 데이터들을 바탕으로만 결정을 내리는 것입니다. 즉, 사업을 직감보다는 하나의 학문처럼 대하며 공부하듯이 접근하는 방식입니다.

How to find PMF

어느 사업가든 창업하고자 하는 업계/시장을 정할때 그냥 직감으로 혼자서 가설을 세우면서 '이렇게 될 것 같다'라고 하고 프로덕트를 빌딩하는 분은 없을겁니다. 최소한의 시장조사라도 하고 나서 결정을 하겠죠. 무조건 성공하는 방법은 이 사전 시장조사를 최대한으로 해서 리스크 확률을 최대한 줄이는 것입니다.

  1. 시장 크기와 성장 속도 알아내기: 모을 수 있는 모든 데이터들을 수집하고, 그 업계에 대해서 읽어볼만한 모든 Mckinsey 리포트들을 읽어보는 것입니다. 나보다 똑똑한 사람들이 쓴 교과서들이니, 200장짜리여도 프린트해서 무조건 다 읽고 필요한 업계 현황 정보들을 다 학습하세요. 현재 전세계에서 유행하는 buzzword 분야보다 훨씬 더 많은 분야에 대해 알아갈 수 있고, 시야가 넓어지게 됩니다. 유행에서 벗어난, 남들이 주목하고 있지 않은, 성장 가능성이 어마무지한 다크호스 업계들을 알아내게 됩니다.

  2. 문제 심각성 확인하기: 그런 업계를 찾아냈다면 그 다음에 문제가 얼마나 심각한지 알아야합니다. 관련 업계 사람들에게 다 cold calling, cold emailing해서 내가 해결하고자 하는 문제가 정말 심각한 문제인지 확인하세요. 대표님은 하나의 사업을 시작하기 전에 몇백명씩 만나고, 최소 10명 이상의 사람들이 다 비슷한 문제점을 말한다면 심각한 문제임을 알게 됩니다.

지금 쓰고나서 보니까 너무 당연한 것들인데 이런 가장 기본적인 것들을 초기에 제대로 하지 않으면 나중에 얼마나 스타트업에게 악영향을 끼치게 되는지 깨달은 것 같아요. 이렇게까지 하니까 매번 새로운 비즈니스를 구축할때 최대한 리스크를 낮출 수 있고 무조건 잘될 수 밖에 없는 솔루션을 만들게 되는 것 같습니다.

사업 유지하기

  1. 1년짜리 로드맵보다는 3개월짜리 짧은 로드맵: 항상 고객들을 많이 만나야하고, 고객들이 원하는 제품을 만들려면 빠르게 바꿀 준비가 돼있어야 합니다. 장기적인 로드맵은 애초에 내 계획대로 되지 않습니다.

  2. 문제가 닥쳤을때 그 벽을 뚫을 수 있는 사람들 채용하기: 똑똑하고 일을 잘하는 사람들은 문제가 생겼을때 어떻게서든 해결해나가는 사람들입니다. "It's their job to do that."

  3. B2B 대상 기업이라면 work ethic이 중요해짐: 하루에 최소 10-12시간은 B2B 고객들을 만나야하고, 나머지 시간에(밤에) 프로덕트를 빌딩해야 합니다. Hustle!

Go Global

처음부터 글로벌하게 가야합니다. 그 이유를 한번에 이해시켜드릴게요. 미국의 healthcare 시장이 한국 전체 GDP의 두배입니다. 유니콘이 되고 싶다면 국내에서의 성공 확률보다 글로벌하게 갔을때 그 확률이 훨씬 높아집니다.

그 대신 경쟁사들은 훨씬 치열해집니다. 그래서 시장을 장악하기 위해서는 어떤 업계에서 프로덕트를 빌딩할 것인지가 굉장히 중요해집니다. 예를 들어 마케팅 업무 자동화 AI SaaS 플랫폼은 절대로 시장을 완전히 장악할 수 없습니다. 이걸 만드는 스타트업만 해도 500곳은 넘을거고, 매일매일 비슷한 아이디어의 새로운 스타트업이 탄생합니다. Zero-to-one을 하고 싶다면 내 아이디어를 누구나 베껴서 제칠 수 있는 분야/프로덕트 말고 내가 확실하게 장악할 수 있는 곳을 찾으세요. 굳이 경쟁을 스스로 하려는 이유는?

특히나 AI 스타트업을 빌딩하고 있다면 현재 단계에서는 incumbent들이 훨씬 유리한 위치에 있기 때문에, 기존 대기업들이 자리잡고 있지 않은 업계들, 즉 incumbent들이 월등히 많은 데이터를 갖고 있지 않은 분야를 찾아야 합니다. 그렇기 때문에 e-commerce과 같은 업계들은 더욱 뚫기 어렵고, 오히려 데이터가 파편화돼있는 부동산 시장 등이 유리해집니다.

앞으로 내가 해야할 것

첫번째 단계인 "How to find PMF" 법칙들을 저도 도전해볼 예정입니다.

  • Mckinsey report 당장 뽑아서 읽고 정리한다. 업계 차별 없이 전범위적으로.

  • AI 최신 기술 논문/리포트들 자료수집 & 공부. 현재 AI 기술이 어느 단계에 있는지 확실히 파악하기 위해. 우리가 생각하는만큼 AI가 그만큼 똑똑한가, 어느정도까지 실제로 업무를 자동화하고 대체할 수 있는가 정확하게 알아내기.

  • 모든 업계들 리스트업 한 다음에 각 업계별로 AI를 결합했을때 incumbent들이 더 우위에 있을지, 스타트업이 우위를 차지할 확률이 더 높은지 분석한다.

이 모든 내용을 여러분과도 공유하고 싶은데, 제가 앞으로 정리하고 조사할 내용들을 함께 배우면서 공유받고 싶으시다면 maily에서 구독해주세요!! 감사합니다.

가장 첫번째 Mckinsey Report 인사이트 글들은 다음 자료들을 정리한 것이 될 것입니다:

  • Generative AI and the future of work in America (July 2023): 생성AI와 미국의 노동 시장 변화

  • The economic potential of generative AI: The next productivity frontier (June 2023): 생성AI가 불러올 경제적 임팩트

  • The state of AI in 2022—and a half decade in review (December 2022): 2022년 AI 기술 변화

26
5
Cailyn Yong

Cailyn Yong

생성AI 제품으로 과연 스타트업은 손익분기점을 넘길 수 있을까?

10X ai club (5).png

가장 중요하게 생각해야할 질문이지만 저희가 평소에 쉽게 간과하고 있을 수 있는 AI 업계의 현황에 대해 리서치 글을 작성하고자 합니다.

최근에 눈에 들어온 뉴스 아티클이 있는데, 대략 내용은 이렇습니다. “마이크로소프트, 구글과 같은 대기업들은 현재 생성AI 제품들로 이익을 내고 있지 않아 많은 투자자들의 걱정을 사고 있습니다. Github Copilot는 월 $10 구독료가 있지만 마이크로소프트는 오히려 고객 당 $20를 잃고 있습니다. 그 이유에는 클라우드 비용, GPU 비용, 그리고 GPT-4와 같이 비싼 API에 의존한다는 점이 있죠. 이를 해결하고자 기업들에서는 직접 더 싼 AI 모델을 만들거나, 엔드 유저에게 더 높은 구독료를 요구합니다. [https://archive.md/jMM1k]”

이 뉴스가 왜 저에게 더 심각하게 다가왔는지는 전 글들을 확인하시면 알 수 있습니다. 제가 예전에 앞으로 AI 스타트업은 어떻게 살아남아야하는가에 대해서 몇개의 글을 적은 적이 있는데, 그때 가장 우려했었던 것은 기존의 incumbent들이 (클라우드 SaaS 대기업 ex) Google, Microsoft, Amazon, etc.) AI 스타트업들이 하고 있는 제품들을 보고 자신의 기존 제품에 바로 그 AI workflow를 적용시켜버린다면 게임이 끝난다는 것입니다.

Game Over.

그 이유에는 여러가지가 있지만, 기본적으로 incumbent 기업들이 갖고 있는 네크워크 moat와 이미 PMF를 찾은지 한참 지나서 손익분기점을 넘기고도 계속 매출을 내고 있는 점이 가장 큽니다. 여기서 계속 발생하는 incumbent vs 새로운 스타트업의 경쟁 구도는 처음 보는 것이 아닙니다. 지금 생성AI 기술혁신이 발생하면서 많은 대기업들과 스타트업들이 이쪽으로 shift하고 있는 흐름은 예전에 클라우드가 생기고 나서의 shift와 매우 비슷합니다. 반면 Cloud 혁신 때에는 새로 생긴 SaaS 스타트업들이 incumbent (기존의 기업들)보다 시장 우위를 재빠르게 차지했습니다.

SANGEET PAUL CHOUDARY의 “How to lose at Generative AI!” 글에 의하면 그 이유에는 여러가지가 있습니다.

  1. Incumbent들은 desktop에 다운받아야 하는 앱을 사용하면서 하나의 소프트웨어와 지원 인프라가 단일 고객에게 제공되는 환경을 구축해놨었는데, 제품 전체를 갑자기 browser로 바꿔야하면서 단일 소프트웨어가 여러 고객에게 제공되어야하는 환경을 구축하는데에 엄청 많은 변화를 요구했음

  2. 클라우드로 가기 위해서는 full software stack을 바꿔야 했음

  3. GTM 모델이 완전히 다른 구독제 방식으로 바뀌어야 했음 (더 낮은 CAC, 더 높은 churn을 요구함)

  4. (CFO가 이 모든걸 이해해야 했음)

이와 다르게 처음부터 Cloud를 지원할 수 있도록 빌딩한 SaaS 스타트업들은 훨씬 쉽고 빠르게 시장을 장악할 수 있었습니다. 하지만 이번 생성AI때의 혁신과는 완전 다른 모습을 볼 수 있습니다. Cloud때와 마찬가지로 많은 incumbent들과 스타트업들이 이 기술에 맞는 플랫폼을 구축하려고 하는데, 지금은 incumbent들이 훨씬 우위를 차지하고 있다는거죠. 그 이유는 위와 완전히 다릅니다.

  1. AI 기술들을 전체 코드 architecture가 바뀌지 않아도 API로 쉽게 적용시킬 수 있다는 이점.

  2. 이미 B2B 고객들을 대량 보유하고 있는 incumbent에게는 더더욱 쉽게 API 바로 적용, HuggingFace와 같은 앱을 쉽게 구축/호스팅할 수 있는 플랫폼을 바로 활용할 수 있음

  3. LLM 학습시키는데 필요한 비용, API 비용, GPU 비용 등을 신생 스타트업보다는 감당할 수 있음

즉 다시 요약을 해보자면, 스타트업들은 초기 PMF를 찾기 위해 무한 실험 사이클을 돌리면서 API 비용과 GPU 비용이 어마무지하게 나오지만, incumbent들은 이미 갖고 있는 고객 베이스 위에 자신의 제품에 알맞는 AI workflow 모델을 적용시키기만 하면 훨씬 빠르고 저렴하게 매출을 올릴 수 있다는 것입니다.

How to win

그렇기 때문에 스타트업이 승산을 조금이라도 더 볼 수 있는 방법은 incumbent들이 이미 자리잡고 있는 기존의 프로덕트 위에 AI 툴을 합치는 방향이 아닌, 1) 자신이 파인튜닝한 AI 모델을 API/제품으로 제공하는 방향으로 가거나 2) AI와 workflow를 혼합시키는 방향으로 제품을 만들어야한다고 생각합니다.

  1. 자신이 파인튜닝한 AI 모델 API/제품으로 제공

이 경우에는 수평적으로 가거나 수직적으로 가는 방법이 있습니다. 수평적으로 가는 것은 특정 AI 모달리티(기능)에 포커스를 맞춰 제품을 전범위의 고객에게 제공한다는 것이고, 수직적으로 가는 것은 컨텍스트에 맞게 정말 필요한 타켓 고객에게만 제공한다는 것입니다.

예를 들어 미드저니나 스테이블디퓨전과 같은 이미지 생성AI 모델들은 특정 분야의 그룹을 위한 것이 아니라 이미지 생성을 하고 싶은 누구나 자신의 모델을 base layer로 사용하게끔 합니다. 뤼튼과 같은 경우에도 텍스트 생성 모달리티를 기반으로 수평적 제품을 제공하고 있습니다. 혹은 ‘이루다’ 캐릭터 AI 챗봇과 같은 것도 특정 성격과 말투를 생성하기 위해 파인튜닝한 모델 위에 빌딩해서 다양한 곳에 use case로 활용하는 수평적 제품이죠. 반대로 예를 들어 AI 모델을 여행 데이터에 파인튜닝해서 여행 계획 일정표를 유저의 prompt에 맞게 생성해주는 제품은 특정 고객만을 위한 수직적 제품입니다.

두가지 경우에 각각 장단점이 있는 것 같습니다. 수평적으로 가는 것의 장점은 다른 회사들과 다양하게 파트너십을 맺을 수 있고, 더 많은 개발자들이 자신의 AI 모델을 테스트해보고 빌딩하면서 여러 스타트업들이 자신의 제품을 base layer로 쓸 수 있습니다. (community growth, marketing growth effect)

반면 단점은 처음에 특정 유저/고객에게 집중해서 만드는 제품이 아니기 때문에 첫 고객을 유치하는데에 꽤 많은 시간과 유지/실험 비용이 들 수 있습니다. 즉 모두를 위한 제품이 될 수 있지만 동시에 모두에게 그저그런, 쓸 이유가 명확하지 않은 제품이 될수도 있습니다. 한번에 너무 많은 것을 제공하려고 하다보면 포커스를 놓치기 마련이죠. 그래도 특정 AI 모달리티에만 집중을 한다면 지금 단계에서는 꽤 괜찮을 거라는 생각이 듭니다.

수직적으로 가는 것의 장점은 당연히 특정 use case에게 집중을 하는 것이니까 수평적 방향 보다는 훨씬 빨리 PMF를 뚫는 다는 것입니다. 반면 제품을 제공하게되는 시장 사이즈가 그만큼 작다는 것이 최대 단점일수도 있습니다.

  1. AI와 workflow 혼합시키기

이 방향은 제가 전의 글에서 언급한 AI native 제품들을 뜻합니다. AI 기술의 혁신으로 앞으로 10년간 우리가 예상하지도 못할 새로운 패러다임의 비즈니스 모델들과 AI에 맞춘 제품들이 나오게 될 것입니다. 여기서 스타트업들이 우위를 차지하려면 몇가지 점들을 계속 생각하고 있어야 할 것입니다.

  • incumbent들이 이미 들어가있지 않은 분야/use case에서 수직적 AI 제품 제공

  • incumbent들이 만든 B2B SaaS workflow들을 AI copilot workflow로 다 통합해버리는 제품. 예를 들어 slack+tally+gmail+discord 이런 툴들을 AI가 한번에 업무 자동화해줄 수 있는 제품 (Zapier가 하고 있지만, 아직 기회는 훨씬 더 많이 열려있다고 봅니다.)

  • AI native 제품 (AI 기술을 활용한, AI에 의존할 수 밖에 없는 창의적이고 혁신적인 제품. 여태까지 우리가 보지 못한 형태의 비즈니스 모델과 서비스)

  1. 추가로 마지막 방향은 처음에 AI 제품을 무료로 출시해서 유저들을 모은 다음, 네트워크를 키워서 점차 가격을 매기는 것. 장점은 PMF를 빨리 찾을 수 있는 것과 커뮤니티를 키운다는 것이지만 단점은 유저들이 왜 pay해야하는지 공감을 하지 못하면 빠른 속도로 제품에서 이탈하게 됩니다.

결론은 스타트업을 빌딩하고 있다면 incumbent가 갑자기 들어와서 이 툴을 자신의 기존 서비스에 장착했을 때 완전히 몰락할 가능성이 없도록 계속 염두에 두면서 빌딩해야 한다는 것입니다.

애초에 손익분기점을 넘길 수 있나요?

AI 스타트업을 하면서 가장 많이 고민하는 점은 제품의 가격을 어떻게 측정해야되는지에 대한 것입니다. 저도 처음에 측정할때 별걸 다 고려하면서 계산했는데,

  • 만약 내가 OpenAI API 크레딧을 쓴다면 내가 한번 텍스트를 생성할때마다 몇개의 토큰을 쓰면서 총 얼마의 크레딧이 차감되는지 계산함

  • 특정 함수나 LLM을 사용하면 더 비싸다는 것도 고려해야 함

  • 몇명의 유저가 내가 지정한 가격에 제품을 사용하면 손익분기점을 넘길 수 있을지 고민

여기서 추가로 생각해야 하는 것은

  • 한명의 유저가 얼마나 많이 API 콜을 할지 모른다는 것. 즉 한명의 유저가 내가 예상한 것보다 훨씬 많이 사용해서 뜻밖의 API 크레딧 무한 차감 현상을 경험할 수도 있음.

  • 할루시네이션 결과값들도 결국 비용 나간다는 것

그리고 가장 중요한 것은

  • 애초에 목표 시장이 작거나, AI 기술을 적용하기에 개방적이지 않은 시장이라면 더더욱 뚫기 어려움

  • 특히나 전문성을 요구하는 일은 사람들이 AI에 반감을 보이거나 의심을 함

손익분기점을 넘기고자 엔드 유저에게 높은 가격을 부르게 되면 이익은 발생하겠지만 장기적으로 봤을때에는 유저 경험이 떨어져서 제품의 retention이 급격히 떨어지게 됩니다. 하지만 그렇지 않으면 스타트업 입장에서는 투자 라운드를 돌아야하고, 안 그러면 계속 출혈을 하게 됩니다. 현재 Microsoft, Google, Amazon과 같은 incumbent들도 이런 악순환 굴레를 겪고 있다는 것을 보면 아직은 갈길이 먼 것 같습니다. 앞으로 더더욱 API 비용과 GPU 비용을 낮출 수 있는 기술 발전이 필요합니다. AI가 현재 buzzword여서 내년에는 투자 라운드도 줄어들고 식을 거라는 말이 많이 나오지만, 그렇다기엔 AI 기술이 Chat GPT로 인해 한번 세상에게 어떤 것을 할 수 있는지 보여줬고, 그런 기술이 받춰주는 이상 죽지 않을거라 믿습니다. 그저 keep going하면 될 것 같습니다.

48
18
Cailyn Yong

Cailyn Yong

짧스콰이엇 AI 뉴스레터

[오늘 읽은 뉴스레터]

  • ElevenLabs에서 자신의 목소리 혹은 다른 사람의 목소리로 29개국 언어로 통역과 더빙을 할 수 있게 새로운 버젼을 출시했습니다. https://elevenlabs.io/dubbing

  • Moonhub AI는 세상 첫 AI 채용 자동화 에이전트입니다. 챗GPT에게 프롬프트를 치듯이 “Bay Area에 있는 아이비리그 candidates 좀 찾아줘”하면 바로 채용할만한 분들을 리스트업 해줍니다. 현재 100명 이상의 B2B 기업들과 함께 하고 있고 그 중에는 Anthropic도 고객사에 있습니다. 5분 안에 자신이 원하는 캔디더트 찾기: https://www.moonhub.ai/

    • 번외로 10X AI University 2주차 강의에서 채용 지원 자동화 에이전트를 직접 만들 수 있게 알려드리고 있습니다. 채용 공고들을 AI로 리스트업한 다음, 자신의 이력서와 비교해서 왜 내가 이 채용 공고에 적절한 캔디더트인지 설명하는 이메일까지 작성하는 것을 자동화 시켜주고 있습니다.

  • Character.ai에서 그룹챗 기능을 출시했습니다: https://beta.character.ai/

  • YC 지원을 준비하고 있는 분들이 계신다면 자기 팀의 지원서를 AI로 컨설팅 받아보세요: https://www.knowsilos.com/

  • OpenAI는 작년의 $28M 연매출에 비해 현재 연매출 $1.3B를 찍고 있습니다. 이는 AI 업계 내에서도 어마무지한 성장 속도입니다. Anthropic은 OpenAI의 연매출의 1%도 안되는 $100M을 내고 있습니다. https://readwrite.com/openais-financial-ascent-from-28-million-to-1-3-billion-in-yearly-revenue/

  • LLM을 만들때 가장 기본적인 기술인 transformers를 이제 자연어뿐만 아니라 프로그래밍 언어들도 알아들을 수 있도록 활용하고 있습니다. https://arxiv.org/abs/2310.08232v1

그 외 도움될만한 AI 업계 현황 리포트 자료 공유해드립니다 [State of AI Report 2023]: https://www.stateof.ai/

10X AI University

누구나 따라할 수 있는 AI 활용 사례들

10
1
Cailyn Yong

Cailyn Yong

새로운 학문을 배우는데엔 딱 100시간만 투자하면 됩니다 (10X AI University 런칭)

10X AI Club 참여 이유

8월 말에 10X AI Club을 처음 설립한 후 지금까지 133명의 분들이 클럽에 조인해주셨고, 카카오톡 오픈채팅방에도 40명의 멤버분들이 참여해주시고 있습니다.

그동안 꾸준히 각 한명한명이 어떤 이유로 클럽에 참여하셨는지, 무엇을 가장 배우고 싶은지 노션에 정리하고 있었는데요, 참가 신청 이유에는 여러가지가 있었습니다.

  1. 자신이 기존에 빌딩하고 있는 제품에 AI를 활용하고 싶은 분들 (사업/제품개발 목적)

    • 헬스케어, 병원 (Medical AI) (생각보다 많음)

    • 패션 (AR/VR) (생각보다 많음)

    • 업무 생산성/자동화 SaaS 툴 (가장 많음)

    • 데이터 추천/탐색형 툴 (두번째로 가장 많음)

  2. AI 프로덕트를 빌딩하고 있는 분들 (AI 관련 정보 얻기 목적)

    • 이미지 생성을 활용한 광고/마케팅 컨텐츠 제작

    • ChatGPT를 활용한 대화형 서비스

    • RPG 게임

    • 생성AI 세일즈 챗봇

    • LLM 활용한 자동화 서비스

  3. 개발 능력은 없지만 어떻게 만드는지 배우고 싶은 분들 / 인사이트 얻고 싶은 분들 (배움 목적)

  4. AI 커뮤니티에 조인해서 네트워킹하고 싶은 분들 (커뮤니티 욕구)

이를 토대로 제가 어떻게 하면 가장 많은 도움을 효과적으로 줄 수 있을지 고민을 했습니다.

2번은 현재 제가 10X AI Club(https://disquiet.io/club/10xAIclub)에 올리는 인사이트 글들과 카카오톡 오픈채팅방에서 매주 공유드리는 "이번주 읽은 글들"을 올리면서 도움을 드리고 있습니다.

KakaoTalk_Photo_2023-10-16-17-12-43 001.jpeg

10X AI University 런칭 이유

하지만 2번을 위해 제가 하는 것들으로만은 나머지 1번, 3번, 4번이 해소되고 있지 않다는 느낌을 받았습니다.

그래서 1번, 3번을 도와드리기 위해 10X AI University라는 것을 9월 18일에 하기로 결정하고, 9월 27일에 첫 런칭 얼리버드 홍보를 했었습니다. https://dis.qa/bQCLPw

많은 분들은 직접 자신의 제품에 AI를 활용하고 싶은 욕구가 뚜렷했고, 직접 배우고 싶은 욕구도 강했습니다. 하지만 어디서부터 어떻게 시작해야할지 감이 안잡힌 상태에서 AI를 접목시키는 것이란 매우 어려운 일이겠다라는 생각이 들었습니다.

저도 처음에 블록체인 업계를 들어가고자 했을때 딱 그 심정이었어요. 컴퓨터공학과를 나오긴 했지만, 학교에서는 블록체인에 대해서 전혀 가르치지 않았고, 주변 사람들도 하는 사람들이 없어서 정말 막막했습니다. 운이 좋게도 제 지인이 블록체인 연구를 하는 분을 소개시켜줘서 어떤 리소스들을 봐야하는지, 무엇을 공부하면 좋은지 추천해줘서 그것부터 그냥 냅다 읽기 시작했습니다.

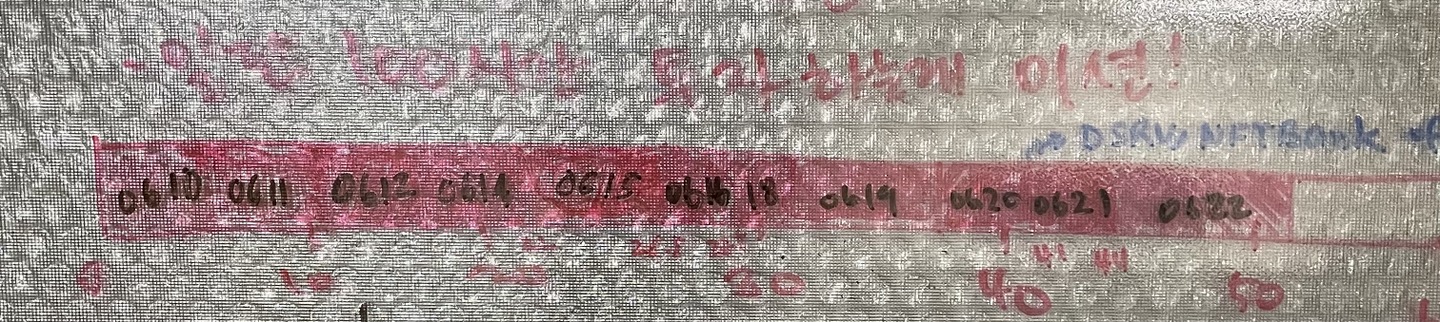
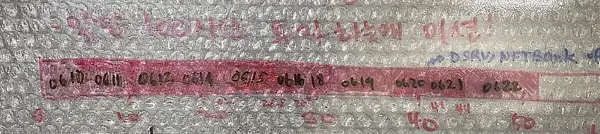
가장 와닿았던 말은 "어떤 분야여도 100시간만 투자하면 뭐든 배울 수 있다"였는데, 그날 이후로 저는 제 방 벽에다가 100시간짜리 바를 만들고 하루에 몇시간씩 투자할때마다 색칠해나갔어요.

KakaoTalk_Photo_2023-10-16-17-25-49.jpeg어떻게 블록체인 공부를 했는지에 대한 글은 여기있습니다: https://brunch.co.kr/@hyerimyong/16

블록체인 공부에 70시간을 투자했을때쯤 저는 작년 서울에서 열린 Korea Blockchain Week에서 많은 블록체인 파운더분들과 대화가 가능하게 됐고, 한 스타트업에서 잡오퍼를 받게 되어 일을 하기 시작했어요.

이와 마찬가지로 여러분도 인공지능에 100시간만 투자하면 정말 그냥 뭐든 할 수 있습니다.

AI 프로젝트 개발, 자신의 제품에 AI 생산성 툴을 만들어서 접목시키는거, 어떤 AI 리서치/논문/뉴스 글을 읽어도 이해가 되는거.. 다 가능해요.

저는 블록체인 공부를 처음 시작할때 저한테 추천 리소스들이랑 도움을 줬던 분들에게 너무 감사합니다. 아마 그분들 아니였으면 어디서부터 시작해야할지 허우적거리다가 동기부여가 떨어졌을 것 같아요. 그 뒤로 AI를 처음 배울때에는 저는 어느정도 새로운 학문을 어떻게 효율적으로 배워야하는지에 대한 노하우가 생겨서 좀 더 쉽게 배우고 응용할 수 있었던 것 같아요.

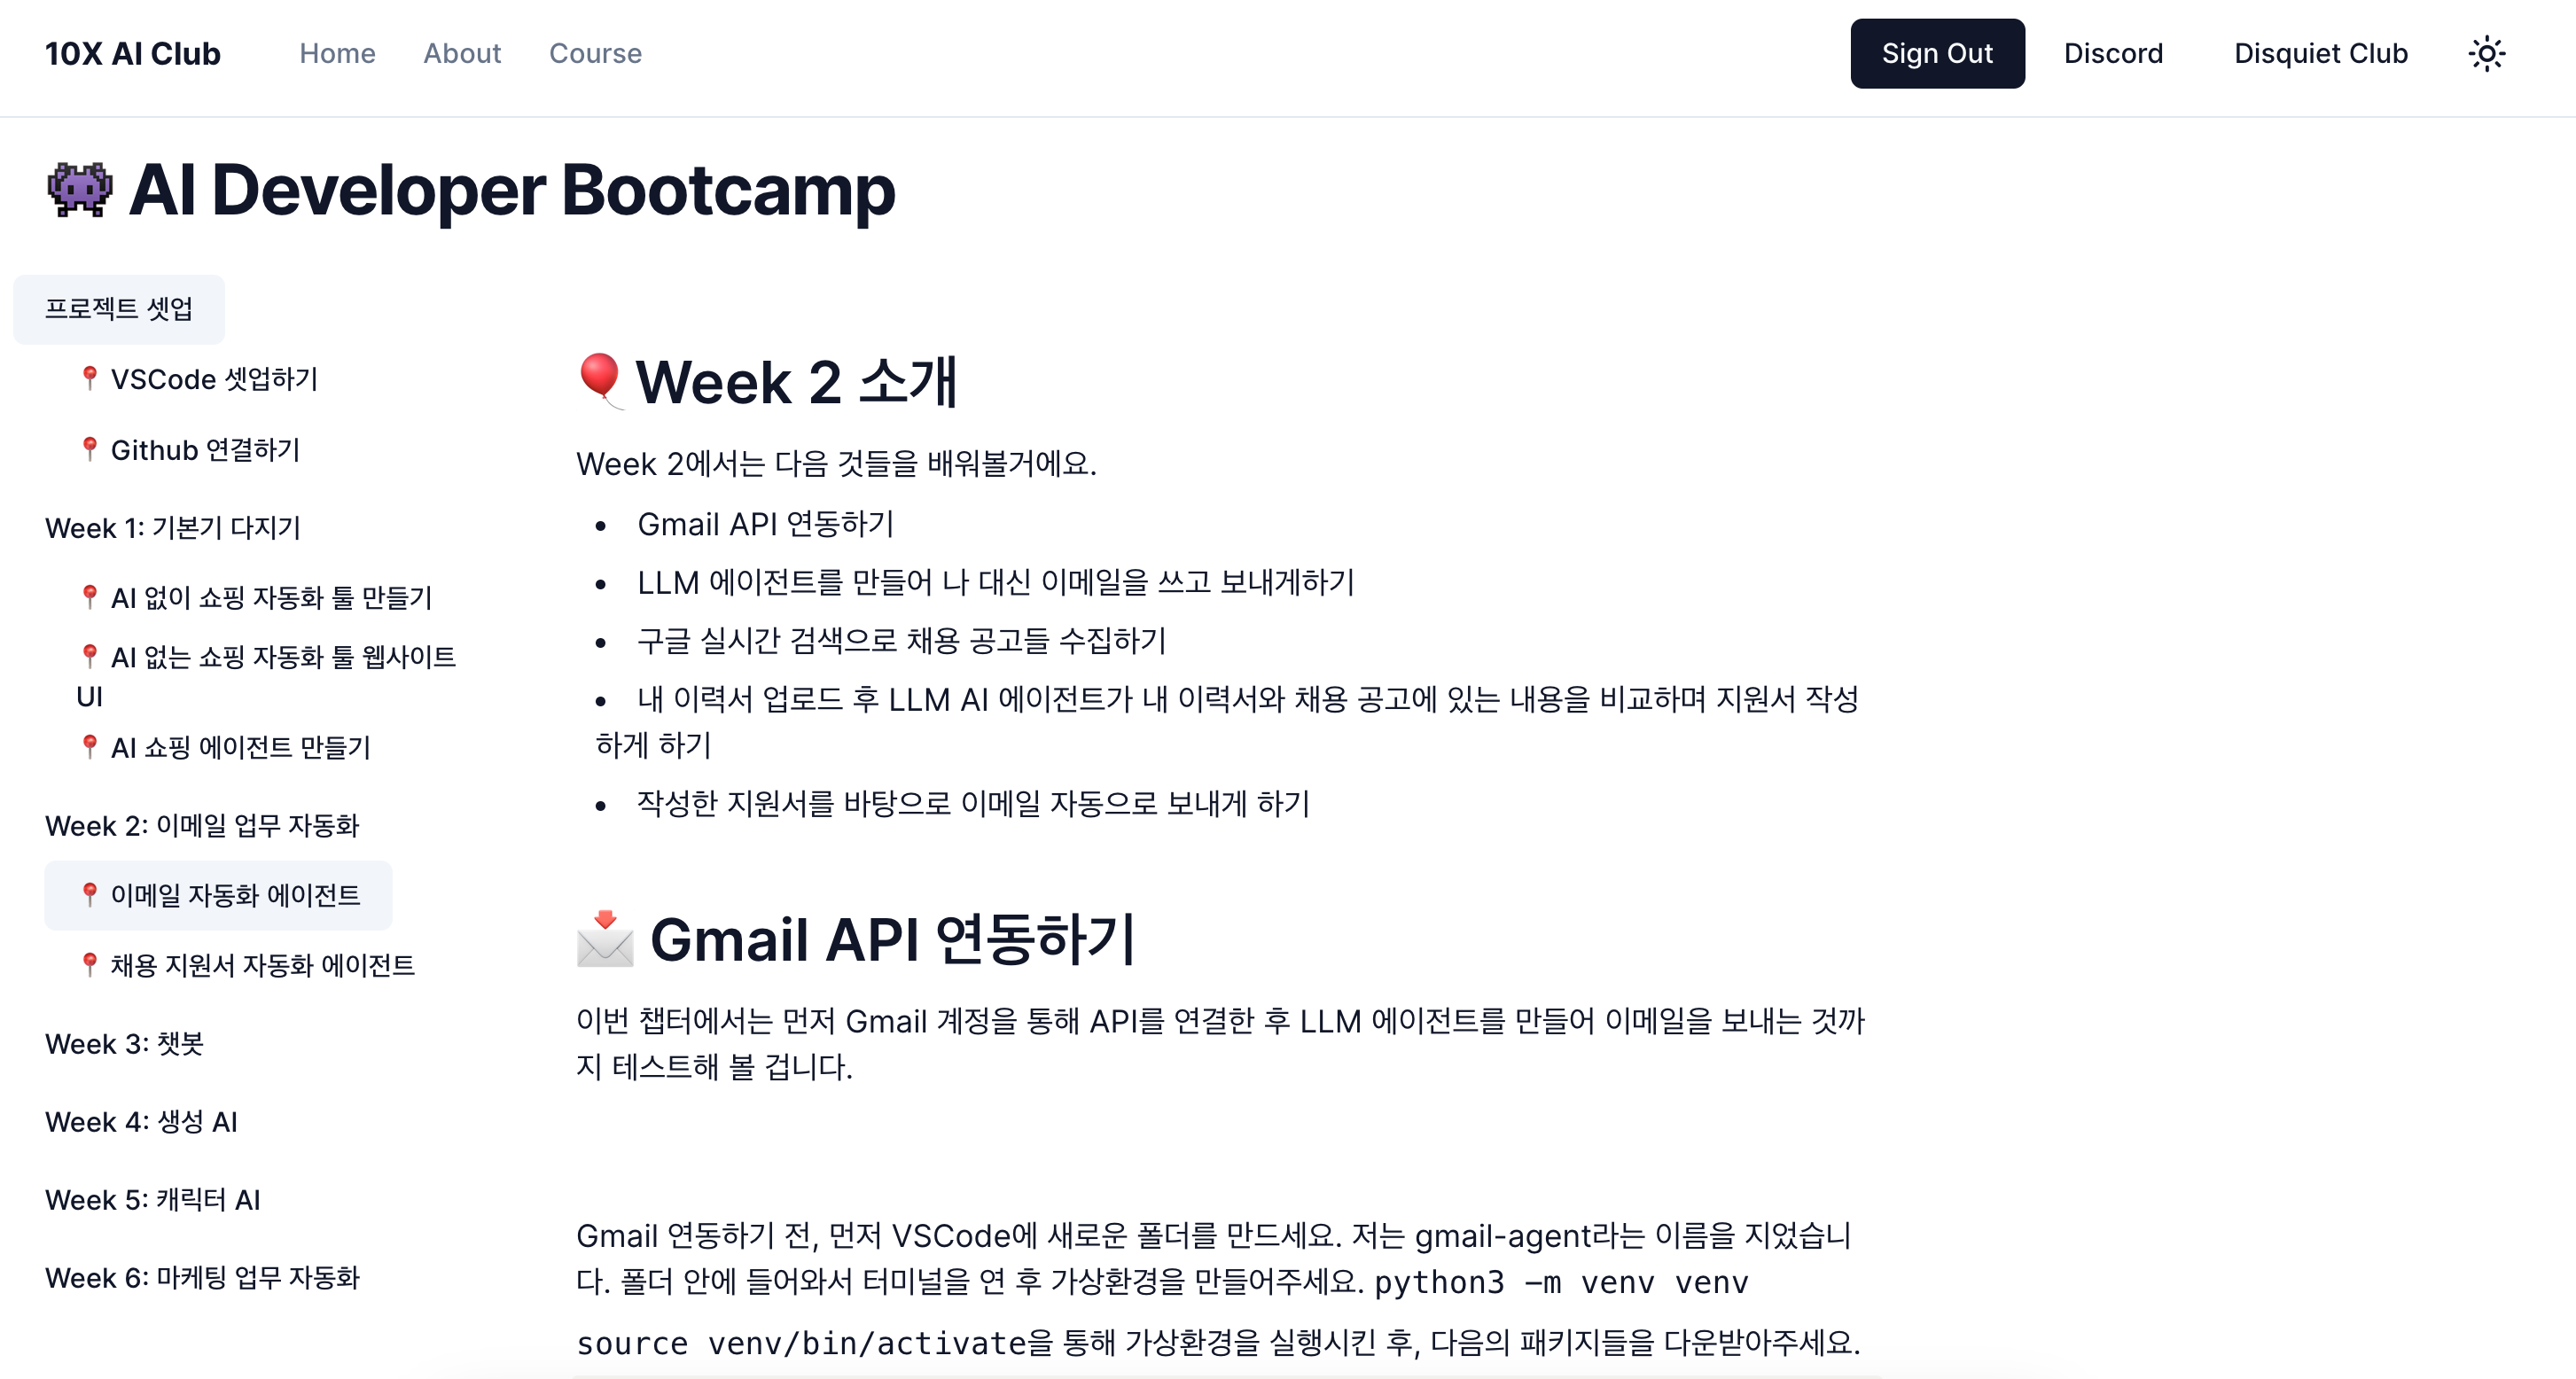
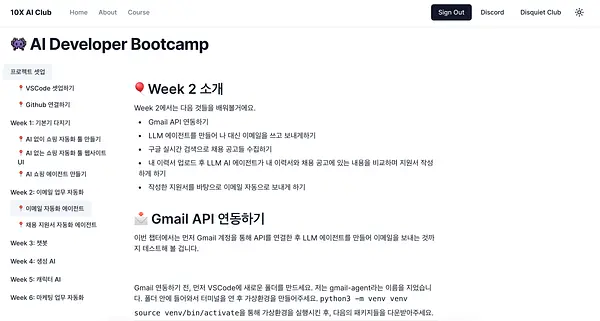
제가 블록체인 공부를 할때 받았던 도움을 이젠 AI 공부를 하고자 하는 여러분에게 드리고 싶습니다. 그래서 10X AI University를 만들기로 결정했고, 오늘 공식적으로 런칭이 됐어요. https://www.10xaiclub.com/ 10X AI Universtiy에 있는 AI Developer Bootcamp 강의는 10X AI Club 멤버분들이 가장 배우고 싶은 토픽들을 위주로 커리큘럼을 짰습니다.

Week 1 기본기 다지기

  • AI 없이 쇼핑 자동화 툴 만들기

  • AI 없는 쇼핑 자동화 툴 웹사이트 만들기

  • AI 쇼핑 에이전트 만들기

Week 2 업무 자동화

  • 이메일 자동화 에이전트

  • 채용 지원서 자동화 에이전트

Week 3 챗봇

  • 비즈니스 챗봇 만들기

  • 챗봇 코드 이해하기

  • 챗봇 LLM 이해하기

Week 4 생성AI

  • DALL-E 이미지 생성 (미드저니 시뮬레이션)

  • ElevenLabs 오디오 생성

  • 추가 리소스

Week 5 캐릭터 AI

  • 카카오톡 캐릭터 AI 챗봇

  • 캐릭터 AI 파인튜닝

Week 6 업무 자동화

  • 마케팅/뉴스레터 업무 자동화 에이전트 만들기

프로젝트들은 OpenAI부터 Langchain, LLM, GPT, DALL-E, ElevenLabs 등을 쓰면서 직접 개발할 수 있도록 알려드리고 있습니다. 애초에 프로그래밍에 대해 전혀 모르시는 분들을 위해 만든 강의여서 더욱 쉽게 이해할 수 있도록 모든 부분들을 글과 이미지로 세세하게 알려드리고, 영상 강의도 있으며 그래도 안된다면 디스코드 방에서 질문/답변을 할 수 있도록 하고 있습니다.

Screenshot 2023-10-16 at 5.38.14 PM.png맛보기 강의들이 궁금하시면 다음 링크에서 확인하실 수 있어요!

VSCode 셋업하기 영상 자료: https://youtu.be/zOhCdFngliA?si=4eiDZs53DC29avDB

글 자료: https://military-roundworm-8aa.notion.site/VSCode-8551d0c68c1a4baa83eb56423b102d61

Github 연결하기 영상자료: https://youtu.be/lTjHlBAr17U?si=wjBxmHZuHCr3azhx

글 자료: https://military-roundworm-8aa.notion.site/Github-3fc07bb0a544438995eaaac6ac52af22

지금도 얼리버드 할인이( 500,000원 1차 얼리버드 할인: 30%, 350,000원) 진행되고 있으니 AI 프로그래밍에 대해서 익숙해지고 실제 자기 비즈니스에 접목시키고 싶은 분들은 참가 신청 부탁드리겠습니다.

10X AI Club 정기모임

KakaoTalk_Photo_2023-10-16-17-50-18.jpeg마지막으로 위에서 리스트업한 4번에 대해 아직 도움을 못드리고 있는 것 같습니다.
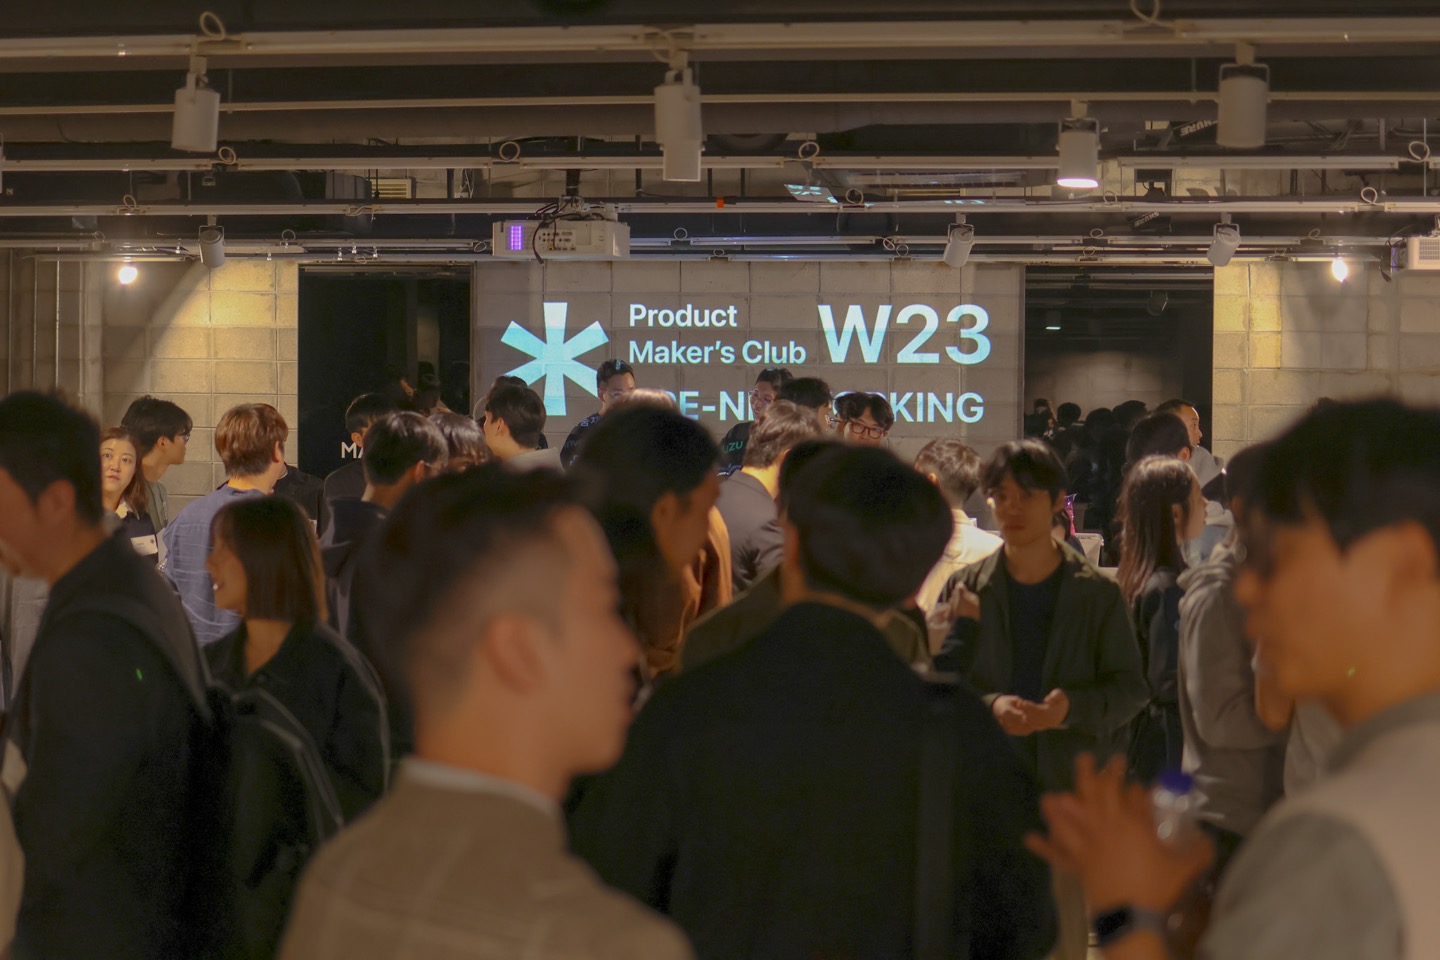
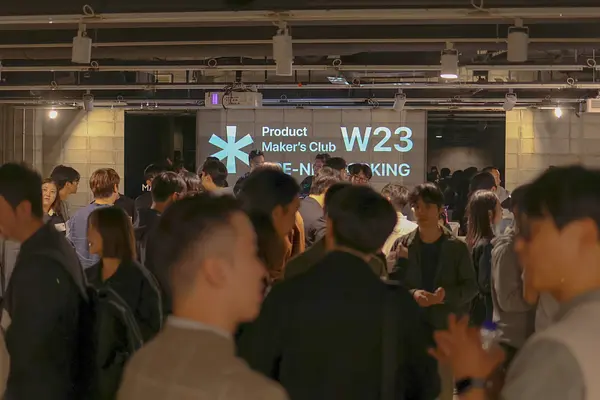
저번 PMC Pre-networking 이벤트를 함께 주최하면서 10X AI Club의 첫 오프라인 모임을 갖게 됐습니다. 이번주부터 6주동안 PMC 운영진으로 참여하게 되는데요, 이런 오프라인 이벤트들을 통해서 더 많은 AI 스타트업을 빌딩하고 있는 분들과 만나며 인사이트를 얻고 참여를 못하시는 분들에게도 배운 점을 공유드릴 예정입니다.

하지만 앞으로 PMC 외에도 AI 커뮤니티에 대한 이런 오프라인 모임은 꾸준히 지속되어야 한다고 생각합니다.

디스콰이엇 팀과 함께 운영하며 덕분에 어떻게 오프라인 이벤트들을 주최해야하는지 정말 많이 배우고 있고, 이를 토대로 10X AI Club도 조만간 이러한 정규모임들을 갖게될 예정이니 많은 관심 부탁드리겠습니다!

긴 글 읽어주셔서 감사합니다 :)

10X AI University

누구나 따라할 수 있는 AI 활용 사례들

15
4
Cailyn Yong

Cailyn Yong

추석동안 oopy.io 결제하기 싫어서 직접 만든 노션 연동 웹사이트

Screenshot 2023-10-02 at 11.32.43 PM.png우피는 웹사이트 빌더중에 단언컨대 최고입니다. 하지만 최대한 돈을 아껴쓰고 싶은 저에게 oopy 도메인을 사서 결제까지 하는건 사치라고 생각했습니다.
추석 한 주 내내 10X AI University 런칭을 위해 웹사이트를 빌딩했는데, 각 커리큘럼 챕터 별로 방대한 양의 컨텐츠 내용들을 직접 Next js와 Tailwind 프론트엔드 개발을 해서 올릴 걸 생각하니 머릿속이 하얘지더라구요.

어떻게 하면 oopy를 사용하지 않고 노션에 올린 내용을 바로 내 웹사이트 도메인에 올릴 수 있을까?

oopy에 웹사이트 연동을 하기 위해서는 무조건 Notion 사이트를 공개로 돌려야 하는데 저 같은 경우에는 유료 회원들만 내용을 접하게 하고 싶었기 때문에 공개로 돌릴 수 없었습니다.

그래서 인터넷을 뒤지다가 몇일동안 할 일을 하루만에 단축시켜준 개발 package를 발견했습니다.

바로 이겁니다: https://github.com/kerwanp/notion-render

노션 데이터베이스에 작성하는 모든 컨텐츠들을 바로 노션 스타일 형식처럼 렌더링해서 Next js 앱에 보여지게 하는 툴입니다.

이 글에서 직접 활용하는 것까지 개발 과정을 공유해드리겠습니다!

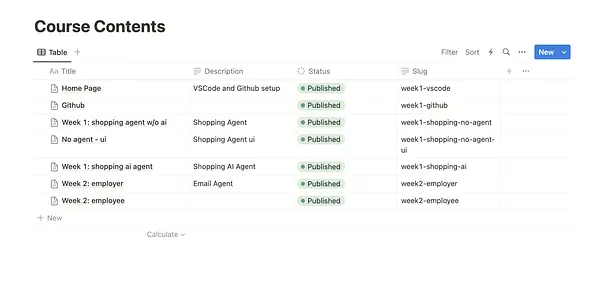
1. 노션 데이터베이스 만들기

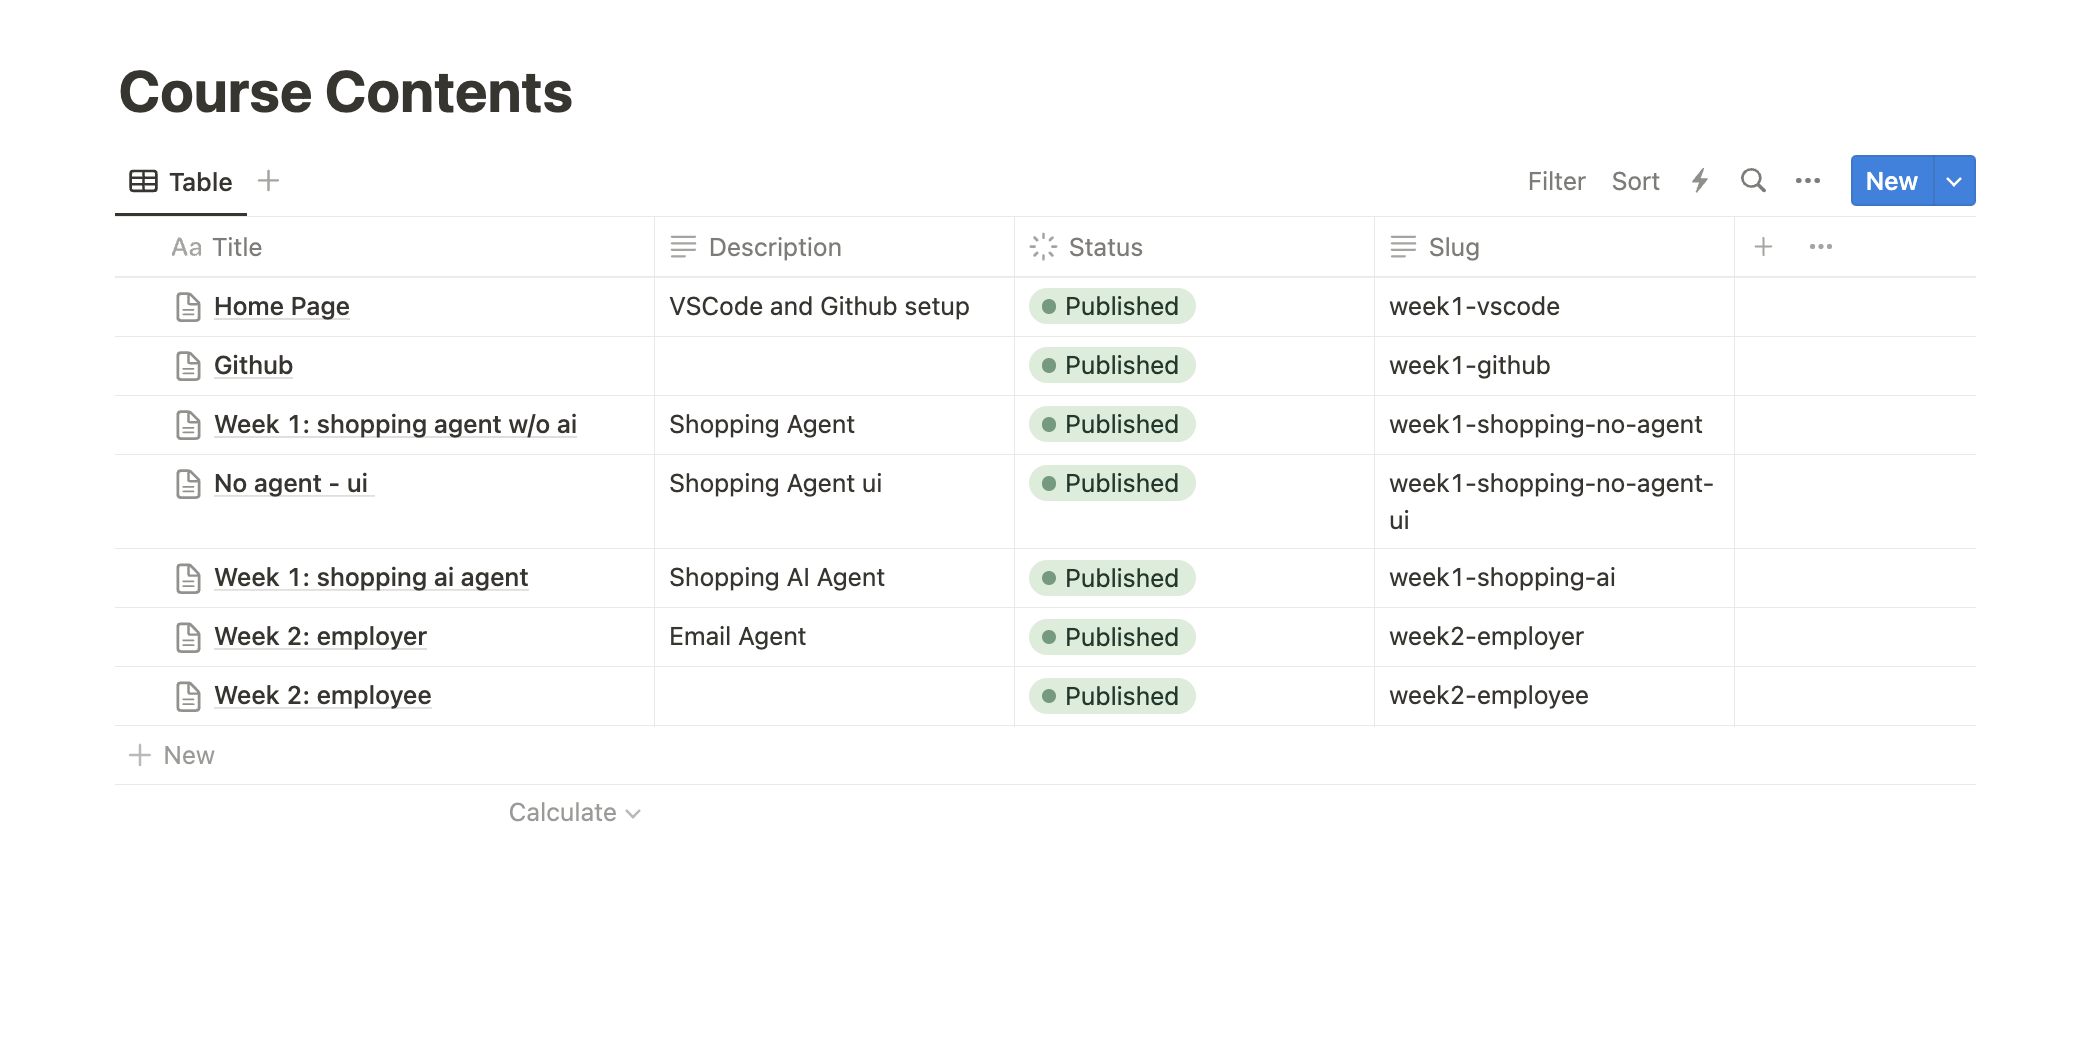
먼저 노션에 이런식으로 테이블을 하나 만들어주세요.

여기서 중요하고 필요한 column 값들은 Status와 Slug 입니다.

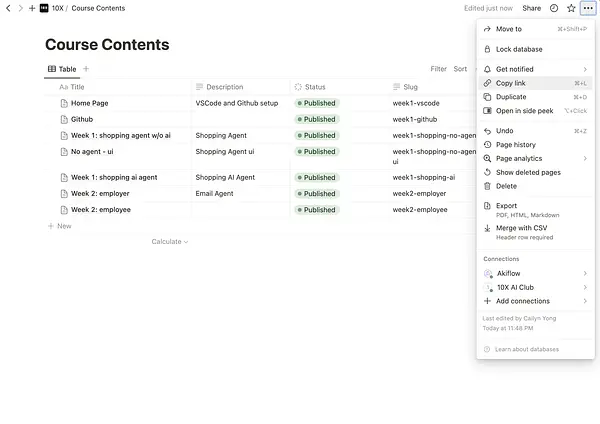
Screenshot 2023-10-02 at 11.46.43 PM.png그 다음 이 데이터베이스의 ID를 찾아줍니다. ID를 찾기 위해서는 상단의 오른쪽 코너에 있는 ... 점 세개 버튼을 누르고 Copy Link를 눌러주세요.
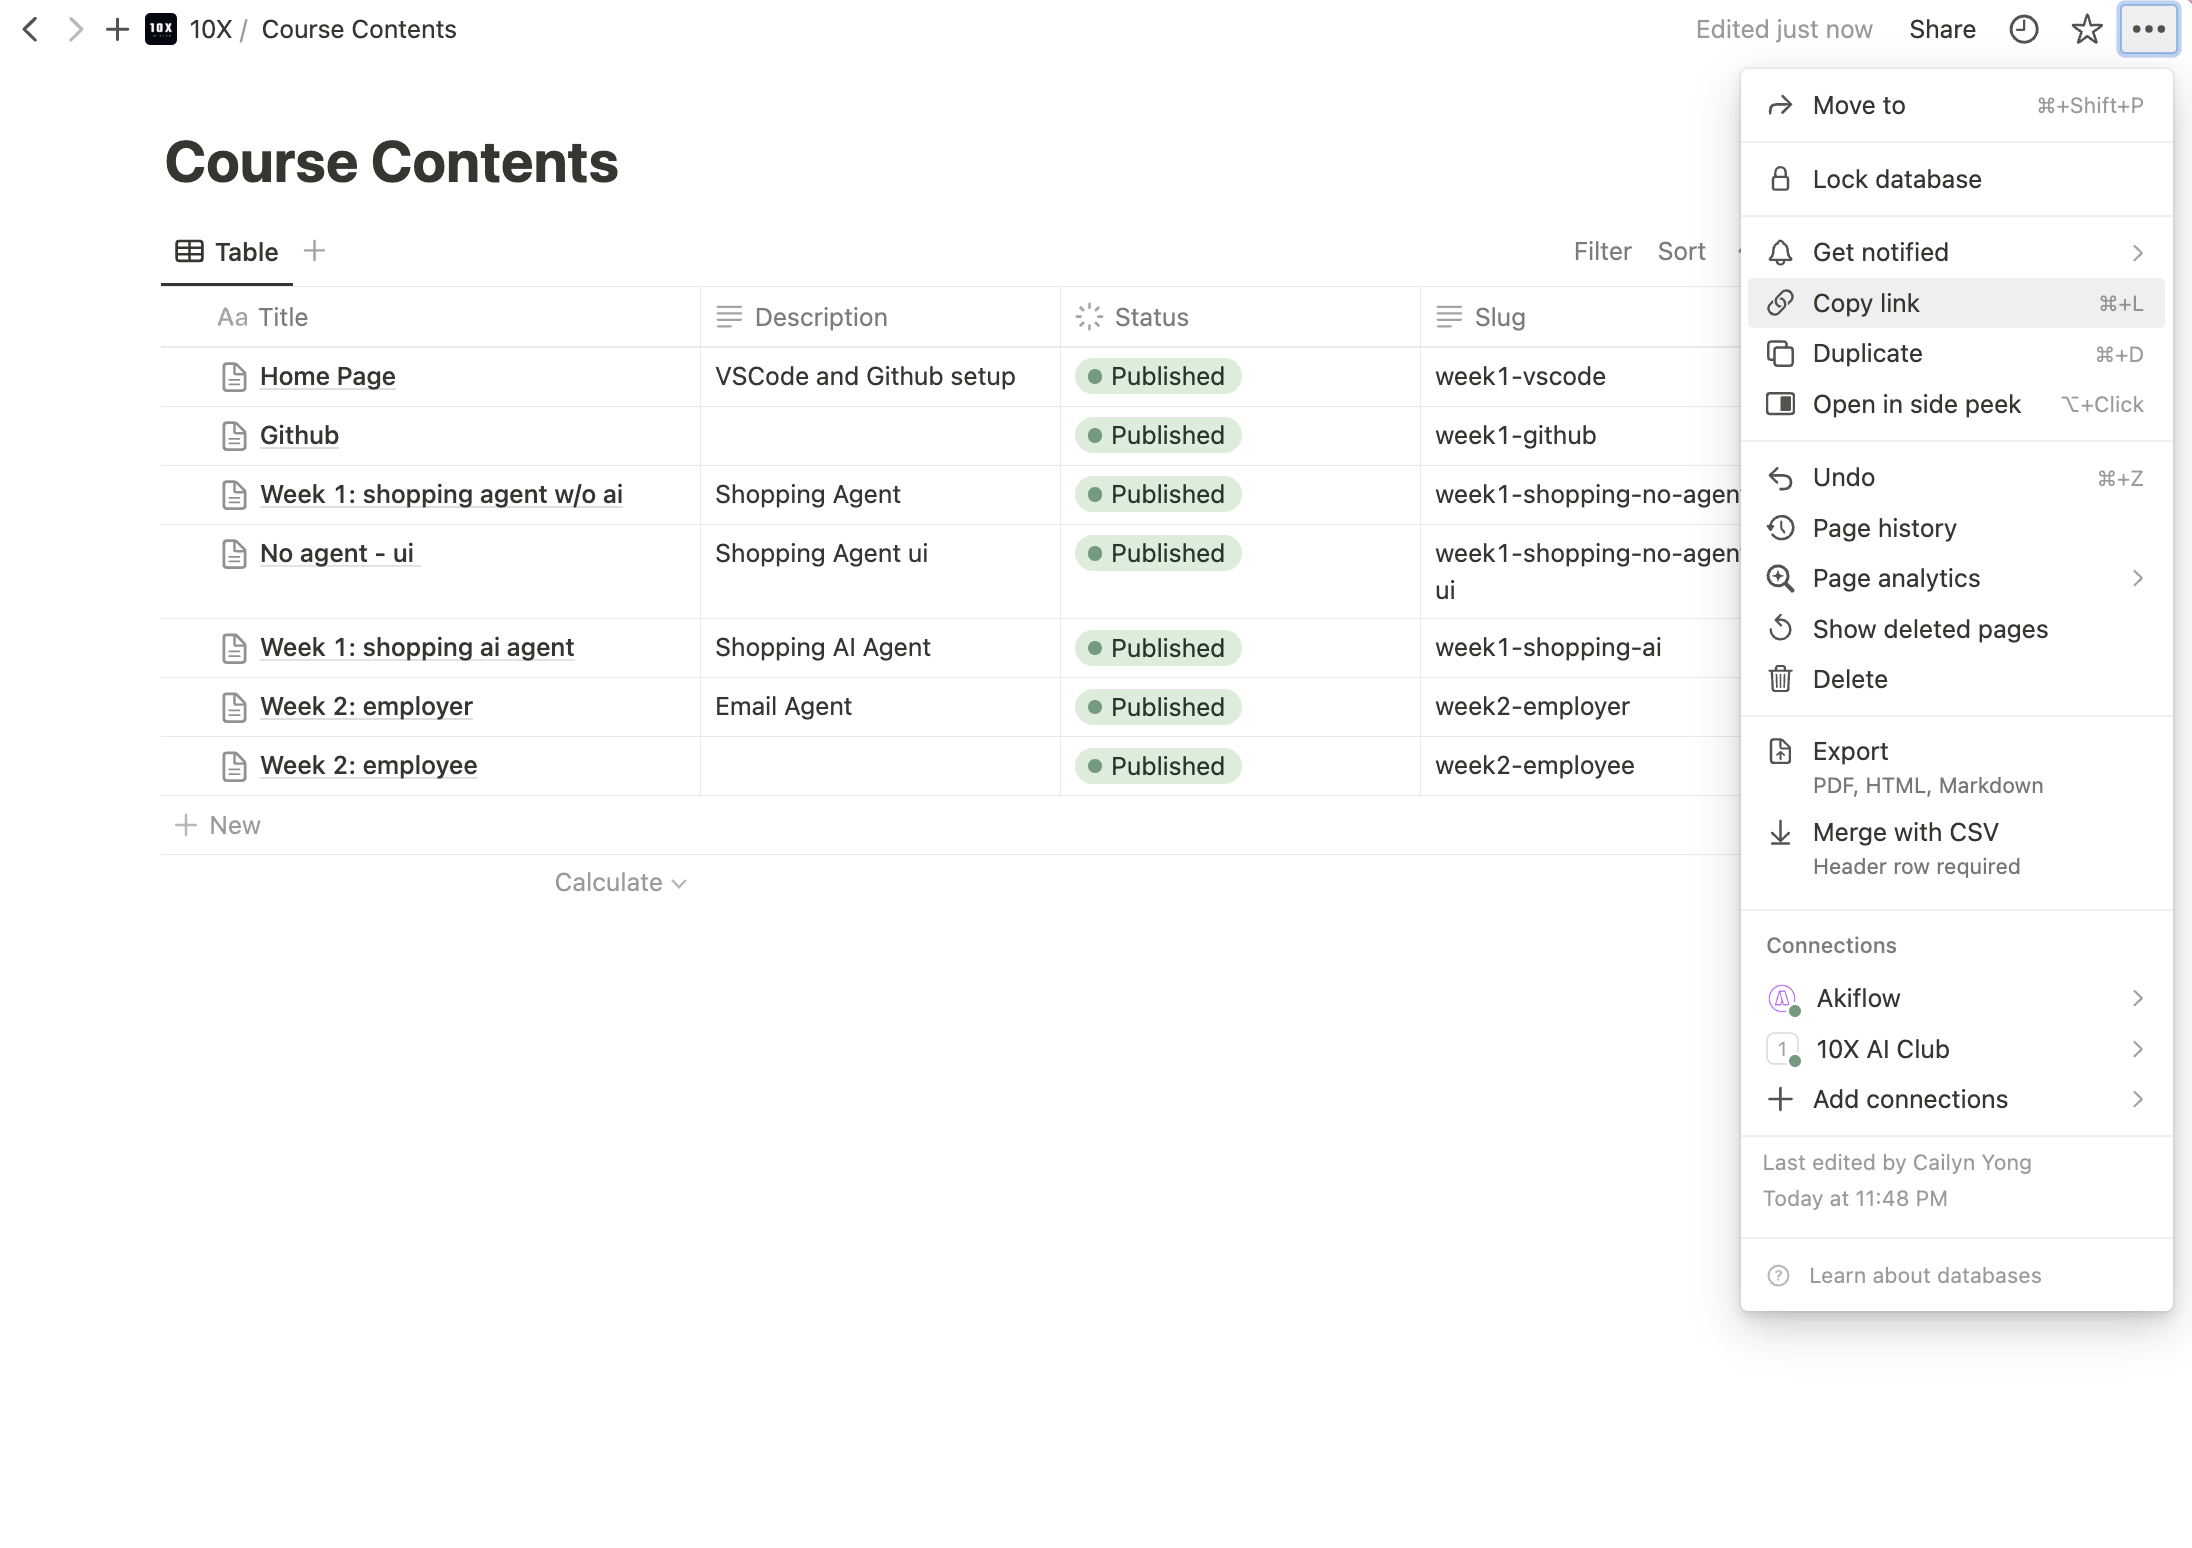
Screenshot 2023-10-02 at 11.48.51 PM.pngnotion.so/5k314fze586d45639eild48951afba89?v=4ca2463b53614a5691bd
그럼 이런식으로 링크가 보여지는데 여기서 데이터베이스의 ID는 www.notion.so/ 다음부터 ? 물음표 전까지의 값입니다. 즉 이 예시에서 ID는 "5k314fze586d45639eild48951afba89" 입니다.

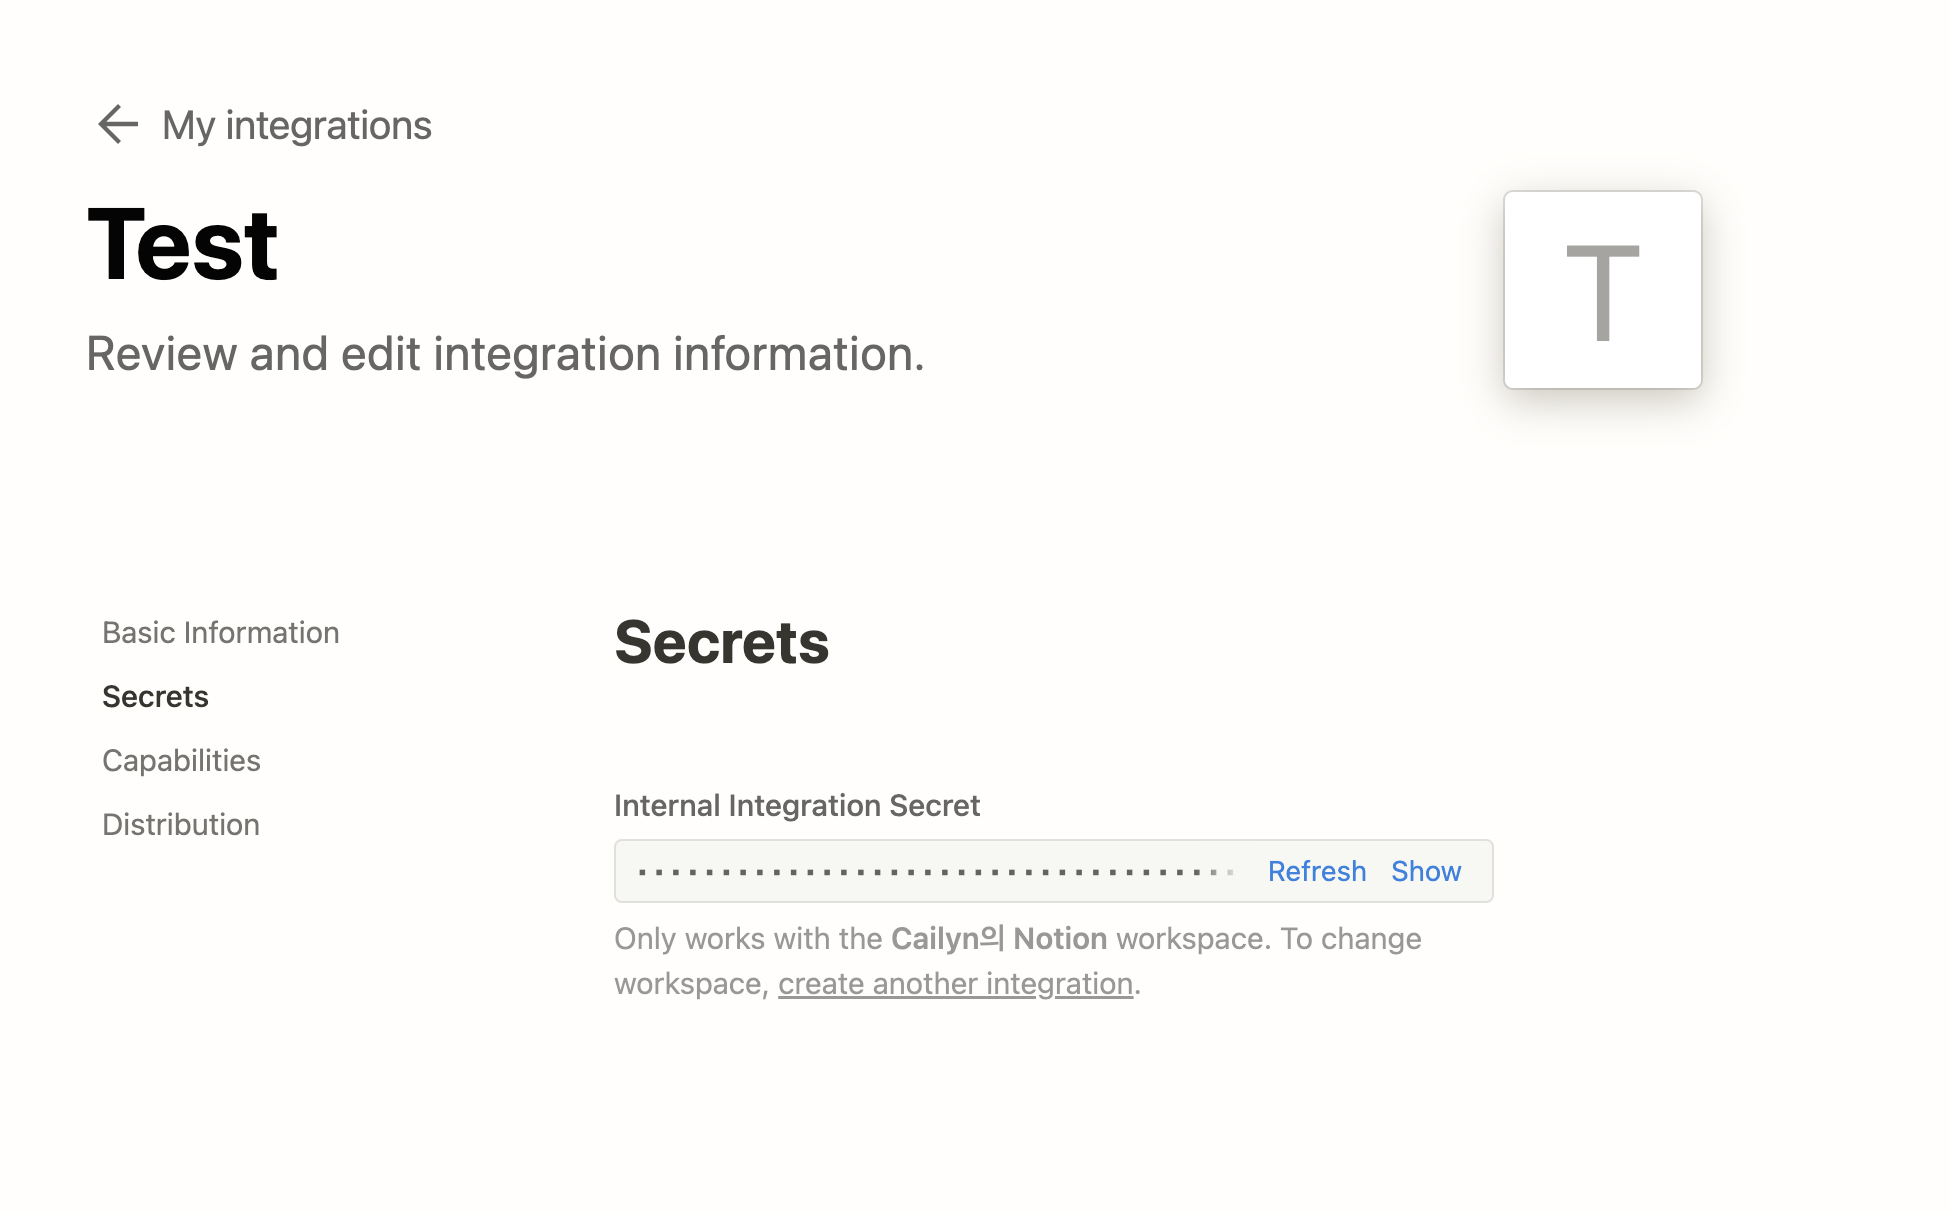
2. 노션 개발자 토큰 얻기

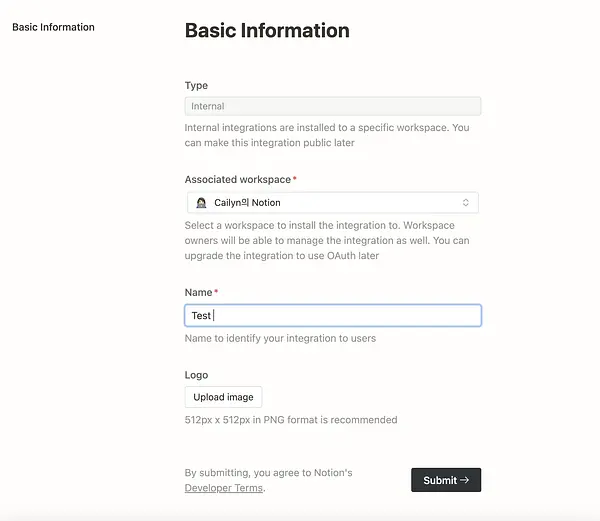
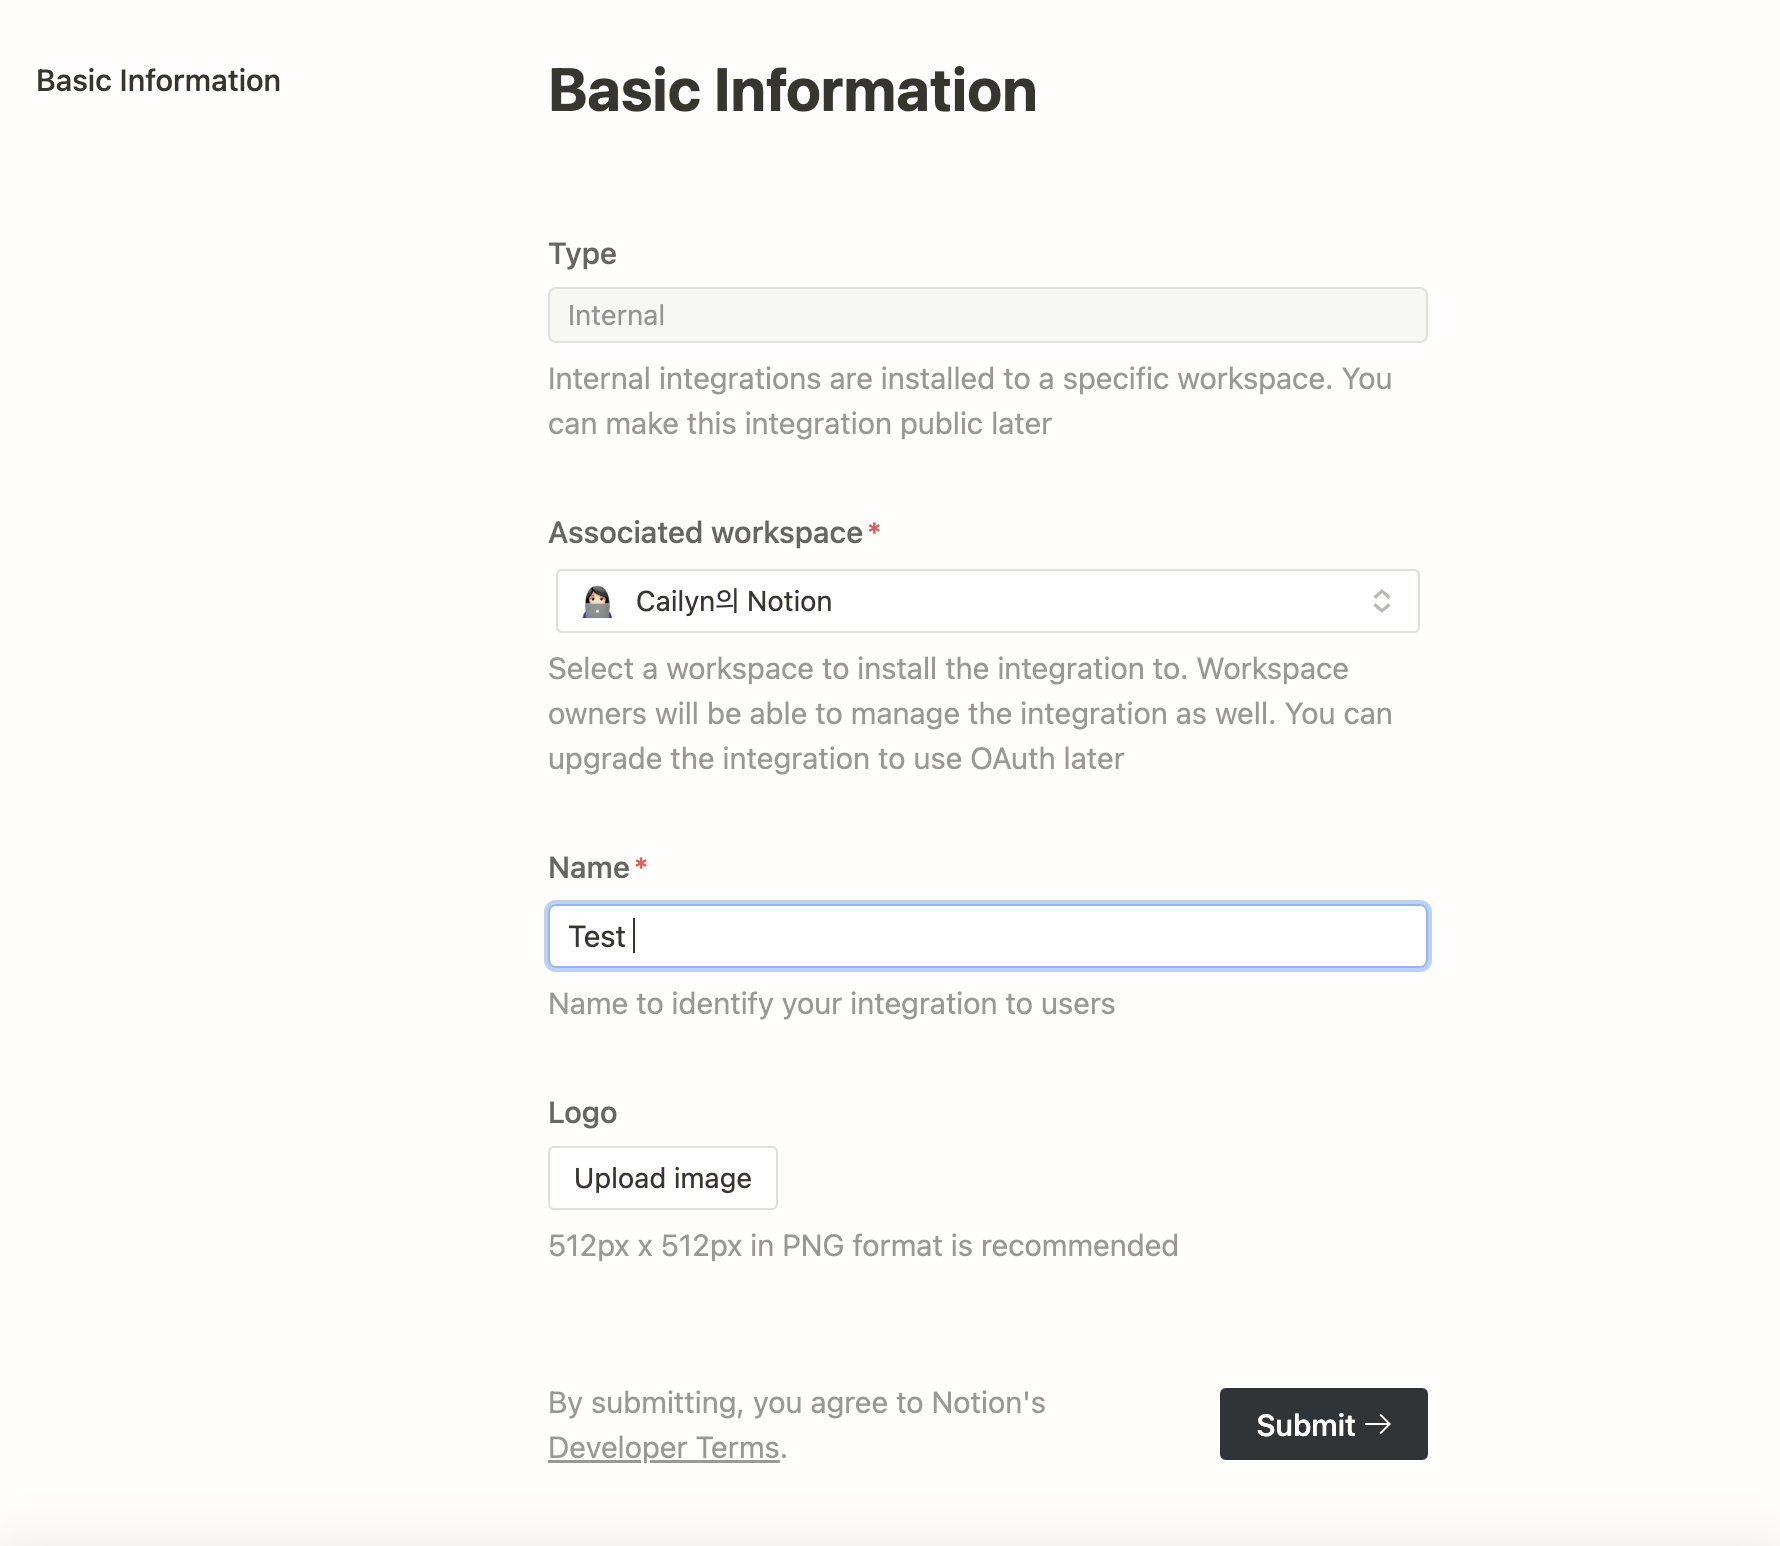
https://www.notion.so/my-integrations 이 링크로 간다음에 새로운 프로젝트를 만들어주세요.

Screenshot 2023-10-02 at 11.57.20 PM.png그 다음 Secret key를 복사해서 저장합니다.

Screenshot 2023-10-02 at 11.58.00 PM.png환경 설정에서는 데이터베이스의 컨텐츠들을 읽어올 수 있게 허용을 해줍니다.
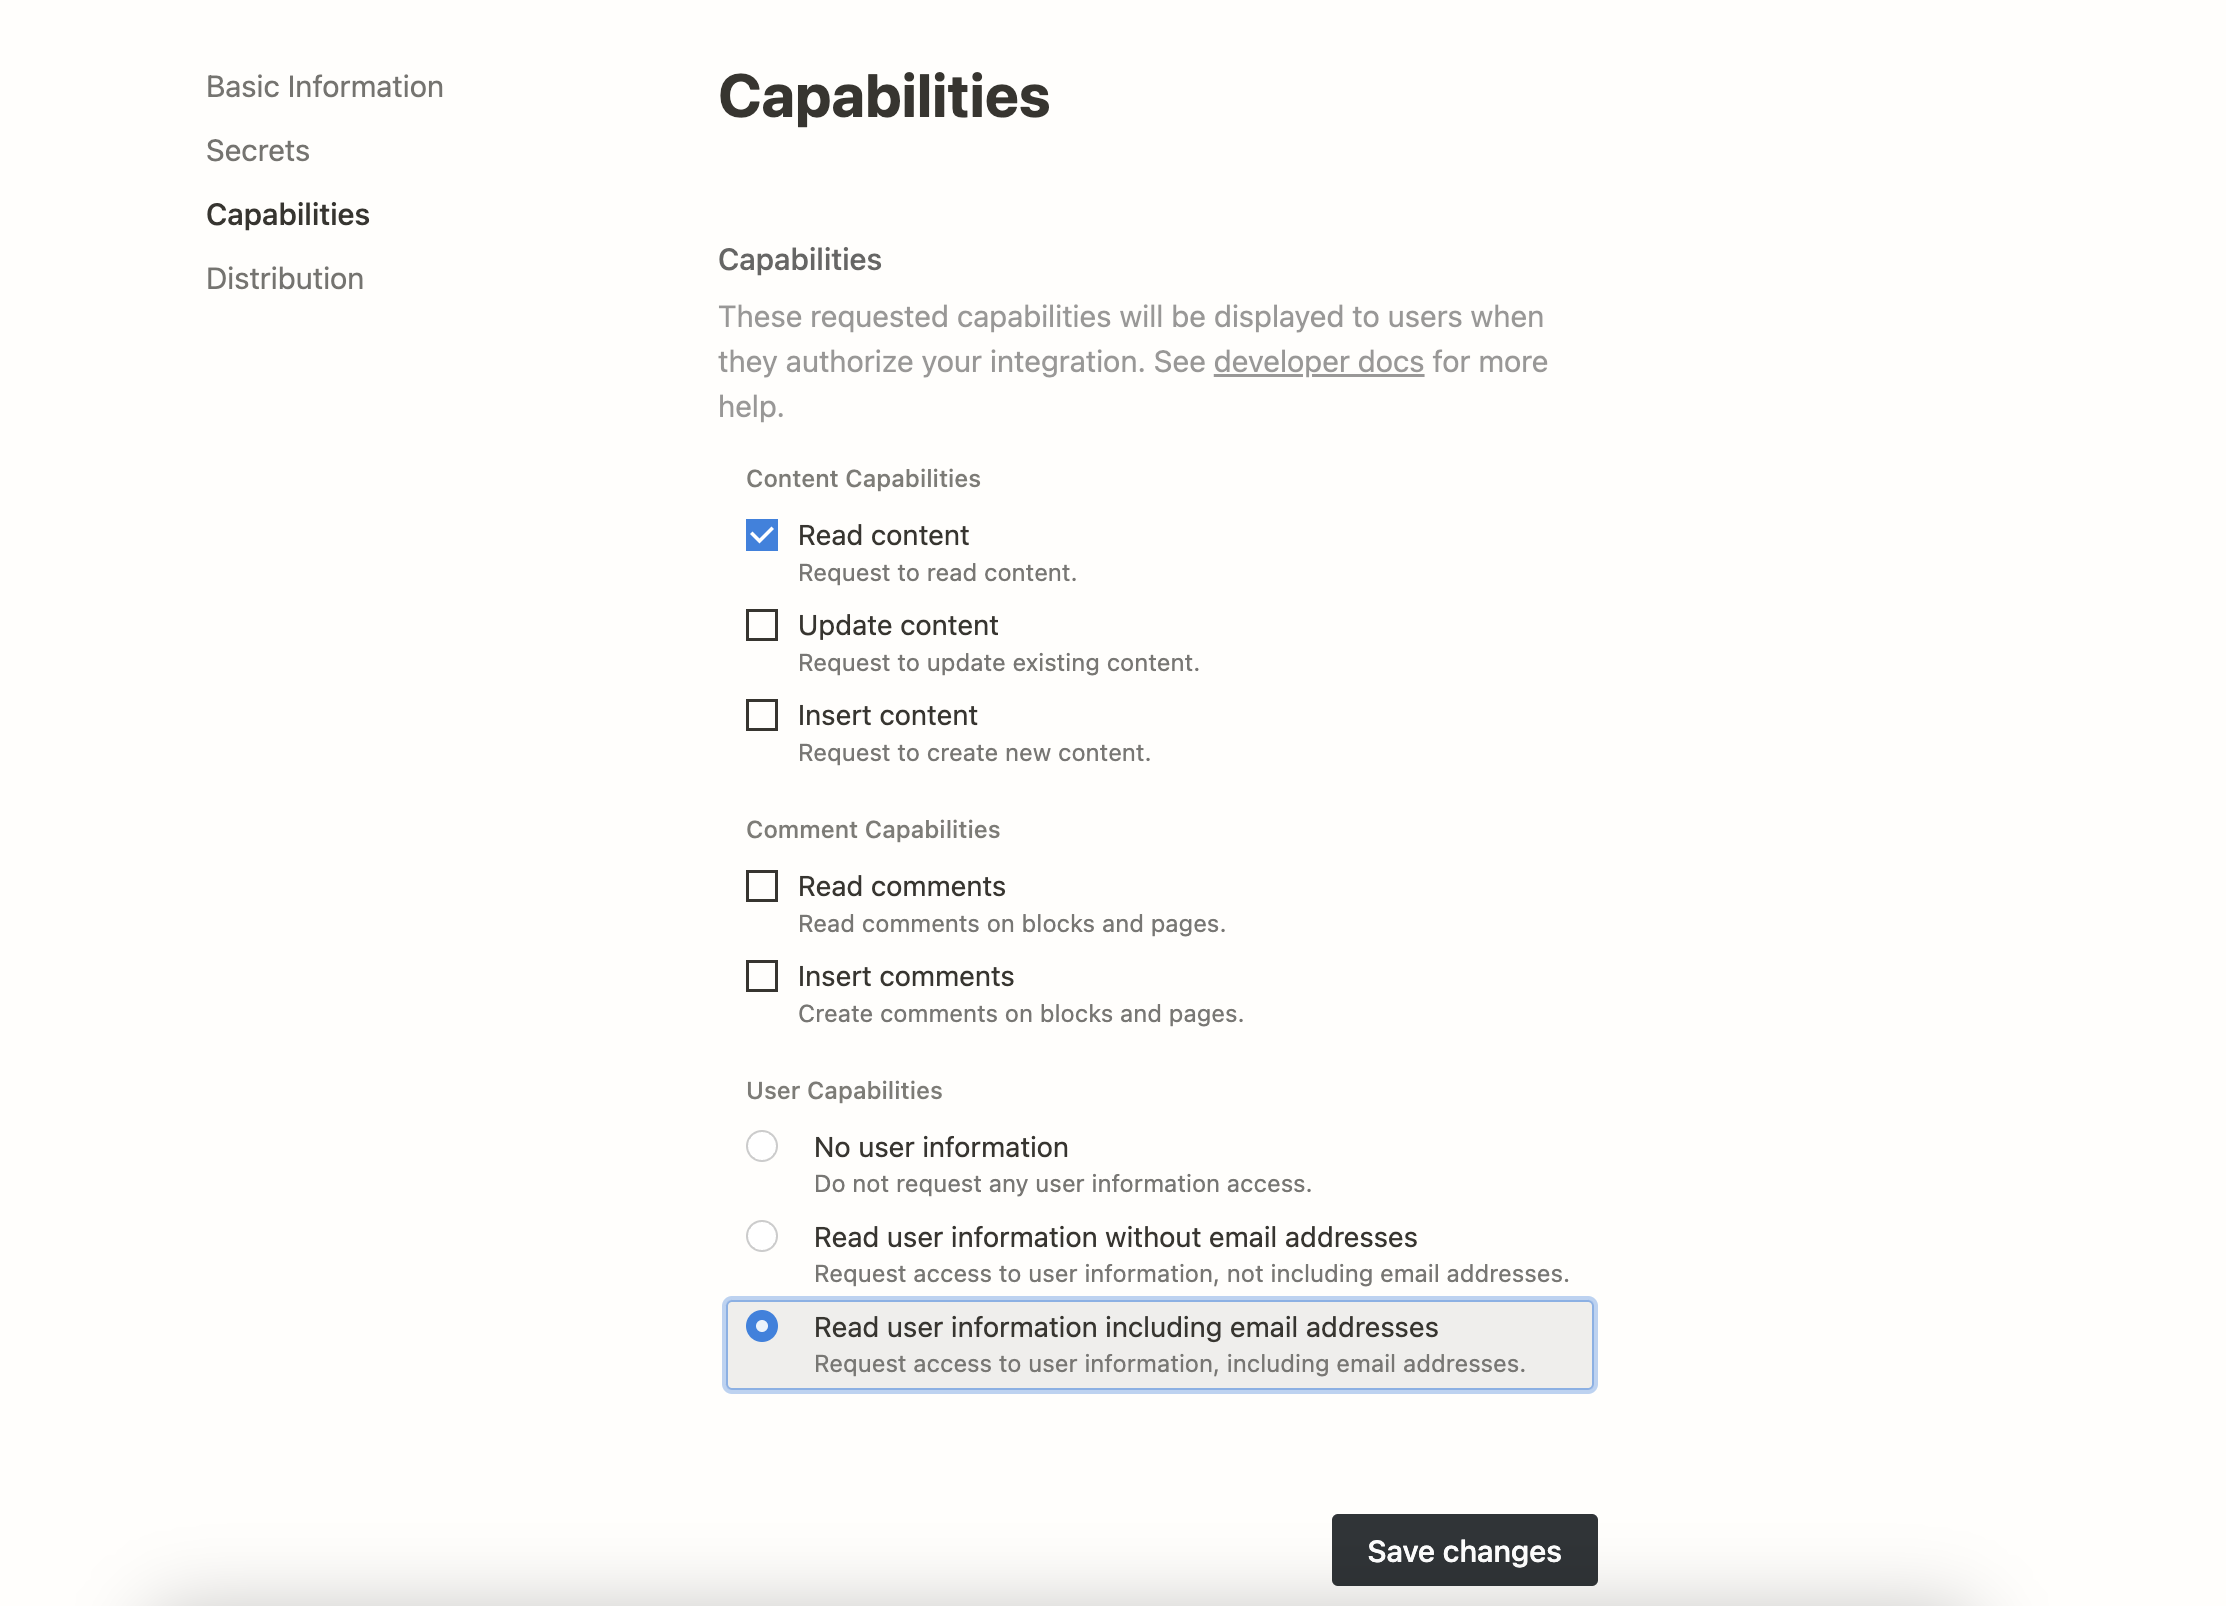
Screenshot 2023-10-02 at 11.59.13 PM.png

3. 프로젝트 셋업하기

이미 기존의 Next JS 앱이 있다면 터미널에 다음의 패키지들을 다운받아주세요.

$ yarn add @notionhq/client @notion-render/client @notion-render/hljs-plugin @notion-render/bookmark-plugin
# Or
$ npm install @notionhq/client @notion-render/client @notion-render/hljs-plugin @notion-render/bookmark-plugin

그 다음에 로컬 .env 파일에 다음 값들을 저장해주세요. 여기서 NOTION_TOKEN은 위에서 저장한 notion secret key이고, NOTION_DATABSE_ID는 데이터베이스 ID 입니다.

NOTION_TOKEN="secret_xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx"
NOTION_DATABASE_ID="xxxxxxxxxxxxxxxxxxxxxxx"

4. 노션 데이터베이스 불러오기

그 다음 Next JS 앱 환경에서 lib 폴더에 notion.ts라는 파일을 만들어줍니다.

import "server-only";

import { Client } from "@notionhq/client";
import React from "react";
import {
  BlockObjectResponse,
  PageObjectResponse,
} from "@notionhq/client/build/src/api-endpoints";

export const notion = new Client({
  auth: process.env.NOTION_TOKEN,
});

export const fetchPages = React.cache(() => {
  return notion.databases.query({
    database_id: process.env.NOTION_DATABASE_ID!,
    filter: {
      property: "Status",
      select: {
        equals: "Published",
      },
    },
  });
});

export const fetchPageBySlug = React.cache((slug: string) => {
  return notion.databases
    .query({
      database_id: process.env.NOTION_DATABASE_ID!,
      filter: {
        property: "Slug",
        rich_text: {
          equals: slug,
        },
      },
    })
    .then((res) => res.results[0] as PageObjectResponse | undefined);
});

export const fetchPageBlocks = React.cache((pageId: string) => {
  return notion.blocks.children
    .list({ block_id: pageId })
    .then((res) => res.results as BlockObjectResponse[]);
});
  1. fetchPages() 함수는 노션 데이터베이스 ID를 사용해서 데이터베이스를 불러온 다음, 데이터베이스의 column 값들 중에서 Status가 "Published"로 돼있는 컨텐츠들만 불러온다는 뜻

  2. fetchPageBySlug() 함수는 마찬가지로 데이터베이스를 불러오지만 데이터베이스의 column 값 중에서 Slug에 있는 텍스트를 바탕으로 내용을 불러온다는 뜻

5. page.tsx에서 데이터베이스 컨텐츠 렌더링하기

그 다음 app/blog/[slug]/page.tsx와 같은 파일 내에서 아래의 코드를 사용합니다.

여기서 const post = await fetchPageBySlug("week2-employee") 줄은 맨 위에 제 데이터베이스 사진에서 Slug column 값들 중에 "week2-employee"로 돼있는 페이지 컨텐츠를 불러온다는 뜻입니다.

import { fetchPageBlocks, fetchPageBySlug, notion } from "@/lib/notion";
import { NotionRenderer } from "@notion-render/client";
import { notFound } from "next/navigation";
import { Client } from "@notionhq/client"
import "@notion-render/client/sass/theme.scss"

export default async function Page() {
  const post = await fetchPageBySlug("week2-employee");
  if (!post) notFound();

  const blocks = await fetchPageBlocks(post.id);

  const client = new Client({ auth: process.env.NOTION_TOKEN })
  const renderer = new NotionRenderer({ client })

  const html = await renderer.render(...blocks);

  return <div className="notion-render" dangerouslySetInnerHTML={{ __html: html }}></div>;
}

그리고 className = "notion-render"를 통해 노션 스타일링 형식에 맞게 페이지 컨텐츠를 불러오도록 합니다.

그럼 노션에 작성한 컨텐츠 스타일링 그대로 Next JS 웹사이트에 컨텐츠가 뜹니다.

Code block부터 이미지, Header, inline code, bullet list 등이 다 렌더링됩니다. (렌더링 되지 않는 블록들도 있습니다! 깃헙 페이지에서 확인하세요.)

Screenshot 2023-10-03 at 12.15.32 AM.png이런식으로 노션에서 작성한 스타일링 대로 그대로 뜹니다!!

마무리..

혹시 하면서 안되는 부분 있으면 댓글 달아주세요! 저도 겨우겨우 우여곡절에 성공한거라 모든 방법들은 다 해봤던 것 같네요.

29
6
Cailyn Yong

Cailyn Yong

이미지 생성AI, 뼛속까지 알아보자 (EPIK 소개부터 DALL-E, StableDiffusion 기술까지)

KakaoTalk_Photo_2023-09-27-21-30-44.jpeg이번주 내내 인스타를 한껏 핫하게 달군 컨텐츠가 있습니다.

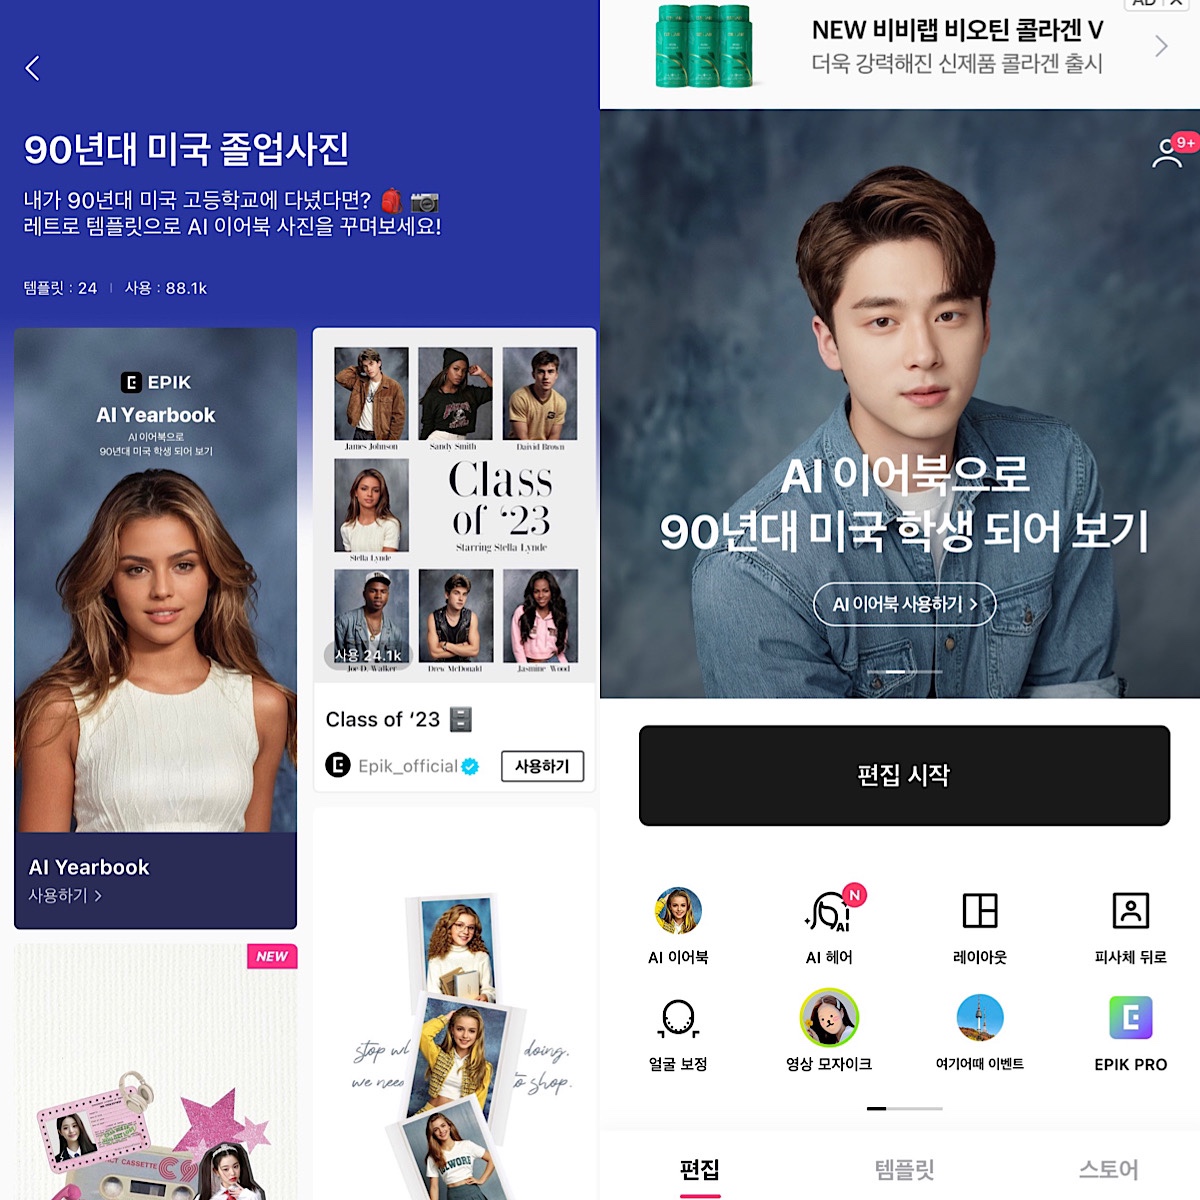
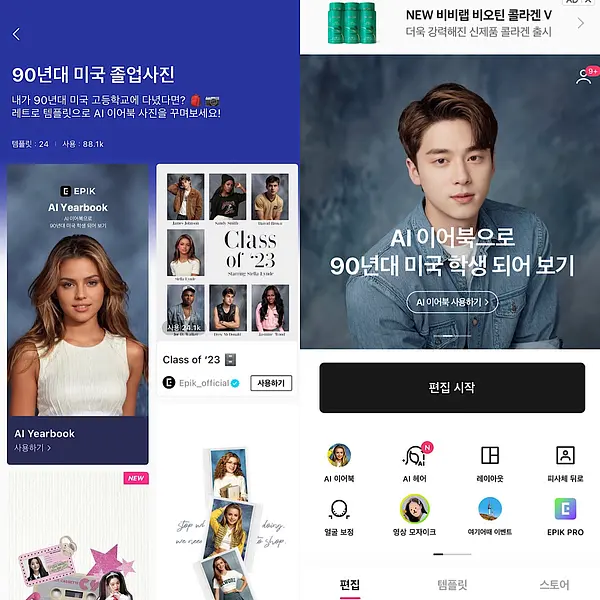
바로 Epik, AI 사진 편집 앱인데요, 이번에는 90년대 미국 Yearbook 컨셉으로 AI 프사를 생성할 수 있는 기능을 출시했습니다.

Epik - AI 사진 편집

KakaoTalk_Photo_2023-09-27-20-09-18 001.jpeg

출시 이후로부터 오늘까지 128.9K번 사람들이 사용을 했고, (이건 심지어 오늘 아침 몇시간 전에 88K였음), 지금은 "현재 AI 이어북 이용자가 급격히 증가하여, 서비스 이용이 지연되고 있습니다. 잠시 후 다시 이용해주세요"라고 팝업이 뜹니다.

이틀전까지만 해도 결제창까진 들어갈 수 있었는데, 그것도 솔드아웃이었습니다. (가격은 30분 안에 생성하려면 8900원, 그 이후의 시간에 나오는건 가격이 더 쌌는데 기억이 안납니다 🥲)

저도 해보고 싶어서 어제 새벽에 이용자 수가 줄어든 틈을 타서 겨우 접속을 해서 결제까지 했는데 30분 안에는 절대 안나오고 한 두시간 이상 기다려야 나오더라구요. 생각해보니 그럼 왜 8900원을 냈지

그 새벽에도 대기자 명단이 제 앞으로 885명이었고, 순간 이 시간에도 에픽 팀은 밤을 새면서 서버가 안 터지길 기도하고 있겠지? 라는 생각이 들었습니다. 화이팅입니다.

에픽은 서버가 터지도록 이렇게 바이럴을 타게 될 수 있었던 이유는 무엇일까요?

알고보니까 에픽은 스노우 자회사더라구요..!

스노우는 저번에도 AI 프사 기능으로 몇백억을 벌었던데 이번에도 미친듯이 벌게 될 것 같습니다.

생각해보니 저는 개인적으로 이런 이미지 생성 필터들이 나올때마다 돈을 지불해서라도 했던 것 같아요. 처음에 렌사가 나왔을때도 그렇고, 스노우 AI 프로필도 그렇고 가격이 다 10,000원 이하여서 이 정도면 지불할만하다고 생각했던 것 같습니다.

하지만 제 원래 성격 상 게임할때도 현질을 안하는 스타일이고, 굳이 사야되지 않는거라면 돈을 지불하지 않는 성격임에도 불구하고 스노우는 어떻게 제 지갑을 열게 했을까요?

아마도 FOMO 전략을 진짜.진짜. 잘 활용한 것 같아요.

저번 AI 프로필때도 그렇고 한 두명이 하다가 백명씩 하고, 천명씩 입소문을 타게 되면서 인플루언서부터 연예인들까지 해서 올리면 그 입소문 속도는 어마무시하게 퍼지게 됩니다.

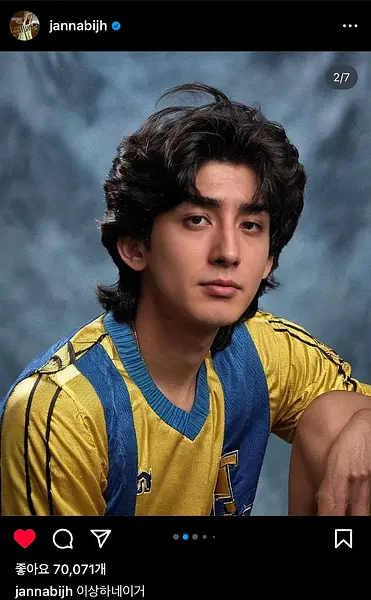
이번 AI Yearbook은 처음에 연예인들이 직접 해서 올리거나, 아님 아이돌 팬분들께서 자신이 덕질하는 아이돌 사진들을 넣고 나온 결과물들을 공유하면서 점점 입소문을 타게 된 것 같아요.

KakaoTalk_Photo_2023-09-27-20-09-19 004.jpeg그렇게 점점 일반인들 사이에서도 이런 필터를 알게되고, 댓글을 통해 다들 "이거 어떤 앱인가요?"라고 물어보고 있었습니다. (저도 댓글 통해 알게됨)
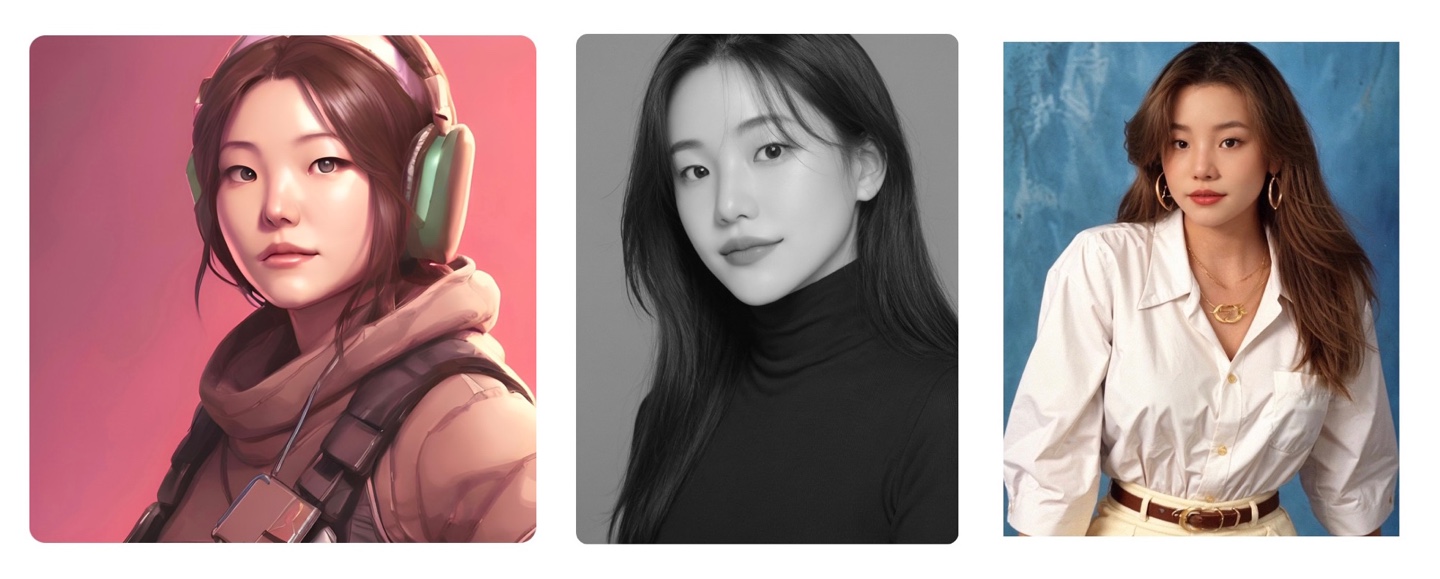
물론 모든 필터들이 이렇게 바이럴을 탈 수 있는 건 아닙니다.

스노우가 진짜 잘하는건 사람들이 정말 재미있어할만한, 그리고 여성 분들을 타겟한 '예쁘게' 나올 수 있는 컨셉 샷들을 잘 찾아내는 것 같습니다.

이번에 이어북 필터로 생성한 결과물들을 보면서 가장 많이 놀랐던 건 확실히 퀄리티 차이였습니다.

사진의 화질부터, 사람 얼굴의 눈, 코, 입, 눈썹, 얼굴형 모양까지 정말 세밀하게 잡았더라구요.

보통의 이미지생성 앱들은 다른 얼굴의 템플렛 위에 유저 인풋 얼굴을 넣는 것이기 때문에 원본 템플렛 사진의 얼굴형을 따라가거나 원본 얼굴의 눈 위치, 눈 모양을 따라가기 마련이어서 내 자신과 닮았다는 느낌을 느끼기가 어려웠습니다. 하지만 이번 이어북 컨셉 사진들은 모든 세밀한 부분들이 제 얼굴과 닮았다는 느낌이 들었습니다.

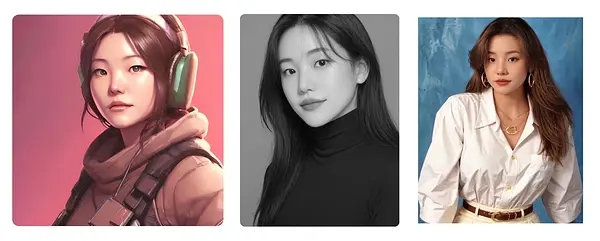
KakaoTalk_Photo_2023-09-27-20-30-59.jpeg예전 스노우 AI 프로필 결과물과 이번 이어북 컨셉 결과물을 비교하자면:
  • 제가 예민해서 그런거일수도 있지만 예전 버젼(흑백 사진)은 눈 주변 쌍꺼풀 라인이나 아이래쉬가 겹쳐 보인다거나 있으면 안될 선들이 하나씩 생성되기도 했습니다.

  • 최신 버젼 (이어북 사진)은 자세히 줌인해봐도 이상하게 생성된 부분이 얼굴쪽에 전혀 없습니다. (목걸이가 잘 생성안되긴 했네요)

  • 예전의 렌사(가장 왼쪽 사진)와 비교하면 퀄리티는 정말 놀라울 따름입니다.

그럼 이걸 만드는 법 + 가격은?

오늘 아침에 결과물을 받자마자 저도 만들어보고 싶어서 인터넷에 있는 모든 소스 코드들을 뒤졌던 것 같아요.

저는 오늘 Stable Diffusion과 DALL-E를 사용해서 둘다 만들어봤는데, 일단 가격상으로

  • DALL-E는 OpenAI의 API를 쓰기 때문에 가격이 나감. 이미지 4개 정도 생성한 결과 $0.20정도 차감됨.

  • Stable Diffusion은 오픈소스 코드이기 때문에 가격이 나가진 않지만 GPU가 필요함!!! 이래서 GPU 비용이 나간다..라는 소리가 나오게 됩니다.

DALL-E

저는 오늘 DALL-E로는 Midjourney처럼 (아래 이미지)

  • 처음에 유저가 "브랜드 이미지를 만들어줘"를 누르면

  • 결과값을 2-4개 정도 뱉어내고,

  • 그 4개의 결과물 중에 원하는 버젼을 클릭하면

  • 그 버젼에 맞게 더욱 사진을 고도화 시킬 수 있는 프로젝트를 하나 개발했습니다.

image.pngStable Diffusion

DALL-E로는 text-to-image 기능만 만들어서 이제 본격적으로 스노우 AI 프로필과 같은 Image-to-image 기능을 돌려보고 싶었어요.

어떤 패키지들이 있는지 둘러보다가 Stable Diffusion XL이라는걸 발견했는데 기존의 Stable Diffusion 모델들보다는 예전 훨씬 더 높아지 성능의 이미지 결과물들을 생성한다고 나와있습니다.

모든 기술 documentation은 여기에 있습니다.

https://huggingface.co/docs/diffusers/api/pipelines/stable_diffusion/stable_diffusion_xl

이런 이미지생성 모델들을 돌리려면 transformer, diffusion 모델들을 돌릴 수 있는 GPU가 필요한데 NVIDIA GPU를 가진 동생분이 계시는데 컴퓨터 비번을 안알려줘서 못쓰고 결국 제 맥북에서 돌릴 수 있는 방법만 계속 찾았어요.

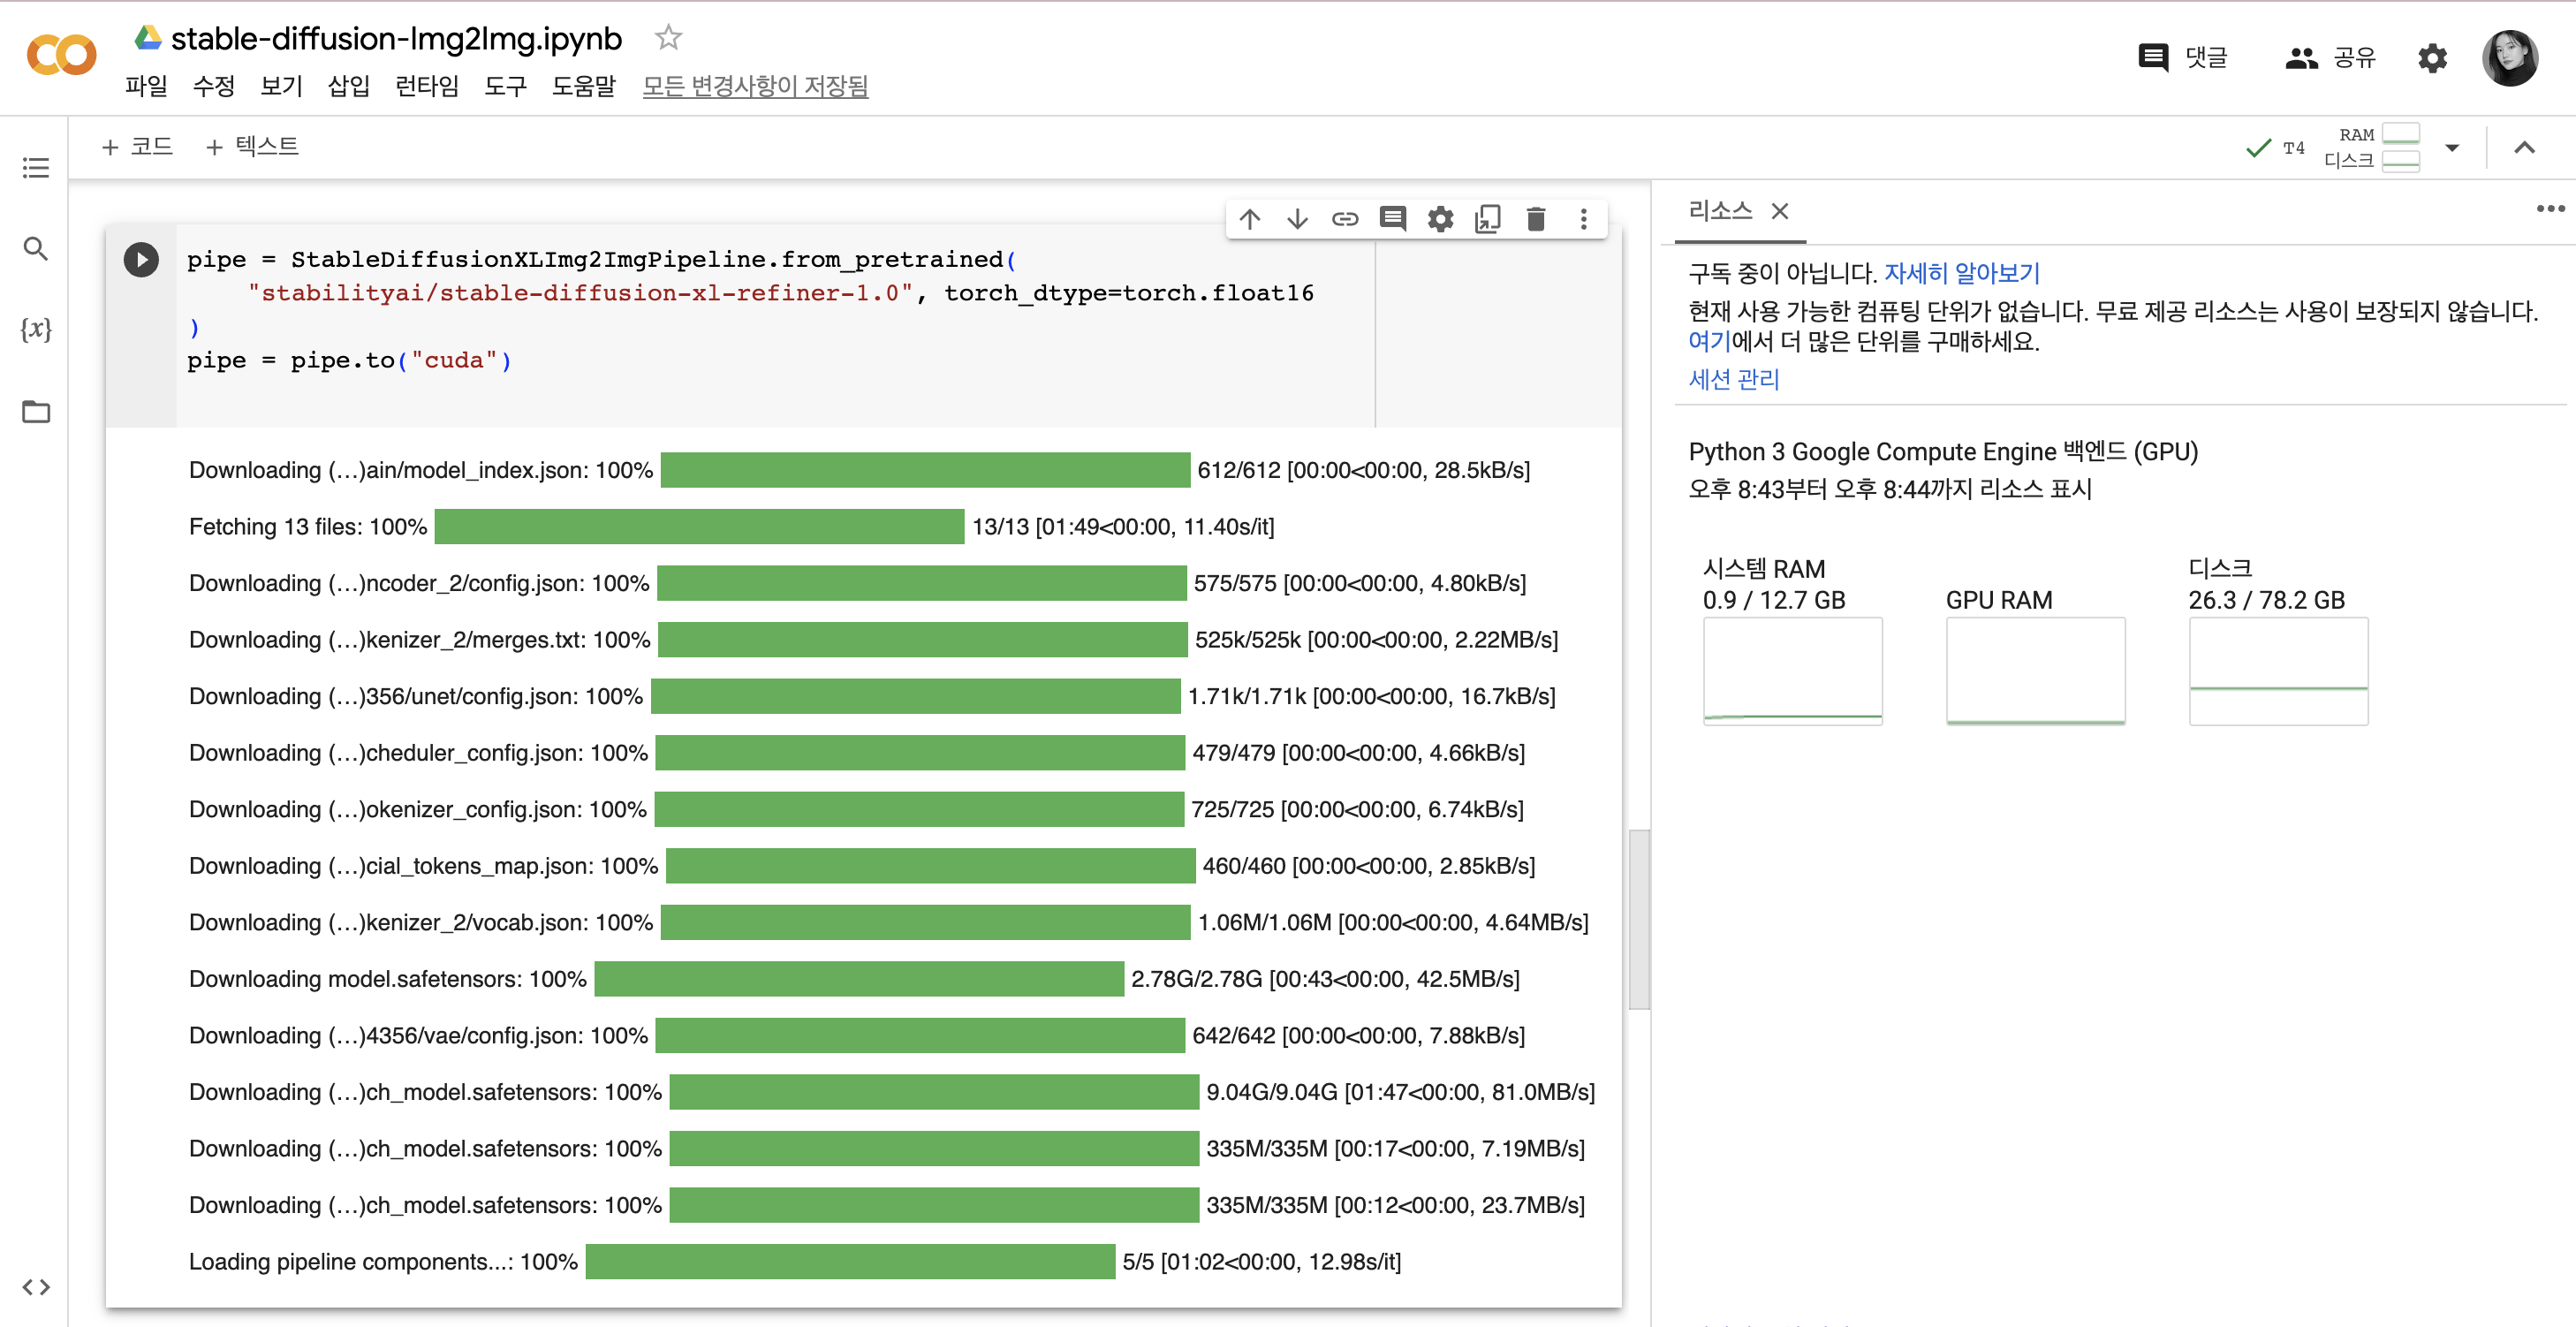
구글 Colab이라는 곳을 쓰면 누구나 브라우저를 통해 임의의 Python 코드를 작성하고 실행할 수 있습니다.

더 기술적으로 설명하면 Colab은 호스팅된 Jupyter 노트북 서비스로, 설정하지 않고 사용 가능하며 GPU를 포함한 컴퓨팅 리소스를 무료로 사용할 수 있습니다!!

Screenshot 2023-09-27 at 8.44.47 PM.png이런식으로 GPU를 무료로 사용할 수 있어요. 환경설정에서 런타임 유형 변경을 누르면 T4 GPU를 쓸 수 있는 환경으로 세팅할 수 있습니다.
Stable Diffusion documentation에서 제공하는 기본 소스 코드를 Colab에서 돌려봤습니다.

import torch
>>> from diffusers import StableDiffusionXLImg2ImgPipeline
>>> from diffusers.utils import load_image

>>> pipe = StableDiffusionXLImg2ImgPipeline.from_pretrained(
...     "stabilityai/stable-diffusion-xl-refiner-1.0", torch_dtype=torch.float16
... )
>>> pipe = pipe.to("cuda")
>>> url = "https://huggingface.co/datasets/patrickvonplaten/images/resolve/main/aa_xl/000000009.png"

>>> init_image = load_image(url).convert("RGB")
>>> prompt = "a photo of an astronaut riding a horse on mars"
>>> image = pipe(prompt, image=init_image).images[0]

그 결과 말을 타고 있는 우주비행사가 나왔어요.

이제 AI 이어북, AI 프로필과 같은 사진들을 만들기 위해서는 조금 더 많은 사진들과 적절한 prompting과 더 자세한 변수값들이 필요할 것 같아요. (10X AI University에서 더욱 상세하게 공개할 예정입니다!)

예를 들어, num_inference_steps=15라는 변수값의 숫자를 높일때마다 사진의 퀄리티가 더 높게 나옵니다.

혹은 negative_prompt의 변수값에는 '이런 유형의 사진들이 절대 나오지 않게 해줘'라고 명시할 수 있습니다.

마무리

오늘은 이미지 생성AI의 활용 사례부터 기술적으로 어떻게 만드는지에 대해 간략히 알아보는 글을 다뤘습니다. 더 많은 활용 사례들이 떠오르신다면 댓글에 달아주세요! 저도 요즘 계속 고민하고 있어서.. 어떤 프로젝트들을 만들어보는게 좋을까요? 🤔

이미지 생성AI는 이렇게 프로필 컨셉 필터로만 활용할때 가장 빛을 내는 걸까요? 브랜드/프로덕트 생성AI 이미지, 혹은 태형님의 https://recipe-p.com/ 와 같은 AI stock image 같은 것들은 평상시에 자주 활용하시나요? 궁금합니다!

깨알 홍보: 10X AI University

10X AI University의 4주차 커리큘럼에서는 이렇게 생성AI 툴들을 활용한 다양한 프로젝트들을 만드는 법을 알려드릴 예정이니 많은 관심 부탁드리겠습니다!

Week 4 생성AI

  • AI 프로필 이미지 생성하기 / 브랜딩 프로덕트 사진 만들기 (DALL-E, Stable Diffusion)

  • 동영상에 AI 목소리와 AI 음악 입히기 (elevenlabs tts)

12
1
Cailyn Yong

Cailyn Yong

20대 중반에 내 자신을 제대로 찾기까지의 과정

아직 2023년이 끝나진 않았지만 올해도 1월부터 9월까지 정신없이 달려온 것 같습니다.

  • 1 - 3월: 블록체인 스타트업 Dev Rel

  • 4 - 5월: Solidity 개발, AI Langchain sideproject 개발

  • 6 - 8월: CtrlX AI 스타트업 창업

  • 8 - 9월: 10X 자기개발 클럽, 10X AI Club 운영, 10X AI University 런칭

  • 10 - 11월: 10X AI University, Disquiet PMC*W23 운영

8월 말부터 10X AI Club을 운영하기 시작하면서 꽤 많은 AI 스타트업 창업가분들과 AI 투자자 분들을 만나며 여러 인사이트들을 얻었고, 10X AI Club 멤버분들과도 배운 점들을 공유드리고 싶어 컨텐츠를 계속 작성했습니다.

이와 별개로, 개인적으로 많은 분들을 만나며 받았던 공통 질문들이 있습니다.

  • 10X AI Club을 운영하는 이유? 수익이 나지 않고 투자 받기도 힘든데 하는 이유?

  • 앞으로 어떤 것을 할건지? 창업을 또 할건지?

10X AI Club을 운영하는 이유?

8월 초에 저는 CtrlX 팀에서 나오기로 결정했습니다. 그 당시 나온 이유는 여러가지가 있지만, 돌이켜보면 제가 제 자신에 대해 여전히 잘 모르고 있었던 것 같고 아직도 찾고 있는 과정이었던 것 같아요. 물론 지금도 여전히 찾고 있지만, 저는 몇개월 전의 제 자신보다는 지금 제 자신을 훨씬 더 잘 알고 있는 것 같고, 무엇을 원하는지, 내가 뭘 잘하는지, 나에게 어떤 것이 맞는지 확실히 알게 됐습니다.

KakaoTalk_Photo_2023-09-25-19-39-33.jpeg2년전에 저는 Eddie라는 첫 스타트업을 창업하면서 아무것도 모르는 상태로 맨땅에 헤딩하며 도전했습니다. 그때 당시에 뉴욕에서 study away 학기를 듣고 있었고, Stern Business School에서 "Getting to Lauch: The Lean Startup Lab" 강의를 수강했습니다. 저는 이 수업에서 스타트업 비즈니스에 대해 배워야할 모든 것들을 이론적인 것부터 배워나갔습니다.
이론적인 것들을 배움과 동시에 저는 실제로 스타트업을 해보고 싶었고, 수업이 시작하고 나서 둘째주에 수강생들은 실제 팀빌딩부터 MVP런칭을 하기 위해 자신의 아이디어들을 피칭하는 시간이 주어져서 저는 이때가 기회라고 생각했습니다. 그때 당시에 저는 교내 교수님들과 학생들이 좀 더 원활하게 커뮤니케이션 하는 것을 도와주고자 학교 LMS 담당 챗봇을 생각했었고, 피칭을 하고 나서는 4명 정도의 학생들에게 연락이 와서 팀을 만들 수 있었습니다.

Screenshot 2023-09-25 at 7.37.56 PM.png저는 수업과는 별개로 실제로 스타트업을 만들고 싶었기 때문에, 같은 아이디어를 들고 뉴욕에 있는 개발자, PM, UI/UX Designer 및 코파운더들을 찾기 위해 여러명과 커피챗을 했습니다. 그 결과 저는 CTO 한명, 그리고 UI/UX Designer 한분을 모시게 됐습니다.
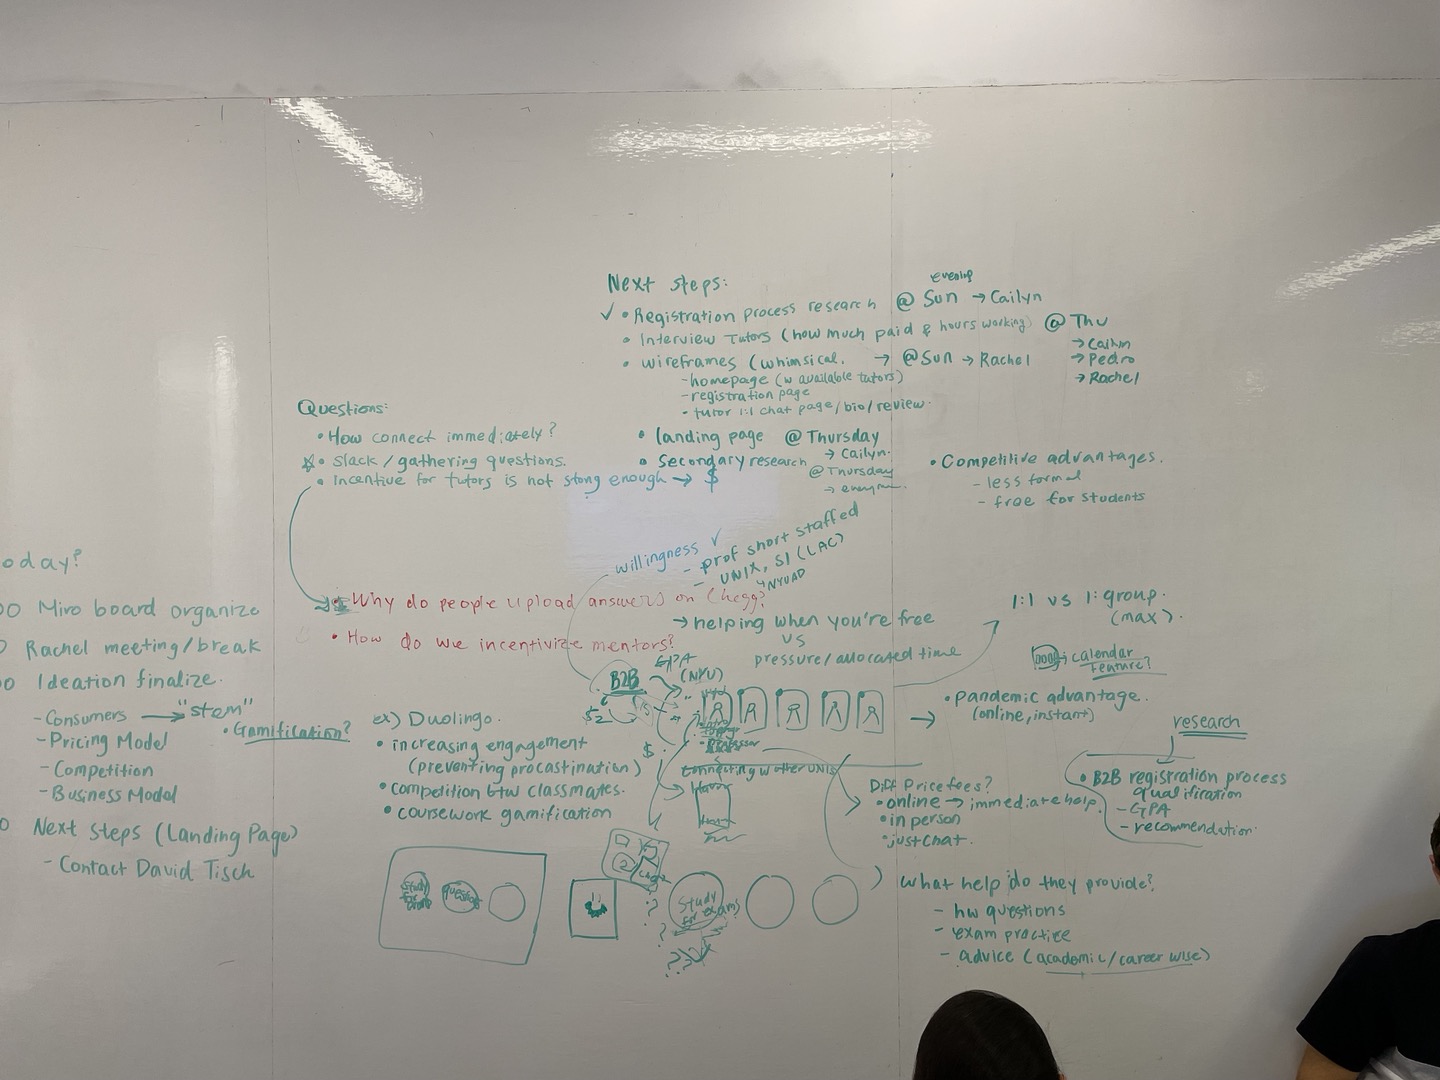
KakaoTalk_Photo_2023-09-25-19-39-37.jpegFast Forward 5개월 뒤, 저희는 여전히 개발을 하고 있었지만 속도가 너무 늦어졌었고, PMF도 찾지 못했지만 막연히 '우리 아이디어는 좋은 아이디어다'라고 생각해서 시장 가설 검증도 하지 않은채 나아가고 있었죠. 그 후 3개월 뒤에 실패라고 인정하기까지 꽤 많은 용기가 필요했고 솔직히 마음이 너무 아팠습니다. 뉴욕에 있는동안 하루도 빠짐없이 스타트업을 하느라 제대로 놀지도 못하고 스트레스가 너무 많아서 밥을 거의 못 먹었었는데, 8개월 뒤에 보니까 제가 집중해야할 문제에 집중을 안하고 그저 내가 믿고 있는 아이디어에만 blind하게 나아가고 있었던걸 깨달으니까 더 현타가 왔던 것 같습니다.
제일 아차 싶었던 점은 수업을 들을 당시에 교수님께서 매 수업마다 강조하셨던 말이 있는데, "제품을 만들때 너희 제품만의 Betty를 찾아야한다."를 놓치고 있었다는 것입니다. 여기서 Betty는 내가 해결하고자 하는 문제점에 대해 깊이 공감을 하며 돈의 금액이 어떻더라도 지불할 의사가 매우 강한 사람, 즉 말 그대로 너의 제품의 열렬한 팬이 될만한 PMF 고객을 찾아야한다는 것이었습니다.

아쉽게도 Eddie는 Betty를 찾지 못했습니다. 그러고 1년 후, 저는 다시 창업에 도전을 합니다.

저는 3월부터 AI sideproject들을 만들면서 직감적으로 느꼈습니다. AI 스타트업은 무조건 해야한다. 이건 단순히 buzzword가 아니라 정말로 이 기술 때문에 세상이 10년 안에 상상조차 할 수 없을 정도로 바껴있을거다라고 느껴서 5월 말에 한국에 들어온 뒤 그 다음주부터 오피스를 구하고 스타트업을 시작했습니다.

Eddie를 하면서 가장 크게 배웠던 것은 어떤 아이디어가 됐든 간에 진짜로 사람들이 깊이 공감할만한 문제를 찾고 나서 해결책을 구해야한다는 것이었습니다. 하지만 저는 시작을 할때부터 오히려 AI라는 기술에 집중을 했기 때문에 더더욱 고객의 니즈파악보다는 기술 위주로 프로덕트 빌딩을 했던 것 같아요. 문제에 집중을 하지 않은채 해결책에 어떻게 AI를 도입할건지 생각을 더 많이 한 것 같습니다.

하지만 두번째 창업을 하고 팀에서 나오면서 느꼈던 건 Eddie때와 같이 "스타트업은 자신만의 Betty를 찾아야한다" 보다는 오히려 "아 내가 스타트업을 하는 이유가 뭐지? 나는 어떤 것을 할때 가장 행복하지?"를 생각하게 됐습니다.

Eddie와 CtrlX를 하게 된 계기의 공통점을 혹시 찾으셨나요? 바로 "창업을 하기 위한 창업"입니다.

제가 진심으로 좋아하는거와 별개로, 창업을 해야만 할 것 같아서, 이걸 하면 내가 바라는 이상적인 삶을 살 수 있을 것 같아서였습니다. "성공"을 이루기 위해 저는 정말 단순히 스타트업을 하면 할 수 있을거라 생각했습니다. 회사에서 직원으로 고정 수입을 받으며 일하는 것보다 스타트업을 하면 내가 원하는만큼의 돈을 벌고 남을 더욱 빨리 도와줄 수 있다고 생각했습니다.

지난 1년동안 블록체인 스타트업에서 일하면서, 그리고 CtrlX를 하면서 되게 많이 느꼈던건 imposter syndrome인데, 어느 환경에 놓여있어도 뭔가 자꾸만 제 역량을 풀 포텐셜로 발휘하지 못하고 혼자서 겉도는 것 같은 느낌이 들었습니다. 저는 여태까지 제가 진짜 좋아하는 것과 제가 잘하는 것을 잘 모른채 다른 사람들에게 끌려다니는 느낌이었습니다.

그래서 팀을 나오고 1주일동안 생각정리를 했을때 나왔던 리스트입니다.

  • 다른 사람들에게 내가 배운걸 공유하는걸 좋아한다

  • 나는 새로운 사람들 만나는걸 좋아한다

  • 다른 사람들의 문제를 해결해주는걸 좋아한다

  • 나는 self-branding을 꽤 잘한다고 생각한다

  • 상대방을 설득시키고 나를 믿게 하는걸 잘한다

이런걸 다 합쳤을때 자연스럽게 커뮤니티 운영이 떠올랐기 때문에 그 주에 10X 자기개발 클럽과 10X AI Club을 런칭하게 됐습니다. 10X AI Club은 어쩌면 제가 살면서 처음으로 진짜 좋아하는걸 행복하게, 제재 없이 무한대로 역량 발휘할 수 있는 곳이라고 생각합니다.

그럼 앞으로 어떤 것을 할건지?

창업이든, 회사 일이든, 공부든, 어떤걸 시작할때 자신이 진심으로 좋아하고 잘하는 것이여야 끝까지 갈 수 있는 힘이 생기는 것 같습니다. 저는 이걸 꽤 최근에 제대로 깨달아서 스스로 좀 놀라기도 했고 이걸 왜 이제서야 알았나 싶어요. 그치만 깨닫고 난 후에는 처음으로 진짜 자유롭다라는 생각이 들었고 제가 하고 싶은걸 잘할 수 있다는 자신감이 생기니까 더 행복해졌습니다.

앞으로 또 창업을 할거냐라고 질문을 많이 받았어서 몇주전까지만 해도 "지금 당장은 안할것 같아요"라고 대답했었는데 사람이 쉽게 바뀌나요? 하하

창업의 형태는 다양할 수 있다는것도 최근에 깨달았습니다. 모든 스타트업은 유니콘이 될 필요도 없고, 엑싯을 위한 창업을 해도 되고, 공동창업자가 없어도 됩니다. Passive income을 위한 창업이어도 좋고, 라면을 사기 위해 하는 창업이어도 좋다고 생각합니다. 무언가 대단한 임팩트를 내기 위해 유니콘이 되겠다는 결심도 정말 너무너무 좋고 필요하지만, 지금의 저는 라면 수익성에 더 집중을 하게 되는 것 같고 제 관심사와 성격과 더 잘 맞는 것 같습니다.

어떻게 될진 저도 잘 모르긴한데 이미 머릿속으로는 세워놓은 계획들이 몇개 있어서.. 이렇게 갈 것 같네요.

  • 10X AI Club은 국내 최대 AI 커뮤니티가 된다. 단순히 사이즈보다는 정말로 사람들에게 도움이 되는 커뮤니티가 될 것이다.

  • 10X AI Club의 Substack, Twitter, LinkedIn 뉴스레터와 Youtube podcast/개발 과정 동영상 업로드

  • 10X AI University를 통해 라면 수익성을 얻고 모든 사람들이 한번이라도 AI 개발을 해보게 한다. 한번이라도 직접 자신의 업무에 AI 툴을 활용할 수 있게 한다.

마지막으로 제 자신에 대해 좀 더 제대로 이해하고 찾기까지 도와준 책을 소개합니다:

다크호스

성공의 표준 공식을 깨는 비범한 승자들의 원칙

https://product.kyobobook.co.kr/detail/S000000710685

32
12
Cailyn Yong

Cailyn Yong

10X AI University 런칭: 누구나 따라할 수 있는 AI 활용 사례들 (얼리버드 할인)

Modern Minimalist Business Card (1).png

안녕하세요, 10X AI Club에서 10X AI University를 출시합니다!

10X AI University에서는 AI를 활용한 여러 사이드프로젝트들을 직접 만들어보고 실제 업무에 적용시킬 수 있도록 강의들을 출시할 예정입니다.

두가지 코스가 있으며, 자신의 목표와 취향에 맞게 고를 수 있습니다.
1. AI Developer Bootcamp 패키지는 개발 위주로, 실제 GPT4, LLM, 생성AI 모델들을 쓰면서 직접 코딩하며 프로젝트들을 개발해 볼 수 있습니다. (10/10 출시 예정)
2. Road to AI Business 패키지는 노코드 툴 위주로, AI 툴들을 실제 업무 환경에 적용시켜서 써볼 수 있습니다. (추후 출시)

👾 AI Developer Bootcamp

이 코스는 GPT 모델, LLM, 생성형 AI 모델들을 직접 활용해서 사이드프로젝트들을 개발해 볼 수 있도록 가르쳐드립니다. 코딩에 대해서 전혀 모르셔도 됩니다. 초보자여도 이해할 수 있게끔 모든 개발 과정을 하나하나 알려드립니다. VSCode를 쓰는 것부터, 내가 만든 코드 파일을 github에 올리는것 까지 도와드립니다.

코딩 과정부터 동영상, 설명 텍스트, 매주 새로운 프로젝트들이 있으며 맨 마지막 주에는 여태까지 배운 것을 토대로 자신만의 파이널 프로젝트를 만들어 공유해주시면 수료증을 발급해 드립니다.

매주 새로운 주제의 사이드프로젝트들을 여러 개 만들고 익숙해지면 앞으로 어떤 GPT/LLM 프로젝트도 쉽게 접근할 수 있습니다. 나만의 아이디어를 파이널 프로젝트로 직접 만들어보세요!

맛보기 강의들을 확인해보세요!

📚 커리큘럼 (7주, 초보자 입문 레벨)

공통

  • VSCode 설치 및 활용법, Github 사용법

  • 모든 소스코드 공유

  • 추천 리소스 공유

Week 1 기본기 다지기

  • 온라인 쇼핑 대신해주는 에이전트 만들기 (Langchain, LLM, OpenAI)

Week 2 업무 자동화

  • 채용 과정 자동화 에이전트 만들기 (이메일 보내는것까지)

Week 3 챗봇

  • 내 비즈니스 전용 고객 지원 챗봇 만들기

Week 4 생성AI

  • AI 프로필 이미지 생성하기 (or 회사 브랜딩 프로덕트 사진 만들기)

  • 동영상에 AI 목소리와 AI 음악 입히기 (elevenlabs, meta)

Week 5 캐릭터 AI

  • 카카오톡 대화를 활용한 나만의 캐릭터 AI 만들기 (or 디스코드나 슬랙 회사 봇 만들기)

Week 6 업무 자동화

  • 마케팅/뉴스레터 업무 자동화 에이전트 만들기 (콜드메일까지)

Week 7

  • 나만의 파이널 프로젝트 만들기

💰 가격: 500,000원 1차 얼리버드 할인: 30%, 350,000원

📆 기간: 7주

🧑‍💻 레벨: 초보자 입문

10월 10일 출시 전까지 신청하시는 분들에겐 AI Developer Bootcamp 얼리버드 할인을 해드리니 아래 Tally로 waitlist 신청해주시면 감사하겠습니다!

혹시 위에 나와있는 커리큘럼 외에 추가로 해보고 싶은 프로젝트, 추천하고 싶은 아이디어가 있다면 댓글로 달아주세요!

16
4
Cailyn Yong

Cailyn Yong

국내 AI 스타트업 씬 한번에 직접 체험해보고 배워가기 (Pre-Networking & PMC*W23)

PMC * W23 Pre-Networking

안녕하세요!

이번에 10X AI Club이 Disquiet과 함께 AI & SaaS 네트워킹 이벤트를 엽니다.

AI 스타트업을 빌딩하고 있는 창업가 분, 개발자 분, 자신의 기존 비즈니스에 AI를 도입하고 싶은 SaaS 팀들, 혹은 진짜 아무것도 모르는데 사이드프로젝트를 만들어보고 싶거나 배워보고 싶은 분들을 위한 이벤트입니다.

정말 마음 편하게 오셔도 되구, 이벤트 내에 있을 연사분들에게 질문들도 실컷 할 수 있도록 이벤트 구성을 했으니 많은 참여 부탁드리겠습니다!

참가 신청하기

연사 리스트업

  • 코르카 대표님, ML 엔지니어

  • Dalpha 대표님, BD/Sales, Co-founder

  • KB 인베스트먼트 심사역

  • ...그리고 저도 10X AI Club을 대표해서 자유 네트워킹에 참석합니다!

참가 혜택

  • PMC*W23 선발 우선순위 부여

  • 디스콰이엇 팀 플랜 무료 온보딩

  • 맛있는 음식과 위스키..가 가장 중요하니까요 😉

PMC*W23은 뭔가요?

PMC는 디스콰이엇 팀에서 매 분기마다 여는 Product Maker's Club으로, 좋은 프로덕트를 만드는 것에 진심인 메이커를 모아, 메이커로그 쓰는 과정을 최대한 쉽고 빠르게 할 수 있도록 도와주는 동시에, 서로 인사이트를 나누고 각자의 목표를 달성할 수 있도록 지원합니다.
이번에는 PMC 주제가 AI & SaaS가 되어, 제품 개발, 고객 발굴, 팀 빌딩, 투자 유치에 고민을 겪고 있는 AI & SaaS 메이커를 최소 50팀 모집합니다.

6주 동안 함께 하며 매주 메이커로그를 업로드하며, AI 팀빌딩을 하고 있는 다른 분들과 네트워킹, 그리고 PMC 파트너 연사분들께도 조언을 받을 수 있습니다.

이번 PMC*W23 파트너 분들은 Corca, Dalpha, Fountain, KB 인베스트먼트, Smoretalk, Step Pay, 10X AI Club, 그리고 아산나눔재단입니다.

참가 보상 (공통)

1) KB 인베스트먼트의 IR 검토 및 피드백

2) Dalpha AI 팀에서 프로덕트에 AI를 도입할 수 있도록 무료 컨설팅 제공

3) 스모어톡 플라멜 500 크레딧 제공 (이미지 500개): AI Image Assistant 플라멜

4) 스텝페이 서비스 3개월 무료 이용권 제공

지원 분야별 완주보상

  • 제품 개발 - Dalpha AI Store 데모 토큰 추가 제공, 실 계약 체결 원하는 완주자에 한해 최우선순위 배정

  • 고객 발굴 - 디스콰이엇 뉴스레터 콘텐츠 발송 및 최상단 배치

  • B2B SaaS 메이커, C레벨 위주의 1000여명 이상의 구독자를 보유하고 있는 뉴스레터에 콘텐츠 발송

  • 각 콘텐츠 최상단에 해당 팀이 원하는 액션(CTA)를 삽입 가능

  • 팀 빌딩 - 디스콰이엇 팀 Pro 플랜 6개월 제공(54만원 상당)

  • 팀 페이지, 채용 공고, 커피챗, 메이커리스트 탐색 필터 기능 활용 가능

  • 투자유치 - 최소 1팀 이상 KB 인베스트먼트에서 투자 진행

더 자세한 내용은 아래 링크에서 확인하실 수 있습니다.

16
11
Cailyn Yong

Cailyn Yong

팀러너스 만난 후기.. 보다는 어떤 유저 페르소나에 집중을 해야하는지에 대한 글

KakaoTalk_Photo_2023-09-16-21-06-52 001.jpeg제목이 꽤 기네요.

어제 정말 운좋게도 팀러너스 사무실에 초대돼서 매주 금요일마다 하는 일주일 회고 회의에 참여할 수 있었습니다.

팀러너스는 아니나 다를까 일주일 안에 또 새로운 제품들과 기능들을 미친듯이 출시했더라구요. 저번 AGI Town 밋업에서 공식적으로 발표한 트윅: AI 사진 & 커뮤니티 제품에 대한 개발을 하고 있었습니다. (다들 다운받아서 써보세요!ㅎㅎ)

제가 사무실에 놀러갔을 때에는 생성AI를 기반으로 한 영상들을 틱톡처럼 업로드할 수 있는 기능을 갓 출시한 상태였습니다. 예를 들어 "내 사진 + 틱톡 챌린지 영상"을 합쳐서 만들면 내 얼굴이 합성된 틱톡 영상이 바로 만들어지는 기능입니다. 내가 직접 춤을 안춰도 AI가 바로 만들어주는..

팀러너스의 @donggie 님과 꽤 오랫동안 얘기를 나눴는데, 그 중에서 가장 인상 깊었던, 하루가 지난 오늘까지도 꽤 오랫동안 고민하게 만들었던 대화 내용 + 생각들을 기록합니다.

KakaoTalk_Photo_2023-09-16-21-06-52 002.jpeg

Cailyn: 이 모든 생성 기능들이 무료면 서버비용 어떻게 감당하세요?

동기님: 저희 목표는 무료화를 통해 최대한 많은 유저들을 플랫폼에 데리고 오는 것입니다.

그 후 대화를 이어나가다가, 동기님께서 갑자기 면접 테스트와 같은 질문을 던지셨어요.

동기님: 트윅에서 제품 개발을 할때 기존 프로필 이미지 생성 기능의 퀄리티를 높여야할지, UI/UX를 더 좋게 만들어야할지, 아님 새로운 기능(동영상)을 추가하는 것에 집중해야할지 - 셋중에 어느 것부터 우선순위로 둬야할까요?

Cailyn: 유저들은 무엇을 원하는데요? 데이터가 어떻게 돼요?

동기님: 유저들은 대부분 얼굴 수정할 수 있는 기능과 눈/손이 더 퀄리티 높게 나오길 원합니다.

Cailyn: UI/UX가 구려도 핵심 기능만 성능이 좋게 나온다면 리텐션은 높을 것 같아요. 그렇기 때문에 기존 프로필 이미지 생성 기능의 퀄리티를 높이는거에 집중해야하지 않을까요?

동기님: 승진님(팀러너스 대표님)은 새로운 동영상 기능을 만들기로 결정하셨어요.

Cailyn: 정답은 없는 것 같아요. 유저들은 새로운 서비스들이 출시될때 실제로 사용해보지 않는 이상 이게 정말로 필요했던 건지 모르기 때문에 그 방향으로 가는것도 좋은 것 같아요. 예를 들어 우리는 우버가 처음 나왔을때 모르는 누군가와 함께 택시를 탈거라는 상상을 못했었으니까.. 결국엔 그냥 더 빨리 많이 만들어보고 시장과 부딪혀보는 팀이 이길 것 같네요.

집에 돌아가고 난 후에도 이 대화가 왠지 모르게 자꾸만 머릿속에 밟혔습니다. 저도 창업을 할때 매번 어떤 기능들부터 만들어야하는지 고민을 너무 많이 했었던 경험이 있어서요.

그러다가 오늘 아침에 우연히 "The Tyranny of the Marginal User"이라는 글을 읽게 됐습니다. 이 글은 대부분의 소프트웨어 앱들이 "minimal user agency"의 방향으로 가고 있다는 것이었습니다.

여기서 minimal user agency는 많은 유저들을 온보딩하기 위해 실제로 앱에는 무의미한 기능들을 만들어 유저들이 무한한 스크롤링을 하며 시간을 보낼 수 있도록, 별로 퀄리티가 높지 않은 컨텐츠만 득실거리는 방향으로 무의식적으로 간다는 것입니다.

예를 들어 구글 서치 조차도 검색을 하면 너무나도 많은 광고 사이트들과 실제로 가치를 제공해주지 않는 결과물들이 나옵니다. 이렇게 되는 이유는 '실제로 유의미한 가치를 제공하지 않는 유저임에도 불구하고 회사의 목표가 최대한 많은 사람들을 데리고 오는게 목표'가 되기 때문입니다.

그럼 이런 질문들을 던질 수 있습니다.

  • 이런 유저여도 네트워크와 커뮤니티가 커지는거에 기여한다면 좋은거 아닌가요?

  • 실제로 앱의 사용자수가 수백만명일때에는 기존 사용자들의 유저 경험보다는 새로 유입된 유저들이 플랫폼을 떠나지 않도록 하는게 더 많은 이익 가치를 제공해주지 않을까요?

결론적으론 그렇긴 합니다. 생각보다 기존 사용자들을 꽤 오랫동안 냅둬도 앱에 머무르고, 설사 떠난다해도 새로 유입된 유저들때문에 제품은 점점 커져서 수익도 그만큼 높아지기 때문이죠.

그래서 현실에서는 대부분의 앱 디자인들이 이런 "marginal user"에게 포커스 된다는 것입니다.

이 글을 너무 흥미롭게 읽어서 팀러너스 개발자인 건우님한테도 공유드렸습니다. 이 문제에 대한 완벽한 정답은 정말 없는 것 같습니다. 그저 스타트업의 미션과 목표가 어떤것인지에 따라 달린 것 같아요.

하지만 성장을 위해서 이런 방향으로 가는게 과연 불가피한지는 더 고민해봐야할 것 같습니다. 좀 더 건전한 방향으로, 퀄리티 높게 갈 수 있을까요? 애초에 가능한가요? 이 방향으로 너무 끌려다니지 않기 위해서는 어떻게 제품 개발을 해야하는지, 무엇부터 우선순위가 돼야하는지 재미있게 고민해볼 수 있을 것 같아요.

실제로 제가 사용하는 기존의 앱들 중에 정말 심각하게 "아 퀄리티 왜 이러지? 못 쓰겠네"하고 삭제한 앱은 여태까지 별로 없었던 것 같긴해요. (정말 쓰렉 아닌이상..) 알고보니 내가 항상 marginal user였던걸로ㅋㅋ

20
4