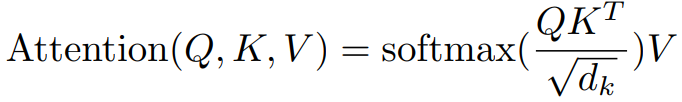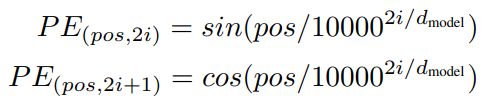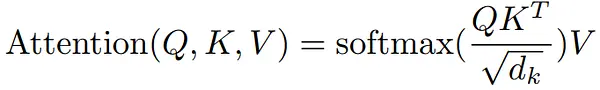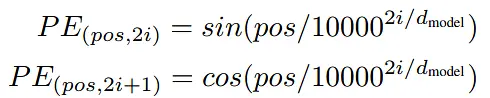임세진

임세진님의 아티클

임세진

임세진

물리학과 입학

"탈 물리는 지혜 순이다."

"우리는 물리를 좋아했지만, 물리가 우리를 싫어한다." (과거형에 눈여겨보라...)

이는 물리학과 학부생들 사이에서 도는 밈들이다.

이토록 악명 높은 물리학과에 입학했다.

하지만 생각하는 자유함이 좋았던 나는 적성에 맞았는지, 상상의 나래를 구체화 시키는 도구로 물리학을 채택하게 되었다.

물리학은 사고를 구체화 시키는 아주 좋은 도구이다.

누군가는 수학도 그러지 않냐? 라고 되물을 수 있다. 하지만, 부분적으로만 맞다고 답할 수 있게 되었다.

수학은 사고를 구체화 시키는 현존하는 가장 좋은 도구이다. 하지만, 실제 현상과 연결 짓는 부분에서는 많은 것이 생략되어있다.

수학과 물리학의 가장 큰 차이점은 사고 실험과 실제 실험을 통한 검증 과정의 유무이다. 수학은 현상을 설명하는 데 중요한 이 두 가지가 없다.

물리학의 이런 장점 덕분에 수업을 듣다가 주로 상상의 나래에 빠져서 수업 내용과 관련된 현상을 손으로 풀고는 했다.. (좋은 건가...???)

예를 들어 버스 배차 시간이 15분인 버스를 아무 때나 버스 정거장에 도착했을 때 10분 이내에 탈 확률이 얼마나 될까?와 같은.. (이는 포아송 event로 생각하면 된다.)

인생 선택 기록장 @휴튼

4
3
임세진

임세진

LLM 스터디 #4

LLM 스터디를 하면서 개괄적으로 파악한 내용

우선 CNN이나 RNN 기반일 때까지만 해도 메모리 문제로 인해 정확한 대용량 언어 처리가 불가능 했습니다. 입력 시퀀스를 하나의 벡터 표현으로 압축해서 사용했는데, 이로 인해 정보 손실이 발생했던 것으로 추측됩니다. 그러나 Transformer 모델이 등장하고 나서 실질적으로 LLM이 가능해진 것으로 생각됩니다.

또한 Transformer 모델은 Attention Mechanism만으로 기존의 CNN, RNN 의존도를 없애려고 했습니다. 따라서 RNN으로 파악했던 언어의 위치 정보를 Positional Encoding이 대신하게 된 것이죠. 그리고 기존의 Attention Mechanism과 동일하게 언어 사이의 관계 및 중요도를 Attention Value로 기술을 합니다. 토큰들의 위치 정보(via Positional Encoding)와 매 출력 마다 집중해서 참고해야 할 입력 토큰들(via Attention Mechanism)로부터 입력된 토큰들의 시퀀스 다음에 올 토큰이 무엇인지 예측을 하게 됩니다.

다시 정리해보자면.... (스킵하셔도 됩니다)

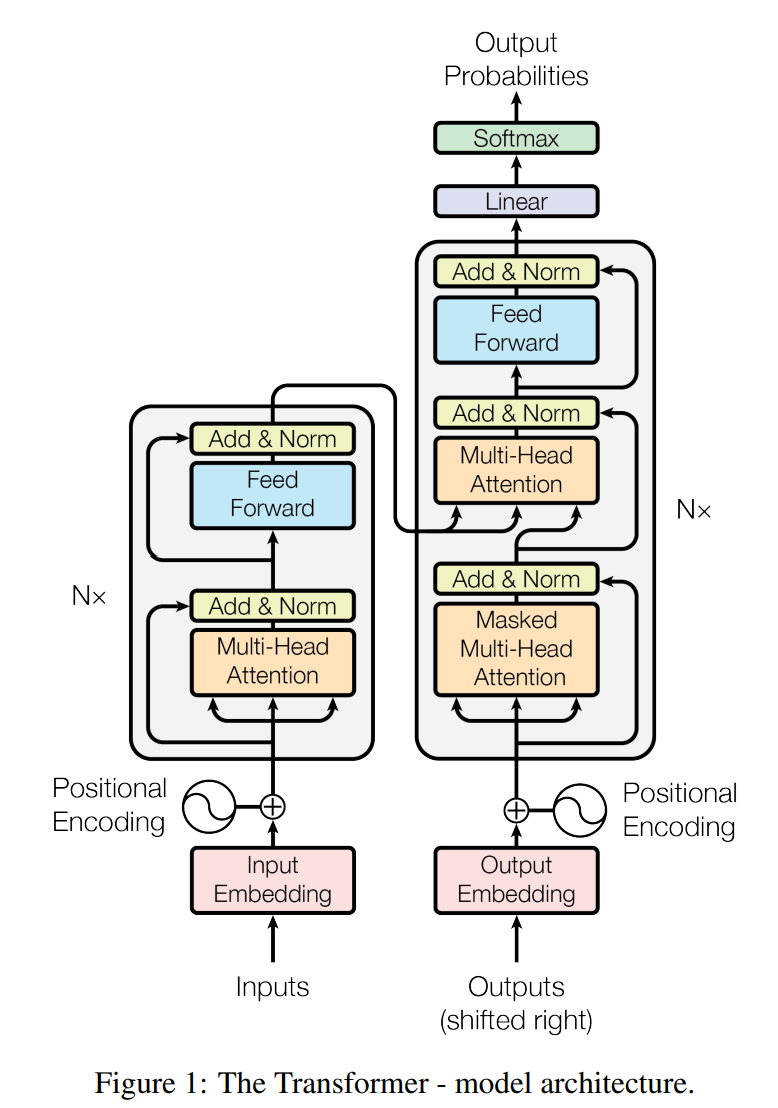
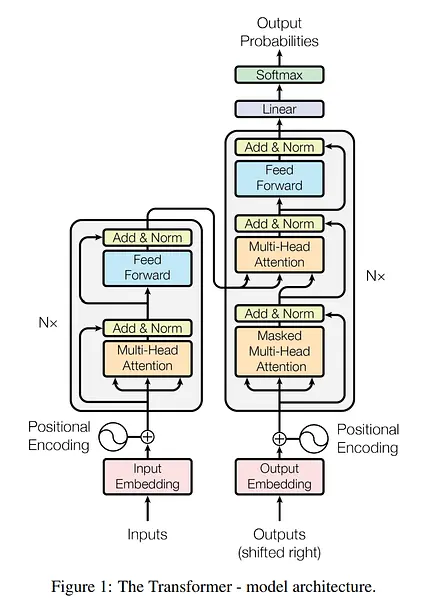
Transformer Model 모식도 입니다.
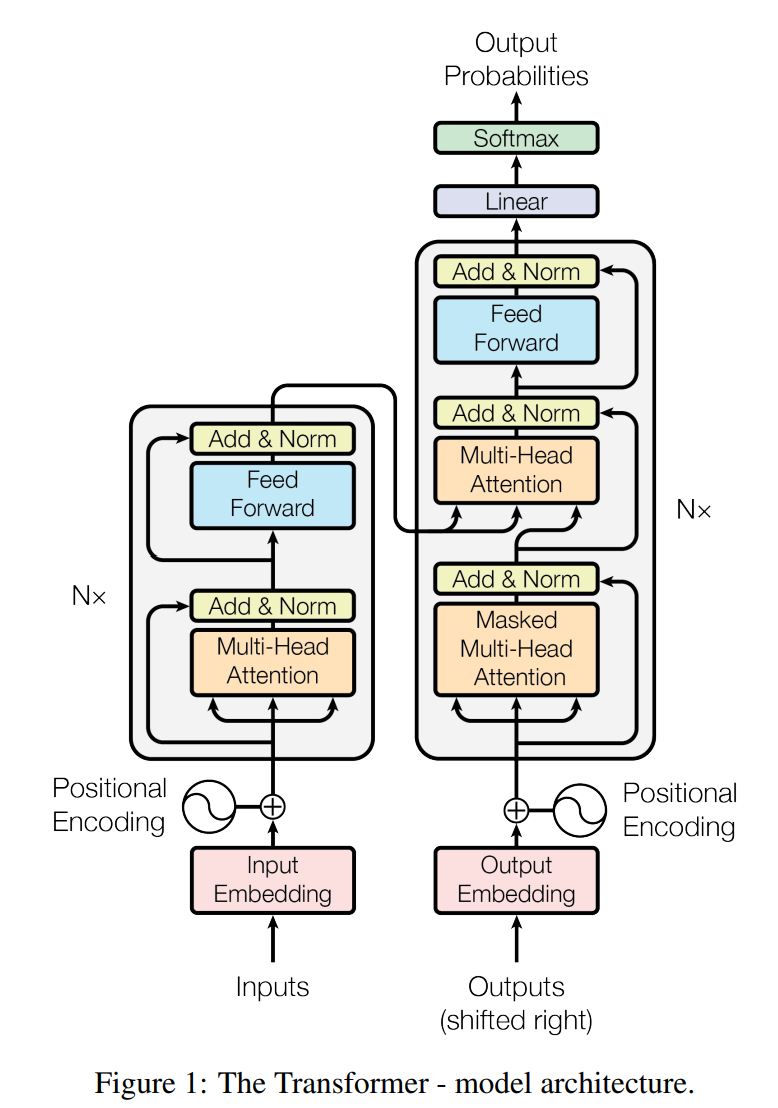
Transformer Model.png

좌측이 Encoder, 우측이 Decoder입니다.

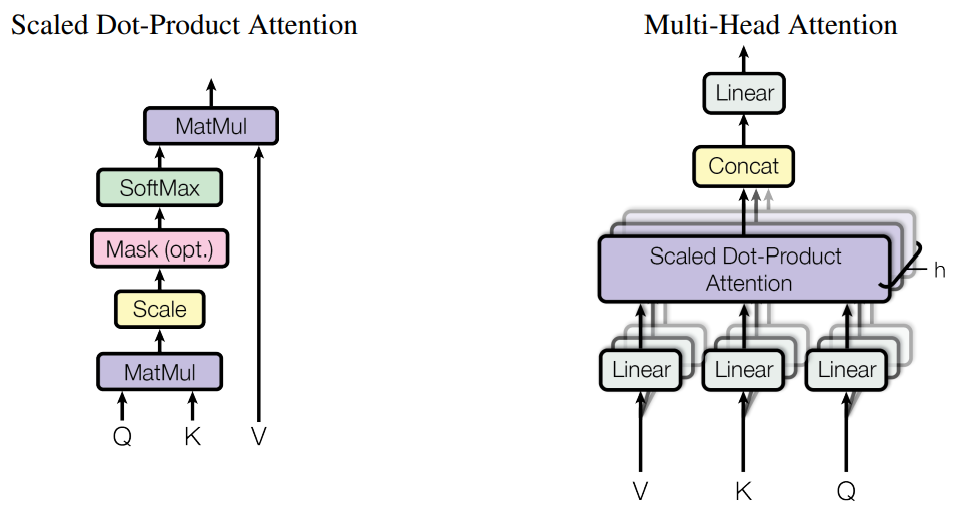
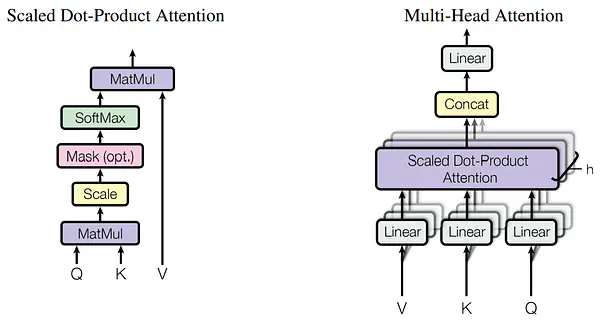
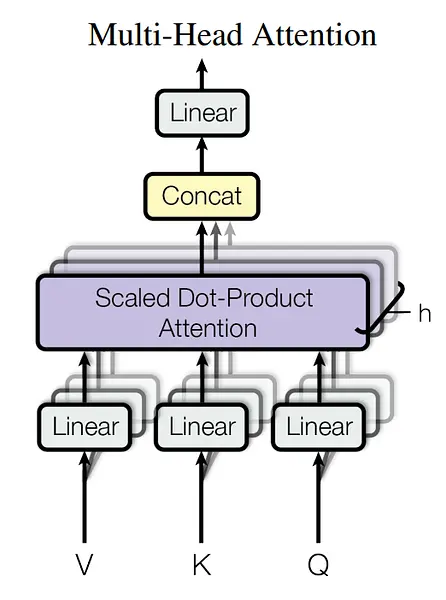
Multi-Head Attention 모식도입니다.
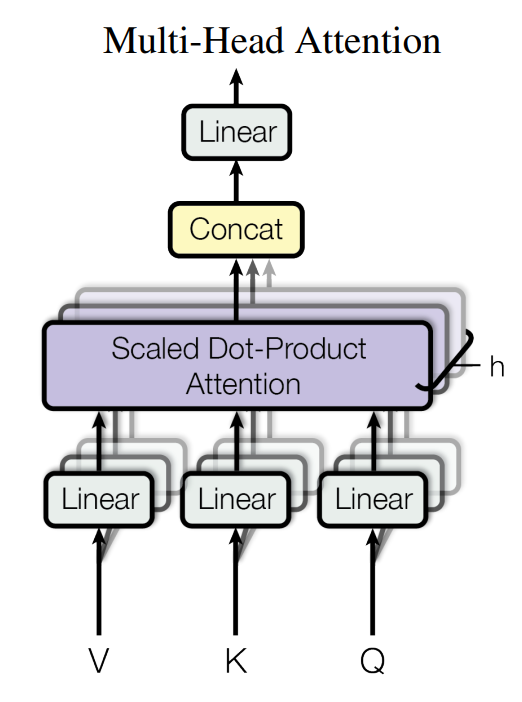
multi_head_attentioin.png

Encoder에서 Key, Value, Query 값은 각각 의미하는 바는 다음과 같습니다.

Key: 입력 시퀀스의 tokenize된 수치 (입력된 문장의 단어들을 위치 벡터로 라벨링)를 64차원으로 변환 (d_model=512, num_head=8이기 때문)

Value: Key와 동일한 값

Query: Key와 동일한 값

Attention Value Matrix:
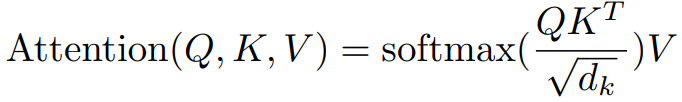
Scaled_dot_product_formula.png

Decoder에서의 Masked Self Attention에서 Key, Value, Query 값의 의미는 다음과 같습니다.

Key: 출력 시퀀스의 tokenize된 수치 (입력된 문장의 단어들을 위치 벡터로 라벨링)를 64차원으로 변환 (d_model=512, num_head=8이기 때문)
Value: Key와 동일한 값
Query: Key와 동일한 값
Attention Value Matrix

Decoder에서의 Self Attention에서 Key, Value, Query 값의 의미는 다음과 같습니다.

Key: Encoder에서 Attention Value Matrix
Value: Encoder에서 Attention Value Matrix
Query: Decoder에서 Attention Value Matrix

이상... 크게 특별할 건 없었던 LLM 스터디를 일단락 지어보도록 하겠습니다..(꾸벅)

다양한 산업들에서 Transformer 모델을 활용하여 다양한 Task들이 비교적 손쉽게(?) 처리될 수 있으리라 기대됩니다.

< 참고 논문 >

Attention Is All You Need

https://arxiv.org/pdf/1706.03762.pdf
6
1
임세진

임세진

스무 살 때 나는 어떤 일을 하고 싶었나?

놀랍게도... 물리학과에 진학해서 물리학과의 진로가 어떻게 되는지 1학년 1학기에 듣자마자 개발하는 물리학자가 되어 밥벌이를 하자라는 생각이 들었다.

그래서 1학년 때부터 방학 때마다 코딩 연습을 꾸준히 했다. 대학교~대학원 생활 내내 코딩을 놓은 적은 없었던 것 같다. 오히려 갈수록 의존도가 높아졌다.

결국 첫 직장을 데이터 과학자의 포지션으로 알고리즘 개발을 맡게 되었다. 나름(?) 원했던 일을 시작하게 된 셈이었다.

물론 첫 직장에서 진정한 의미의 데이터 과학을 많이 다뤄보지는 못했다는 아쉬움이 남지만... 지금 원 없이 해보고 있으니 현재 생활은 만족스럽다.

계란한판 @휴튼

5
0
임세진

임세진

일을 즐기는 법

워라밸을 강조하는 것은 하는 일이 재미있고, 보람차면 사라지는 것 같다.

일이 잘 되면서 재미가 있으려면, 일에서 재미 요소를 발견해야 한다고 생각한다.

수많은 좋은 서비스들에서는 사용자들의 Gamification의 요소가 들어있다.

그리고 사용자들의 Gamification을 설계할 수 있는 사람들이라면, 본인들의 업무를 할 때에도 재미 요소들을 충분히 설계할 수 있는 사람들일 것이다.

사용자들이 즐겁고 재밌는 경험을 얻어가는 것도 중요하지만, 이런 좋은 서비스가 나오기까지의 과정들에서는 개발에 참여하는 사람들도 즐겁고 재밌는 경험을 해야 한다고 생각한다.

프로젝트에 참여하는 개개인도 현재 내가 하는 일에서 어떤 것이 재미있을지 본인에게 스스로 질문하면서 여러가지 소소한 시도들을 해봐야 한다고 생각한다.

이 게시글은 언젠가 하는 일에 흥미를 잃을 뻔할 나를 위하여 작성해둔다.

2
3
임세진

임세진

LLM 스터디 #3

트랜스포머 모델 아키텍쳐

Transformer Model.png

1. Inputs & Outputs

  • 입력 시퀀스: (x_1, ..., x_n)

  • Encoder 결과물(hidden layer): (z_1, ..., z_n)

  • 출력 시퀀스: (y_1, ..., y_m)

  • 위의 트랜스포머 모델에서 좌측이 Encoder, 우측이 Decoder에 해당됨

2. Multi-Head Attention

attention.png

Scaled Dot-Product Attention

  • Q: 쿼리 값(문장 속 낱말들을 임베딩 한 결과), K: key 값(낱말들에 대한 정보를 제공하는 값) , V: value 값(key 값의 의미를 수치 값으로 갖고 있음)

  • keys의 차원: d_k

  • values의 차원: d_v

  • 각 토큰을 임베딩하는 차원: d_model (d_model 차원의 vector로 문자들을 구분할 수 있다.)

  • h: 평행한 어텐션 레이어 개수

이 연구 논문에서는 d_k = d_v = d_model / h = 64, h = 8로 두었다. (d_model = 512)

Scaled Attention을 수식으로 간단하게 표기 :

Scaled_dot_product_formula.png

3. Positional Encoding

PE.png

  • Positional Encoding을 통해 문자들의 위치를 d_model 차원의 좌표(위치 벡터)로 변환하여 표현할 수 있다.

  • 그리고 해당 위치에 있는 문자가 바뀌어도 Positional Encoding의 결과물은 바뀌지 않는다. (위치에만 종속되어 있는 값이다)

  • pos: 시퀀스 내의 임의의 토큰의 위치

  • i: d_model 차원 이하의 차원

https://arxiv.org/pdf/1706.03762.pdf
12
4
임세진

임세진

LLM 스터디 #2

간략한 논문 리뷰: Attention Is All You Need #1

시퀀스 변환 모델은 Encoder와 Decoder를 포함하는 복잡한 RNN이나 CNN을 기반으로 합니다. 그리고 어텐션 메커니즘으로 Encoder와 Decoder을 연결한 모델이 가장 성능이 좋은 모델이었습니다. 이에, Google 연구팀에서는 어텐션 메커니즘만을 기반으로 하는 트랜스포머 모델을 제안하게 됩니다.

RNN은 기본적으로 입력 시퀀스 데이터의 token 위치와 출력 시퀀스 데이터의 token 위치에 대해 계산을 하게 됩니다. 조금 더 상세하게 표현하면, RNN은 바로 이전 데이터가 t-1 시점의 입력 데이터이면, t 시점에 올 데이터를 예측합니다. 이러한 시퀀스의 기본적인 특징으로 인해 학습 데이터들의 병렬화가 되지 않습니다. 그리고 이것은 데이터의 길이가 길수록 더욱 중요해지는 문제가 됩니다. 메모리의 한계로 인해 학습 효율이 많이 떨어지게 되죠. 물론 이 또한 어느 정도는 개선이 되었지만, 아직 효율성의 문제점은 남아있었습니다.

어텐션 메커니즘은 출력 데이터의 길이에 상관 없이 token들 사이의 연관성을 모델링 할 수 있습니다. 그러나, 대부분의 케이스들에서 어텐션 메커니즘은 RNN과 같이 사용되었습니다.

이 논문에서, Google 연구팀은 RNN을 피하고 어텐션 메커니즘에 전적으로 의존하는 트랜스포머 모델을 제안합니다. 그리고 이는 입력 데이터와 출력 데이터 사이에서 global한 token들 사이의 연관성들을 이끌어 냅니다. 이 때문인지는 몰라도, 트랜스포머 모델은 훨씬 더 많은 병렬화를 할 수 있게 됩니다.

모델 아키텍쳐에 대한 글은 다음 번 기록에서 남겨볼게요~

(논문 읽다가 오해한 부분이 있어 정정했습니다)

https://arxiv.org/pdf/1706.03762.pdf
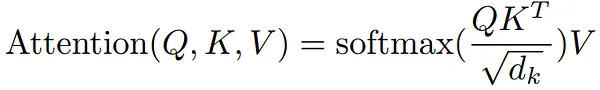
7
2
임세진

임세진

LLM 스터디 #1

  1. 휴튼에 대한 간략한 소개

휴튼은 보다 많은 사람들이 '내적 글쓰기'라는 수단을 통해 내면에 집중하고, 궁극적으로 자신을 더 깊이 이해하여 명확한 목적의식을 가진 삶을 살 수 있도록 도와주는 서비스입니다.

  1. LLM 스터디를 시작하게 된 배경

휴튼에서는 최근 생성AI를 기반으로 한 기능을 오픈하려고 합니다. 이 과정에서 배우고 있는 것을 공유하고자 합니다.

  1. LLM이란..?

LLM은 large language model의 약어로, 전통적인 RNN 기반이 아니라, 최근에 성능이 잘 나오던 transformer-based architecture을 기반으로 제작되었다고 합니다.

LLM은 이름에 걸맞게, 엄청난 언어 데이터를 학습해서 생성한 모델이구요, self-supervised learning을 해서 문맥 안에서, 그리고 문장 안에 필요한 다음에 올 토큰(*)을 예측한다고 해요.

LLM이 학습하는 과정은 다음과 같다고 해요.

1) 문자열 데이터를 tokenize(*)하여 각 문자들에게 고유한 숫자 값 부여

2) 문장에 다음에 올 단어를 예측하는 모델을 생성

3) 모델 파라미터를 랜덤하게 할당

4) tokenize된 문자열 token들을 모델에 Feed Forward(**)

5) 문장에 다음에 올 단어를 예측하고, 실제 다음에 오는 단어 사이에 loss(***)를 계산

6) loss를 최소화 하는 방식으로 모델 파라미터를 재 조정

7) 모델의 정확도가 높아질 때 까지 1) ~ 6)의 과정을 반복


< (*) 부연 설명 >

여기서 토큰이라는 용어가 생소하신 분들을 위해 간략하게만 설명을 드리면, NLP에서 모든 언어의 낱말들은 컴퓨터에서 학습을 하기 편하게 tokenize라는 과정을 거쳐요. tokenize 과정을 통해 각 낱말은 고유의 ID 값을 지니게 되어요.

< (**) 부연 설명 >

Feed Forward는 단순하게 설명하면, 딥러닝 모델에서 데이터를 모델에 넣어서 예측하게 하는 과정을 의미해요. 딥러닝 모델은 크게 데이터 전처리, 모델 생성 및 초기 파라미터 설정, Feed Forward, Back Propagation의 과정들이 있어요. 보통은 모델이 정확해질 때까지 Feed Forward와 Back Propagation 과정을 반복해요. Back Propagation을 진행하면, 모델이 넣어준 데이터에 맞춰서 정교하게 수정된다고 이해를 하시면 돼요.

< (***) 부연 설명 >
loss는 Back Propagation이나, 모델의 파라미터를 재 조정할 때 계산되는 값이에요. 예측 값이랑 실제 값이랑 얼마나 다른 지를 수치적으로 나타내죠. loss를 계산하는 방식은 여러가지가 있어요. 보통 모델이나 데이터에 따라 loss를 계산하는 방법이 달라져요.


< 참고 자료 >

8
2