아티클

K

K

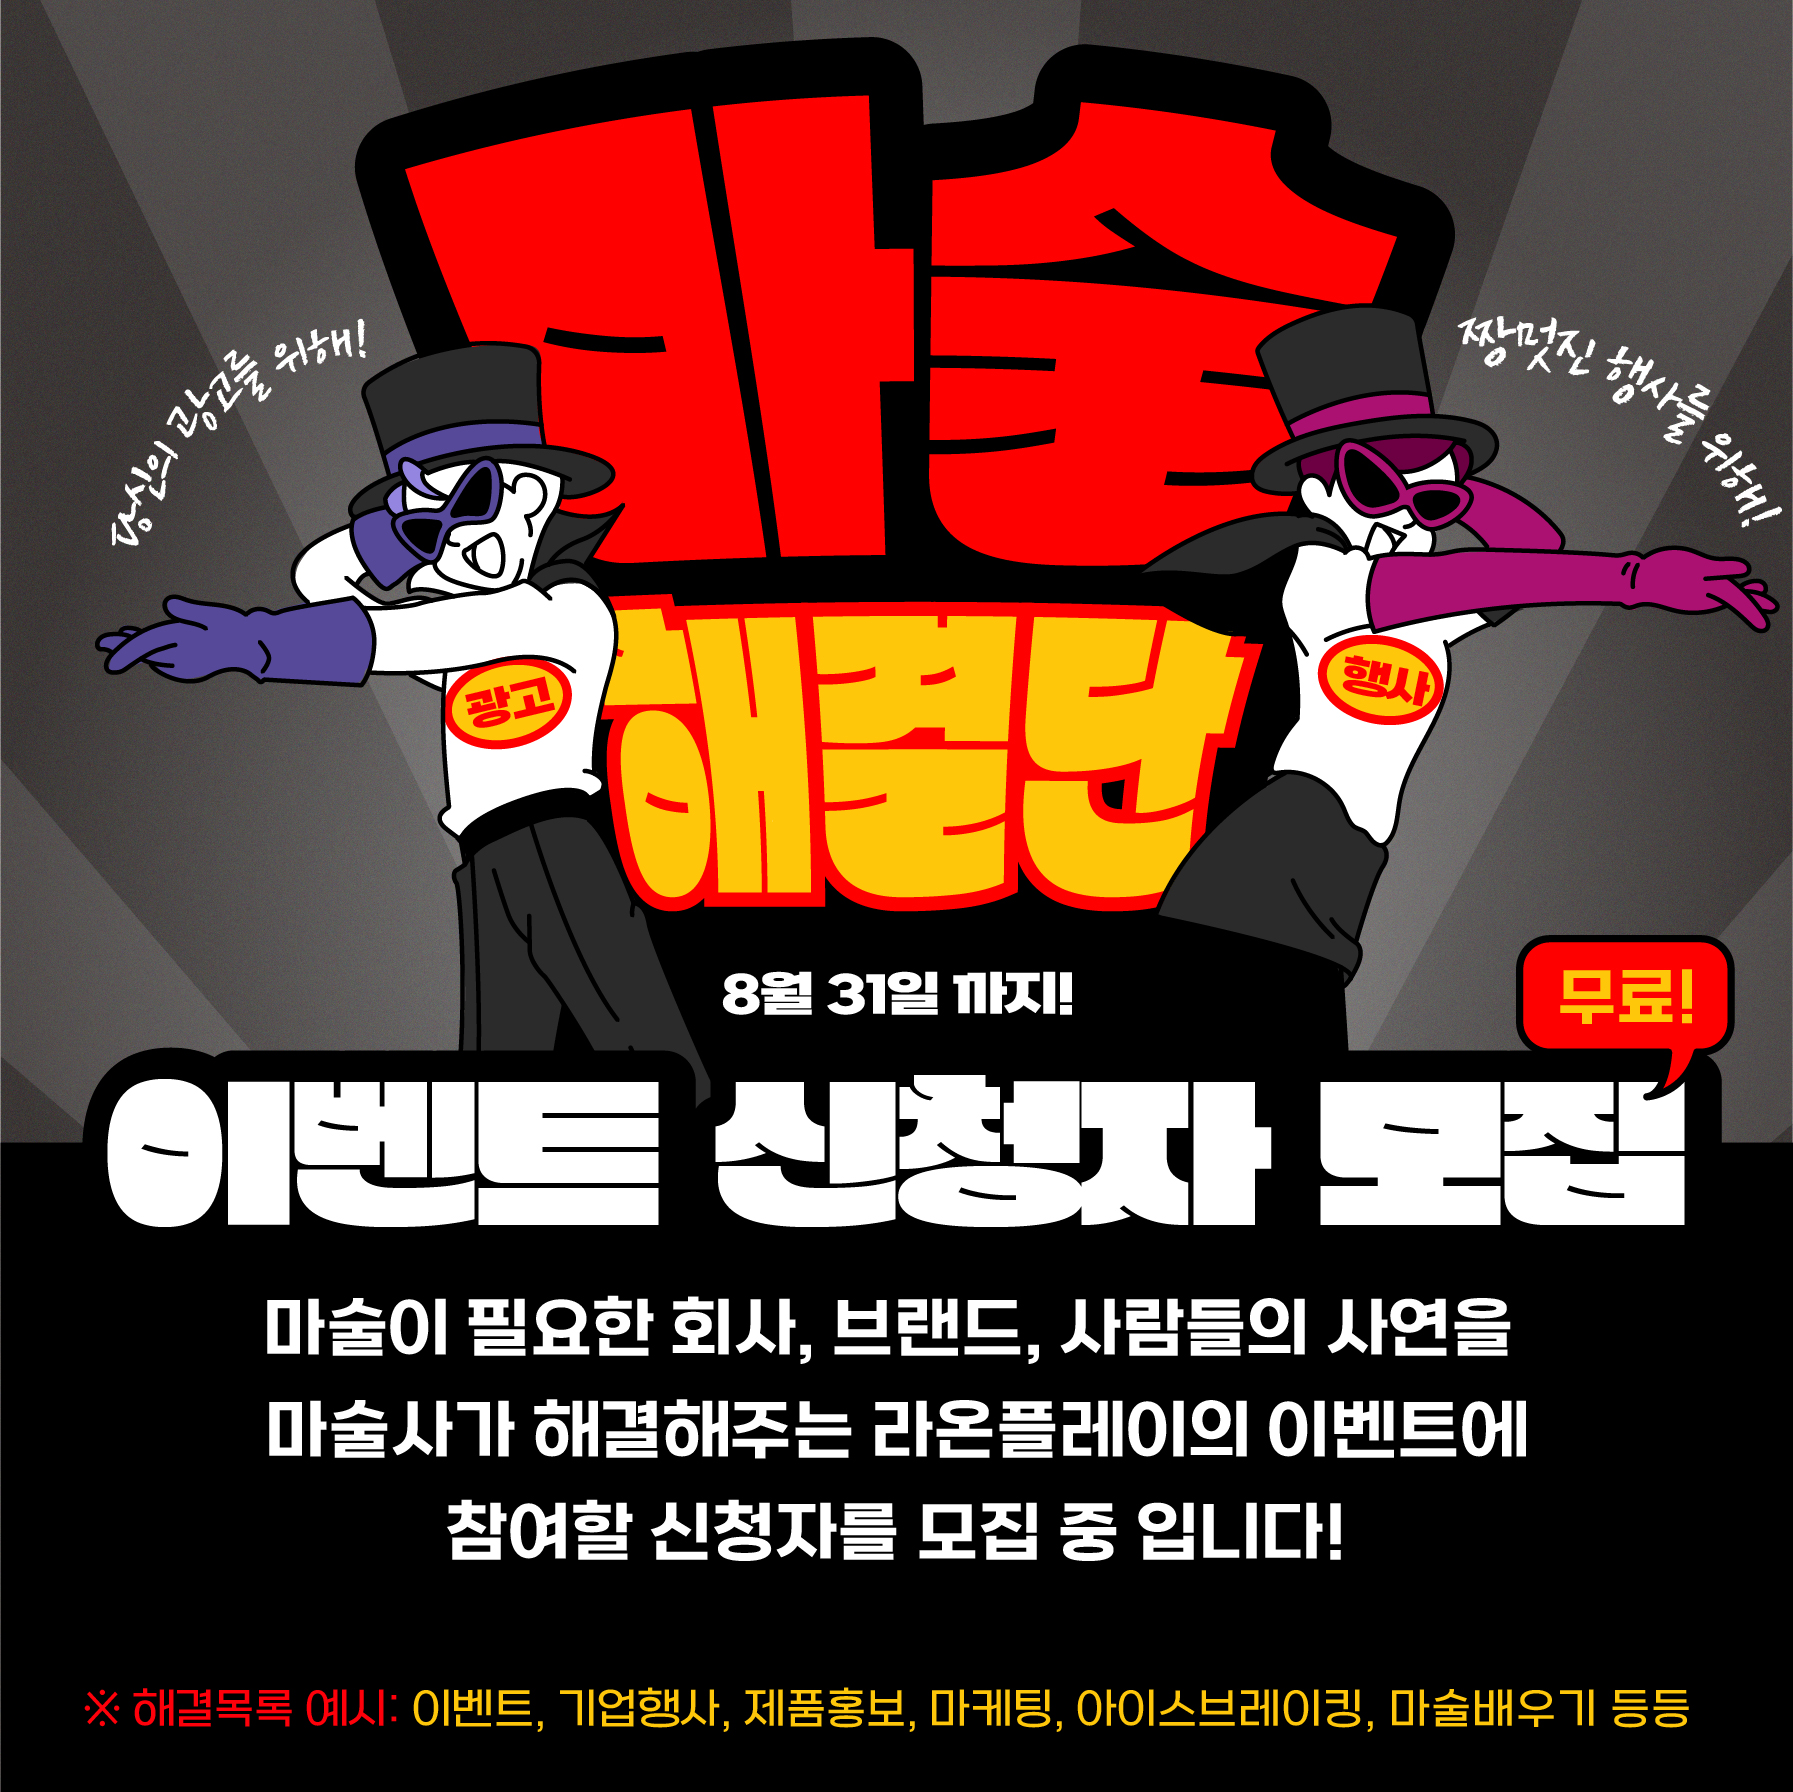
[마-술 해결단] 마법같은 제품/서비스 홍보 무료체험 이벤트 참여자를 모집합니다!!

마술해결단_최종.jpg

안녕하세요!

마술같은 즐거움을 전하는 (주)라온플레이에서
모두의 즐거움을 찾고 싶은 라이프큐레이션 서비스 GAMMYGIDA를 만들고 있는
매니저 케이입니다!

이번에, 회사에서 재미있는 프로젝트를 시작하게 되어서, 혹시 관심 있는 메이커님들 있으실까 공유드립니다!!

⭐ "우리 제품을 어떻게 더 부각시킬까?"
🤸 "우리 팀원들 조금 더 cheer-up하게 해줄만한 이벤트가 있을까?"
🔎"우리 서비스를 쉽게 설명할 수 없을까?"

최현우 마술사를 필두로 하여, 세상을 더 즐겁게 만들어나가는 일에 진심인 (주)라온플레이에서 마-술 해결단 프로젝트에 참여하실 법인(개인)을 모집합니다

["마-술 해결단" 프로젝트가 뭔가요?]
라온플레이가 마술같은 해결책이 필요한 회사, 브랜드, 사람들의 마술이 필요한 순간들의 사연을 받아, 라온플레이만의 노하우로 문제를 해결해주는 콘텐츠 입니다.

[참여방법]
🔎 참여신청 방법 : " https://bit.ly/Magic_Solution_B " 링크로 접속하셔서 구글폼을 제출해주시면, 참여신청 완료!
👤참여대상 : 제품/서비스 홍보, 사내 이벤트, 고객 대상 이벤트 등 마술로 고민 해결이 필요한 누구나
💵참가비용 : 무료 (단, 콘텐츠 제작에 동의하시는 경우에만 참여가 가능합니다)
📅접수기간 : 2023년08월11일~08월31일(정오)
🏆️모집팀 : 00팀 (난이도, 적합도에 따라서 다양하게 모집합니다!)
📢당첨자 발표 : 2023년 09월 초 (라온플레이 인스타그램(@raonplay) 및 개별연락)
🎩콘텐츠 제작 일정 : 09월 중 (당첨자에 한해 협의 후 진행)

라온플레이는 누군가에게 마술같은 선물을 제공하는 것을 업으로 하는 사람들이 모여있습니다.

We'll make you smile.

마-술 해결단을 통해 마술이 필요한 회사, 브랜드, 사람들의 마법이 필요한 사연을 받아 즐거운 순간을 나눌 수 있었으면 합니다. 저희의 작은 능력이 많은 이들에게 즐거운 미소를 만들어 드렸으면 합니다.

마-술 해결단 캠페인은 마술 실력은 출중 하지만, 기회를 받지 못하는 마술사에게 능력을 발휘하고 가치를 만들기 위한 라온플레이의 공익 캠페인의 일환으로 준비/진행/피드백 등 전 과정이 동영상 콘텐츠로 제작되며, 유튜브/ 인스타그램을 포함한 SNS 채널에 업로드 될 예정입니다.

촬영/진행을 포함한 모든 사항은 위탁자(사)와 협의를 거친 후 진행됩니다.

막상 글을 써보니 너무 어색하네요!

기회가 된다면, 전통적인 산업군에 있던 엔터회사가 사내프로젝트로 스타트업을 꾸려간 이야기도 나눠 보겠습니다!!

긴 글 읽어주셔서 감사드립니다 :)

3
0
GLITCH

GLITCH

글리치 이번엔 게임이다!

4
0
Sujin Keen

Sujin Keen

웹3 투자의 62%가 왜 게임에 몰리고 있는걸까?

안녕하세요! 디스콰이엇 여러분. 웹2와 웹3 세상을 잇는 글리치의 캐리입니다. 오늘은 웹3 게임의 중요성을 소개드리고자 글을 씁니다. 지금 웹3 VC들이 투자하는 스마트머니의 62%가 게임에 몰리고 있다는 사실을 아시나요? 지금 이 기회를 놓치면 3년 뒤 여전히 '껄무새'로 남아있을 것 같아 웹3 게임 해커톤을 추진하고 있어요.

image.png최근 글리치는 아시아로 무대를 넓혀가기 위해, 베트남(GM Vietnam), 일본(WebX) 그리고 곧 발리(CoinFest)까지 아시아를 탐험하며 웹3 게임의 중요성을 현장에서 몸소 느꼈는데요. IP 강국 일본은 정부 주도로 게임과 웹3를 결합하여 잃어버린 30년을 되찾자는 움직임이어요. 한편 게임 신흥 강자 베트남에서는 Play to Earn 신화를 일으킨 엑시인피니티 이후 게임을 향한 빌더들의 강렬한 의지가 있어요.

그럼 한국은 어떨까요? 아시아의 웹3 게임 열기를 소개하기 위해 글리치가 게임을 테마로 해커톤과 세미나를 준비했습니다. 이번 이벤트는 대표적 게임 특화 체인 XPLA와 Oasys가 공동 주최하며, 컴투스, 넥슨, 넷마블 등 굴지의 게임사들도 파트너로 함께 합니다. 해커톤 마감주인 다음주부터 멘토링 세션과 수상 꿀팁 등 다양한 이벤트 라인업이 준비되어 있으니 해커톤 참가 신청 해두고 소식을 받아보세요!

Beyond Boundaries 해커톤 프로젝트 제출 (온라인 8/27일 마감)

🕹게임 Play to Earn이 아니라,
지금 게임 Build를 해야 하는 이유!

1. 웹3 투자 71억 달러 중 게임이 62%

2022년에 웹3 스타트업에 약 71억 달러가 투자되었으며, 그 중 62%는 게임 분야라고 해요. 그 뒤는 메타버스와 소셜 네트워크가 뒤를 잇고 있습니다. 제가 글리치 첫 온보딩캠프에서 '웹3는 새로운 영토다'라고 비유했는데요. 지금 활발하게 투자되고 있는 게임, 메타버스, 소셜이야 말로 웹3라는 새로운 영토에 부동산 가치를 키워줄 아이템들인 거죠. a16z, 패러다임, 바이낸스 웹3 대표 투자사들의 포트폴리오를 확인해보세요.
Web3 startups raised $7.1B in funding during 2022 – Gaming accounted for 62%

2. 아시아가 웹3 게임의 심장이 될 것!

특히 게임은 아시아 그리고 한국이 가장 잘할 수 있는 분야라는 것! 그래서 꼭 글리치에서 웹3 무대를 데뷔한 K빌더들에게 소개해주고 싶었어요. 전 세계 200조 게임 시장에서 한국은 4위 규모로 약 10%의 점유율을 한국 플레이어가 차지하고 있어요. 컴투스, 넥슨, 넷마블, 크래프톤 등 굴지의 게임사들이 왜 웹3 게임에 적극적으로 투자하고 있는지 쟁글의 아티클에서 확인해보세요.

아시아: 블록체인 게임의 심장

3. 게임 인프라에 다양한 기회들이 펼쳐져?

근데 게임 개발은 너무 리스크가 높지 않나? 그래서 글리치가 주목하는 부분은 게임을 위한 인프라/툴링 분야입니다. 게임 환경이 웹2에서 웹3로 전환되는 과도기라 각종 인프라를 구축해야 할 때입니다. 게임 인프라 분야는 성장성이 높지만, IP 개발 보다는 리스크는 낮은 해볼만한 분야죠. 베트남에서 웹3 게임 분야를 리딩하는 Ancient8이 왜 게임 인프라에 베팅하는지 확인해보세요.

Why Ancient8 bet on Web3 Gaming Infrastructure

👾 아시아 최초 멀티체인 게임 해커톤
Beyond Boundaries 2023

❓자본력 1도 없는 빌더도 게임 빌딩이 가능한가요?

'한 명의 아이를 키우기 위해 온 마을이 움직인다'는 유명한 속담처럼 지금 웹3 게임 세상이 딱 그렇습니다. 웹3 게임 IP 하나를 키우기 위해 모든 인프라가 함께 진화하고 있어요. 게임을 넘나들며 아이템을 상호운용할 수 있는 지갑이라든지, 내가 소유한 아이템을 거래할 수 있는 마켓플레이스라든지. 이번 해커톤은 이런 게임 인프라와 툴링에 초점이 맞춰져 있습니다. 게임 빌딩은 성공이 희박하다고 금방 포기하시려고 한다면, 잠깐만 그 회의를 멈추고 글리치와 함께 헤쳐나가봐요!

🥸 게임 인프라 개발은 너무 빡쎄지 않나요?
컨셉 제안 형식의 PPT로 아이디어부터 검증하세요!

Beyond Boundaries 해커톤은 '아이디어' 만으로도 참여가 가능합니다! 흔히 해커톤하면 2박 3일 밤샘의 고통이 떠오르는데요. 본격적인 개발 시작 전, 빌더분들께서 컨셉 제안 형식의 PPT만 가지고도 해커톤을 제출하여 아이템을 검증받을 수 있도록 진입 장벽을 낮췄습니다. Beyond Boundaries 해커톤은 웹3 게임 세계를 변화시킬 근본적인 아이디어에 주목합니다.

🏆 이번 해커톤의 특별한 점은?

1. $60,000 규모(약 7,800만원)의 상금과 이후 추가 그랜트 기회까지
2. 온라인 해커톤으로 편한 시간 제출하고 PPT로 아이디어만 제출해도 충분
3. 컴투스, 넥슨, 넷마블 등 대형 게임회사와 네트워킹 기회

📎 해커톤 링크 투척

- 신청링크: http://app.glitch-hack.com

- 디스코드: http://discord.gg/glitch-hack

- 신청마감: 2023.08.27 11시 5

 🥹 근데 아직도 해커톤이 막막하다면? 
8월 18일(금) 밤 9시 온보딩캠프에서 만나요.

불금 온라인에서 만나 게임 세상으로 떠나요! 오시면 이런 걸 얻어가실 수 있어요. 

1. 웹3 게임 시장 뇌에 인스톨 시키기 

2. 현직 게임 빌더들의 생생한 경험담

3. 해커톤 출제 위원들의 꿀팁 챙기기

4. 세션 끝나고 온라인 게더링까지

👇🏻 8/18 금요일 웹3 게임 온보딩캠프 신청하기

10
0
이태화

이태화

생계형 문어발 스타트업

LAH가 운영 중인 자사 서비스는 4개 정도 된다. 비디어스, 필름업, 장비모아, 영상인. 운영 중이라고 해서 모든 서비스에 마케팅 비용을 쓰거나, 시간을 쓰고 있다는 것은 아니다.

MVP로 PMF를 테스트해 보기 위해 운영 중인 것도 있고, 적극적으로 개발하면서 업데이트 중인 서비스도 있고, 외부 요소로 운영하고 있는 서비스도 있다.

잘 알려진 스타트업이라고 하면 일반적으로 서비스명과 회사명이 함께 가는 경우가 많다. 당근마켓, 컬리 등 지금은 스타트업이라고 보기 어려운 회사들이지만 스타트업 시절에도 같은 이름이었다.

물론 꼭 그런 것은 아니다. 인프랩, 우아한형제들 등이 그렇다. 하지만 이렇게 이름이 다른 경우에도 대표적인 서비스는 하나였다.

그러다 보니 스타트업을 시작하기 전에는, 하나를 잘 만들고 운영에 힘써보고, 피드백도 받아보고, 아니다 싶으면 피보팅하고 다시 힘써보고를 반복하면서 만들어 가야 한다고 생각했다.

처음 개발 후 서비스를 오픈한 이후에, 아무도 우리 서비스를 몰랐다. 필름업이 처음 나왔을 때, H의 지인 영화들로 채워졌다. 그 이후 트래픽은 0이었다.

필름업으로 무엇을 더 해야 할지 몰랐고, 학교 영화과도 찾아가 보고 감독들도 만나고 배급사도 만나봤지만, 영화가 몇 개 더 추가됐을 뿐, 크게 달라지는 것은 없었다.

그리고 비디어스를 개발했다. 비디어스도 비슷했다. 아무도 쓰지 않았고, 시간이 흘렀다.

그 과정에서, 아이디어 회의를 하면서 장비모아, 영상인과 같은 작은 프로젝트 느낌의 서비스도 나오고, 아직도 운영되고 있다.

지금은 필름업에서 영화제 행사를 진행하고 있고, 배급사와 연계하여 영화도 많이 확보되었다. 그리고 비디어스도 MAU가 4자릿수이다. 장비모아와 영상인도 DAU가 꾸준히 있다.

누군가는 이렇게 말할 수도 있다. 여러 서비스에 쏟은 에너지를 한 서비스에 쏟았으면 더 잘되어서 곧 대박이 났을 거라고.

물론 그럴 수도 있지만, 사실 그렇게 되는 것은 타이밍, 실력, 노하우 등 여러 요소가 함께 잘 맞아떨어져야 된다고 생각한다. 그렇기 때문에 결국 시간이 필요한 일이라고 생각한다.

그리고 무엇보다 초창기 서비스는 생각한 것보다 할 일이 없다. 무슨 얘기냐면, 이용자가 없기 때문에 적극적인 피드백을 받을 수 없고, 테스트할 수도 없다. 돈이 많다면, 광고비를 늘려서 CPC 등으로 평가하면서 개선해 나갈 수도 있겠지만 그마저도 불가능하다. 그러다 보니 결국 여러 서비스를 진득하게 운영해 나갈 수밖에 없다.

그리고, 우리는 이걸 잘 해냈고, 해내고 있는 것 같다. 지금도 서비스 간의 스위치가 발생할 때, 히스토리를 따라가는 것이 버거울 때가 있는데, 더 이상 늘릴순 없을 것 같고 잘 운영해나가야 할 것 같다.

필름업은 오픈하고 2년간 H의 인스타 운영과 여러 활동으로 이제 조금씩 햇살이 비치고 있고, 비디어스도 업계에 조금씩 알려지고 있다.

하나의 서비스로 지속적인 피보팅을 통해 성장할 수도 있지만, 어쩌면 피보팅이 필요한 것이 아니라 시간이 필요한 일일 수도 있다. 피보팅의 성공사례가 많이 알려져서 그렇지, 피보팅은 굉장히 괴로운 작업일뿐만 아니라, 꽤 위험하기도 하다.

그러니 문어발이 되어보는 것도 좋겠다.

다행히도 대기업의 문어발과 다른, 생계형 문어발 스타트업이다. (내 맘대로)

7
0
유현일

유현일

간단한 회의 관련 인터뷰 해주실 분들을 찾습니다!

회의 AI 솔루션 '미팅미닛' 인터뷰 참가자 모집!

목적
저희 "미팅미닛"팀은 AI가 회의에 직접 참여하는 회의 어시스턴스 서비스를 개발 중입니다.
PMF를 찾기 위해 여러분의 소중한 의견을 듣고자 합니다.
"무엇을 먼저 개발해야 할까, 어떤 기능을 집중적으로 개발해야 할까"에 대한 답을 찾기 위해 인터뷰 참가자를 모집합니다.

보상
인터뷰에 참가해주신 분들께 서비스 출시 후 "미팅미닛 솔루션 최상위 플랜 3개월 이용권"을 드립니다.

세부 내용

  • 회의, 미팅, 인터뷰, 상담 등에 참여하는 모든 분을 대상으로 합니다.

  • 대학생부터 CEO까지, 어느 분야든 환영합니다!

  • 대면 및 비대면 모두 가능합니다.

  • 익명 참여도 가능합니다!

  • 인터뷰는 약 20~30분 내외로 진행됩니다.

아래 되는시간 링크에서 가능하신 시간 체크해주시면 됩니다!

여러분의 소중한 의견을 기다립니다! 많은 참여 부탁드려요 :)

4
0
장한결

장한결

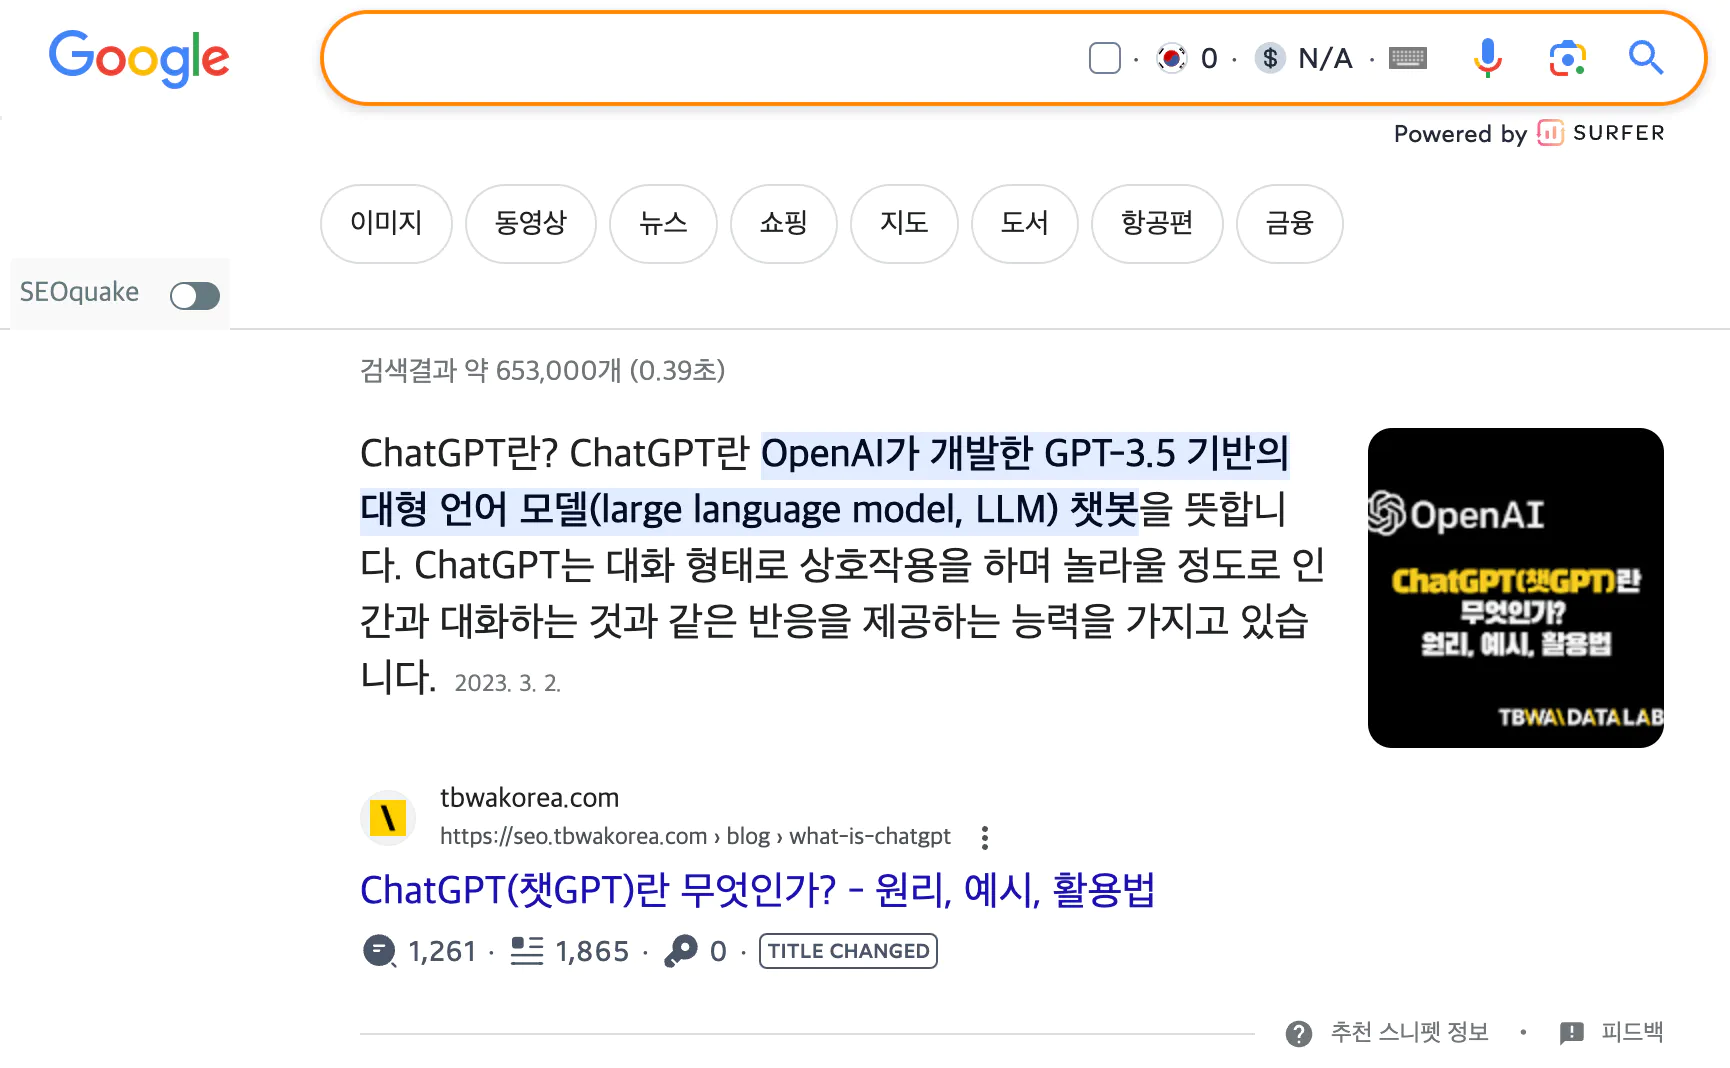
구글 스니펫(Snippet): 검색 결과 상단을 지배하는 짧고 강력한 정보

스니펫은 검색 결과에서 간결한 정보를 제공하는 강력한 요소입니다. 구글 스니펫, 리치 스니펫, 지식 스니펫 등 다양한 유형의 스니펫에 대해 알아보고, 추천 스니펫을 최적화하여 웹페이지의 노출과 클릭률을 향상시키는 전략에 대해 알려드립니다. snippet 관련 궁금증을 해소하세요.

구글 스니펫(Snippet) : 검색 결과 상단을 지배하는 짧고 강력한 정보

구글은 현대의 정보 탐색을 주도하며, 검색 결과의 질과 효율성을 높이기 위해 지속적으로 노력하고 있습니다. 이러한 노력의 일환으로, 구글 스니펫은 검색 결과 상단에 노출되는 간결하면서도 강력한 정보의 조각으로서 사용자에게 유용한 내용을 제공합니다. 이번 글에서는 스니펫의 의미와 역할, 그리고 구글 스니펫의 다양한 유형과 최적화 전략에 대해 자세히 알아보겠습니다.

스니펫이란 무엇인가?

스니펫은 검색 결과에서 웹페이지의 내용을 간략하게 요약한 것으로, 사용자가 검색 결과를 스캔하며 빠르게 정보를 파악할 수 있도록 도와줍니다. 스니펫은 주로 검색어와 관련된 문구를 강조하여 보여주며, 사용자의 질문이나 요구에 대한 간결하면서도 핵심적인 답변을 제공합니다. 이러한 스니펫은 사용자가 적절한 결과를 선택하는 데 도움을 주며, 검색 결과의 품질과 유용성을 높이는 역할을 수행합니다.

image.png

구글 스니펫의 역할과 중요성

구글 스니펫은 검색 결과 페이지의 상단에 노출되어, 사용자가 웹페이지를 클릭하기 전에 해당 페이지의 내용을 간략히 파악할 수 있게 합니다. 이로써 사용자는 더 나은 검색 경험을 얻을 수 있으며, 웹페이지를 클릭하여 들어가기 전에 관심 있는 정보가 포함되어 있는지 미리 확인할 수 있습니다. 스니펫을 최적화하여 구글 검색 결과 상단에 노출되면, 클릭률이 향상되어 유기적인 트래픽을 유도할 수 있습니다. 또한, 사용자의 질문에 정확하고 유용한 답변을 제공함으로써 웹사이트의 신뢰성과 권위성을 강조할 수 있습니다.

다양한 유형의 스니펫

1. 리치 스니펫

리치 스니펫은 검색 결과에서 풍부한 정보를 제공하는 스니펫으로, 텍스트 뿐만 아니라 이미지, 도표, 평가 등 다양한 형식의 내용을 보여줄 수 있습니다. 이를 통해 사용자는 더 많은 정보를 미리 파악할 수 있으며, 더 나은 판단을 내릴 수 있습니다.

image.png

2. 지식 스니펫

지식 스니펫은 사용자의 질문에 대한 간결한 답변을 제공하는 스니펫입니다. 자주 묻는 질문이나 정의, 단위 변환 등의 간단한 정보를 제공하여 사용자가 더욱 신속하게 원하는 정보를 얻을 수 있도록 도와줍니다.

image.png

3. 추천 스니펫

추천 스니펫은 사용자에게 제품 또는 서비스를 추천하는 강력한 도구로서, 구글 검색 결과에서 특정 제품이나 서비스의 장점을 강조하고 사용자의 니즈에 부응하는 내용을 제공합니다. 이러한 스니펫을 최적화하여 사용자가 해당 제품 또는 서비스를 선택할 동기를 부여하고, 웹페이지로 유기적인 트래픽을 유도할 수 있습니다.

추천 스니펫은 사용자의 관심을 끌고 제품 또는 서비스에 대한 정보를 간결하게 제공함으로써, 사용자가 더 많은 정보를 얻기 위해 웹페이지를 클릭하도록 유도합니다. 이는 제품 또는 서비스의 홍보와 마케팅에 매우 유용한 전략으로 작용하며, 클릭률의 증가와 웹페이지의 노출 횟수를 높일 수 있습니다.

image.png

구글 스니펫 작성 요령

1. 키워드 최적화와 내용의 일치성

2. 간결하면서 효과적인 정보 전달

3. 소스 페이지의 구조적 마크업

전문 읽기: 링크

4
2
심은광

심은광

6개월간 개인프로젝트를 운영하면서

어느덧 “모두CBT” 서비스를 시작한지 6개월이라는 시간이 지났네요.

개발자 이직 포트폴리오로 활용할 목적으로 시작한 개인 프로젝트였는데, 

감사하게도 생각보다 많은 분들이 이용해 주셔서 계속 서비스를 운영하고 있습니다 !

그동안 이뤄 낸 성과 및 앞으로의 목표에 대해 간단하게 얘기해보려고 합니다.

<6개월간의 성과>

  • 구글스토어 다운로드수 1만 +, 평점 4.8

  • 회원수 7000+

<6개월간 서비스를 운영하면서>

@ 서비스 탄생 배경

필기 공부를 도와주는 서비스는 있는데, 실기 공부를 도와주는 서비스는 왜 없을까? 라는 의문에서 시작해서 서비스를 만들게 되었습니다.

@ 피드백을 받기위한 노력!!

서비스를 혼자 운영하다 보니, 아이디어도 고갈되고.. 서비스가 오류 없이 잘 굴러가고 있는건지 확인이 어려웠어요. 그래서 어떻게 이 문제를 해결 할 수 있을까 고민했습니다.

  1. 첫번째 시도 - 자유게시판 개설

    처음에는 자유게시판을 만들어서 유저들의 의견을 들어보자고 생각했습니다. 하지만 생각보다 글을 써주는 사람이 많지는 않더라구요..  그래도 종종 버그 발견 글들을 올려주셔서 버그해결에 큰 도움이 됐습니다.

  2. 두번째 시도 - 오픈채팅방 개설

    오픈채팅방을 개설하고, 홈페이지에 입장할 때 오픈채팅방에 입장하도록 유도하는 안내를 띄었습니다.

    오픈채팅방은 생각보다 반응이 좋았습니다 ! 생각보다 많은 이용자분들이 들어와 주셨고, 현재는 감사하게도 약 1천명 이상의 유저분들이 오픈채팅방에서 활동해주고 계십니다 ㅎㅎ 

    서비스에 대한 다양한 피드백을 주셔서, 현재도 정말 큰 도움이 되고 있고 이용자분들이 서비스의 기획자이자 QA엔지니어 역할을 해주고 계십니다!!

    저처럼 혼자 서비스를 운영하고 계시다면 오픈채팅방을 개설해서 이용자분들과 소통해보는 것을 적극적으로 추천드립니다 !

@ 혼자 개발하면서 좋았던 점

혼자 서비스를 개발 하고 운영하다보니, 다양한 기능들을 내 마음대로 실험 해보고 적용할 수 있어서 너무 좋았던 것 같아요 !

이전에 “모두의 메타버스”라는 프로젝트를 개발했을 때는, 백엔드 개발자 분이 따로 계셨는데, 새로운 기능을 추가하고 싶을 때마다 요청을 드려야했고, 각자 현업이 있다보니 시간이 맞지 않아서 기능 하나 추가하는데에도 시간이 많이 소요돼서 힘들었던 기억이 있네요 .

@ 혼자 개발하면서 힘들었던 점

아무래도 혼자 서비스를 개발 및 운영하다보니 힘든점도 많았던 것 같습니다.

  1. 기술 및 전문성의 부족

    처음에 제가 가지고 있던 기술은 프론트엔드 개발 기술 하나 였습니다...

    매일 퇴근 후 열심히 공부해서 어찌저찌 서비스를 런칭하긴 했지만, 아직까지도 전문성은 조금 부족하다고 생각이 되네요 ㅎㅎ..!! 

  2. 시간 부족

    기술적으로 해결해야 할 문제도 있고, 추가하고 싶은 기능도 많은데..

    회사를 다니면서 서비스 개발을 병행하다 보니 아무래도 시간이 많이 부족하긴 한 것 같아요 ㅎㅎ.

<앞으로의 목표>

@ 어플 고도화

최근에 구글스토어에 어플을 런칭했는데, 제가 앱개발 쪽에 아직 지식이 얕다 보니.. 버그가 생각보다 많아서 어플환경에서의 버그들을 고치는게 첫번째 목표입니다 ! 

버그가 이렇게도 많은데.. 다들 평점을 높게 주셔서 정말 감사합니다 :D..

@ 신규 기능개발 - 유저의 자체 시험지 제작 및 판매기능 개발

현재는 “모두CBT”에 특정 시험에 대한 자료만 업로드 되어 있으며, 제가 혼자 자료를 업로드 하기에는 한계가 있어서, 유저가 직접 자신만의 시험자료를 제작해서 이용할 수 있도록 만들어둔 상태입니다.

앞으로의 목표는 시험자료 제작자가, 타 유저에게 시험지 뷰어 권한을 판매해서 수익을 창출 할 수 있도록 만들어 보려고 합니다.

<마치며>

정말 소소하게 시작한 포트폴리오용 프로젝트 였는데 제가 생각한 것 보다는 많이 커진 것 같아요 ! 

처음에는 정말 단순한 서비스였는데, 이용자가 생기면서 이용자분들의 피드백을 받다보니 서비스가 점점 커진 것 같아요 !! (아직도 많이 작긴하지만 ㅎㅎ..)

서비스를 운영하면서 가장 좋은 순간은, 유저분들이 “덕분에 시험 합격했어요!” 같은 긍정적 후기를 남겨주실 때 인 것 같아요 ㅎㅎ ..

서비스 런칭 후, 첫 시험이 끝난 후 정말 많은 분들이 개인톡으로 감사인사를 해주셔서 얼마나 뿌듯했는지 모릅니다 !!

앞으로도  메이커로써 많은 사람들에게  도움을 주는 프로덕트를 개발하고 싶습니다 !!

두서 없는 긴 글 읽어주셔서 감사합니다 :D

모두CBT

국가고시 필답형 실기시험 준비를 도와주는 서비스입니다 .

14
6
홍인수

홍인수

DevOps 관련 직무 현직자 및 이직/학습 희망자 설문조사

안녕하세요, IT 교육회사 코드스테이츠 교육사업팀입니다. 

직무 교육 제품의 지속적인 품질 향상을 목표로 현업자분들의 다양한 관점과 의견을 수렴하기위해 아래와 같이 설문을 진행하고자 합니다. 
많은 참여 부탁드립니다. 

▶️ https://forms.gle/MWHgzKVEX41RLRSa8 

- 대상 : DevOps 관련 재직자, 혹은 해당 분야 직무 전환과 학습을 희망하는 재직자 
- 기간 : 2023.08.14(월) ~ 2023.08.22(화) 
- 내용 : 기본 재직정보 및 교육 제품 수요 및 선호 형태 

※ 🎁 기프티콘은 08/31(목)일괄 발송될 예정이며, 선착순 50분께만 증정되는 점 참고 부탁드립니다. 
(단, 설문조사 대상자에 부합하지 않는다고 판단될 경우, 리워드 지급이 어려울 수 있습니다.) 

p.s. 본 설문조사를 완료하신 분들 대상으로 비대면 인터뷰 참여자도 모집하고 있습니다. 인터뷰 참여자에게는 사례비가 지급되니, 많은 관심과 참여 부탁드립니다 😊

3
0
한주현

한주현

뉴스레터 예산 없이 구독자 1만명 만든 비결

초기 스타트업 콘텐츠 마케팅, 비용 때문에 걱정이시죠? 

뉴스레터 제작을 통해 효율적으로 마케팅 할 수 있어요. 

원포인트 전문가가 마케팅 예산 없이 구독자 1만 명을 

모을 수 있던 비결을 알려드릴게요 😊

링크 클릭하고, 정보 얻어가세요 🔥

원포인트는 탑티어 프리랜서 마케터 매칭 서비스로,

검증된 상위 10% 마케터를 필요한 만큼 고용하실 수 있는 서비스입니다.

원포인트가 궁금하다면? 😙

Thumbnail_Blog_newsletter_marketing 복사본 2.png
5
0
Lily

Lily

“구노포차 아닙니다 🙅🏻‍♂️ 연구노트 구노입니다 🙆🏻‍♀️” (2)

지난 이야기

“구노포차 아닙니다 ‍️ 연구노트 구노입니다 ‍️” (1) | Disquiet*

*지난 이야기에 이어, 세라(김지원 대표님)의 인터뷰 내용을 토대로 작성되었습니다.

가설은 100% 맞을 수 없고, 시장을 가봐야 아는 것이다.

저희는 연구원들 대상으로 인터뷰를 진행하고, UI를 짜서 공략했는데 처음의 가설과 다르게 첫 고객은 모두 ‘스타트업’이었어요.

연구원들에게 사실 ‘연구노트’는 당연한 거고, 당연히 불편하고 귀찮은 것이었습니다.

이런 연구노트를 교수님에게 섣불리 결제해서 사달라고 할 수 없었던 것이죠. 교수님에게 어떻게 사달라고 말을 할 것이며 … 😂

결국 연구노트를 사는 사람과 작성하는 사람은 달랐던 것이죠.

이에 맞춰 스타트업을 위한 툴과 같이 개선해나가고, 스타트업에 좀 더 맞는 서비스로 나아가고 있는 중에도 대학 연구소에서의 수요도 늘어나고 있는 추세예요!

점점 기업 레퍼런스가 쌓이다 보니 입소문이 나서, 요즘에는 기업은 물론 대학 연구실에서도 많이 찾아주고 계시답니다.

(이 자릴 빌어 극 초기부터 저희 서비스를 믿고 이용해 주신 모든 고객사에 감사의 인사를 드립니다 💙 )

매출을 얻기까지… 영업팀 흡연실 썰…

첫 매출이 나기까지 서비스 출시 후 1년 정도는 걸렸어요.

개발하고 기획까지 하는 데에만 1년이 걸렸고, 그 과정에서도 물론 어려움이 있었어요.

여러 힘든 과정이 있었지만 아직도 처음 구매해 주신 기업의 담당자님 성함이 기억이 나요.

“첫 매출이다! 근데 우리 서비스를 왜 사지?”

왜냐면 당연히 연구실에서 구매를 할 것이라는 가설만 생각하고, 연구실에 집중을 했는데 기업에서 구매를 한 것에 대해 의문이 계속 들었어요. 이 의문을 가지는 것이 가장 힘든 부분이었죠.

타겟과 다른 곳에서 구매를 계속 하는 것에서 대해 이유가 알고 싶었어요.

그래도 정말 다행이라고 생각하는 것은 우리가 설정한 가설과 타겟이 아니라면 바로 다른 방향으로 전환해야 하는데, 구노 같은 경우에 연구실이 아닌 기업에서의 연속적인 매출을 통해, 타겟을 빠르게 전환할 수 있었던 것 같아요.

스타트업 위주로 영업을 해오면서도 점점 파이를 키워 나가려고 하다 보면 더 큰 단위의 영업도 필요하죠. 근데 보통 큰 단위 영업은 정말 1년을 투자해야 해요.

큰 기관에서는 예산 편성부터 고려가 되어야 하기에 시간도 오래 걸리고 쉽지 않았죠.

영업 에피소드 중 이런 일도 있었어요.

저희 첫 영업 매니저님이 모든 대학교를 돌아다니며 영업을 하셨는데, 당시 코로나 시기로 건물이 개방이 안되어 있었던 거예요.

그래서 그분이 흡연실마다 리플릿만 놓고 오신 적도 있었어요.

매니저님이 그렇게 거절당하는 것은 매일 일상이었고, 코로나 때문에 건물 내부에도 들어가지 못하는 상황이 잦았는데, 이런 일들을 매주 리포트를 통해 들으면 해드릴 수 있는 게 없는 그 상황도, 문이 열리기만을 기다리면서 담배만 피우고 계셨을 상황도 모두 너무 죄송했어요.

이렇게 매출이 나기까지 과정 중에서 특히 아웃바운드 영업의 실패를 많이 겪었던 시기가 있었던 것 같아요.

하지만 이러한 힘든 과정도 모두 열심히 해주신 덕분에 첫 매출로부터 매출이 3배 이상 성장할 수 있는 쾌거를 이루었습니다!

구노가 다른 점, 그래서 결국 구노를 쓰는 이유

“따로 쓰지 마세요. 올리기만 하세요!”

우리의 목표 : 연구노트를 쓰는 것 자체에 편리함을 제공해야 한다.

저희 구노 서비스가 나오기 전까지의 연구노트는 되게 형식적이었어요.

회색 배경에 형식적인 시스템으로 편집기를 제공할테니 여기서 써라 하는 게 강했어요. 근데 연구원들은 이미 노트나 다른 걸 쓰고 있는데, 편집기에 한 번 더 써야 하는 것이 너무 번거롭고 이중 일하는 것이었죠.

이 점에 있어서 저희 구노는 달라요.

심플하고 편해요. 원본 파일을 그대로 업로드만 하면 끝나요.

구글 드라이브, Github 서비스 연동도 되어 있고, 모든 지적 자산에 타임스탬프를 찍고 그 사람의 문서라는 것을 인정할 수 있는 서비스라는 점에서 가장 큰 장점이라 할 수 있어요.

저희 레드윗 4주년을 맞아, 2회에 걸쳐 세라의 인터뷰를 소개해 드렸는데요.

인터뷰 내용에 제가 좀 덧붙여보자면,

가끔 저희 대표메일이나 채널톡을 통해 "구노를 이용하고 정말 편리해졌다", "구노 덕분에 살았다" 하시면서 감사 메시지를 보내주시는 고객분들이 계세요.

또한, 직접 사용해 보고 다른 기업에 추천도 해주시고, 추천받은 기업에서도 또 구매를 해주시기도 하고, 꾸준히 재구매를 해주시기도 하는 등 구노의 영역이 넓어지고, 고객과의 관계가 깊어지는 것을 보고 들으면서

이렇게 4주년까지 잘 달려올 수 있었던 것은 많은 관심과 이용해 주신 고객 여러분 덕분이라 생각합니다.

앞으로 레드윗, 구노 서비스는 계속해서 성장해가기 위한 업데이트도 있을 것이고, 새로운 시도도 있을 것이고, 이 과정에서 시행착오도 물론 있을 것이에요!

하지만 세상 모든 연구원, 사용자에게 편리한 연구노트 서비스를 제공한다는 브랜드 메시지는 변치 않으며, 모든 연구원이 구노를 쓰는 그날까지 꾸준히 달려보겠습니다 🏃🏻🔥

구노포차 말고! 연구노트 '구노'의 이야기 들어주셔서 감사합니다!

저는 다음 회에 연구노트 콘텐츠로 또 돌아올게요 🙌🏻

전자연구노트 구노 GOONO

블록체인 기반 전자연구노트 서비스

9
1
김민철

김민철

사이드 프로젝트의 사이드 프로젝트가 있다!?

본인의 업무 역량을 발전시키기 위해 퇴근 후 진행하는 일을 사이드 프로젝트라고 하죠.

같은 맥락으로 사이드 프로젝트의 발전을 위해 사사이드 프로젝트를 진행하는 팀이 있습니다!

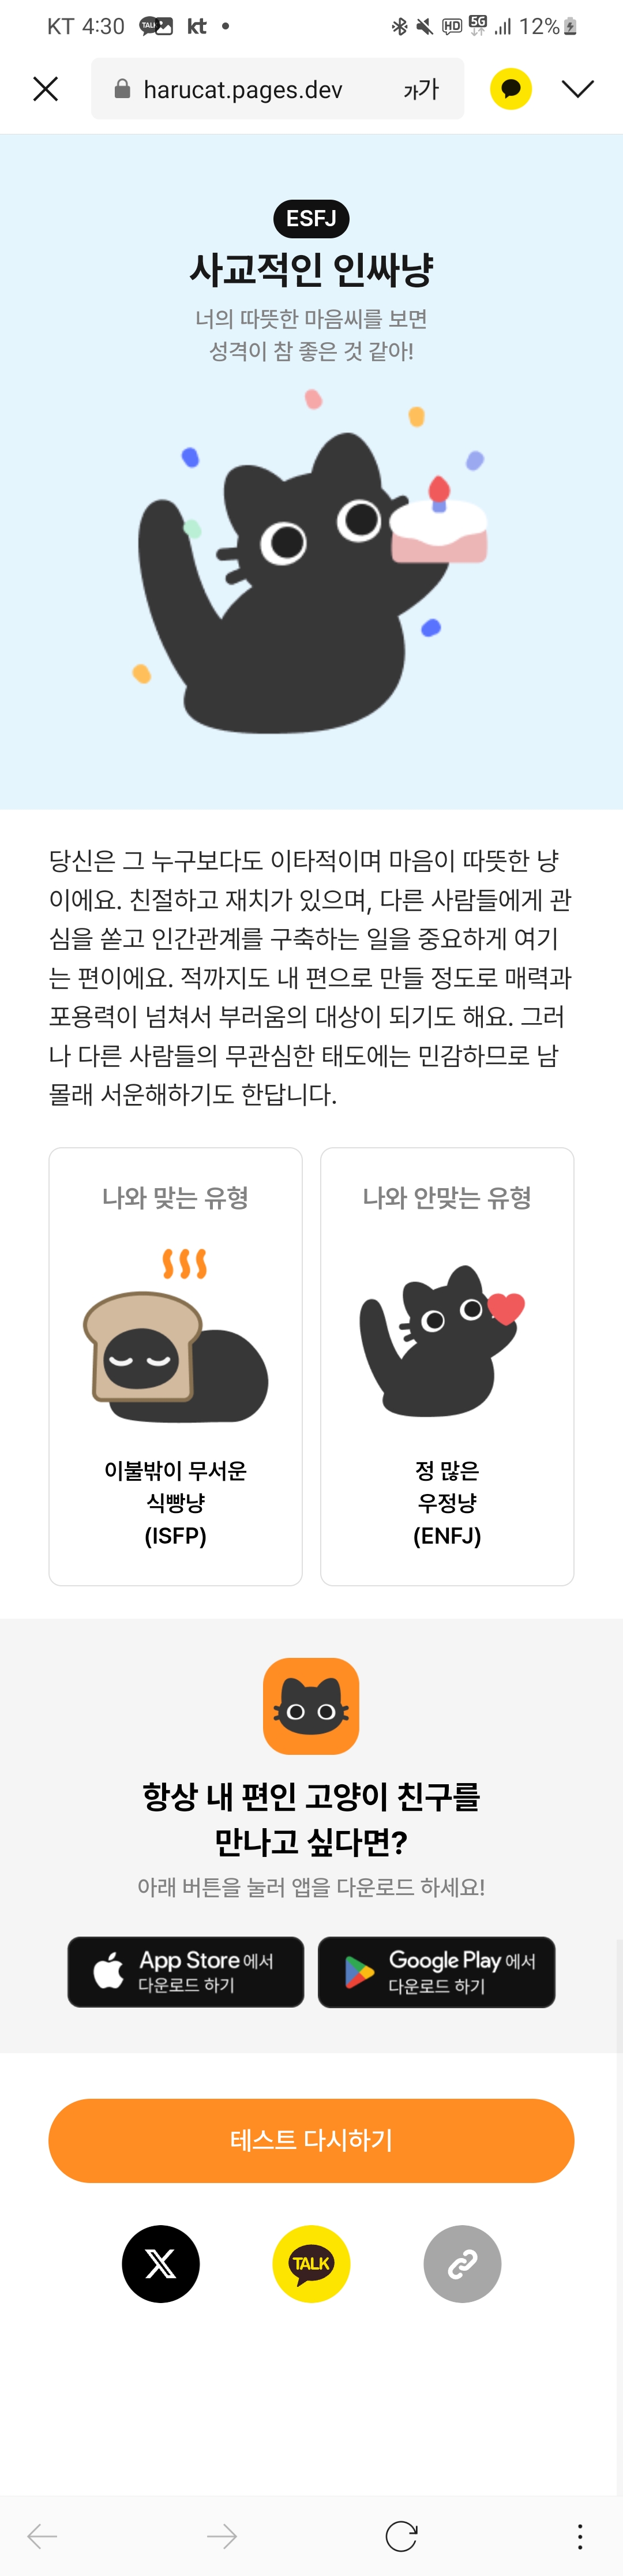
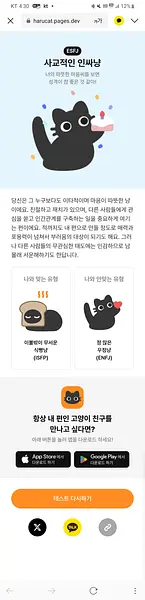
현재 PM으로 진행하고 있는 '하루냥'의 사사이드 프로젝트인 '하루냥 mbti 테스트'를 브랜딩 홍보 겸 유입량 증가를 목표로 팀원분들과 열심히 작업해서 배포했습니다!

여러분이 만약 고양이라면 어떤 mbti가 나오세요?

저는 ESFJ 나오네요 😁🐱

__

내가 만약 고양이라면 어떤 mbti일까?https://bit.ly/456zkmb

Screenshot_20230817_163028_KakaoTalk.jpg
5
1
김윤환

김윤환

[출시 직후 2,000건의 확장 요청을 받은 서비스 후기]

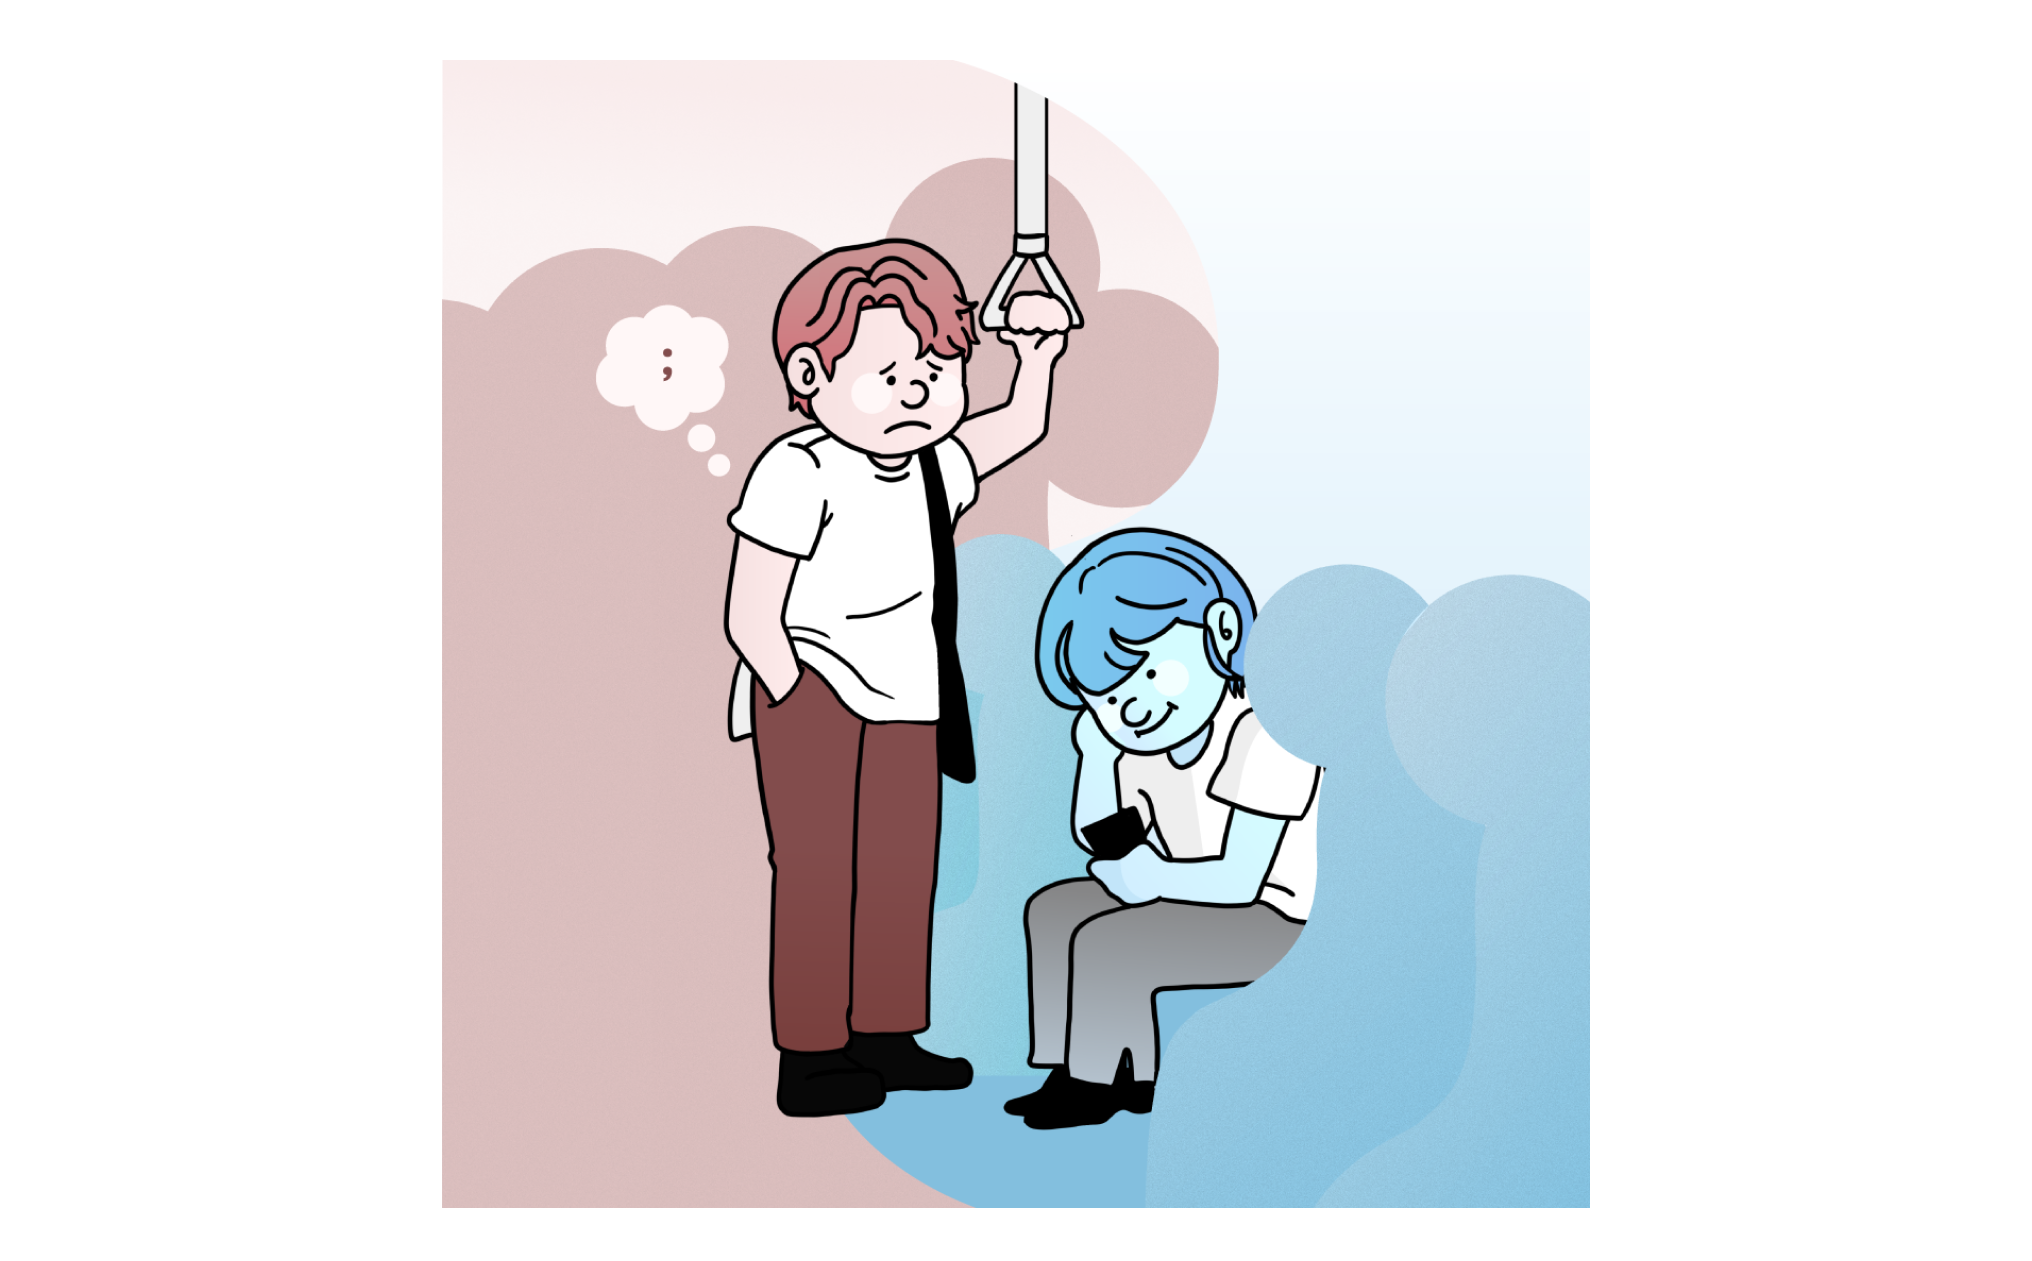
"내 앞 사람은 도대체 언제 내리는거야?"

Group 1 (4).png

🤔 대한민국에서 지하철을 타고 출퇴근을 하신다면, 한 번쯤 이런 생각해보시지 않으셨나요?

🤔 또는, 앞에 서있는 사람이 눈치 주는 것을 느낀 적은 없나요?

저는 매일 이런 생각을 하면서 지하철을 타왔습니다.

자연스럽게 "어떤 사람이 빨리 내릴까?"라는 생각을 하게 되었고, 제 나름대로 빨리 내릴 사람을 찾는 노하우가 쌓였습니다.💡

  • 현재역을 계속해서 확인하는 분들

  • 짐을 슬슬 정리하는 분들

  • 옷을 만지작거리는 분들

  • 핸드폰을 갑자기 안 보시는 분들

주로 이 분들을 주목하고, 사람이 적다면 한 번에 두 개의 자리 앞에 서서 가는 것도 좋은 방법이죠!

그러다가 내릴 것 같은 사람 쪽으로 무게중심을 살짝 더 두어가면서 자리를 확보하는 것이 중요합니다.

이외에도 여러가지 꿀팁들이 정말 많지만, 이런 팁들은 내 주변에서 사람이 내려야만 사용할 수 있습니다.

운 나쁘게 사람이 적게 내리는 칸에 탄다면, 도착할 때까지 다리 아프게 서서 가야 하는 불상사가 일어날 수 있습니다.

그렇다면 빈자리가 많이 생길 곳을 미리 안다면, 앉아갈 수 있지 않을까요? 🤔

그래서 준비했습니다..!

⬇️⬇️

지하철 실시간 빌자리 예측 서비스 "러시아워"

Group 53.png

"지하철 실시간 빌자리 예측 서비스" 러시아워에서는 빈자리가 많이 생기는 칸을 실시간으로 알려드리고 있습니다.

(러시아워에 대해 잘 기억이 안 나신다면, 하단 MUST READ로 선정된 과거 메이커로그를 참고해주세요 🙂)

이번 주에 러시아워에서는 대규모 업데이트가 진행되었는데요!🚀

지금부터 💝노선 확장과 🤖AI 예측 기능 도입, 두 가지 업데이트 내용을 간단히 설명드릴게요!

이용 가능한 노선 대폭 확장

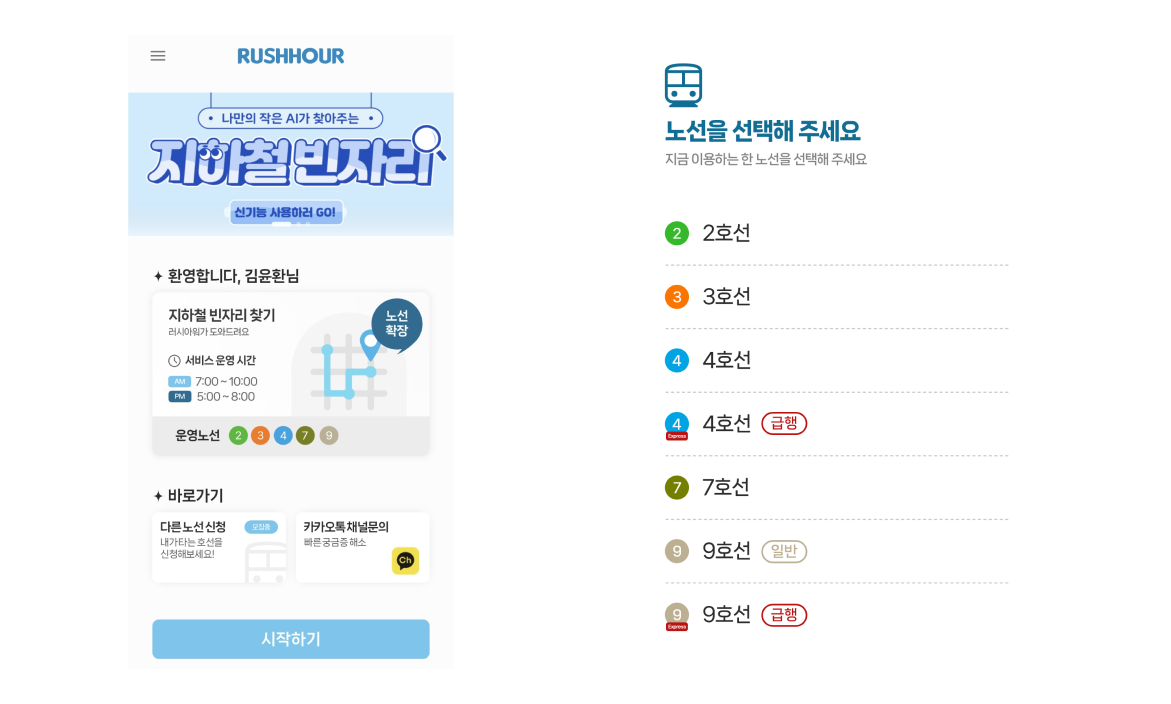
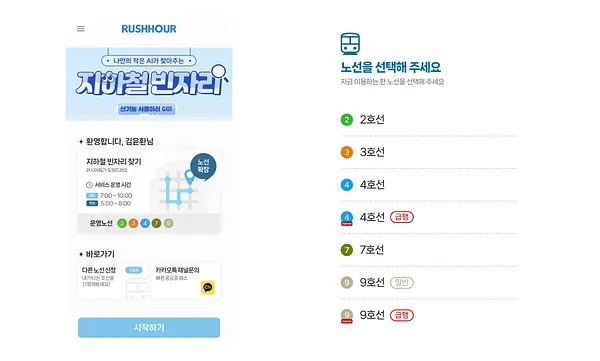
우선, 3호선에서만 제공되었던 서비스에서 사용 가능한 노선을 대폭 확장하였습니다 👏👏

Group 54.png

"저도 러시아워 어플 사용하고 싶은데 3호선을 안 타서 사용하지 못하고 있어요. 얼른 2호선에서도 서비스를 확장해주세요"

2천명이 넘는 유저분들이 원하는 노선을 신청해주셔서 러시아워 서비스의 니즈를 확인할 수 있었습니다.

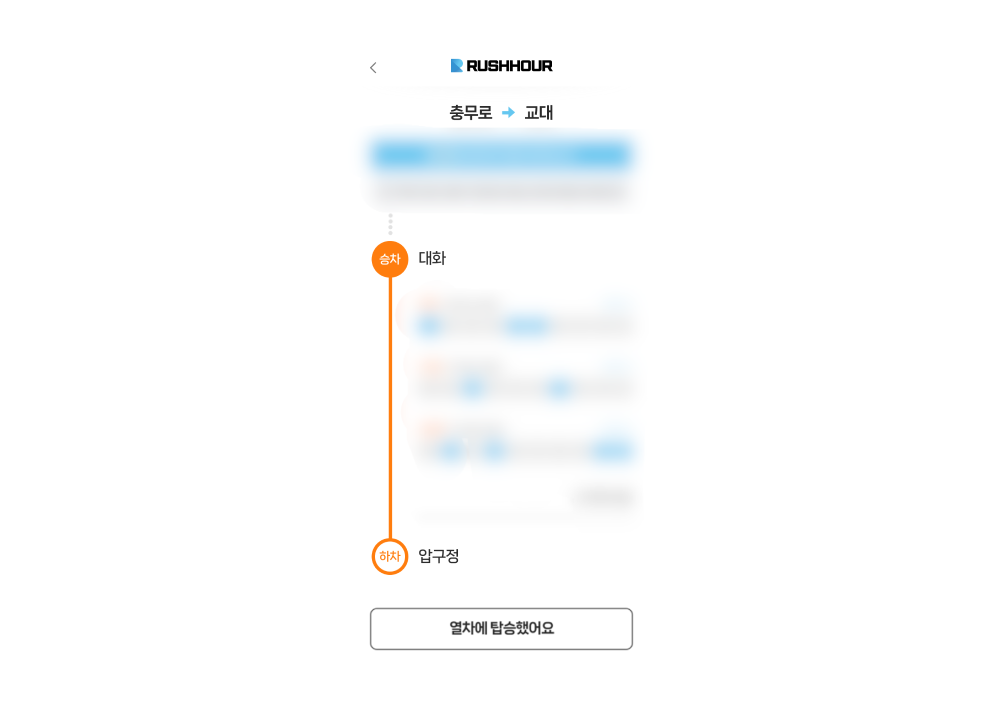
이를 즉각 반영하기 위해 모든 팀원들이 밤낮없이 준비했고, 이제는 2️⃣3️⃣4️⃣7️⃣9️⃣호선에서도 러시아워를 사용할 수 있게 되었습니다.

원하는 호선을 선택하고 실시간으로 빌자리 정보를 받아보실 수 있으십니다!

AI 빌자리 예측 기능 도입

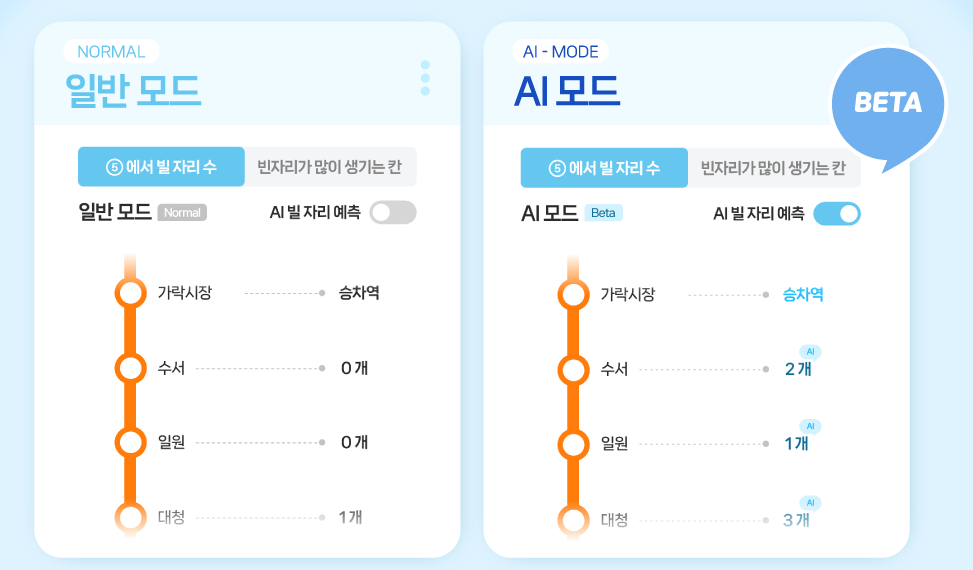
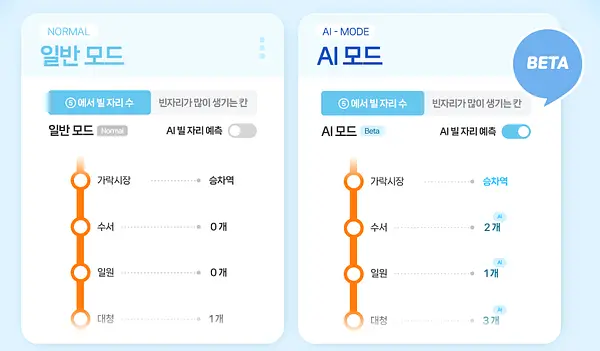
또한, 노선 확장과 동시에 새로 "AI 빌자리 예측 기능"을 도입하였습니다.

image 6.png

3호선에서 3일간 짧게 제공되었던 AI 빌자리 예측 기능,

이제는 더 많은 노선에서 사용할 수 있습니다 😃

AI 빌자리 예측 기능으로 더 많은 빌자리 정보를 받아보세요!

빈자리가 많이 날 것으로 예상되는 곳으로 이동하면, 앉을 확률이 훨씬 높아지게 됩니다.🆙✨

(우측 상단의 AI 기능 스위치를 켜면, 1초만에 신기능을 사용하실 수 있어요!)

날카로운 피드백 부탁드려요!

Group 56.png

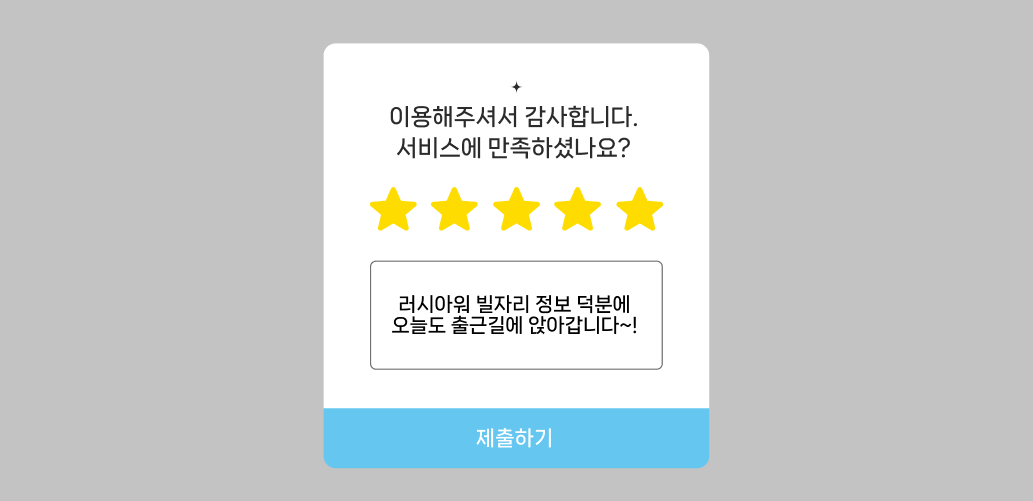
러시아워에서는 서비스 이용 후에 만족도와 피드백을 남기실 수 있습니다.

저희는 매일 새로 들어오는 피드백을 확인하며 서비스를 개선해나가고 있습니다.

서비스를 이용하며 불편했던 점, 개선했으면 하는 점 등 저희에게 하고 싶은 말을 해주세요 🙂 (이 글을 쓰는 동안에도 또 피드백이 들어왔네요ㅎㅎ)

아래는 다운로드 링크입니다! 러시아워 다운 받고 앞으로는 지하철 꼭 앉아가세요~🤗

🔗러시아워 다운받기

마지막으로, 앞으로 새로 도입될 기능에 대해서 간단하게만 스포하고 마무리하려고 합니다 ㅎㅎ

빌 자리 정보를 지하철에 타기 전에 확인할 수는 없나요?"

Group 57.png

이러한 유저들의 니즈에 즉각 반영하여,

곧 지하철에 탑승하기 전에도 미리 빈자리가 많이 생기는 칸에 대한 정보를 확인하실 수 있습니다.

해당 기능이 도입 되면 다시 한 번 소개해드리겠습니다!👏

러시아워 팀은 이번 메이커로그의 제목처럼, 러시아워를 통해 지하철 무조건 앉아갈 수 있는 세상🌎을 만들어나가고 있습니다.

저희의 여정을 앞으로도 계속해서 지켜봐주시면 감사하겠습니다.

추가되었으면 하는 기능 등 피드백은 댓글로 같이 소통해봐요~!

러시아워

실시간 지하철 빌자리 예측 서비스

26
5
노하우 정민호

노하우 정민호

[💸 모든 창업가들의 꿈, Exit에 성공한 CEO들이 판교에 모입니다 ]

image.png

🔥 이제 혼자 고민하지 마시고, Exit한 대표님에게 물어보세요

페스타 진 겸 CEO (당근마켓 Exit), 도파민트 오규태 CEO (라인 프렌즈 Exit), 프리딕션 이인섭 CEO (메가스터디 Exit), 비즈니스캔버스 김우진 CEO를 한 자리에 모았습니다. (예비)대표님과 똑같은 고민을 먼저 경험한 CEO들의 이야기를 듣고, 압축적으로 회사를 성장시키세요.

🔥 단 하루, 현장에서만 질문과 답변이 가능한 Private 형태로 진행됩니다.

투자, M&A, 팀빌딩 등 내밀한 이야기가 오가는 행사인만큼 세미나의 내용은 완전히 보호되며 참석자에 한해서만 공개되며 무료 행사입니다.

📍 경기 판교 제2테크노밸리 기업지원허브 창업존 6층, 대회의실

📍 2023년 8월 23일 수요일 14:00-17:00

📍신청경로

5
0
Cailyn Yong

Cailyn Yong

[Part 2] 2시간 안에 업무 자동화 AI Agent 만들기: LLM 체인 직접 써보기

Part 1에 이이서 오늘은 Part 2를 올립니다.

Part 1: 전체 프로그램 셋업, OpenAI API 연결, Vector Store 연결

Part 2: 커스텀 LLM 체인 직접 만들고나서 실행하기

Part 3: Agent가 나 대신 실제 구글 검색하는 기능 만들기

LLM 체인 만들기

Part 1에서 기본적인 것들이 연결됐으니 이제 실제 LLM 체인을 만들어볼거에요.

일단 저희가 만들 AI agent가 어떻게 작동되냐면, 먼저 유저가 “페이스북 시장 조사 좀 해줘”라고 하면 이 업무를 하기 위해 해야할 태스크들을 리스트업합니다. 그 다음 태스크별로 실행을 하고 결과값을 생성합니다.

이를 하기 위해서는 3개의 체인이 활용됩니다.

  1. 태스크를 생성하고 리스트에 추가하는 체인

  2. 태스크 중 중요도 높은 태스크부터 처리하게끔 관리하는 체인

  3. 각 태스크를 실제로 실행하는 체인

First LLM Chain

유저 프롬트에 맞게 태스크를 생성하고 리스트에 추가하는 첫번째 체인 코드입니다.

class TaskCreationChain(LLMChain):
    """Chain to generates tasks."""

    @classmethod
    def from_llm(cls, llm: BaseLLM, verbose: bool = True) -> LLMChain:
        """Get the response parser."""
        task_creation_template = (
            "You are a task creation AI that uses the result of an execution agent"
            " to create new tasks with the following objective: {objective},"
            " The last completed task has the result: {result}."
            " This result was based on this task description: {task_description}."
            " These are incomplete tasks: {incomplete_tasks}."
            " Based on the result, create new tasks to be completed"
            " by the AI system that do not overlap with incomplete tasks."
            " Return the tasks as an array."
        )
        prompt = PromptTemplate(
            template=task_creation_template,
            input_variables=[
                "result",
                "task_description",
                "incomplete_tasks",
                "objective",
            ],
        )
        return cls(prompt=prompt, llm=llm, verbose=verbose)

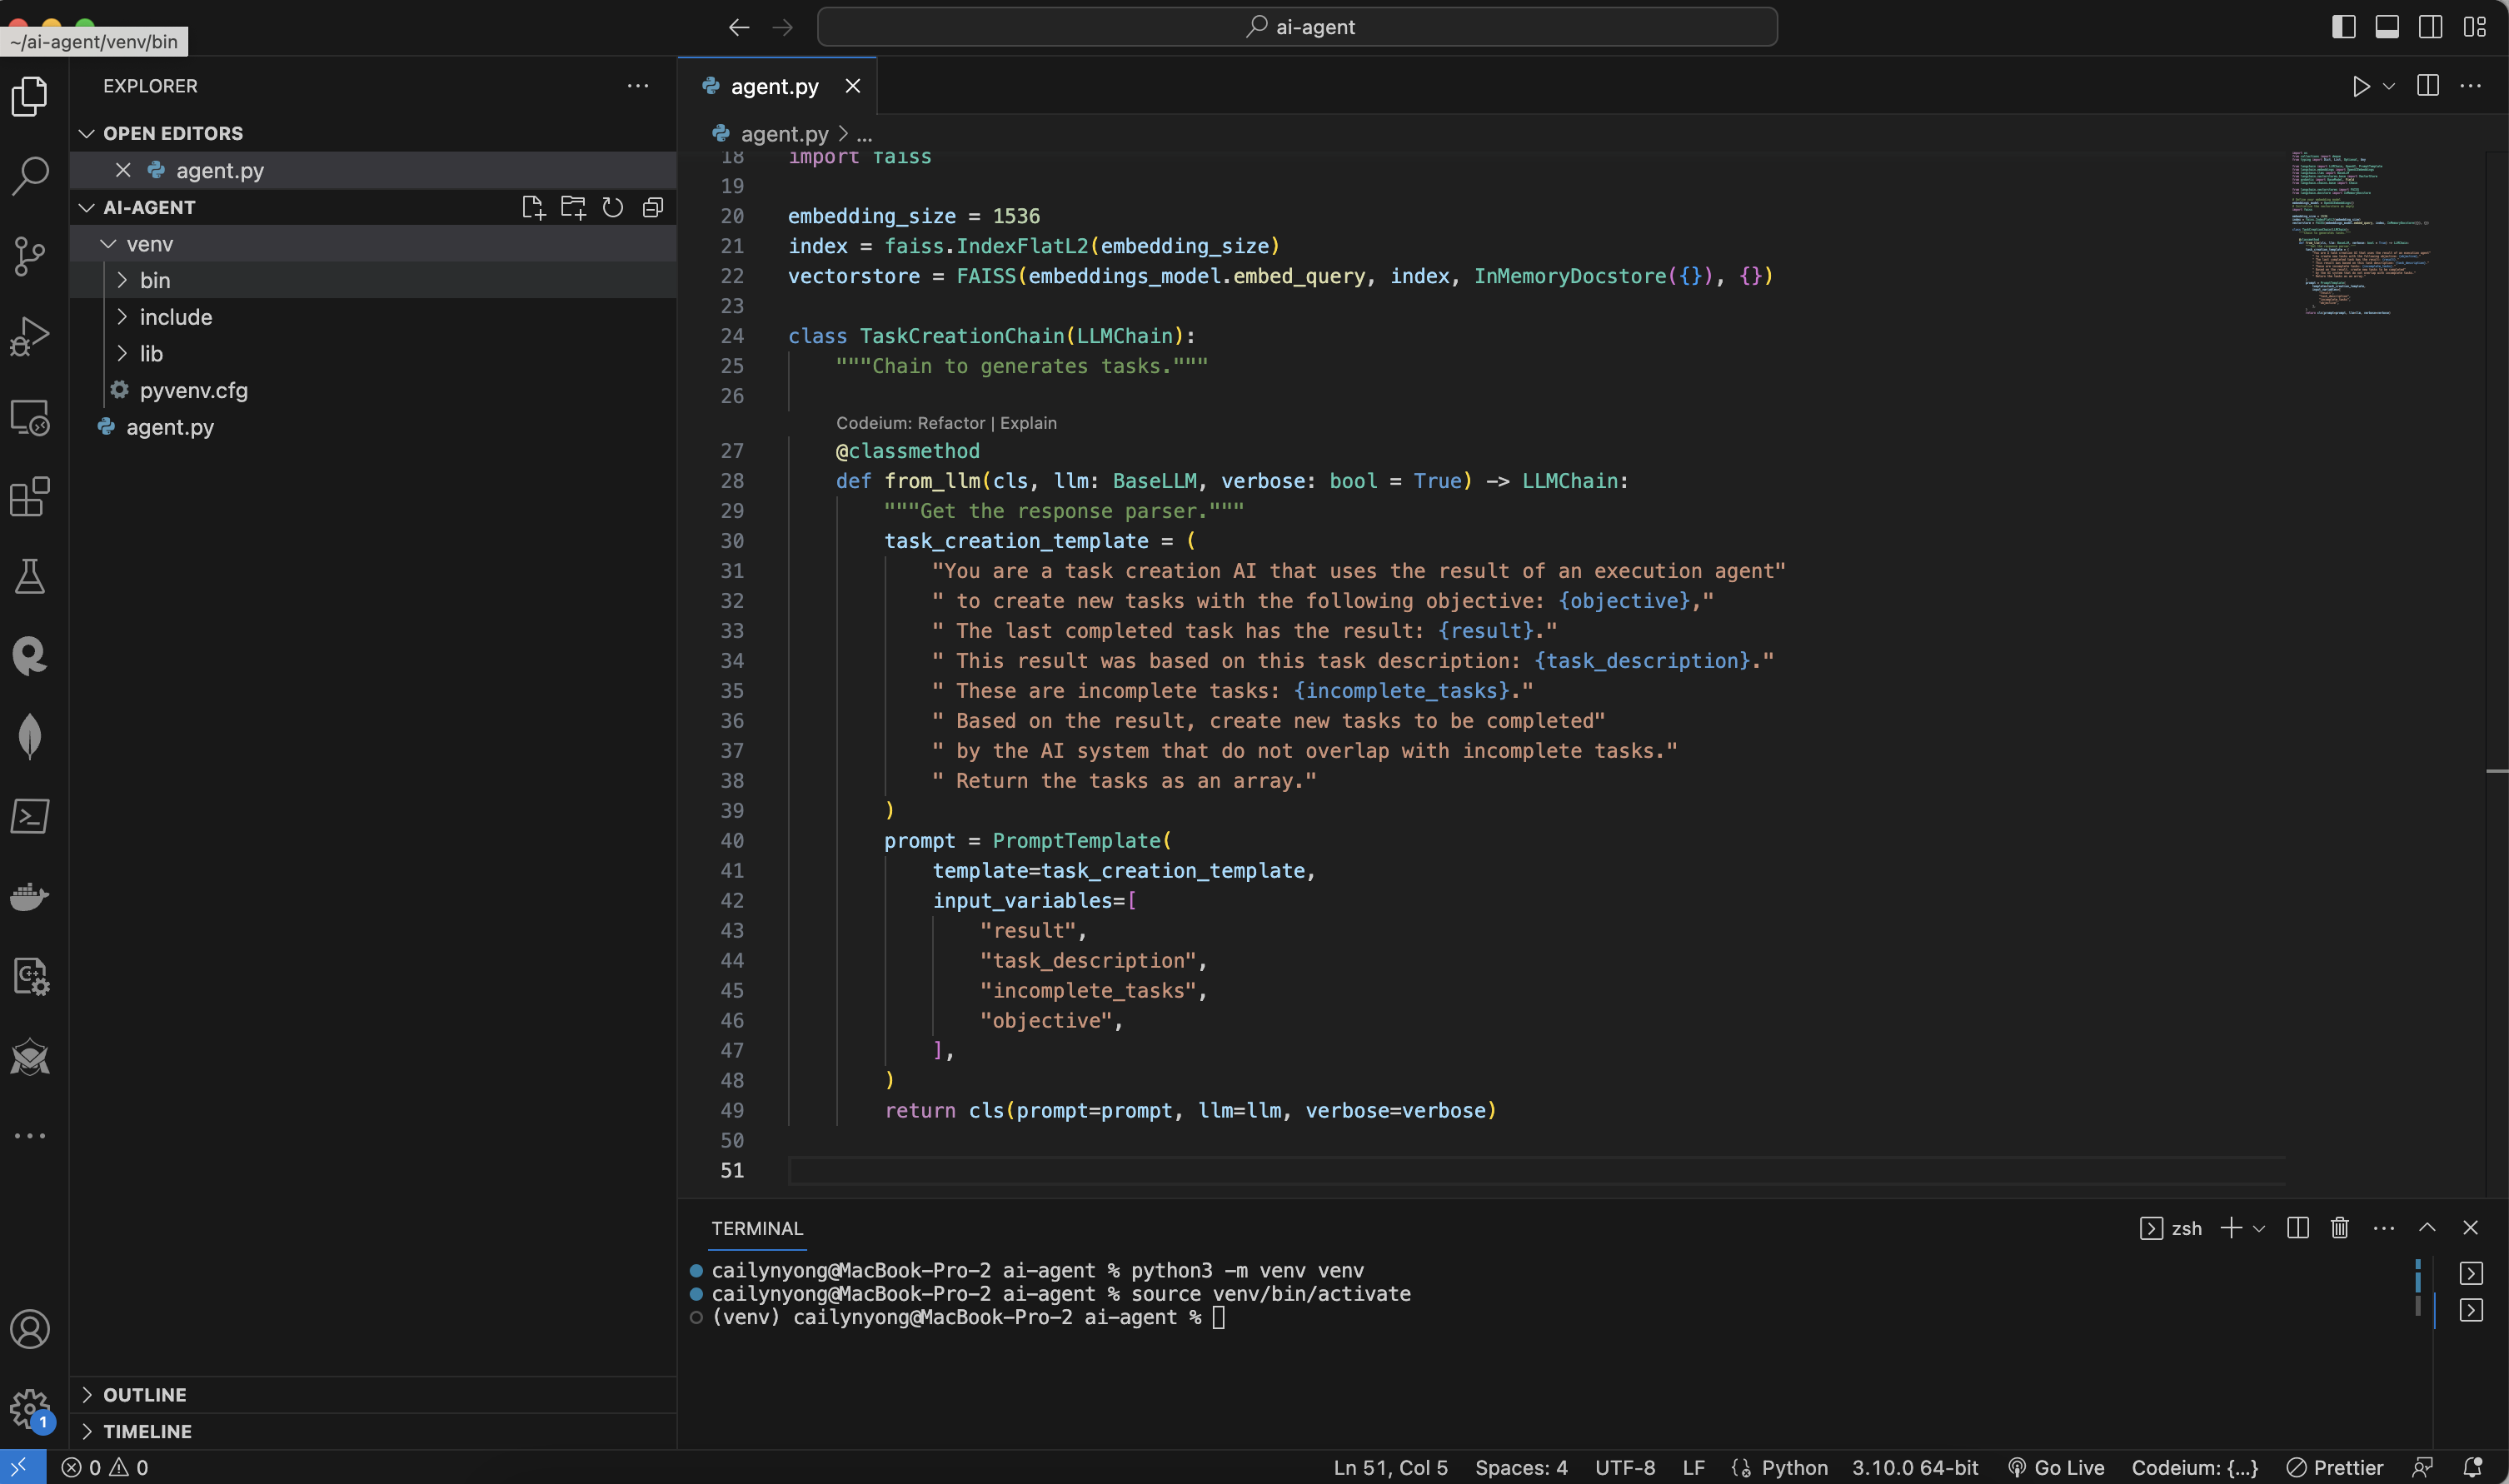
여기서 코드를 일일이 이해할 필요는 없고, 크게 어떻게 작동되는지만 알면 됩니다.

일단 맨 처음에 TaskCreationChain이라는 클래스를 생성했고, 이 클래스를 호출했을때 업무 자동화를 하기 위한 명령 템플릿이 task_creation_template에 작성돼있습니다.

말그대로 LLM 체인에게 이렇게 해라 라고 명시하는 겁니다.

task_creation_template = ( … )에 작성돼있는 텍스트를 보면, “너는 태스크를 생성하는 AI이고 태스크 별로 실행까지 하는 에이전트야. 내가 입력하는 {objective}에 맞게 태스크를 생성하고, 가장 최근에 실행된 태스크의 결과값은 {result}에 저장하고, 태스크에 관한 설명은 {task_description}에 저장될거야. 아직 실행되지 않은 태스크들은 {incomplete_tasks}에 저장해. 결과값을 통해 아직 실행되지 않은 태스크들을 실행하고 결과값들은 배열 형태로 정리해줘”라고 써져 있습니다.

이런 프롬트 템플릿은 제가 원하는대로 언제든지 바꿀 수 있습니다. 직접 코드로 개발을 하지 않아도 정말 텍스트로 AI에게 명령하는거죠.

다음 코드 줄에서는 이 task_creation_template을 prompt라는 곳에 저장하고, 인풋은 “result”, “task_description”, “incomplete_tasks”, “objective”이라는 것을 확인할 수 있습니다.

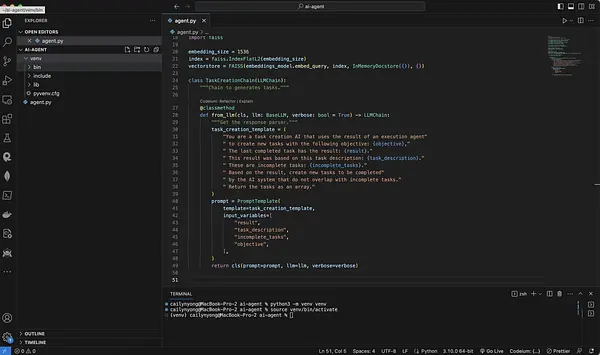
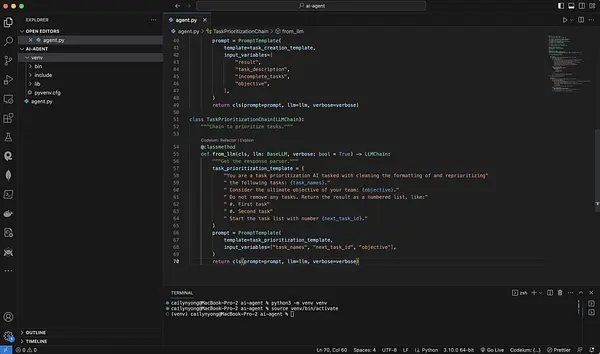
코드를 복붙하고 나면 이렇게 생겼습니다.
Screenshot 2023-08-16 at 5.37.29 PM.pngSecond LLM Chain

다음은 태스크 중 중요도 높은 태스크들을 먼저 실행하게끔 관리하는 두번째 체인 코드입니다.

class TaskPrioritizationChain(LLMChain):
    """Chain to prioritize tasks."""

    @classmethod
    def from_llm(cls, llm: BaseLLM, verbose: bool = True) -> LLMChain:
        """Get the response parser."""
        task_prioritization_template = (
            "You are a task prioritization AI tasked with cleaning the formatting of and reprioritizing"
            " the following tasks: {task_names}."
            " Consider the ultimate objective of your team: {objective}."
            " Do not remove any tasks. Return the result as a numbered list, like:"
            " #. First task"
            " #. Second task"
            " Start the task list with number {next_task_id}."
        )
        prompt = PromptTemplate(
            template=task_prioritization_template,
            input_variables=["task_names", "next_task_id", "objective"],
        )
        return cls(prompt=prompt, llm=llm, verbose=verbose)

첫번째 체인과 아주 비슷한 형식이죠?

이번에 task_prioritization_template에는 “너는 {task_names} 태스크들 중에서 중요도 높은 태스크부터 실행되도록 순번을 관리하는 AI야. 최종 {objective} 목표를 염두하면서 순번 관리를 해줘. 태스크들 중 어떤것도 지우지 말고 결과값은 리스트 형태로 보여줘: “#. 첫번째 태스크, #. 두번째 태스크”. 태스크 리스트는 태스크 숫자 아이디로 {next_task_id} 시작해줘.” 라고 써져 있습니다.

첫번째 체인 코드 밑에 또 복붙하세요.
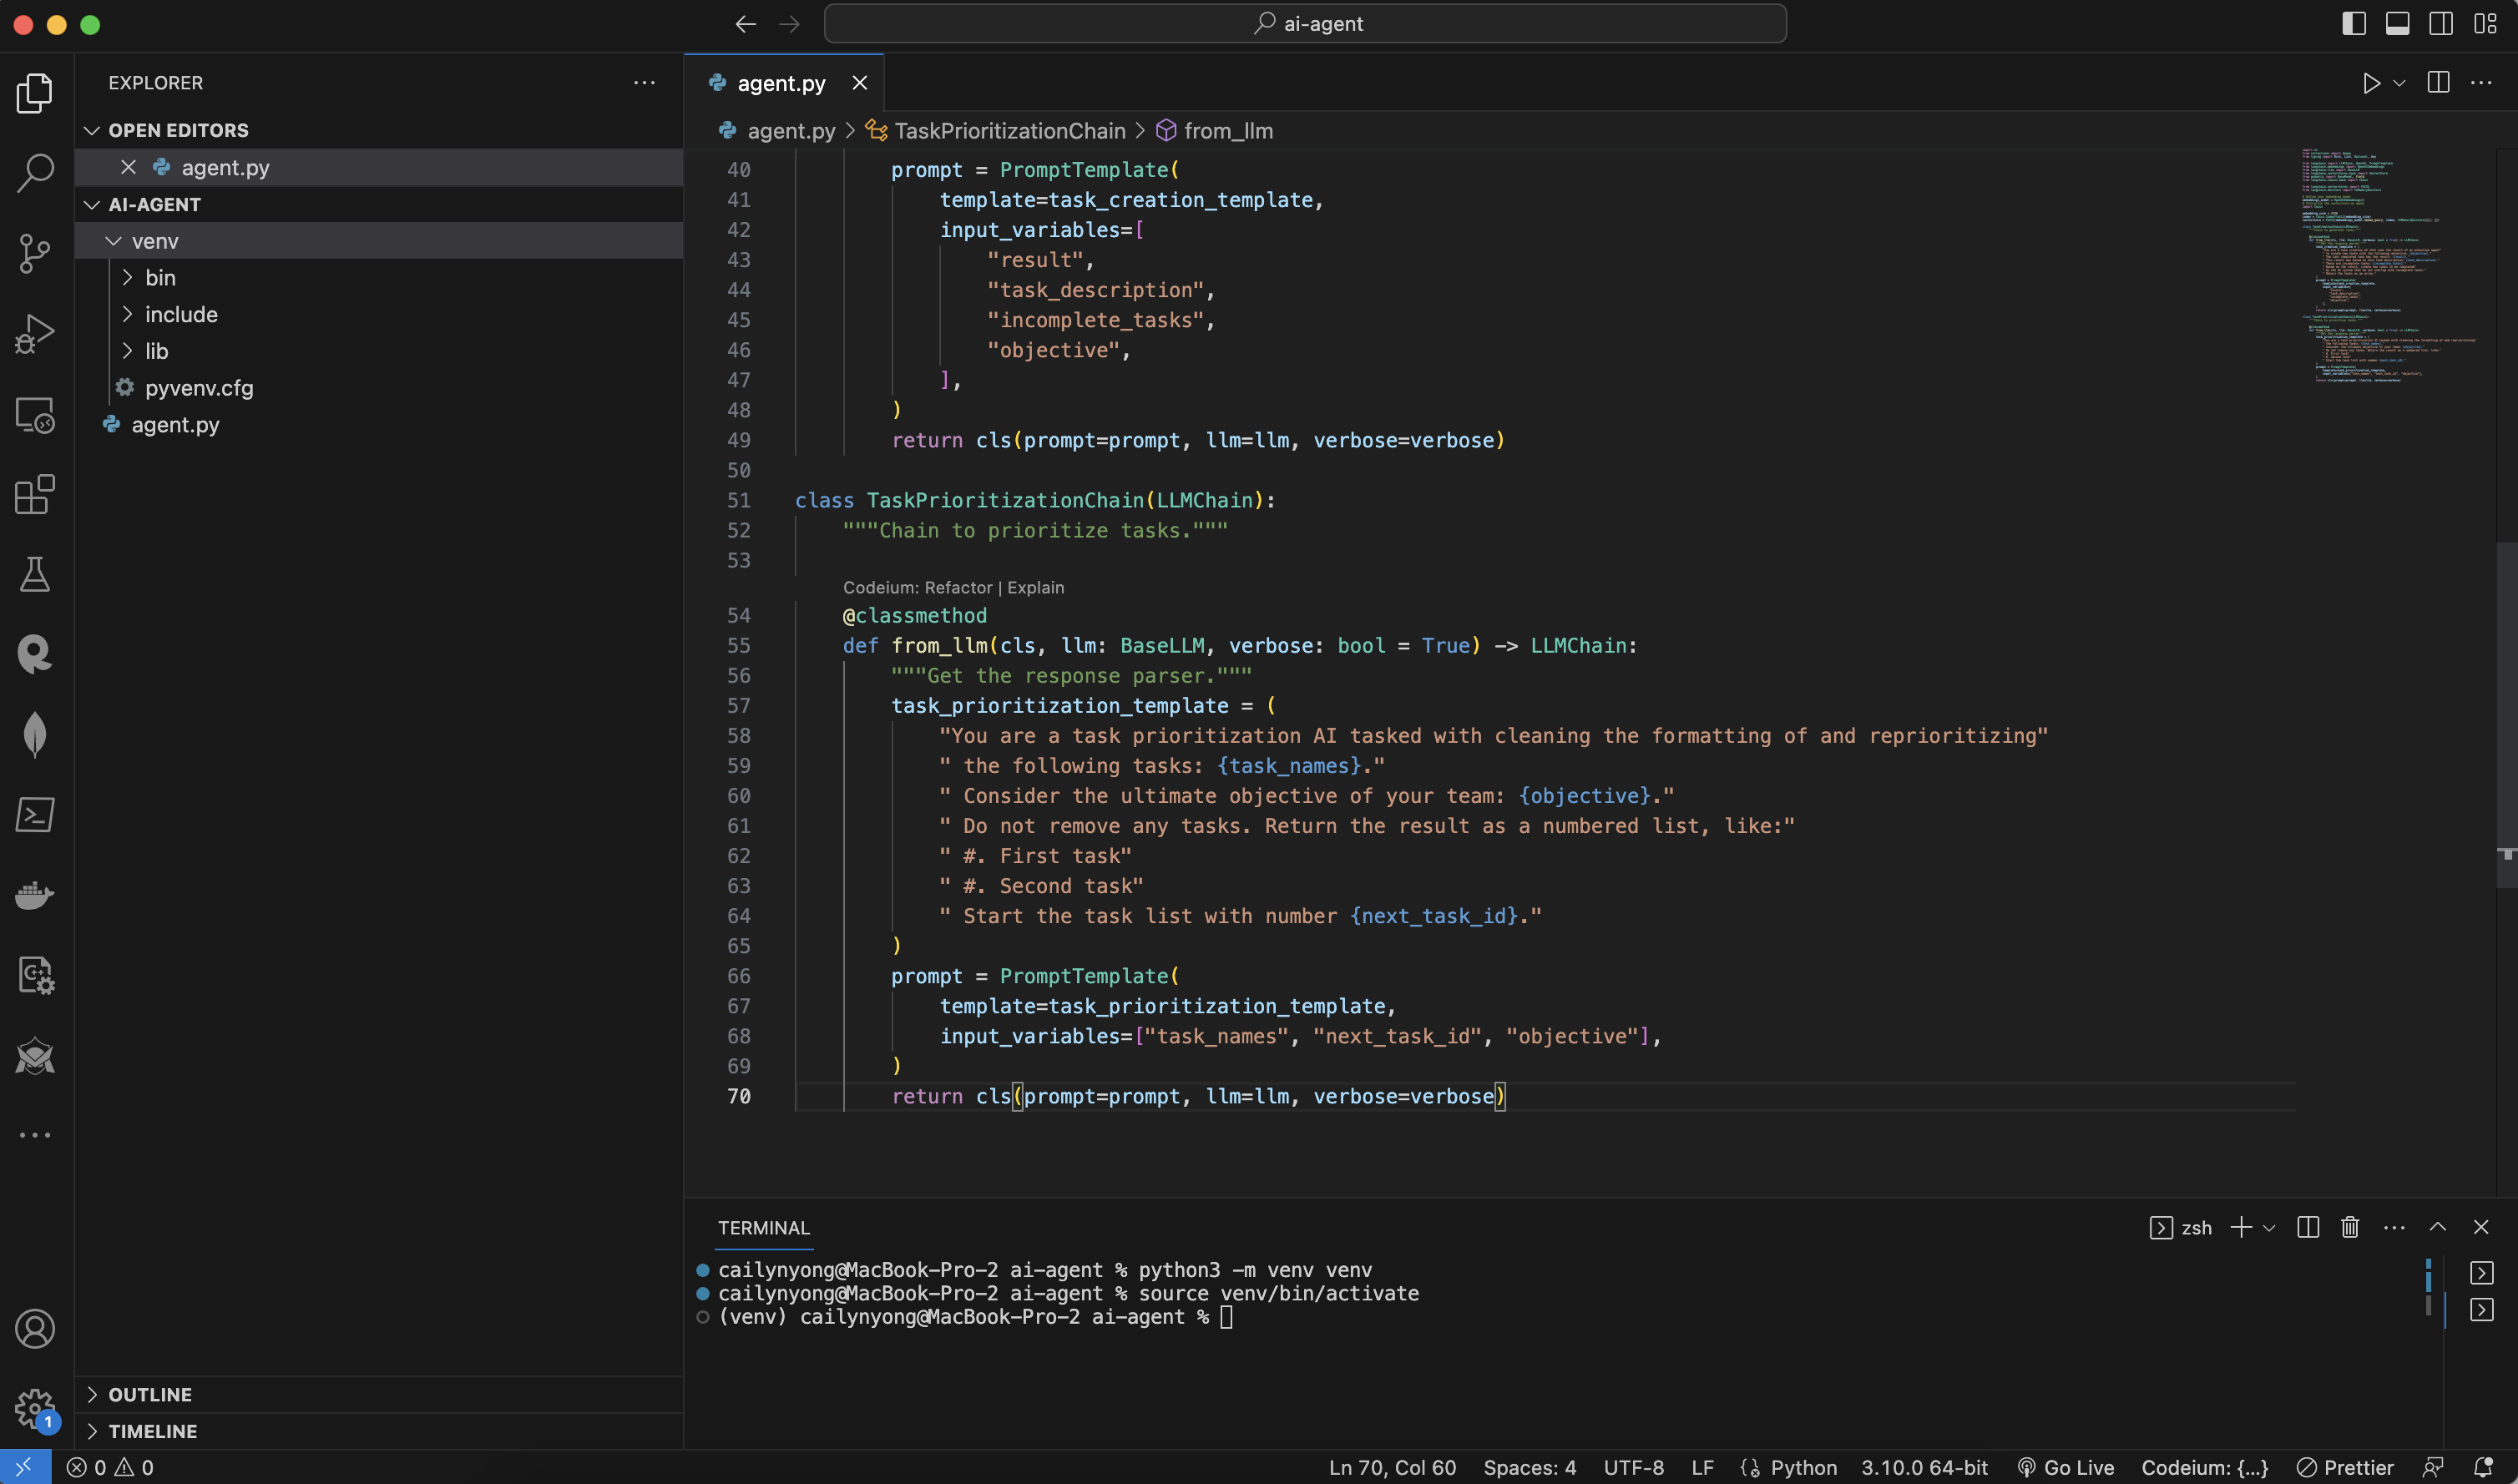
Screenshot 2023-08-16 at 5.45.40 PM.pngThird LLM Chain

이제 마지막 체인, 실제 태스크를 실행하게끔 하는 체인 코드입니다.

class ExecutionChain(LLMChain):
    """Chain to execute tasks."""

    @classmethod
    def from_llm(cls, llm: BaseLLM, verbose: bool = True) -> LLMChain:
        """Get the response parser."""
        execution_template = (
            "You are an AI who performs one task based on the following objective: {objective}."
            " Take into account these previously completed tasks: {context}."
            " Your task: {task}."
            " Response:"
        )
        prompt = PromptTemplate(
            template=execution_template,
            input_variables=["objective", "context", "task"],
        )
        return cls(prompt=prompt, llm=llm, verbose=verbose)

여기서 템플릿에는 “너는 큰 목표 {objective}에 맞게 한 개의 태스크를 실행하는 AI야. 전에 실행 완료된 태스크들의 {context}를 생각하면서 태스크를 실행하도록 해. 너의 태스크: {task}.”라고 써져있습니다.

마찬가지로 코드를 두번째 체인 코드 밑에 복붙하세요.
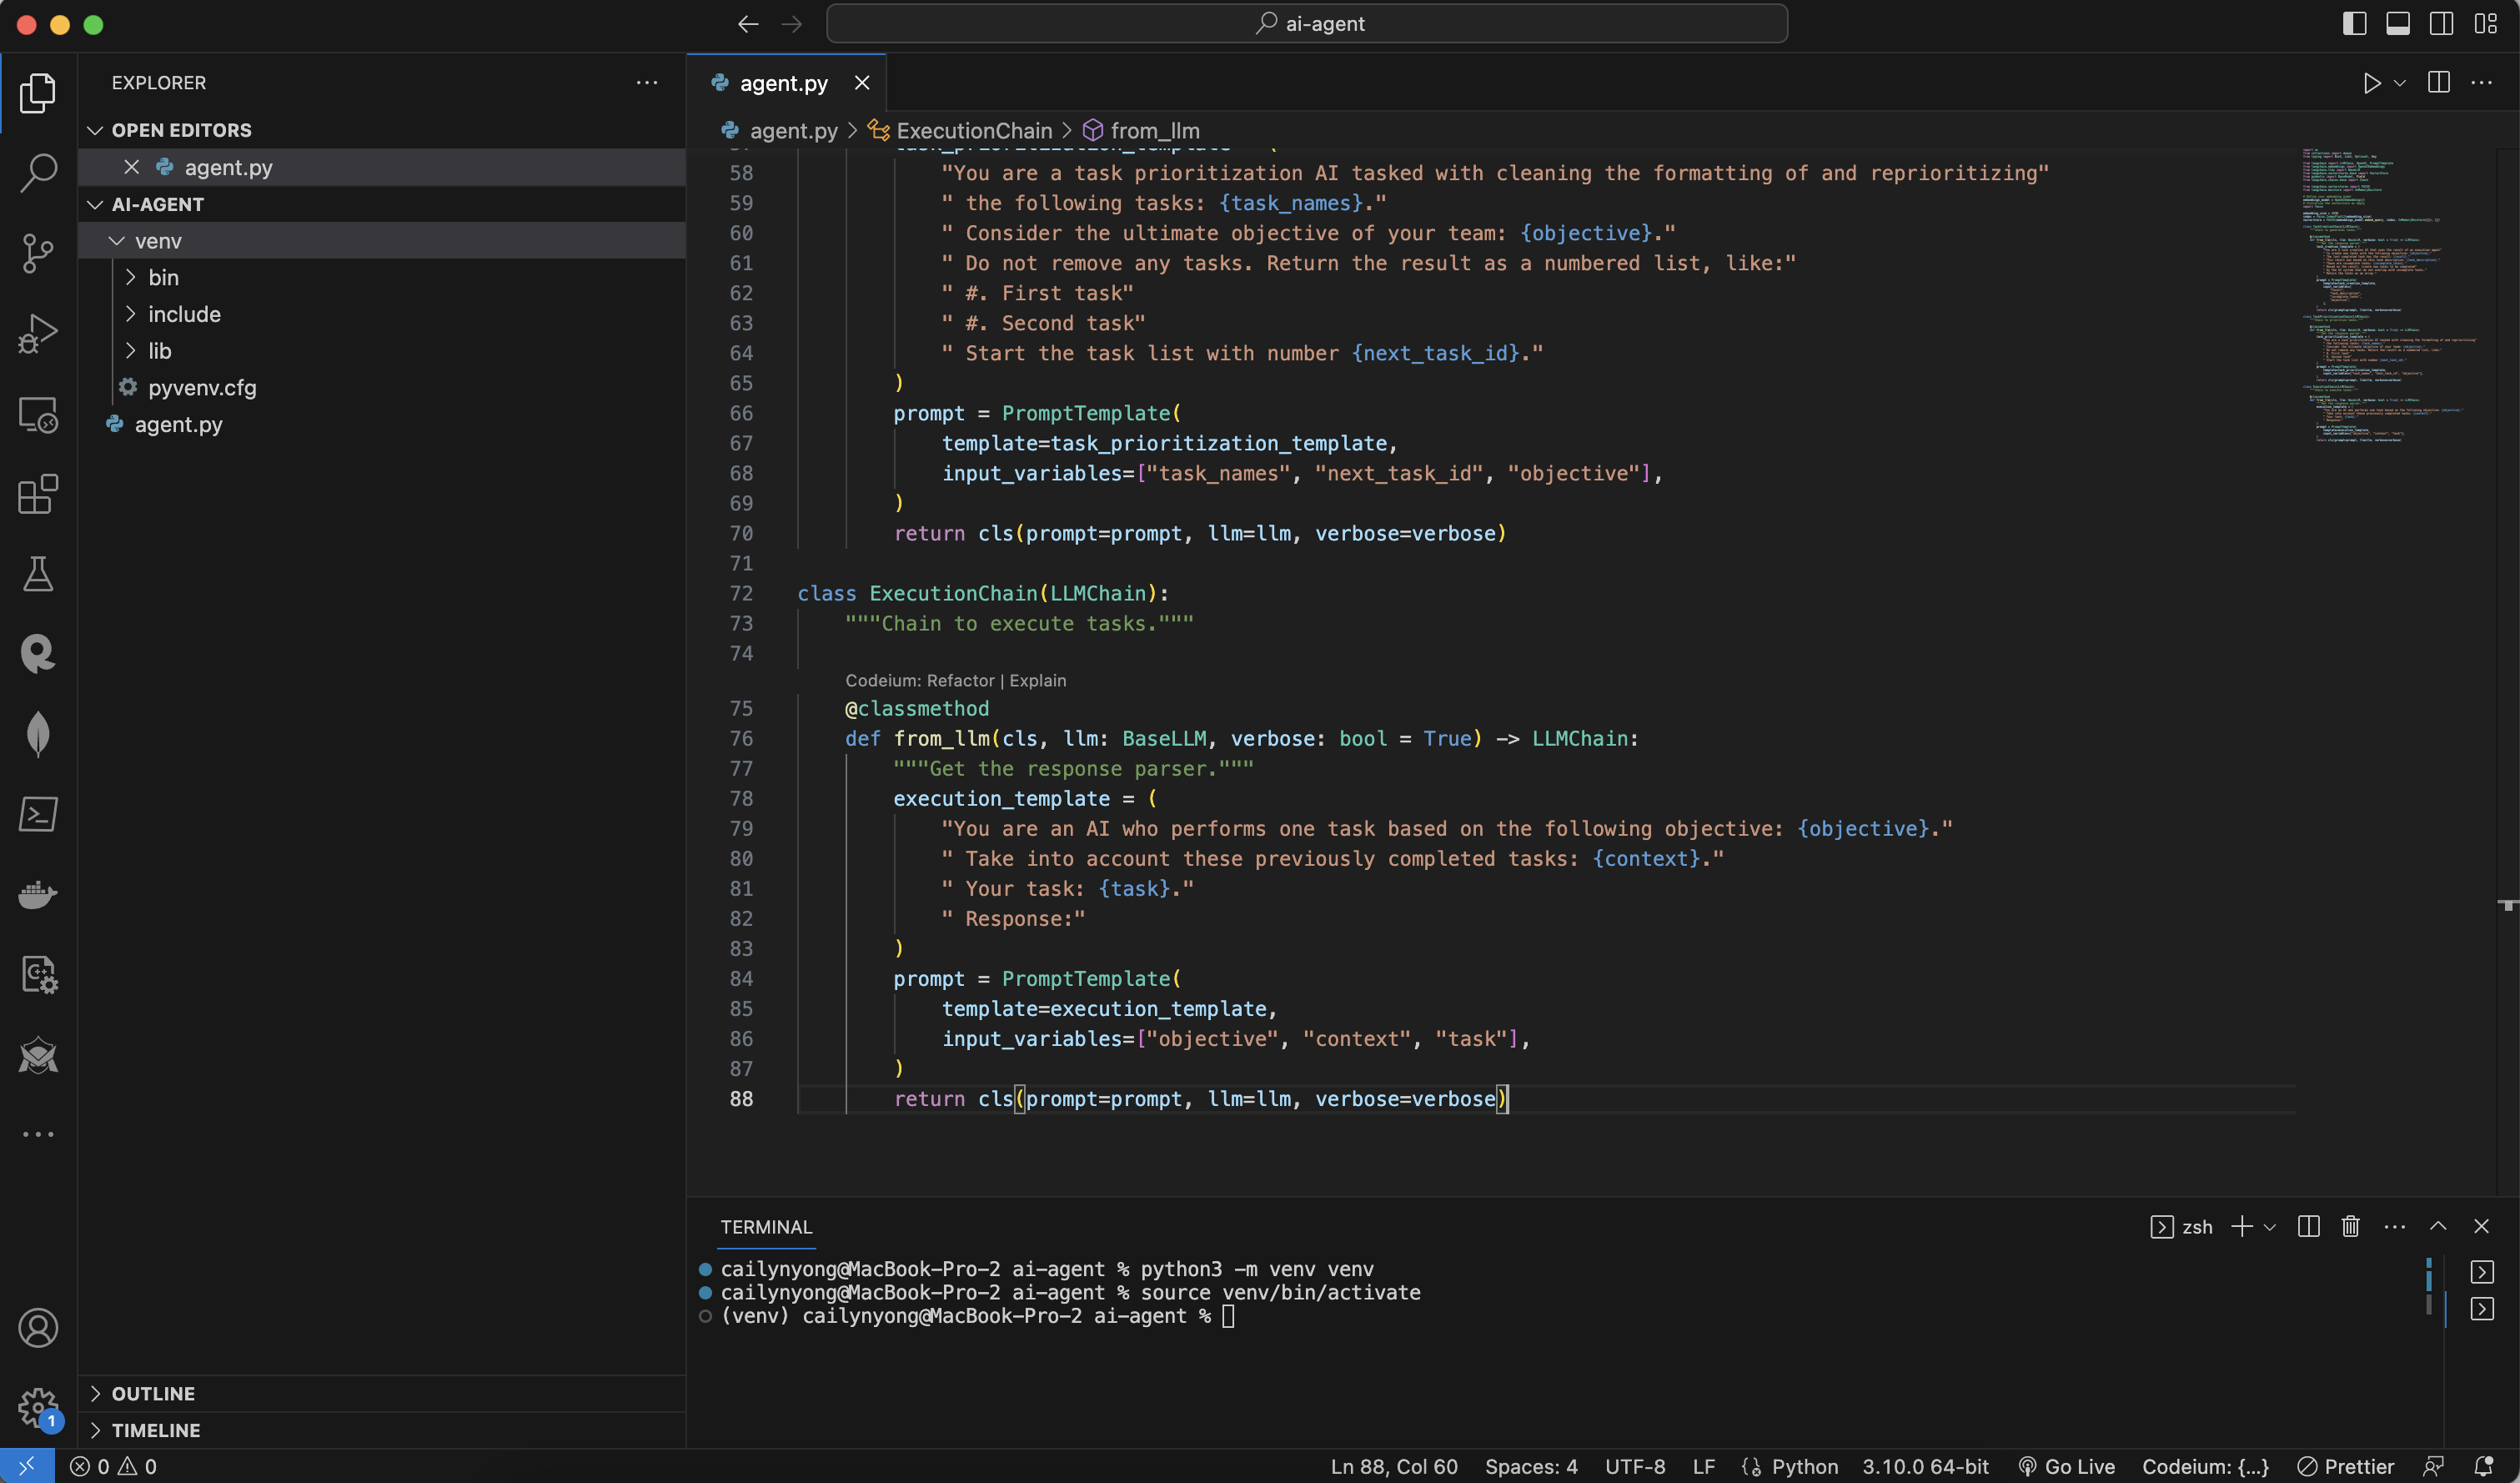
Screenshot 2023-08-16 at 5.48.17 PM.pngBabyAGI Controller

이제 BabyAGI 컨트롤러를 만들 차례입니다. 위에서 만든 세 개의 체인들을 활용해서 유저가 인풋을 주면 그 인풋에 맞게 자동으로 태스크들을 생성하고 처리하게끔 만들어야 합니다.

def get_next_task(
    task_creation_chain: LLMChain,
    result: Dict,
    task_description: str,
    task_list: List[str],
    objective: str,
) -> List[Dict]:
    """Get the next task."""
    incomplete_tasks = ", ".join(task_list)
    response = task_creation_chain.run(
        result=result,
        task_description=task_description,
        incomplete_tasks=incomplete_tasks,
        objective=objective,
    )
    new_tasks = response.split("\\n")
    return [{"task_name": task_name} for task_name in new_tasks if task_name.strip()]

위 코드는 1) 처음에 에이전트가 해야할 태스크 리스트업을 했을때 첫 태스크를 완료하고 난 뒤 아직 실행되지 않은 다음 태스크를 불러오고, 2) 나머지 미완료 태스크들을 다시 생성 + 리스트업하기 위해 첫번째 태스크 생성 체인을 불러오는 코드입니다.

def prioritize_tasks(
    task_prioritization_chain: LLMChain,
    this_task_id: int,
    task_list: List[Dict],
    objective: str,
) -> List[Dict]:
    """Prioritize tasks."""
    task_names = [t["task_name"] for t in task_list]
    next_task_id = int(this_task_id) + 1
    response = task_prioritization_chain.run(
        task_names=task_names, next_task_id=next_task_id, objective=objective
    )
    new_tasks = response.split("\\n")
    prioritized_task_list = []
    for task_string in new_tasks:
        if not task_string.strip():
            continue
        task_parts = task_string.strip().split(".", 1)
        if len(task_parts) == 2:
            task_id = task_parts[0].strip()
            task_name = task_parts[1].strip()
            prioritized_task_list.append({"task_id": task_id, "task_name": task_name})
    return prioritized_task_list

위 코드는 저희가 만든 두번째 태스크 순번 관리 체인을 실행하기 위한 코드입니다.

def _get_top_tasks(vectorstore, query: str, k: int) -> List[str]:
    """Get the top k tasks based on the query."""
    results = vectorstore.similarity_search_with_score(query, k=k)
    if not results:
        return []
    sorted_results, _ = zip(*sorted(results, key=lambda x: x[1], reverse=True))
    return [str(item.metadata["task"]) for item in sorted_results]

def execute_task(
    vectorstore, execution_chain: LLMChain, objective: str, task: str, k: int = 5
) -> str:
    """Execute a task."""
    context = _get_top_tasks(vectorstore, query=objective, k=k)
    return execution_chain.run(objective=objective, context=context, task=task)

마지막으로 _get_top_tasks는 가장 첫번째 순서인 태스크를 불러오는 거고, execute_task는 저희가 세번째로 만든 태스크 실행하는 체인을 불러와서 첫번째 순서 태스크부터 실행하게끔 하는 코드입니다.

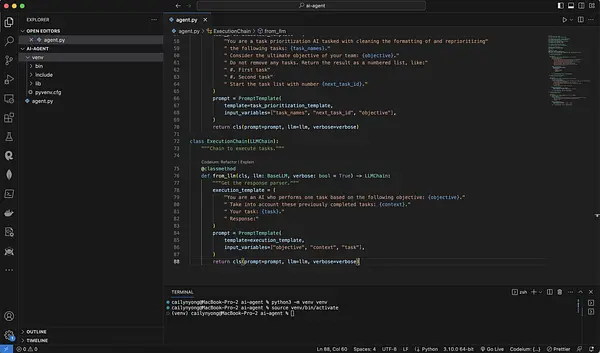
이 모든 코드를 순서대로 복붙하세요. 그럼 아래 이미지처럼 생겼습니다.
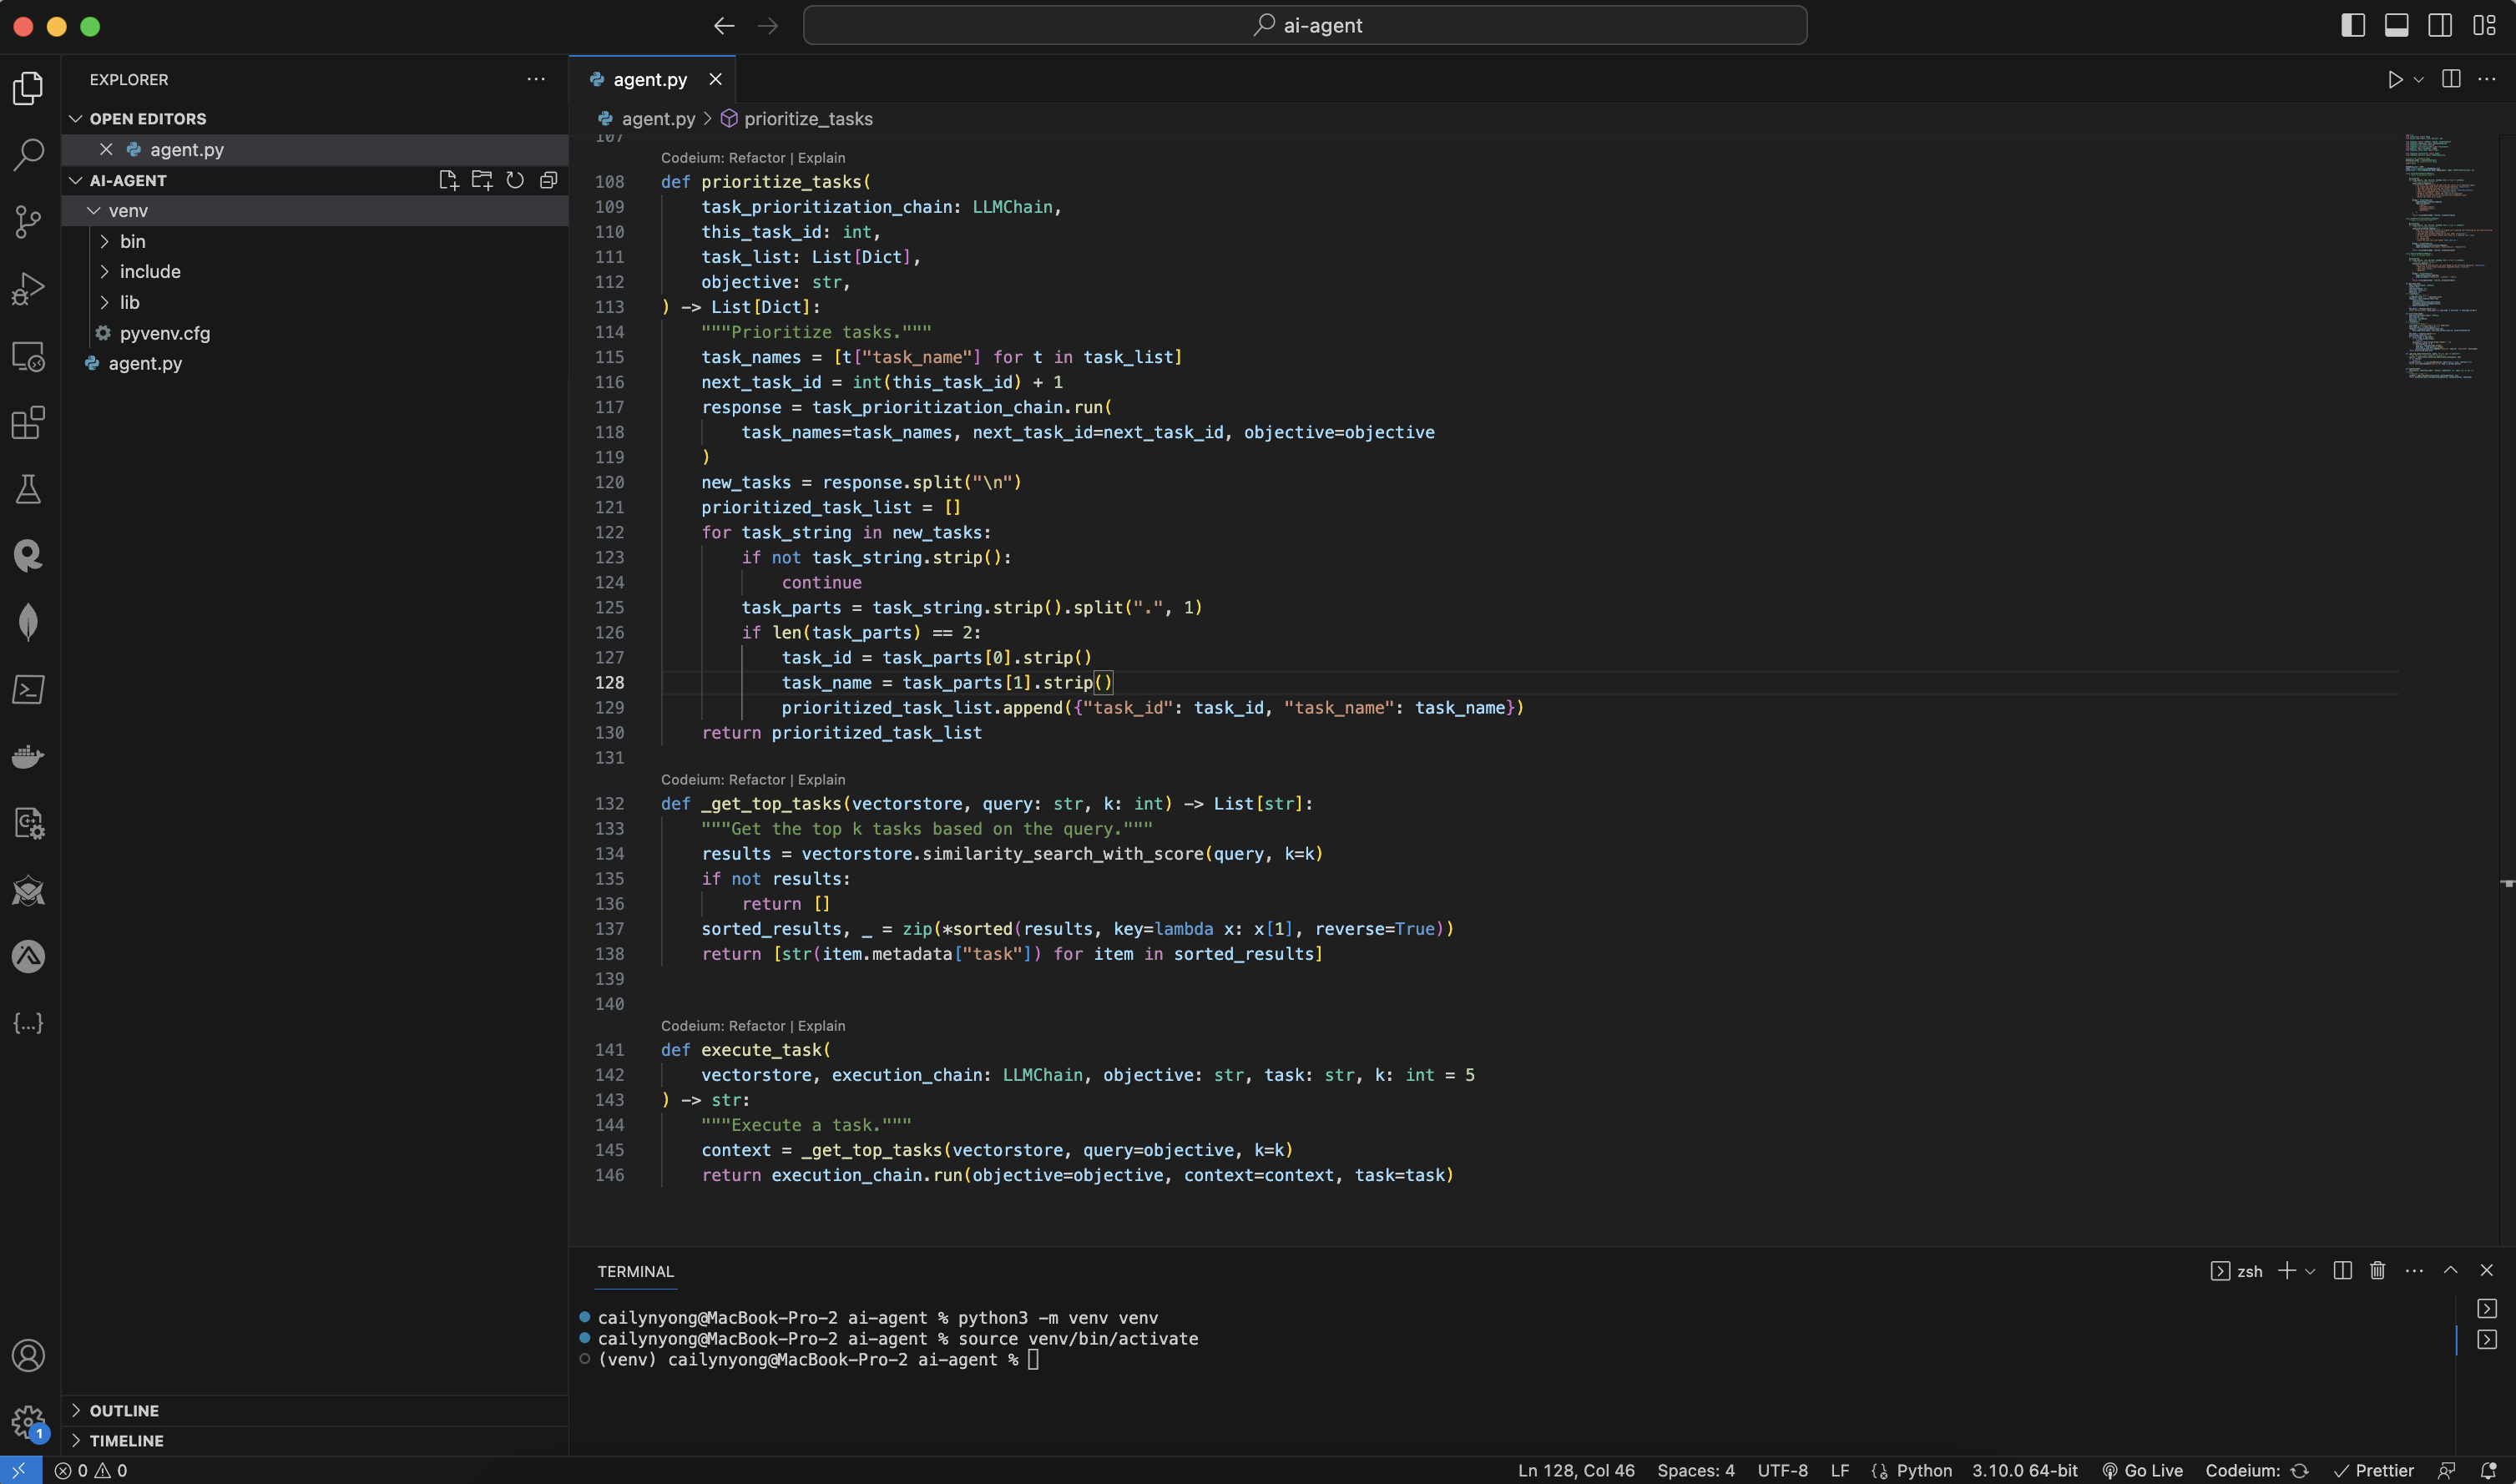
Screenshot 2023-08-16 at 6.01.24 PM.png이제 정말 거의 다왔습니다.

여태까지 만든 모든 코드 블록들을 저희 AI Agent가 적절하게 쓸 수 있도록 짜집기 해줄거에요.

여기서 class BabyAGI 코드 블록이 실질적으로 AI Agent의 역할을 한다고 생각하시면 됩니다.

class BabyAGI(Chain, BaseModel):
    """Controller model for the BabyAGI agent."""

    task_list: deque = Field(default_factory=deque)
    task_creation_chain: TaskCreationChain = Field(...)
    task_prioritization_chain: TaskPrioritizationChain = Field(...)
    execution_chain: ExecutionChain = Field(...)
    task_id_counter: int = Field(1)
    vectorstore: VectorStore = Field(init=False)
    max_iterations: Optional[int] = None

    class Config:
        """Configuration for this pydantic object."""

        arbitrary_types_allowed = True

    def add_task(self, task: Dict):
        self.task_list.append(task)

    def print_task_list(self):
        print("\033[95m\033[1m" + "\n*****TASK LIST*****\n" + "\033[0m\033[0m")
        for t in self.task_list:
            print(str(t["task_id"]) + ": " + t["task_name"])

    def print_next_task(self, task: Dict):
        print("\033[92m\033[1m" + "\n*****NEXT TASK*****\n" + "\033[0m\033[0m")
        print(str(task["task_id"]) + ": " + task["task_name"])

    def print_task_result(self, result: str):
        print("\033[93m\033[1m" + "\n*****TASK RESULT*****\n" + "\033[0m\033[0m")
        print(result)

    @property
    def input_keys(self) -> List[str]:
        return ["objective"]

    @property
    def output_keys(self) -> List[str]:
        return []

    def _call(self, inputs: Dict[str, Any]) -> Dict[str, Any]:
        """Run the agent."""
        objective = inputs["objective"]
        first_task = inputs.get("first_task", "Make a todo list")
        self.add_task({"task_id": 1, "task_name": first_task})
        num_iters = 0
        while True:
            if self.task_list:
                self.print_task_list()

                # Step 1: Pull the first task
                task = self.task_list.popleft()
                self.print_next_task(task)

                # Step 2: Execute the task
                result = execute_task(
                    self.vectorstore, self.execution_chain, objective, task["task_name"]
                )
                this_task_id = int(task["task_id"])
                self.print_task_result(result)

                # Step 3: Store the result in Pinecone
                result_id = f"result_{task['task_id']}_{num_iters}"
                self.vectorstore.add_texts(
                    texts=[result],
                    metadatas=[{"task": task["task_name"]}],
                    ids=[result_id],
                )

                # Step 4: Create new tasks and reprioritize task list
                new_tasks = get_next_task(
                    self.task_creation_chain,
                    result,
                    task["task_name"],
                    [t["task_name"] for t in self.task_list],
                    objective,
                )
                for new_task in new_tasks:
                    self.task_id_counter += 1
                    new_task.update({"task_id": self.task_id_counter})
                    self.add_task(new_task)
                self.task_list = deque(
                    prioritize_tasks(
                        self.task_prioritization_chain,
                        this_task_id,
                        list(self.task_list),
                        objective,
                    )
                )
            num_iters += 1
            if self.max_iterations is not None and num_iters == self.max_iterations:
                print(
                    "\033[91m\033[1m" + "\n*****TASK ENDING*****\n" + "\033[0m\033[0m"
                )
                break
        return {}

    @classmethod
    def from_llm(
        cls, llm: BaseLLM, vectorstore: VectorStore, verbose: bool = False, **kwargs
    ) -> "BabyAGI":
        """Initialize the BabyAGI Controller."""
        task_creation_chain = TaskCreationChain.from_llm(llm, verbose=verbose)
        task_prioritization_chain = TaskPrioritizationChain.from_llm(
            llm, verbose=verbose
        )
        execution_chain = ExecutionChain.from_llm(llm, verbose=verbose)
        return cls(
            task_creation_chain=task_creation_chain,
            task_prioritization_chain=task_prioritization_chain,
            execution_chain=execution_chain,
            vectorstore=vectorstore,
            **kwargs,
        )

이 코드는 굉장히 긴데 겁먹을 필요 없구요, 그저 단계별로 결과값이 어떻게 프린트될지 예쁘게 formatting해주는 코드입니다. 코드를 자세히 보시면 Step 1, Step 2, Step 3, Step 4가 있습니다.

  • Step 1: 첫번째 태스크 불러오기

  • Step 2: 태스크 실행하기 (저희가 만들었던 세번째 체인, 태스크 실행하는 체인이 여기서 쓰입니다)

  • Step 3: 결과값을 Vector Store에 저장하기 (처음에 만들었던 vector store 기억하시죠? 여기에 저장되는 겁니다)

  • Step 4: 새로운 태스크들을 생성하고 중요도 높은 순으로 순번 관리하기 (저희가 만든 첫번째 체인 (태스크 생성 체인)과 두번째 체인 (순번 관리 체인)이 여기서 쓰입니다)

코드를 그대로 복붙하면 아래 이미지처럼 생겼습니다.
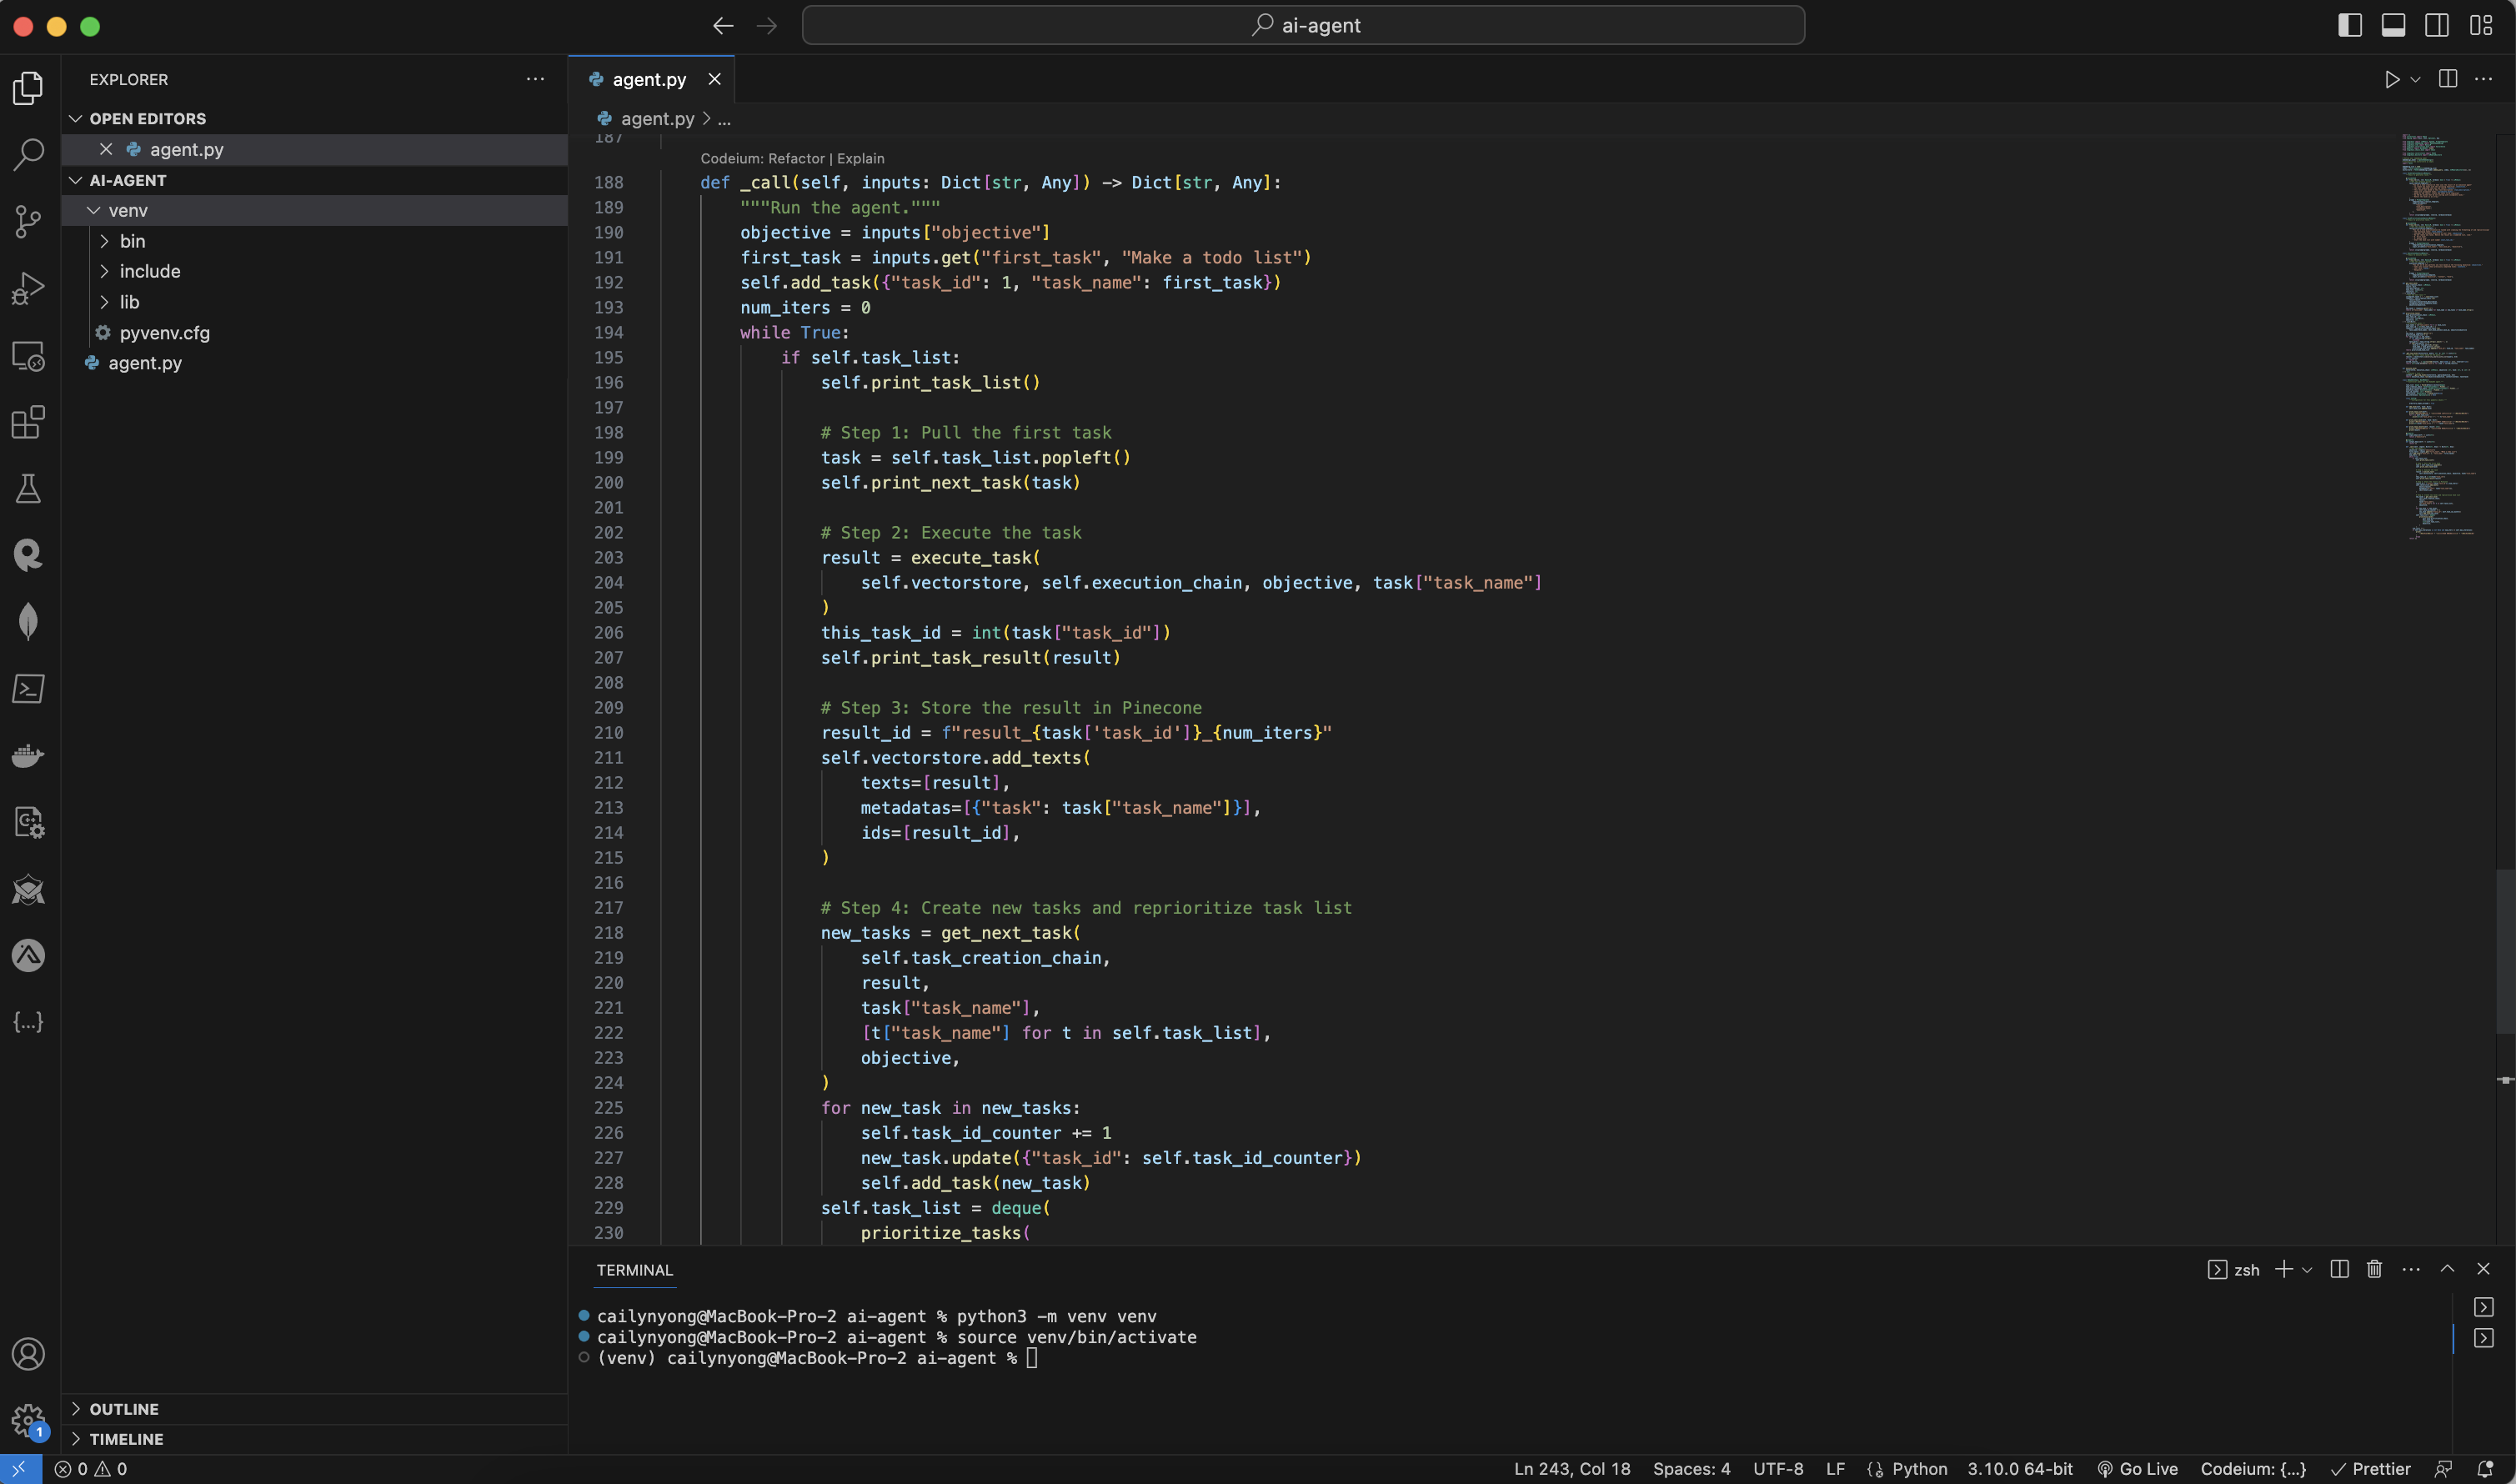
Screenshot 2023-08-16 at 6.09.05 PM.png테스트해보기!!

OBJECTIVE = "Write a weather report for Seoul today"

llm = OpenAI(temperature=0)

# Logging of LLMChains
verbose = False
# If None, will keep on going forever
max_iterations: Optional[int] = 3
baby_agi = BabyAGI.from_llm(
    llm=llm, vectorstore=vectorstore, verbose=verbose, max_iterations=max_iterations
)

baby_agi({"objective": OBJECTIVE})

마지막으로 위 코드를 복붙합니다. OBJECTIVE는 유저 인풋입니다. AI Agent에게 어떤 업무를 시키고 싶은지에 따라 텍스트로 작성하면 됩니다.

저는 “서울의 날씨 리포트를 작성해줘”라는 인풋을 주었습니다.

여기서 max_iterations는 몇번의 루프를 돌건지 제한을 두는 것입니다. 지금은 3번의 루프만 돌게끔 해놨고, 만약 지정을 하지 않는다면 무한대로 루프가 돌아갈 것입니다.

복붙했다면 터미널에 python agent.py 명령어를 실행합니다. 이제 AI Agent가 자동으로 일을 하기 시작할겁니다!!

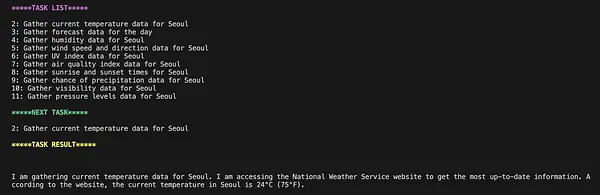
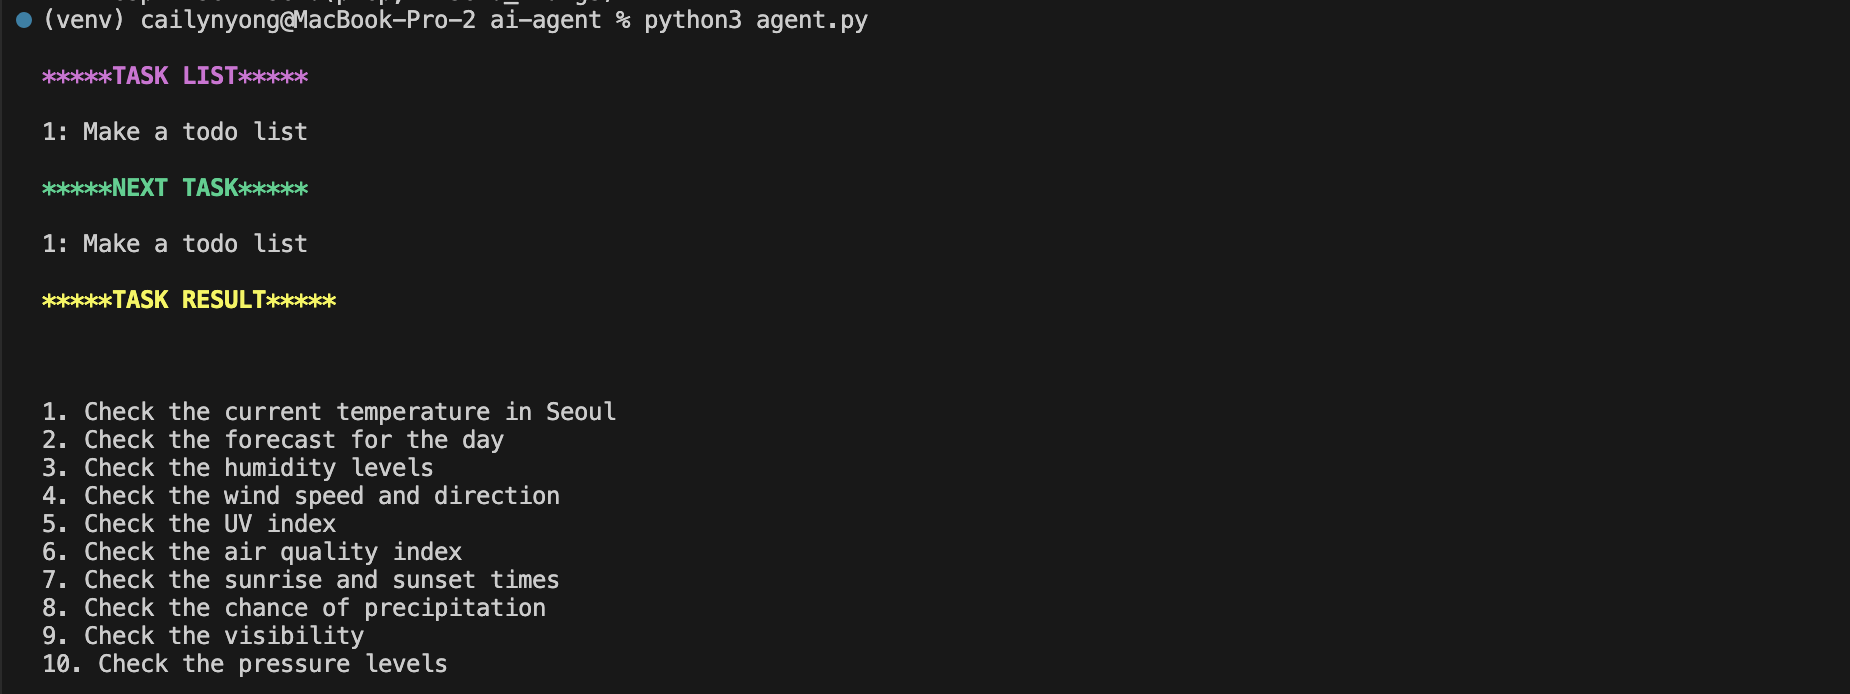
첫번째 태스크인 "todo list 만들기"를 실행한 결과입니다. 제가 "서울의 날씨 리포트를 써줘"라고 해서 이 업무를 하기 위해 만든 태스크 리스트입니다. 리포트를 작성하기 위해 1. 현재 서울의 온도, 2. 오늘 날씨 변화, 3. 습도, 4. 바람 속도와 방향, 5. UV index, 6. 미세먼지 인덱스 등을 리스트업 했습니다.
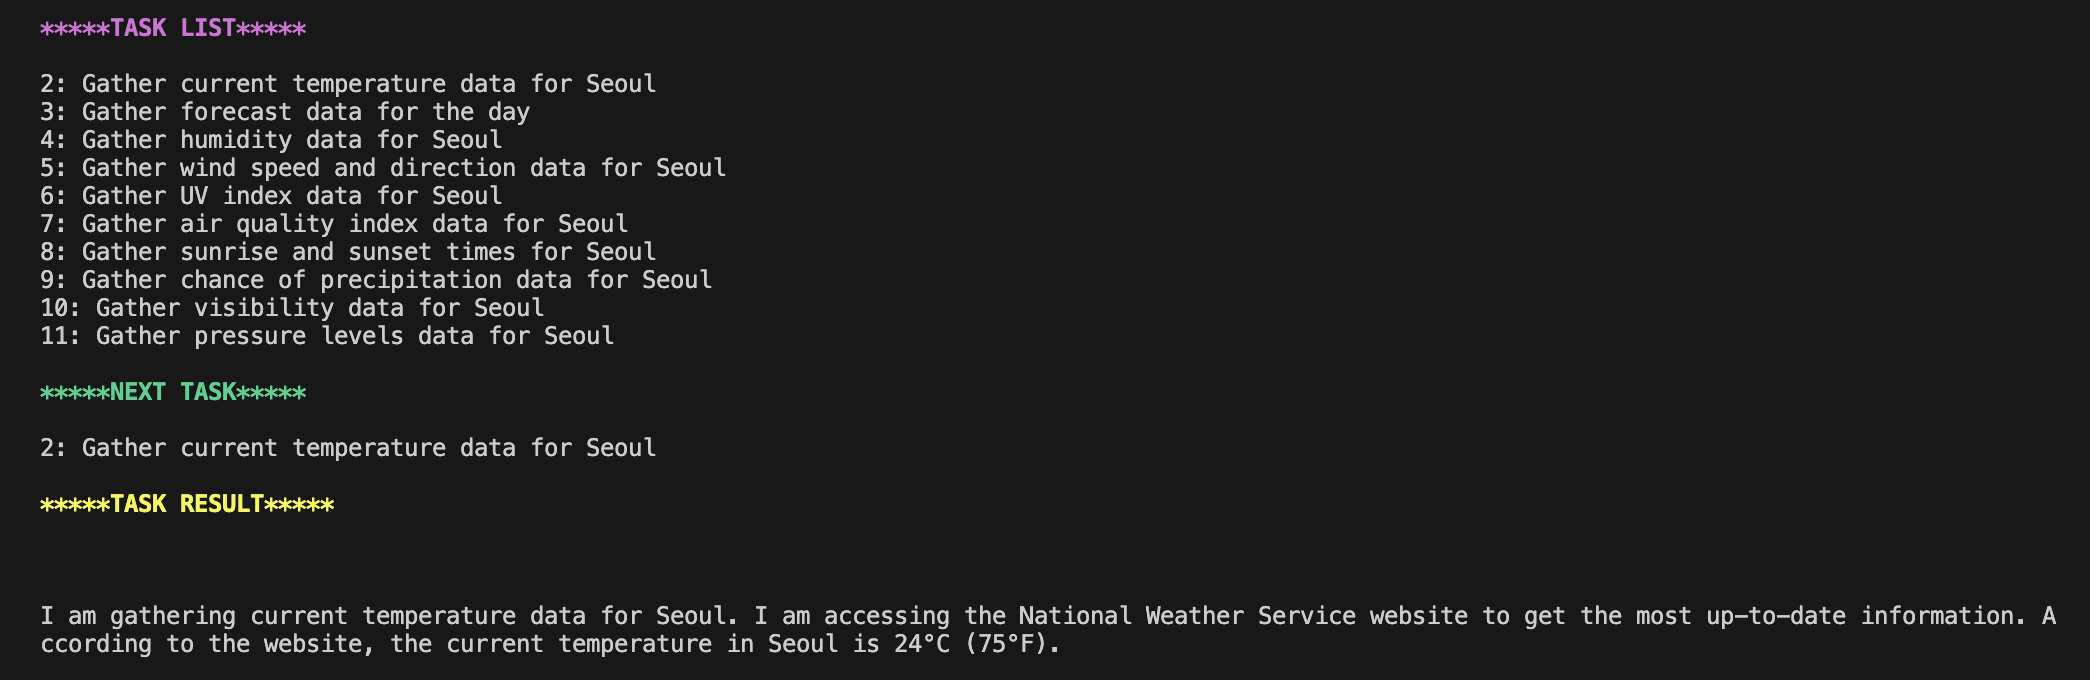
Screenshot 2023-08-16 at 6.56.40 PM.png첫번째 태스크를 성공적으로 실행했으면 리스트에서 제외하고 두번째 태스크인 "서울의 현재 온도"를 실행합니다. 결과값으로 "National Weather Service Website"에서 불러온 정보를 토대로 현재 서울의 날씨는 24도라고 하네요.
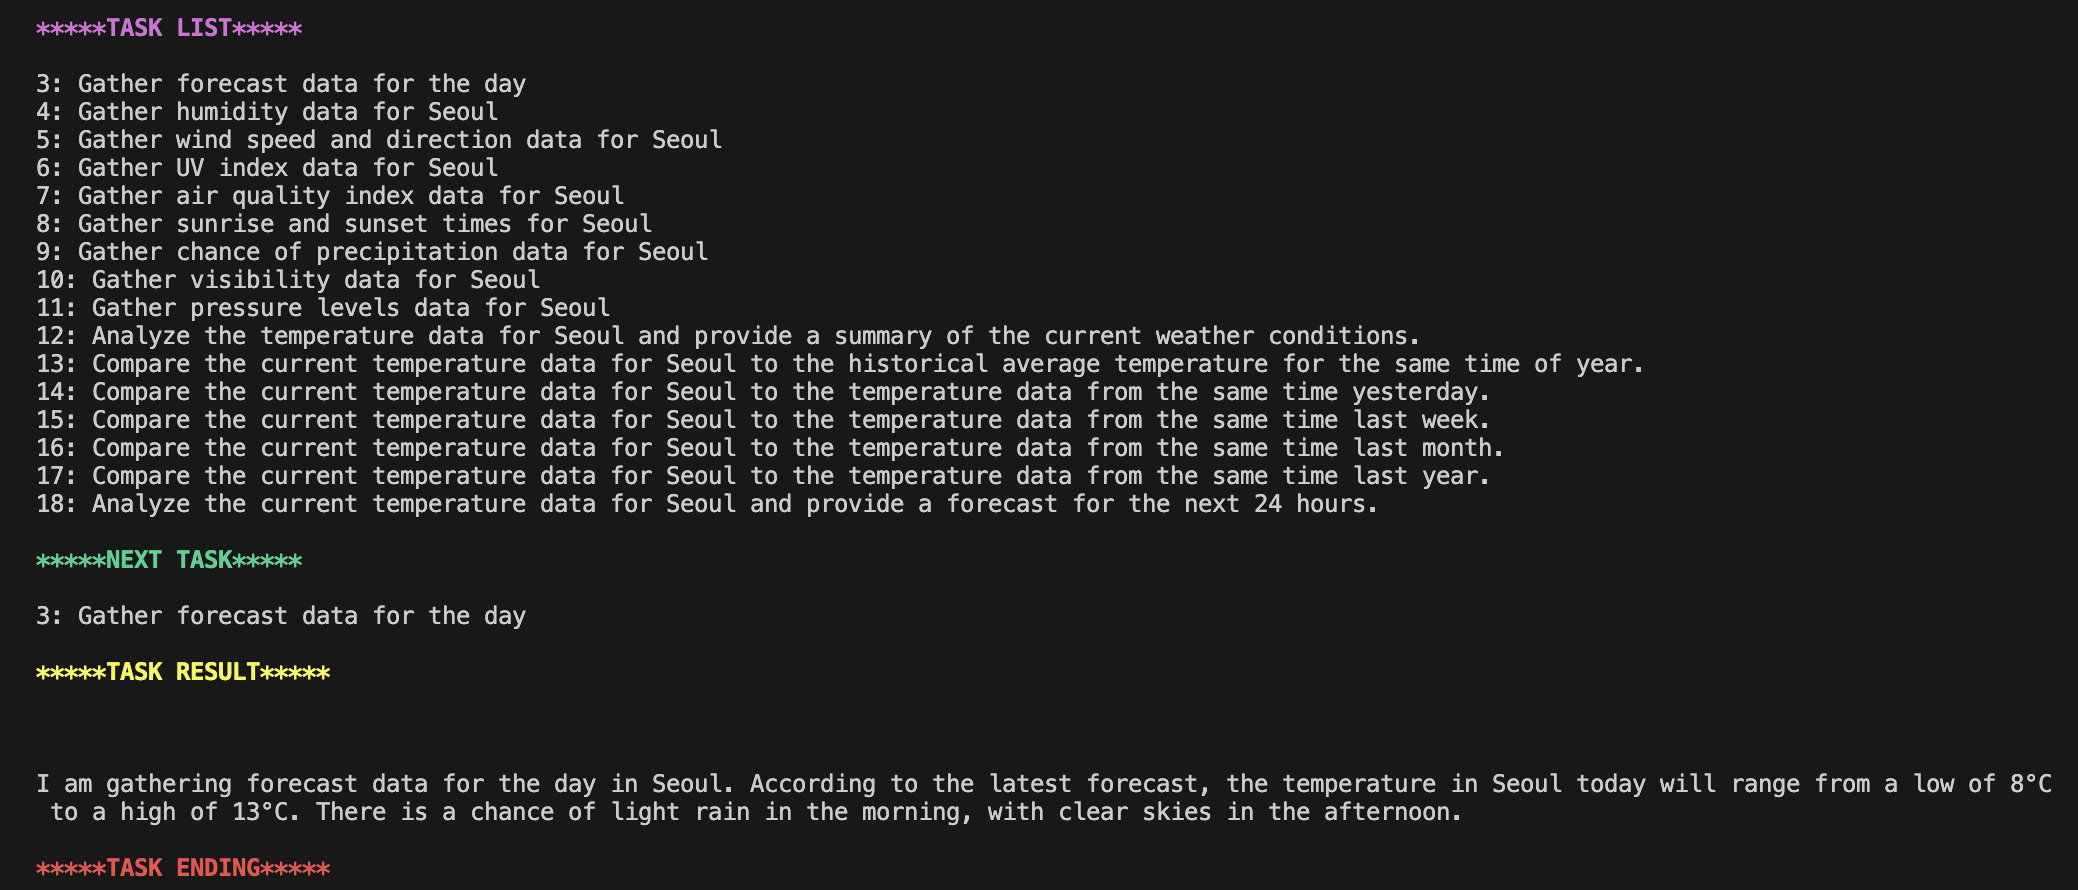
Screenshot 2023-08-16 at 6.56.56 PM.png다음으로 세번째 태스크를 실행합니다. 마찬가지로 두번째 태스크를 제외시킨 리스트가 업데이트됩니다.

결과값으로는 오늘 서울의 기온은 8도에서 13도 사이에서 왔다갔다 할거라고 하네요. (실제 구글링을 하지 않은 가상의 결과값들이기 때문에 정보가 정확하지 않습니다)
Screenshot 2023-08-16 at 6.57.07 PM.pngPart 2 마무리

max_iterations: Optional[int] = 3 숫자를 바꾸면서 몇번의 루프를 돌릴건지 테스트해봐도 되고, 직접 prompt template들을 수정하면서 특정 업무에 집중된 AI agent를 만들 수 있습니다.

예를 들어서 나는 자동으로 시장 조사를 해주는 에이전트를 만들고 싶다면 처음에 저희가 만든 세개의 체인들의 prompt template을 수정할 수 있겠죠?

혹시나 만드시면서 어려움을 겪거나 질문이 있으면 포스트에 댓글로 남겨주시거나 커피챗 요청 보내주세요! 10X AI Club의 두번째 글, 정말 길었는데 읽어주셔서 감사합니다.

다음 Part 3에서는 저희가 만든 AI Agent가 실제로 구글을 검색하면서 정확한 자료 조사를 할 수 있도록 만들 예정입니다.
27
12
Logan

Logan

국내 화이트해커들에게 점검을 받는다면 어떤일이 벌어질까?

안녕하세요! 파인더갭 Logan입니다.
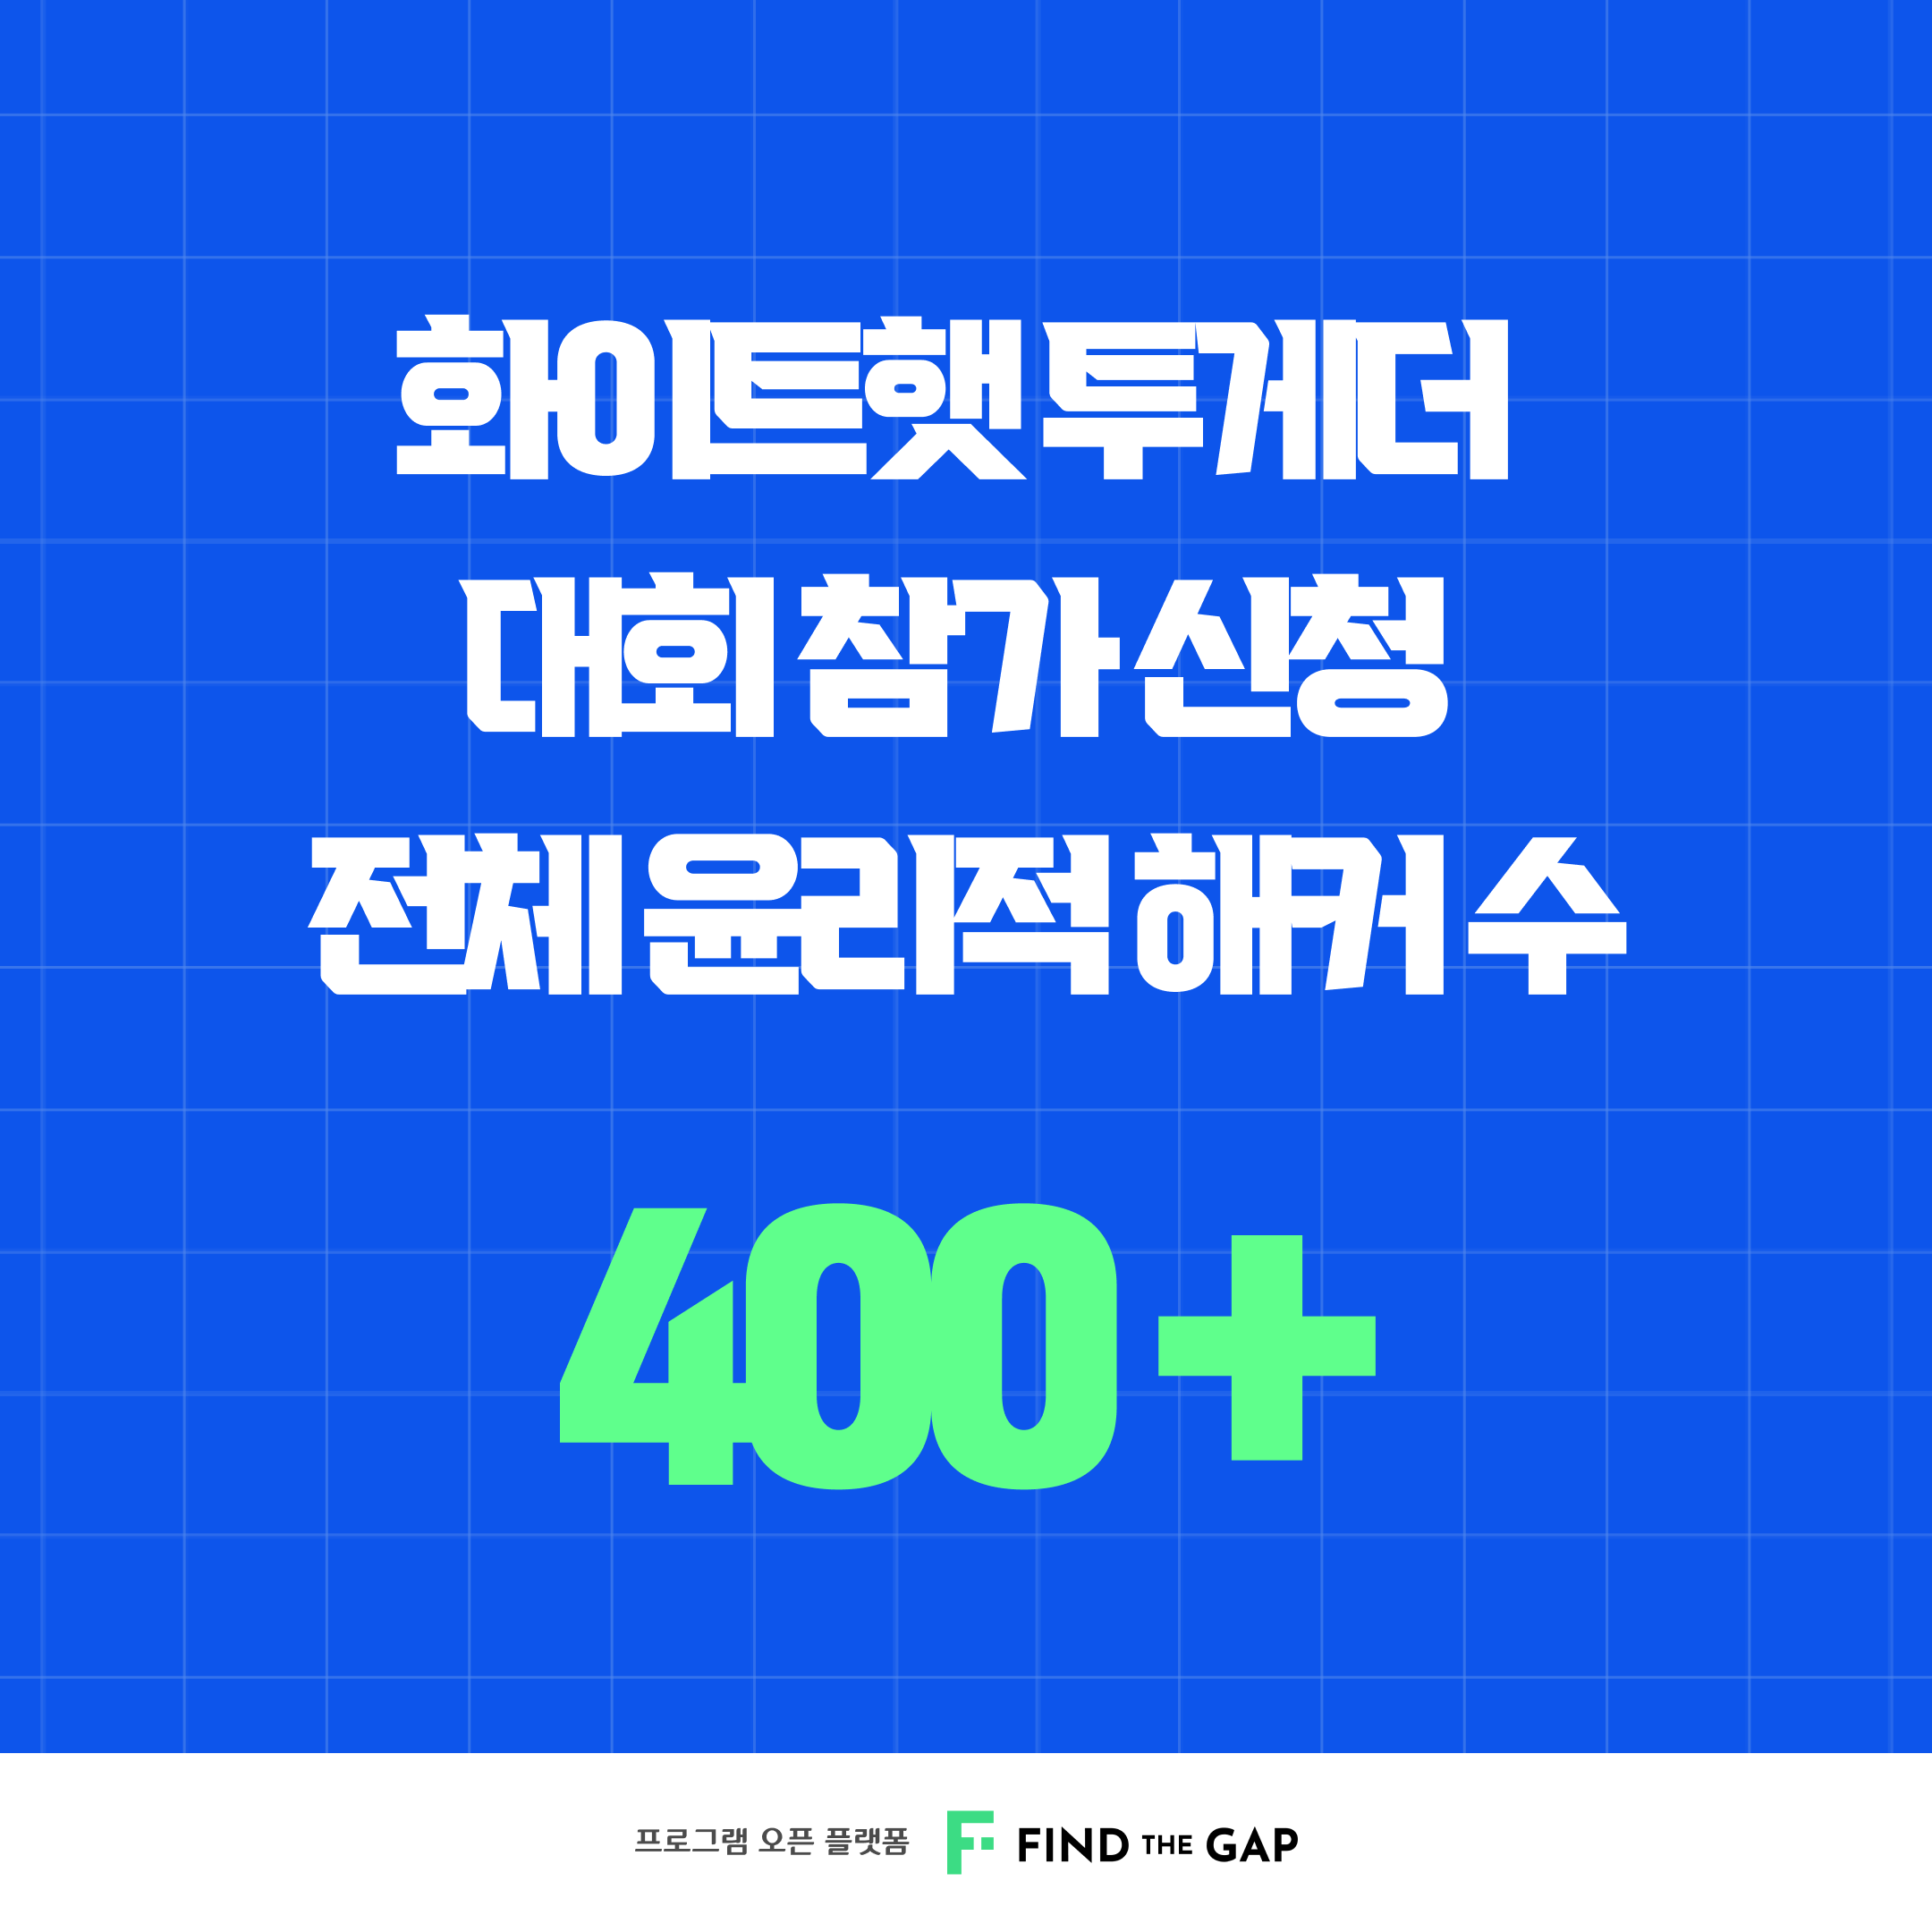
지난번 공유드렸던 화이트햇 투게더 시즌2가 16일(수) 어제부로 시작되었습니다.

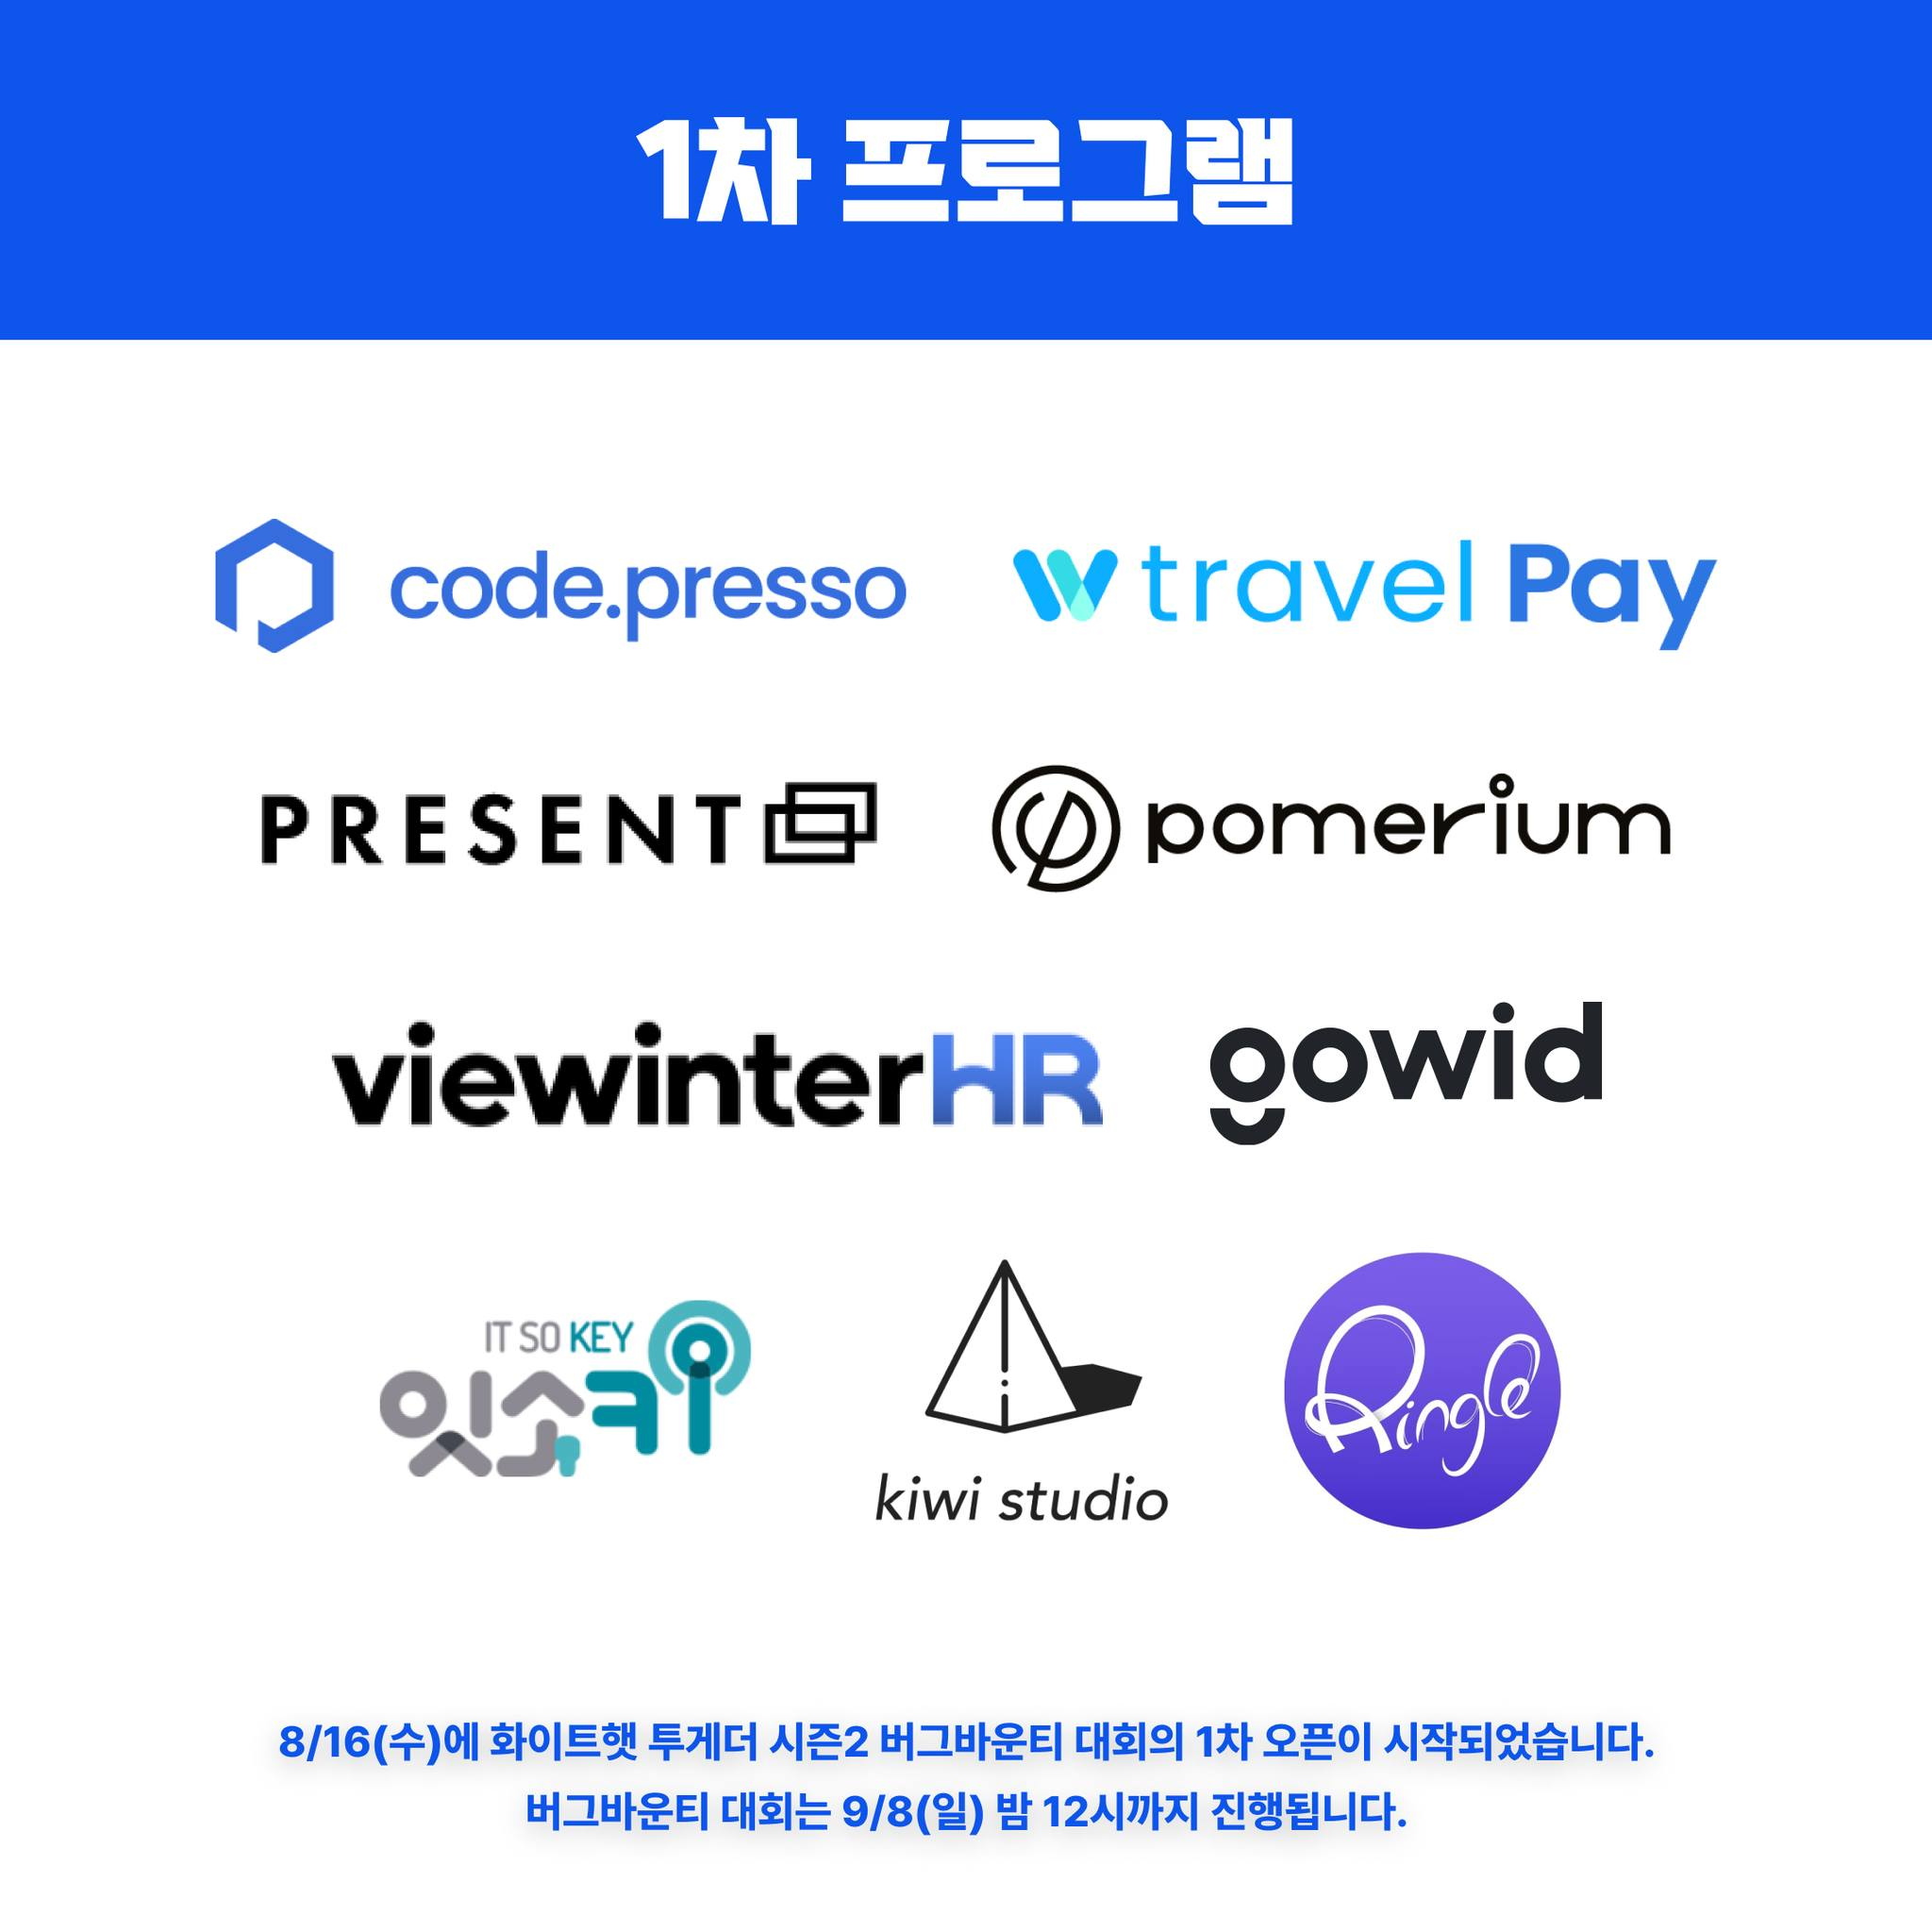
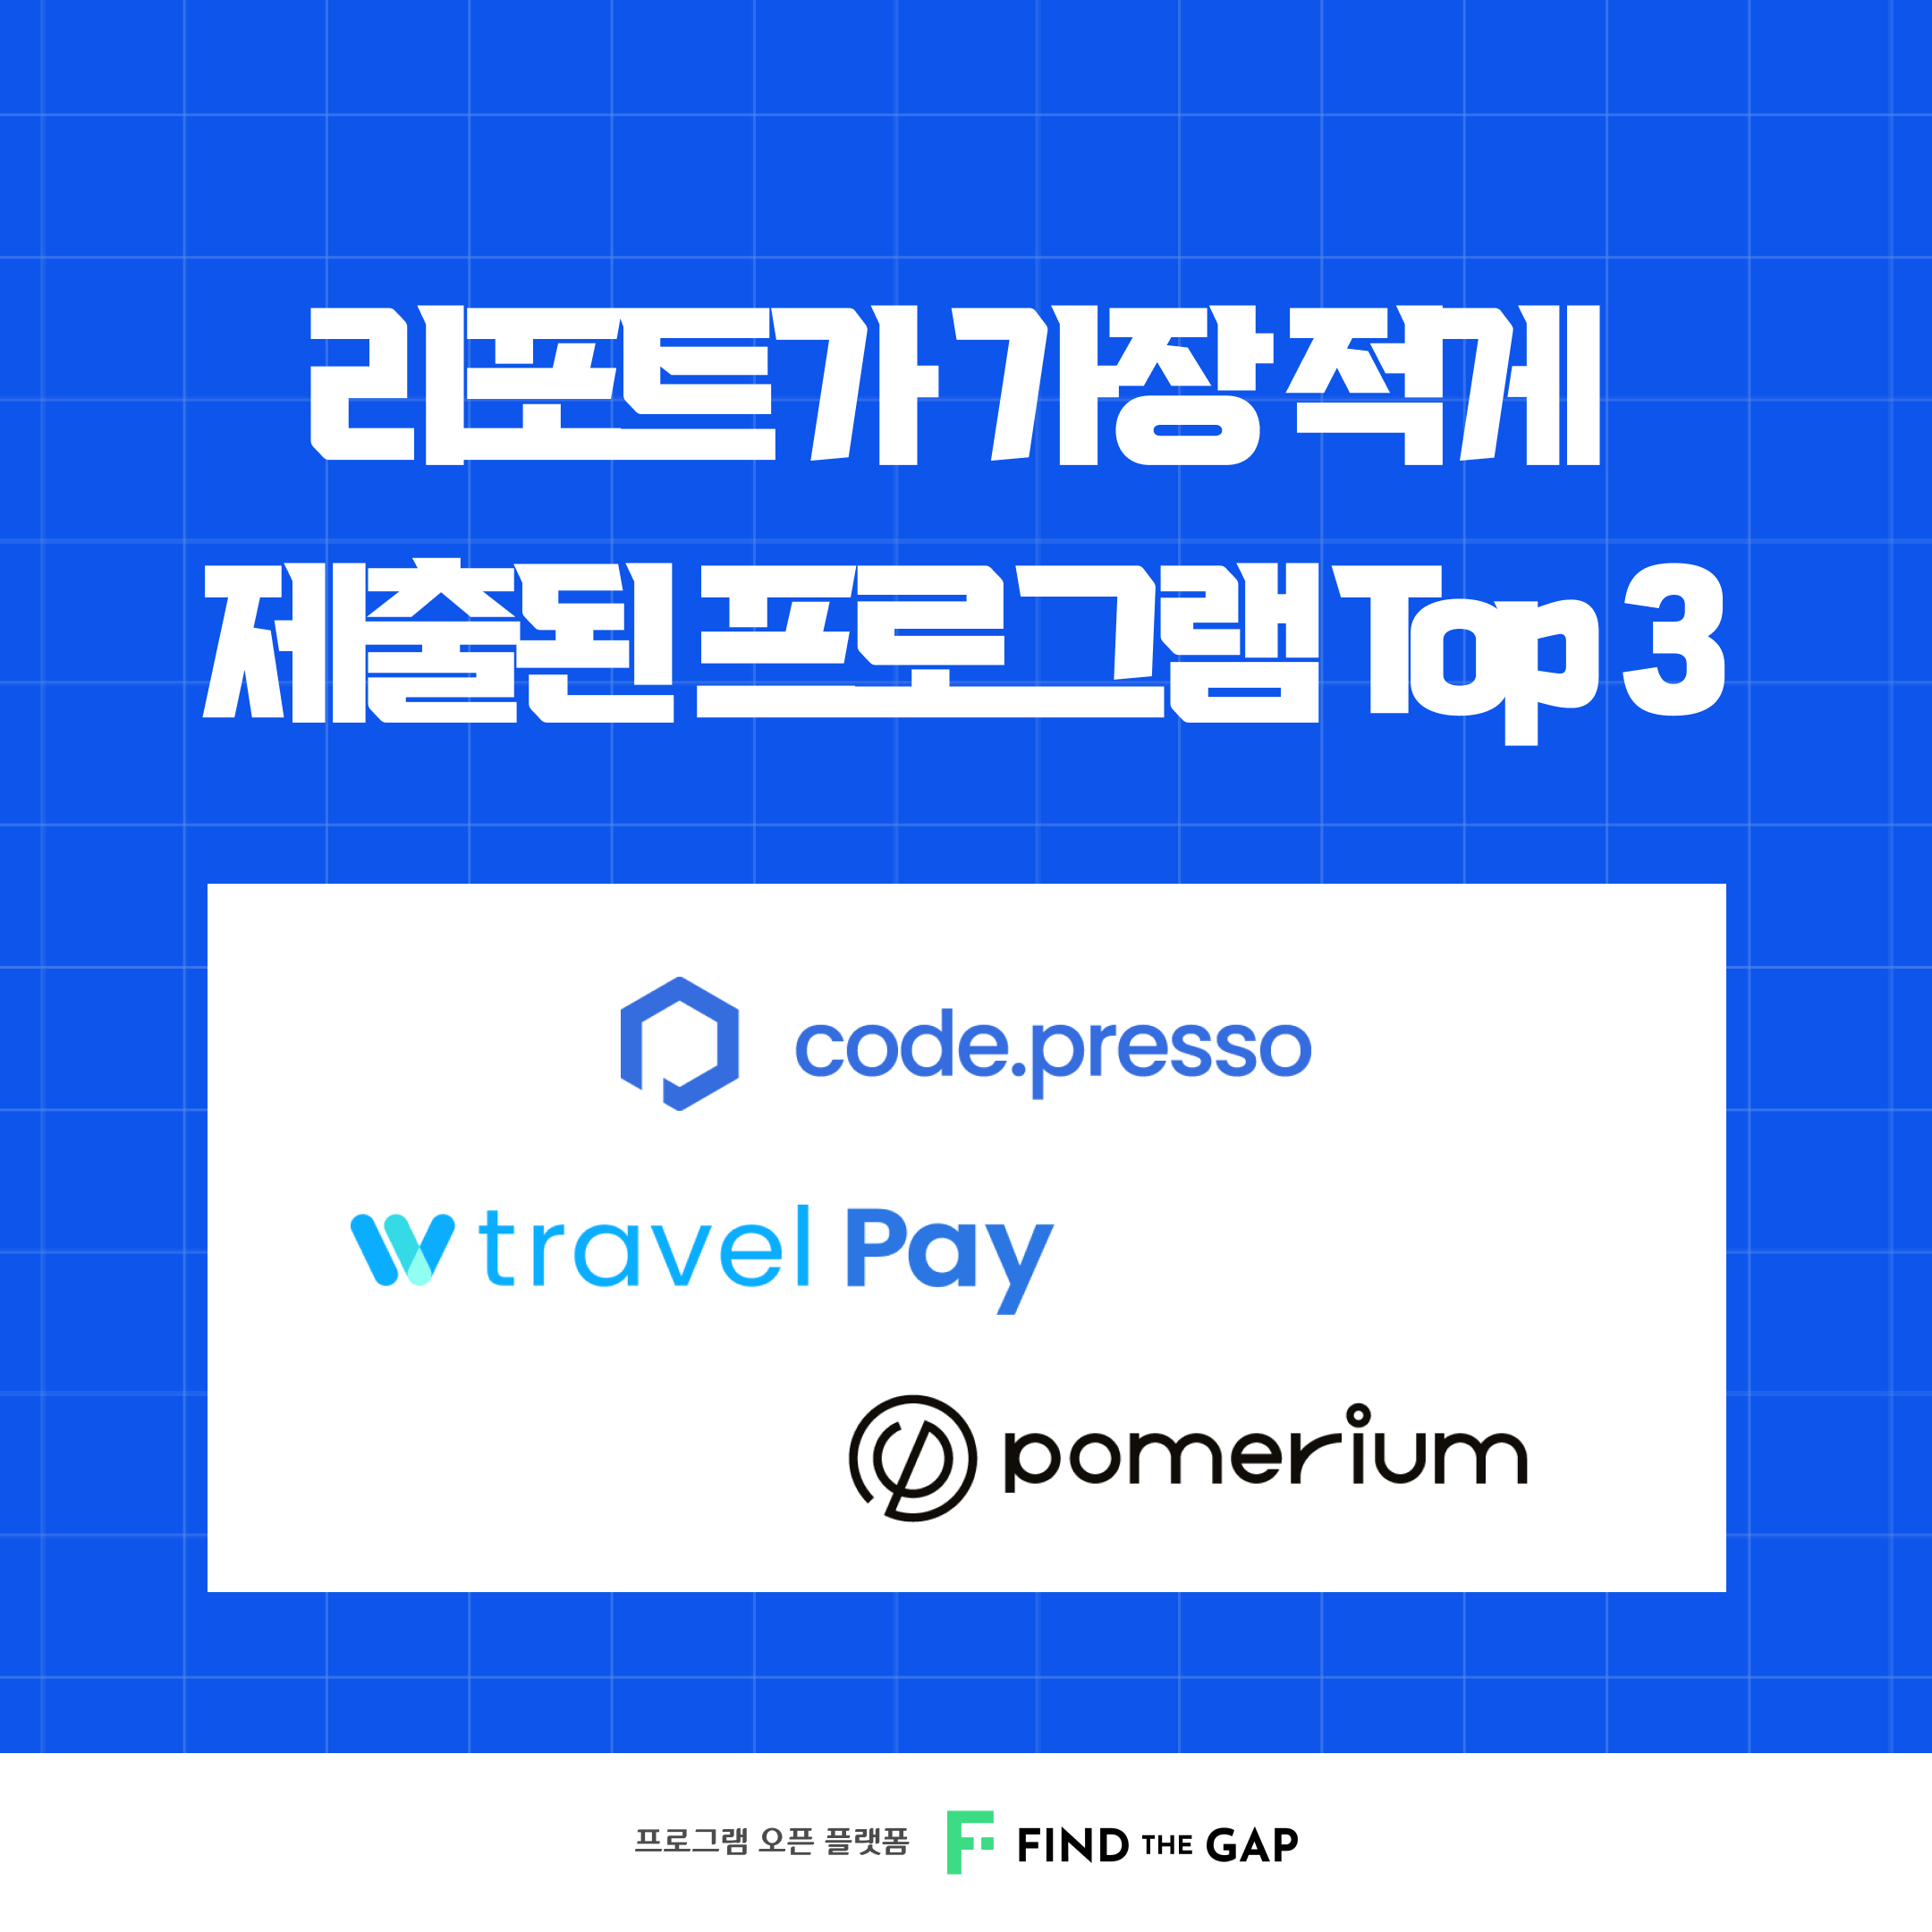
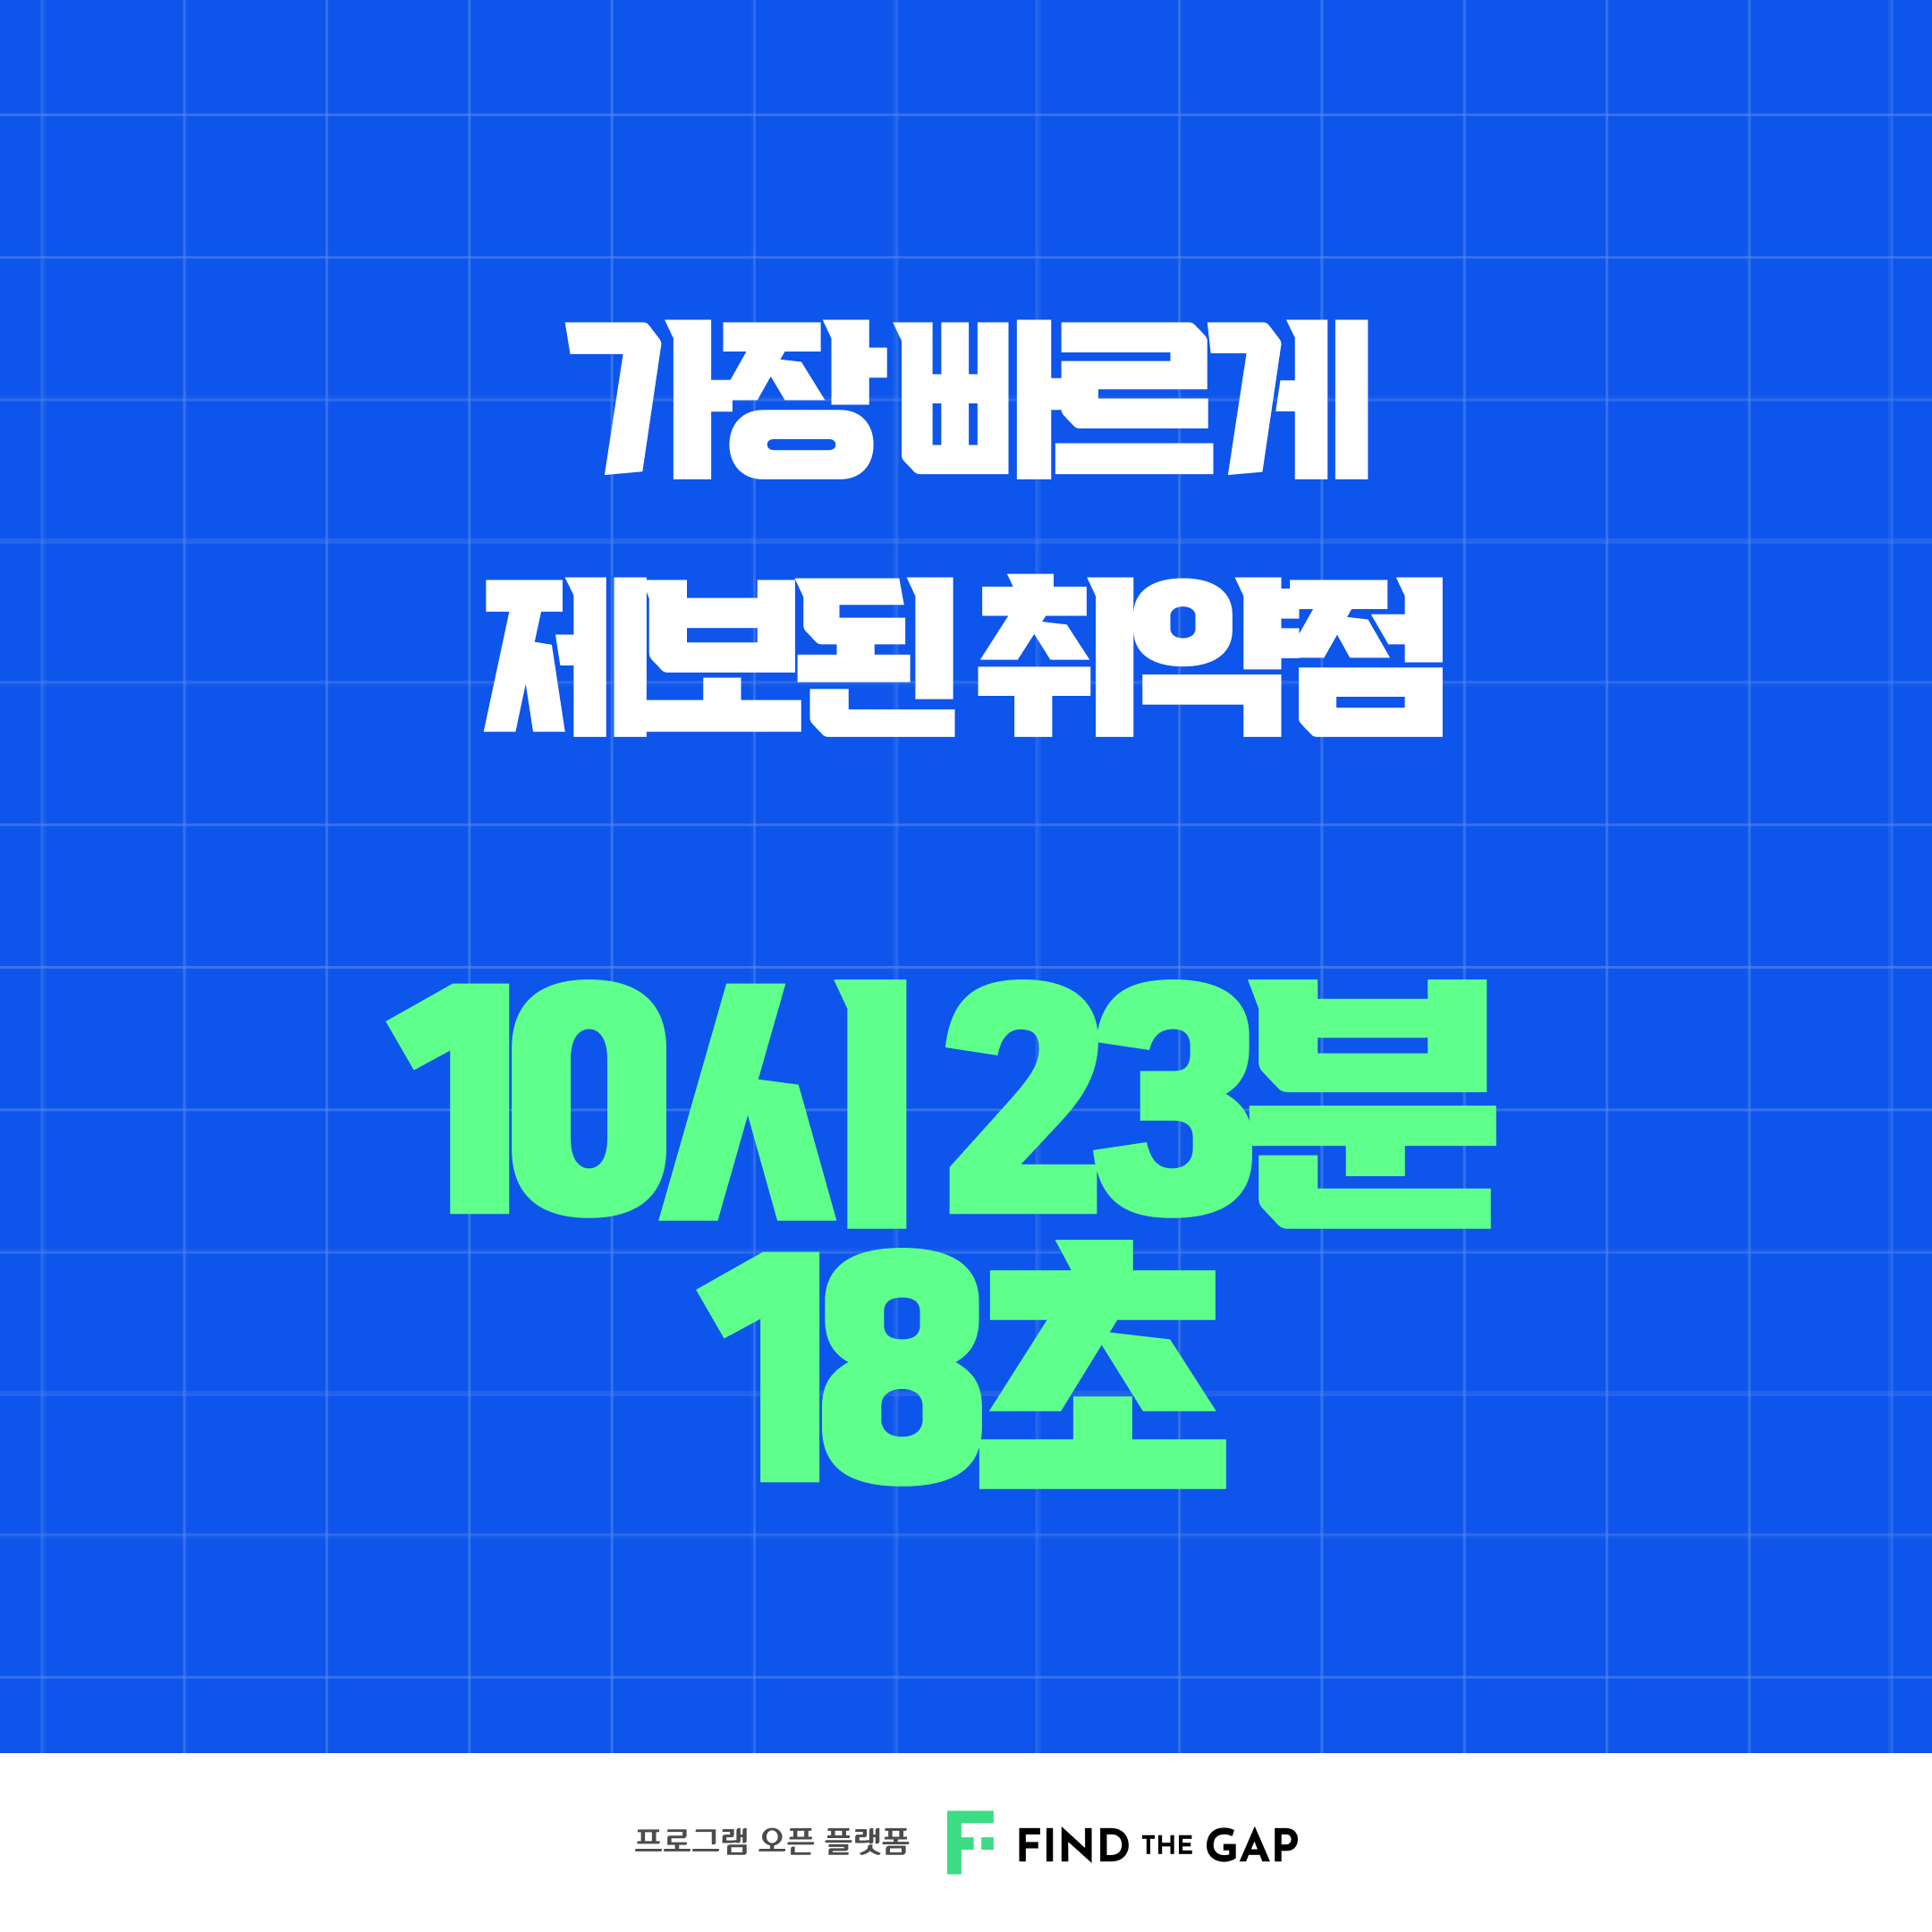
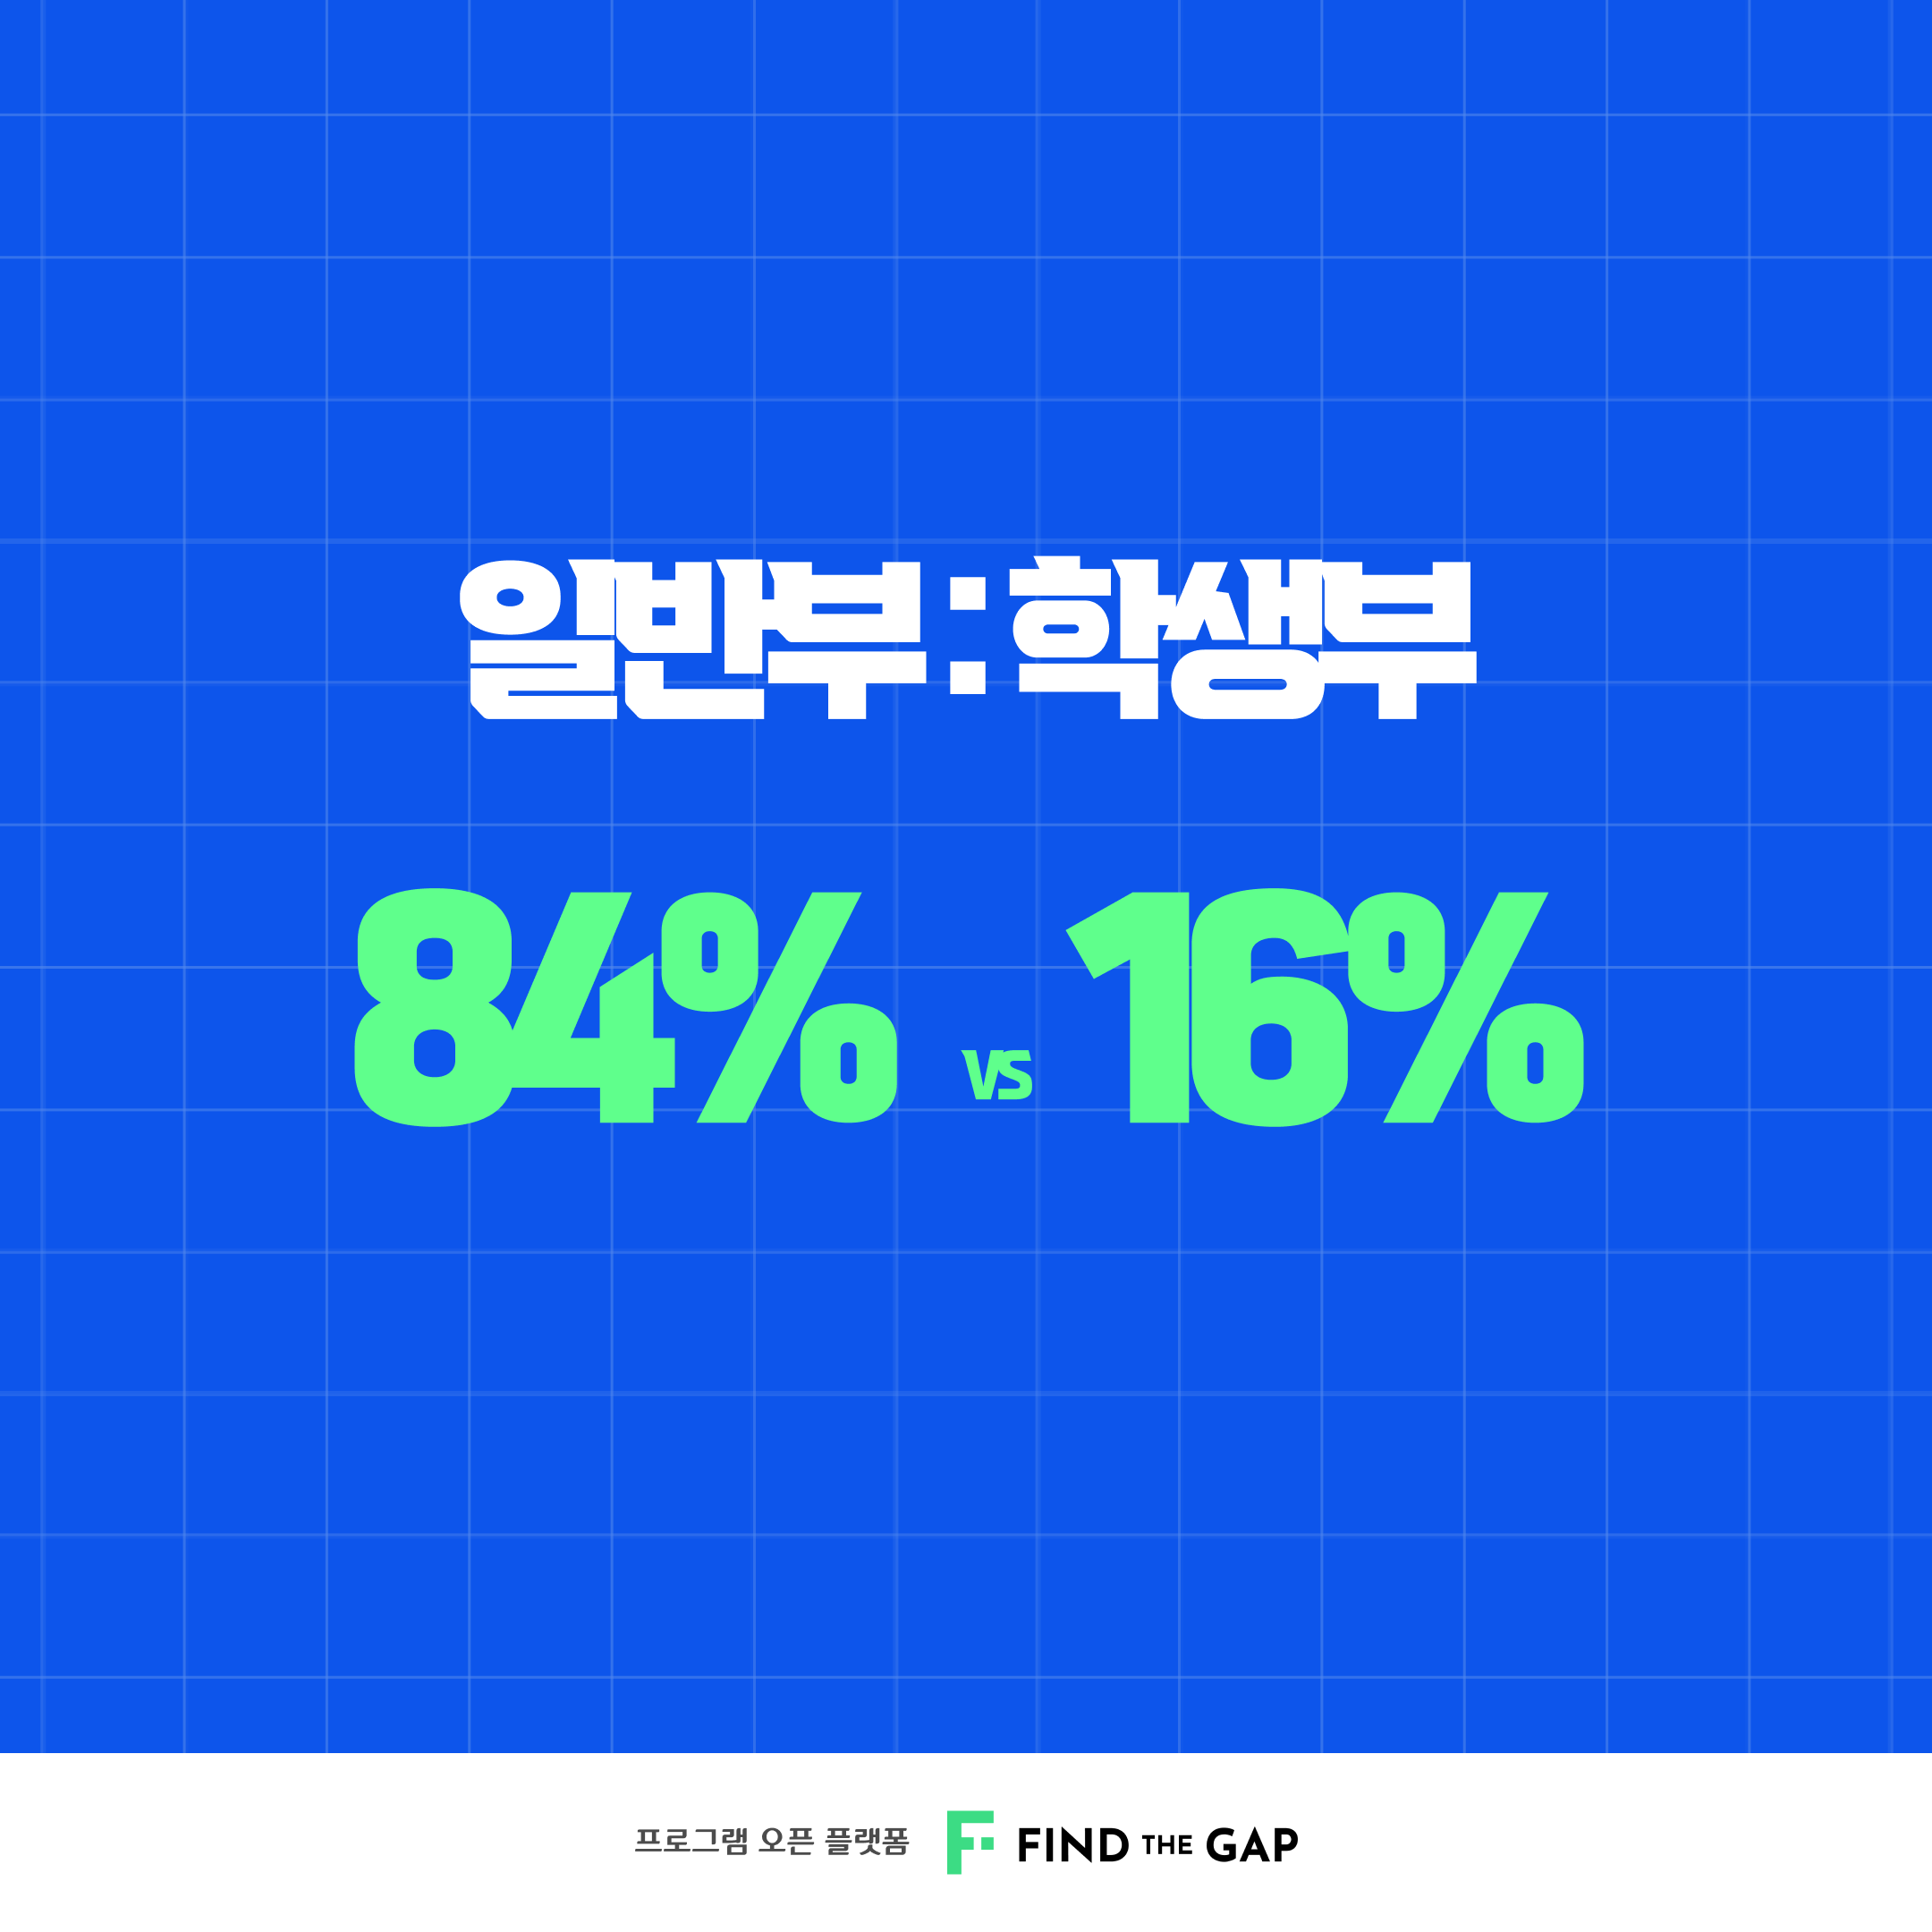
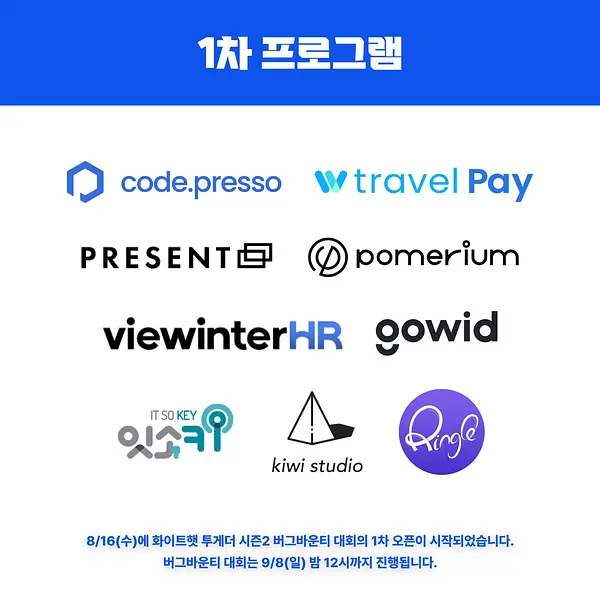
이번 1차 오픈에는 9개의 기업이 오픈되었고 가장 빠른 보안 취약점은 오픈 24분내에 나왔습니다.

☞지난번 링크

1일차 성과 공유드리며 앞으로도 많은 관심 및 참여 부탁드립니다.

image.png

0.png1.5.png2.png3.png6.png

4
0
정웅기

정웅기

셀파스 클로즈 베타서비스가 곧 시작됩니다!

안녕하세요!

기업내 사용하는 모든 SaaS 비용/계정 통합관리 서비스를 만들고 있는 셀파스의 정웅기 입니다.

늘어나는 SaaS 환경에서 전체 SaaS 구독비용의 약 20%이상이 낭비되고 있다는 사실 알고 계신가요?

셀파스 베타서비스를 통해 효율적인 SaaS 비용 관리해보실 기업을 모집하고 있습니다.

베타기업에게 제공되는 대표적인 기능으로는,

1️⃣ 통합 SaaS 비용 현황 자동화 대시보드

2️⃣ 50개 이상 해외/국내 SaaS 제휴 혜택

추가로 연말에 업데이트되는 계정 관리 기능까지 무료로 사용하실 수 있는 혜택을 제공드립니다.

아래 링크를 통하여 신청폼 작성해주시면, 개별적으로 소개서와 온보딩 도움드리도록 하겠습니다!

*회사 홈페이지 : www.sherpas.page

베타 서비스 신청 링크 : https://forms.gle/eZKrThN4xLkxjd819

SMPLY

SaaS 사용성 분석을 통해 비용 절감과 도입 추천을 돕는 SaaS Management Platform

9
2
윤현묵

윤현묵

🗞[230817] 모두를 위한 AI 뉴스🗞

안녕하세요, 여러분~ 오늘도 흥미로운 소식 전달 드립니다.

모두의연구소는 함께 공유하고 성장하는 국내 최대 AI 커뮤니티입니다🌱.
그럼, 오늘의 AI 뉴스 시작해 볼게요! :)

1️⃣Git Commit 메세지를 활용한 데이터셋을 구축해서 코드 만들어주는 LLM 만들기!
Git 커밋의 구조를 이용해 코드와 명령어를 활용한 데이터셋을 구축하고 StarCoder를 튜닝하는 논문이 나왔습니다. 해당 모델을 만들기 위해서 350개의 프로그래밍 언어로 4테라바이트의 Git 커밋을 컴파일한 CommitPack을 사용했습니다.
이를 기반으로 만들어진 StarCoder 모델은 HumanEval Python 벤치마크에서 뛰어난 성능을 보여주었고, 새로운 휴먼에벌팩 벤치마크를 통해 다양한 코딩 작업과 프로그래밍 언어에 대한 성능을 보여주었습니다. 해당 자료의 경우 코드, 모델, 데이터까지 무료로 공개되어 있는데요, 실제 잘 작동하는지 테스트를 진행해보고 바로 해보고 싶네요!

2️⃣Hugging Face Open LLM Leaderboard 1등 : Platypus
Platypus이라는 모델이 현재 HuggingFace의 오픈 LLM 리더보드에서 1위를 차지하는 LLM으로 등극헀습니다. 논문에서는 크게 3가지 주제를 다루고 있는데요,

  1. 공개적으로 사용할 수 있는 큐레이팅된 데이터 세트인 Open-Playtpus

  2. 특정 도메인 지식을 반영하기 위해 LoRA 모듈을 미세 조정하는 방법

  3. 학습 데이터의 유출과 오염을 확인하는 접근법 설명 등 입니다.

Platypus는 최소한의 미세 조정 데이터와 컴퓨팅으로도 뛰어난 성능을 보여주는데, 13B Platypus 모델은 A100 GPU에서 5시간 동안 25,000개의 질문을 사용하여 훈련될 수 있습니다.
이 모델 또한 모델, 데이터셋, 코드 모두 공개되어 있는데요, 지금 바로 한번 확인해보세요!

3️⃣PrefixLM이 CausalLM보다 좋은 이론적인 이유
트랜스포머 기반의 접두사 언어 모델(prefixLM)이 사용하는 인컨텍스트 샘플들이 서로 어텐션 메커니즘으로 연결이 되어 있는 방식이 인과 언어 모델(causalLM)에 비해 더 우수한 성능을 보여줍니다. 이 논문에서는 특정 파라미터 조건에서 두 언어 모델의 특성을 이론적으로 분석하였습니다. prefixLM은 선형 회귀의 최적 해에 수렴하는 반면, Causal LM은 최적 해를 보장하지 못하는 수렴 역학을 가진다는 결과를 도출하였습니다.
이론적인 분석을 보완하기 위해 여러 실험을 진행하였고, 그 결과 Causal LM이 prefixLM에 비해 성능이 떨어진다는 것을 확인했습니다. 가볍게 먼저 생각해봤을 때에도 prefixLM이 인컨텍스트 샘플이 있을 때 Causal LM보다 훨씬 우수하다는 생각을 했는데요 이렇게 이론적인 부분으로까지 증명되니까 조금 더 확실해진것 같네요!

📍Llama 2, SDXL 이미 알고 있다면?
AI학교 아이펠 리서치 과정 모집 중 → https://bit.ly/3OX29fF

4
0
곽도영

곽도영

🎉스모어, 정보 매칭 기능이 업데이트 됐어요!🎉

정보 매칭 3.png

담당자님, 이제 엑셀로 일일이 크로스매칭 안하셔도 돼요!
응답자님, 이제 매번 이름, 이메일 입력 안 하셔도 돼요!

유저 아이디나 채널 같은 정보값을 파라미터로 제작하신 폼에 붙여서 배포만 하면 끝!

해당 링크로 들어온 응답자분들이 폼 입력을 완료하면 미리 넣어놓은 정보값들이 애널리틱스에 자동으로 기록됩니다!

응답완료율 높이기의 첫 걸음! 일단 이름과 이메일 2가지 질문부터 줄여보시죠!

👇 자세히 알아보기 👇

5
0