이정민

이정민님의 아티클

이정민

이정민

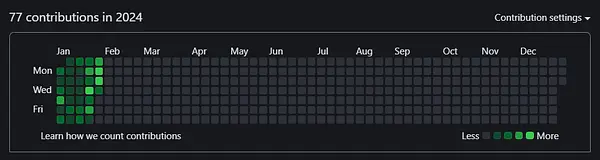
(개인 월별 성과) 매일 1일 1커밋 이상 하기 성공 ✅

github history _Jan 24.png

드디어 제 버킷리스트 중 하나를 일부 달성했습니다.

바로 깃헙 모든 날짜에 잔디 심기인데요.

저는 사실 순정(?) 개발자는 아닙니다.

그나마 예전부터 ai 개발을 해야 해서 python 을 많이 다루었던 정도?

근데 x.com 이나 reddit.com 보면서 미친 사람들에 대한 동경심이 생기면서 이론적으로만 얘기하지 말고 코드로 보여주는 식으로 증명해야겠다는 생각이 갑자기 들더라고요.

그래서 결국 이번 1월 한 달 간은 CES 출장 등 일이 있었음에도 1일 1커밋을 지켰습니다. 그리고 개발 관련 소통도 더 많이 하려고 노력 중입니다. 재밌네요 :)

플라멜 Flamel v0.1

프롬프트 엔지니어링이 필요 없는 가장 쉬운 검색형 이미지 생성 서비스

0
0
이정민

이정민

(2024 AI Part 1) AI Application 에서 성공 사례가 나와야 한다

Thumbnail.png

안녕하세요,

AI 이미지 어시스턴트, 플라멜(Flamel)을 만들고 있는 이정민 입니다.

이번 CES 2024 에서도 AI 가 많은 주목을 받았습니다.

사실상 AI를 따로 외칠 필요가 없이 자연스러운 존재로 다가가는 계기가 되는 것이 아닌가 합니다.

특히 CES 기간 동안 AI 관련 주목할 만한 소식은 개인적으로 2가지였다고 생각합니다.

한 가지는 AI를 위한 디바이스 r1의 출시와 다른 한 가지는 AI로 인한 빅테크의 레이오프 였습니다.

CES 를 둘러보고, 해외 글을 열심히 읽어보면서 2024년 AI 생태계에 대해 개인적으로 산업과 기술의 영역에서 생각해본 바를 이번에 적어보고자 합니다.


오늘은 산업 중에서도 첫 번째 내용입니다.

--

  1. 2024년에는 Business Layer 에서 활약하는 팀이 등장해야만 한다.

  2. 기술이 필요하다. 그래서 기본적으로 AI 스타트업은 ML 엔지니어가 필요하다.

  3. 단순히 기술만 있다고 이기는 것도 아니다. 제품으로서 바라보아야 한다.

  4. 이미 사용자에게 AI는 AGI 이다. AGI를 표방하는 UI/UX를 기획해야 한다.

--

1.     2024년에는 Business Layer 에서 활약하는 팀이 등장해야만 한다.

해당 제목은 등장한다가 아니라 해야한다에 주목하는 의미임을 다시 한 번 강조하고 시작합니다.

개인적으로 생성 AI 와 관련된 글로는 Sequoia Capital 이 게재한 것이 가장 주목할 만한 글로 생각됩니다. ChatGPT가 출시되기 직전 2022년에 첫 번째, 그리고 작년에 두 번째 글을 발표했는데요.

해당 Act 2 (2023) 글은 크게

  • Act 1 (2022) 글에서 예측한 내용 중 맞았던/틀렸던 것

  • 생성 AI 에서 모델/프로덕트 레벨에서 성공할 가능성을 높이는 Framework
    (또는 Playbook, 다만 정답이라고는 절대 말 못함)

로 구성되어 있습니다.

일단 위 글에서는 아래 내용에 주목해 볼만 합니다.

"킬러앱은 나왔으나 버티컬한 세분화는 나타나지 않았다."

Vertical separation hasn’t happened yet. We still believe that there will be a separation between the “application layer” companies and foundation model providers, with model companies specializing in scale and research and application layer companies specializing in product and UI. In reality, that separation hasn’t cleanly happened yet. In fact, the most successful user-facing applications out of the gate have been vertically integrated.

아마 작년 VC 에서 바라본 생성 AI 스타트업에 대한 시각을 한 문장으로 정리하면, 버티컬이 중요하다 입니다. 그런데 정작 현재까지 성공은 버티컬에서 나오지는 않았습니다.


즉, 올해는 해당 시각에 대한 검증이 역으로 이루어질 수도 있습니다.

일단 버티컬 어플리케이션(Vertical Application)이 등장하지 못했던 이유는 두 가지입니다.

  1. 2023년에는 사용자가 아직 생성 AI를 사용할 준비가 안되었다.


    먼저, 사용자가 AI에 대해 잘 모릅니다.
    희한하죠, 뉴스에서는 매일 생성 AI에 대해 언급하고 있으니까요.

    그런데 주위에 생성 AI를 사용해본 사람, 그리고 지금도 사용한 사람을 돌아본 적이 있으신가요?


    아래 자료를 보시면 한국은 최하위권 수준으로 생성 AI에 관심을 보이고 있음으로 밝혀졌습니다. 심지어는 세계 최고 유망한 AI 스타트업을 보유한 미국조차도 전반적으로 큰 관심이 있다고 보기에는 어려움이 있어 보입니다.

    생성 AI 국가별 종합 관심도 (사진=일렉트로닉허브)

    실제로 이 부분은 제가 CES 등 그간 부스 활동을 하면서도 느낀 지점이었습니다.
    AI가 이미지도 생성할 수 있나 라는 물음에서 ChatGPT 들어본 적은 있다 정도의 답변에서 말이죠.

    사실 사용자 입장에서는 생성 AI라는 단어가 1년도 되지 않았기 때문에 당연한 상황일지도 모릅니다.
    일반 사용자에게 성공적으로 접근한 AI 프로덕트 수를 세어보면 한 손으로도 가능하지 않을까 생각합니다. 그 정도로 아직은 생성 AI 에 대한 구체적인 사용처를 찾지 못했다고 보여집니다.

    즉, 모바일 시대에는 '연결', '공유' 라는 키워드가 있었고 사용자들이 호응했던 것과는 대비가 되는 상황입니다.

    다음으로, 사용자가 AI를 어떻게 사용해야 할 지 잘 모릅니다.

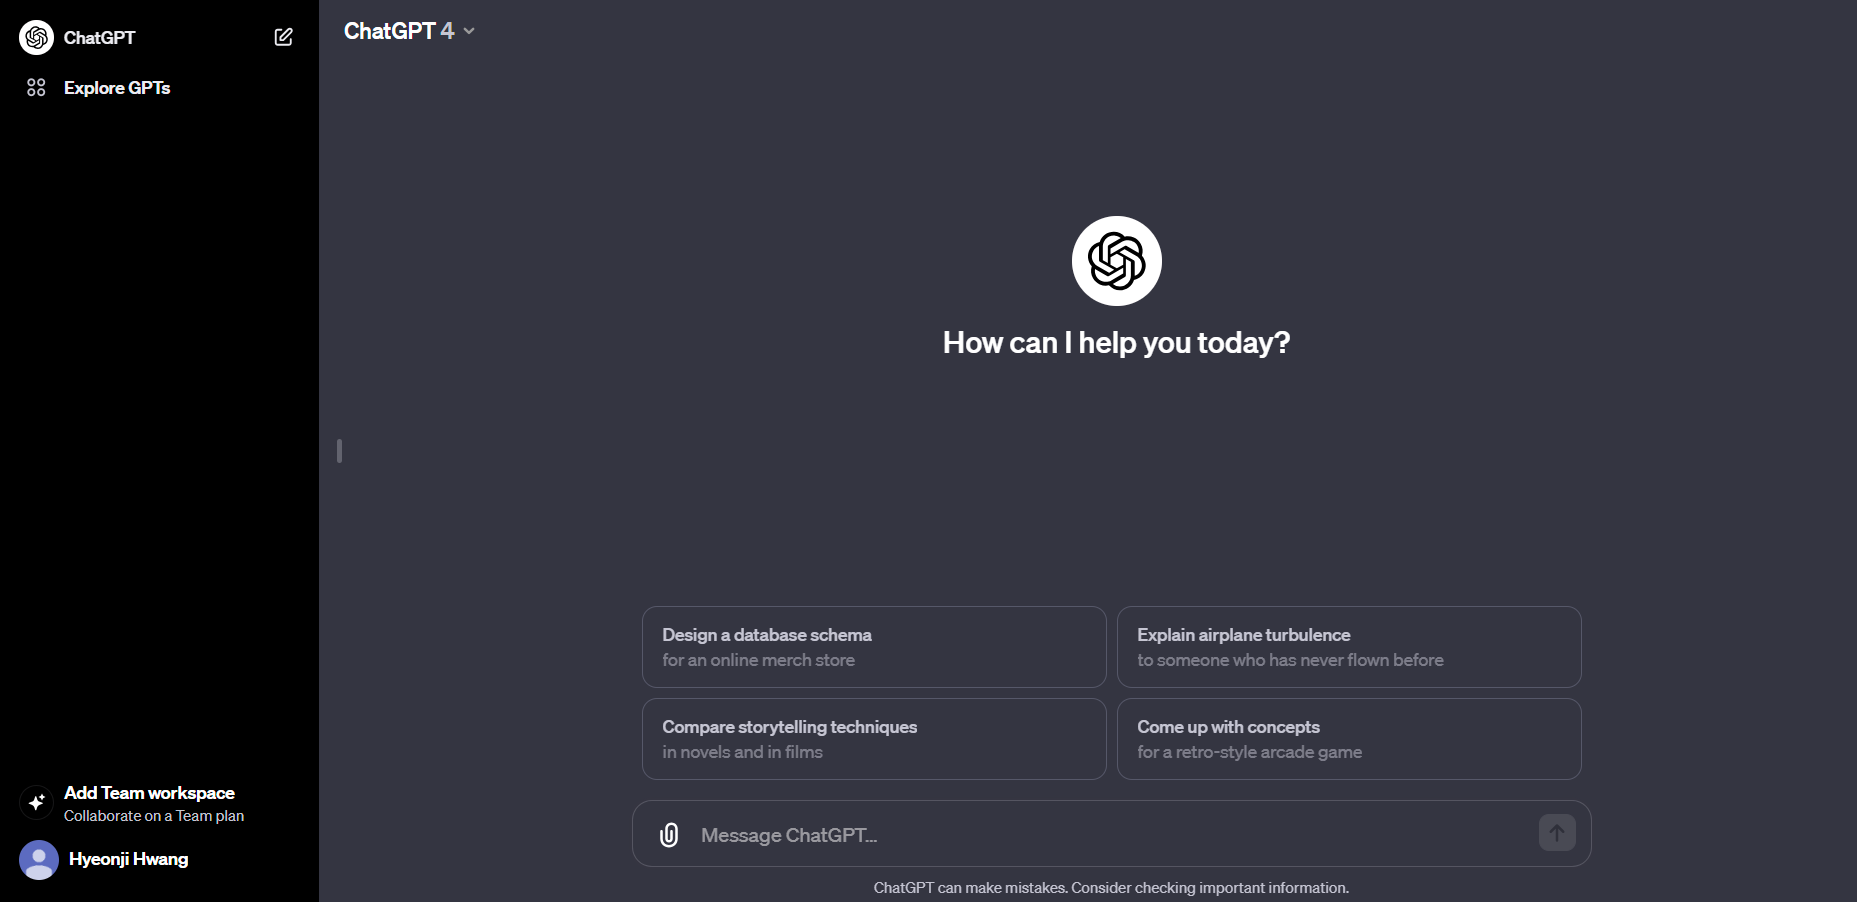
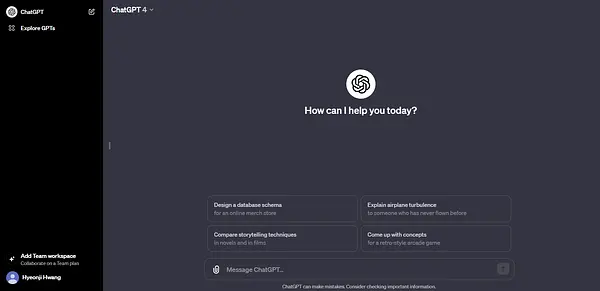
    아래 화면을 보아주세요.

    image.png

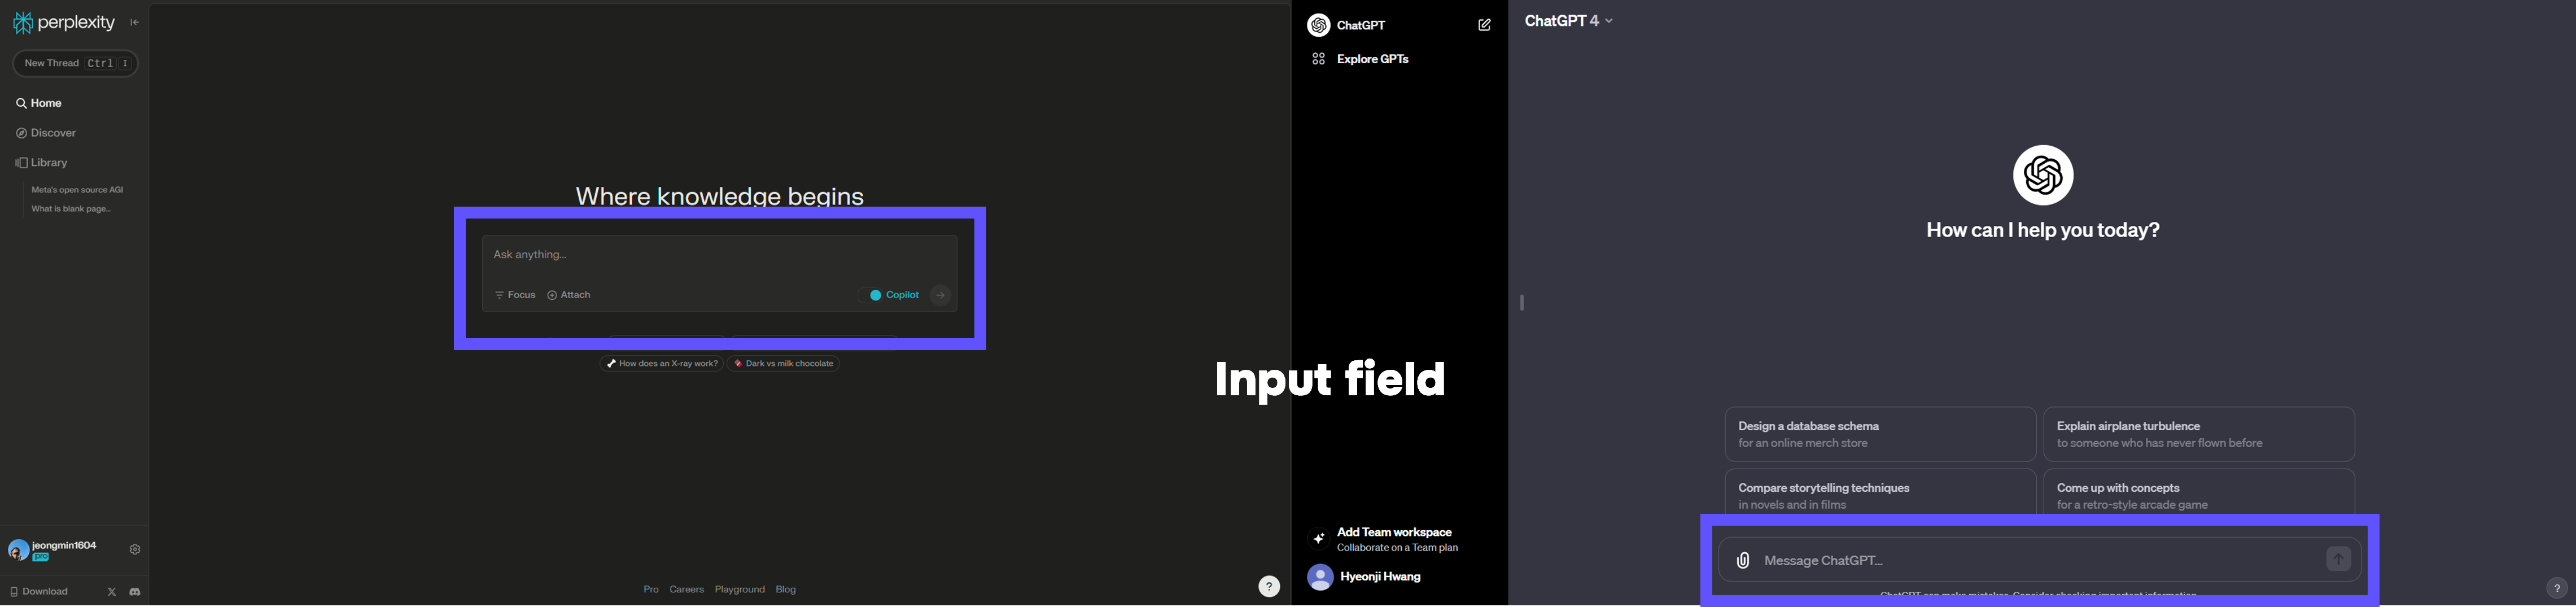
    ChatGPT 에서 볼 수 있듯이 생성 AI 시대 가장 대표적인 UI 는 Chat Interface 입니다.

    그런데 말입니다. 무엇을 입력해야 할 지 감이 잘 오시나요?
    완전한 자유도가 있지만, 그만큼 사용자에게 모든 것을 넘겨주어 부담을 주기도 합니다.

    A man is looking at a white blank paper-ai-generated-flamel.png

    이를 'Blank Page Syndrome' 이라고 합니다. 다시 말해 빈 화면에 어떤 말을 해야 원하는 결과를 얻을 수 있는 지 모른다는 것입니다.

    그래서 무언가 엄청난 것이라는 것을 들어본 적은 있지만, 매번 ChatGPT 에게 물어보는 것은 날씨가 어떤가, 어떤 주식이 잘될 것인가 이고, Adobe 에서는 생성이 아니라 배경 지우기를 사용하는 데 그치고 있는 것입니다. (물론 누끼를 자동으로 따는 것이 엄청난 효용성을 가져다 주기는 합니다.) 즉, 사용자의 기대감에 못 미치는 사용성을 보여주고 있는 것입니다.

  2. 굳이 버티컬 어플리케이션이 필요한가? ChatGPT (한국은 Wrtn) 로 대표되는 horizontal 서비스에서 다 할 수 있다.

    앞에서도 말씀드린 것처럼 일반 사용자에게 있어 AI가 필요한 이유가 아직 정확히 정의되지 않았습니다. 즉, 목적은 무언가를 생성한다는 것이지만 '무엇'을 생성해야 하는 지에 있어 사용자에게 파편화된 수만 가지의 니즈가 존재하고 있다는 의미입니다. 현재와 같은 상황에서 사용자 수를 늘리기 위해서는 결국 접점을 많이 만들어야 한다는 뜻이며, 이는 한 기능에 특화된 것이 아님을 의미합니다.

    예시를 하나 들어보겠습니다. 사람들은 보통 쉐이크쉑 보다 맥도날드를 3배 이상 많이 간다고 합니다.
    그 이유는 무엇일까요? 가격일 수도 있습니다.

    또 한편으로는 갈 이유가 많아서 일 수도 있습니다. 일반적으로 버거만 먹을 수도 있고요. 아침에는 머핀을, 오후에는 커피를 간단히 테이크아웃 할 수도 있습니다.
    즉, 사용자가 자주 올 수 있도록 이유를 많이 만들어 준 것입니다.

    그림7.png

    다시 AI 프로덕트로 돌아오면 OpenAI 는 ChatGPT 를 운영하면서 다양한 사람들의 니즈를 알았고, 대신 일일이 맞추어 줄 수는 없지만 서비스에 유입시키려면 한 공간에서 그 목적을 채워줘야 한다라는 사실을 인지했습니다. 그래서 OpenAI는 Plugin 에 이어 GPT store 라는 형식으로 텍스트의 생성, 분석에서 이미지에 이르기까지 다양한 역할을 수행하게 만들었습니다.

    그러다 보니 사용자에게 있어 ChatGPT 와 같은 기존 플랫폼이 아닌 다른 서비스를 이용해야 하는가에 대한 설득이 안 되고 있는 상황입니다.

    물론 이 부분은 1번 이유가 해결이 되면 풀릴 문제라고 보여집니다.
    구체화된 니즈가 확인되는 순간 정체성이 모호한 플랫폼 카테고리의 서비스는 상당한 어려움을 겪을 수 있습니다.

그렇다면 올해는 어떤 양상이 펼쳐질까요?

저는 이미 지난 2년 간 상당한 규모의 자본 투입이 이루어진 것을 보았을 때,

당장은 시장 도메인에 따른 버티컬 어플리케이션에 대한 수요가 크게 나타나지는 않을 것으로 판단하고 있습니다.

(수요가 특정되었다면 이미 나왔어야 하는 시점이지만 아직 그렇게 되지는 않았다는 점, 버티컬 어플리케이션 플레이어에 대한 자본 투입이 생각보다 더딘 점이 근거)

그 이유는 여전히 사람들에게 생성 AI 에 대한 접근 장벽이 높은 것처럼 보여지는 것 때문입니다.

아직은 작은 규모의 시장에서 이것 저것 세분화해서 프로그램을 사용할 만큼의 성숙도에 도달하지 못했기 때문에 적어도 2024년에는 기존 플레이어의 플랫폼식 운영이 어느 정도 성과를 낼 것이라고 생각합니다.

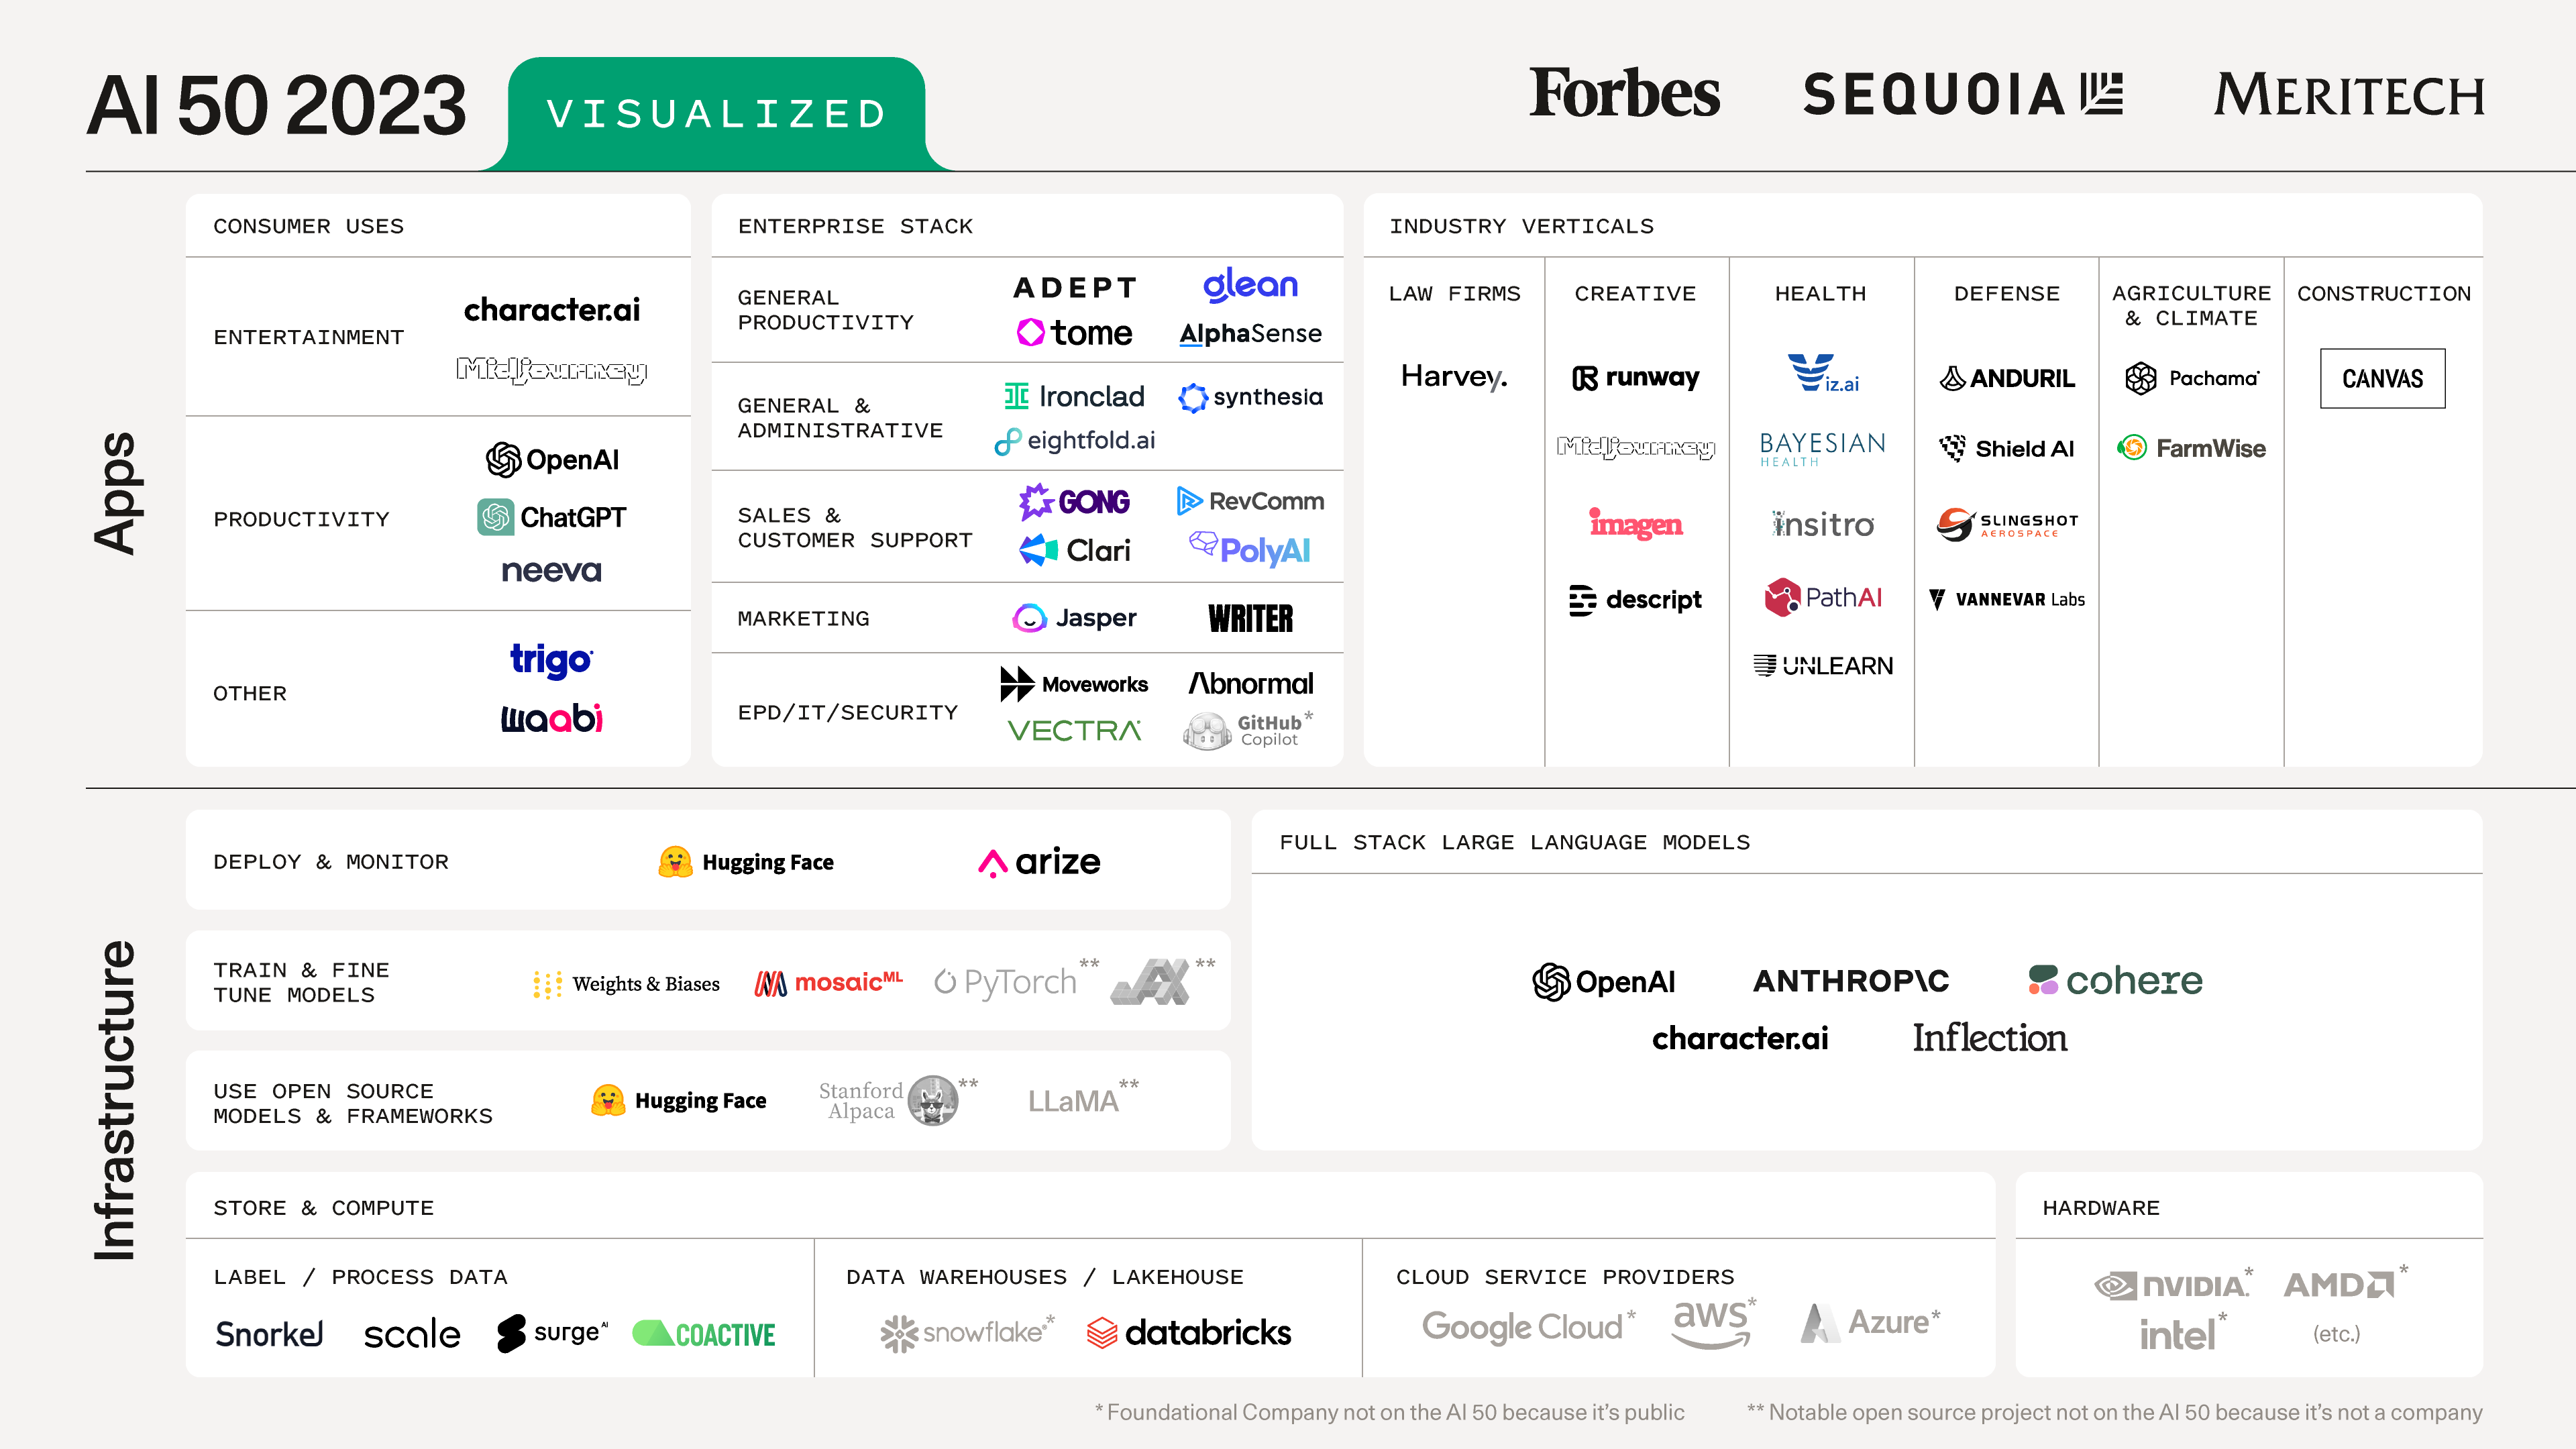
image.png

다만 Infrastructure Layer 에 있는 빅테크 입장에서는 다양한 Application 이 등장해 성공하는 것이 중요할 수도 있습니다.

언젠가 "생성 AI 관련 매출은 엄청난 성장을 거두었다" 라는 기사를 본 적이 있으실 것입니다.
과연 누가 사용하는 것일까요? 기업입니다.


(AI 기업 매출 추정 자료) https://www.techopedia.com/top-10-ai-revenue-leaders

당장 OpenAI 의 2023(e) 매출이 $1.6B, 원화로 2.1조에 달하는 데, 대부분이 API 비용으로 추산됩니다.

(180M ChatGPT 가입자 수 x 1% 전환율 x 12개월-사실 Pro 출시는 12개월도 되지 않음으로 비용 추산해보면 대부분은 API 비용임을 짐작케 함)


결국은 수요자가 아닌 또 다른 공급자인 기업이 현재 대부분의 AI 스타트업의 매출 향상에 기여했다고 보여집니다. 왜 그런가 하면, 일단 추가적인 R&D 없이도 서비스를 출시하기 쉬워졌고(잘하려면 R&D 를 무조건 해야하지만 출시 자체에 있어서는 R&D 없이 가능), 생성 AI 라는 키워드 자체가 주가 등의 실질적인 가치 향상에 기여하는 부분이 있기 때문입니다.

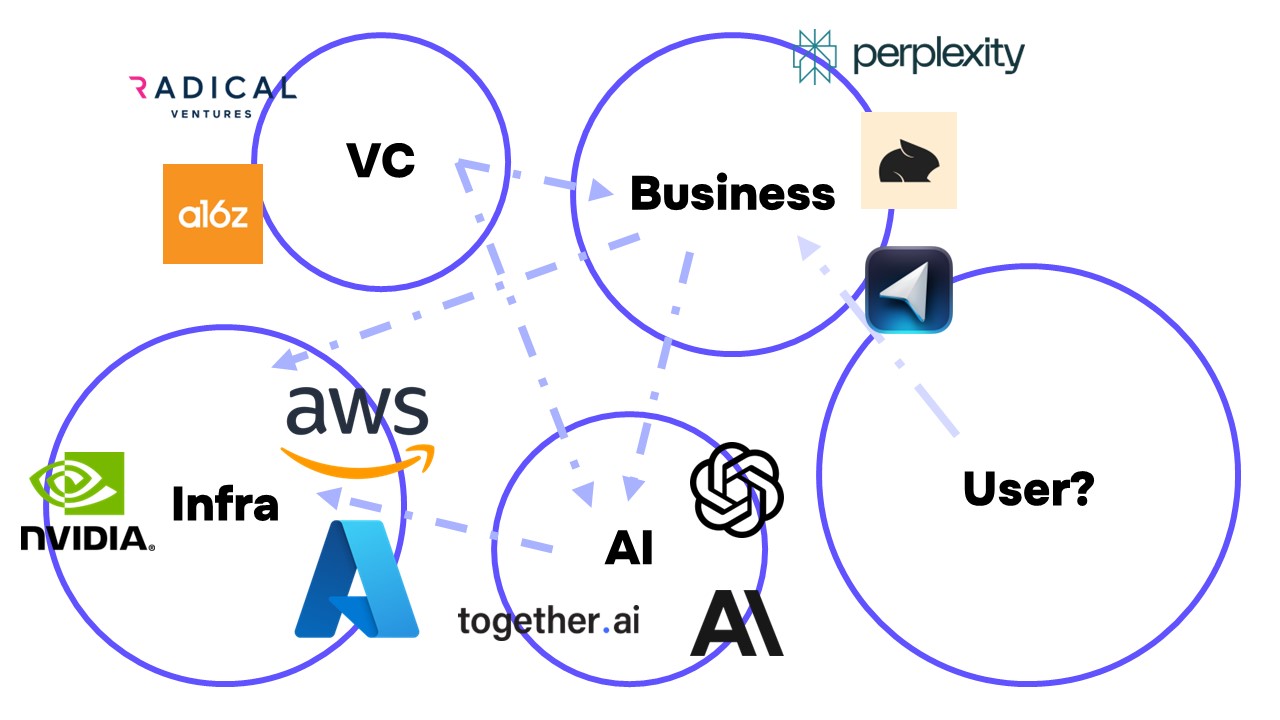
Revenue Flow.jpg

(화살표는 자본의 흐름, 결국 Business 영역에 있는 제2, 제3의 공급자의 입장에서 더 큰 가치를 주지 못하면 자본의 흐름이 끊긴다는 의미)

다만 현재로서는 원 공급자가 아닌 '또 다른 공급자'로서 고객을 유치할 유인을 확보한 상황은 아닌 상황인 것은 고민을 남기는 지점으로 보여집니다.

API는 일반 사용자가 이용하는 형태는 아닙니다. 즉, 내부 생산성 개선 목적으로 사용하는 것이 아니라는 의미이며, 이는 제품으로서 외부 사용자에게 다른 큰 가치를 제공해주어 돈을 벌 수 있어야 함을 뜻합니다.

일단은 기대감이 가득하기에 모든 기업에서 추진하고 있지만, 실제 사용자 입장에서 더 큰 가치를 만들어내는 상황이 만들어지지 않는다면 결국 비즈니스 어플리케이션 분야에서 사용을 줄일 것이며, AI 인프라 기업 또한 서버 인프라 사용을 줄이게 될 것이고, 이는 서버 인프라에도 차례대로 영향을 주어 무너질 수도 있음을 의미합니다.

그렇기 때문에, 인프라 기업 입장에서 시장의 기대감을 키워 생성 AI 분야 내 Iconic 한 플레이어를 키워내어야 그 동안 투입한 비용에 대한 ROI 를 높일 수 있어 현재도 투자를 과감히 진행하고 있습니다.

2023년 AI 스타트업에 투자한 금액 중 2/3 이 빅테크에서 나온 피치북 보고서가 이를 대변합니다.

(참고로 한국에서 AI 기업에 가장 관심을 보이는 곳은 통신 3사 입니다.)

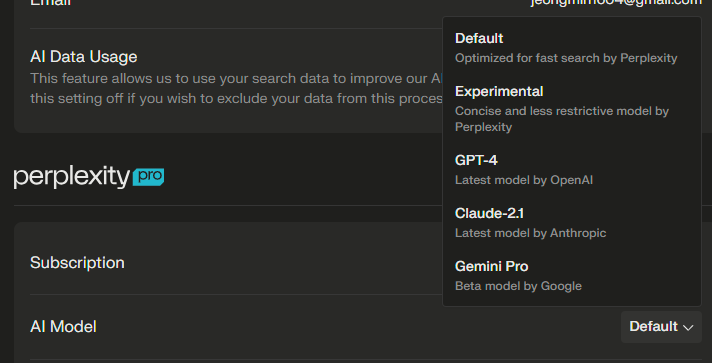
그렇다면, 현재 빅테크가 주목하고 있는 AI 스타트업은 어디가 있으며, 우리는 이 곳에서 무엇을 확인해야 할까요?

대표적인 예시로 생성형 검색 엔진 Perplexity 가 있습니다.
(기타 참고할 기업은 Midjourney, Pika Labs 가 비슷한 Playbook 으로 성장. Cursor.sh 도 재밌는 기업)

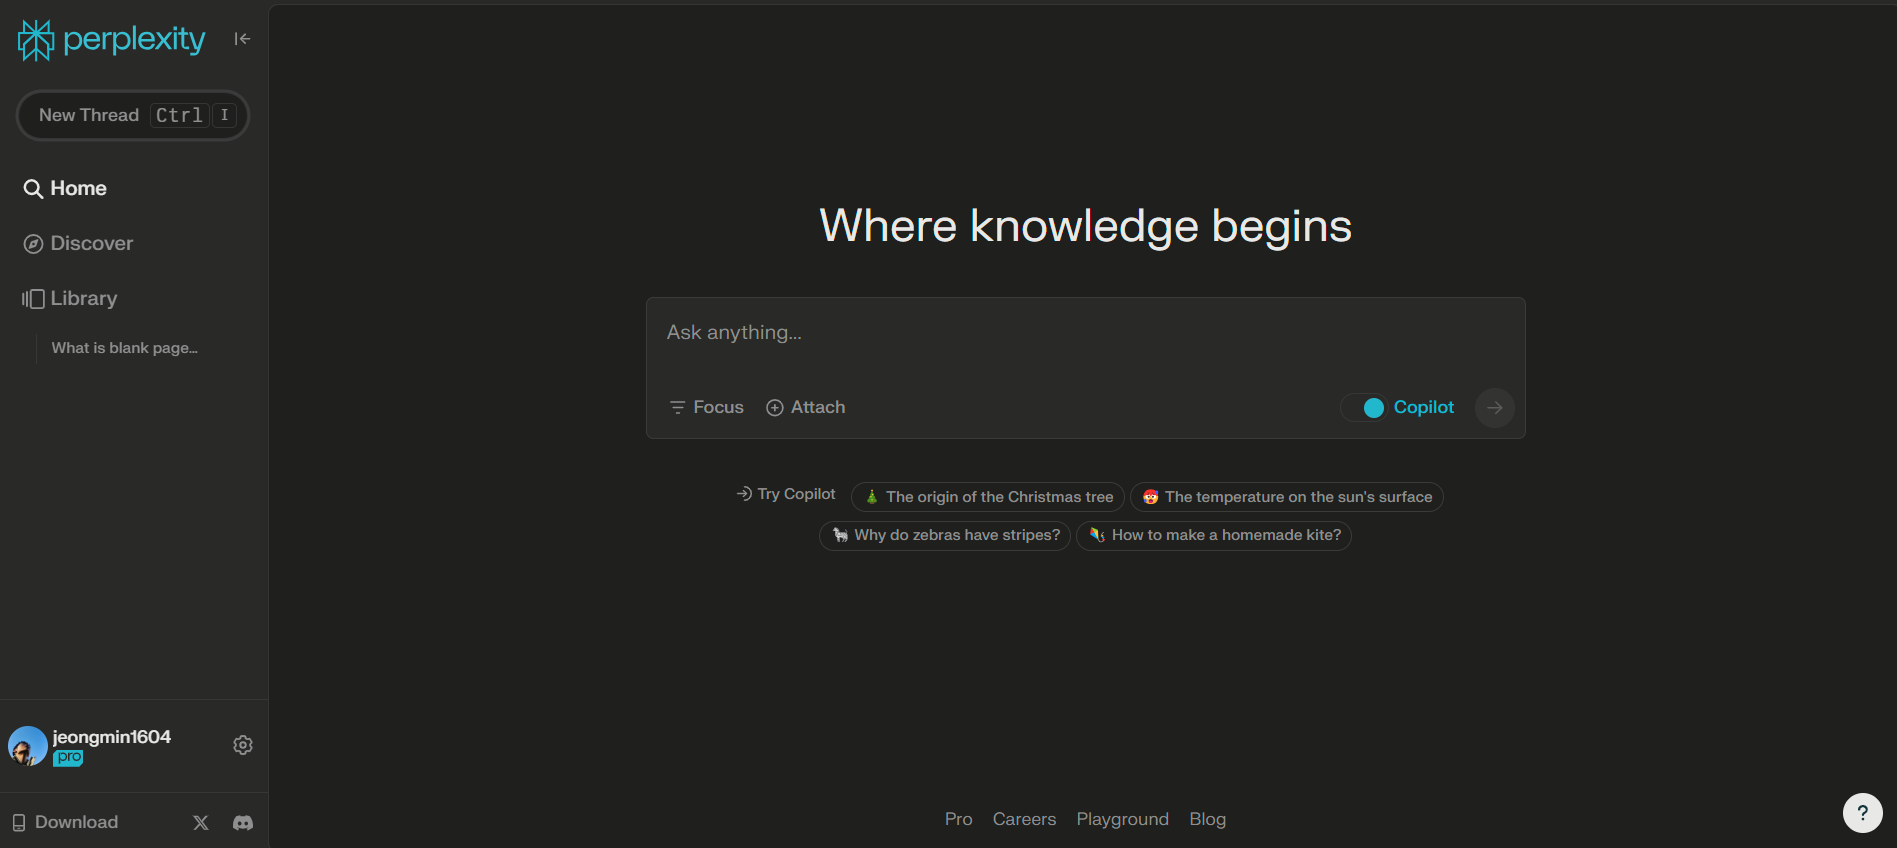
image.png

Perplexity 는 AI 기반 검색 엔진입니다.


이번 시리즈 B 라운드에서 약 1,000억원 ($73.6M) 을 유치했고, 투자자의 명단에는 제프 베조스 아마존 창업자 뿐만 아니라 실리콘밸리 내 유명 개인 투자자가 많이 포함되어 있습니다.


Perplexity 가 놀라운 점은,

  • UI 가 ChatGPT 랑 크게 달라 보이지 않는다는 점 -> ChatGPT 와 비교하여 차별성을 드러내기 쉽지 않다는 의미

    그림8.png

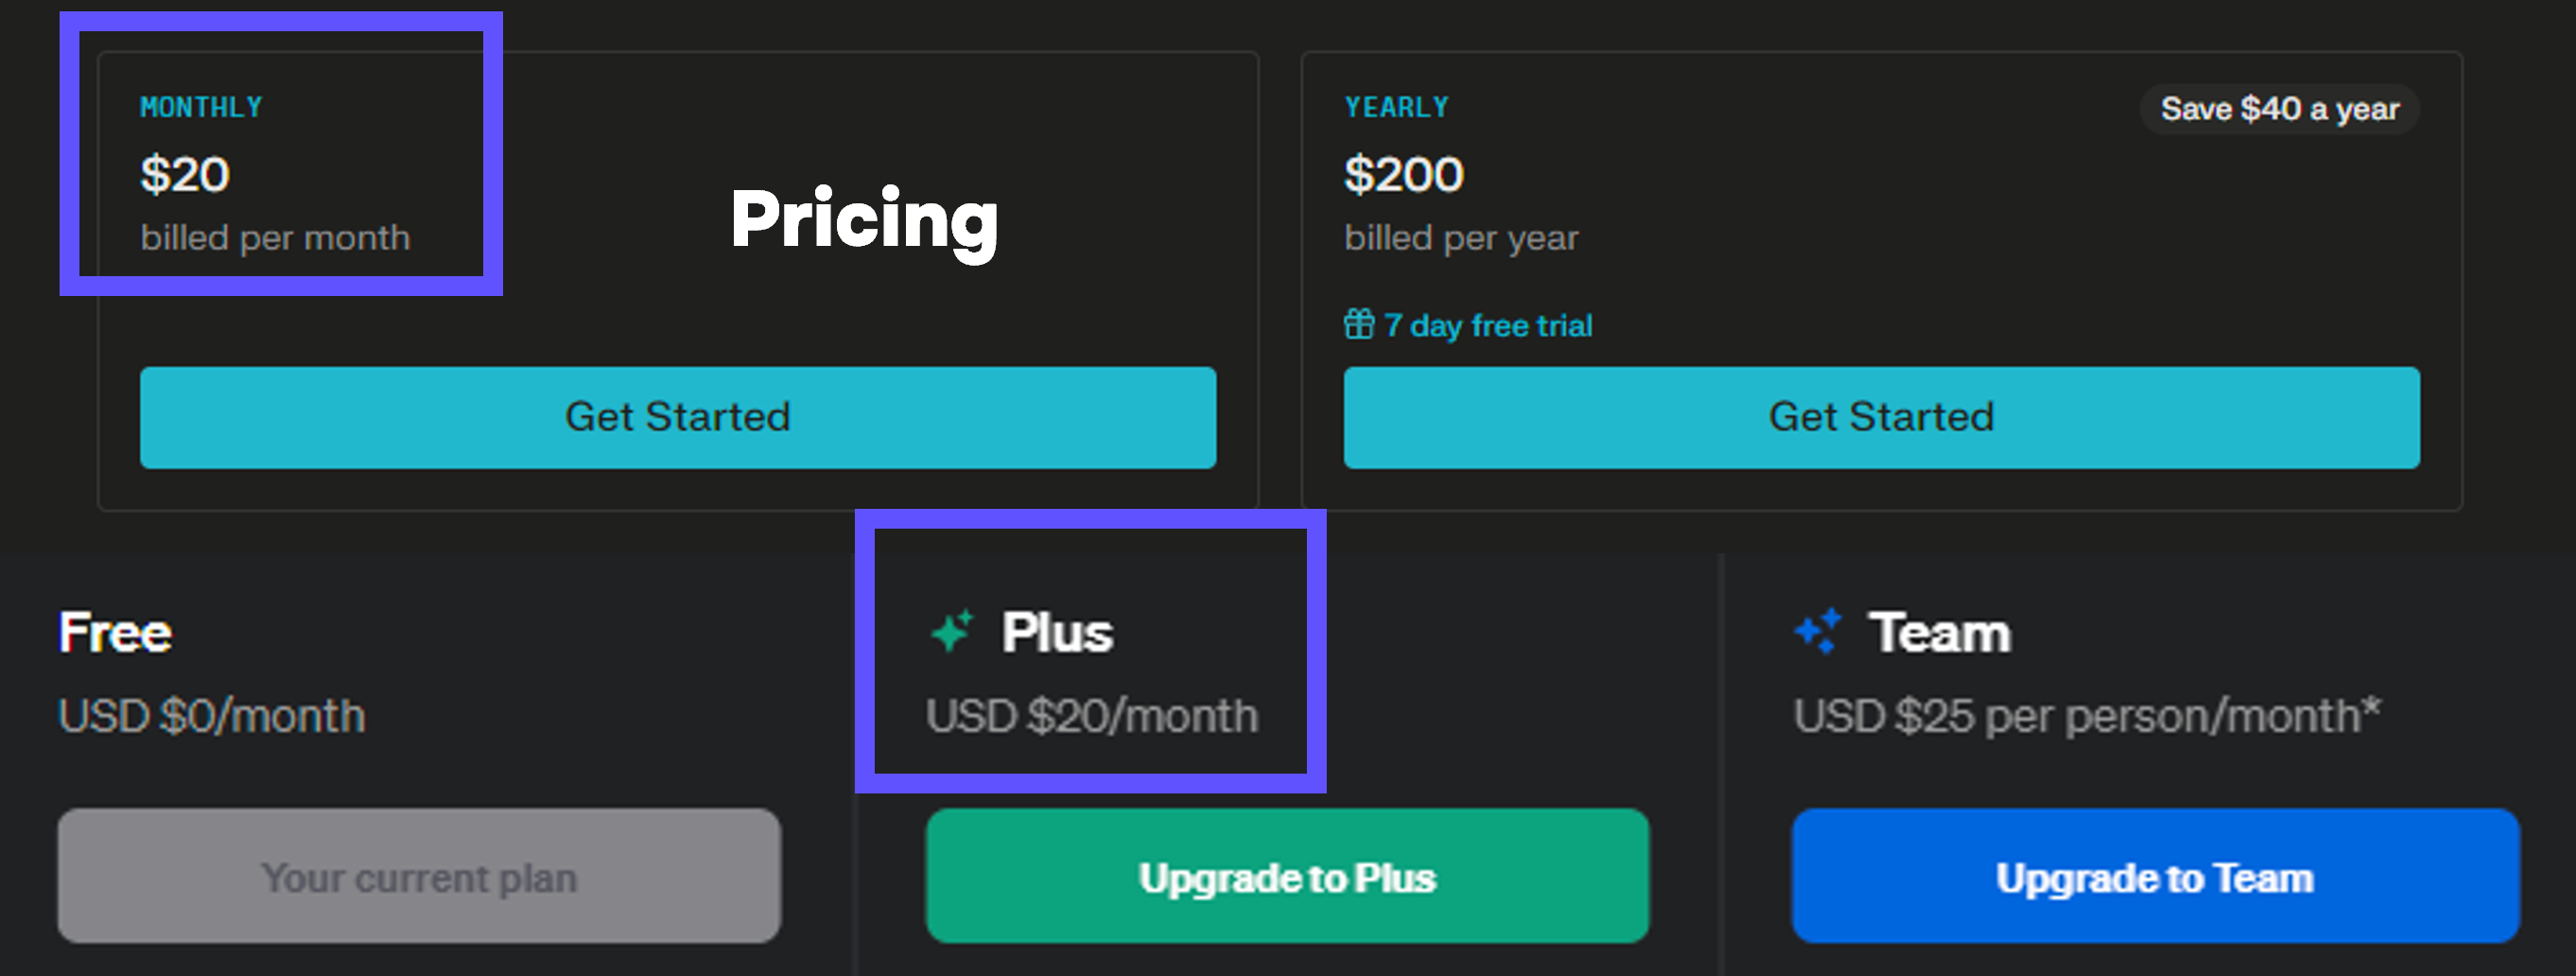
  • 가격도 ChatGPT 랑 동일한 점 -> ChatGPT 이상의 가치를 주어야 한다는 의미

    그림9.png

  • API 를 이용한 Third-party app 이라는 점 -> 같은 모델을 ChatGPT 보다 훨씬 제한적으로 사용하기에 성능 개선이 쉽지 않다는 의미

    image.png

입니다.

그런데 GPT 에 대한 권한을 훨씬 많이 가지고 있는 빅테크 Microsoft 의 Bing Chat 의 50% 수준에 달하는 검색량을 2023년에 처리했고, 앱 다운로드 수 100만 건 이상, 방문자 수 4,500만명을 기록하는 등 엄청난 성장세를 보였습니다. 어떻게 한 것일까요?

일단 Perplexity 는 검색 지향 AI를 표방했습니다.
링크드인에 표시된 소개를 빌리면 첫 문장은 "The most powerful answer engine." 이라고 합니다. 그리고 뒤에 오는 문장이 바로 "Powering curiosity with answers backed by up-to-date sources." 입니다.

즉, ChatGPT 를 경험해본 사용자 중 새로운 내용에 대한 검색이 불가능하다, 환각 현상(Hallucination)으로 정확한 결과가 나오지 않는다 라는 문제를 느낀 사용자에게 빠르게 접근한 것입니다.
그리고 결과 값에 대한 보증을 제대로 찾아준 UI를 구성해내었습니다. 이는 후속 글에서 더 자세히 다루겠습니다.

검색을 타겟한 것이 효과적이었던 것이 처음 ChatGPT 가 등장했을 때 언론에서 가장 많이 다루었던 이야기가 "구글은 이제 죽었다" 였습니다. 사람들이 가장 빠르게 연상했던 도메인이었다는 뜻입니다.

그리고 구글이라는 빅테크의 엄청난 레거시 서비스를 대체하겠다 라는 포부는 상당한 파급력이 있었습니다. 구글이 단순 검색만 하는 것은 아니지만, 구글의 최대 매출원은 검색 광고로 2022년 기준 $162B 로 전체 매출의 약 72%를 차지했습니다. 이런 구글의 현재 기업 가치는 $1.8T에 달합니다. 악화되고 있는 검색 경험을 제공하지만 여전히 엄청난 숫자를 자랑하는 기업을 제친다라는 점이 그들의 마음을 사로잡았습니다.


그래서 저희가 Perplexity 로 부터 배울 점은

  • 사람들이 AI를 통해 쉽게 연상할 수 있는 지점은 어디인가?

  • 사람들이 불편함을 느끼기 시작한 레거시 서비스가 어디인가?

  • 해당 분야에 특화된 UI 는 무엇인가?

  • 서드 파티로도 충분히 잘할 수 있는 역량과 가능성이 존재하는가?

입니다.

이에 대한 내용이 후속 글에 정리가 될 예정입니다.
아참, 이번 글에 있었던 이미지는 모두 AI 가 생성한 것입니다. 바로 Flamel 에서 말이에요.

플라멜 Flamel v0.1

프롬프트 엔지니어링이 필요 없는 가장 쉬운 검색형 이미지 생성 서비스

10
3
이정민

이정민

🤣 외국 인디 개발자 느낌으로 SNS 바꾸기

image.png

나름 외국물에 익숙하다면 익숙한 사람으로 생각했는데 외국인 친구들과 소통하는 공간에서 정말 눈에 안 들어오는 프로필을 하고 있는 제 모습을 얼마 전 비행기에서 발견했습니다.

x.com 도 그렇고 나름 기록을 하려고 하니 관리를 해야겠더라고요.

생각해보면 개인 또는 팀의 PR 파트가 중요할 수도 있는데 다른 일에 바빠서 미룬 것을 이번 주에 집중해서 개선하고 있습니다.

https://twitter.com/dannypostmaa

https://twitter.com/marc_louvion

https://twitter.com/DanKulkov

위 링크로 연결된 인디 개발자 분들을 참고해보았습니다.

특징은

  1. 프로필 배경에 특정 컬러를 준다.

  2. 키워드가 담긴 배너를 만든다.

  3. 본인의 설명을 간결하지만, 의외로 자세하게 적는다.

인 것 같습니다. 저도 따라 해보았고 앞으로 ml 쪽 내용을 이제 많이 공유할까 합니다.

플라멜 Flamel v0.1

프롬프트 엔지니어링이 필요 없는 가장 쉬운 검색형 이미지 생성 서비스

0
2
이정민

이정민

(2023 회고) 이 글을 읽고 제 실수를 반복하지 마세요

썸네일1.png(made by Flamel)

2023년이 얼마 안 남았네요.

사실 작년 이맘때 저는 마음을 많이 졸였습니다.

졸업을 앞두고 취업이 아닌 창업이라는 어려운 길을 향해 나아가기로 결정했기 때문입니다.

이제 와서 말씀드리지만, 저는 당시에는 AI 개발에 있어서도 크게 앞서는 사람도 아니었습니다. (ML engineer로 대표님이 계셨지만) 그리고 무엇보다 팀에는 프로그램 개발자가 없었습니다.

그래도 꿈꿔왔던 창업의 길 문턱에서 멈추지 않고 달려와 작년에 그린 모습에 대해 지금 글을 써볼 수 있는 것 같습니다.

일단 성과를 말씀드리는 것은 뒤에서 하고,

반성에 대한 내용을 여러 자 써보려고 합니다. (팀의 의견이 아닌 개인의 생각입니다)

--

1. 정부지원사업(+창업경진대회)을 '효과적'으로 하자.

먼저 창업중심대학 운영을 도와주신 한양대학교 창업지원단, 그 중에서도 특히 저희 팀을 도와주신 강혜주 매니저님께 감사의 말씀을 드립니다. 매니저님 덕분에 정신 없는 상황 속에서도 많은 성과를 낼 수 있었습니다.

정부지원사업을 효과적으로 하자는 의미는 크게 두 가지입니다.

한 가지는 팀에 필요 없는 사업은 무작정 지원하지 않는다와 다른 한 가지는 단순하게 사업비 예산 비목을 정한다 입니다.

일단 팀에 필요 없는 사업은 무작정 지원하지 않아야 함을 배웠습니다.

정부지원사업은 서류 작업이 많이 필요한 작업입니다. 선정 과정 뿐만 아니라 후에도 제대로 집행이 되었는 지 증빙을 위한 과정이 진행됩니다. 이는 프로덕트 개발에 집중해야 될 리소스가 분산될 수 있음을 의미합니다.

스모어톡이 다양한 올해 초 지원 사업 및 창업 대회에 선보인 이유는 두 가지입니다.

첫 번째, 팀을 알리기 위한 수단이었기 때문입니다. 실제로 여러 기관 및 담당자 분들께서 도와주신 덕분에 좋은 기회를 많이 가질 수 있었습니다.

그리고 두 번째, AI 비즈니스의 빠른 움직임 및 전반적인 벤처 금융 환경의 악화였습니다. AI 비즈니스의 경우 disruptive 한 모델이 나오는 순간 기존 비즈니스가 무너지는 경우를 많이 볼 수 있었고 (역으로 말하면 새로운 기능이 나오면 금세 주도권을 가질 수도 있는 상황), 벤처 기업 탄생의 씨앗이 될 수 있는 자금을 선제적으로 확보하지 않으면 금세 사업이 좌초될 수 있는 리스크가 존재하는 사업 환경 또한 확인한 상황이었습니다.

성과를 내었습니다. 그런데 그것이 프로덕트의 성공이었냐고 하면 아직 이라는 답을 드릴 수 밖에 없는 것 같습니다. 그리고 그 이유 중 하나로 문제에 집중할 수 없던 환경을 떠올립니다.

결과적으로 지원 사업에서 파생된 지원 사업의 경우 당장 팀에게 필요한 것은 아니었지만 참여함으로서 큰 의미를 만들지 못하고 소모한 금액도 존재합니다.

그게 참 아쉽습니다. 해당 비용을 더 현명하게 쓸 수 없다면 그렇게 할 수 있는 팀과 공유할 수 있었다면 어땠을까. 그리고 우리는 이제서야 방향성을 찾은 프로덕트를 조금 더 빨리 만들었다면 어땠을까. (덕분에 2024 시작을 재밌게 할 수 있게 되었지만)

다음으로 사업비 예산의 비목은 크게 정해야 함을 배웠습니다.

애초에 저희 팀은 인건비가 적게 발생하는 소규모 팀입니다. 그렇기에 저는 유치한 사업비에 대해 인건비를 제외한 후 정말 '꼼꼼하게' 계산 후 비목을 설정해서 진행했습니다. 그리고 이것이 현명한 것이라 생각했습니다. 그런데 앞서 말씀드린대로 사업비 증빙을 위한 서류가 정말 많습니다. 이 중 필수 서류 항목에 대하여 생략할 수 있는 방식을 잘 활용하면 업무량을 크게 줄일 수 있습니다.

결국 현명하게 사업을 처리하지 않은 결과 수 천만원의 사업비 중 수십만원의 집행되지 못한 잔액이 발생하고 말았습니다. 만약 예산 비목을 세세하게 정하지 않고, 큰 비용이 발생하는 건에 집중해서 설정했다면 적은 가짓 수의 서류로 잔액 또한 발생하지 않게 사업을 수행하지 않았을까라는 아쉬움이 남습니다.

2. B2B에서 공통의 needs 를 찾을 수 없다면 의미 없을 수도 있다.

스모어톡은 운이 좋았습니다. 소규모 팀임에도 정말 좋은 고객사 분들을 모실 수 있었기 때문입니다. 또한 많은 기업 관계자 분들께서 도입 문의를 남겨주셨습니다. 그래서 흥미로운 프로젝트도 함께 진행할 수 있었습니다.

그런데 스타트업은 빠르게 성장하기 위해 디자인된 기업의 형태를 의미합니다.

즉, 적은 리소스로 고객의 정확한 문제에 집중하여 수익을 빠르게 창출하는 비즈니스 모델을 구축해야 스타트업이라고 할 수 있습니다.

급격한 금리 인상으로, 일반 고객보다는 기업을 상대로 해야 수익을 발생시킬 수 있다는 기조 아래 많은 스타트업이 B2B 에서 방법을 찾으려고 하고 있습니다. 실제로 B2B SaaS 시장의 성장세가 탄탄한 것도 해당 움직임에 힘을 실어주지 않았나 생각합니다. (링크, Tech is Cooling Off. B2B SaaS is Not. from BCG)

다만 기업의 수요가 파편화되어 있다면 적은 수의 인원으로는 불가능한 비즈니스일 수 있음을 이해해야 합니다.

수 개월 전 기업의 향후 전략에 대한 프로젝션 자료를 요청 받아 작성하는 과정에서 B2B 보다 B2C 에서의 시장 파급력을 이해하게 되었습니다. 당연히 어떤 방식이 보다 유리하다라고 생각하는 것은 없습니다. 프로덕트가 속한 시장 도메인에 따라 천차만별이기도 합니다. 다만 서비스 건 당 단가 및 예상 고객 수를 예상해보면, 어떻게 시장에 접근해야 할 지 예상해볼 수 있습니다. 경우에 따라 단가 경쟁력을 재고해보아야 할 수도 있고, 고객 수를 늘려야 할 수도 있음을 확인할 수 있기 때문입니다. (그런 점에서 예상 매출액을 계산해보는 것을 꼭 해보시기를 추천해드립니다. 저는 조금 늦게 했습니다.)

저는 스모어톡이 B2B를 잘하는 팀이라는 것을 인지했음과 동시에 현재 상황에서는 적은 리소스의 최대 집중으로 시장에서 큰 파급력을 일으키는 것이 필요함을 깨달았습니다. 이것이 스모어톡이 기능의 관점에서 사용자가 '가장 원하고 있던' 것을 '가장 편하게' 제공하고자 프로덕트를 새롭게 업데이트하고 있는 이유입니다. (워낙 많은 프로젝트를 진행하면서 수요가 있는 지점을 알게 된 것이 2023년의 수확입니다)

--

기타 느낀 점으로는..

  • 회사와 나를 '가끔은' 분리 시켜야 정신 건강에 좋다.

  • 말로 하는 사람이 대부분이다. 그래서 사업 아이디어가 있다면 옮겨보면 좋다.

올해는 제가 살면서 가장 짧게 느껴진 한 해였습니다.

그만큼 치열하게 한 해를 보냈고, 그래서 더 그간의 과정에서 아쉬움을 느끼는 점도 많습니다.

하지만 어쩌겠나요. 지나간 일인 것을.

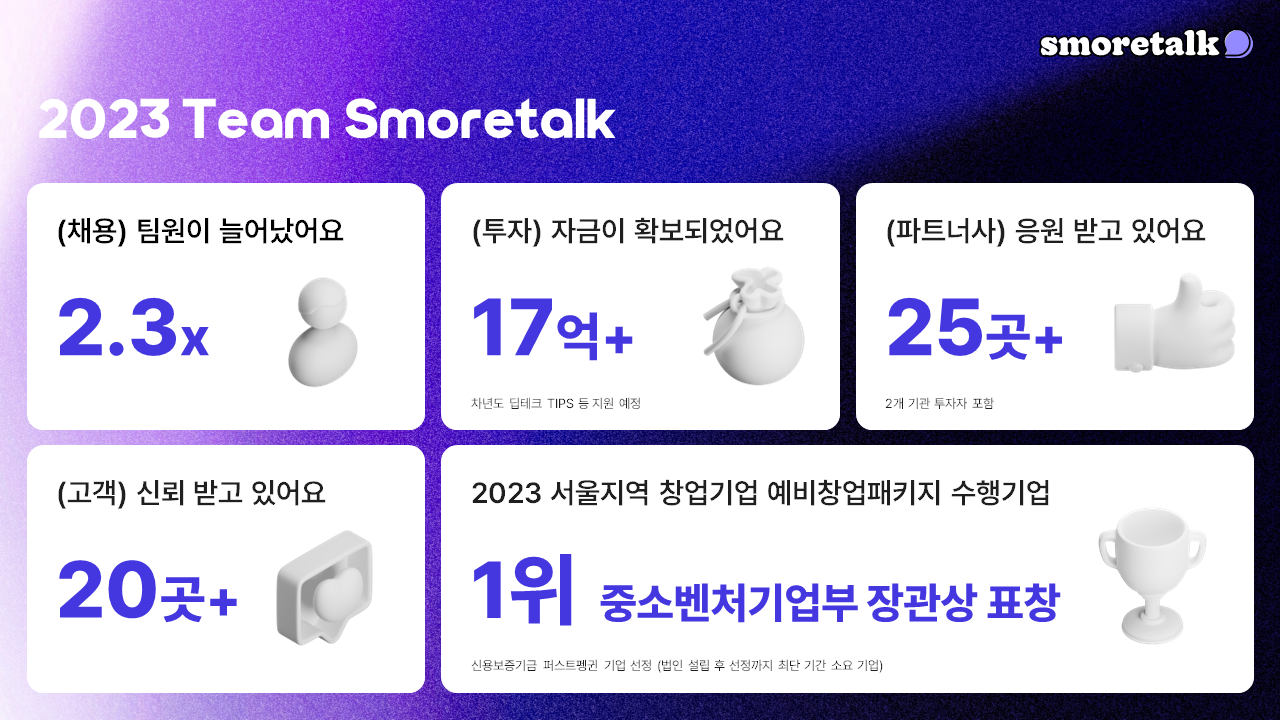
그래도 이렇게 결산을 정리하니까 뿌듯합니다.

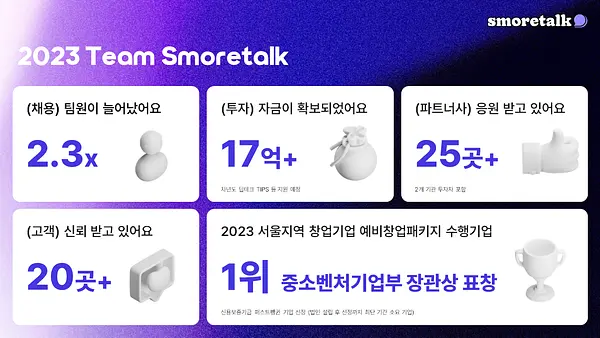
2023 smoretalk.png

한 번씩 스스로를 위로할 때 듣는 노래 중 하나가 "하기나 해 - 그레이" 입니다.

노래 가사처럼 내년에도 일단 하는 사람이 되어서 창업의 길을 묵묵히 걸어갈 수 있는 사람이 되고 싶습니다.

모두 새해 복 많이 받으세요!

플라멜 Flamel v0.1

프롬프트 엔지니어링이 필요 없는 가장 쉬운 검색형 이미지 생성 서비스

28
14
이정민

이정민

👇 미래에 AI 디자이너와 함께 일하는 모습은?

recording_gif.gif

생각보다 우리 가까이에 있을지도 모릅니다.

정식 프로덕트는 전혀 아니고 (훨씬 더 편한 플라멜은 이미 베타 테스트 중)


그 대신 미래에는 어떤 모습의 도구가 등장할 지 함께 고민해보고자 스모어톡과 함께 일하고 있는 AI 디자이너(인간 아님, AI)와 함께 영상을 찍어보았습니다.

참고로 스모어톡은 AI 시대에 걸맞는 정말 간편한 UI/UX를 고민하고 있습니다.
혹시 관심 있으신 분들은 커피챗 부탁드립니다.

11
6
이정민

이정민

(D+180) 자랑스러운 우리 팀, 스모어톡

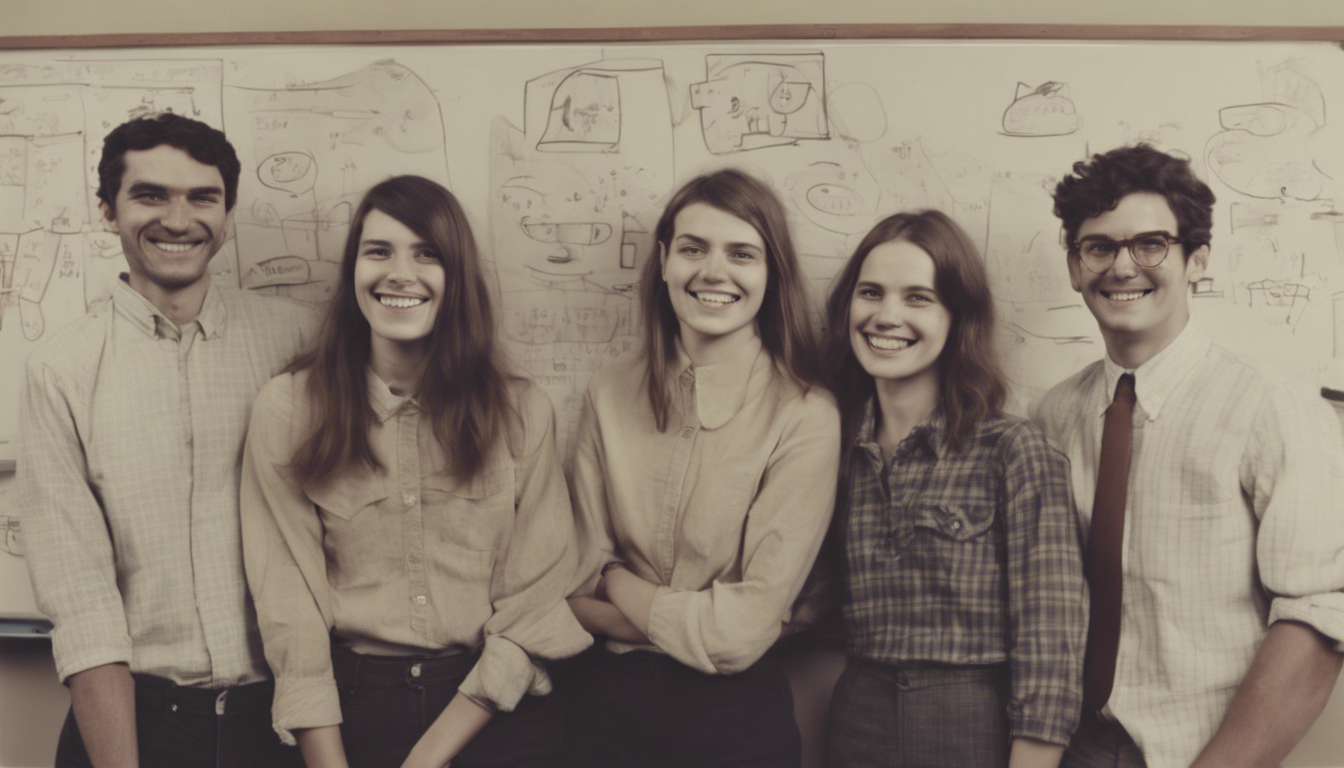
화이트보드 앞에서 웃고 있는 사람들.png(made by Flamel)

어느덧 11월도 마무리가 되어 가는 시점입니다.

물론 스타트업에게 7일은 매우 긴 시간이지만 말입니다.

저희 팀은 최근에 프로덕트 고도화에 대해 더욱 박차를 가하고 있습니다.

  1. 벌써 400명에 육박하는 클로즈 베타 신청자 분들 중 순차적으로 권한을 부여하여 다양한 기능을 제공

  2. 잠재 고객 인터뷰를 통해 발굴하여 팀 내부 개발 툴에는 적용이 되어 있는 기능에 대해서 완성도를 높임

  3. QA 끝나면 베타 툴에 도입

위 과정을 빠르게 가능하게 한 이유는 결국 팀원분들 덕분인데요.

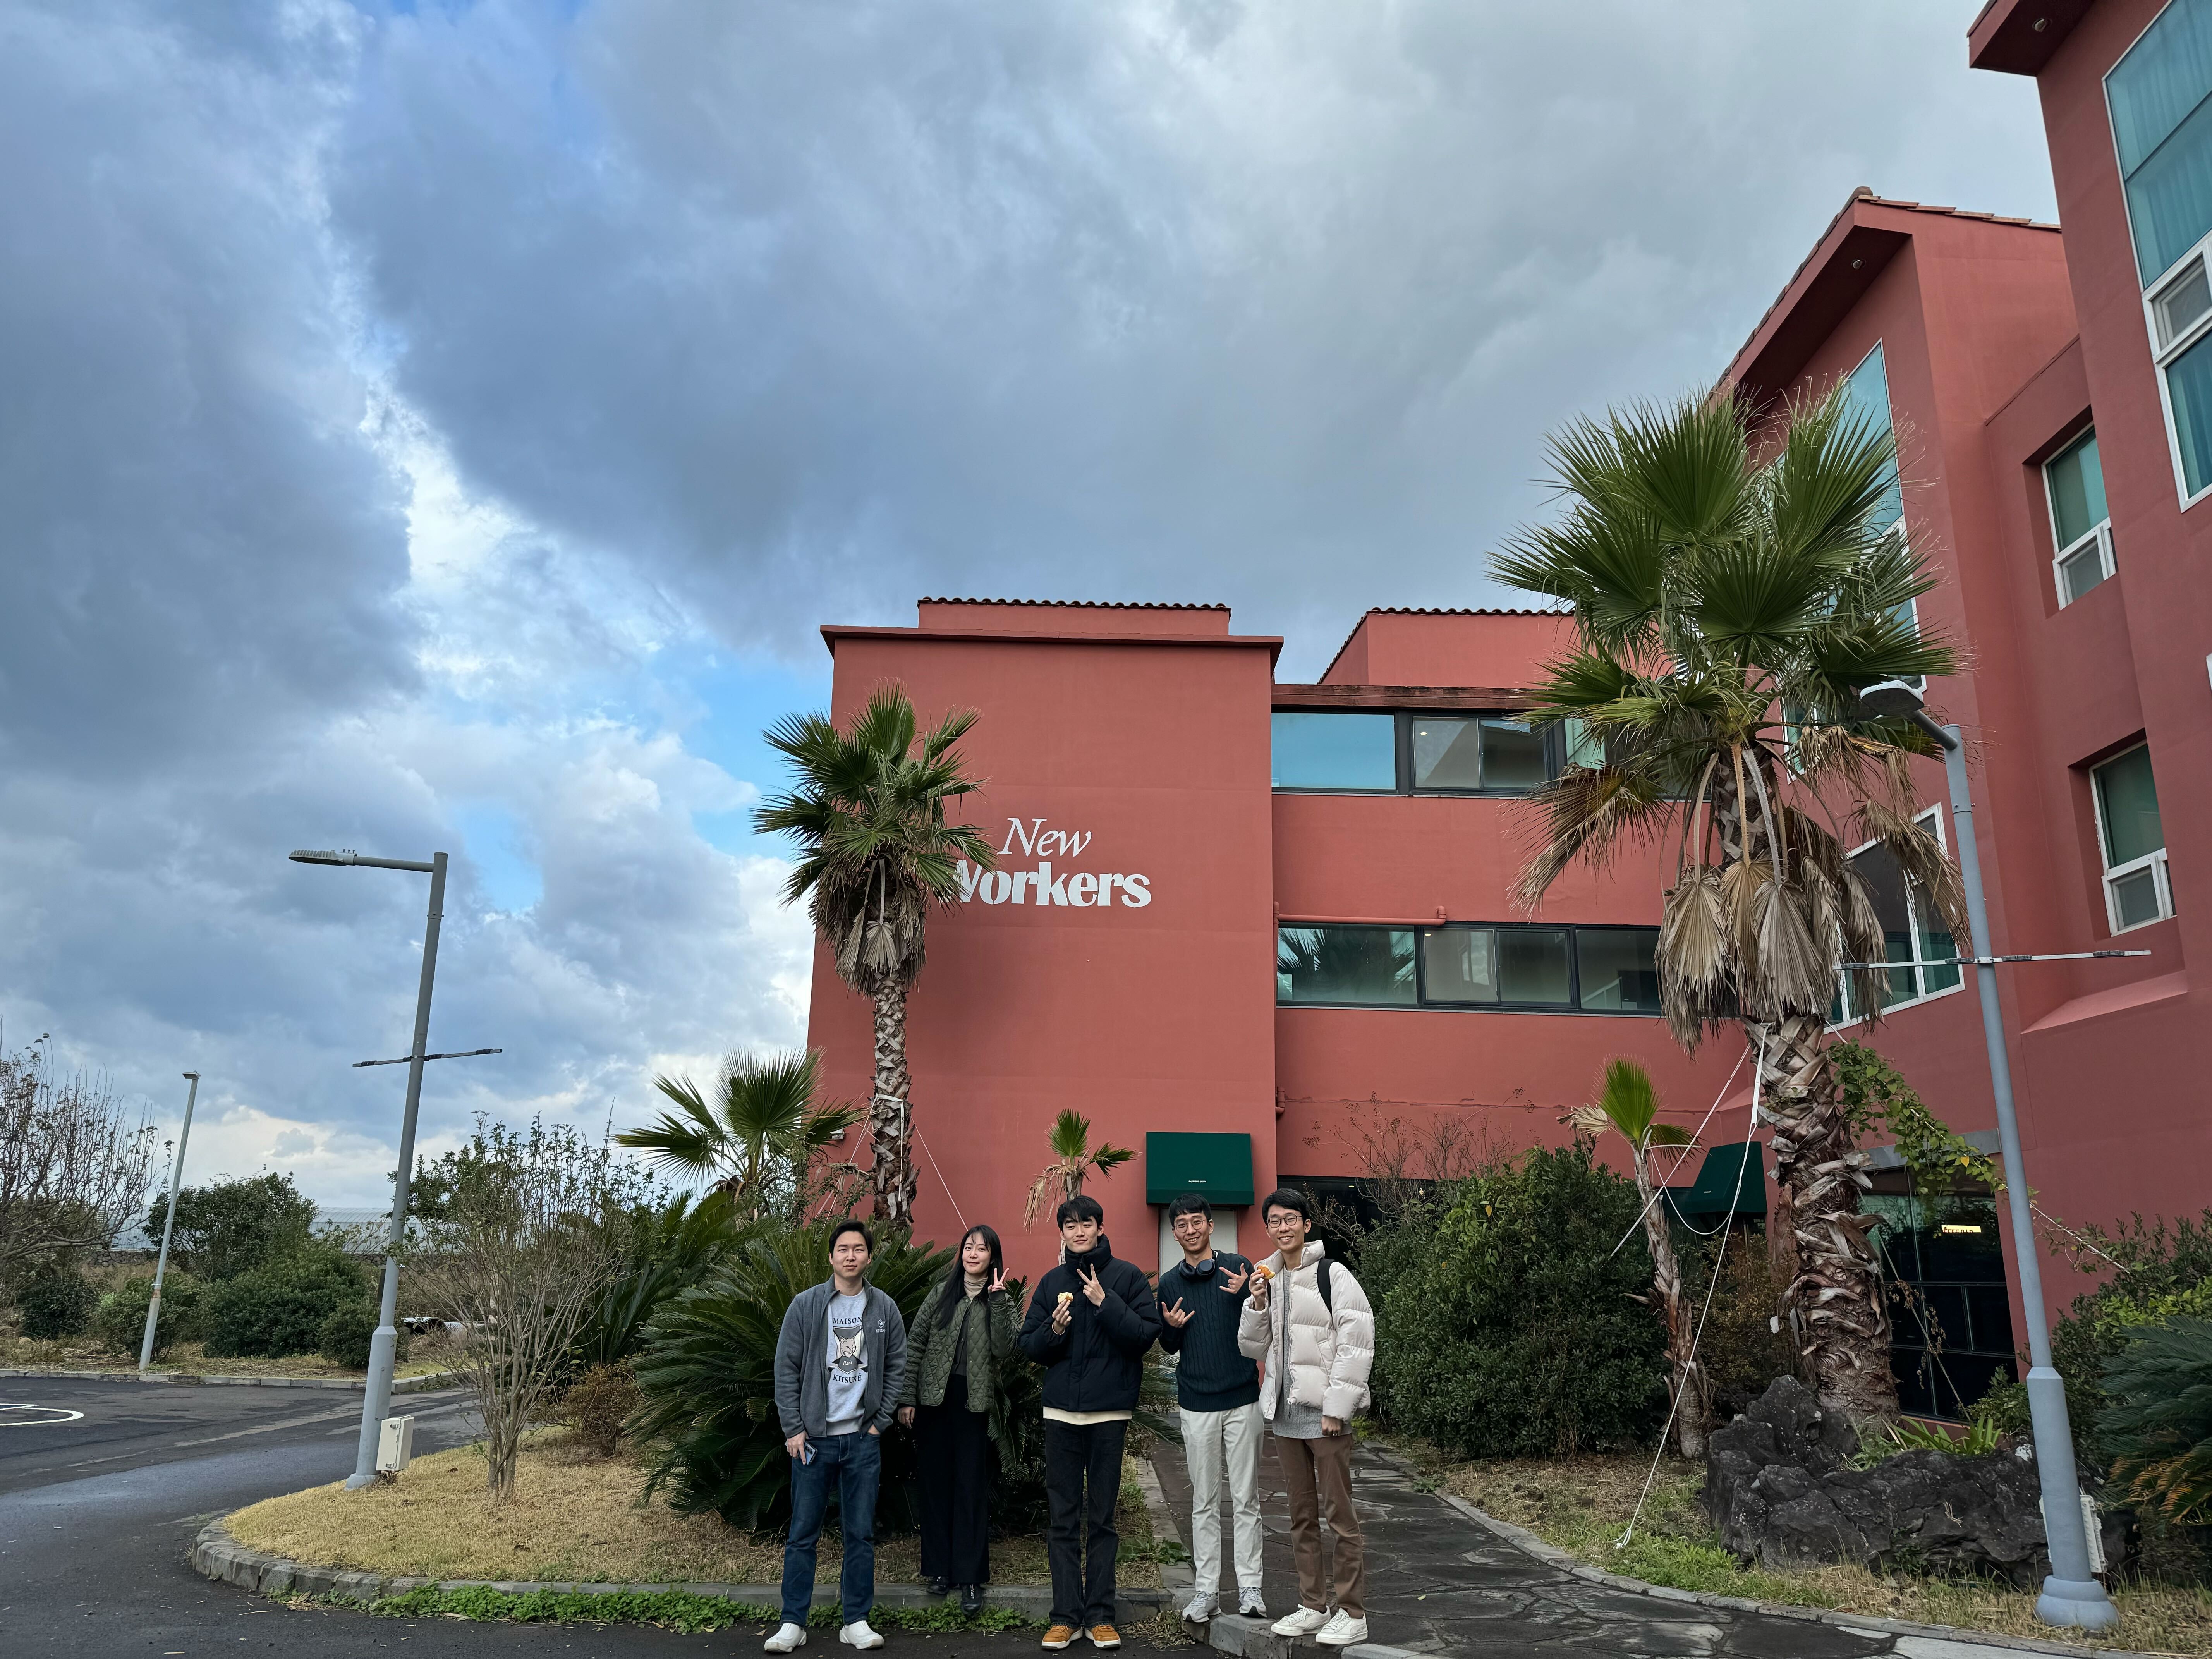
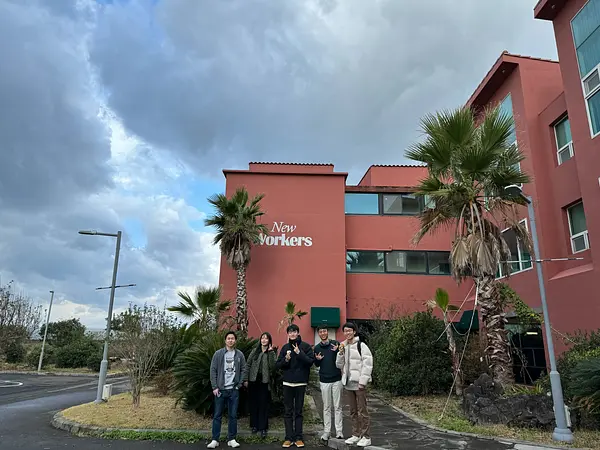
IMG_8104.jpg

아무 것도 없던 팀에 원대한 목표 하나로 뭉친 팀원 분들과 제주도로 워케이션을 다녀 오면서 또 한 번 팀원 분들에 대한 고마움이 떠올랐습니다.

잠도 못 자고, 밥도 제대로 못 먹을 정도로 바쁜 일정에서도 계속해서 쌓이는 일정을 계획적으로 관리할 수 있는 CEO님,

제 지인이 대부분 알 정도로 유명한 개발자로서 전반적인 개발 관리 및 듬직한 사수가 되어주시는 CTO님,

회사 생활은 처음이지만 프론트 개발에 멈추지 않고 프로덕트 기획까지 자발적으로 참여해주시는 Dev님까지.

그런 팀원분들과 일할 수 있기에 창업이 참 매력적이라고 생각합니다.

플라멜 Flamel v0.1

프롬프트 엔지니어링이 필요 없는 가장 쉬운 검색형 이미지 생성 서비스

17
9
이정민

이정민

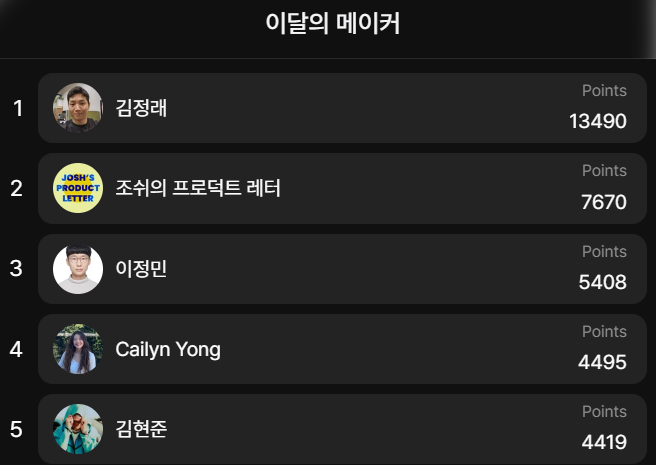
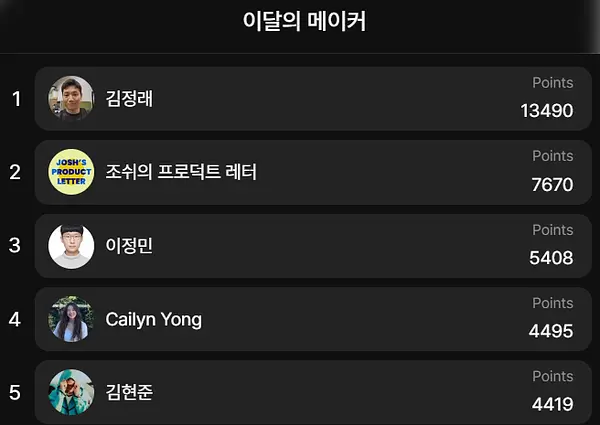
🥲 2236-5052-5408

제목에 적힌 숫자가 의미하는 것은 무엇일까요? 🤔

스크린샷 2023-10-31 210848.png

참고로 제목에 적힌 숫자는 8-9-10월 디스콰이엇에서 제가 확보한 포인트입니다.

킬러 콘텐츠는 없었지만 정말 감사히도 많은 분들께서 글을 읽어봐주셨습니다. 🙏

(차트에 계신 분들, 모두 제가 존경하는 분들입니다)

벌써 11월입니다.

그리고 글을 이제서야 작성하는데요.

스타트업 씬에서 10월, 11월은 한 해 있었던 내용을 정리하는 수확의 달이기도 합니다.

한국이나 미국이나, 또는 그 외 국가나 많은 곳에서 스타트업이 결과를 발표하고 이에 따라 명예가 있는 타이틀을 수여합니다.

스모어톡도 그래서 조금 바빴습니다.

중기부 장관상 2건 외 다양한 대회에서 주신 명예로운 상장.

그리고 사업자 등록 5개월만의 신용보증기금 퍼스트펭귄기업 선정.

이번에 감사히도 위의 결과를 받게 된 것은 어리석었던 제가 올해 초 벌인 일에서 나온 결과들인데요.

돌아 보니 이제 이런 건 사실 하나도 중요하지 않다고 생각합니다.

왜 중요하지 않냐에 대해서 3가지로 정리해드리겠습니다.

  1. 본 사업에 지장을 줄 수 있을 정도로 서류가 정말 많다. 이는 사업 실행 속도를 저해한다.

    • 기업이 어떻게든 돈을 받는 행위는 중요합니다. (이런 점에서 사업의 안전 장치가 마련된 한국은 창업가들에게 미국 다음으로 복 받은 환경이라고 생각합니다) 그렇지만 성장을 위해서라면 국가가 아니라 고객에게서 돈을 받아야 합니다. (B2G 사업 제외)

    • 정부에게서 돈을 지원 받을 경우 많은 증빙 서류가 필요합니다.

    • 고객을 만나는데도 정신이 없을텐데 서류와 기타 요청 사항에 대응한다? 과연 정말 우리는 사업을 하고 있는 걸까요 아니면 정부지원기관 서류 업무를 하고 있는 걸까요?

  2. 우리는 팀이 아니라 기업이다. 이는 상장이 실제 실적에 큰 의미가 없음을 말한다.

    • 상장 기업을 생각해보면 실적 발표 시에 우리가 무슨 무슨 상을 받았다 라고 한 공시 자료를 본 적이 있으신가요? 설령 있더라도 주가에 하등 영향을 주지 않습니다.

    • 이유는 매출, 영업이익 등의 회계상 지표 또는 신사업의 성장세, 혹은 인재 유치가 기업에게는 훨씬 중요하기 때문입니다.

    • 초기 기업인 우리들은 시장의 성장세, 프로덕트의 기대 수익에 대한 가설에 맞는 지표를 제시해야지, 상장 또는 어디 프로그램에 선정되었다는 것을 대외적으로 알리는 것은 크게 의미가 없다고 생각합니다. 그래서 중요하지 않습니다.

  3. 상장은 작은 성공이다. 이는 성장 욕구를 저해한다.

    • 크게 상장을 받으면 잘하고 있다고 착각하게 됩니다. 사실 잘하는 게 맞을지도 모릅니다.

    • 그런데 거기에 사로잡혀 안도감을 가질 경우 얼마 크지도 않은 사업의 상태에서 머무르게 됩니다. 이만해도 잘하고 있다고 생각하기 때문에.

    • 스타트업은 폭발적인 성장을 추구하는 그룹입니다. 최소한 몇 사람만이라도 우리의 고객이 되게 하여 다른 대체 서비스로 넘어갈 수 없게끔 만들어야만 향후에 앞에서 말한 폭발적인 성장을 기대할 수 있습니다.

잘하면 상장, 그리고 홍보 기사까지 자연스럽게 이어진다는 것을 경험한 반 년이었습니다.

기술적인 내용까지 스모어톡에 관심을 보인 기업에게 증명해낸 반 년이었습니다.

그런데 그만큼만 하면 아무 의미가 없다는 것도 깨닫게 된 반 년이었습니다.

10월에는 개인사로, 그리고 팀을 위해서 정말 단 한 순간도 쉬지 못했고, 덕분에 독감까지 걸려 퍼포먼스가 급격히 낮아지는 것을 스스로 느끼기도 했지만 모든 것을 정리하고 어찌되었든 팀에게 좋은 것을 만들었다는 점에서 자부심을 느끼되 이제는 우리의 서비스 플라멜을 공개하는 만큼 더 미친 듯이 고객의 마음을 사로잡겠습니다.

후드티 입고 모니터를 바라보는 소년, 뒤에서 바라보는 모습.png

(made by Flamel)

*상금 받은 것은 프로덕트 고도화를 위해 떠나는 제주도 워케이션에서 식비로 멋진 팀원 분들과 좋은 시간 만드는 데 사용할 예정입니다.

플라멜 Flamel v0.1

프롬프트 엔지니어링이 필요 없는 가장 쉬운 검색형 이미지 생성 서비스

5
0
이정민

이정민

🤔 우리가 팔고 있는 꿈은 무엇인가요?

사람들을 등지고 서있는 후드티 입은 남자.png

(made by Flamel)

확실히 경기가 침체된 상황입니다.

Risk free return

우리가 미국이라는 전 세계에서 가장 강력한 국가에 돈을 빌려주면 1년 만 지나도 약 4%(=표면 금리, 채권 시세 차익 고려한 수익률은 5%... wow)의 이자 수익이 돌아옵니다.

Risk premium

반면 리스크가 매우 큰 벤처 투자 수익률은 연 이율로 따지기에는 애매하지만 '23 청산 펀드의 평균 수익률이 한 자릿수에 가까워질 것으로 예상됩니다.

즉, 리스크 대비 수익 차이가 크지 않은 거죠.

자본주의 체제에서 꿈을 펼치기 위해서는 '돈'이라는 수단이 필요한 경우가 많습니다. 그런데 앞의 이유로 돈을 가져오는 행위가 매우 어려워진 시점에서 창업의 근본으로 돌아와 보면, 잠도 잘 못자고, 자유 시간도 많이 빼앗기는 이 행위를 우리가 하고 있는 이유는 무엇인가요?

저마다 다양한 이유가 있겠지만, 저는 한국이 AI 산업에서 뒤쳐지면 안된다와 K-Pop 이 그러했듯이 성장이 많이 된 나라에서의 새로운 성장 동력은 한계가 없는 크리에이티브 산업이며 이와 관련한 SW 주도권을 가져와야 한다는 문제 의식으로 시작했습니다.

이는 피터 드러커의 말씀 중 하나인 "모든 비즈니스는 반드시 위대한 미션에서 출발해야 한다"에서 영향을 받은 것입니다.

사실 꿈을 이루는 행위는 쉽지 않습니다. 그런데 인사의 목적이던, 투자의 목적이던 타인에게 이루어지지 않은 꿈을 설득하는 것은 더욱 어렵습니다. 그럼에도 여러분들이 힘든 시기 속에 꾸준히 달려 갈 수 있는 원동력은 꿈 때문이지 않을까 생각합니다.

플라멜 Flamel v0.1

프롬프트 엔지니어링이 필요 없는 가장 쉬운 검색형 이미지 생성 서비스

0
1
이정민

이정민

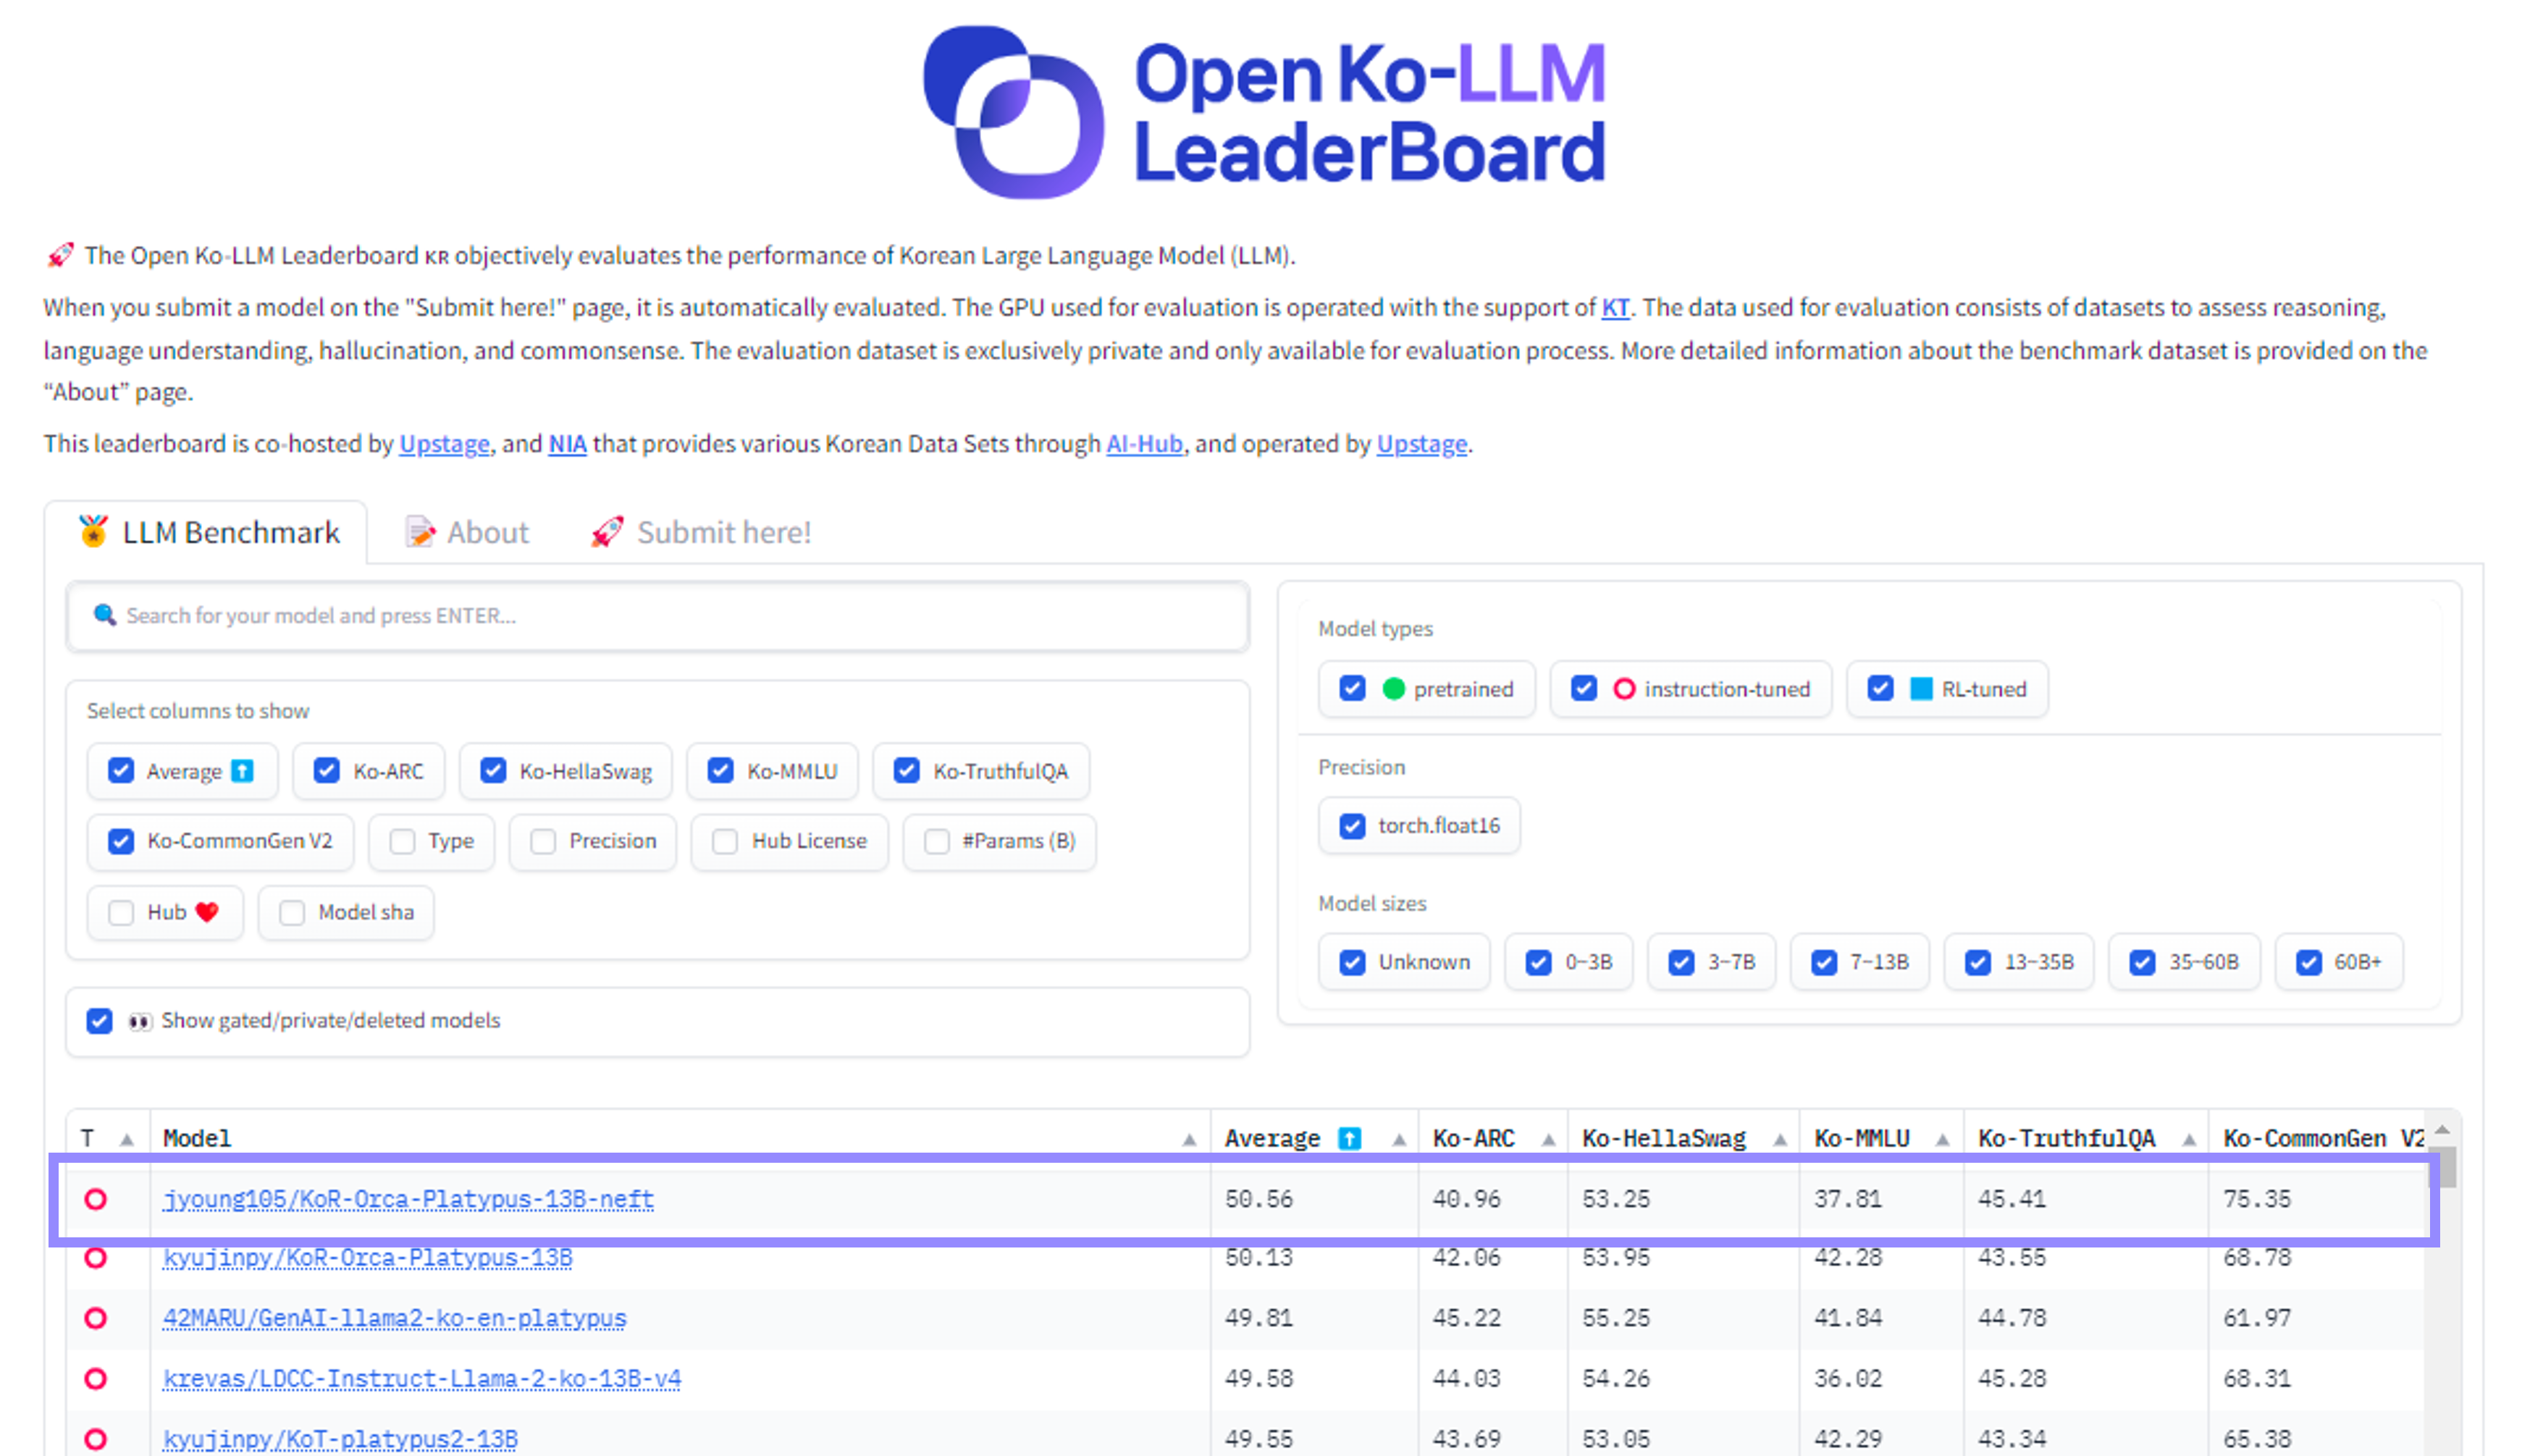
🏆 한국어 오픈 소스 LLM 1위 달성

차트 1등 메인 표시_오픈 llm.png

보라색 네모가 바로 저에요 :)

업스테이지와 한국지능정보사회진흥원(NIA) 가 운영하는 한국어 거대언어모델 리더보드에서 1위(!!!)🏆에 올랐습니다. 원래 하나 시작하면 1등하기 전까지는 못 배겨서 끝까지 시도해보았습니다... (3번째 제출)

우선 LLM 을 학습해본 경험은 없었기 때문에(이론적으로만 알던 상황) 사비로 100,000원을 날리면서도 학습이 거의 안 되서 포기한 경험도 있었는데, 직접 돈의 소중함(?)을 경험하고 방법론을 찾아가다보니 효율적인 학습을 진행하는 데 도움이 되더라고요. 결론은 데이터가 정말 중요하다고 생각했고, 오픈소스 생태계 활성화를 위해 데이터셋을 공개해주신 (주)미디어그룹사람과숲, (주)마커 그리고 한규진 개발자님께 다시 한 번 감사드립니다.

링크: 한규진 개발자님 블로그

저 또한 이미지 모델 관련 코드는 공유하고 있지만, LLM 쪽으로는 기여한 부분이 적은 것 같은데 한국어 멀티턴 데이터셋을 시간 날 때마다 준비 중이고 공개하여 윗 분들처럼 기여할 수 있도록 하겠습니다.

리소스 지원이 가능한 기관이 있다면 도와주시면 더 빨리 할 수도 있고요!

*1등이 기쁘지만 마냥 중요한 것은 아니기 때문에 향후 개선이 필요한 점을 제안하면

  • 해당 방법론이 CommonGen, TruthfulQA 지표의 개선을 가져다주지만, 그 외에는 성능이 하락한 것으로 보여짐

  • 참고로 학습한 방식은 정규화를 강화한 방식

  • 언어 성능을 개선하기 위한 방식은 다른 형태의 지시 데이터(멀티턴이라던가)와 이를 지원하는 프롬프트 구성이 필요한 것으로 판단됨

    이정민(스모어톡, tonylee@smoretalk.io)

0
9
이정민

이정민

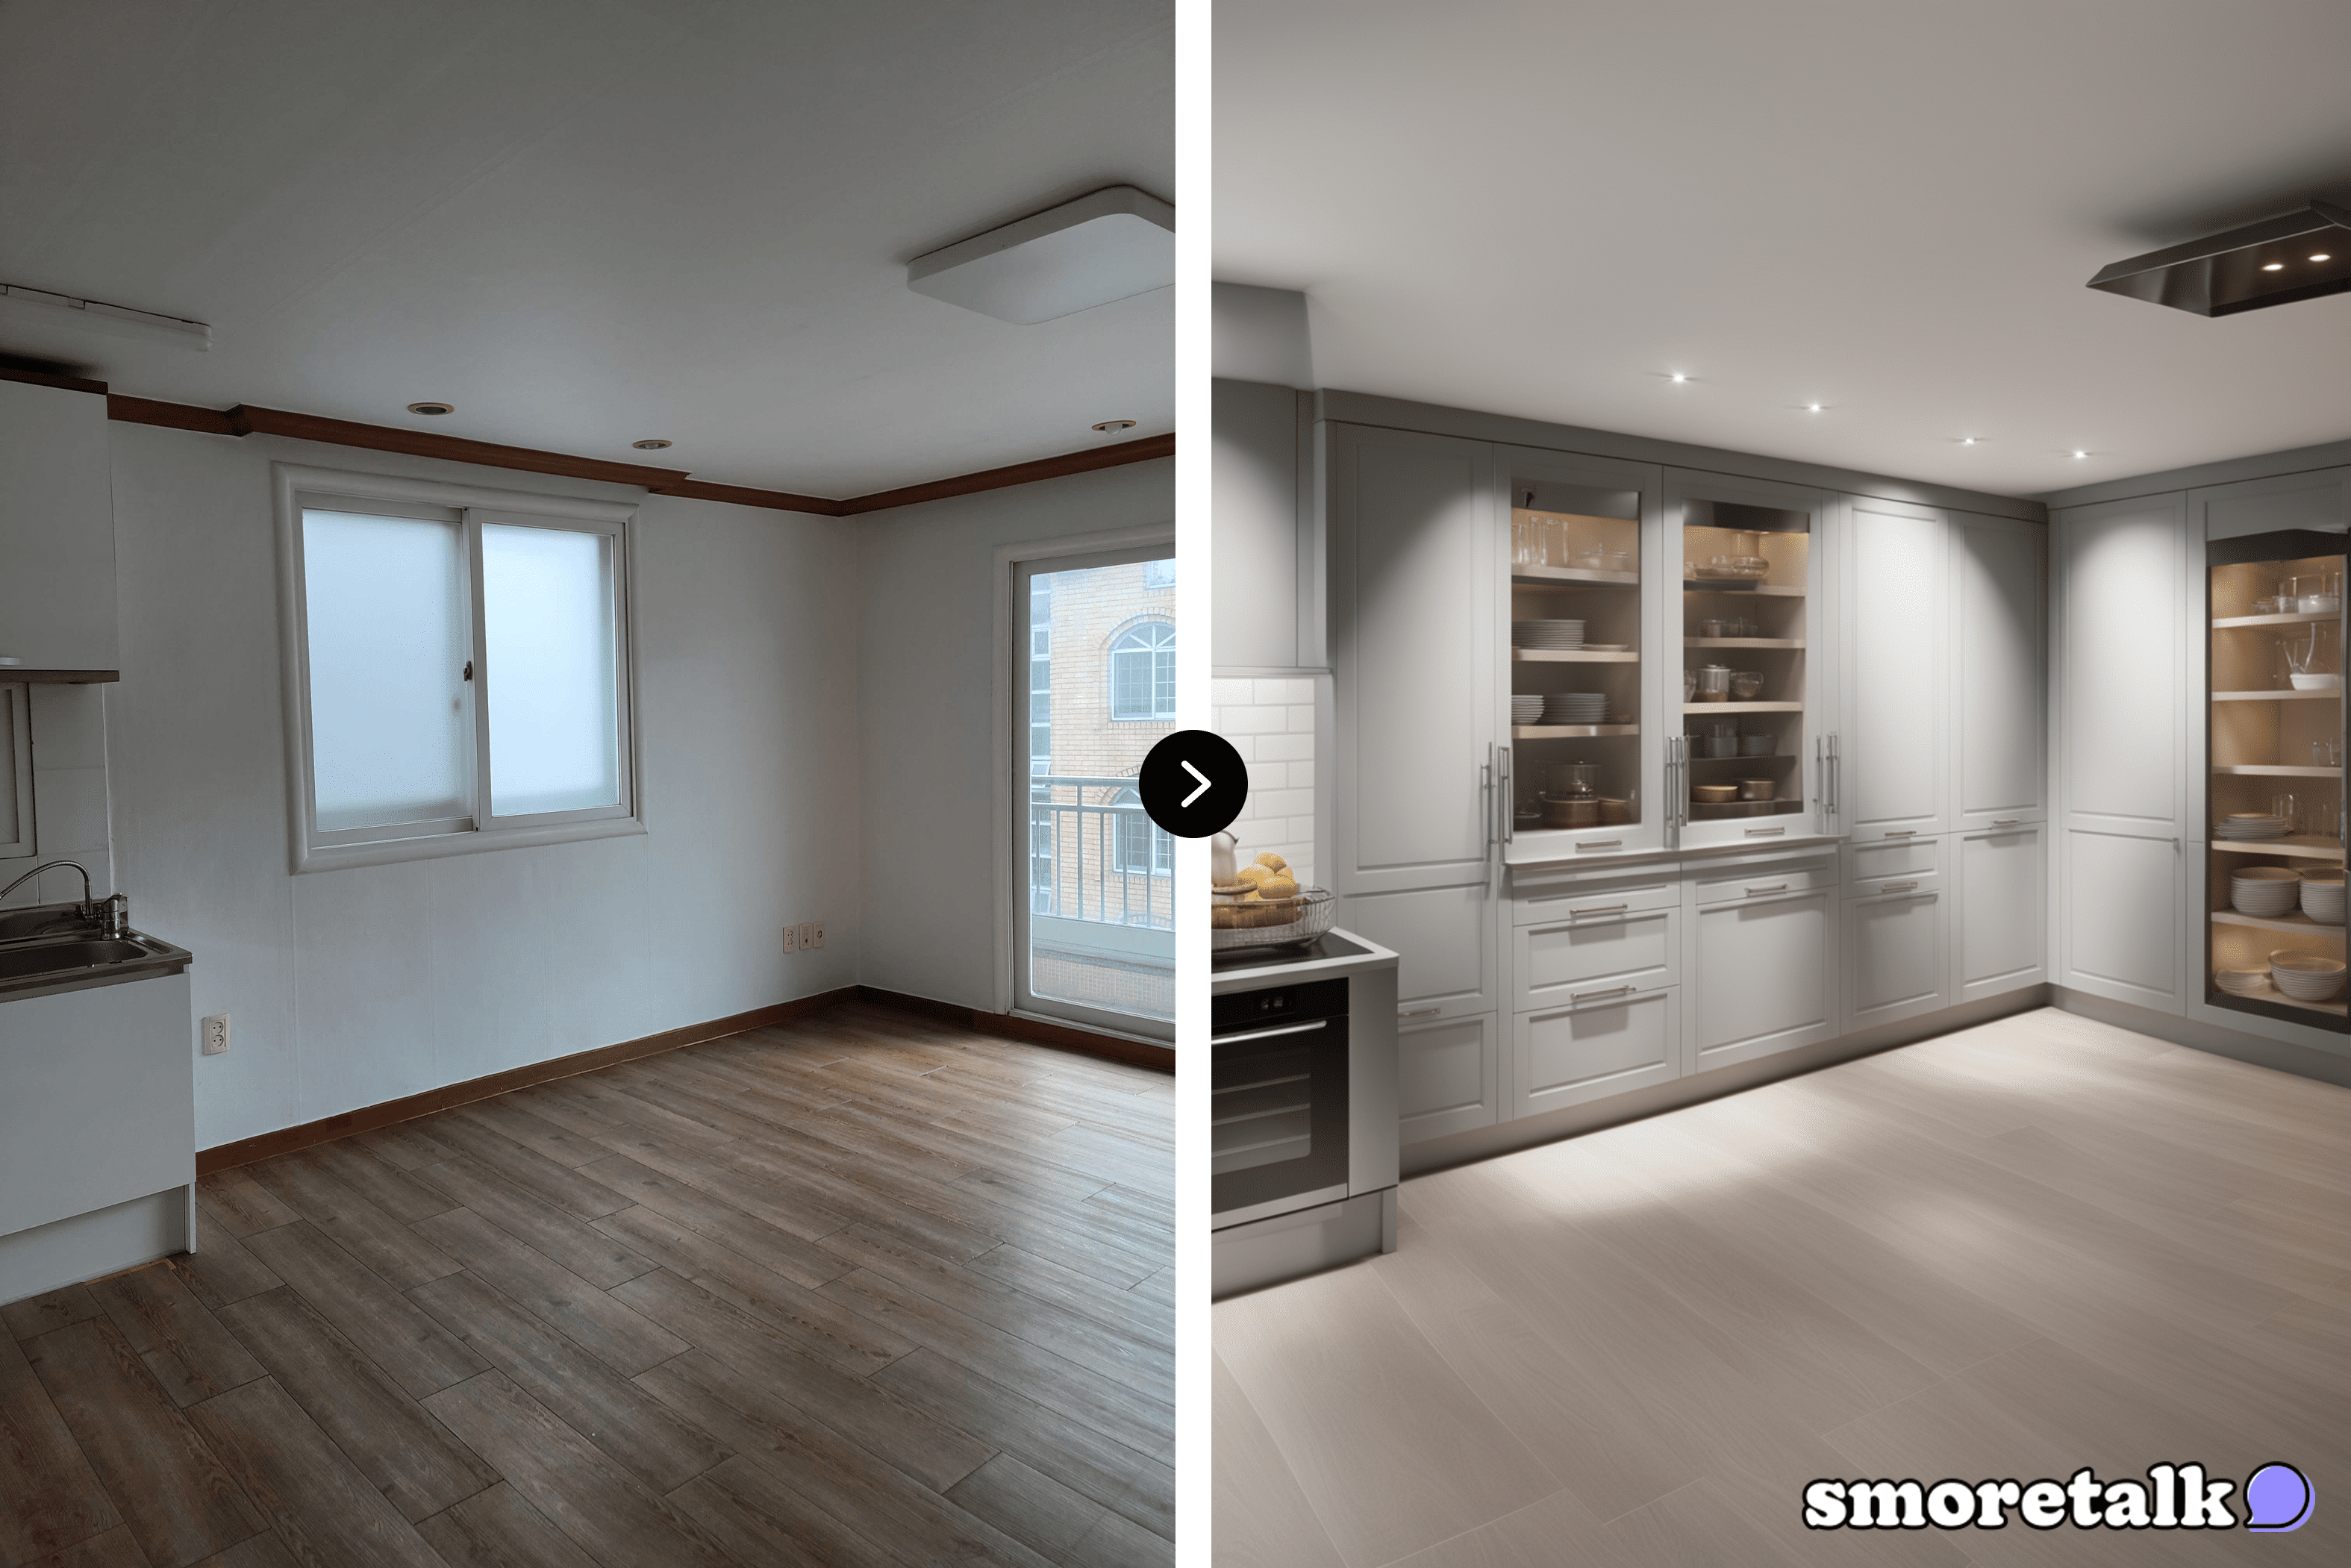
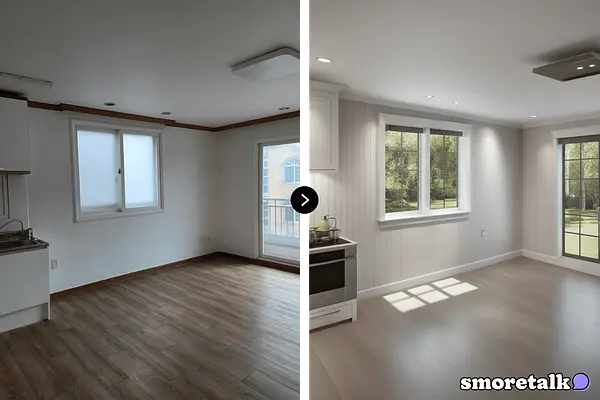
[Tip] MZ 세대가 열광하는 인테리어, 10초 만에 하기 🏠

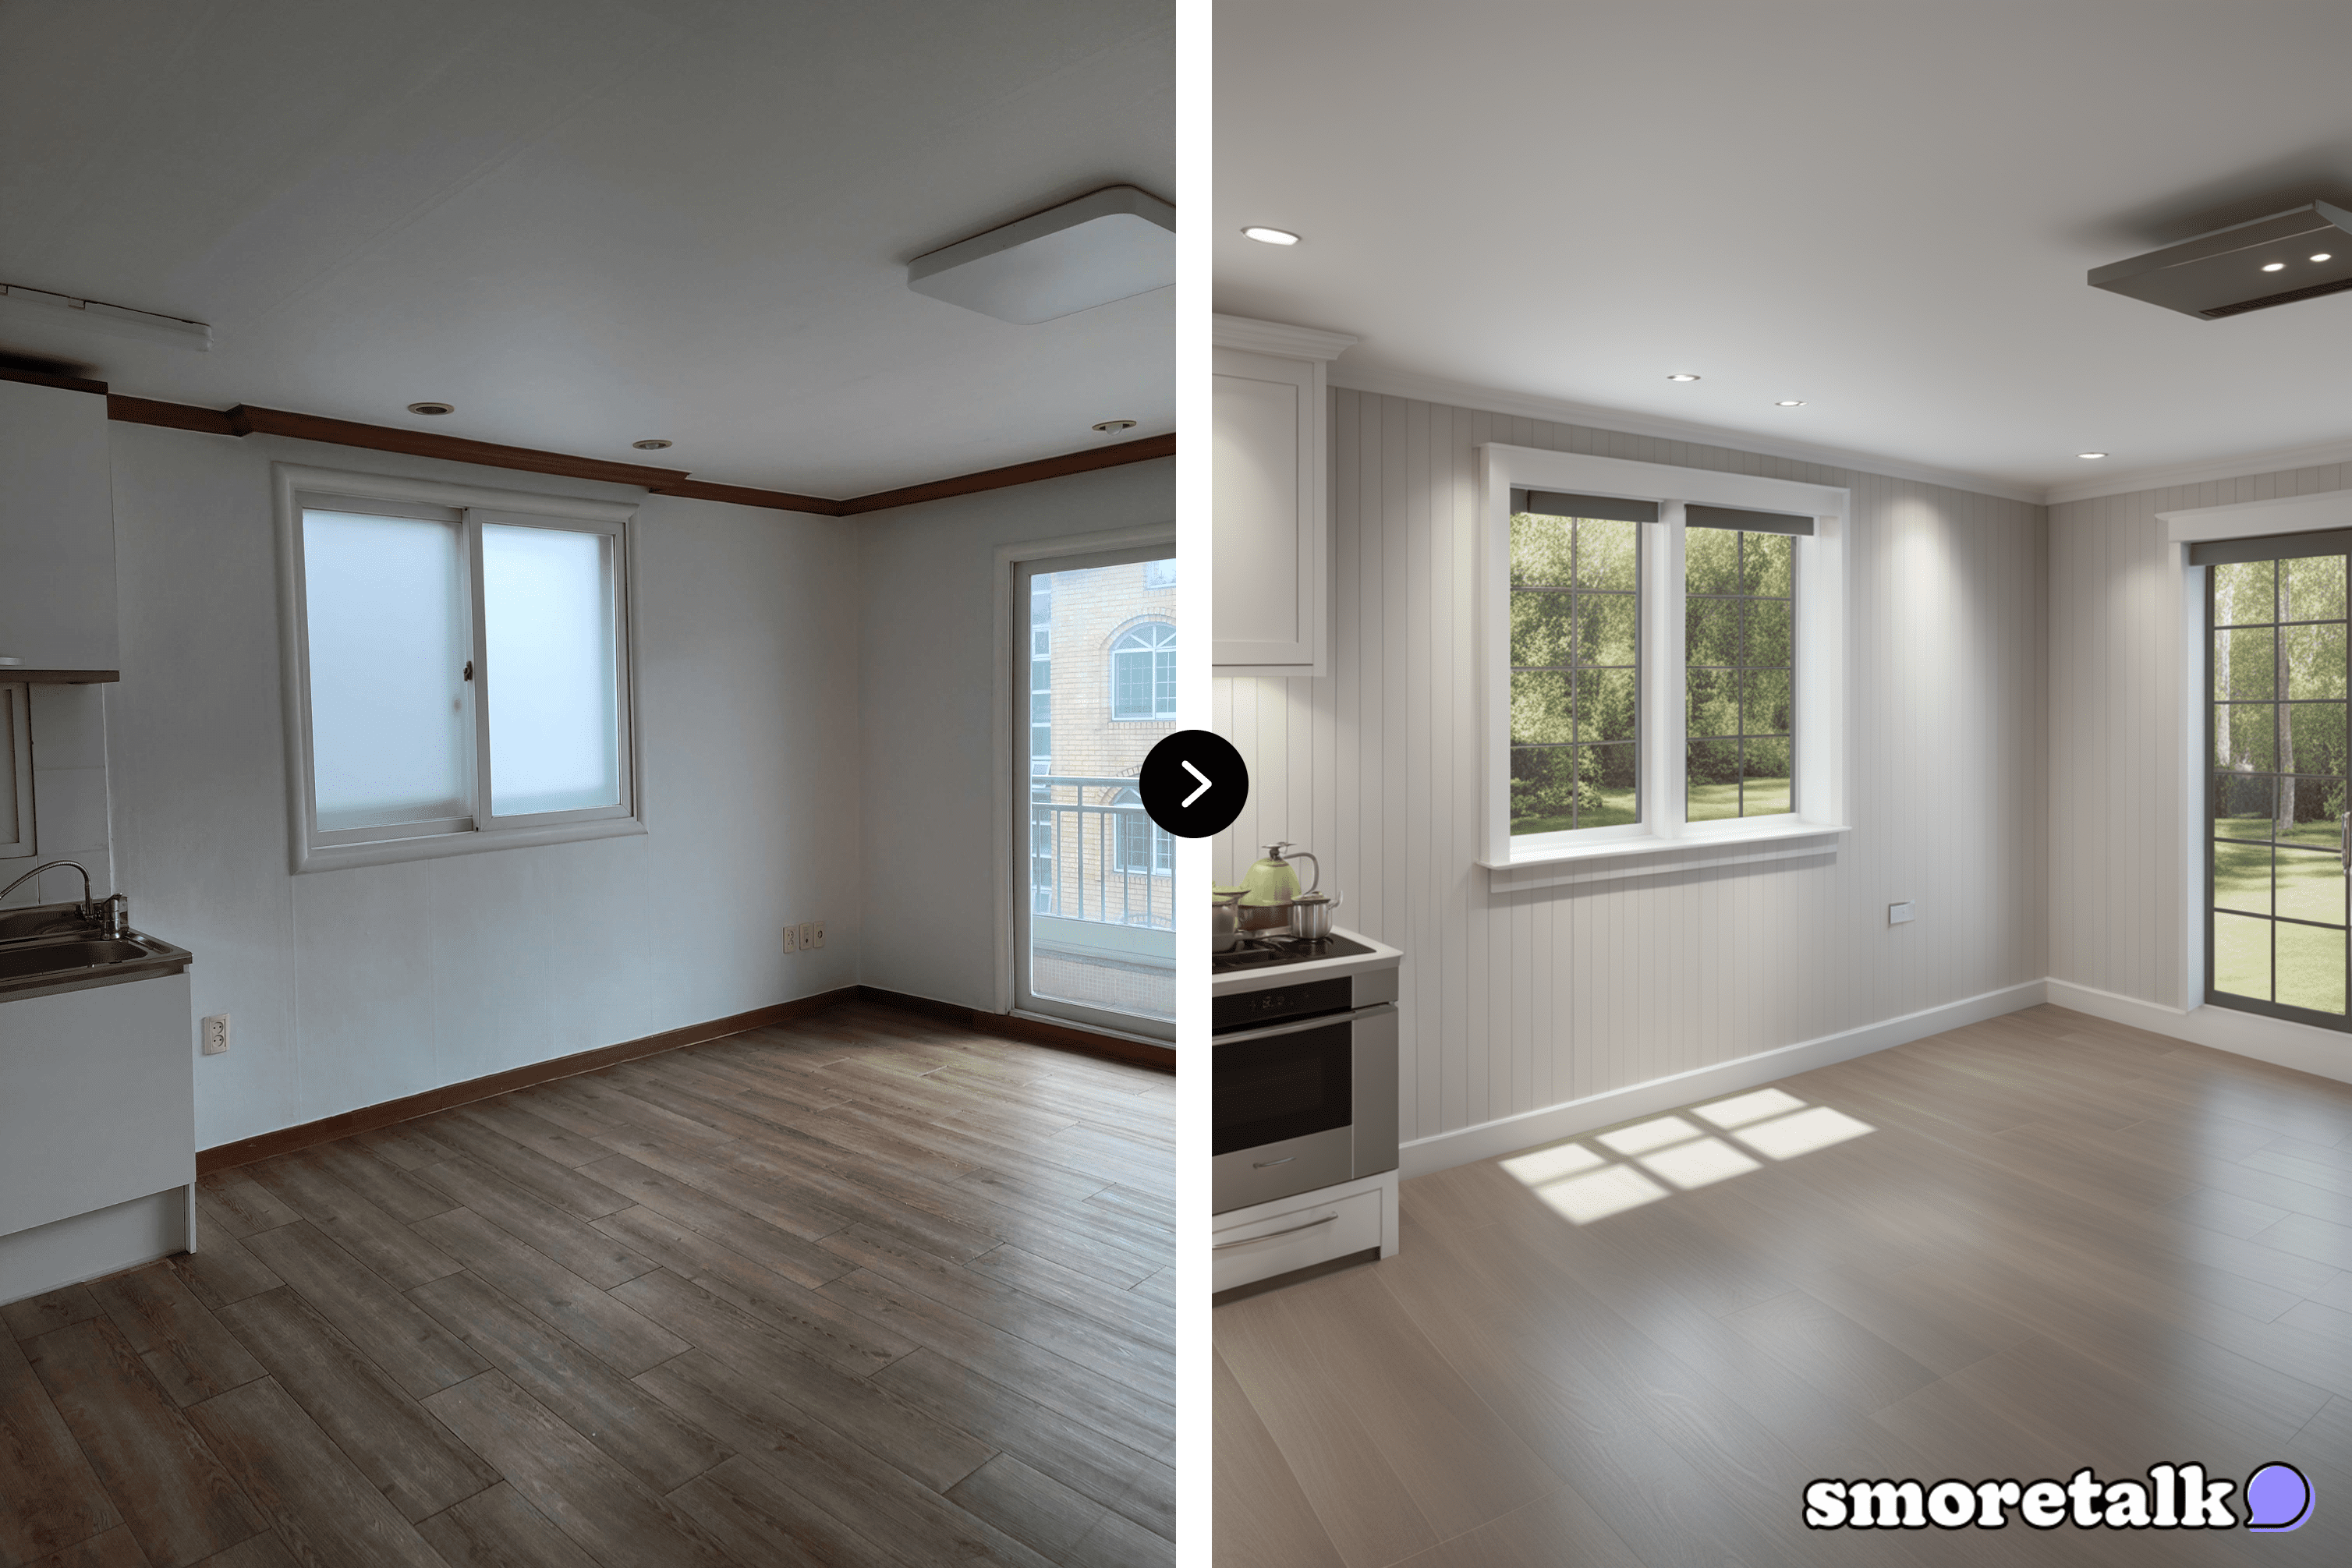
인테리어 디자인 변경 예시 (1).png출처: 우리집, 스모어톡 인테리어 변경 예시 결과물

🥲 휴 2주 만에 살아 돌아왔습니다... 이사 정말 힘드네요... (몸살도 났어요)

최근 들어서 가장 오래 글을 안 쓴 기간이었던 것 같습니다.

'왜 바빴는가' 라고 질문을 주신다면,

2주간 스모어톡은 이미지 어시스턴트, 플라멜 출시를 앞두고 최소한 대한민국에 파급력을 줄 수 있는 방식을 고민해 무언가를 준비하고 있었습니다. (여전히 잘 모르겠지만 일단 Go, 정말 커밍쑨...)

또한 도전! K-스타트업 2023 왕중왕전 준비(링크), Open Ko-llm Leaderboard 5위 등극(링크, 10/25 일자 1위) 등 오랜만에 저도 ML 엔지니어가 아닌 CSO(전략 담당) 로서 AI 최신 동향에 대해 다시 확인하는 시간을 가졌던 것 같습니다.

그리고 (제일 중요한) 마침 제가 직전 자취방 계약 만료로 이사를 했어야 했는데요.

와... 이사 정말 힘들더라고요...

그런데 또 막상 텅 빈 집을 보고 계약 후 여기를 무엇으로 채워야 할까를 고민하게 되었습니다.

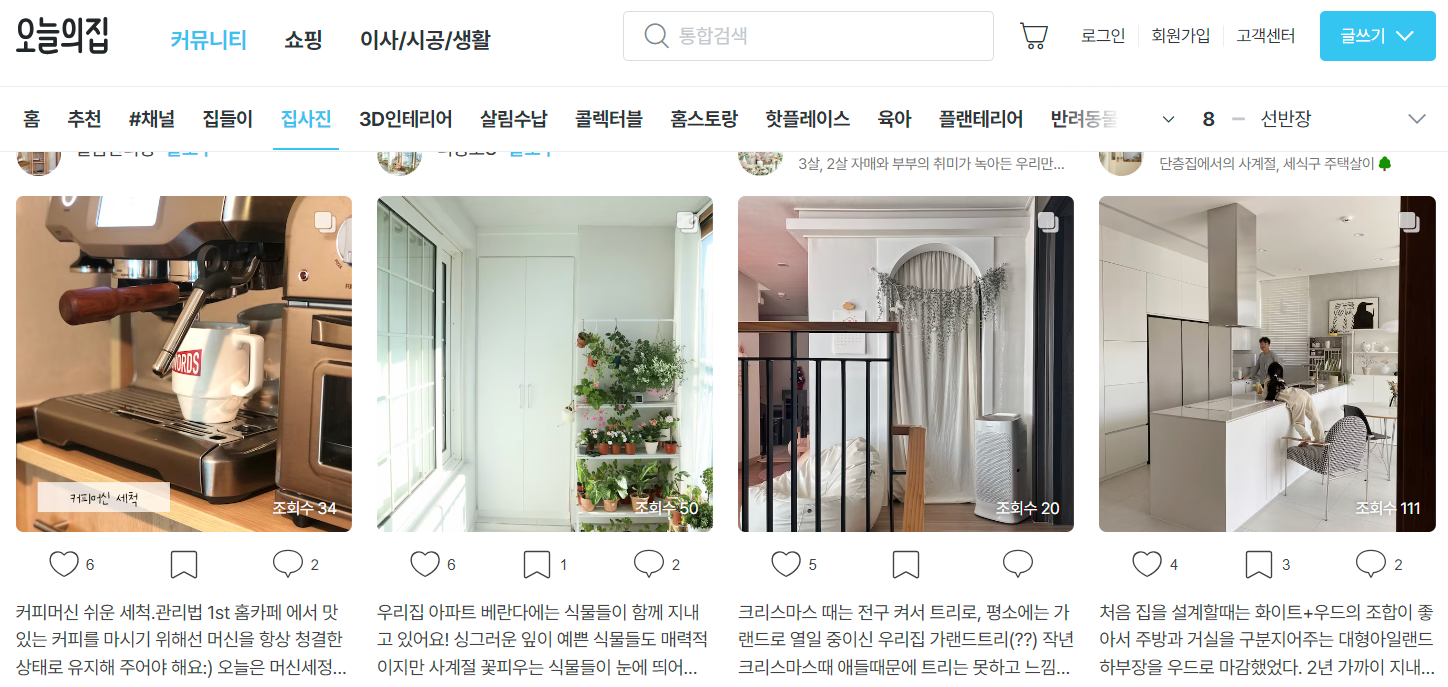
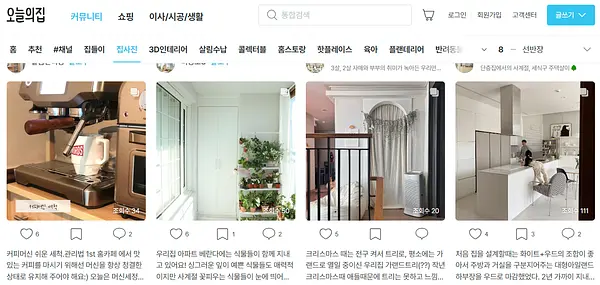
image.png출처: 오늘의집 커뮤니티

사실 저와 같이 2·30 대로 대표되는 MZ세대 사이에서 '집 꾸미기'에 대한 관심이 높은 상황입니다. 광명 이케아에 찾아 갔을 때에도 정말 많은 청년들이 조립 가구를 둘러보고 있더라고요.

이유는 간단합니다.

어차피 월급으로는 집 마련하기 힘드니 인테리어라도 고급으로 해서 집을 꾸미자라는 것인데요.

대부분의 MZ세대(저 포함)는 자가가 아닌 전·월세를 들어 살고 있습니다. 그리고 '오늘의집' 의 주요 이용자는 25~34세, 현대리바트의 페이지뷰의 약 40%가 MZ세대인 것이 앞의 가설을 뒷받침하고 있다고 보여집니다.

그런데 인테리어는 공간 디자인의 특성에 따른 문제가 존재합니다.

  1. 각기 다른 공간에 맞추어야 합니다.

  2. 소유한(=제한된) 인테리어 자산을 기반으로 디자인 해야 합니다.

  3. 빠르게(!) 끝내야 합니다.

또한 당연하게도 디자인이기 때문에 시각적인 미학 또한 소비자의 구매를 이끌어내는 주요 요소이지만, 그만큼 많은 시안을 준비하기에는 여러 물리적인 어려움이 존재합니다.

인테리어 수요자 입장에서도 오프라인으로 직접 업체를 방문하여 견적을 내고, 2~3주를 소요해 시안을 제공받는 것은 당연히 불편했습니다. (중요! 물론 이 솔루션의 구매자는 인테리어 업체입니다)

그런데...

AI와 함께 10초 내로 4개 이상의 시안을 받아 볼 수 있게 되었습니다.

금방 시안을 만든다면, 고객을 설득하는 데 큰 효과가 있지 않을까요?

그래서 국내외에 해당 솔루션을 열심히 개발하는 기업이 존재합니다.

외국에서는,

한국에서는,

가 있습니다. (혹시 추가해야 할 기업은 알려주시면 수정하겠습니다)

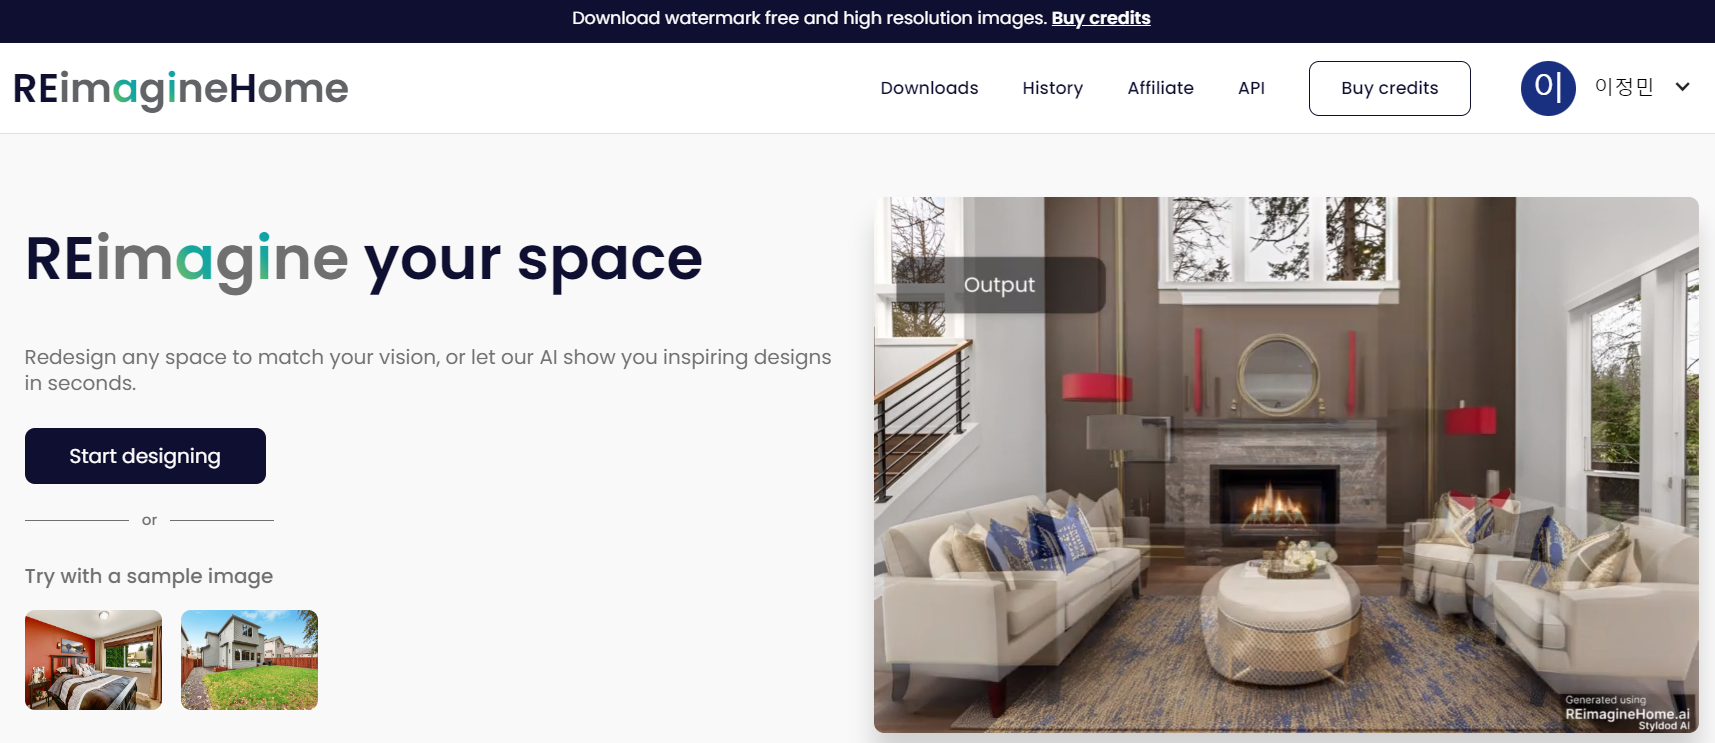
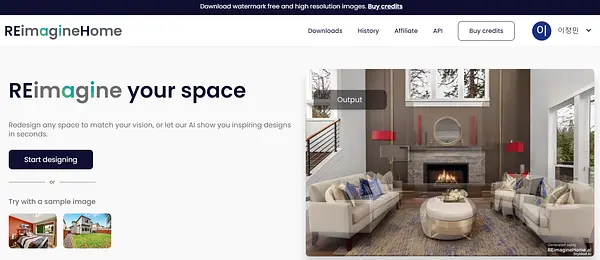
오늘은 그 중 REimagine Home 에 대해 살펴보고, 기능에 대해 실제 코드로 구현해보겠습니다.

(빨리 직접 코드로 만들어보고 싶은 분께서는 아래로 스크롤 해주세요)

image.png출처: REimagineHome 홈페이지 메인

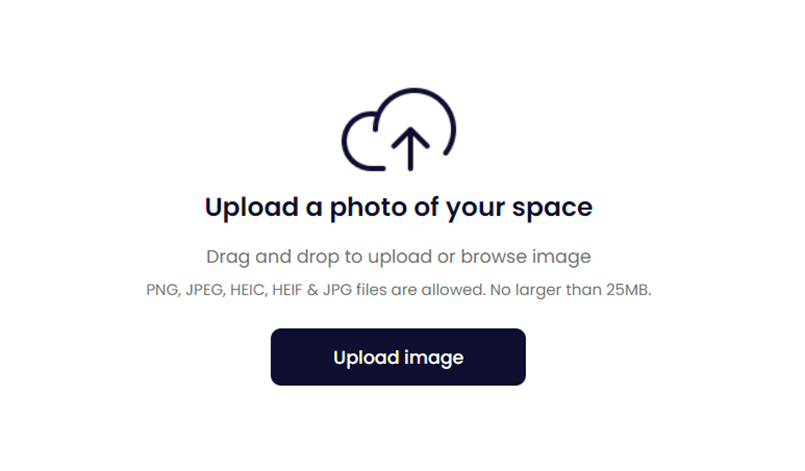
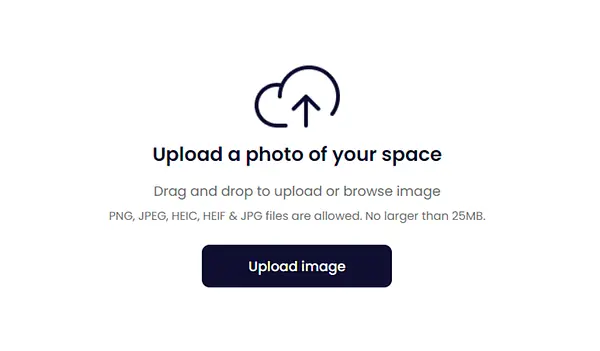
1. 사진 업로드

사진을 업로드 합니다.

image.png

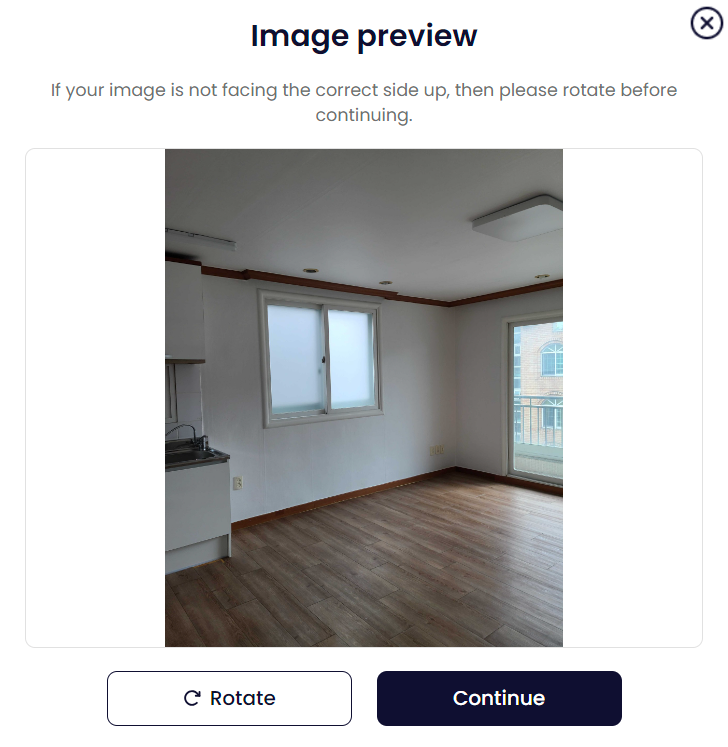
2. 업로드 한 사진 한 번 더 확인

잘못된 구도로 촬영할 시 일부 회전할 수 있도록 한 번 더 확인합니다.

image.png

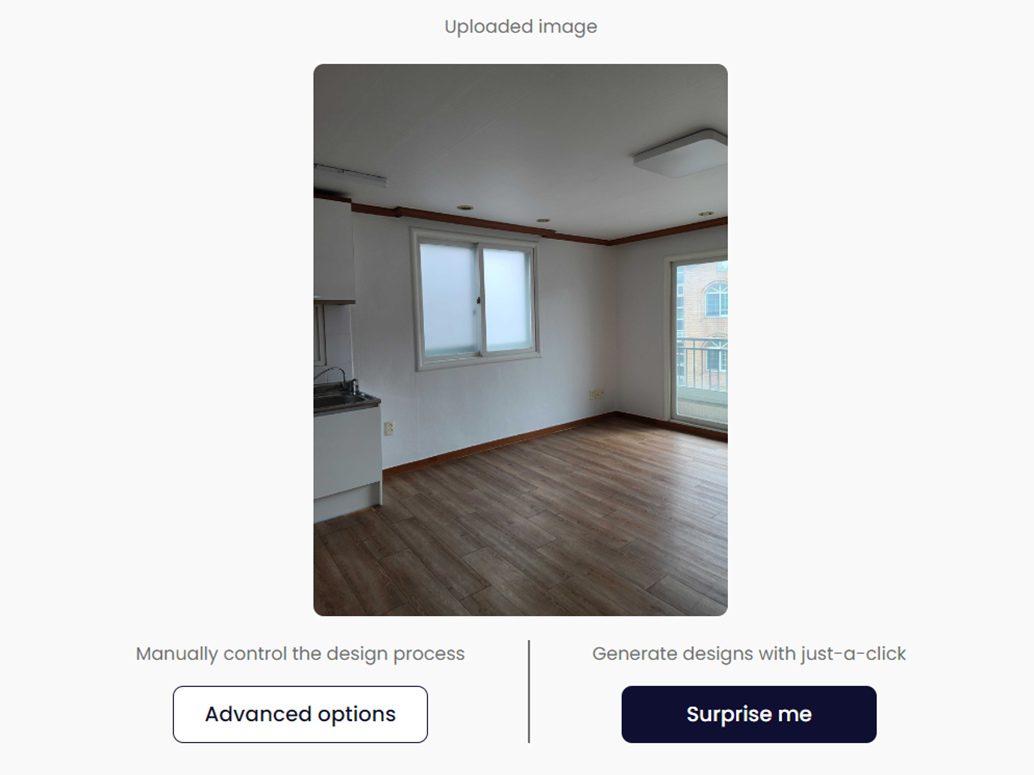
3. 생성 옵션 선택

간편하게 생성할 지 혹은 세부적인 조건을 조정하여 정확하게 생성할 지 선택하게 합니다.

image.png

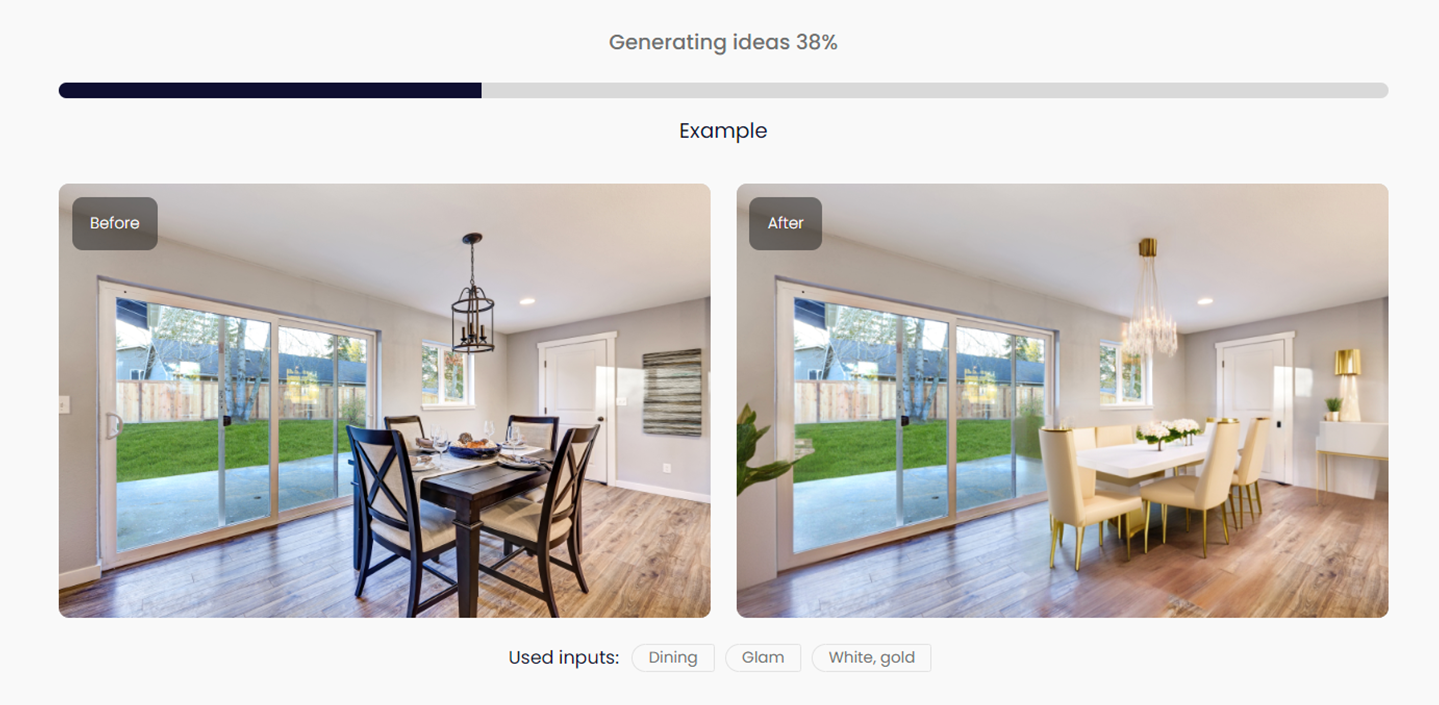
4. 설정 기다리기 (중요💡)

대기 하는 시간 동안 전후 화면을 비교시켜주고, 하단에 어떤 입력 값을 넣는 지 보여줌으로써 사용자의 관심을 유도합니다. 좋은 방식인 것 같더라고요.

image.png

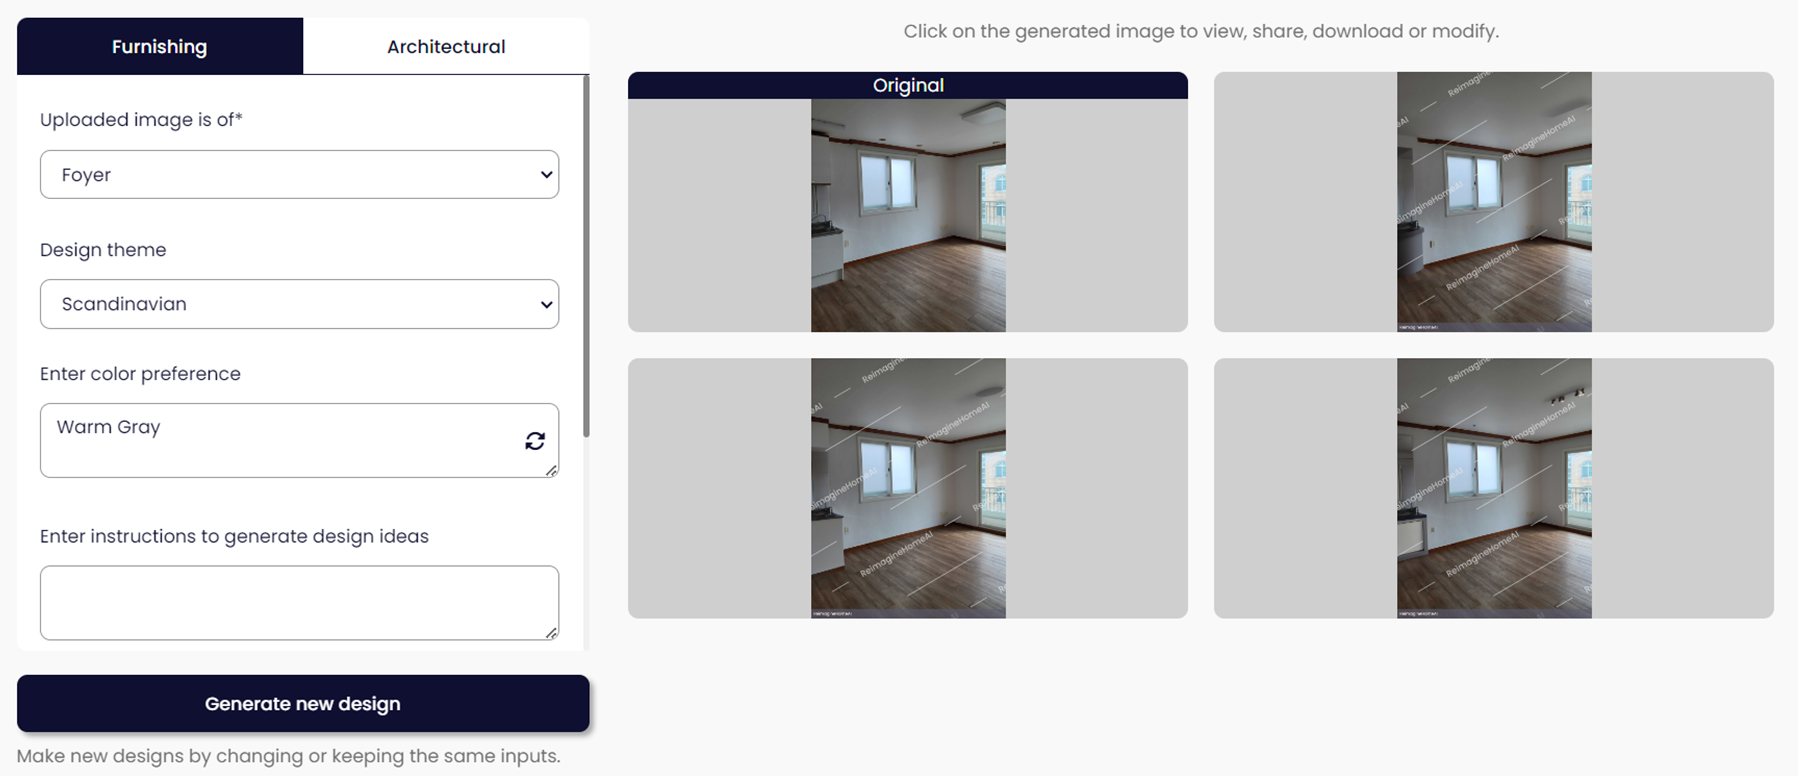
5. 생성하기

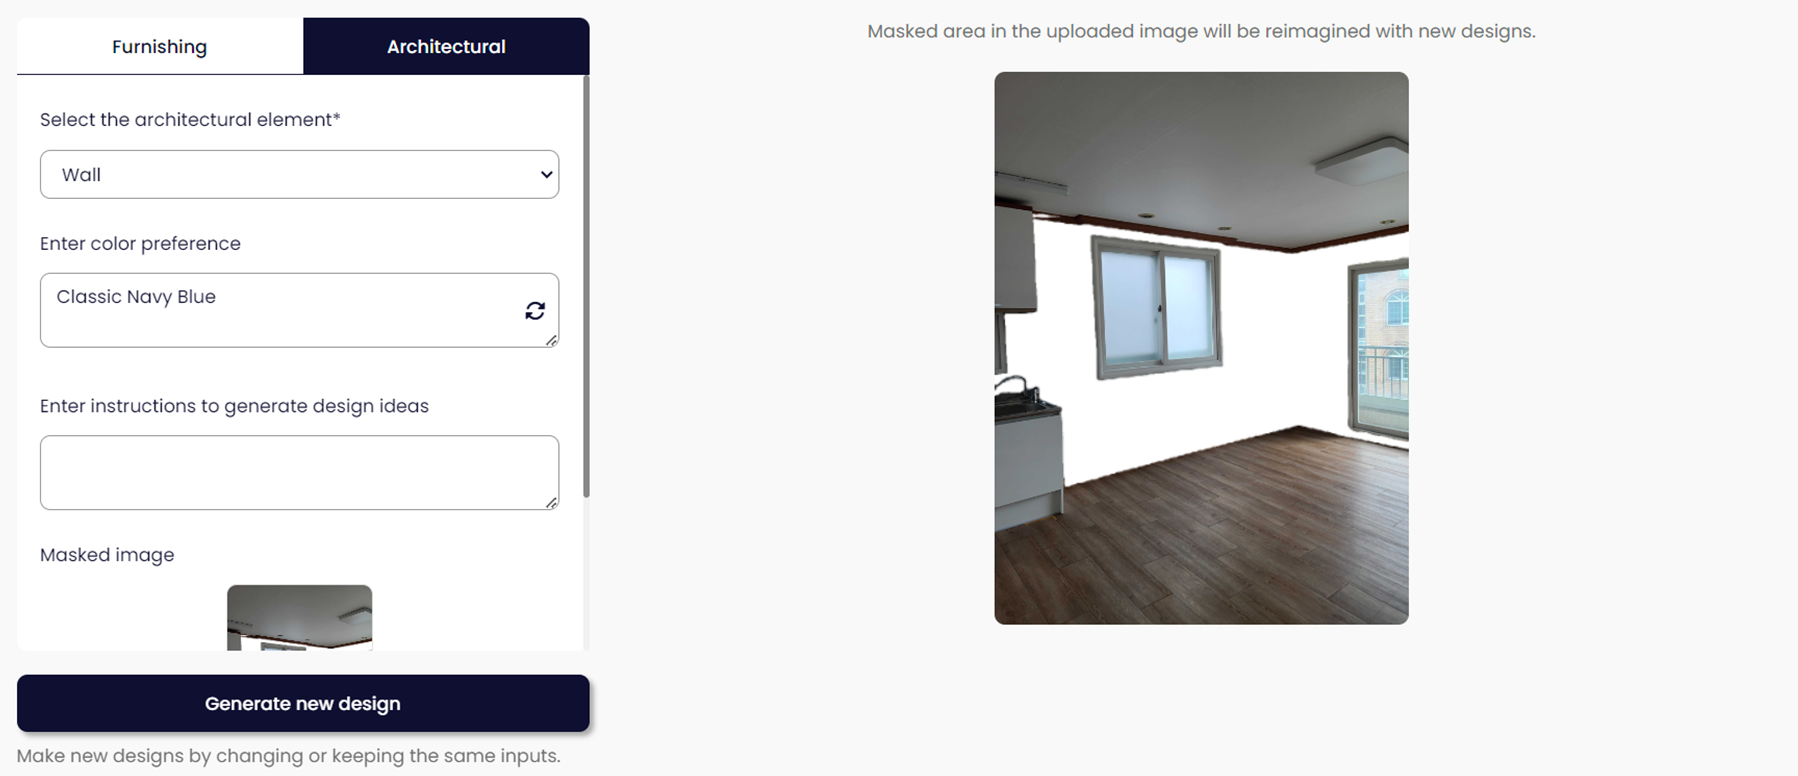
image.pngimage.png다음과 같이 두 가지 조건이 있습니다.

하나는 가구의 재배치를 의미하는 Furnishing, 다른 하나는 실내 구조의 일부를 변경하는 Architectural 입니다.

첫 번째, Furnishing 에서는 현재 이미지가 나타내는 장소가 구체적으로 어디인지(거실인지 부엌인지)에 대한 설명을 넣고, 인테리어 테마를 설정합니다. 다음으로 선호하는 색상 톤과 구체적인 지시 사항을 AI에게 안내합니다. (실제 인테리어 디자이너가 고객을 응대하는 과정과 유사하죠?)

두 번째, Architectural 에서는 현재 이미지의 천장, 벽, 바닥 중 변경을 원하는 것을 선택하여 자동으로 마스킹을 만들고, 선호하는 색상 톤과 구체적인 지시 사항을 AI에게 안내합니다.

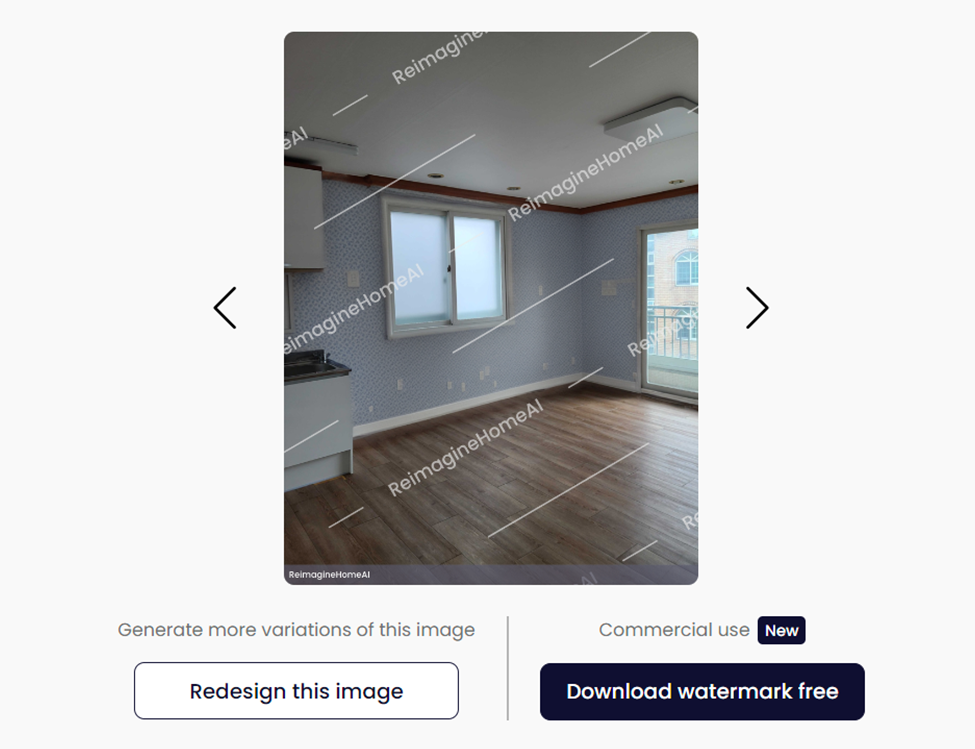
image.png저의 경우 두 번째 옵션인 Architectural 에서 벽과 네이비 블루를 선택하여 생성한 결과는 다음과 같습니다.

생성을 다하니, 사이트에서는 이제 수고했으니 워터마크를 지우려면 돈을 내지 않겠나...? 라고 말을 합니다.

(저는 제가 만들기 때문에 돈을 안냅...)

과정이 꽤나 간단하지만, UX를 최적화 시켰다는 점이 주목할 만한 것 같습니다.

특히, 구역 별로 오토 마스킹을 해야 한다는 기술적인 설정을 둔 것도 재밌는 포인트라고 생각되었습니다.

실제 인테리어라는 것이 맨 처음 이사할 때를 제외하고는 일부만 변경하기 때문에 이러한 포인트에서 시장 조사가 잘 되었다고 판단했습니다.

그렇다면 직접 만들어 볼 수는 없을까요? 🤔(당연히 핵심이죠?)

이전에 안내해드린 서비스 내 Furnishing 을 구현해볼 예정이며 간단히 설명을 드리겠습니다.

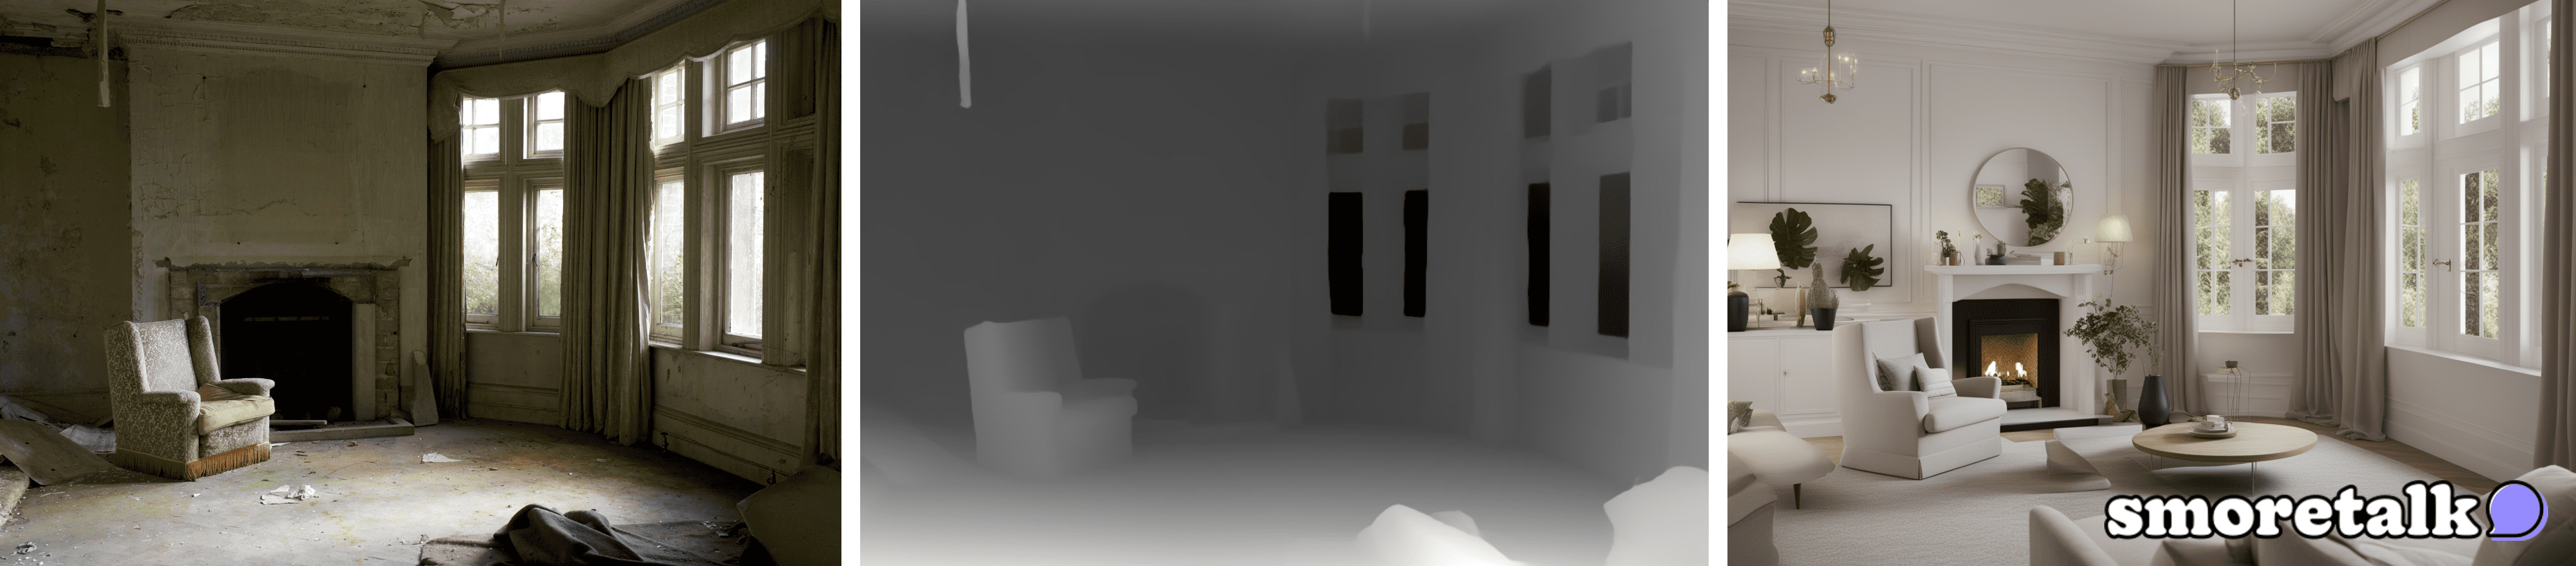
해당 방법은 Embodied AI Foundation 에서 공개한 MiDaS (이미지 내 깊이 측정 모델) 과 Stable Diffusion 의 ControlNet (사전에 주어진 입력값을 통해 생성할 이미지의 형태를 고정) 기능을 활용합니다.

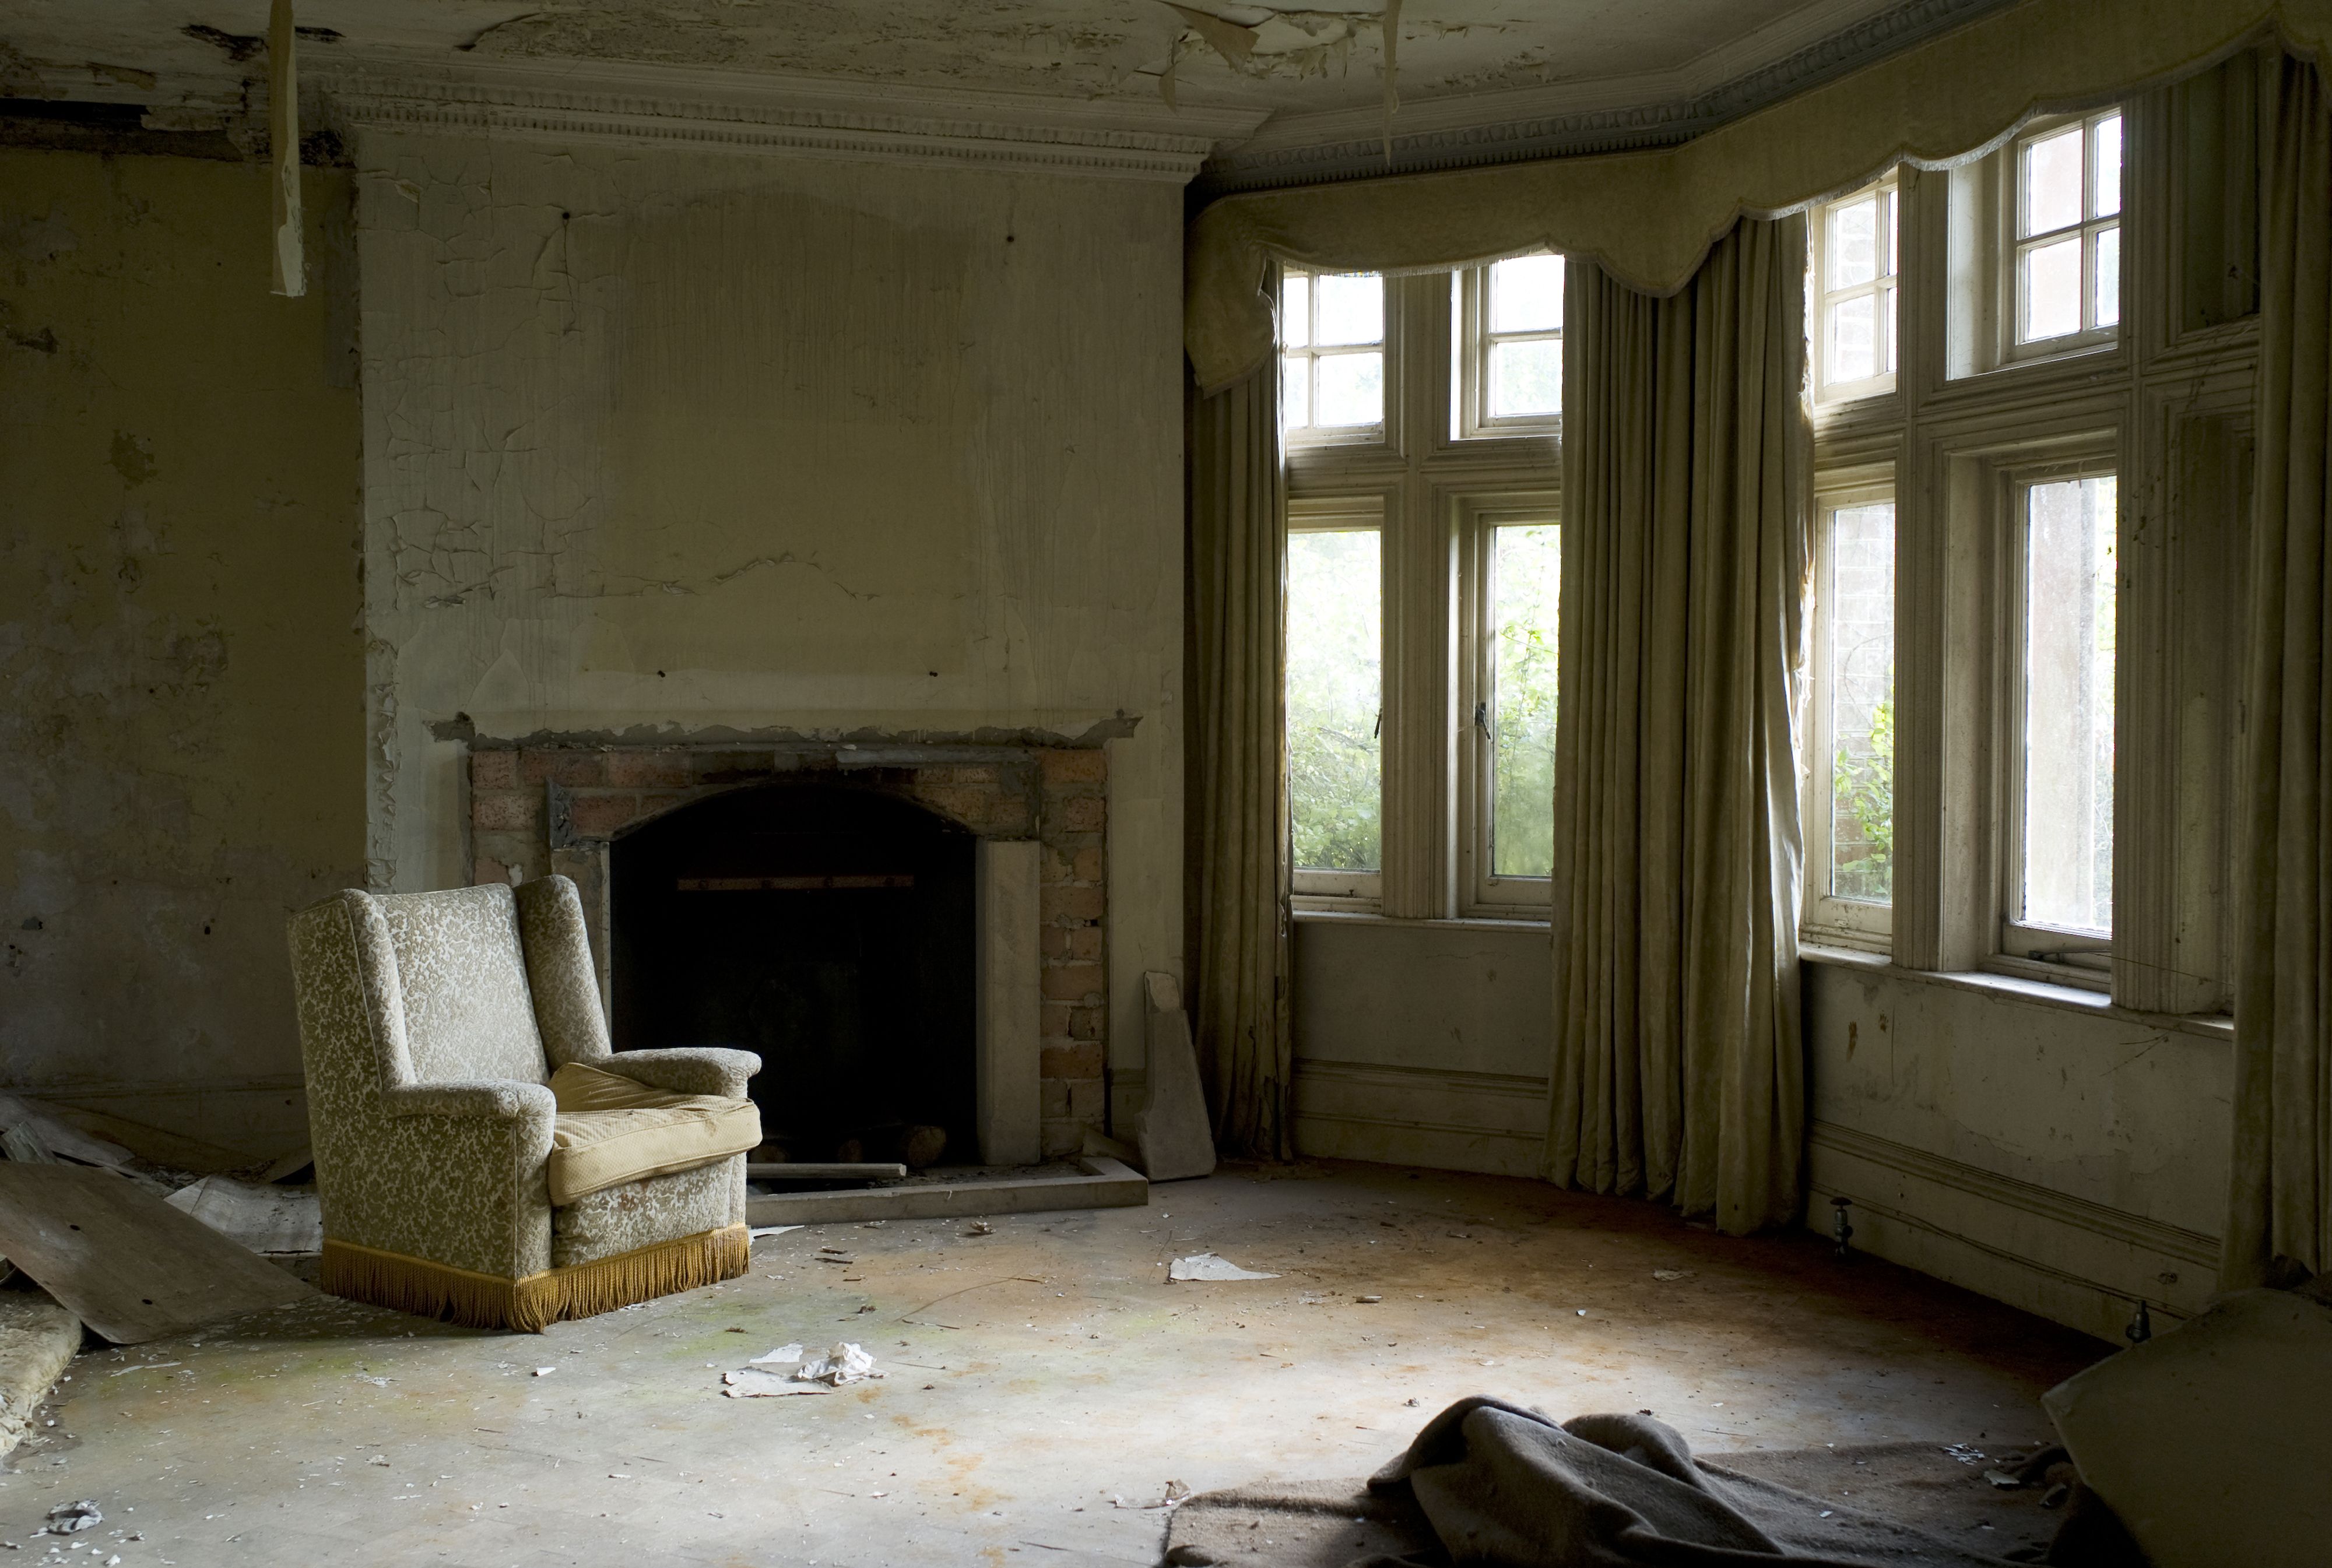
  1. 실내 사진 이미지를 준비합니다.

    • 아무거나 인테리어 디자인을 원하는 실내를 찍은 이미지 한 장을 준비합니다.

1452703299-gettyimages-464401381.jpg

  1. 구글 코랩 (GPU) 을 엽니다.

    • MiDaS 과 Stable Diffusion 을 사용하기 위해선 GPU 가 필요합니다.

    • 코랩은 클라우드 기반 Jupyter Notebook 환경입니다. 무료로도 사용 가능합니다. (다만 유료로 사용 가능한 V100 이상 부터 사용이 원활합니다)

    • 다음 코드를 입력해주세요.

  1. 라이브러리 세팅을 합니다.

라이브러리 설치

# Install libraries

!pip install -q git+https://github.com/huggingface/diffusers.git -U
!pip install controlnet_aux==0.0.7 # for conditioning models and detectors
!pip install -q transformers accelerate -U

# For xformers with correct torch version due to colab update (for memory efficiency)
!pip install -q torch==2.0.0+cu118 torchvision==0.15.1+cu118 torchaudio==2.0.1+cu118 torchtext==0.15.1 torchdata==0.6.0 --extra-index-url https://download.pytorch.org/whl/cu118 -U
!pip install -q xformers==0.0.19 triton==2.0.0 -U

라이브러리 추가

# Set the Generator and the MiDaS Detector

import torch
import numpy as np
from PIL import Image
from controlnet_aux import MidasDetector
from diffusers import AutoencoderKL, DDIMScheduler, StableDiffusionXLAdapterPipeline, T2IAdapter, DiffusionPipeline
from diffusers.utils import load_image, make_image_grid

  1. AI 모델을 GPU 에 설정합니다.

여기에서 중요한 부분은 본 코드에서는 이미지 내 디테일한 표현을 강화하는 LoRA 가중치를 추가해주었기 때문에, 사용자 입력값인 prompt 앞에 'detail_' 을 추가해주어야 합니다.

# load adapter
adapter = T2IAdapter.from_pretrained(
    "TencentARC/t2i-adapter-depth-midas-sdxl-1.0", torch_dtype=torch.float16, variant="fp16"
).to("cuda")

# load scheduler
model_id = "stabilityai/stable-diffusion-xl-base-1.0" # Base model

ddim = DDIMScheduler(
    num_train_timesteps=1000,
    beta_start=0.00085,
    beta_end=0.012,
    beta_schedule="scaled_linear",
    clip_sample=False,
    set_alpha_to_one=False,
    steps_offset=1,
)

# load vae
vae = AutoencoderKL.from_pretrained(
    "madebyollin/sdxl-vae-fp16-fix", torch_dtype=torch.float16
)

# load base for sdxl
pipe = StableDiffusionXLAdapterPipeline.from_pretrained(
    model_id,
    vae=vae,
    adapter=adapter,
    scheduler=ddim,
    torch_dtype=torch.float16,
    variant="fp16",
    use_safetensors=True
).to("cuda")

# save memory and improve inference speed
pipe.enable_xformers_memory_efficient_attention()

# set lora for detailed image
pipe.load_lora_weights("jyoung105/detail-tweaker-XL-lora", weight_name="add-detail-xl.safetensors", adapter_name="detail")
#pipe.set_adapters("detail")

# load MidaS detector
midas_detector = MidasDetector.from_pretrained("lllyasviel/Annotators").to("cuda")

# load refiner for sdxl
refiner_id = "stabilityai/stable-diffusion-xl-refiner-1.0"
refiner = DiffusionPipeline.from_pretrained(
    refiner_id, vae=vae, torch_dtype=torch.float16, variant="fp16", use_safetensors=True)
refiner.to("cuda")

# save memory and improve inference speed
refiner.enable_xformers_memory_efficient_attention()

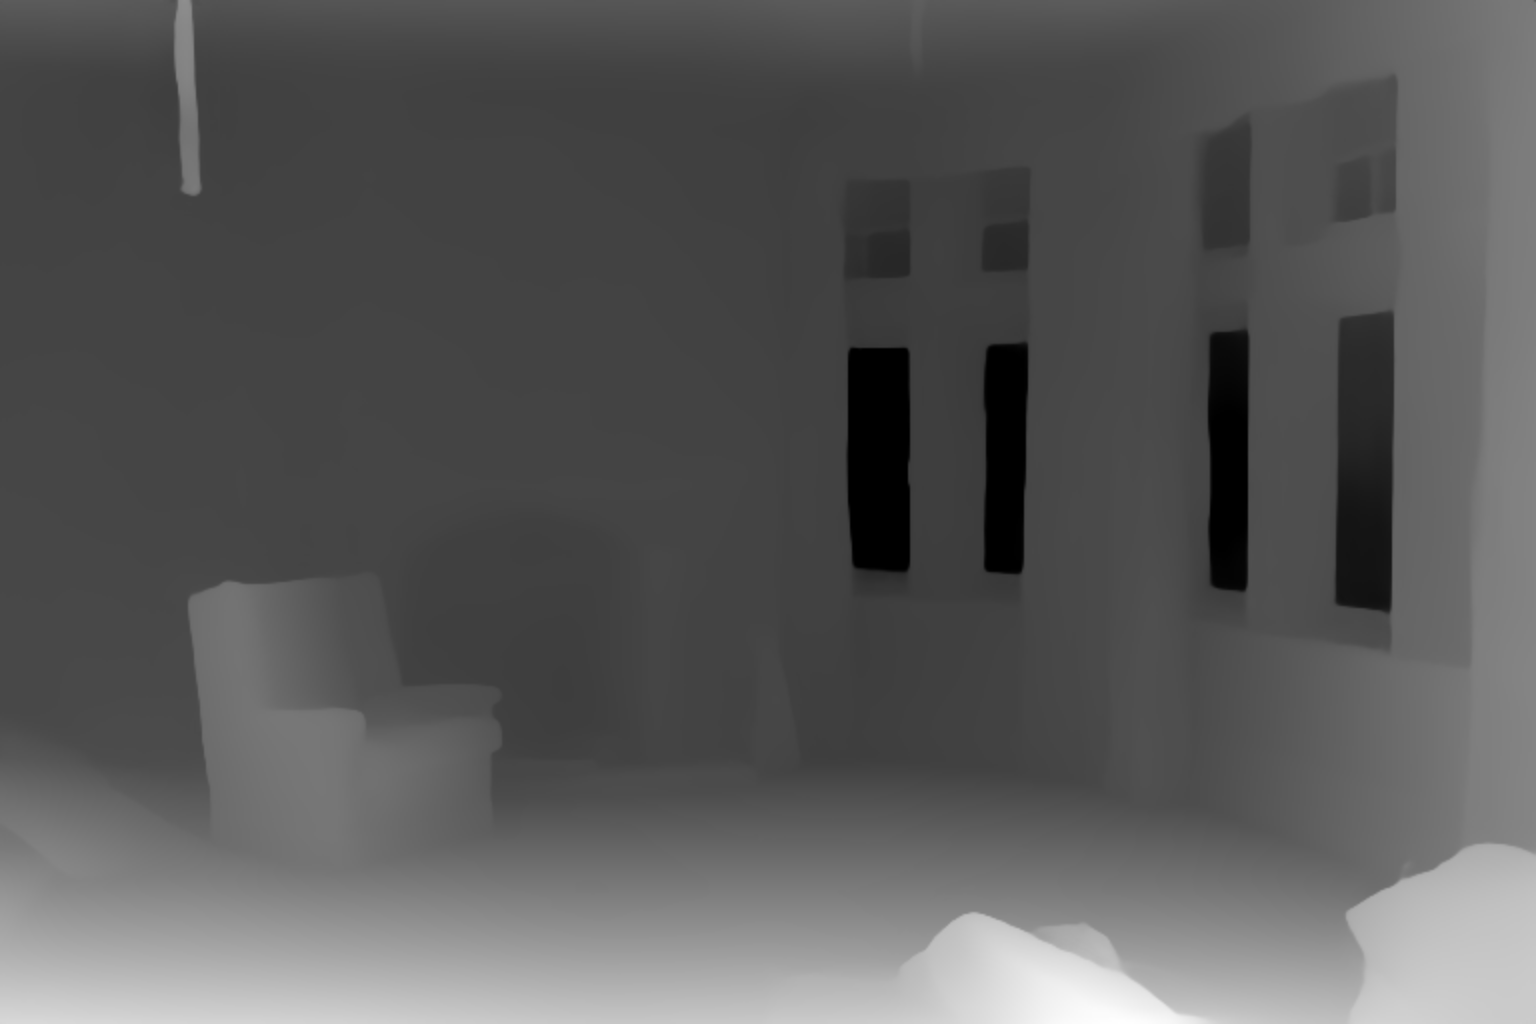
  1. 원래 이미지에서 MiDaS를 통해 Depth 이미지를 추출합니다.

image = load_image(url) #IMPORTANT! url is from your image
midas_image = midas_detector(image, detect_resolution=512, image_resolution=1024)
midas_image = np.array(midas_image)[:, :, ::-1]
midas_image = Image.fromarray(np.uint8(midas_image))

다운로드 (4).png

  1. 프롬프트 등 원하는 스타일의 이미지를 텍스트 형태로 입력합니다.

prompt = "detail_photo of a room with sofa, 4k, f1.5, highly detailed, high defintion"
negative_prompt = "wrong, anime, cartoon, graphic, text, painting, crayon, graphite, abstract, glitch, deformed, mutated, ugly, disfigured"
seed = 1234567890
generator = torch.Generator(device="cuda").manual_seed(seed)

latents = pipe(prompt=prompt,
               negative_prompt=negative_prompt,
               image=midas_image,
               num_inference_steps=40,
               adapter_conditioning_scale=0.9,
               adapter_conditioning_factor=1.1,
               guidance_scale=8,
               generator=generator,
               output_type="latent",
               cross_attention_kwargs={"scale": 1.5}
               ).images

images = refiner(
    prompt=prompt,
    negative_prompt=negative_prompt,
    guidance_scale=7.5,
    image=latents,
    generator=generator,).images

image = images[0]
image.save("/content/interior.png")

의 과정을 거치면 나오는 이미지들은 다음과 같습니다,

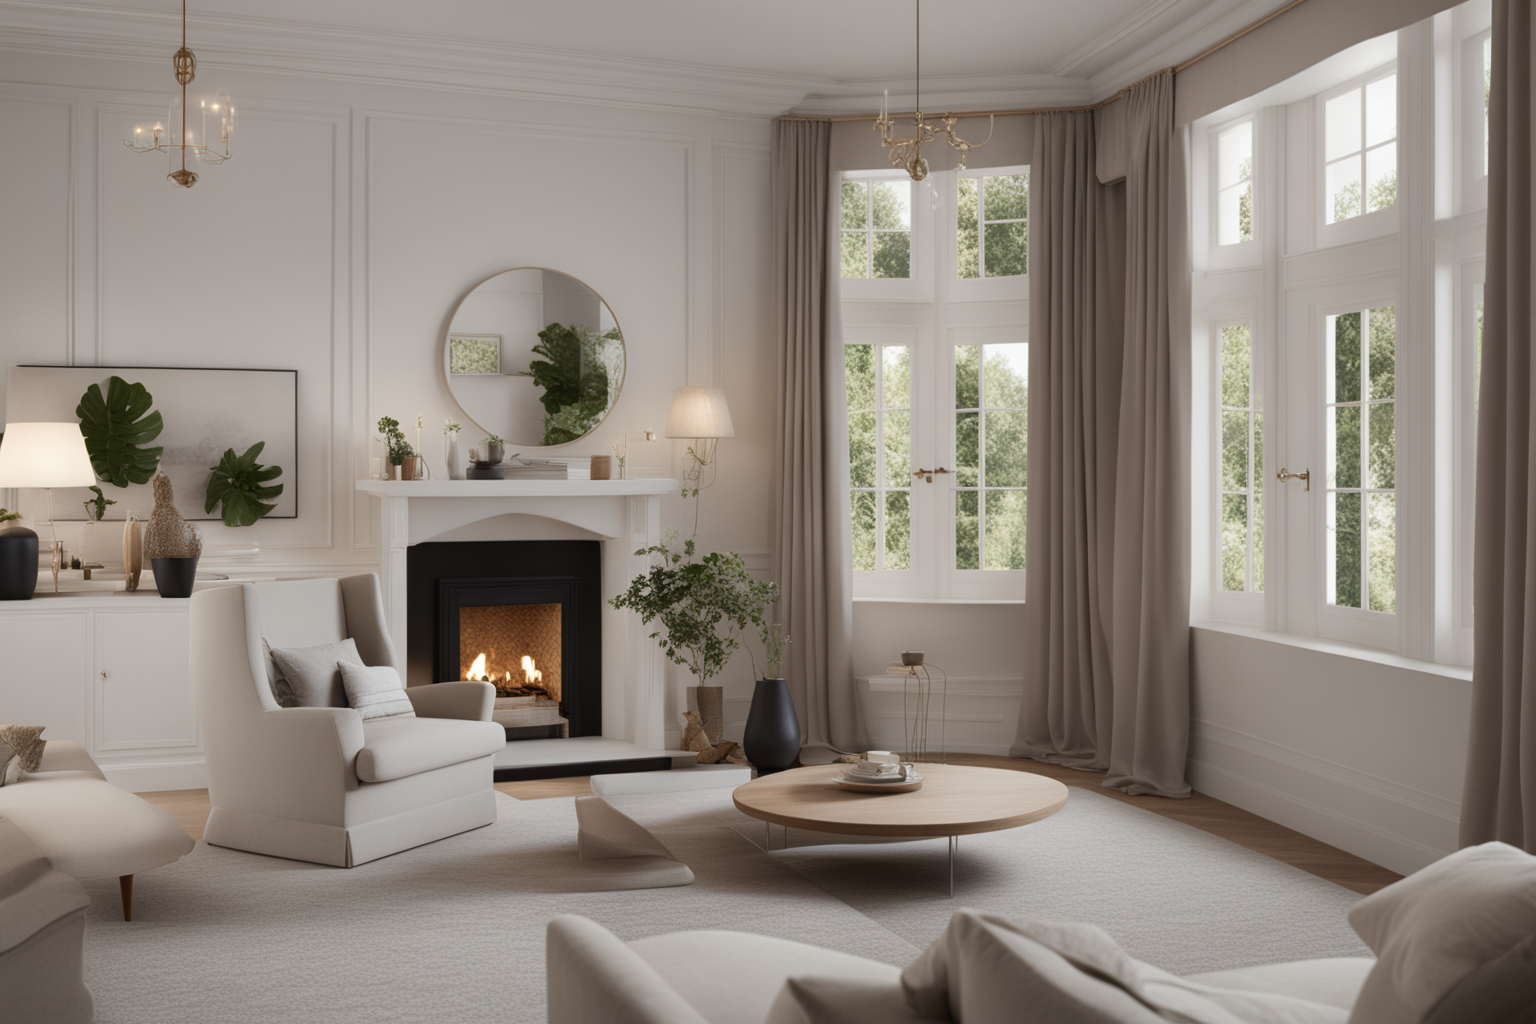
짜잔 🌟

다운로드 (2).png다행히 이번에는 개발하는 데 그렇게 오랜 시간이 걸리지는 않더라고요.

다만 아쉬운 점은 다음과 같습니다.

  • 아래 이미지에서 확인할 수 있듯이, 무엇이 무엇인지를 정확히 확인하지는 못한다. 이 때 필요한 것이 semantic segmentation (구역에 대한 의미를 부여하며 영역 분할).

인테리어 디자인 변경 예시.png정확한 촬영 장면 반영을 위해서는 추가 ControlNet 이 필요할 수도 있다.

  • 기업에서 사용하길 원하신다면, 본인만의 자산으로 사용 가능해야 하는데 생성 이미지는 무작위적으로 나온다. 이 때 필요한 것이 LoRA (파인튜닝) 또는 IP Adapter (해당 기술 관련 글)

*참고로 단순히 파인 튜닝을 한다고 결과물이 잘 나오는 것은 아닙니다. 상용화 수준을 원하신다면 기술력이 필요합니다.

같이 고민해보고 싶은 분들 또는 서비스하고 싶은데 AI 모델 관련 협업이 필요하시면 연락주세요!

인테리어 디자인 변경 예시 2.png오랜만에 이사를 하면서 관련해 실제 현장에서 AI를 사용해볼 수 있는 지점을 모색해 볼 수 있었습니다. 실제 현장에 이미지 생성 모델을 확산시키고자 하는 비전은 계속되며 다음 번에도 재밌는 아이디어로 찾아뵙겠습니다 :)


이정민 (스모어톡, tonylee@smoretalk.io)

플라멜 Flamel v0.1

프롬프트 엔지니어링이 필요 없는 가장 쉬운 검색형 이미지 생성 서비스

18
7
이정민

이정민

[Tip] 생각보다 트랙션 나오는 슬랙 이모지 사이트 👨‍💻

샘 알트먼 이모지 버전.png슬랙 이모지 만들기 AI와 함께 라면 어렵지 않아요 👋

여러분 다들 슬랙 사용하시나요?

슬랙(Slack)은 글로벌 1위 기업용 메신저로 22년도 기준 100대 기업 중 77 곳이 슬랙을 사용하고 있습니다.
사실 슬랙의 첫 시작은 게임(tiny spec)이었는데, 나중에 메신저로 피벗해서 큰 성공을 거두었습니다.

엔터테인먼트 기업으로 시작한 슬랙에 "일하는데 꼭 진지해야 되나?"라는 의구심에서 탄생한 슬랙 메신저의 정체성을 이루는 요소가 있습니다.

바로 이모지(Emoji) 입니다.

저희 회사 뿐만 아니라 다양한 스타트업, AI 커뮤니티의 슬랙을 보면 이모지를 정말 잘 사용하고 있는데요.

소통을 캐주얼하게 해준다는 점에서 큰 효과를 주는 것 같습니다.

그런데 남들 모두가 사용하는 이모지, 스타트업은 그런 거 안 좋아하잖아요.

차별화(?)를 위해 슬랙 이모지를 직접 만들거나 아니면 다른 홈페이지에서 가지고 오곤 합니다.

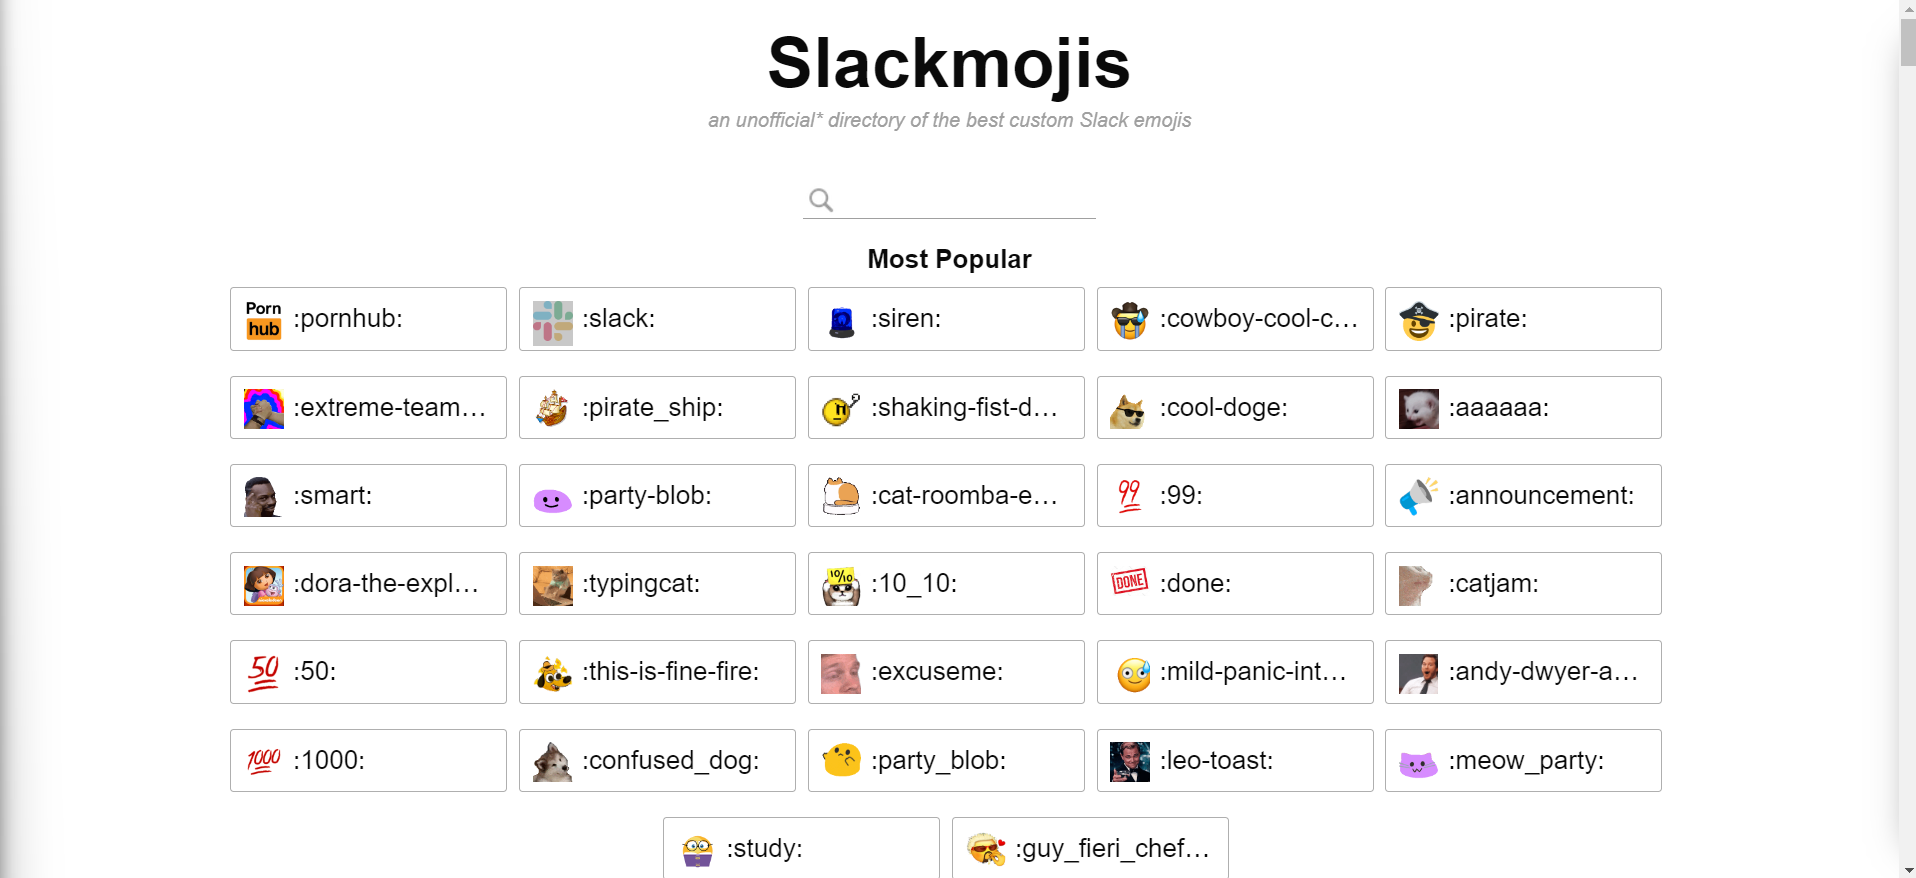
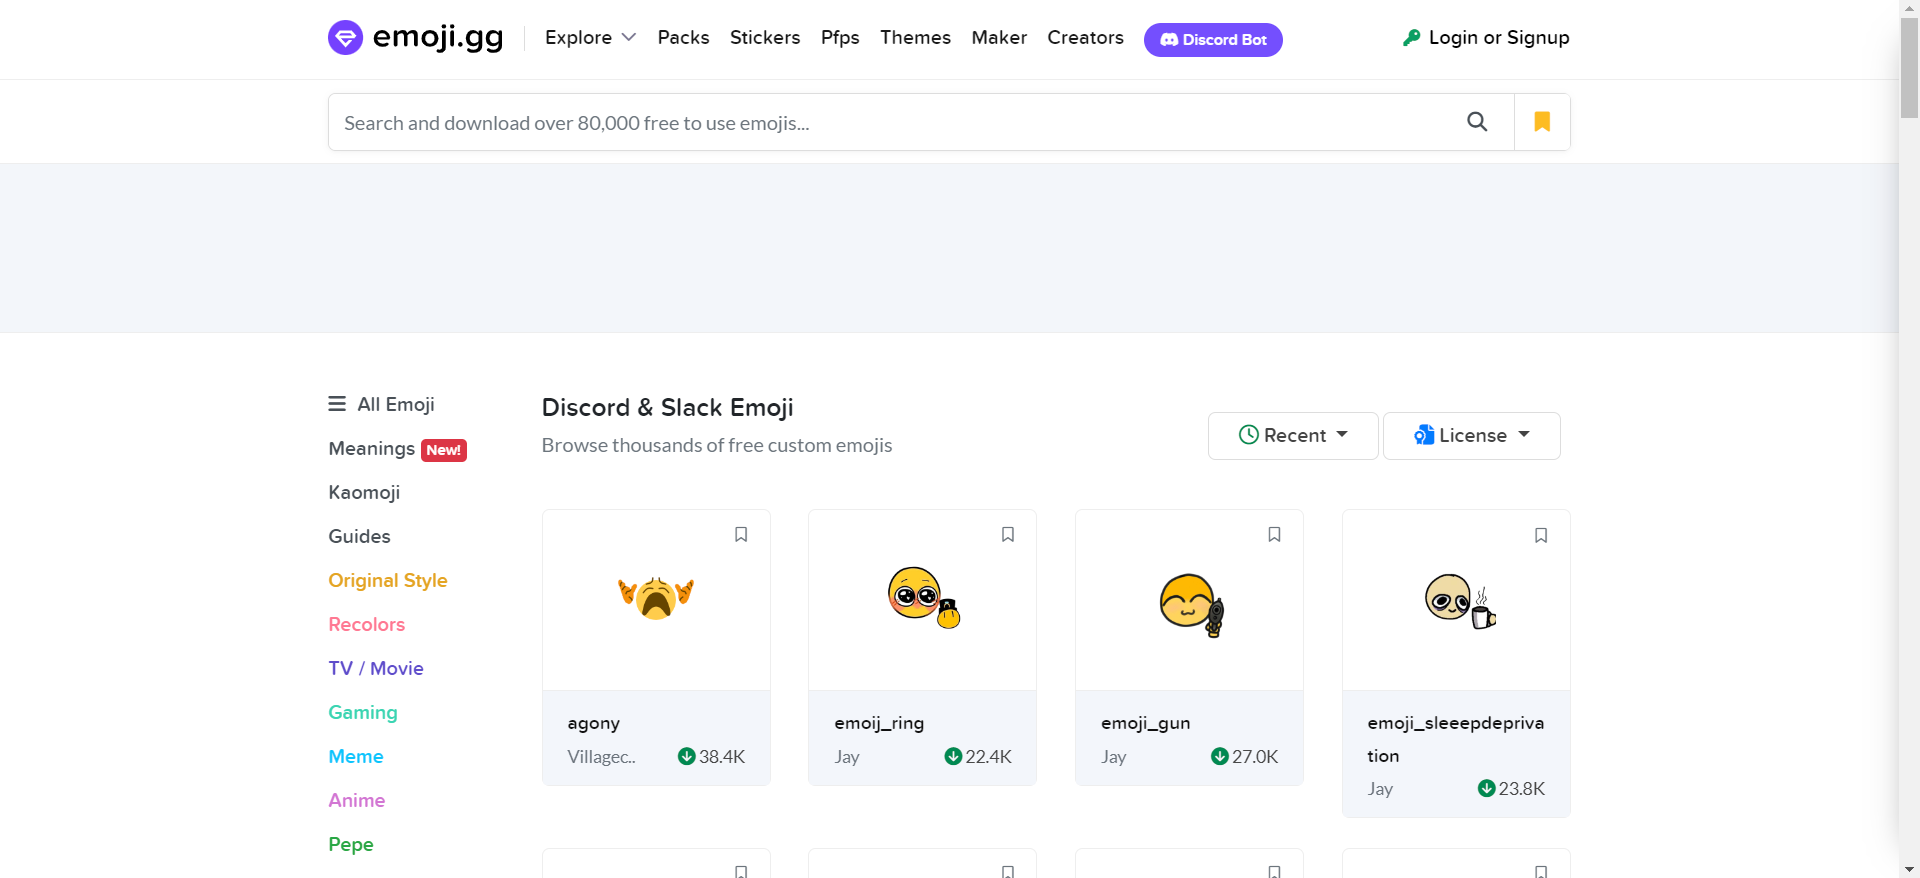
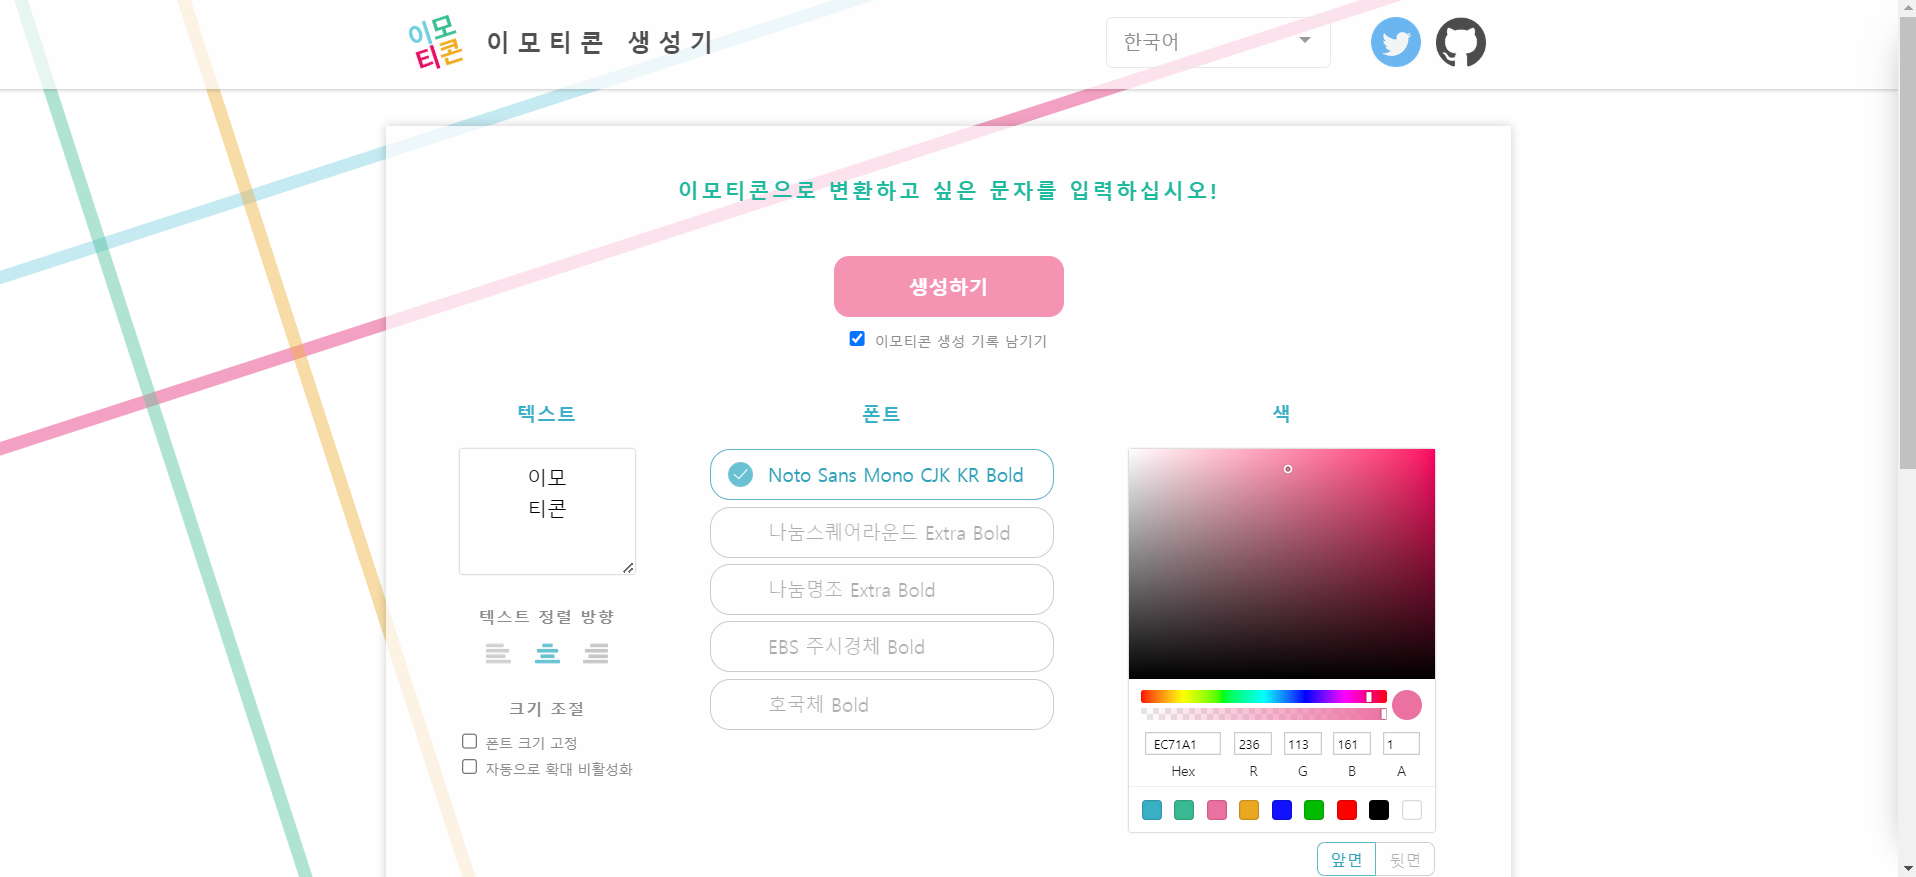
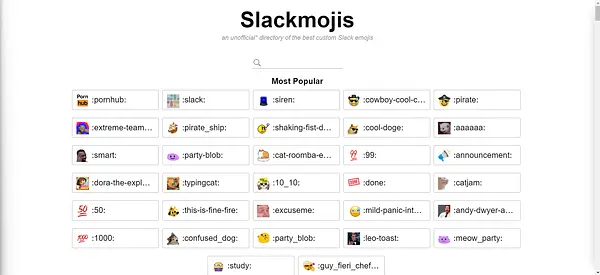
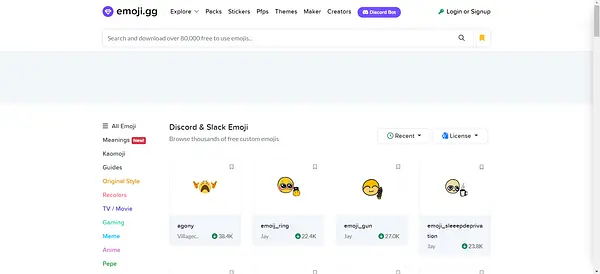
그래서 그런지 슬랙 이모지 사이트... 접속량이 꽤 있습니다. 세 개의 사이트를 살펴보면요.

  1. https://slackmojis.com/

image.png월간 방문 횟수 260K (23.09 기준)

  1. https://emoji.gg/

image.png

월간 방문 횟수 845K (23.09 기준)

  1. https://emoji-gen.ninja/ko/

image.png월간 방문 횟수 34K (23.09 기준)

오... 단순한데 많은 사람들의 관심을 이끌어 내었습니다.

그리고 이러한 관심을 잘 간파한 우리 오픈 소스 진영 내 한 개발자가 이모지의 창의성을 극대화한 서비스를 하나 들고 옵니다.

바로 https://emojis.sh/ 입니다.

우선 서비스 개발자의 말부터 들어 봅시다.

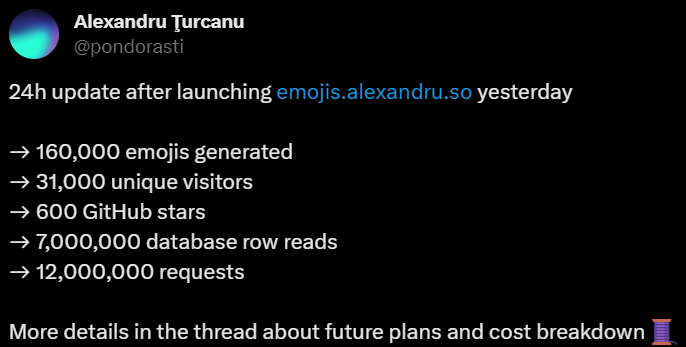
https://twitter.com/pondorasti/status/1709776270014443895

image.png런칭 24시간만에 160,000 개의 이모지 생성, 31,000명 방문...

현재 420,000 개의 이모지가 생성된 것으로 나오니 대략 80,000명이 방문했을 것으로 예측됩니다.

(물론 서비스 운영해보신 분들은 아시겠지만 열성 유저가 저 이모지의 대부분을 만들었을 수도 있습니다)

그런데 특이한 것이 보이죠?

바로 600개의 깃헙 스타입니다. 바로 오픈 소스로 홈페이지를 공유한 것인데요.

홈페이지를 봐야겠습니다.

image.png홈페이지는 정말 단순합니다. 이모지로 만들고 싶은 내용 입력 후 생성.

과정은 텍스트 필터링, 입력값에 어울리는 '이모지스러운' 이미지 생성, 배경 제거 의 순으로 진행되는 것으로 보입니다.

그리고 오른쪽 상단에는 깃헙 로고가 있는데 클릭하면 위 홈페이지의 전체 코드가 담긴 repo 로 연결됩니다.

이렇게 글로벌 레벨에서는 오픈 소스 생태계가 생각보다 정말 활발히 운영되고 있습니다.

그래서 저도 하나 공유를 드려볼까 하는데요. 슬랙 이모지 한 번 직접 만들어 봅시다.

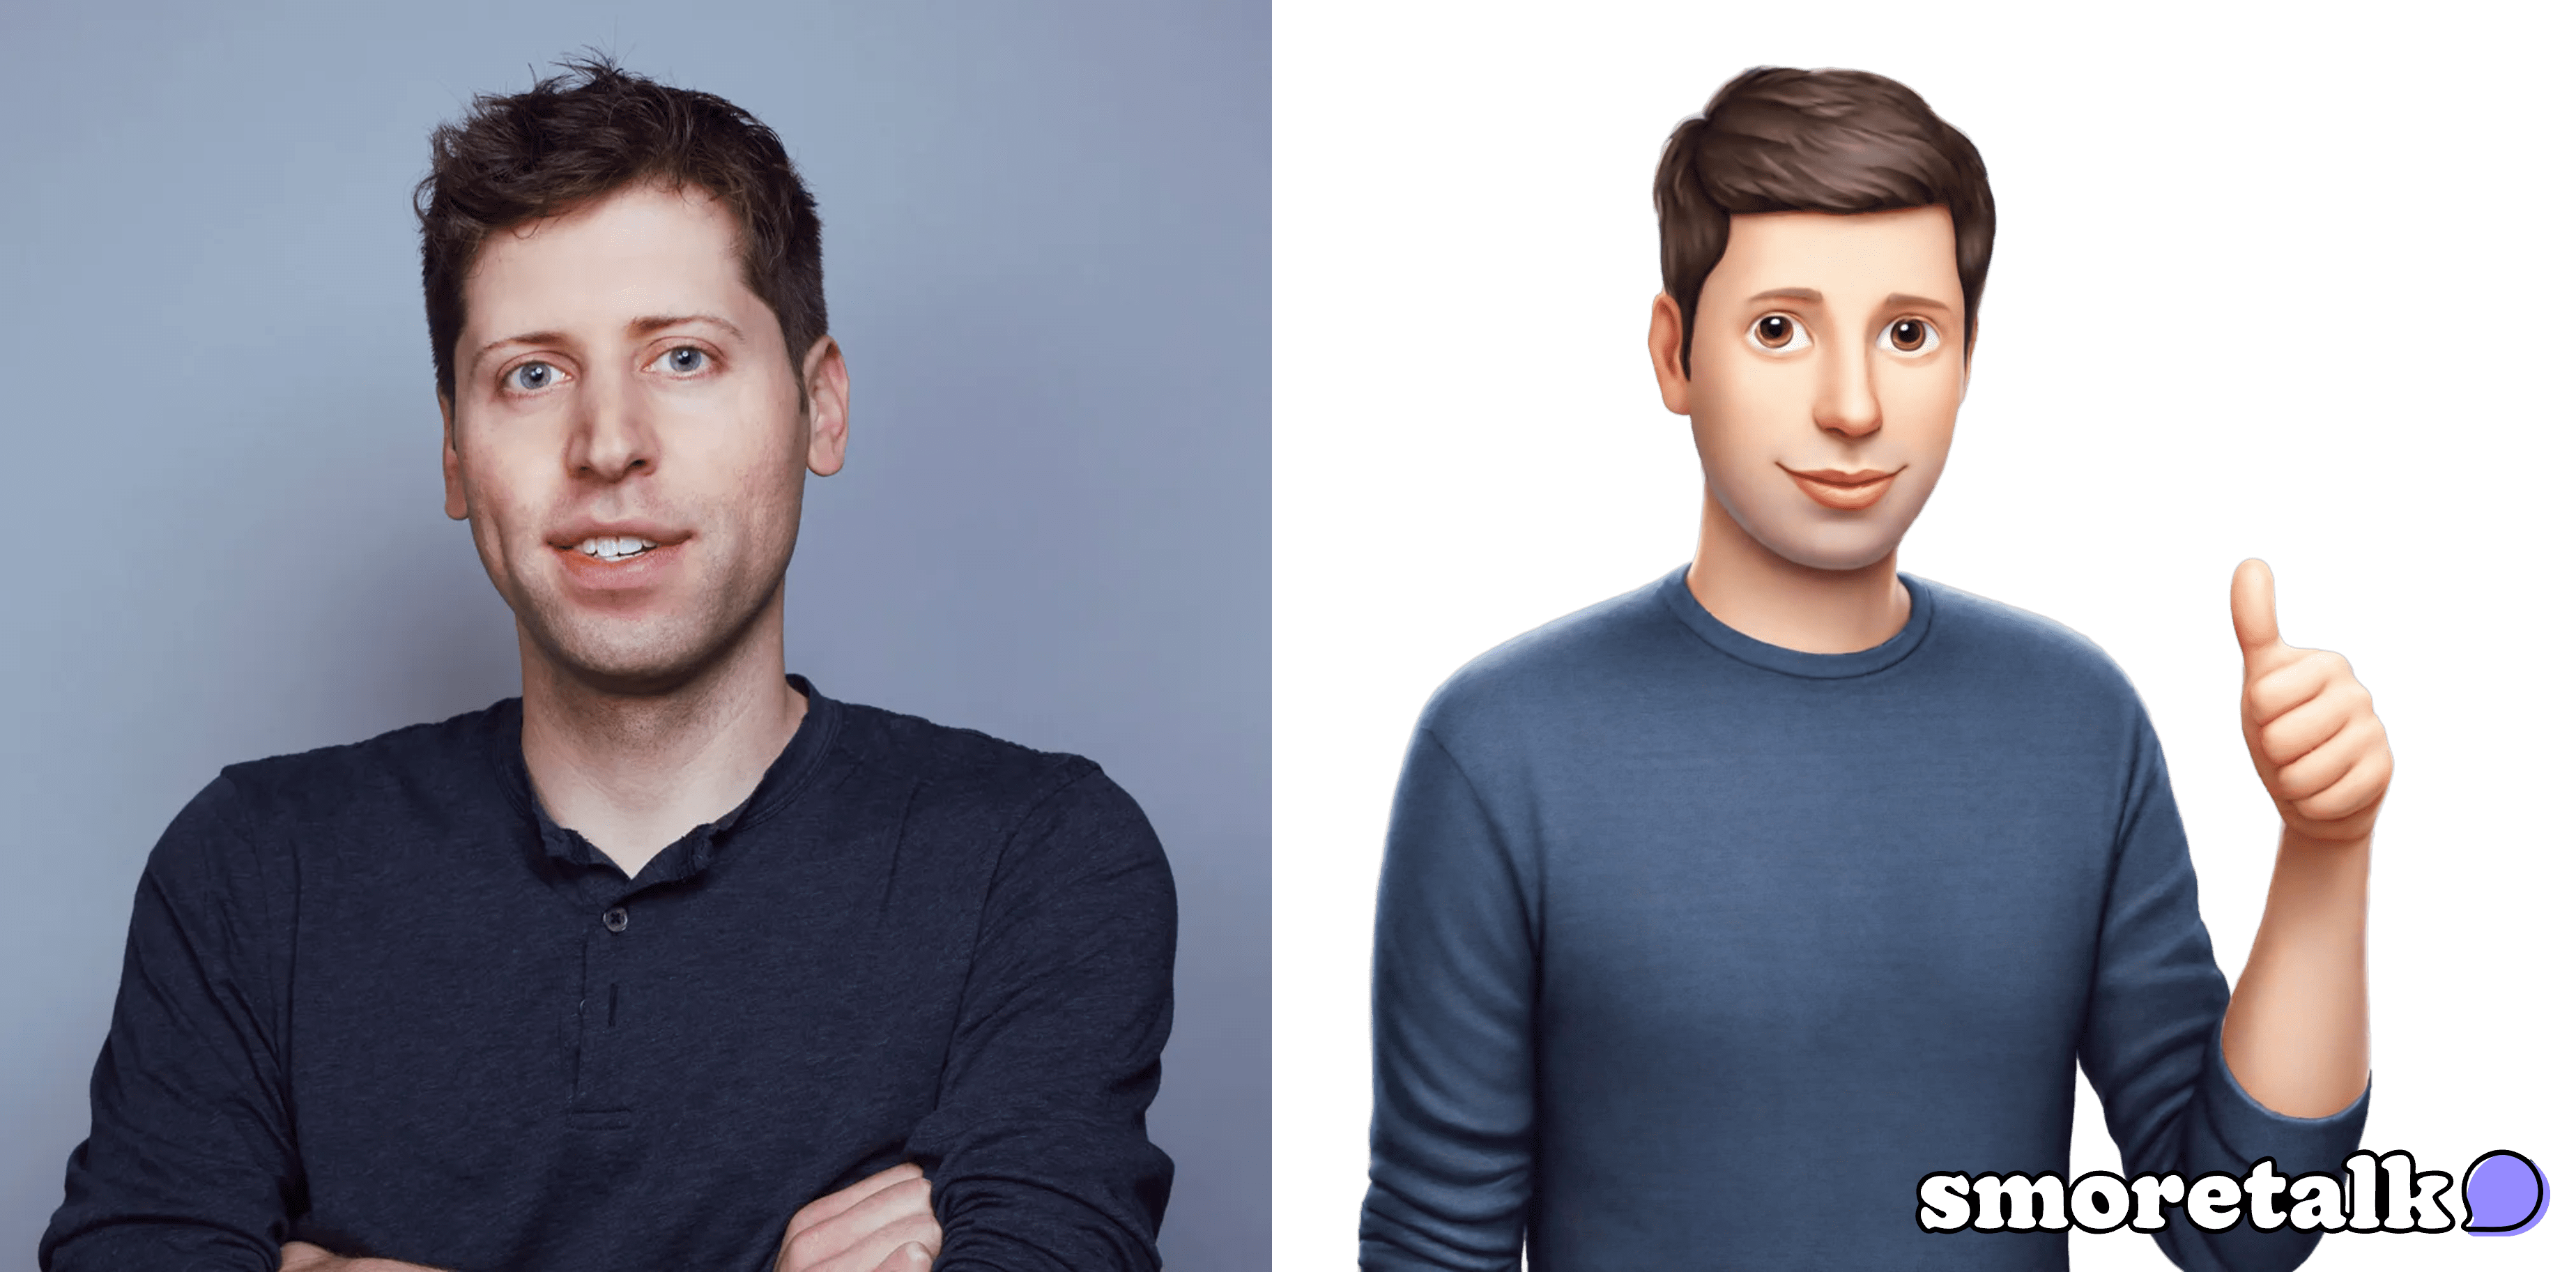
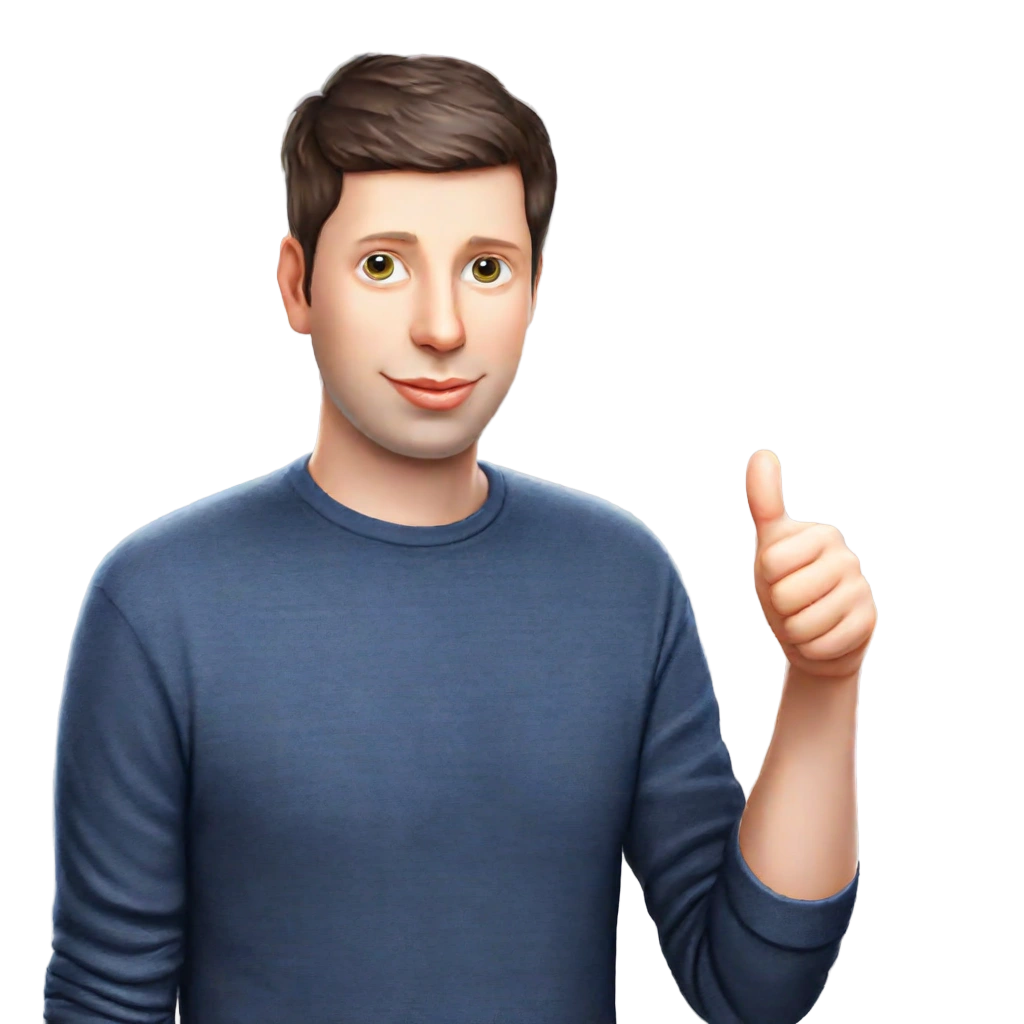
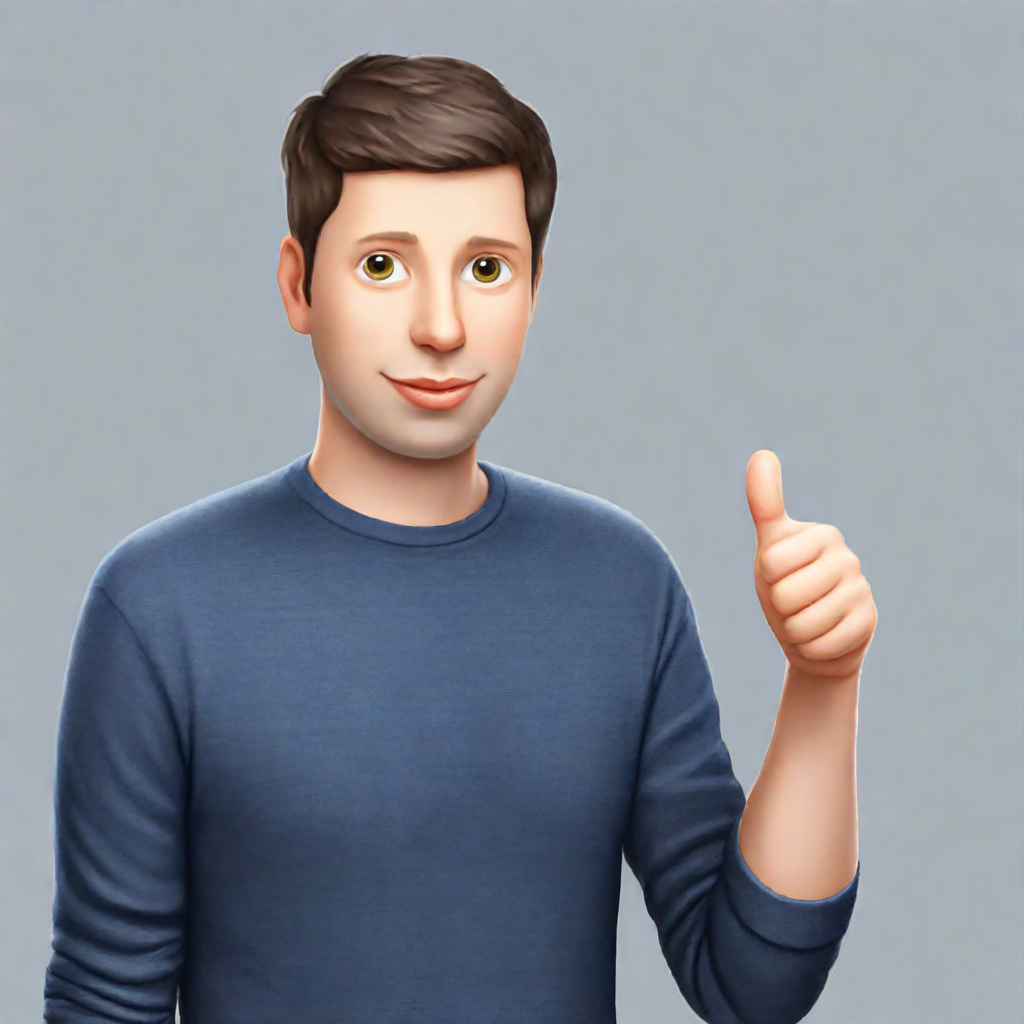
sam altman with thumbs up _ios _2_clipdrop-background-removal.png저는 전 세계 3위, AI 분야 1위의 기업 가치를 자랑하는 오픈 AI 의 CEO 샘 알트먼이 참 대단한 사람이다 라고 생각합니다. 오픈 소스에 대척점에 서기는 했지만, Y Combinator 의 성공적인 운영에 이어 새로운 패러다임을 이끌어 나가고 있다는 점에서 존경스럽습니다.

그런 점에서 멋진 사람의 '따봉'이 좀 더 있어 보이는 것 같아(개인적인 생각) 저희 팀의 슬랙 이모지로도 알트먼의 따봉👍을 사용하기 시작했습니다.

슬랙 캡처.png

이런 샘 알트먼 이모지를 만들기 위해선,

  1. Colab 을 킵니다. 그리고 라이브러리를 다운 받습니다.

!pip install -U git+https://github.com/huggingface/diffusers.git
!pip install -U transformers accelerate xformers safetensors

  1. Stable Diffusion XL 을 세팅합니다. iOS emoji 의 파인튜닝 모델과 함께요.

import torch
from diffusers import AutoencoderKL, DDIMScheduler, StableDiffusionXLPipeline

# Set Scheduler
ddim = DDIMScheduler(
    num_train_timesteps=1000,
    beta_start=0.00085,
    beta_end=0.012,
    beta_schedule="scaled_linear",
    clip_sample=False,
    set_alpha_to_one=False,
    steps_offset=1,
)

# Set Decoder
vae = AutoencoderKL.from_pretrained(
    "madebyollin/sdxl-vae-fp16-fix", torch_dtype=torch.float16
)

model_id = "stabilityai/stable-diffusion-xl-base-1.0"

# Set Stable Diffusion
pipe = StableDiffusionXLPipeline.from_pretrained(
    model_id,
    vae=vae,
    scheduler=ddim,
    torch_dtype=torch.float16,
    variant="fp16",
    use_safetensors=True
).to("cuda")

# For efficient memory
pipe.enable_model_cpu_offload()
pipe.enable_xformers_memory_efficient_attention()

# IMPORTANT!!! Set LoRA of iOS emoji
pipe.load_lora_weights("camenduru/ios-emoji-xl", weight_name="ios_emoji_xl_v2_lora.safetensors")
pipe.fuse_lora(lora_scale=0.6)

  1. 입력값을 넣어 생성합니다.

prompt = "A TOK emoji of Sam Altman"
negative_prompt = "ugly, deformed, noisy, blurry, distorted, grainy, text, cropped"
generator = torch.Generator("cuda").manual_seed(42)
image = pipe(prompt=prompt, negative_prompt=negative_prompt, num_inference_steps=40, generator=generator)
image = image.images[0]

  1. 그 결과는 바로 다음과 같습니다.

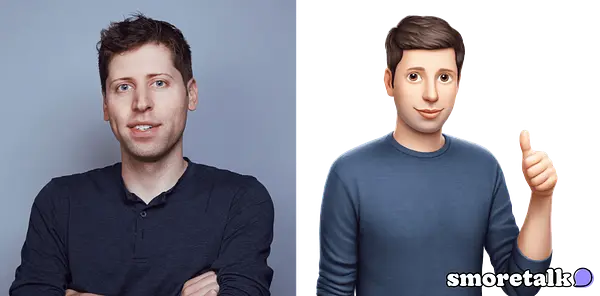
sam altman _ios _pre.png좋은데 샘 알트먼이라고 하기에는 조금 애매합니다.

이럴 때는 IP-Adapter 를 사용해 참고할 만한 이미지를 일부 반영해 이미지를 생성해줍니다.

저는 샘 알트먼의 프로필 이미지를 참고하도록 사용했습니다.

from ip_adapter import IPAdapterXL

image_encoder_path = "/content/h94/sdxl_models/image_encoder" 
ip_ckpt = "/content/h94/sdxl_models/ip-adapter_sdxl.bin"  
ip_model = IPAdapterXL(pipe, image_encoder_path, ip_ckpt, device="cuda")

코드를 간략히 보면 이미지를 반영하는 image encoder 와 이미지를 생성하는 스테이블 디퓨전 모델에 반영되는 weight 값이 설정 되어야 함을 알 수 있습니다.

images = ip_model.generate(pil_image=profile_image, num_samples=1, num_inference_steps=50, seed=164710062023, prompt="A TOK emoji of a man with thumb up", negative_prompt="low quality, blurry, mutated", guidance_scale=7.5, scale=0.75)

profile_image 에 위 샘 알트먼의 프로필 이미지를 입력하고 기존과 동일하게 입력하여 이미지를 만들면 됩니다. 저는 '따봉을 주는' 샘 알트먼의 이모지가 필요했기 때문에 입력 값에 'with thumb up" 을 집어넣어 주었습니다.

그래서 나온 결과는 바로

sam altman with thumbs up _ios _2.png

위 이미지를 배경만 제거하면 슬랙 이모지에 사용할 수 있는 이미지가 만들어 지게 됩니다. 시도해 볼만 한가요?

당장은 코드 작업이 좀 불편한 분들이 계실 수도 있어서 저도,

  • Vercel 로 빠르게 웹페이지 배포 후 공개 (돈 많이 나갈 예정)

  • 특정 부위 묘사 잘하는 AI 모델 자체 개발 (새벽 남는 시간 데이터셋 모으는 중)

을 고민해 보고 있습니다.

스모어톡과 함께 이미지 AI를 기업 내에 도입하고 싶은 분들은 커피챗, 미팅 등으로 편하게 연락주세요 :)


이정민 (스모어톡, tonylee@smoretalk.io)

플라멜 Flamel v0.1

프롬프트 엔지니어링이 필요 없는 가장 쉬운 검색형 이미지 생성 서비스

17
4
이정민

이정민

파인튜닝이라도 우리만 할 수 있는 것이 있지 않나?

_d37742e8-5720-4942-951d-ff035c043559.jpeg

현실이 비록 이렇긴 한데,

그래도 AI 정말 재밌으니까 한국에서 아무도 안 했던 무언가를 보여주고 싶다.

여기서 아무도 안 했던 것에 대한 것은 그림에 나와 있다.

비록 리소스 문제로

Pre-train 이 아니라 Fine-tune 에 집중하지만
Fine-tune 으로도 아무도 못한 걸 하면 의미가 있지 않을까 싶어서 그걸 보여주고 싶다. 아무튼 추석은 다 갔다.

플라멜 Flamel v0.1

프롬프트 엔지니어링이 필요 없는 가장 쉬운 검색형 이미지 생성 서비스

12
0
이정민

이정민

[Tip] 90초면 모든 촬영이 끝, AI 패션 모델 만들기 (2)👗

👇👇👇 이제 직접 만들어 볼까요?
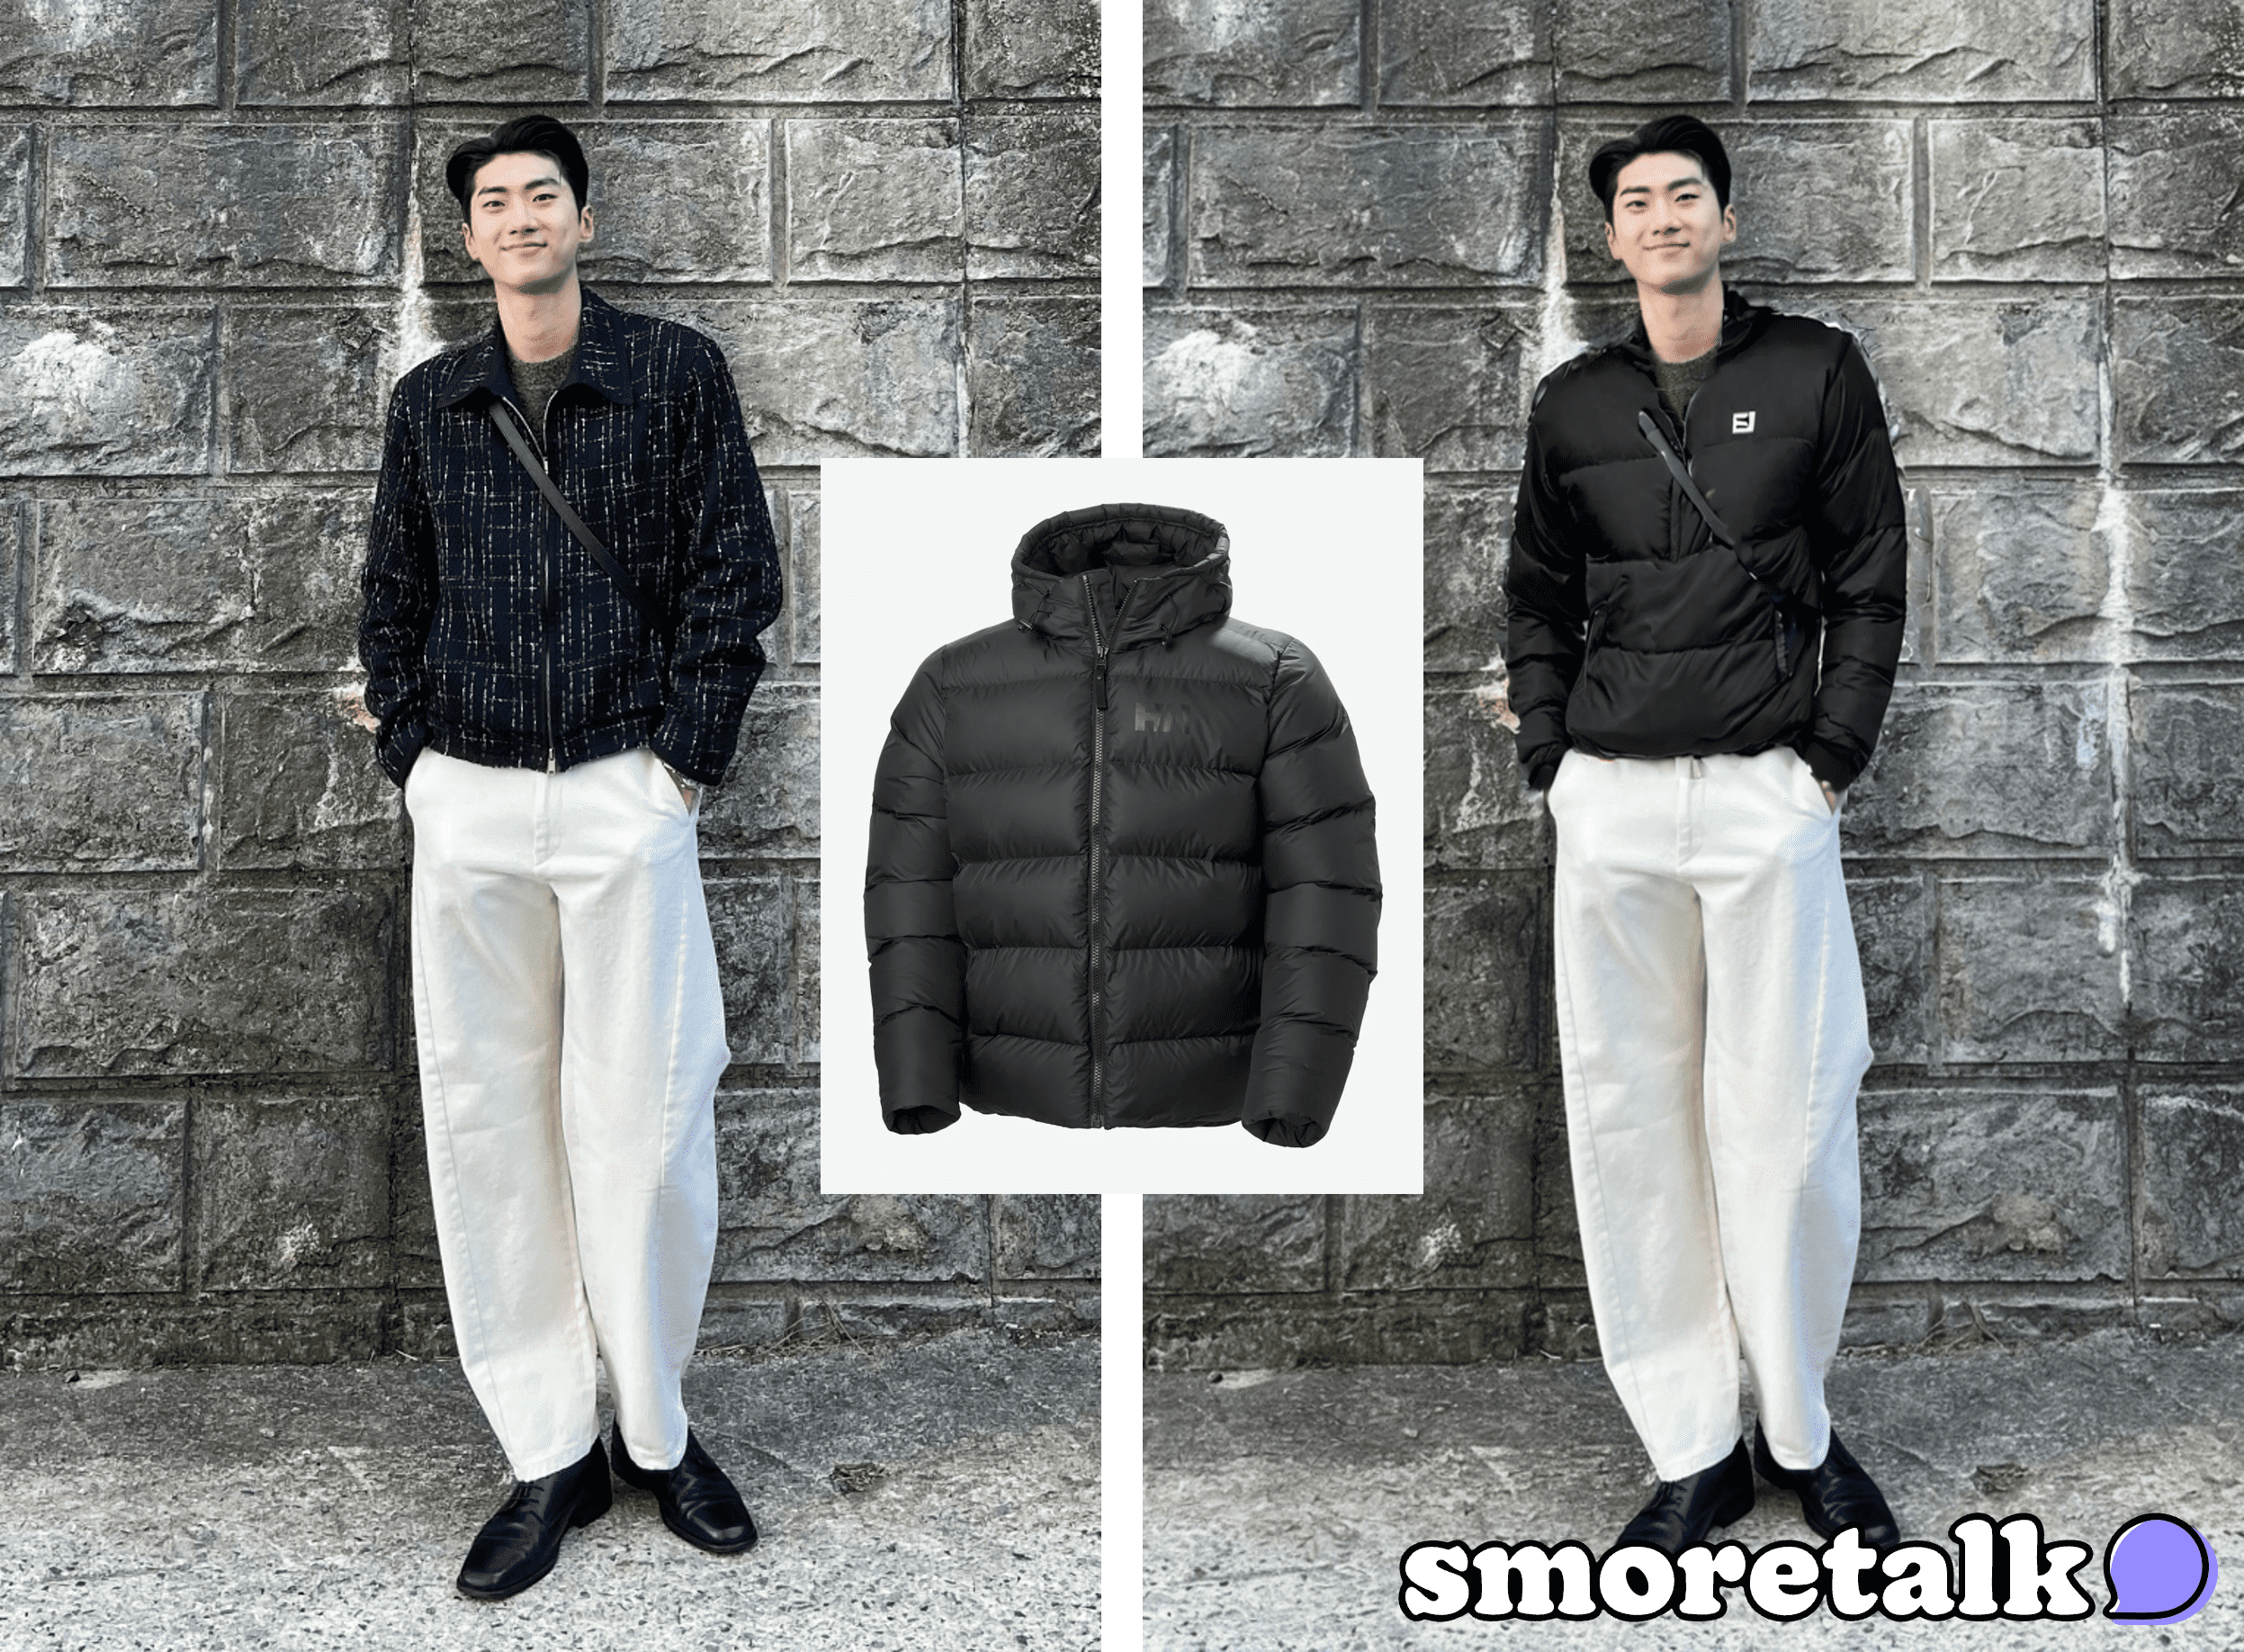
작업 예시 _1 (1).png출처: 무신사 스냅 (링크, 스냅 닉네임 zero_jean_), 스모어톡 의상 변경 예시 결과물

AI 패션 모델에 관한 전반적인 내용은 AI 패션 모델 만들기 1편 링크 를 확인해주세요
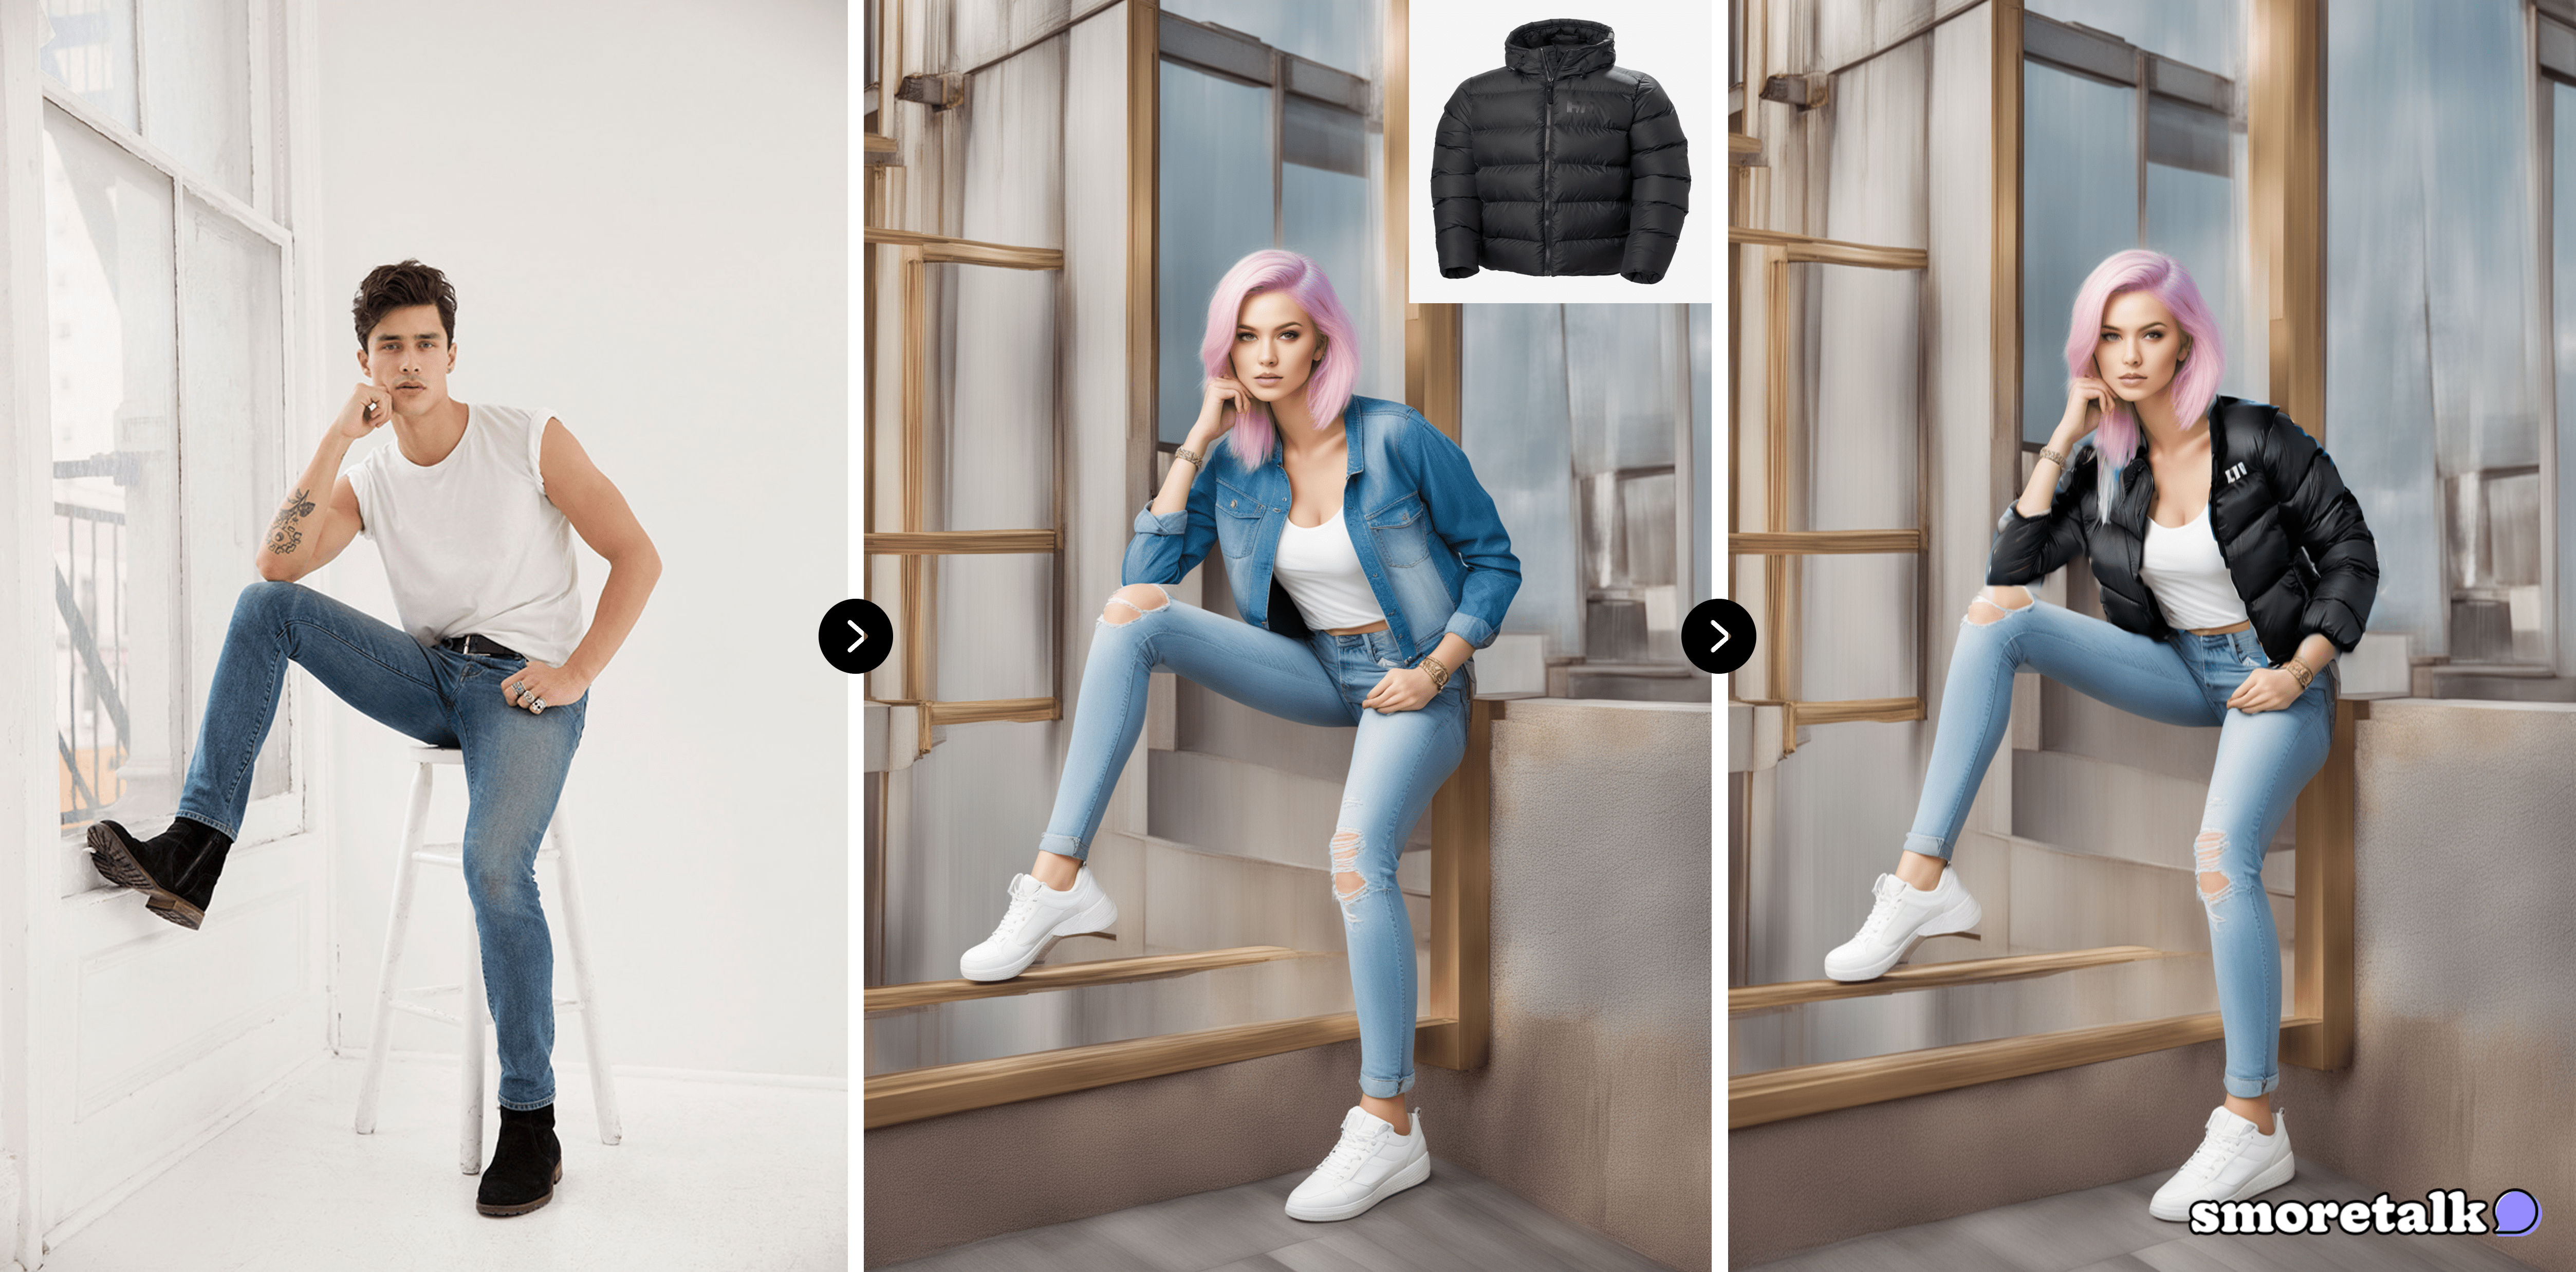
모델 의상 변경 예시.png

그럼 이제 만들어 봐야죠?

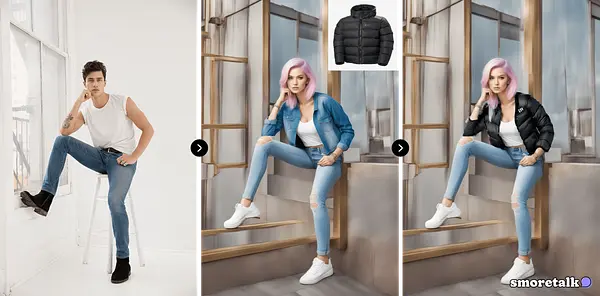
어도비 코리아의 블로그 글 [입문자들을 위한 패션 사진 촬영법](링크) 을 참고한 저의 작업 플로우는 아래와 같습니다. 여기에 세부적인 작업 과정이 추가가 될 것입니다.
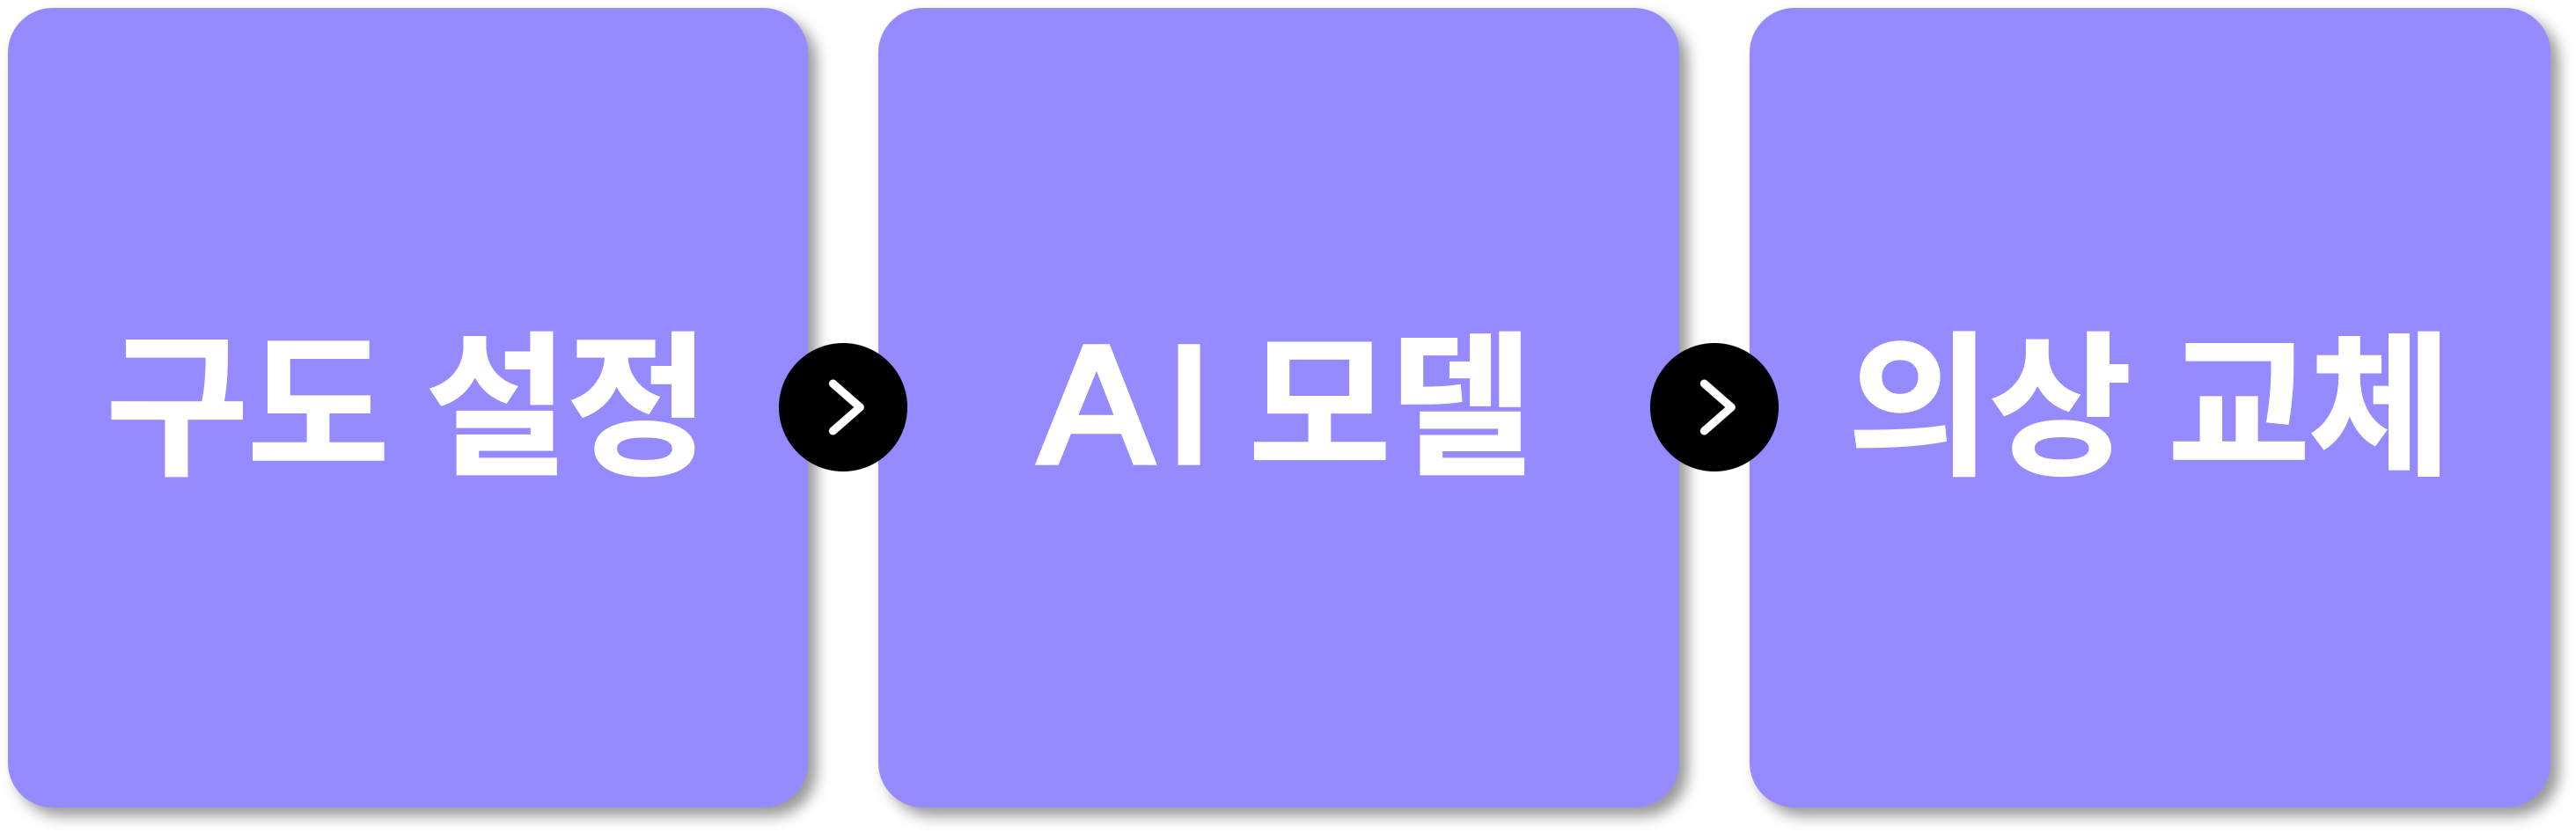
작업 구조도.png

먼저 구도를 확보해야 합니다.

패션 사진은 단순히 촬영에 그치는 것이 아니라 사진에 스토리텔링을 담아야 합니다. (이걸 왜 패션 문외한인 제가 말씀드리는 지는 모르겠지만...)

저는 이미지 구도 확보를 목적으로 무신사 스냅(링크) 을 참고했습니다.

무신사 스냅은 트렌디한 패션 컨텐츠를 보여주는 무신사의 앱인앱(App-in-App) 형태 버티컬 SNS 입니다.
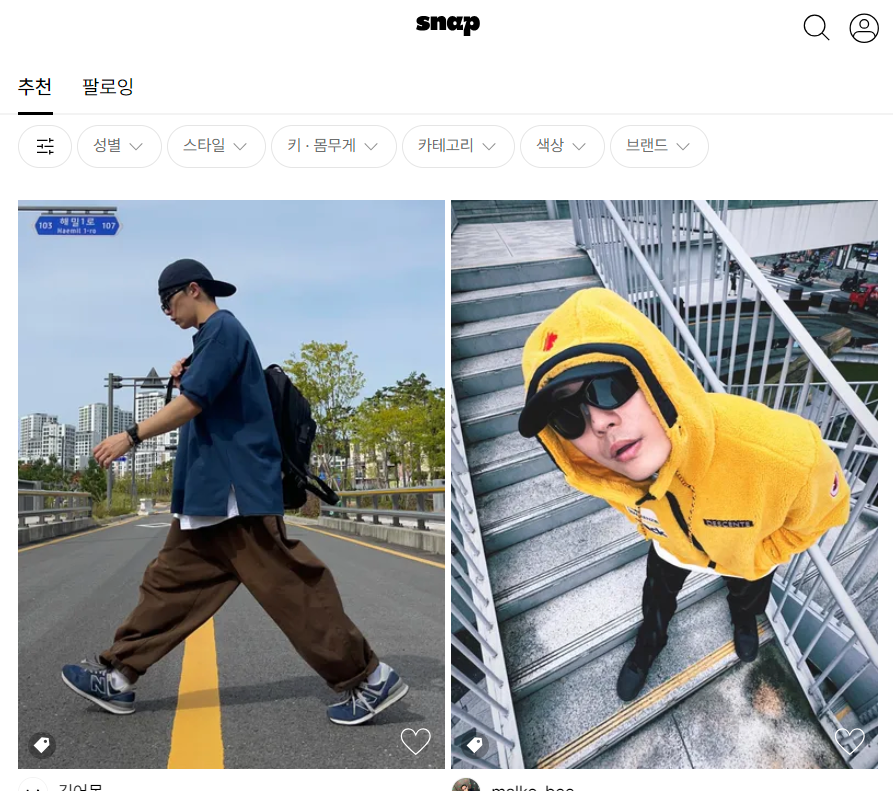
image.png

출처: 무신사 스냅 (김어몽 님, malko_bee 님)

아무래도 스트릿 패션과 관련한 구도를 잡기가 용이해 보입니다.

저는 무신사 스냅 구글 검색 후 나온 이미지 중에서 하나를 무작위로 선정했습니다.

바로 이 사진이죠.
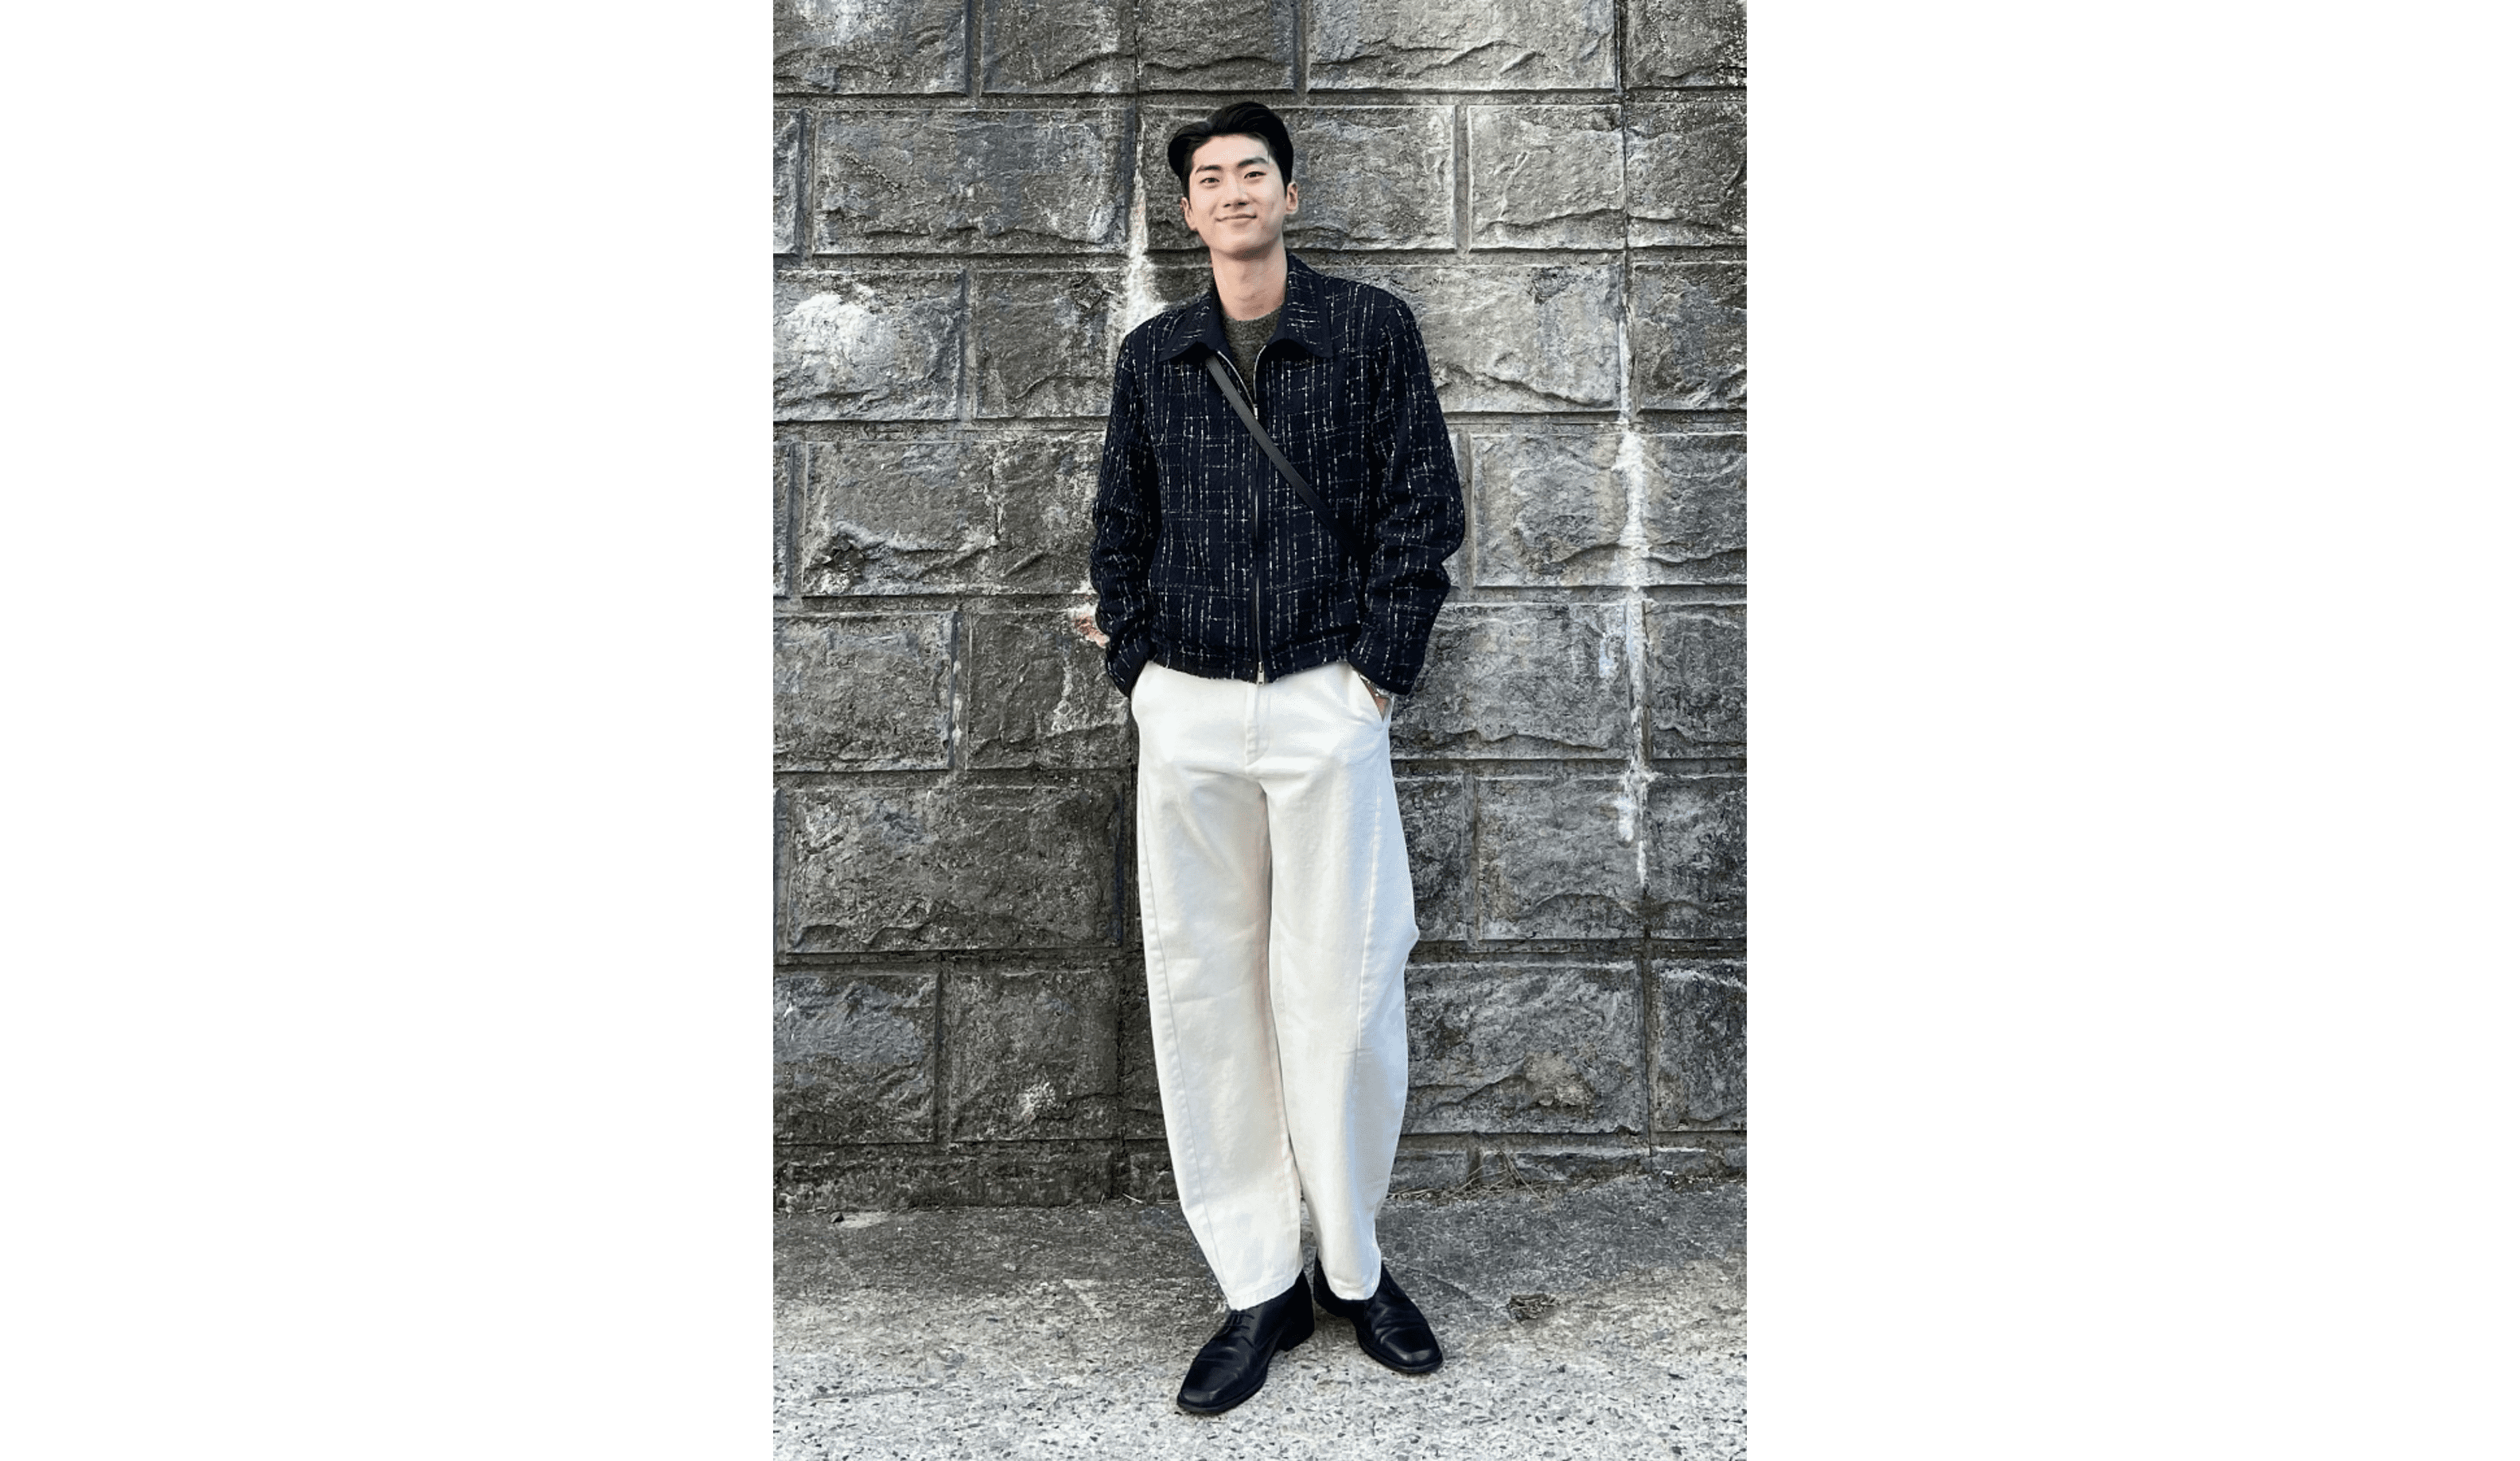
모델 사진 _기본 (1).png

출처: 무신사 스냅 (링크, 스냅 닉네임 zero_jean_)

감각적인 이 사진을 활용해서 하는 작업은 먼저 자세를 추출합니다. (전체 코드는 아닙니다)

from controlnet_aux import OpenposeDetector

#set the detector
pose_detector = OpenposeDetector.from_pretrained("lllyasviel/Annotators").to("cuda") 

image_path = "/content/drive/MyDrive/{file_name}" #chcck file_name
image = load_image(image_path)

#detect posture
pose_image = pose_detector(image, detect_resolution=512, image_resolution=1024, include_face=True, include_hand=False)
pose_image = np.array(pose_image)[:, :, ::-1]
pose_image = Image.fromarray(np.uint8(pose_image))

그러면 아래와 같은 자세 이미지가 추출됩니다.
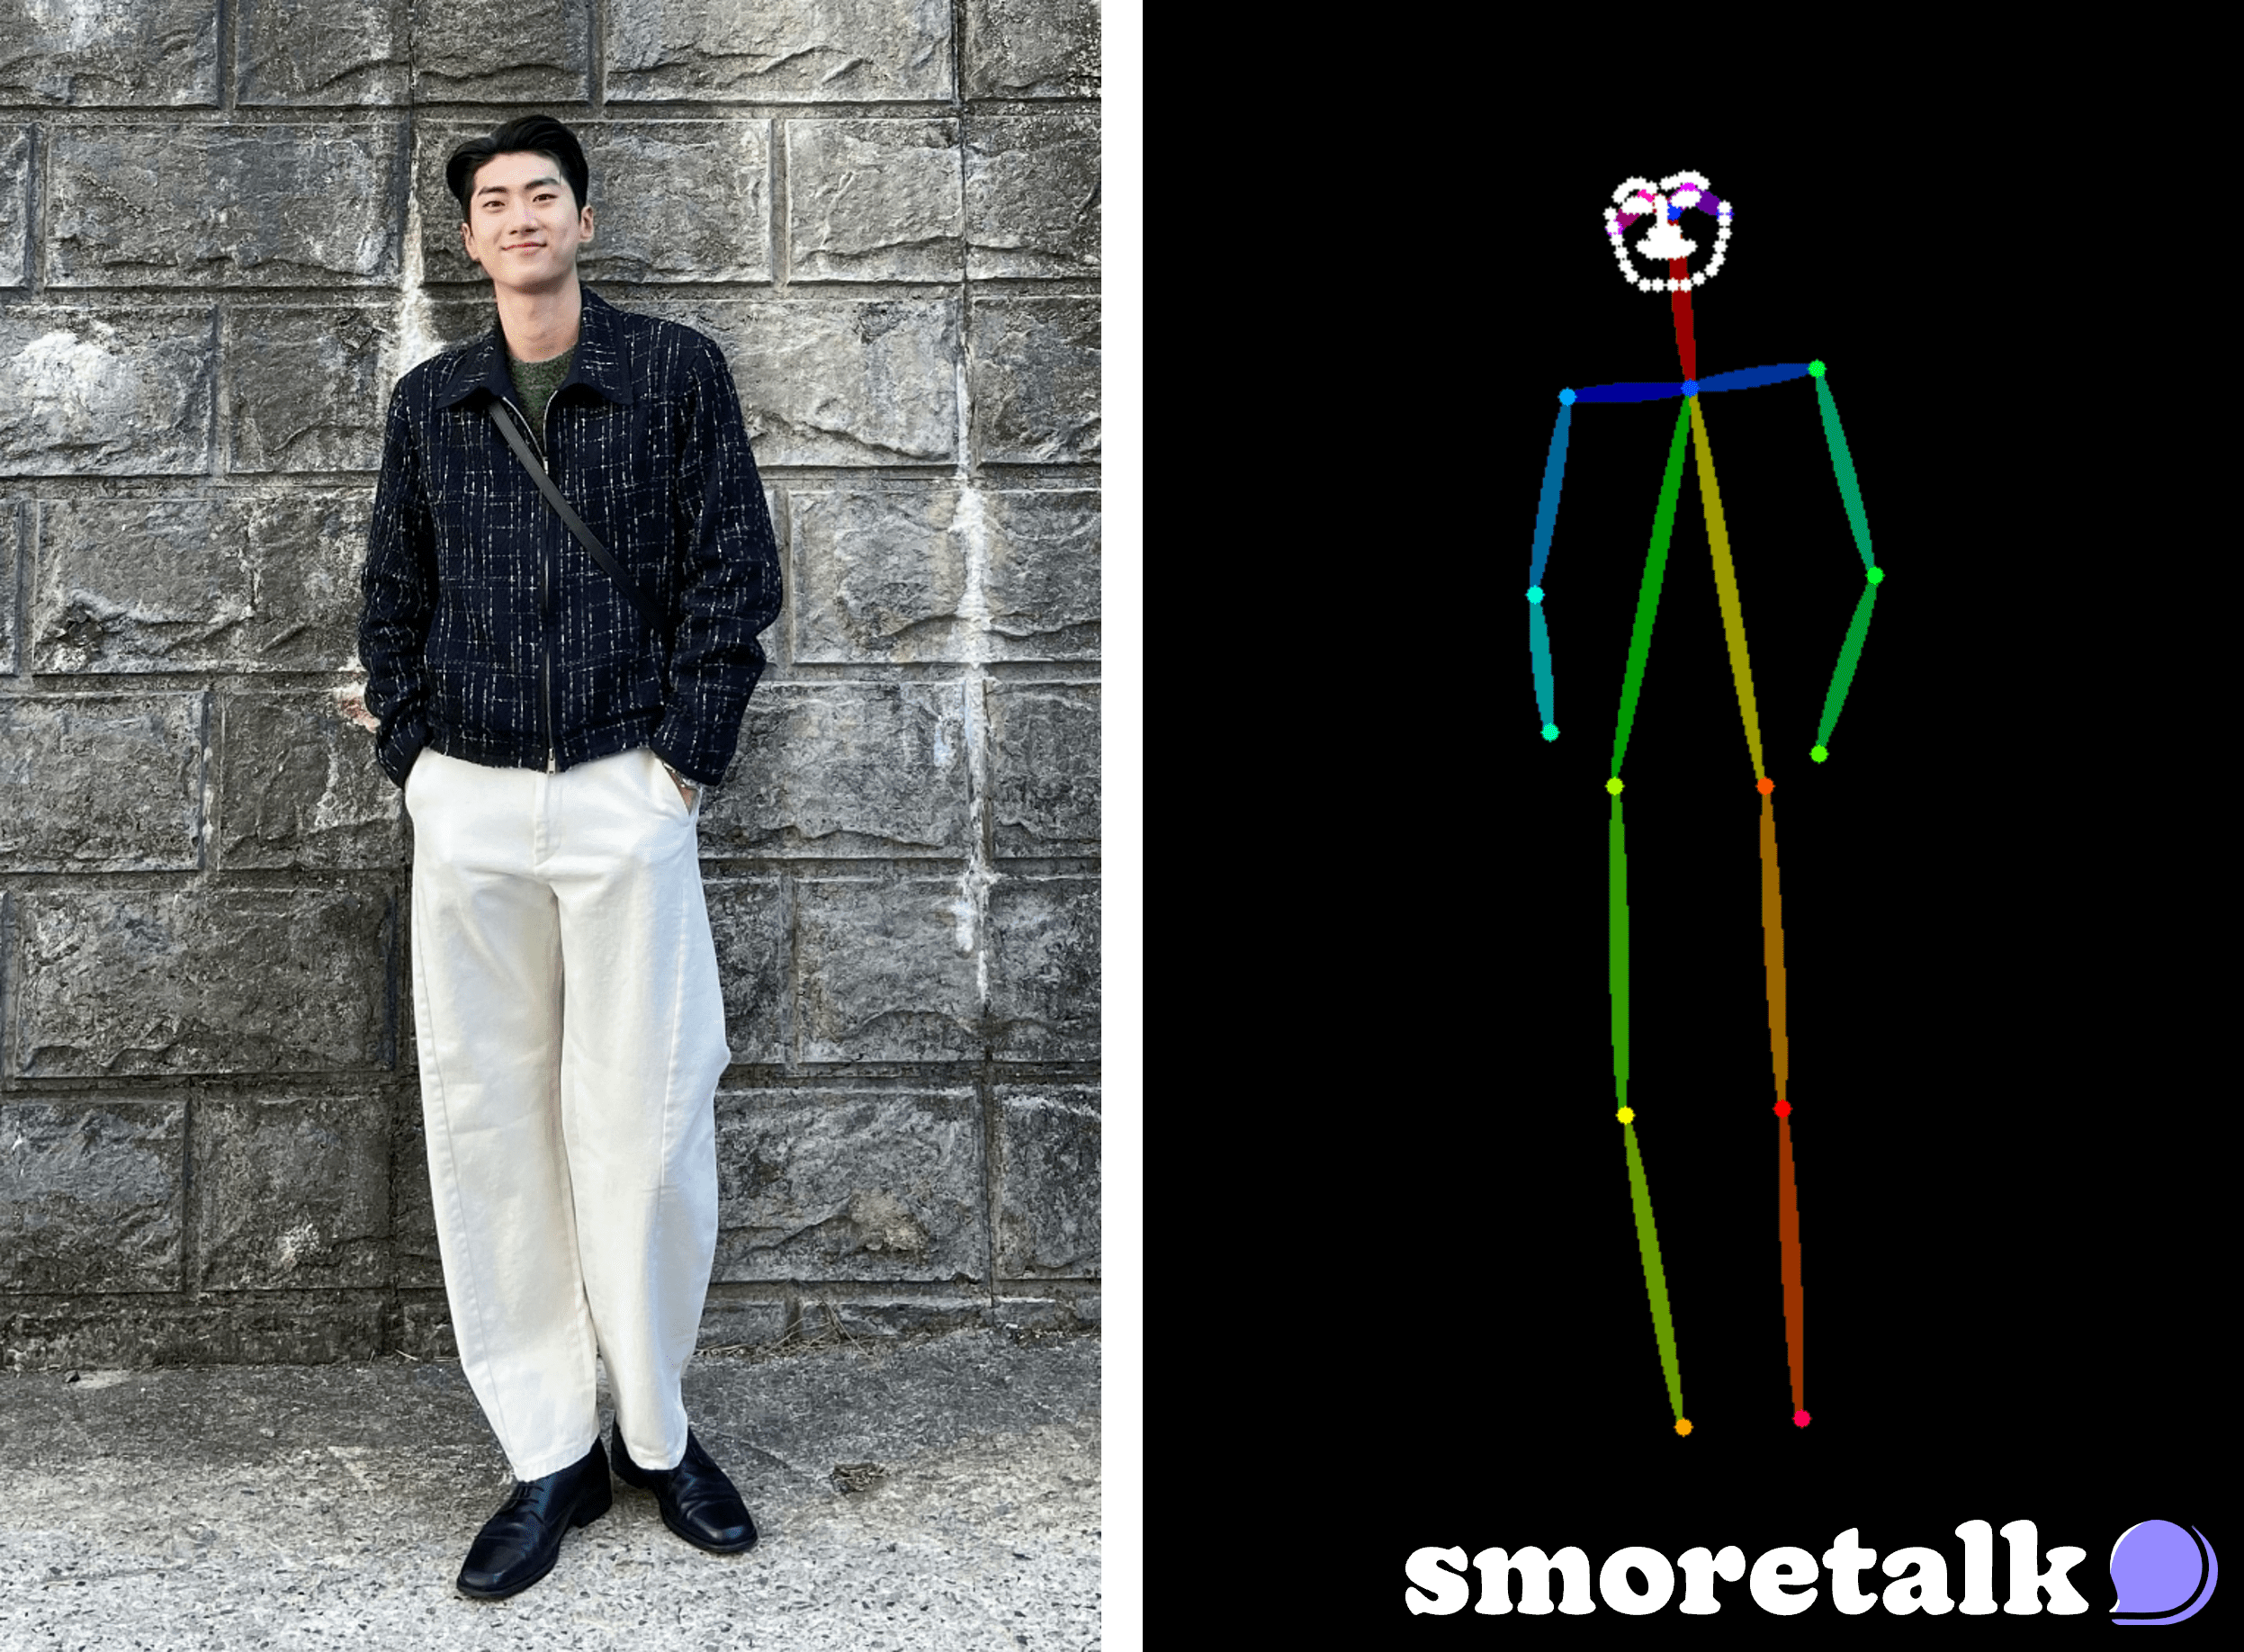
작업 구도 추출 _1 (1).png자세 이미지는 말 그대로 자세만 있기 때문에 실제 사람 같은 가상 모델의 이미지를 만들어야 할 거에요.

해당 이미지로 이미지를 생성하는 방법으로 Stable Diffusion 을 구성하는 모듈 중 U-Net 에 지속적으로 윤곽값을 설정해주는 ControlNet 을 사용합니다.

아래 코드 중 image=pose_image 가 바로 윤곽값을 설정해주는 문장입니다. (전체 코드는 아닙니다)

# Generate an image with ControlNet
prompt = "photo of beautiful girl, with pastel hair, blue jeans, in golden ratio, model pose, dslr, 8k, 4k, ultrarealistic, realistic, photorealistic, natural skin, textured skin"
negative_prompt = "wrong, deformed hands, mutated limbs, blurry, bad quality, nude, text"
seed = 2024

compel_base = Compel(tokenizer=[pipe.tokenizer, pipe.tokenizer_2] , text_encoder=[pipe.text_encoder, pipe.text_encoder_2], returned_embeddings_type=ReturnedEmbeddingsType.PENULTIMATE_HIDDEN_STATES_NON_NORMALIZED, requires_pooled=[False, True])
compel_refiner = Compel(tokenizer=refiner.tokenizer_2 , text_encoder=refiner.text_encoder_2, returned_embeddings_type=ReturnedEmbeddingsType.PENULTIMATE_HIDDEN_STATES_NON_NORMALIZED, requires_pooled=True)

high_noise_frac = 0.85

conditioning, pooled = compel_base(prompt)
conditioning_neg, pooled_neg = compel_base(negative_prompt) if negative_prompt is not None else (None, None)
generator = torch.Generator(device="cuda").manual_seed(seed)

latents = pipe(prompt_embeds=conditioning,
               pooled_prompt_embeds=pooled,
               negative_prompt_embeds=conditioning_neg,
               negative_pooled_prompt_embeds=pooled_neg,
               image=pose_image,
               num_inference_steps=40,
               adapter_conditioning_scale=0.9,
               adapter_conditioning_factor=1.1,
               guidance_scale=8,
               denoising_end=high_noise_frac,
               generator=generator,
               output_type="latent",
               cross_attention_kwargs={"scale": 1.}
               ).images

conditioning, pooled = compel_refiner(prompt)
conditioning_neg, pooled_neg = compel_refiner(negative_prompt) if negative_prompt is not None else (None, None)
generator = torch.Generator(device="cuda").manual_seed(seed)

images = refiner(
    prompt_embeds=conditioning,
    pooled_prompt_embeds=pooled,
    negative_prompt_embeds=conditioning_neg,
    negative_pooled_prompt_embeds=pooled_neg,
    guidance_scale=7.5,
    denoising_start=high_noise_frac,
    image=latents,
    generator=generator,).images

image = images[0]

저는 compel library 를 통해 텍스트 임베딩을 최적으로 조정하도록 했습니다.

굳이 사용 안 하셔도 되기는 합니다. 쉬운 코드는 추후에 수정해서 공유해드리겠습니다.
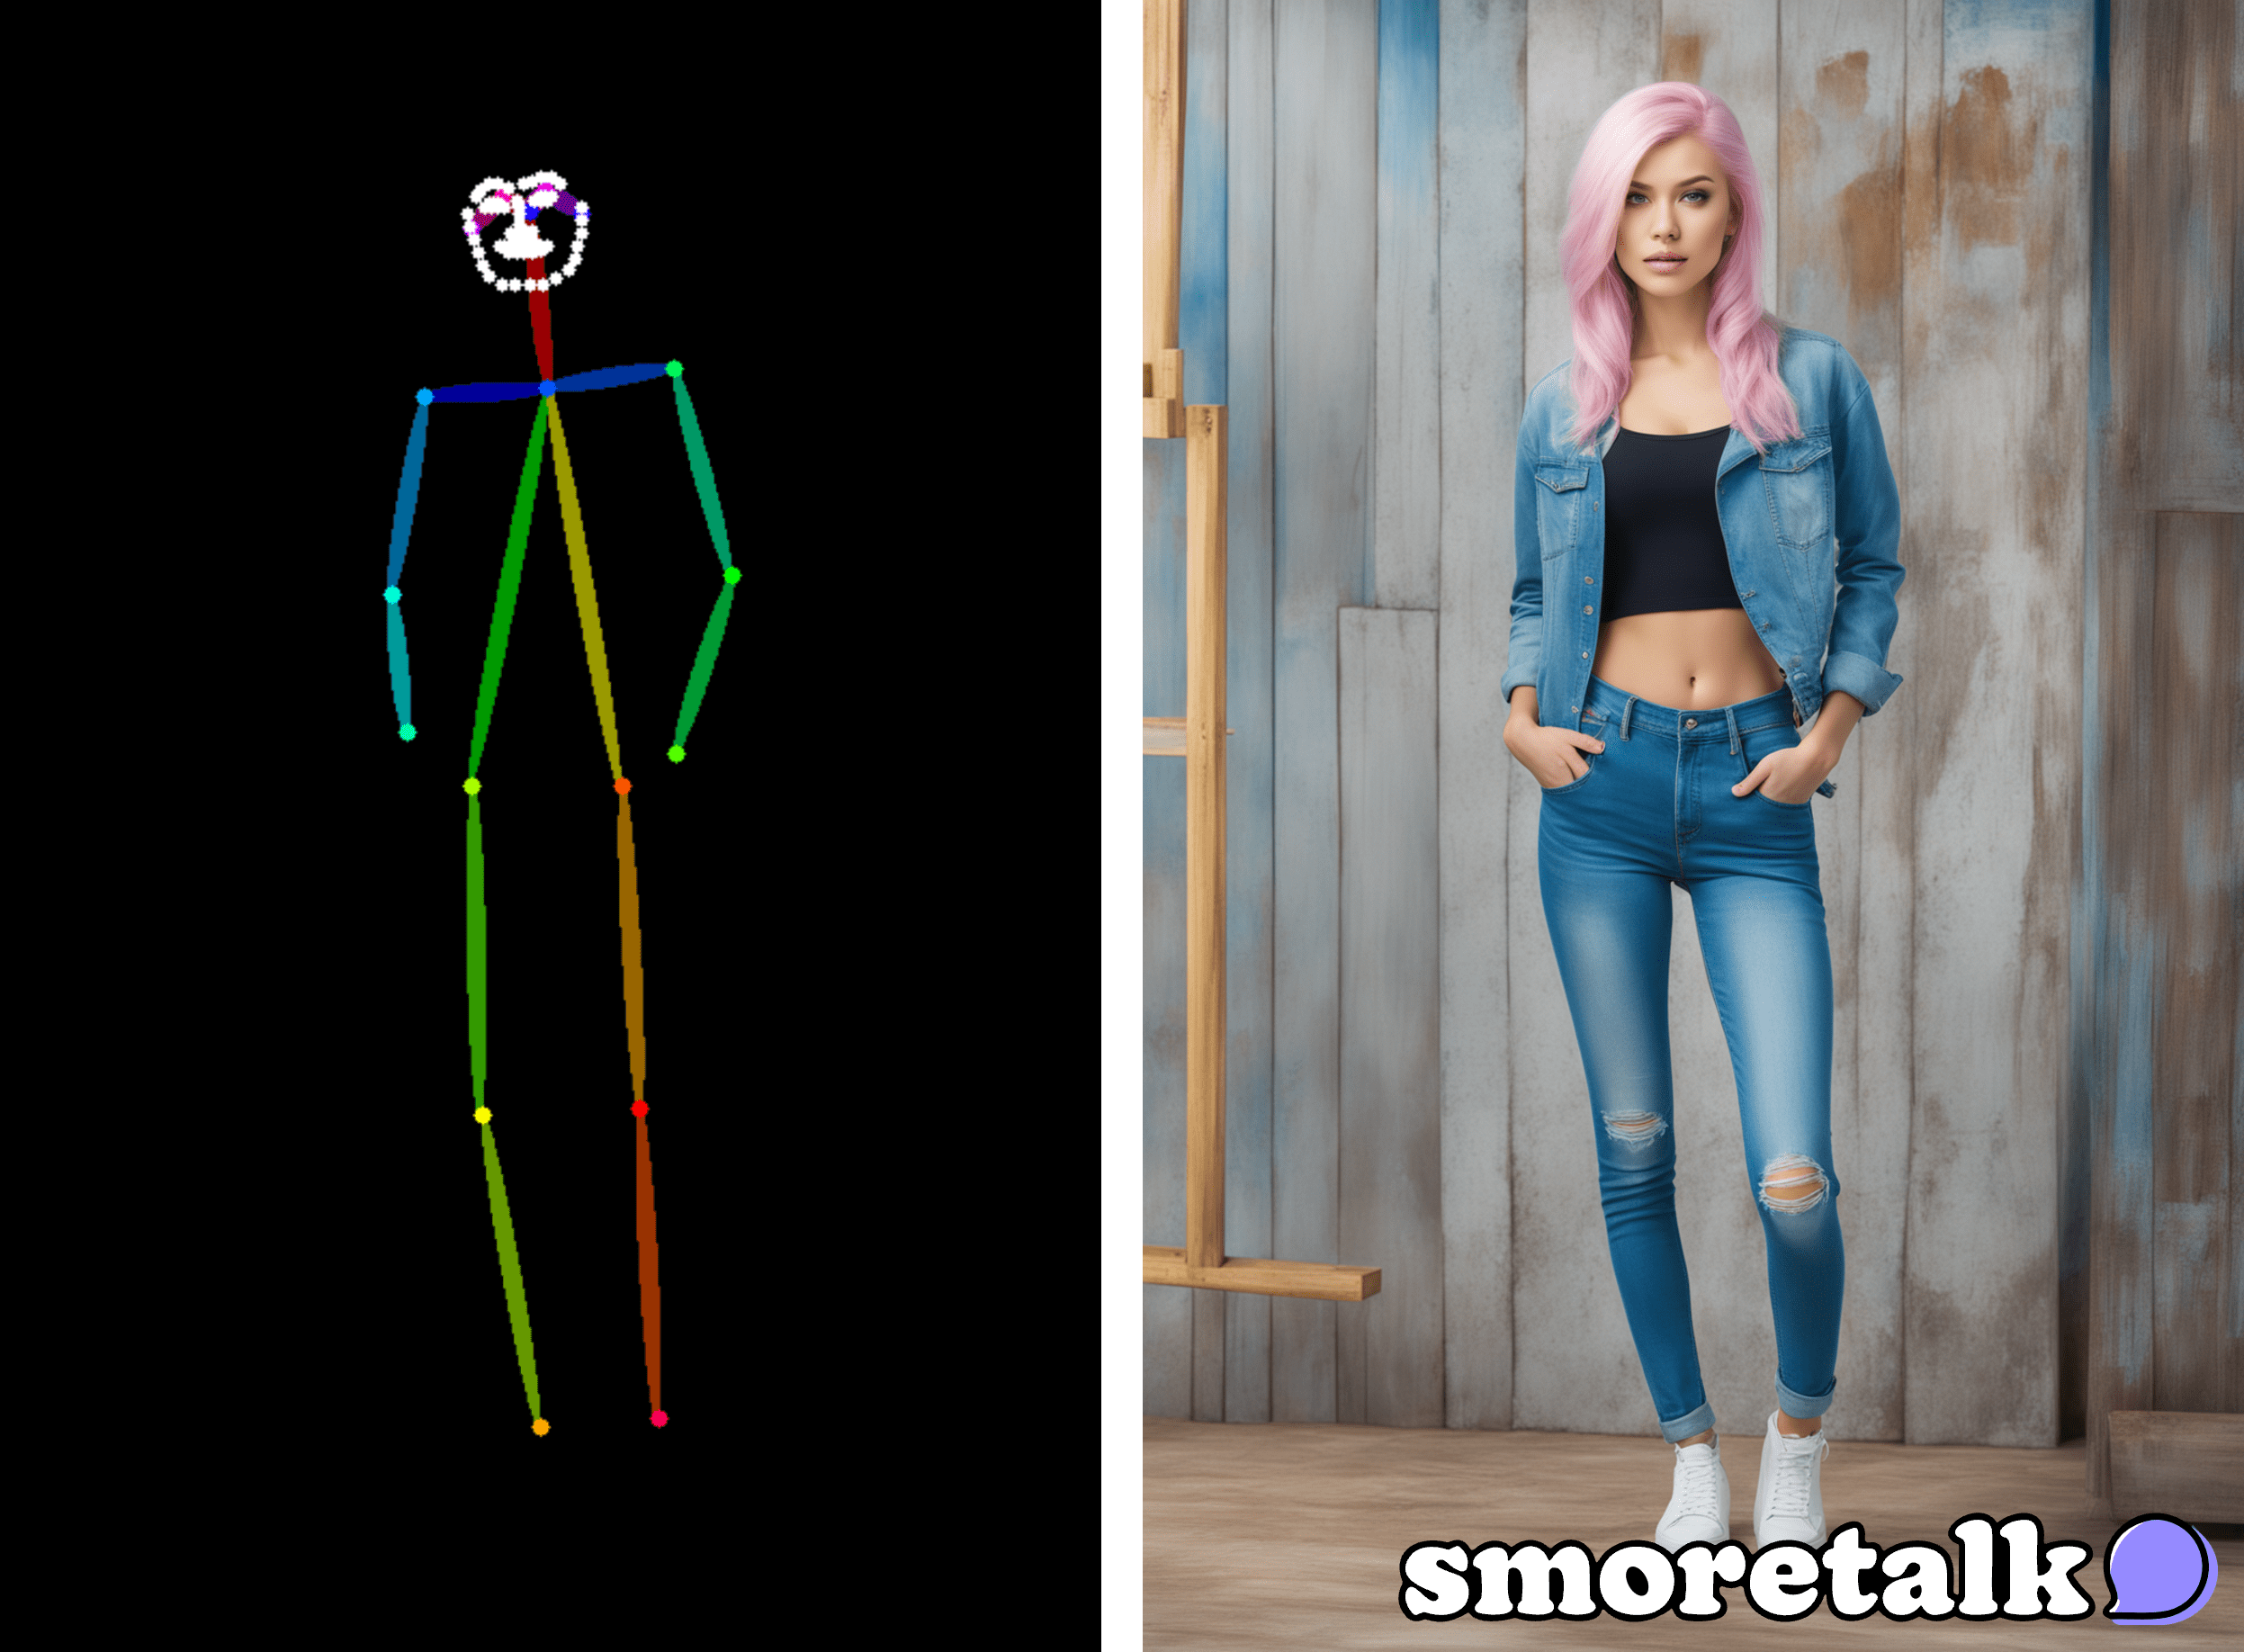
작업 구도 추출 _3 (1).png그렇게 일단 이미지 하나 완성했습니다.

다음으로 입고 있는 청자켓을 그대로 딴 마스킹 이미지가 필요합니다.

전체 이미지를 수정하는 것이 아니라 이미지 내 일부를 수정해야 하기 때문에, 수정이 필요한 영역을 지정하는 마스킹 이미지가 필요합니다.

필요한 영역의 마스킹 이미지를 생성하는 방법으로 자연어 기반 마스킹이 가능한 Grounded SAM 을 사용합니다. Grounding DINO 를 통한 자연어 기반 객체 인식, SAM 을 통한 객체 이미지 분할을 연결한 구조라고 이해하시면 될 것 같습니다.

세 가지 함수를 이용합니다. (전체 코드는 아닙니다)

# detect object using grounding DINO
def detect(image, text_prompt, model, box_threshold = 0.3, text_threshold = 0.25):
  boxes, logits, phrases = predict(
      model=model,
      image=image,
      caption=text_prompt,
      box_threshold=box_threshold,
      text_threshold=text_threshold
  )

  annotated_frame = annotate(image_source=image_source, boxes=boxes, logits=logits, phrases=phrases)
  annotated_frame = annotated_frame[...,::-1] # BGR to RGB
  return annotated_frame, boxes

# segment object with SAM
def segment(image, sam_model, boxes):
  sam_model.set_image(image)
  H, W, _ = image.shape
  boxes_xyxy = box_ops.box_cxcywh_to_xyxy(boxes) * torch.Tensor([W, H, W, H])

  transformed_boxes = sam_model.transform.apply_boxes_torch(boxes_xyxy.to(device), image.shape[:2])
  masks, _, _ = sam_model.predict_torch(
      point_coords = None,
      point_labels = None,
      boxes = transformed_boxes,
      multimask_output = False,
      )
  return masks.cpu()

# Make masking image based on the result of SAM
def draw_mask(mask, image, random_color=True):
    if random_color:
        color = np.concatenate([np.random.random(3), np.array([0.8])], axis=0)
    else:
        color = np.array([30/255, 144/255, 255/255, 0.6])
    h, w = mask.shape[-2:]
    mask_image = mask.reshape(h, w, 1) * color.reshape(1, 1, -1)

    annotated_frame_pil = Image.fromarray(image).convert("RGBA")
    mask_image_pil = Image.fromarray((mask_image.cpu().numpy() * 255).astype(np.uint8)).convert("RGBA")

    return np.array(Image.alpha_composite(annotated_frame_pil, mask_image_pil))

그러면 아래와 같이 'jacket' 을 입력했을 때 자켓의 이미지만 분할 되는 모습을 확인하실 수 있습니다.
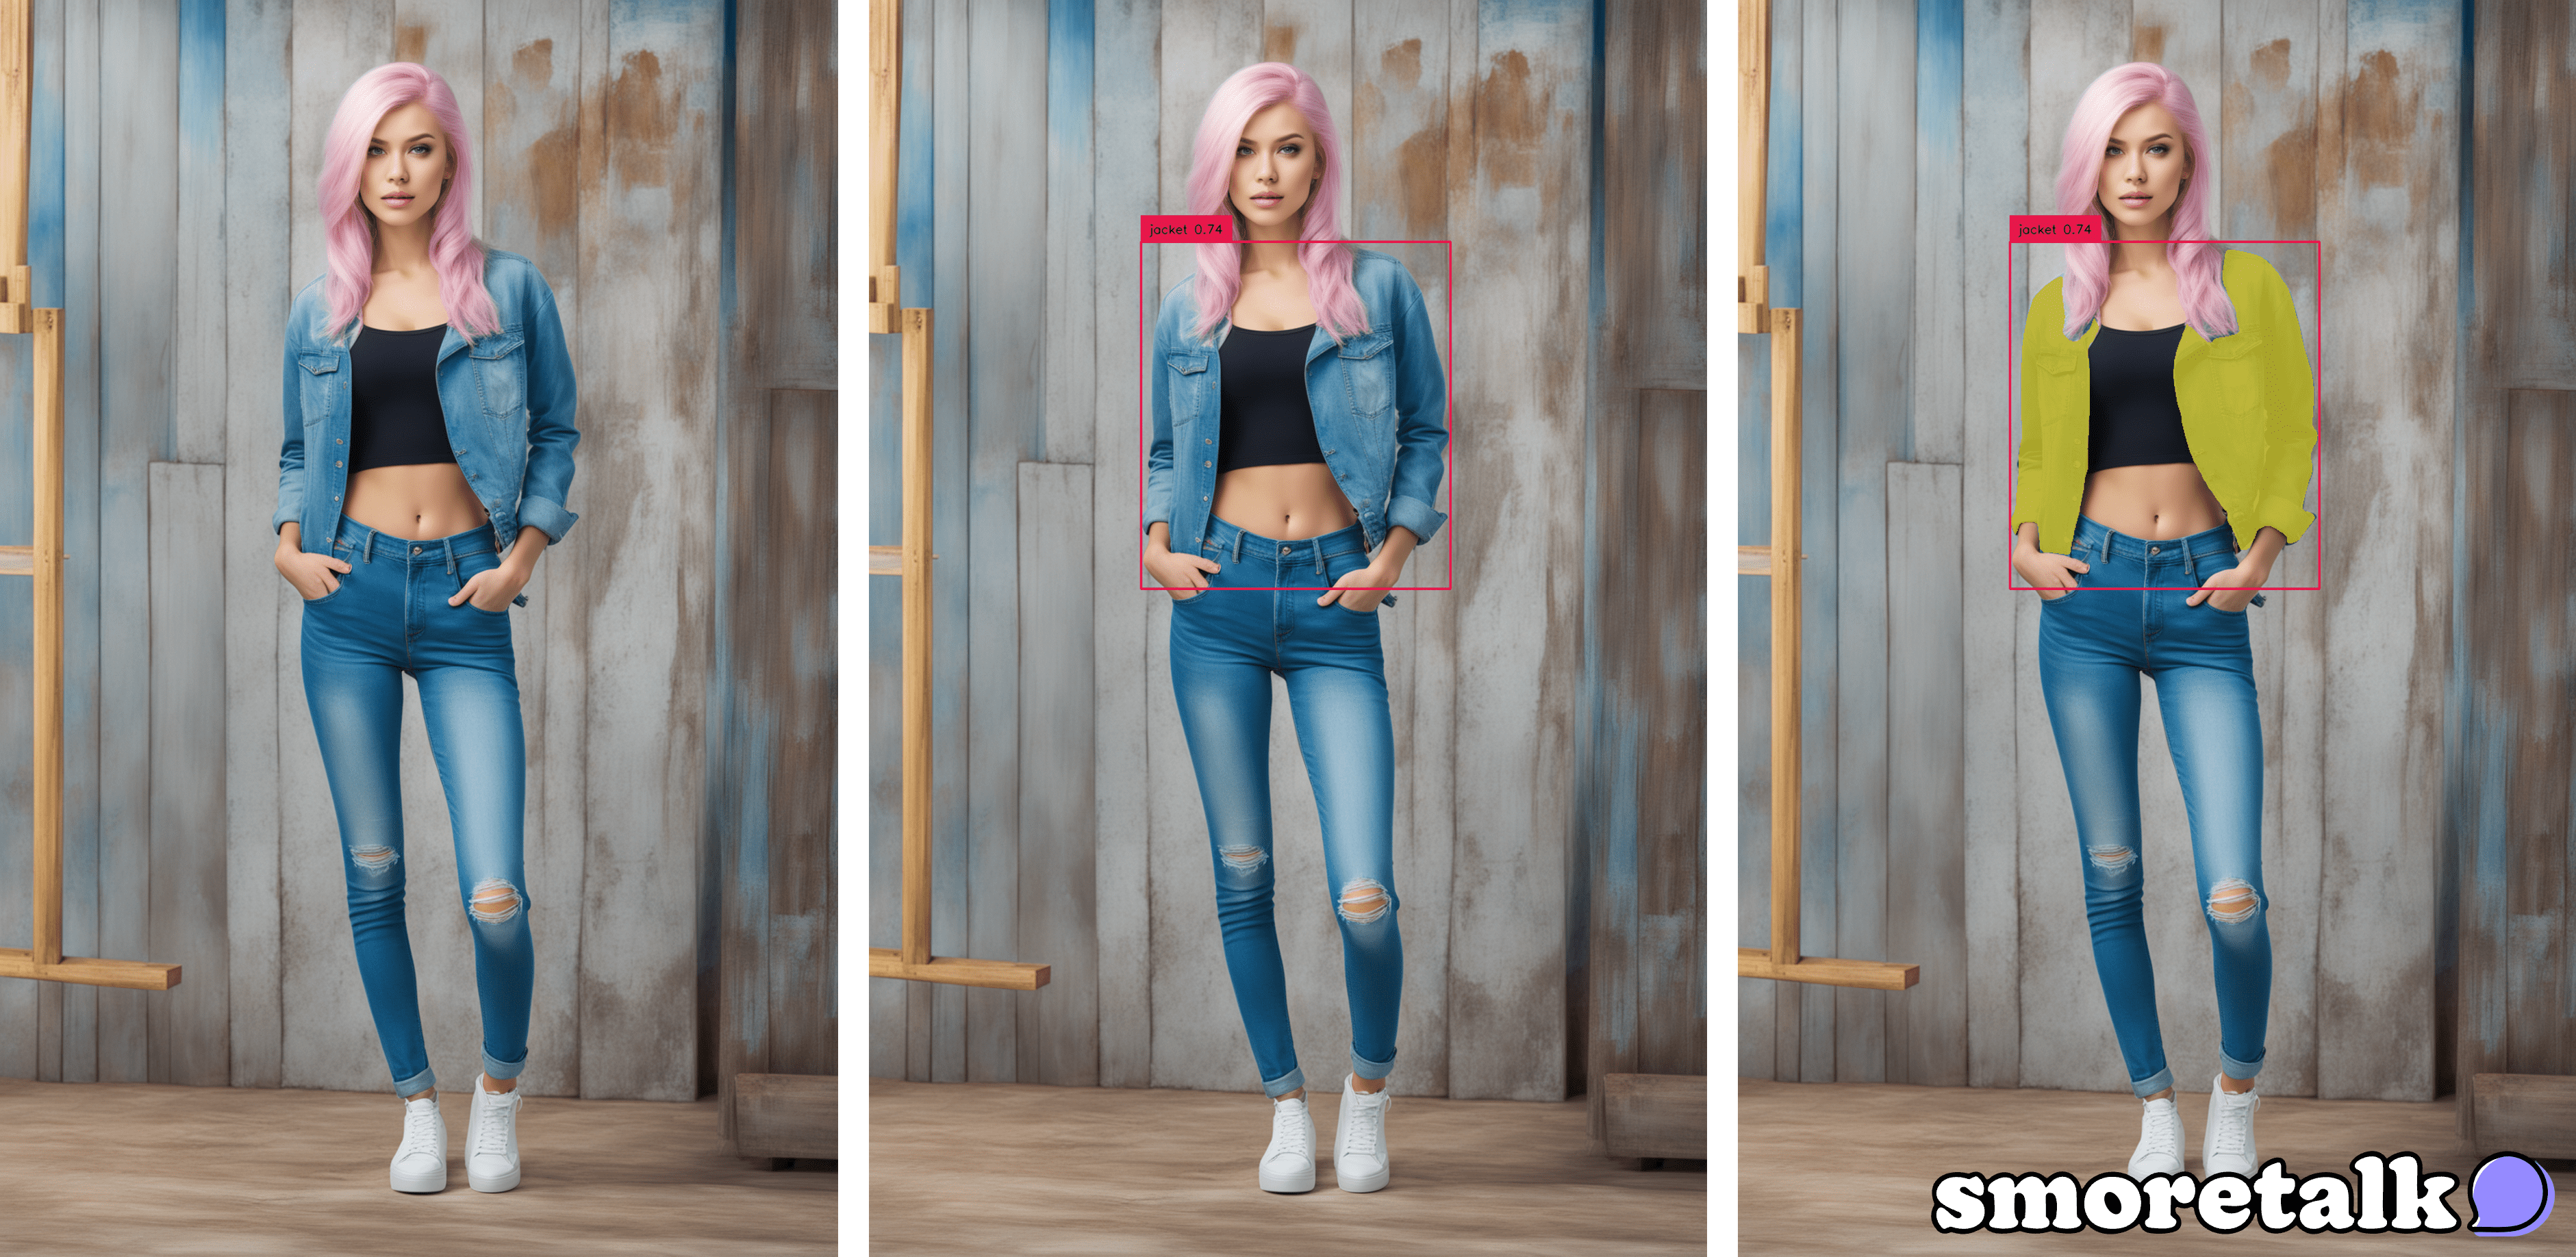
작업 구도 마스킹 2 (1).png

그리고 마스킹 이미지를 만들어야 합니다.

mask = segmented_frame_masks[0][0].cpu().numpy()
image_mask_pil = Image.fromarray(mask)

(중요) 참고로 마스킹 이미지의 의미는 하얀색 부분이 수정하는 영역, 검은색 부분이 고정되는 영역입니다.
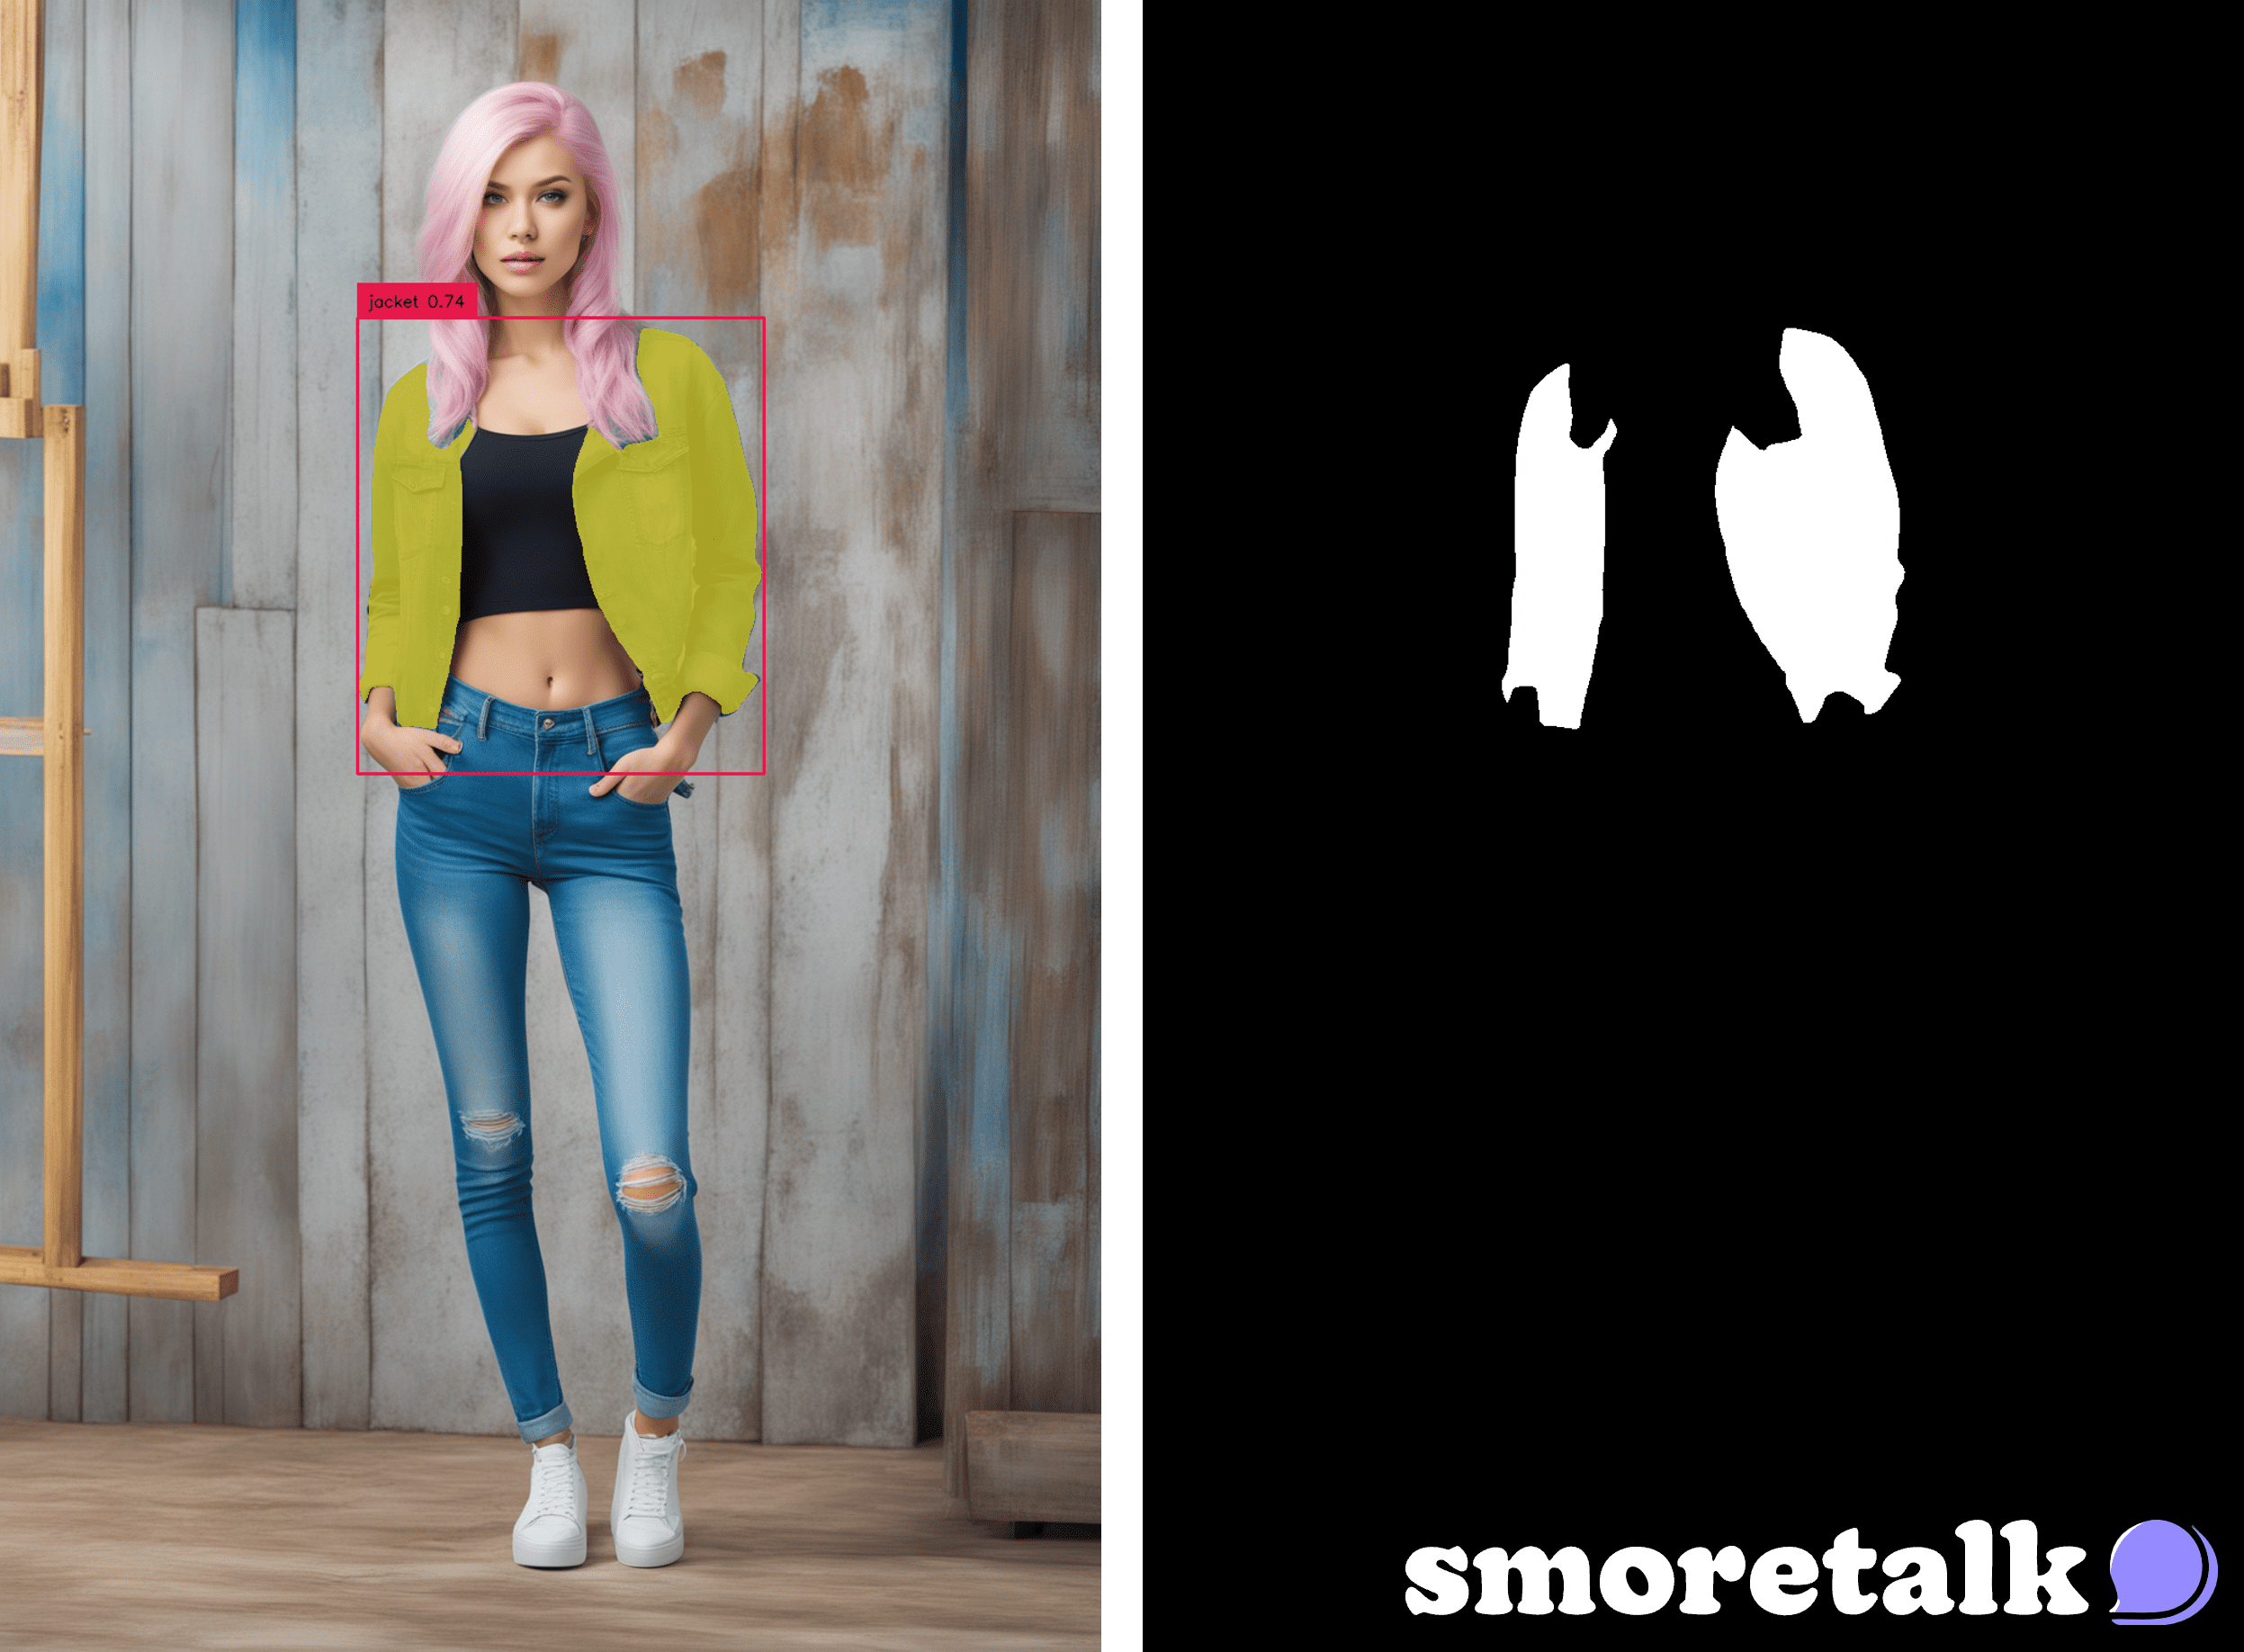
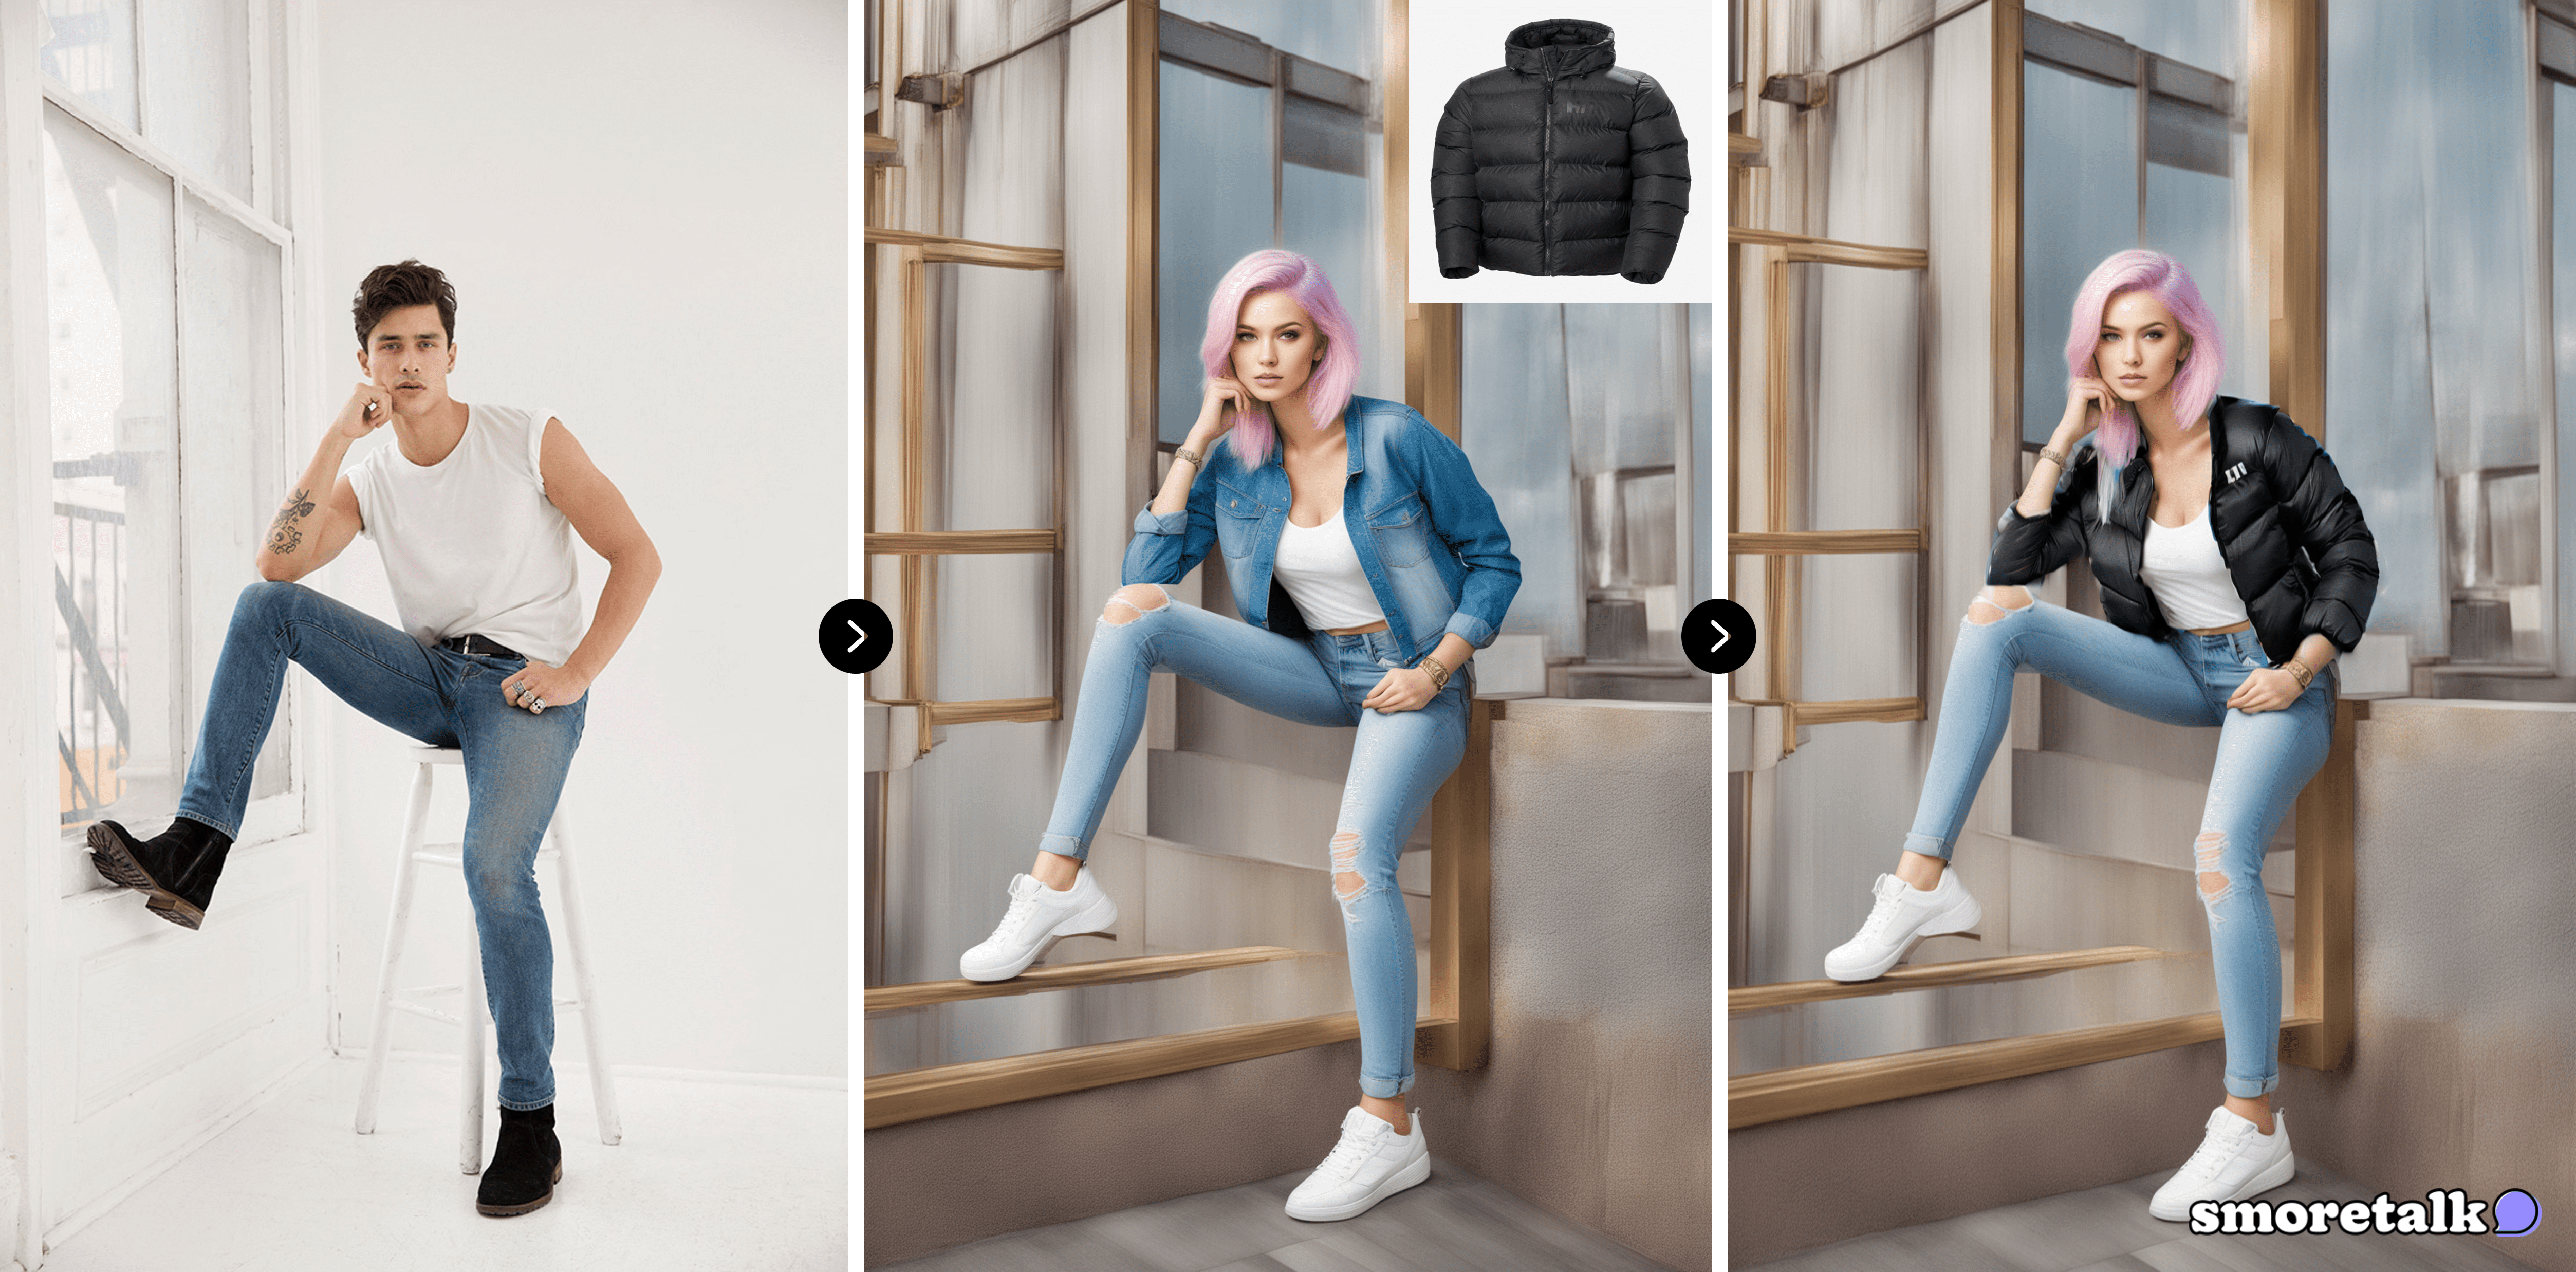
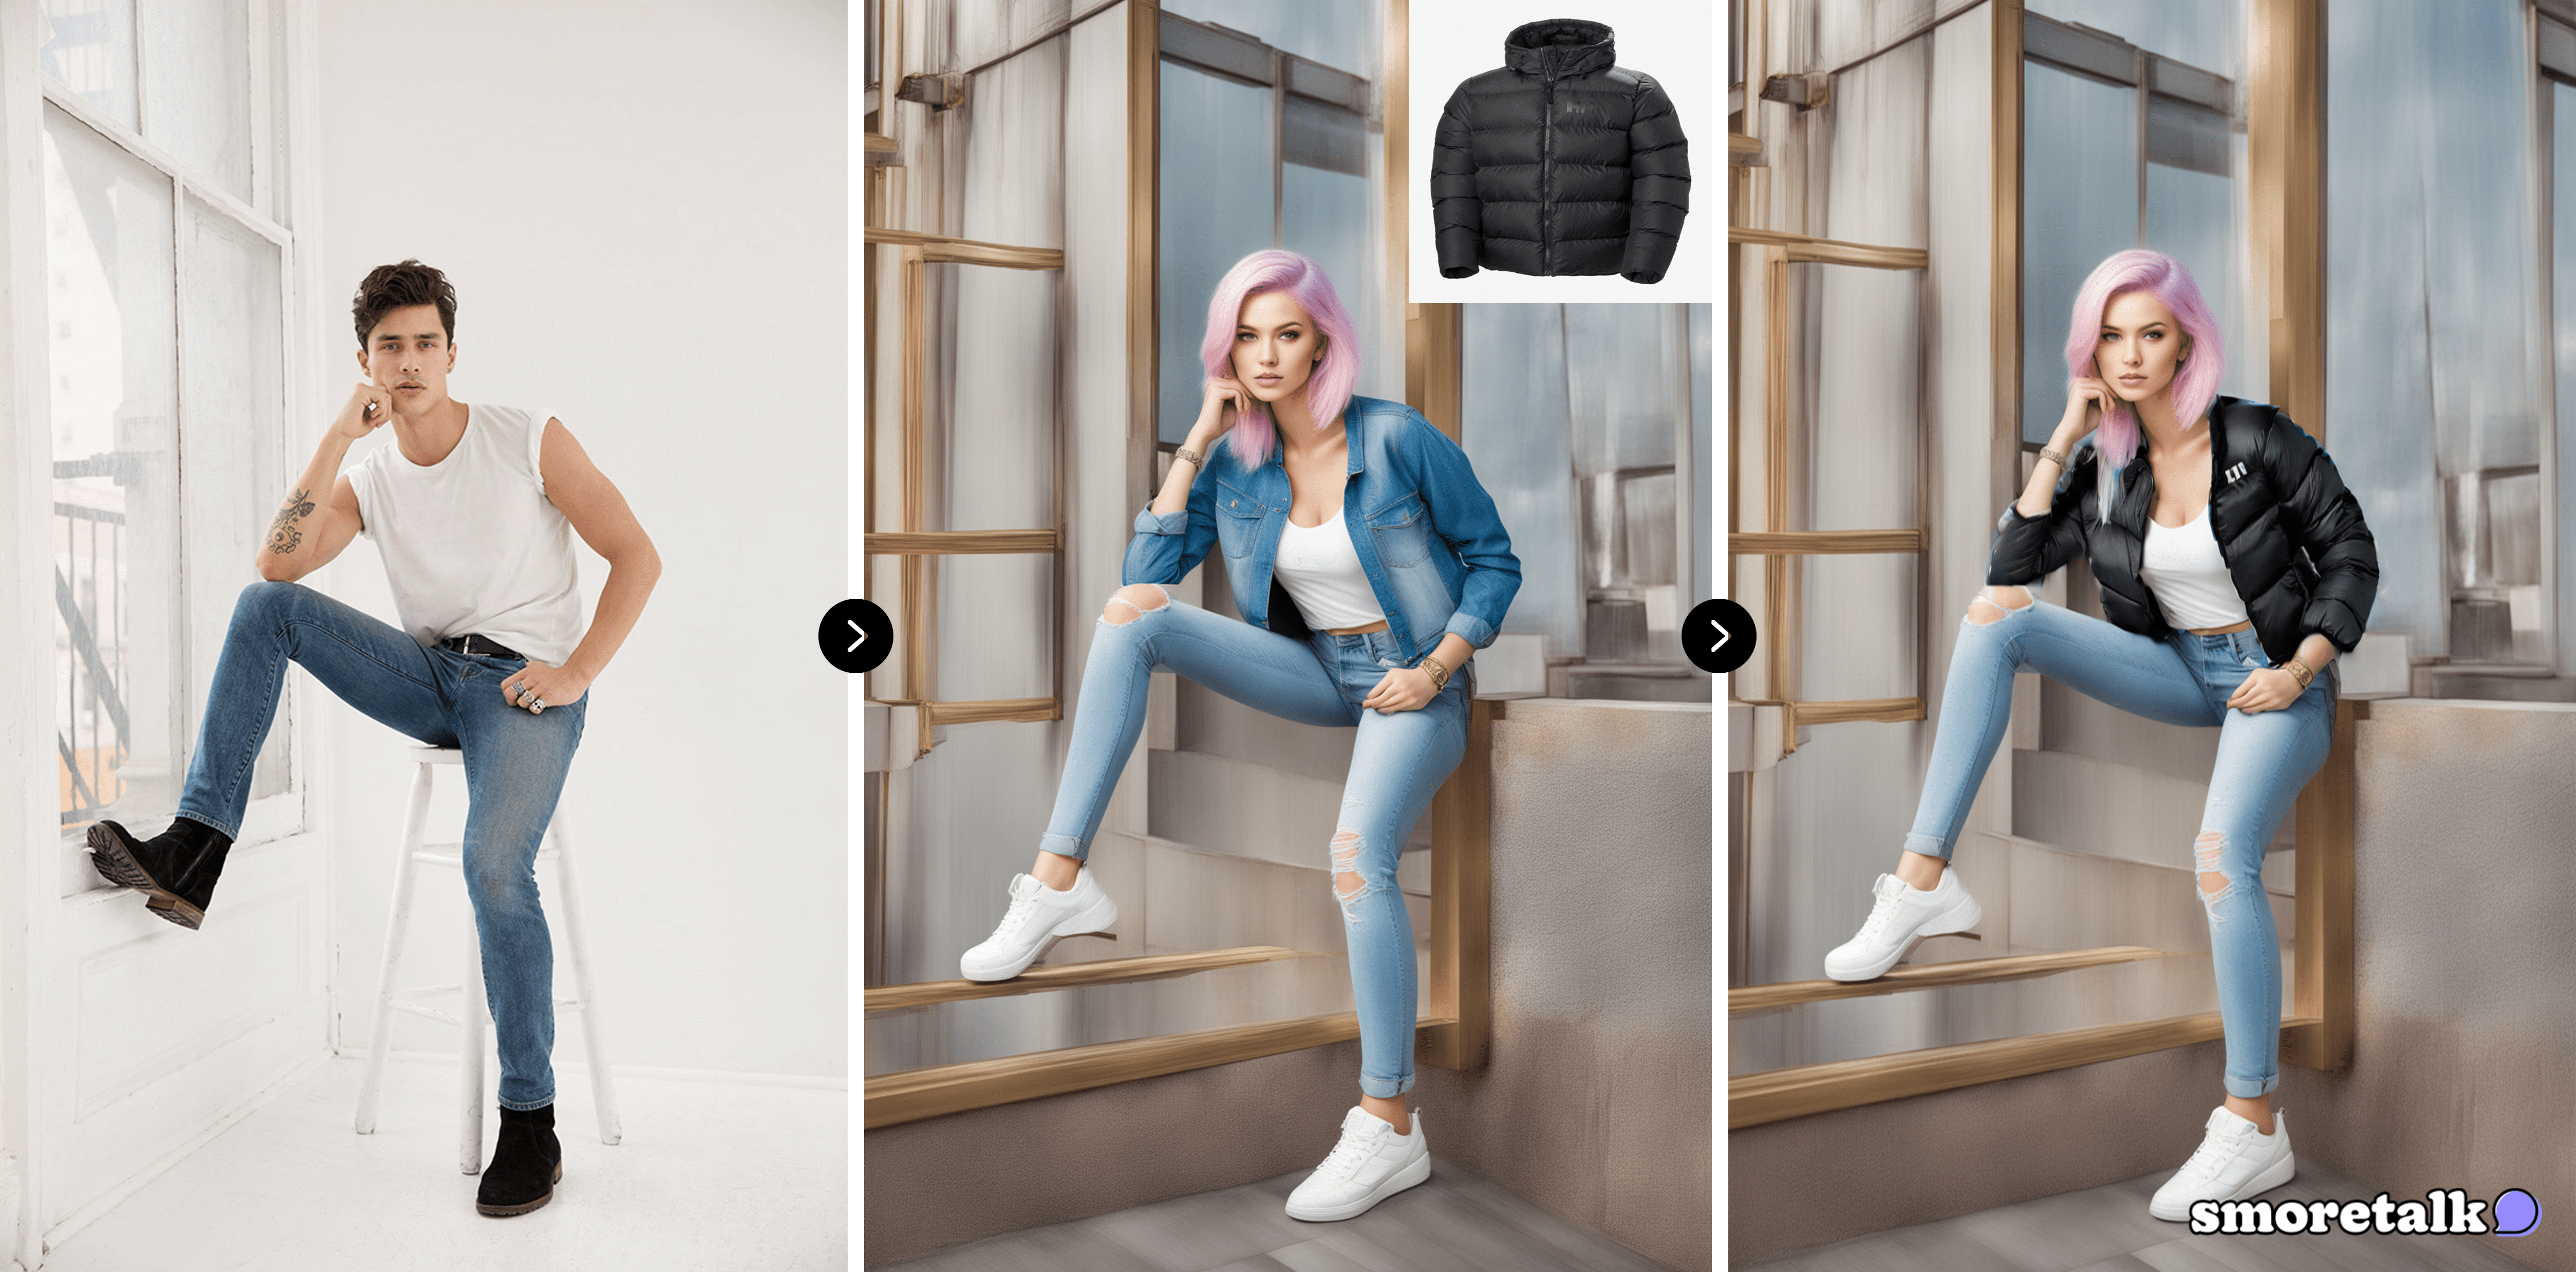
작업 구도 마스킹 3 (1).png그렇게 마스킹 이미지도 확보했습니다.

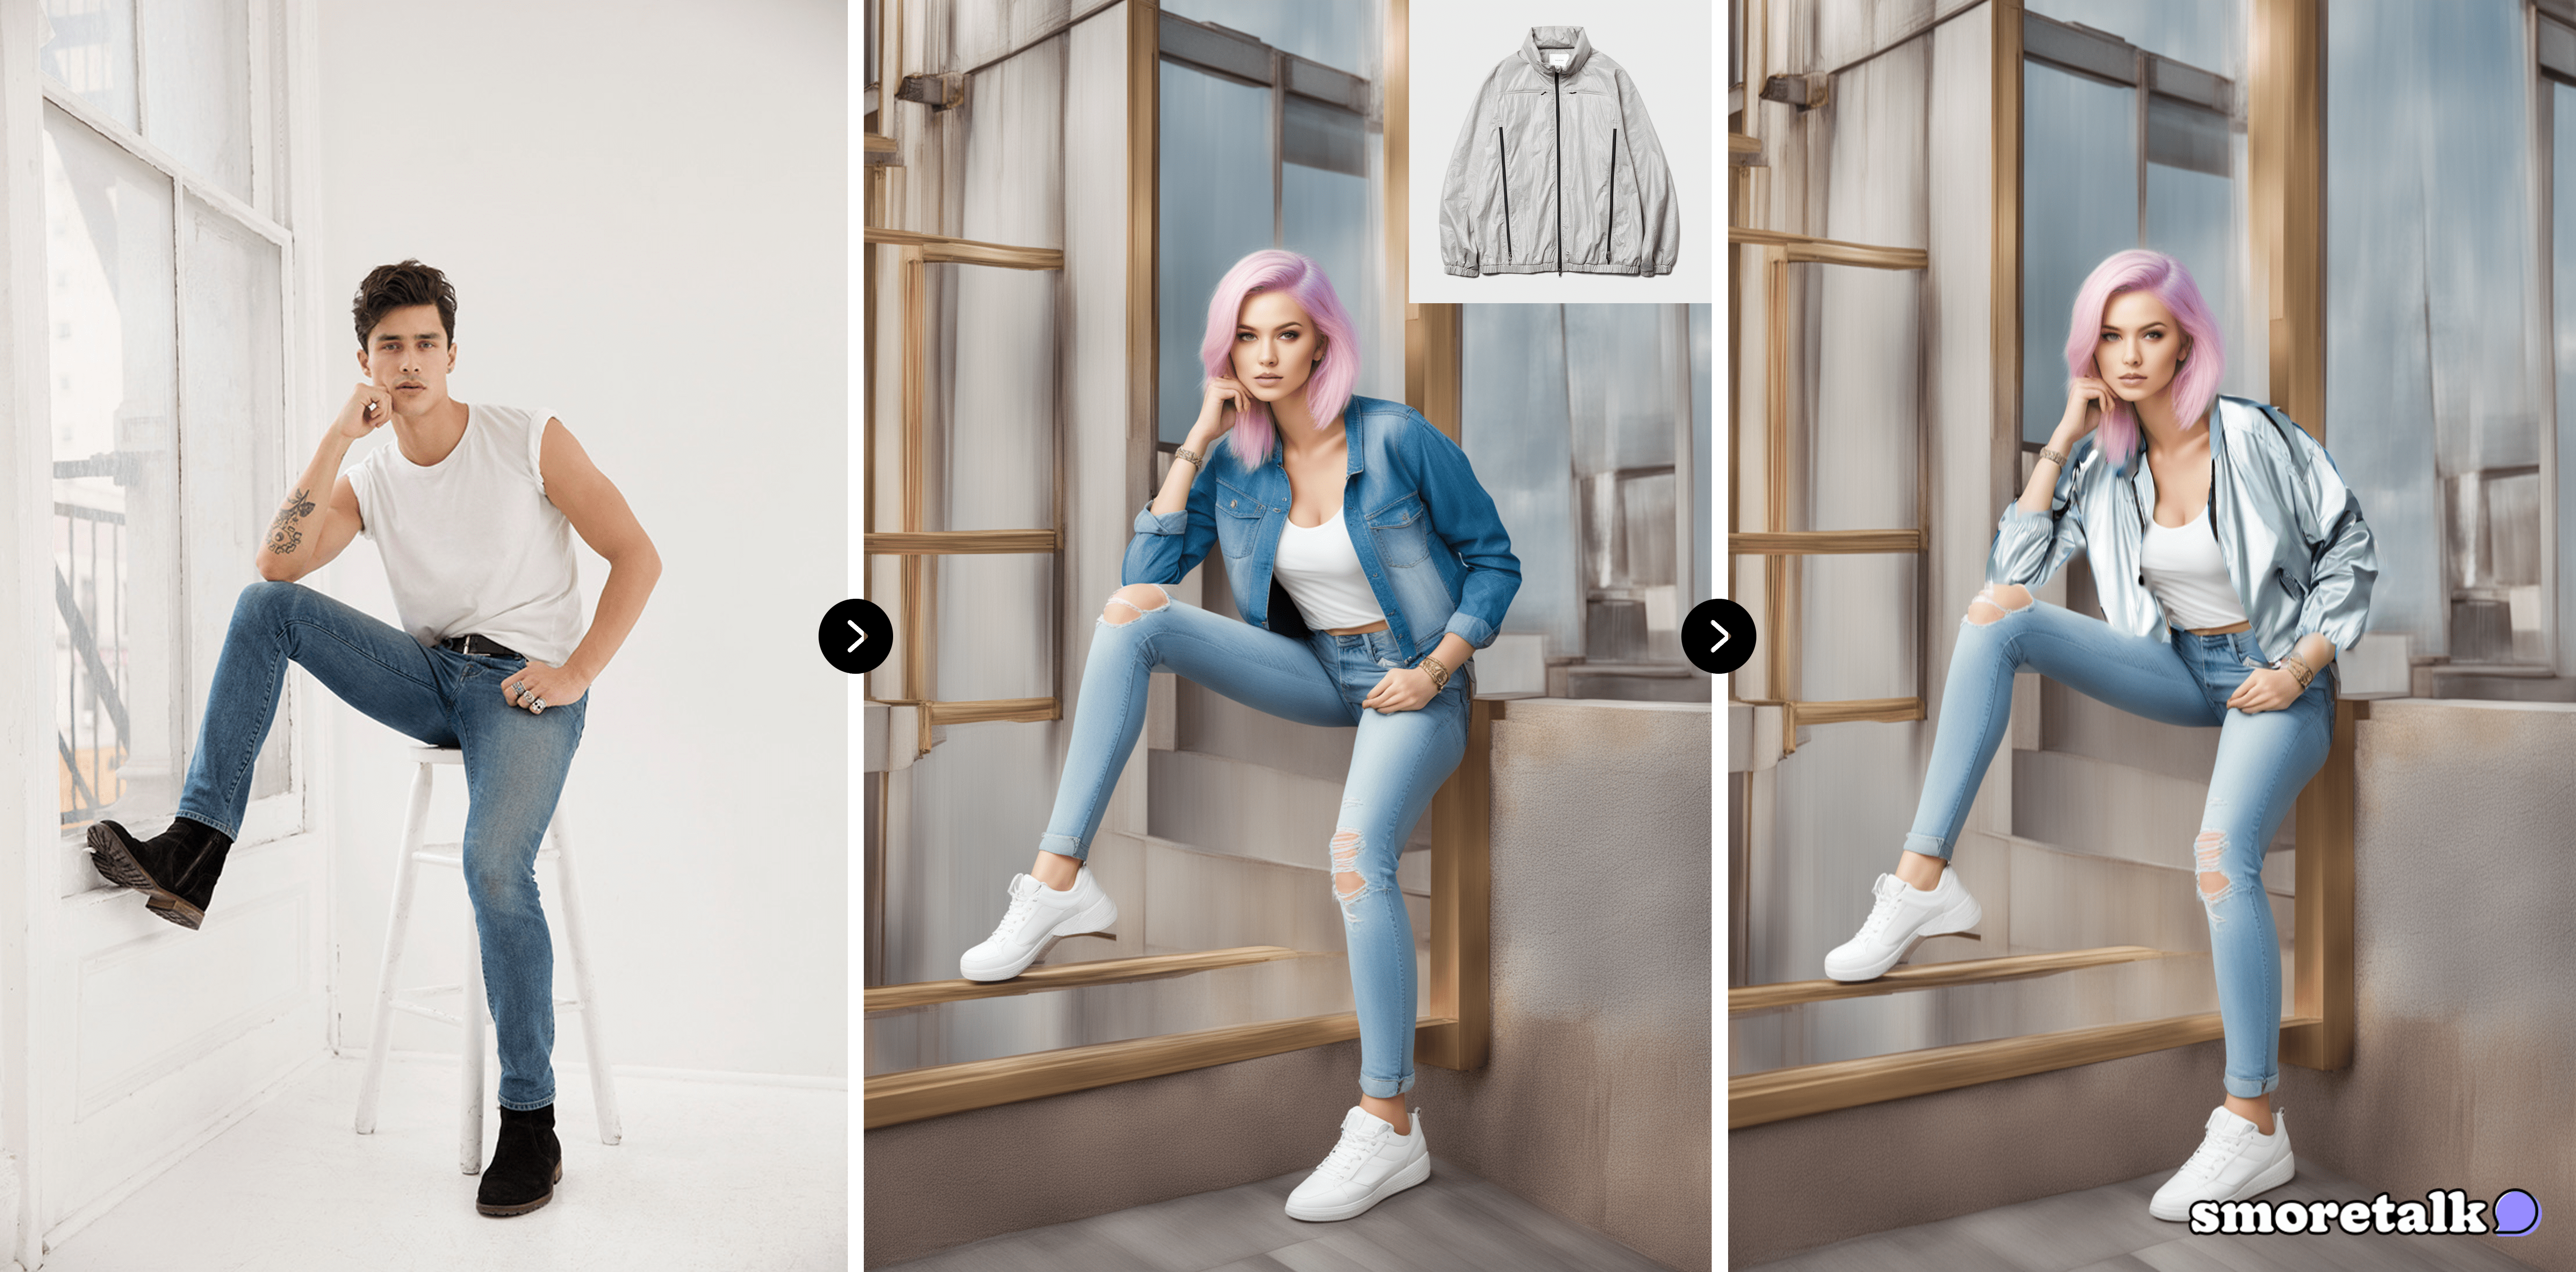
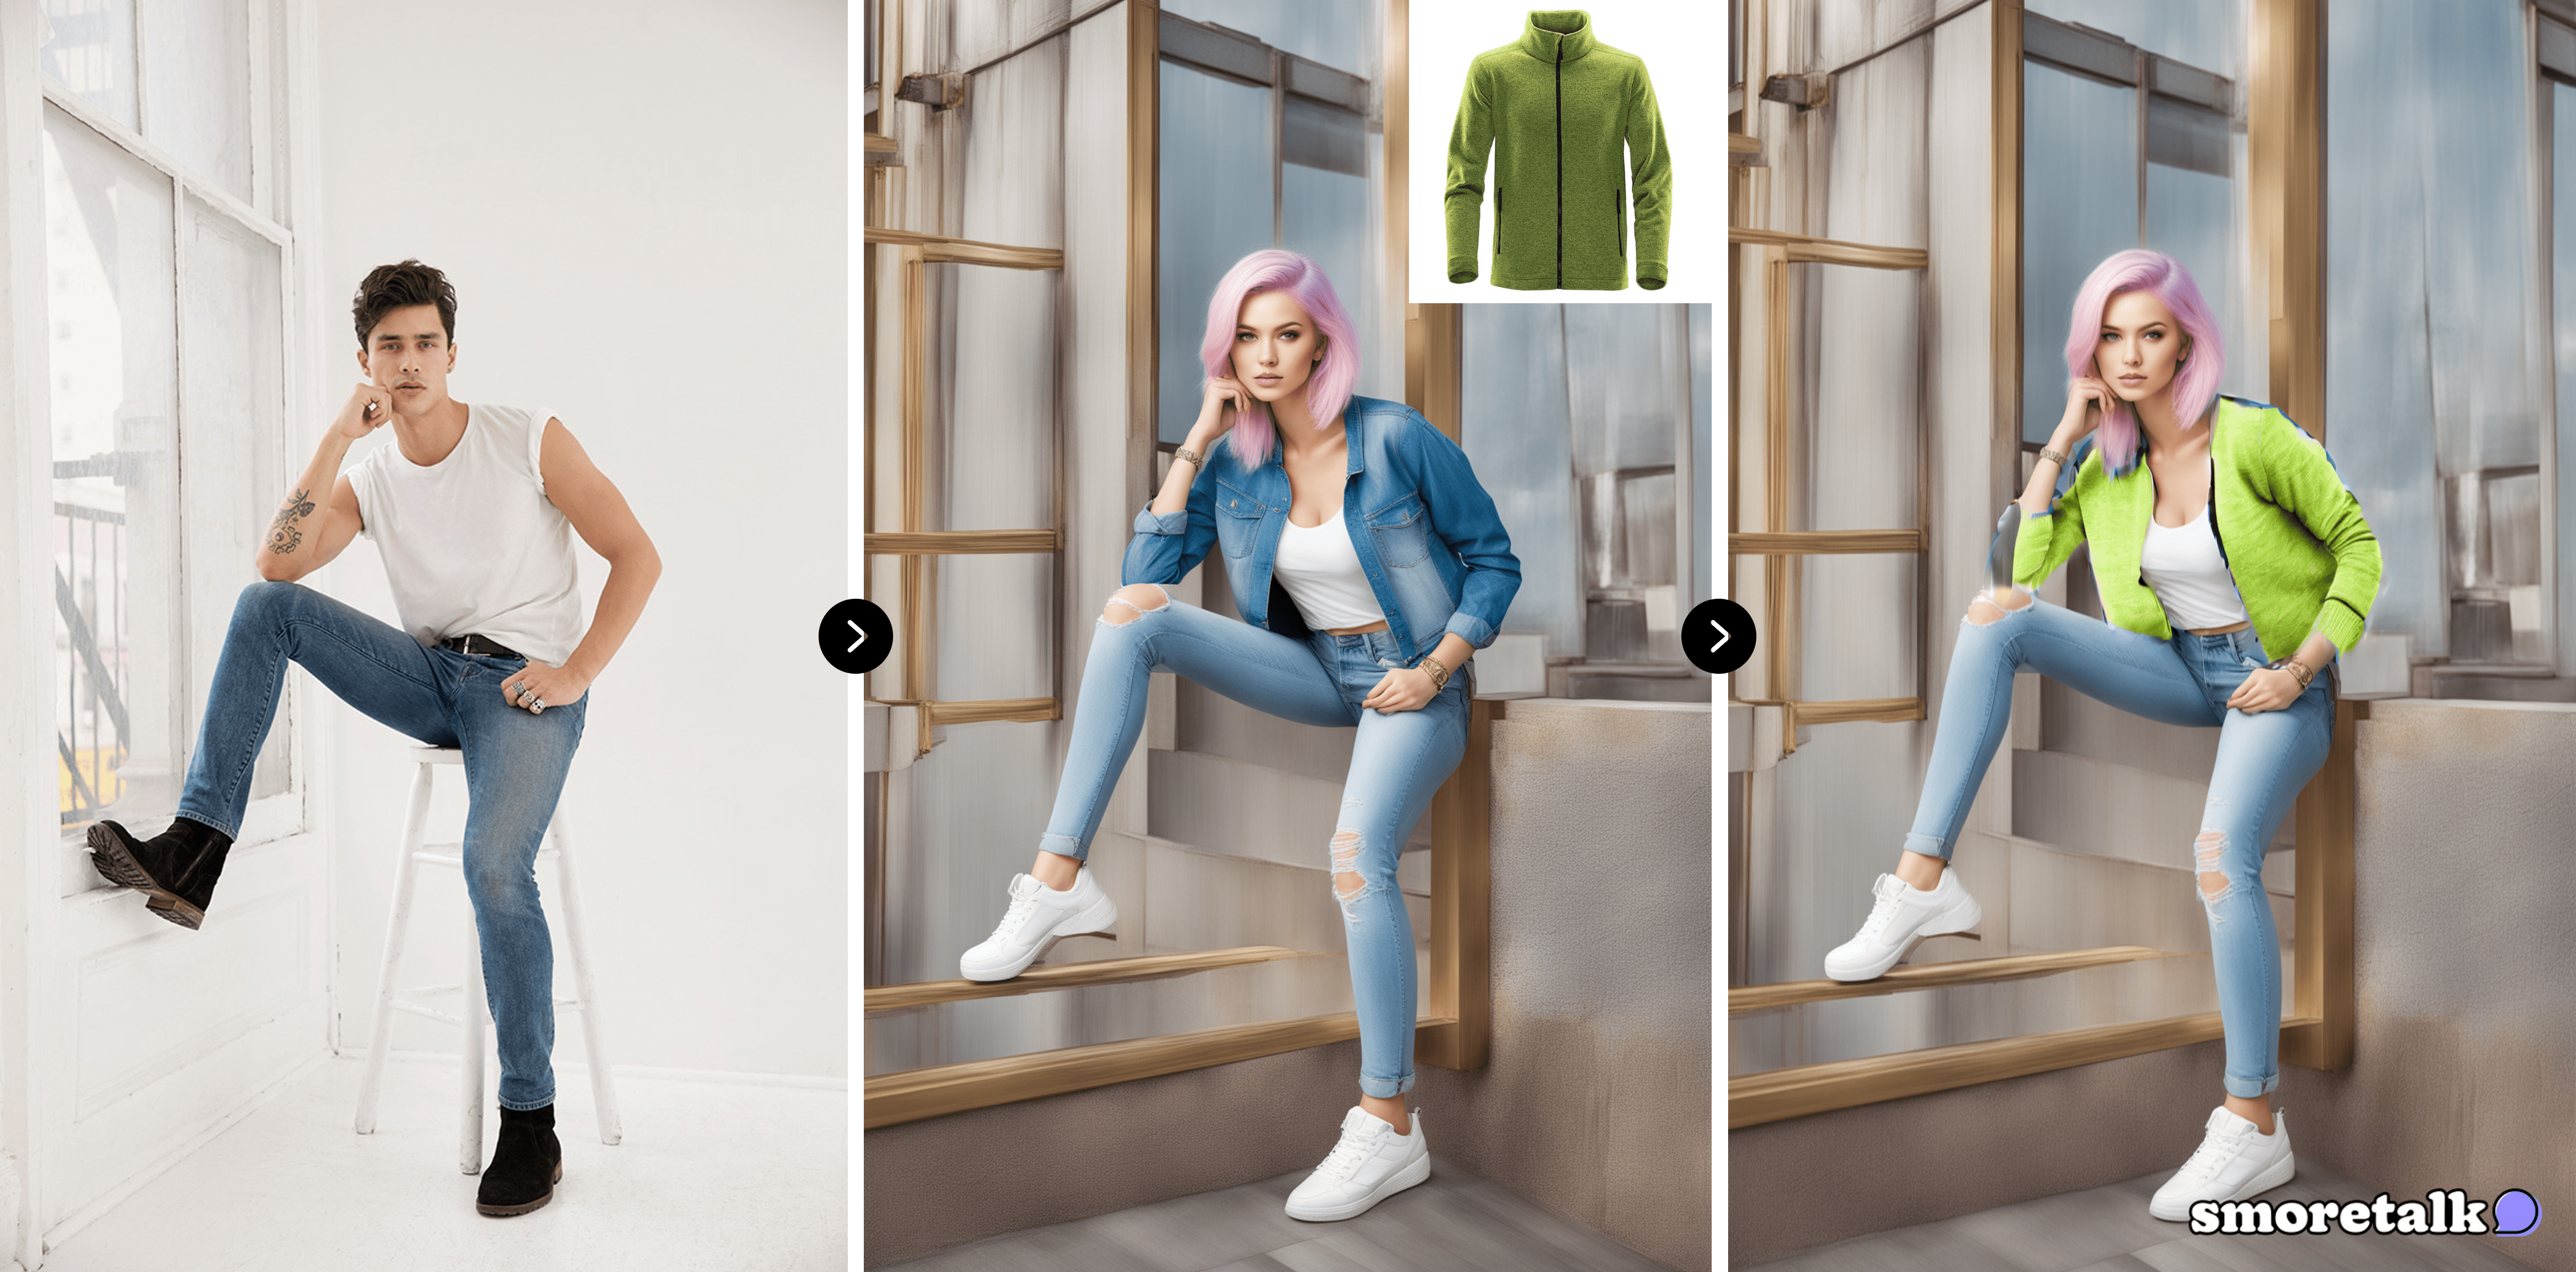
마지막으로 입고 있는 청자켓을 다른 자켓 이미지로 수정합니다.

저는 가상의 옷이 아니라 실제 가지고 있는 옷을 그대로 반영하는 것을 원하기 때문에, 기존의 이미지 입력 방식으로는 한계가 있습니다. 학습을 하자니 시간과 필요한 이미지가 많이 필요한 것이 문제입니다.

그래서 있는 옷 이미지를 그대로 집어 넣어주고자 이미지 방식의 프롬프팅 효율성을 극대화한 IP Adapter 를 사용합니다. (전체 코드는 아닙니다)

image_encoder_path = "/content/h94/sdxl_models/image_encoder"
ip_ckpt = "/content/h94/sdxl_models/ip-adapter_sdxl.bin"

ip_model2 = IPAdapterXL(pipe2, image_encoder_path, ip_ckpt, device="cuda")

# save the width and height
width, height = image_source_pil.size

# resize for inpainting
image_source_pil = image_source_pil.resize((1024, 1024))
image_mask_pil = image_mask_pil.resize((1024, 1024))

# Upload an image of clothes
new_clothes_image = Image.open("/content/drive/MyDrive/{image_file}")
new_clothes_image.resize((1024, 1024))

# Generate an image with IP Adapter
final_images = ip_model2.generate(pil_image=new_clothes_image, prompt="best quality", negative_prompt=negative_prompt, image=image_source_pil, mask_image=image_mask_pil, num_inference_steps=60, strength=0.95)
final_image = final_images[0].resize((width, height))

아래 이미지는 순서대로 코드 내 image_source_pil, image_mask_pil, final_image 입니다.

패딩 이미지는 코드 내 new_clothes_image 에 해당하고요.
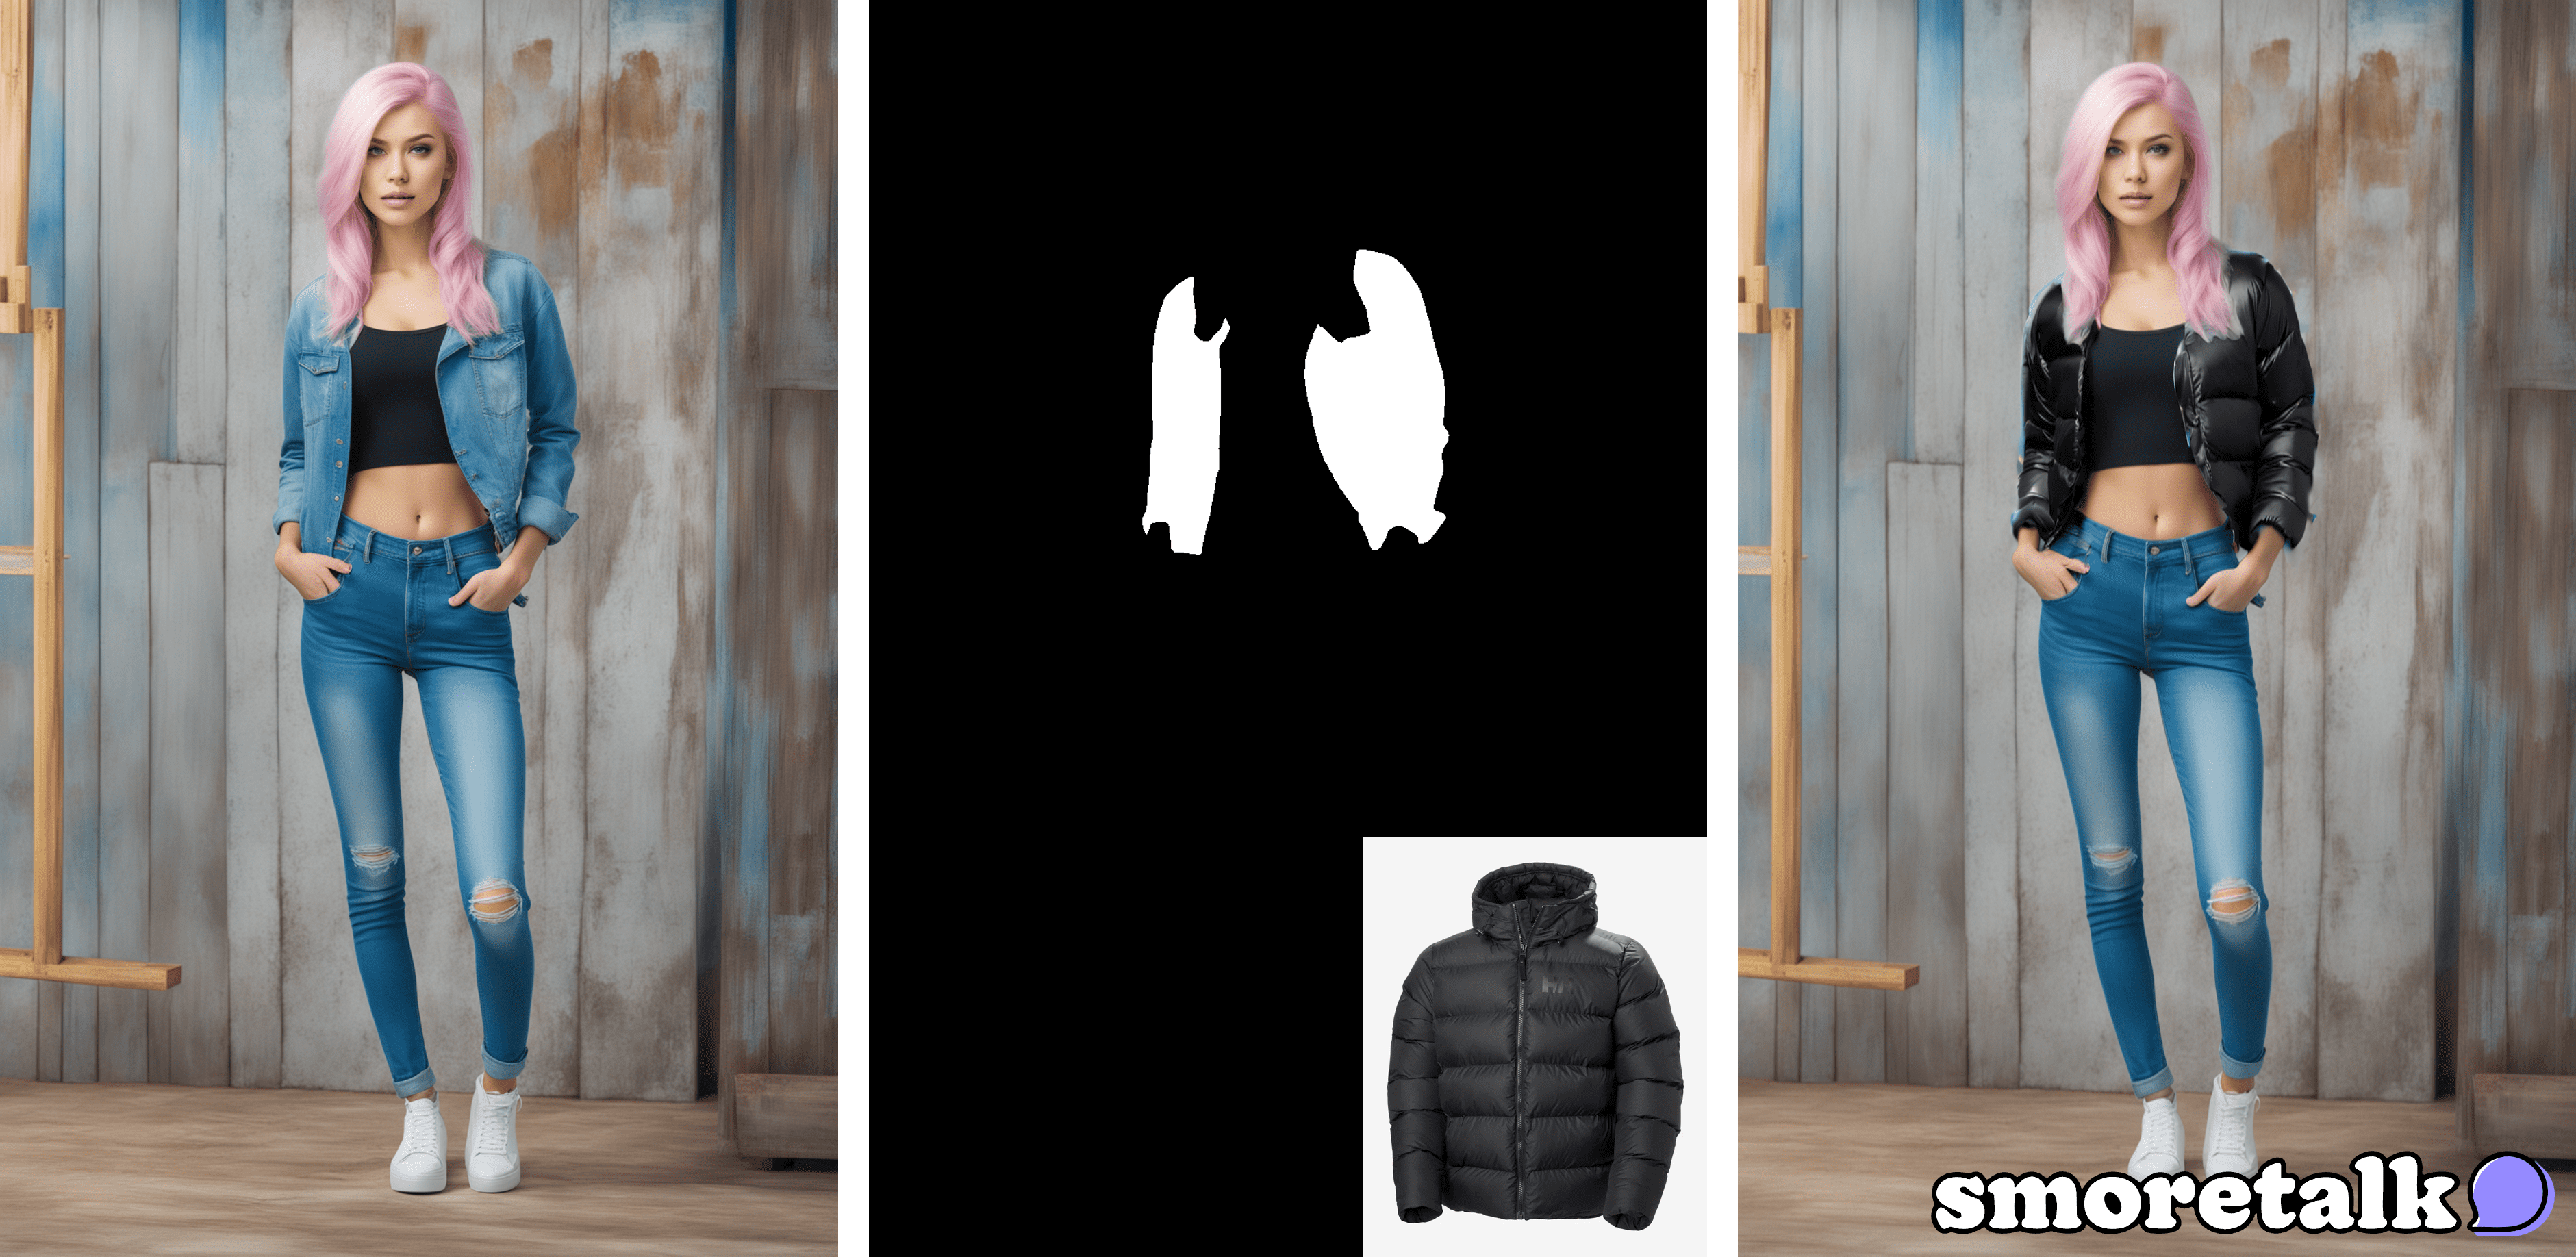
작업 결과 (1).png

그래서 나온 이미지를 다시 크게 살펴보면,

작업 결과 2 (1).png

패딩 이미지가 꽤나 잘 반영된 이미지가 나오는 것을 확인할 수 있습니다.

사실 새로운 모델 이미지를 사용하지 않아도 됩니다.

첫 단계를 생략하고 진행하면 아래와 같은 이미지가 만들어집니다.
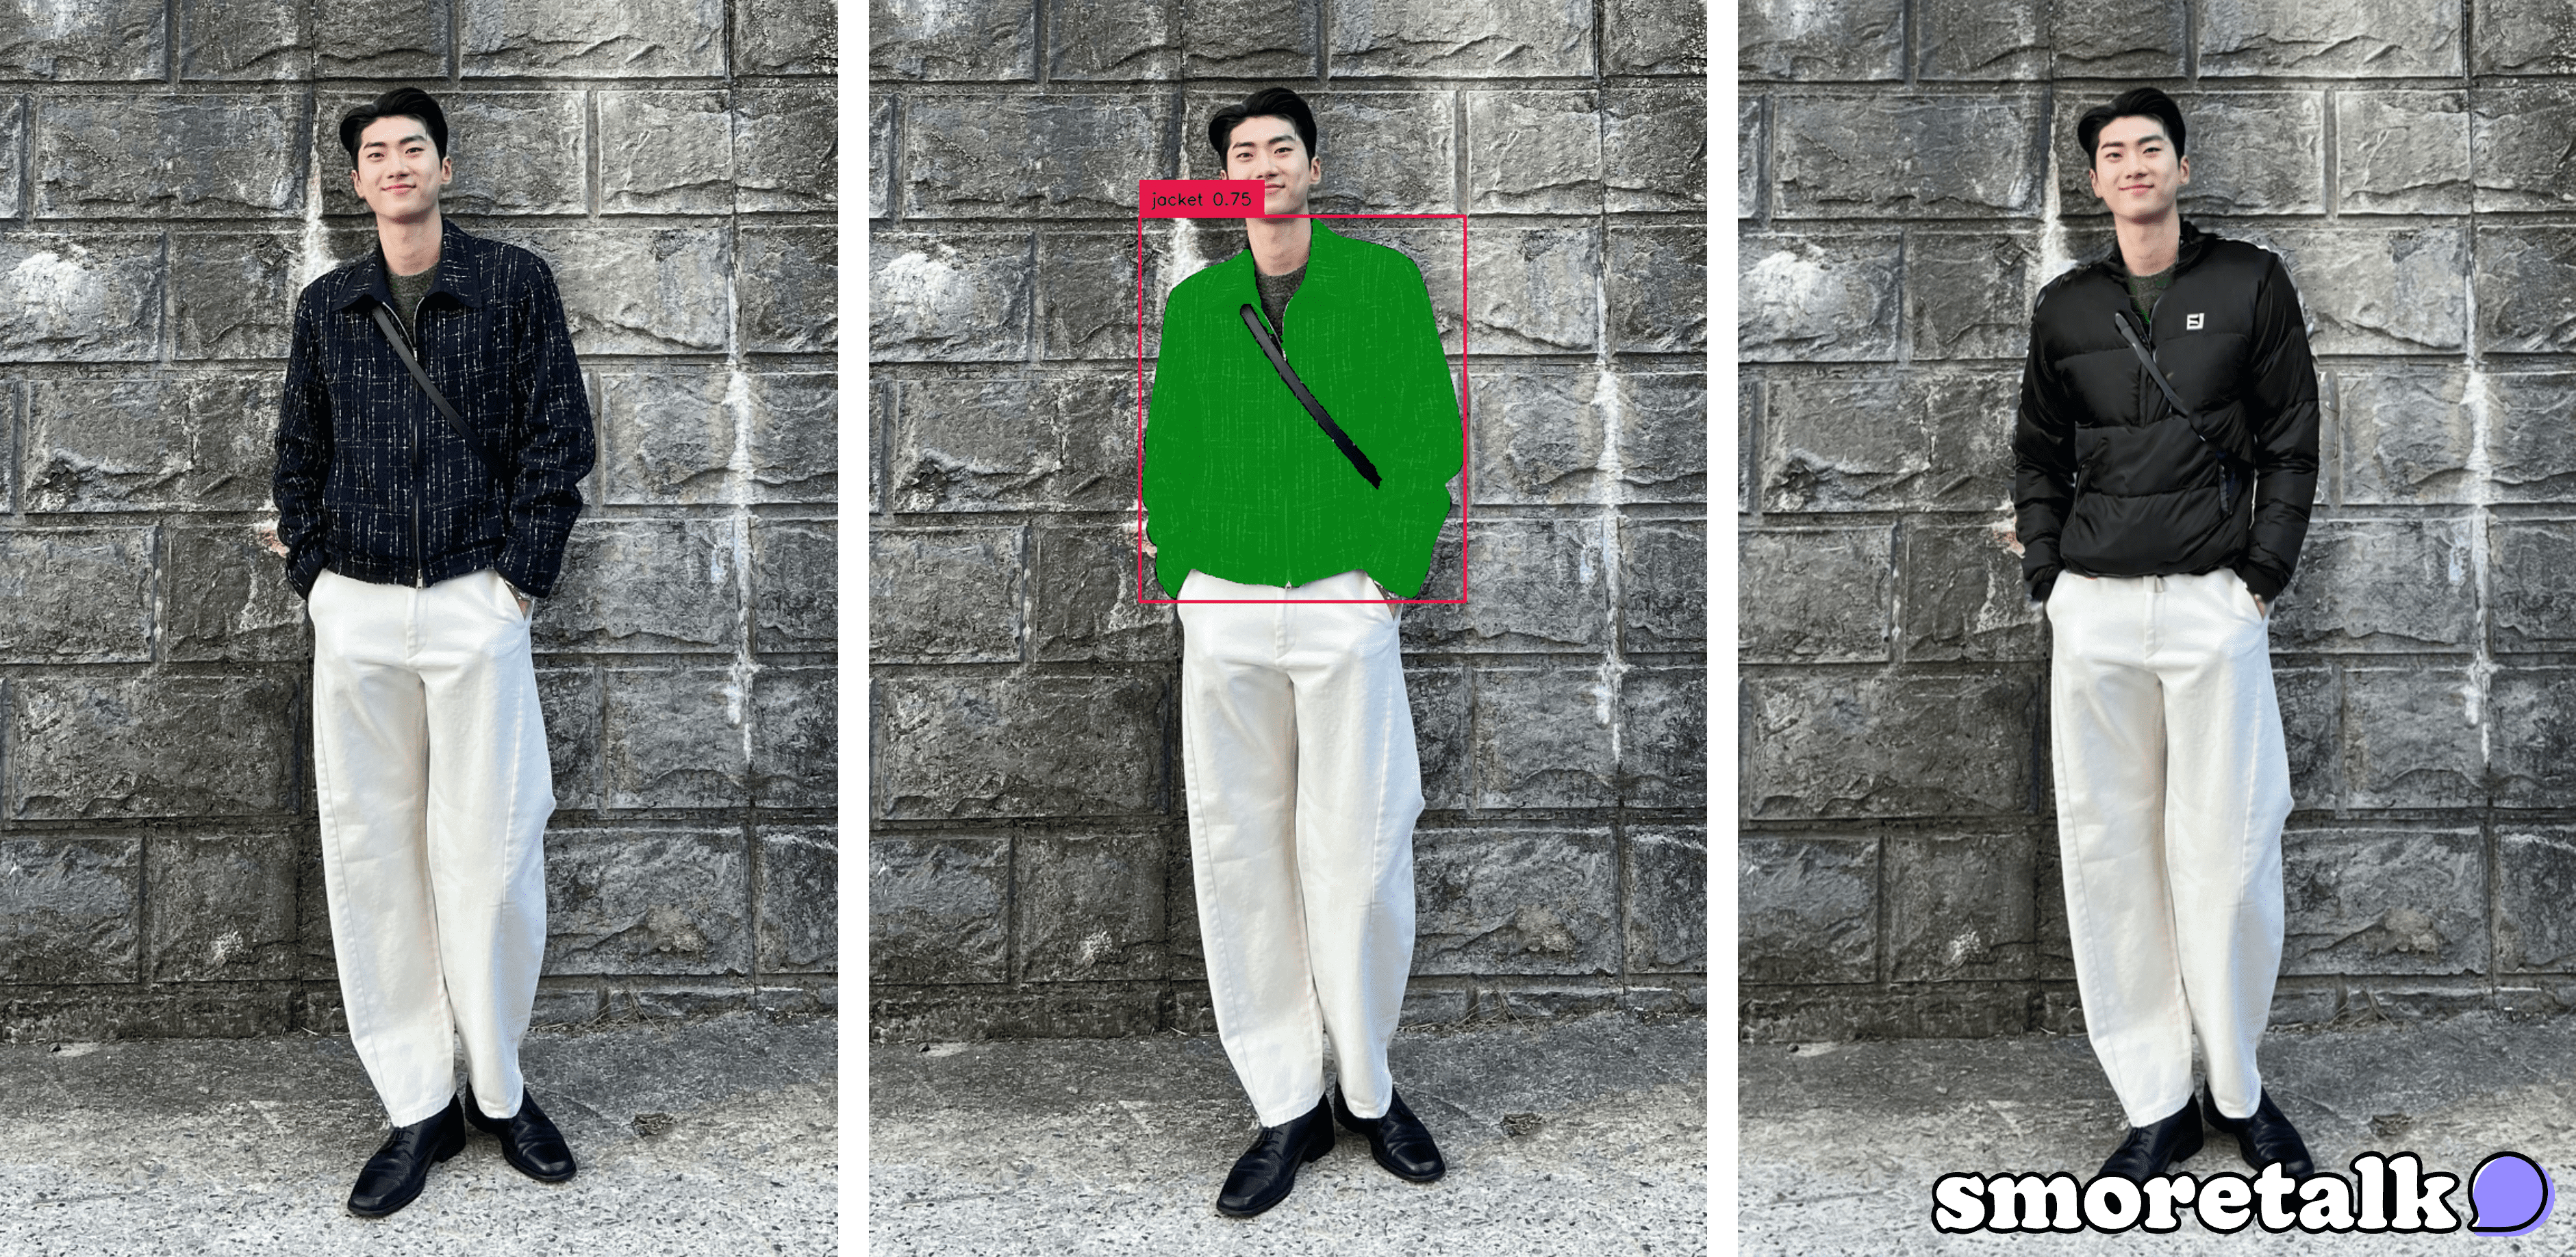
작업 결과 3 (1).png실제 이미지에서도 패딩 이미지가 잘 반영된 모습을 확인하실 수 있습니다.

다만 이미지 생성 모델을 통해 나온 이미지가 아닐 경우 이미지 내 일부를 수정하는 인페인팅 작업 과정에서 부자연스럽게 결과 이미지가 나올 수 있다는 점은 기억해 주셔야 할 것 같습니다. 현재 기준 어도비 파이어플라이의 제너레이티브필을 사용한 결과를 생각해보시면 쉬울 것 같습니다.

이번에는 사실 많은 코드를 공유해드리지는 못했습니다.

작성된 코드가 매우 길기 때문에 과정을 안내해드리고자 한 글이 다소 어지러워질 수 있다고 판단했기 때문입니다.

다만 궁금하시면 최대한 많이 질문 남겨주세요. 글 수정을 통해 반영하도록 하겠습니다.

그리고 이 방법이 사실 최선은 아니고,

구글에서 발표한 TryOnDiffusion (링크) 이 현재 기준으로 최고의 방법인데 안타깝게도 공개된 코드가 하나도 없습니다.

추석 연휴가 끝나기 전 팀이 필요한 업무를 다 마치면 한 번 스크래치를 만들어볼까 합니다. 스모어톡이 타겟하는 시장은 아니라서 시간 날 때 혼자 해보려고 합니다.

이미지 AI 모델이 궁금하시다면 언제든 연락주세요!
이정민 (스모어톡, tonylee@smoretalk.io)
플라멜 Flamel v0.1

프롬프트 엔지니어링이 필요 없는 가장 쉬운 검색형 이미지 생성 서비스

18
4
이정민

이정민

(추석 기념 회고) 3개월 간 GTM 시도해 본 후기 🌝

스모어톡이 벌써 법인 설립 후 5개월이 되었습니다. (4/28 ▹9/28)

사업자 등록 2개월 만에 시드 투자 유치,
5개월 간 3곳의 유료 고객사를 포함하여 실질적인 도입 의사를 밝힌 문의 15건을 달성했습니다.

할머니, 할아버지를 만나는 아시안 소년.pngMade with 플라멜 (👉 2차 클로즈 베타 테스터 등록하기)

안녕하세요,

스모어톡의 글쟁이 이정민입니다.

드디어 저희 팀이 법인 설립 5개월을 맞았습니다.

작년 3월에 @황현지 님과 팀을 만들었으니, 스모어톡이라는 팀에만 1.5년을 바치고 있네요.

스모어톡은 두 가지 문제를 푸는 팀 입니다.

  1. 이미지 작업 시간이 너무 많이 걸린다는 것 (그럼에도 해야 하는 것)

  2. 이미지 생성 모델이 사용하기 불편하다는 것 (기술적으로나 혹은 UI적으로나)

그래서 하고 싶은 건 이거에요.

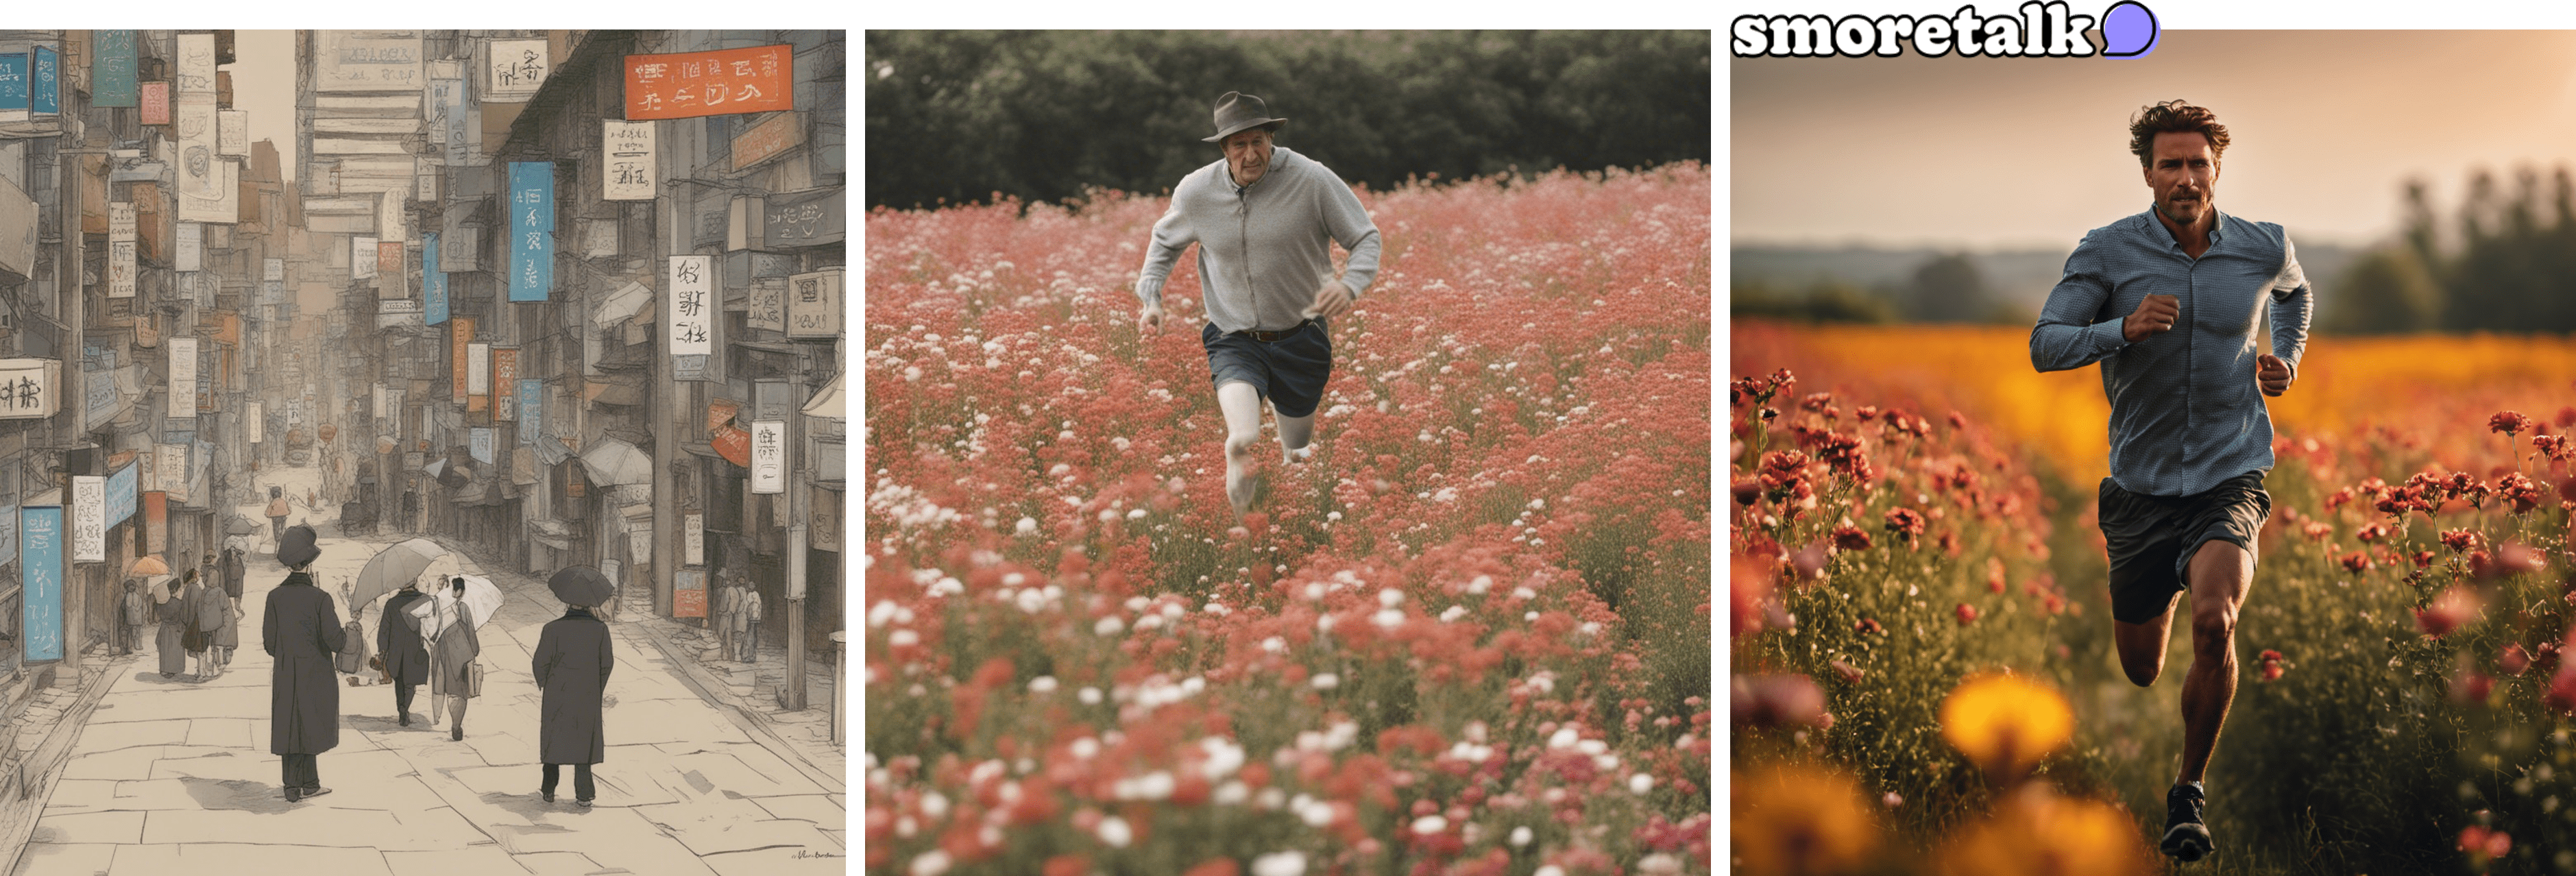
예시.png(왼쪽부터 번역 없음, 번역 있음, 스모어톡 기술 - 대신 GPU Cloud 에 올려야 하는 상황)

"누구보다 쉽게 더 좋은 이미지를 얻을 수 있도록 하자."

사람에 따라 한 번에 그게 될 수도 있고, 여러 번이 걸릴 수도 있지만 최소한 그 과정이 어렵게 느껴져서는 안된다 라는 것이 팀의 기본 철학입니다.

AI 이미지 어시스턴트, 플라멜에 대한 자세한 이야기는 출시 일정에 맞추어 따로 글을 올리도록 하겠습니다.

여튼 작년 후반부터 운영한 노코드 기반 MVP 스모어데이와 함께 저희는 다양한 수요처를 확인했고,

지난 7월 시드 투자 유치에 성공했습니다. (사업자 등록 2개월 만의 성과)

저희 투자사 분들에 대한 이야기는 아래 글에 적어두었습니다.

  • 포스텍홀딩스, 링크

  • 한국투자액셀러레이터, 링크

해당 시기에 맞추어 카카오브레인 브레인 100X 프로그램 참여사로 협약을 맺기도 했습니다 - 뉴스 링크

그리고 기업이 되어서 제일 중요시했던 고객 모으기. AI 기술력이 있다고 해서 가만히 앉아만 있으면 누군가가 찾아주나요? 저희는 고객사 또는 고객을 만나러 온오프라인 가리지 않고 다양한 곳을 찾아 다닌 것 같습니다. 3가지로 요약할 수 있을 것 같은데요.

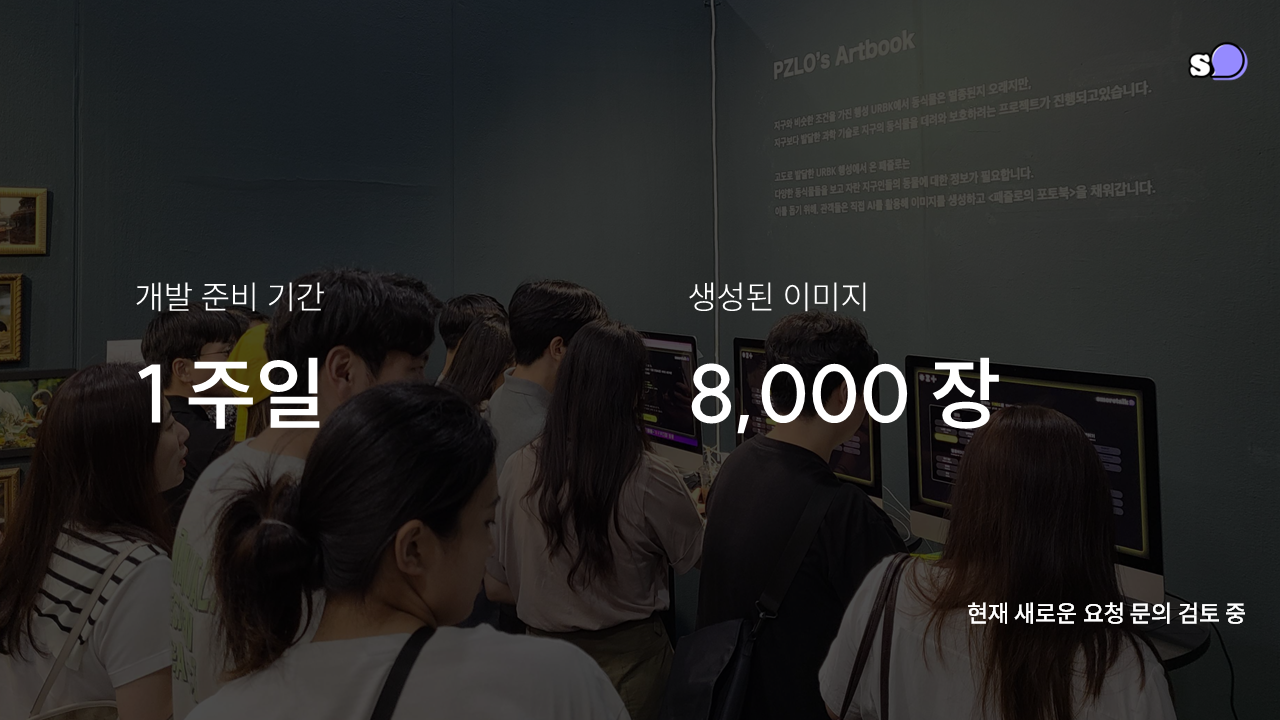
우선 아시아 최대 스트릿아트페어, 어반브레이크 2023에 AI 기술 지원을 하게 되었습니다.

예시2.png전시회 준비 기간이 촉박했음에도 불구하고, 3일 만에 준비를 완료하여 총 일 주일만에 세팅을 완료하여 성공적으로 전시회를 치러내었습니다.

새로운 팀 세팅이 얼마 지나지 않았을 때의 일이라 우리가 무언가를 할 수 있다는 자신감을 얻는 계기가 되었던 것 같습니다.

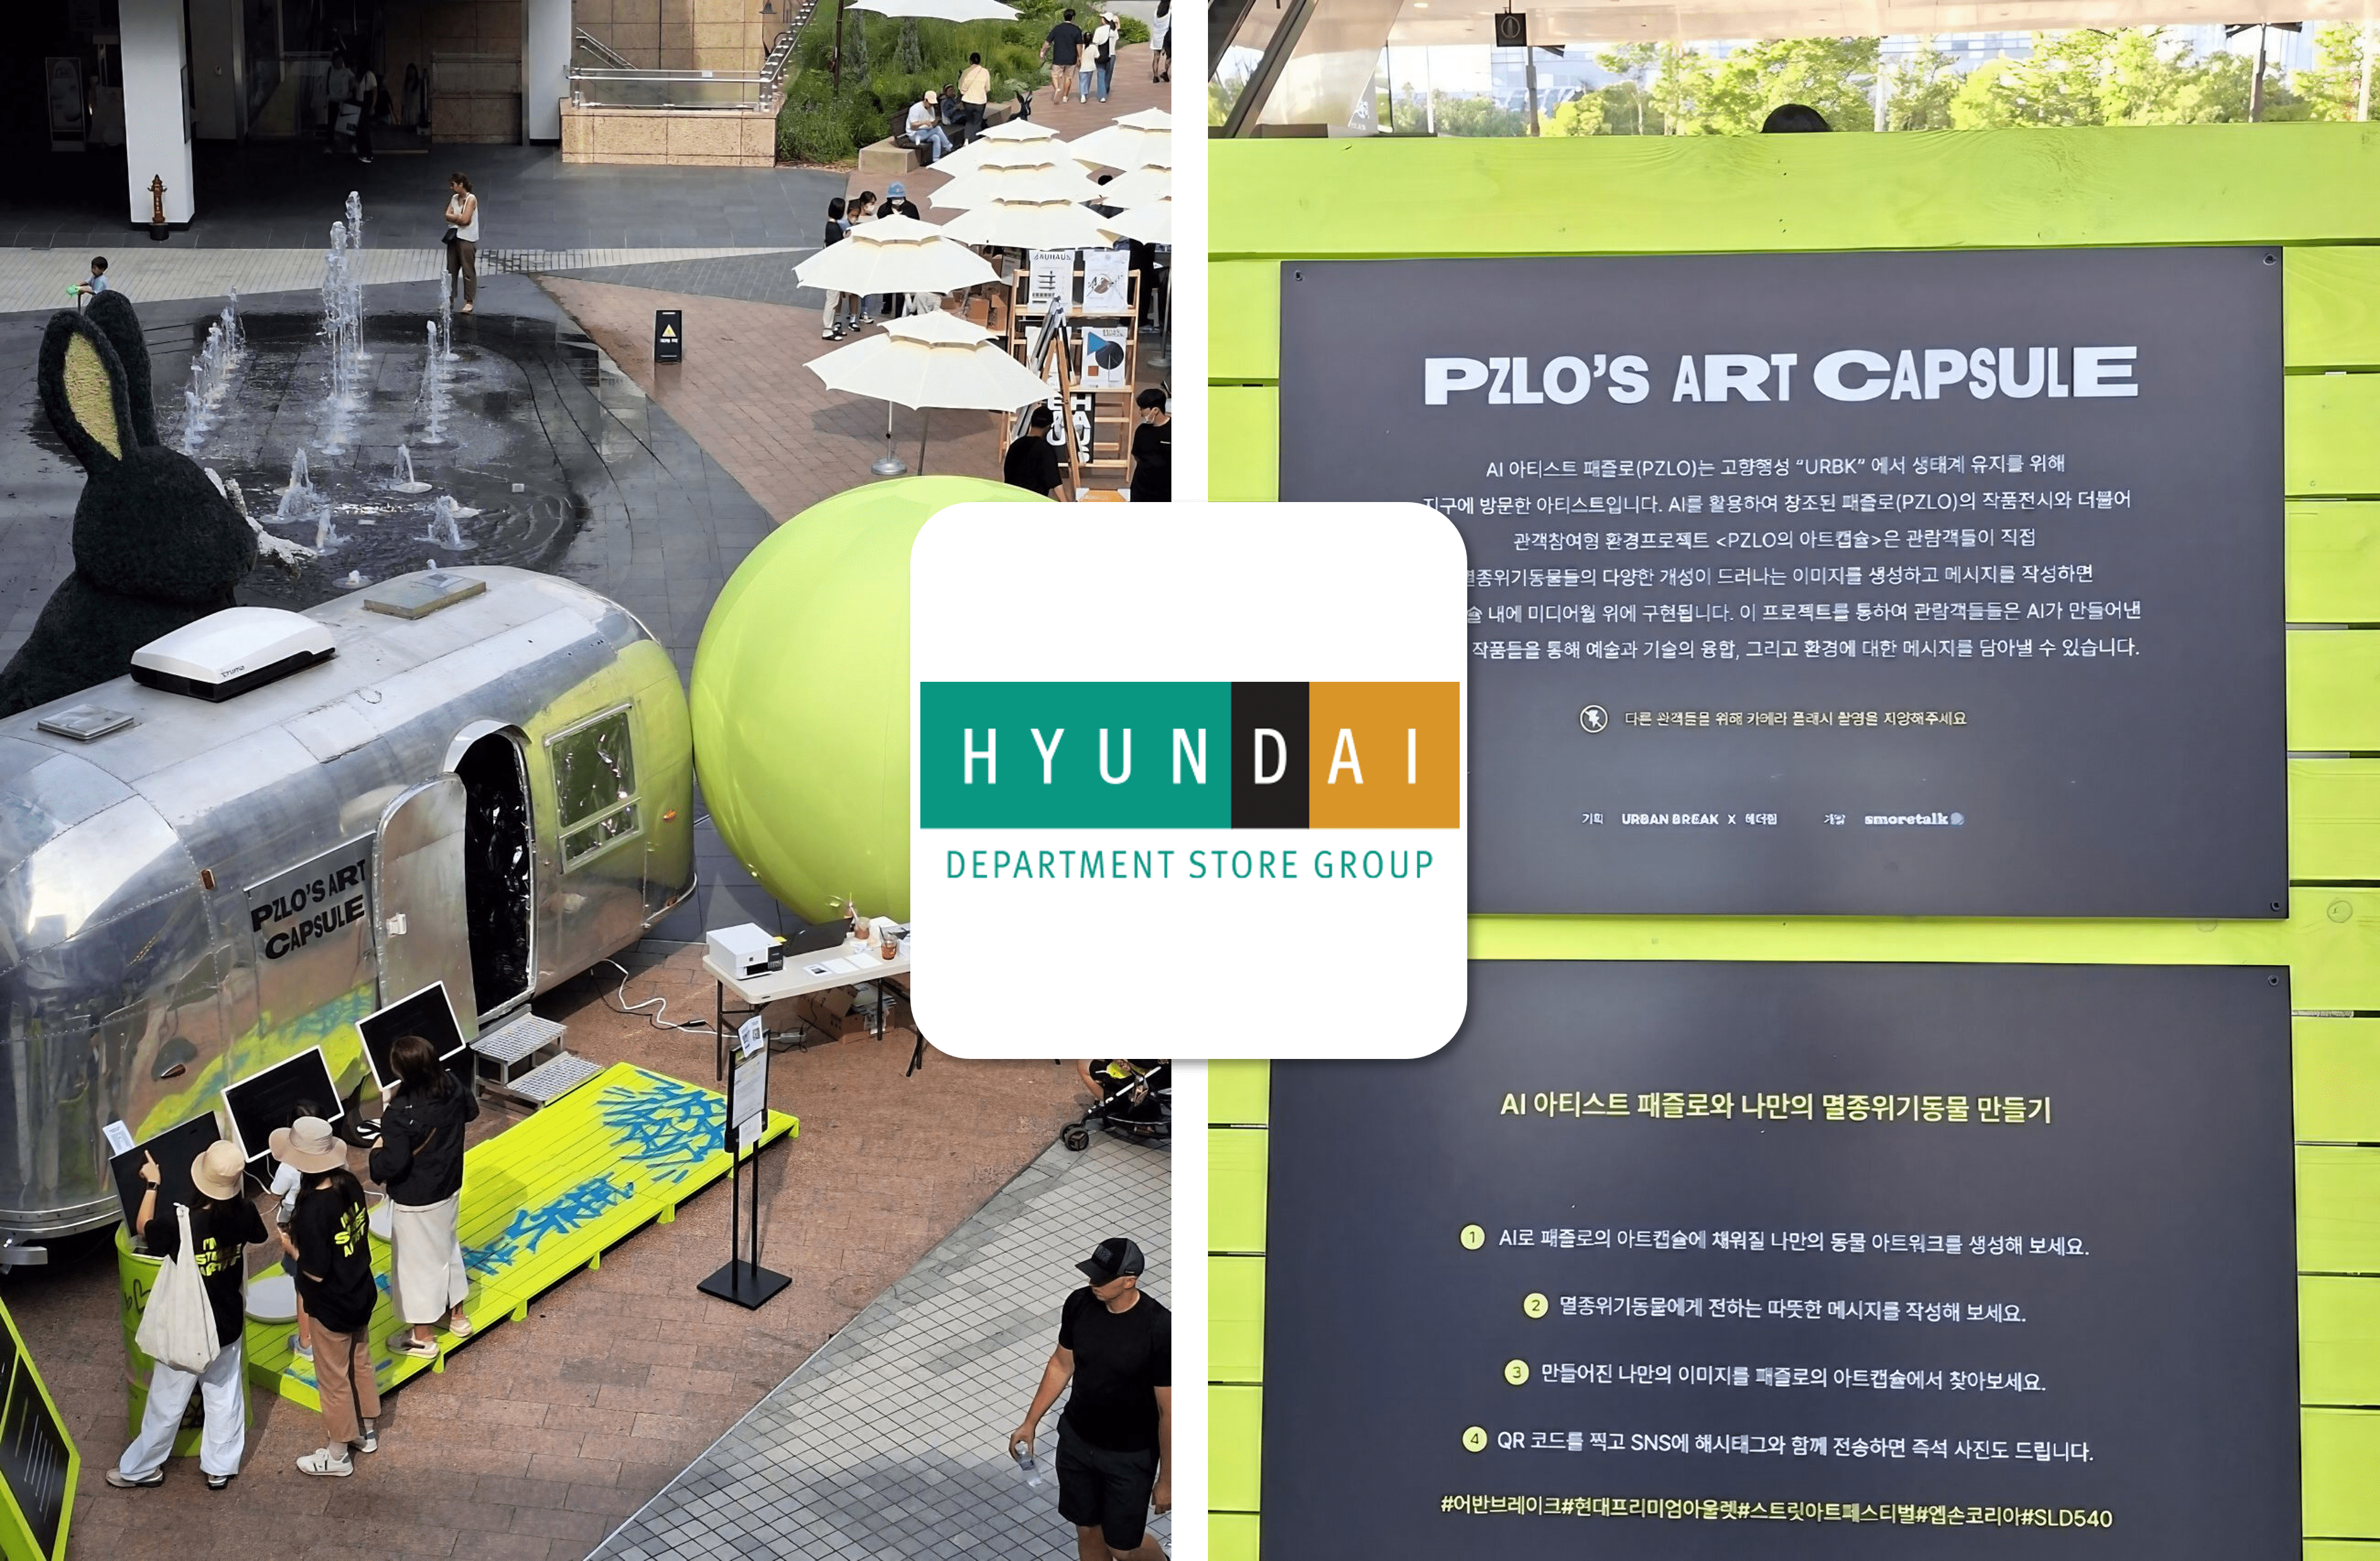
예시3.png(우측 이미지 개발 에 스모어톡 로고... 뿌듯합니다ㅎㅎ)

해당 전시회에서의 성과를 바탕으로 스모어톡은 현대프리미엄아울렛과 손을 잡고 AI 아트를 보다 많은 사람들이 접할 수 있게 체험의 장을 제공해주고 있습니다. 현재(9/28 기준)는 송도점 (a.k.a 송현아) 에서 체험하실 수 있습니다.

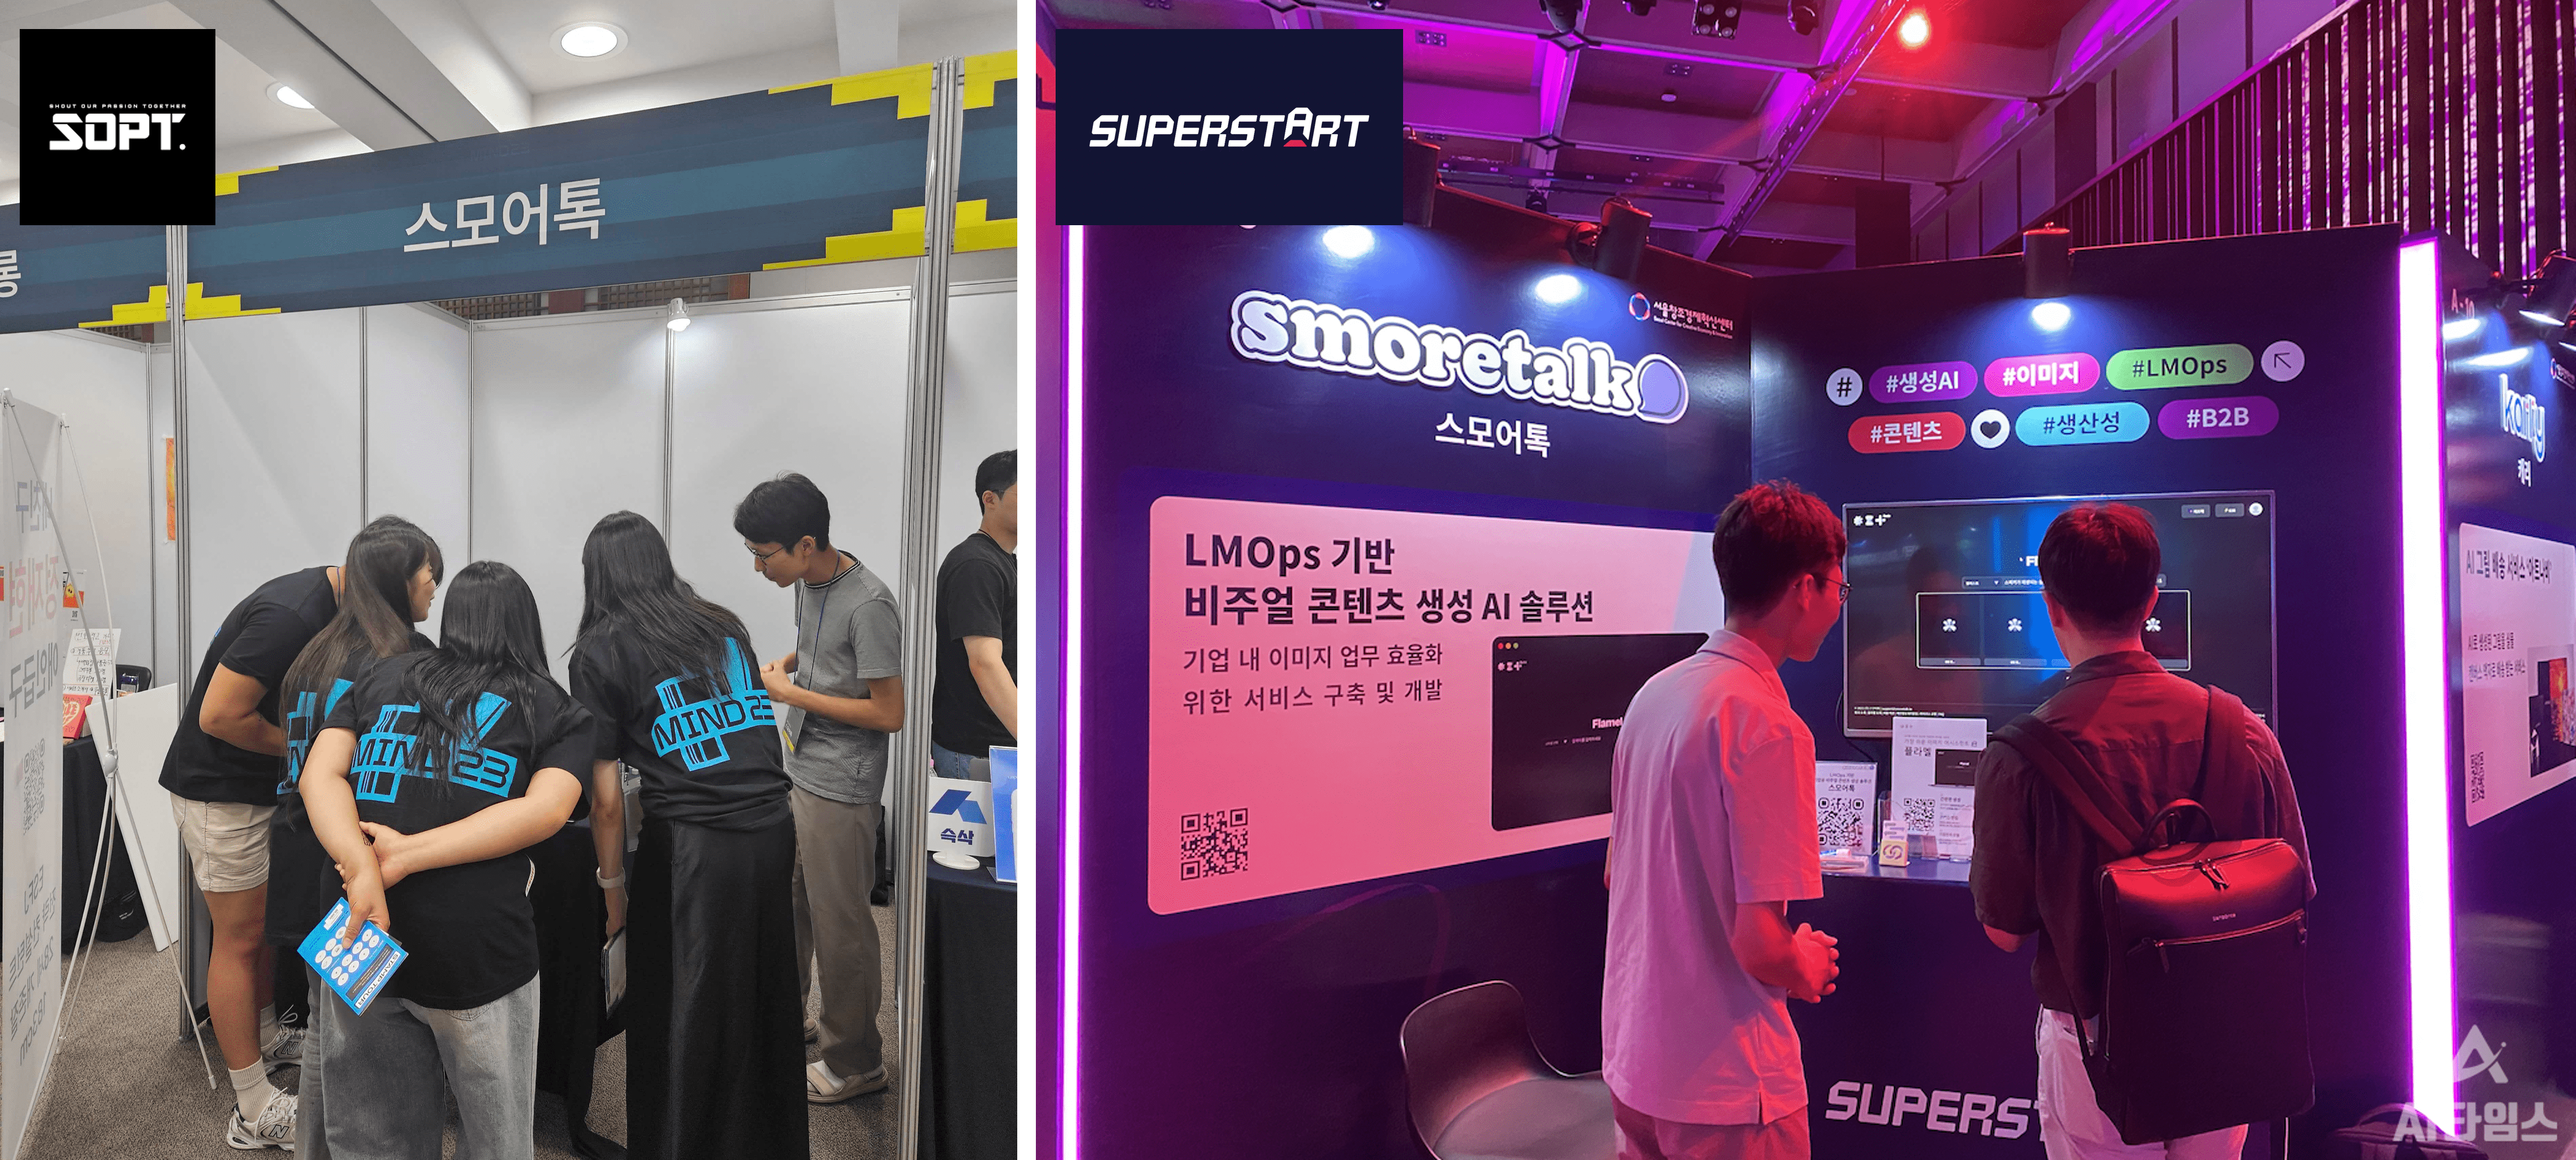
다음으로, SOPT 컨퍼런스를 시작으로 부스에서 플라멜에 관심이 많은 다양한 고객을 만나 뵐 수 있었습니다.

예시4.png(왼쪽 SOPT MIND 23 컨퍼런스, 오른쪽 LG 슈퍼스타트데이 2023 - 뉴스 링크)

현직 마케터, 디자이너 또는 해당 직무를 꿈꾸는 학생 분들, 그리고 관련 기업 담당자 분들과 이야기를 할 수 있었고, 준비 중에 있습니다.

확실히 부스에서 고객 분들과 이야기를 더욱 나누면서 고객 분들의 워크플로우를 개선해야겠다는 목적 의식이 더욱 강해졌고, 그래서 살면서 한 번도 뵙지 못했던 분들께 인터뷰를 작년 말에 이어 다시 요청하게 되었습니다. 사업을 하려면 이 정도 깡다구는 있어야 되지 않겠나 라고 스스로에게 질문하는 시간이었습니다.

마지막으로, 이미지 AI 에 대해 생각보다 많은 분들께서 모른다는 것을 인지하게 되면서 저는 스모어톡을 대표하여 디스콰이엇 이미지 AI 얼라이언스 클럽을 통해 이미지 AI 사용과 관련한 글을 쓰기 시작했습니다.

c447e2f33949472ba30436f500077c2287a87b45ecc6cfb29c15ff743235bcff.webp현재 이미지 AI 관련 글은,

  1. AI 아바타 - 조회수 2,100회, 디콰 글 링크 (코드 포함)

  2. AI 상품 이미지 - 조회수 410회, 디콰 글 링크 (코드 포함)

  3. AI 패션 모델 (1) - 조회수 450회, 디콰 글 링크 (코드 불포함)

을 적어 보았는데요. 생각지도 못하게 많은 관심을 보여주셔서 감사드립니다.

위 글과 실제 사용 사례를 잘 나타내주신 @황현지 님의 글에 힘입어 1차 클로즈 베타 당시 3일 만에 60 곳 이상의 기업/기관 내 근무 중이신 참가자 분들의 신청을 받을 수 있었습니다. (참고로 2차 모집도 시작되었습니다 👉 2차 클로즈 베타 테스터 등록하기)

그래서 감사의 의미로 추석 연휴에 이미지 AI 관련 글로 자주 찾아뵐까 생각 중입니다.

일환으로 다음 글은 AI로 패션 모델을 만들어 보는 과정이 담긴 AI 패션 모델 (2) 로 찾아뵈려고 합니다.

이미지 AI를 모두(특히, 마케터와 디자이너) 가 쉽게 사용하는 그 날까지 스모어톡이 달려가 보겠습니다.

많이 기대해주세요 :) 😆

플라멜 Flamel v0.1

프롬프트 엔지니어링이 필요 없는 가장 쉬운 검색형 이미지 생성 서비스

16
4
이정민

이정민

[예고편] 이미지 생성 모델, 그게 뭐냐? 🤔

diffusion.gif

made by 스모어톡

AI가 이미지를 생성한다고 합니다.

아바타도, 상품 이미지도, 패션 모델 사진도 만들 수도 있대요.
그런데 AI가 이미지를 생성하는 방식은 알고 계신가요?

앞으로 스모어톡이 설명해드리겠습니다. Coming Soon 🚀

이정민(스모어톡, tonylee@smoretalk.io)

p.s. GIF 만드는 방법

import matplotlib.pyplot as plt
import matplotlib.animation as animation

timesteps = 50

fig = plt.figure()
ims = []

for i in range(timesteps):
    im = plt.imshow(image_list[i]) #image_list: list of images from step 1 to 50
    ims.append([im])

animate = animation.ArtistAnimation(fig, ims, interval=400000, blit=True, repeat_delay=10000)
animate.save('diffusion.gif', fps=12)
plt.show()

플라멜 Flamel v0.1

프롬프트 엔지니어링이 필요 없는 가장 쉬운 검색형 이미지 생성 서비스

9
0
이정민

이정민

[Tip] 90초면 모든 촬영이 끝, AI 패션 모델 만들기 (1)👗

👇👇👇 아래 사진들의 공통점이 무엇인지 아시나요?

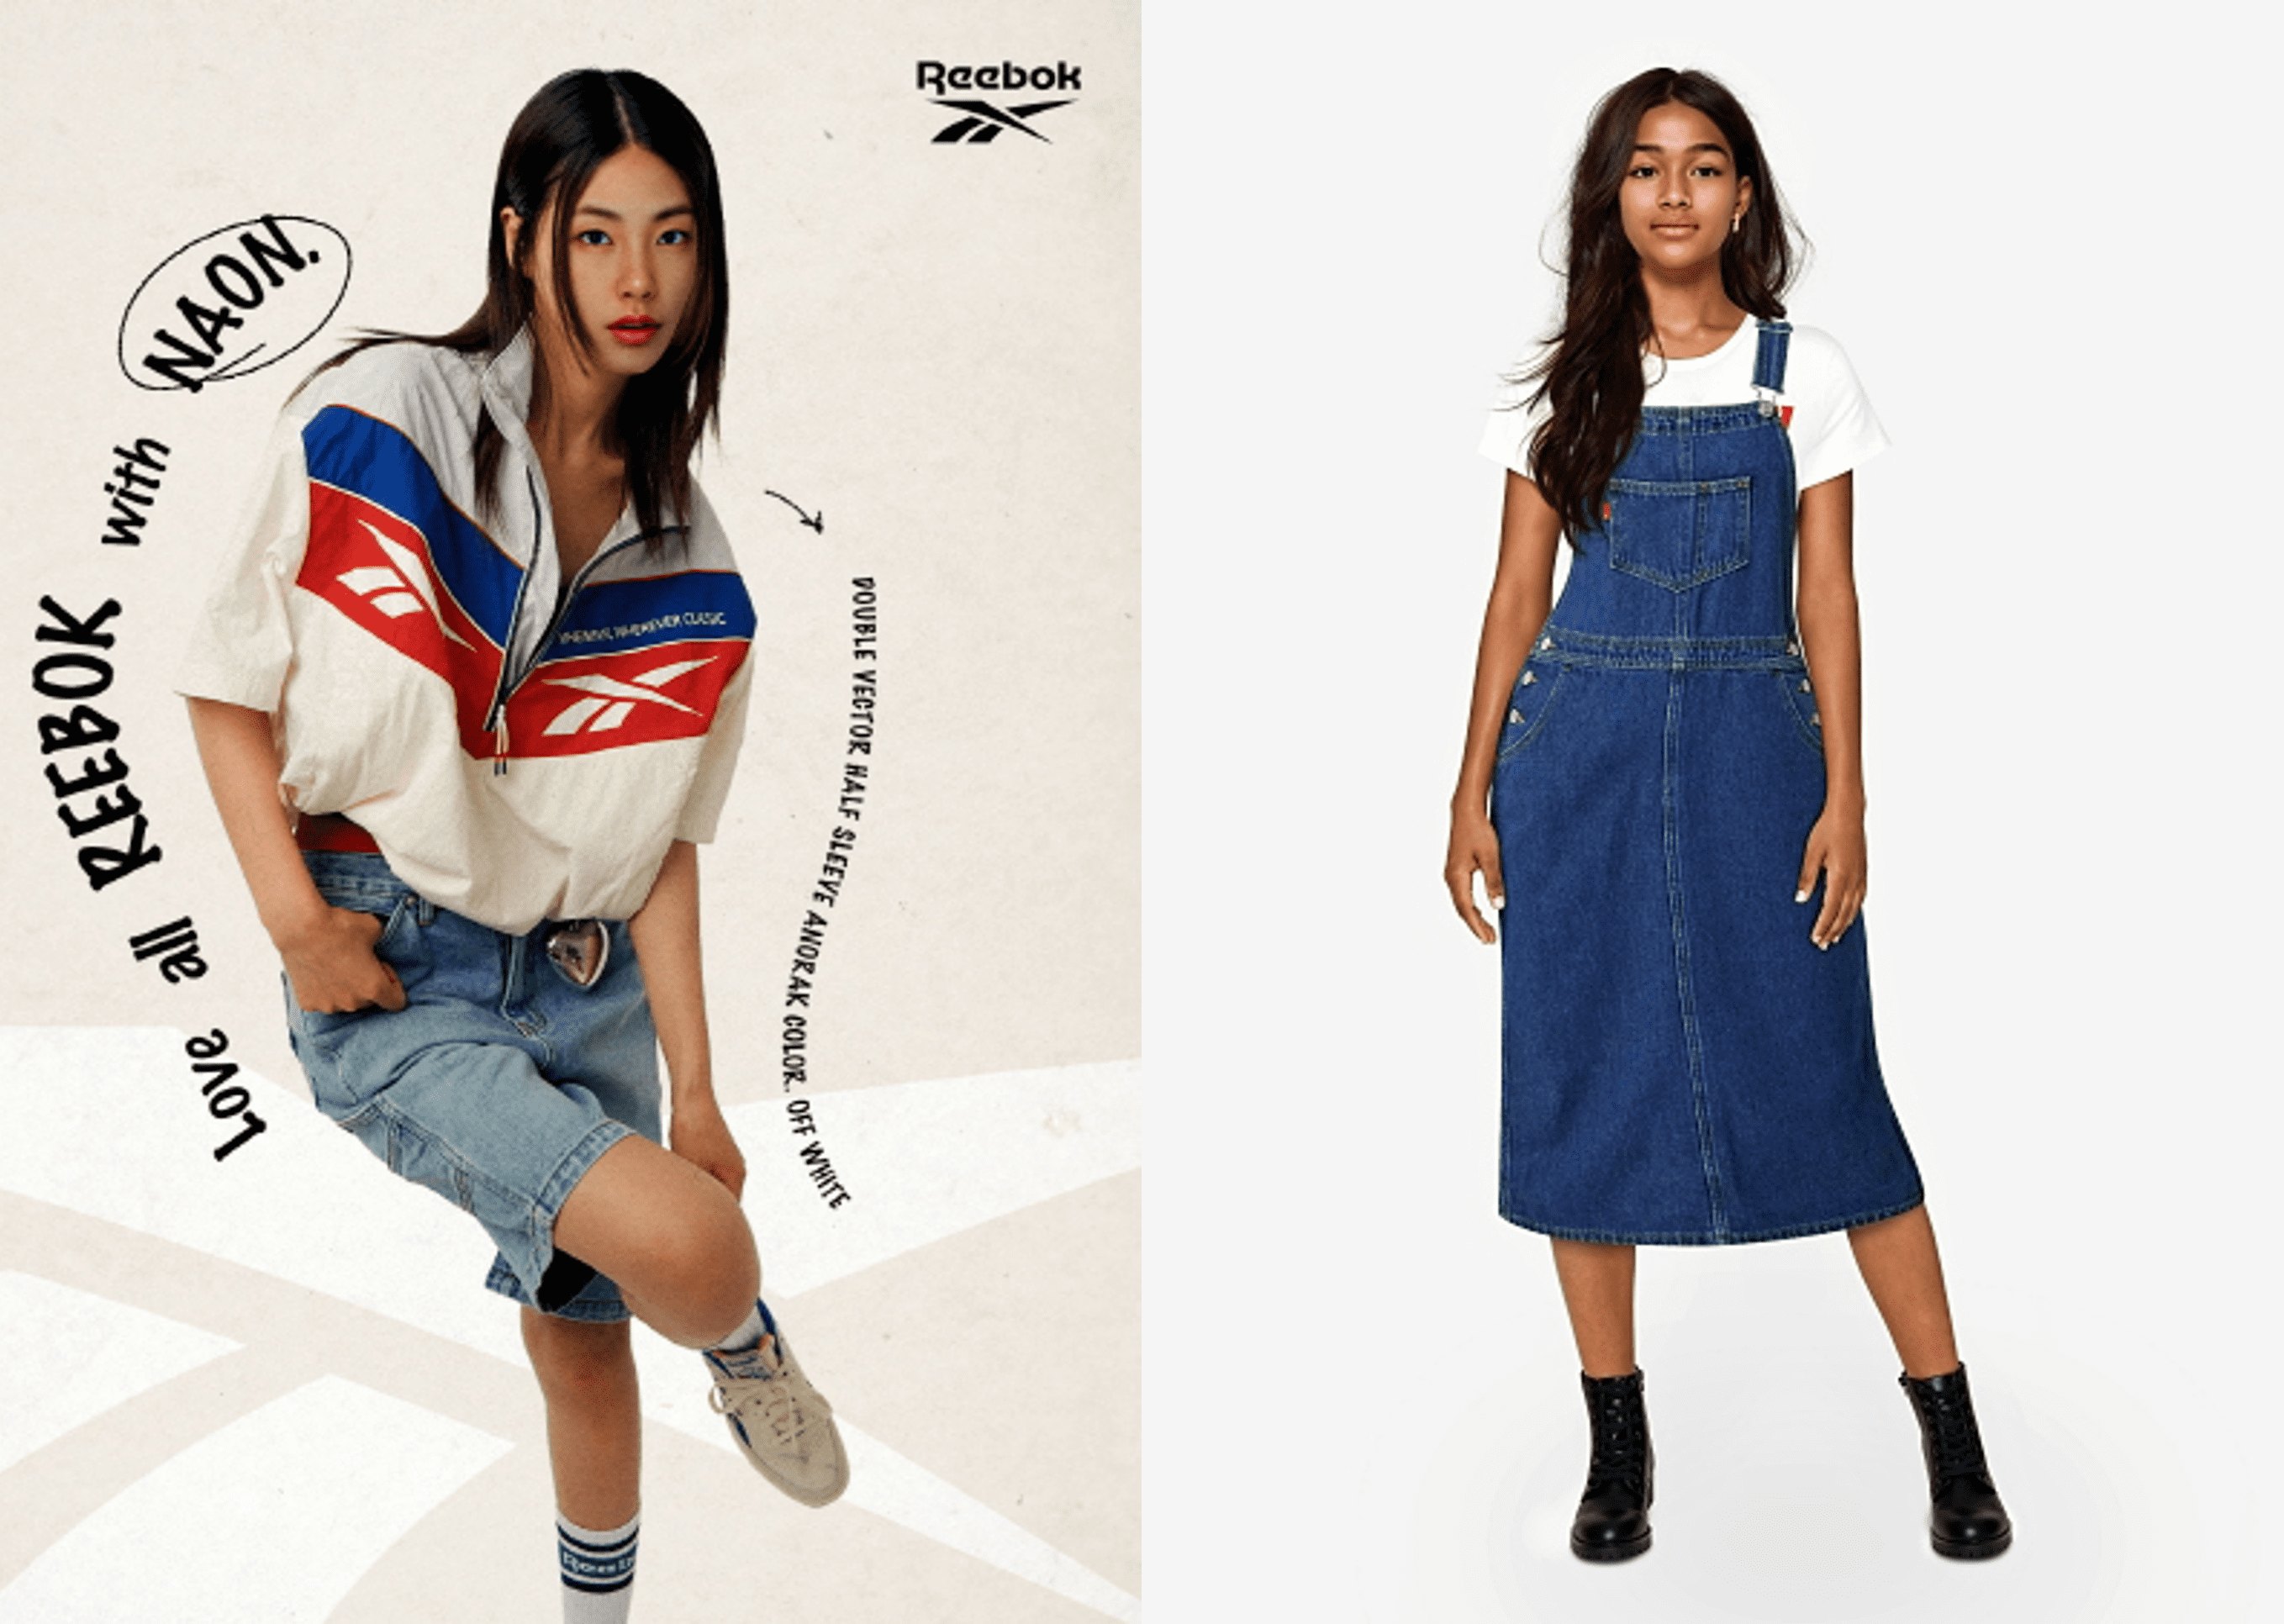
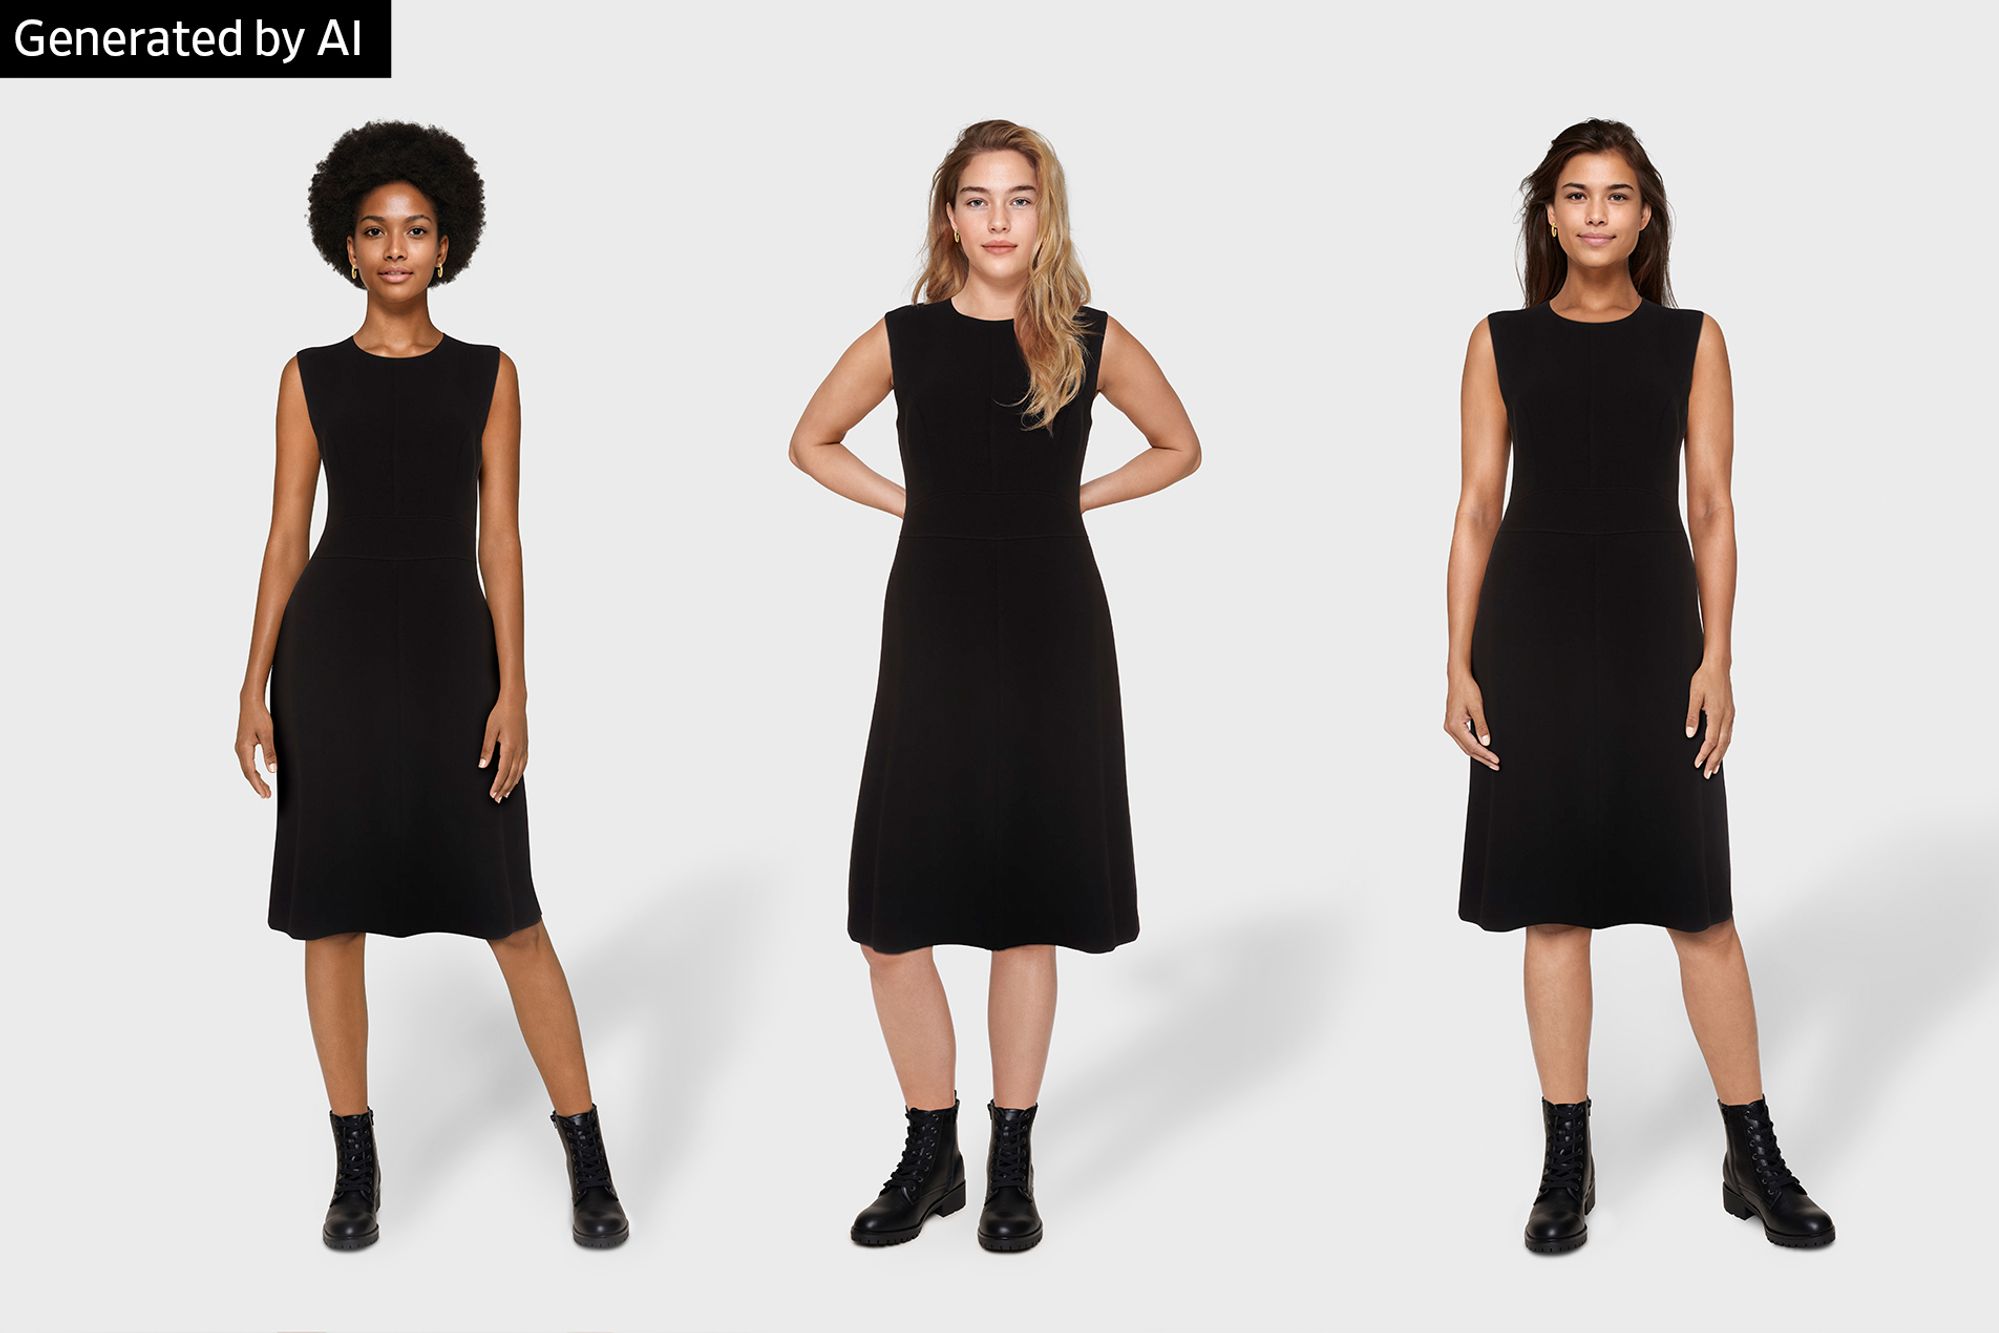
AI 모델.png출처: LF 패션 모델 나온 (왼쪽), Levi's 패션 모델 (오른쪽)

바로 실제 사람이 아닌 AI 패션 모델의 사진이라는 것입니다.

유통가에서는 이미 버추얼 휴먼(가상인간)의 도입을 서두르고 있습니다.

이유는 여러가지입니다.

그 중 하나는 모델도, 세트도, 사진작가도 필요 없어 패션 광고 소재에 다양성을 불어 넣어줄 수 있기 때문 이라고 생각합니다.

패션계에 AI 도입 사례는 대표적으로 2가지가 있어 보입니다.

첫 번째는, 썸네일에도 있는 리바이스(리바이 스트라우스)의 AI 패션 모델입니다.

지난 3월 생성 AI 패션 모델을 제작하는 디지털 패션 스튜디오 Lalaland.ai 와 협력해 진행한 사례입니다. AI 모델이 실제 고객의 역할을 보충함으로서 향상된 경험을 제공하기 위함이 이유였죠.

물론 모델의 일자리를 빼앗을 것이란 우려도 함께 튀어나왔습니다.

라라랜드.jpeg출처: 월스트리트저널 (링크)

두 번째는, AI 패션 위크(이하 'AFW') 입니다.

지난 4월 뉴욕에서 개최된 2023 AFW 에서는 기존의 패션 위크 문법을 완전히 부수었습니다. 지정된 시간대에 런웨이에서 실물 모델이 새로운 패션을 선보이던 이전과 달리 갖가지 이미지 생성 AI (주로 미드저니) 를 사용해 의상 컬렉션 이미지를 제작하여 제출했고, 온라인 전시 및 투표 후에 실제 제품 생산이 이루어졌죠. 기존 디자이너의 작업이나 레퍼런스에 의존하는 프롬프트를 사용하지 않고 진행되었다는 점에서 참신하기까지 했습니다.

본 행사에서는 디자이너가 수 많은 샘플을 만들어내는 데 필요한 리소스(시간, 비용)을 획기적으로 줄일 수 있다는 가능성을 탐색할 수 있었습니다.

출처: AI 패션 위크(링크)

그래서 결론은, 아이데이션에도 실제 캠페인 작업물에도 AI는 새로운 가능성을 주었다는 것입니다. 즉, 중소형 패션 기업이 대다수인 시장에서 AI는 해당 기업들에 더 넓은 기회의 장을 줄 수 있다는 것입니다.

해당 문제를 풀고자 하는 기업으로는 앞서 언급한 lalaland.ai 외에 외국에서는,

한국에서는,

가 있습니다. (혹시 추가해야 할 기업은 알려주시면 수정하겠습니다)

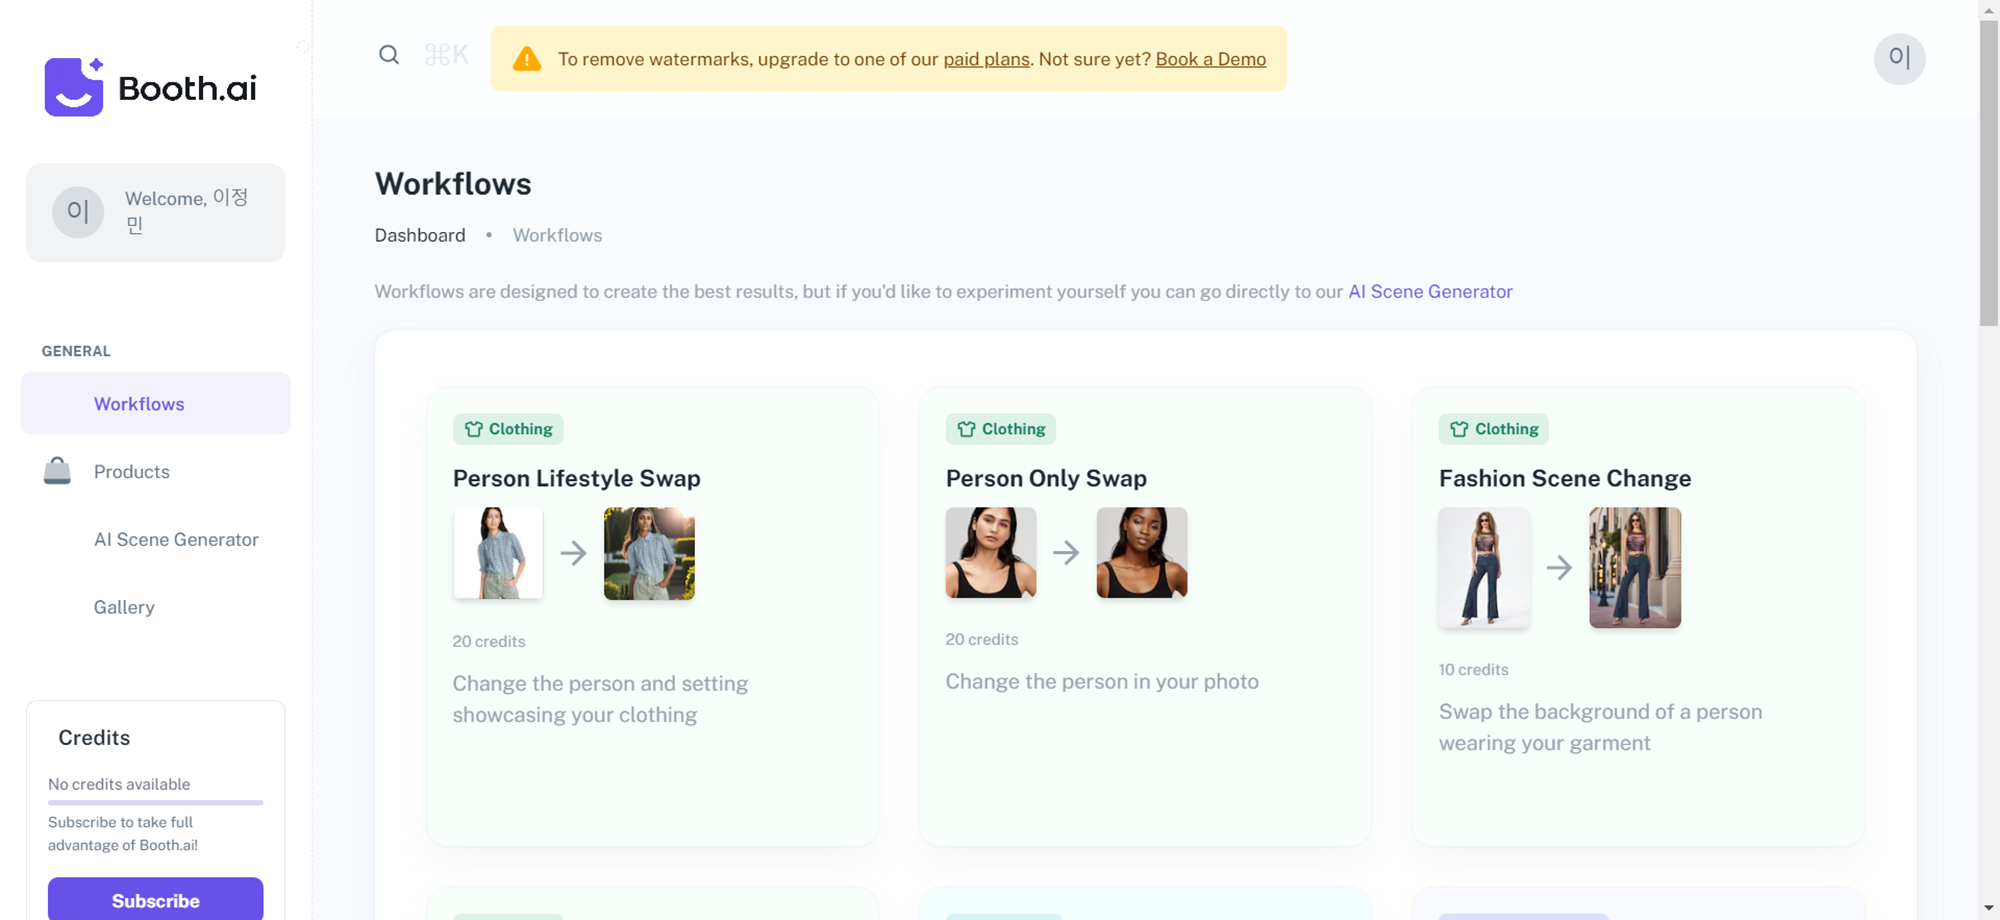
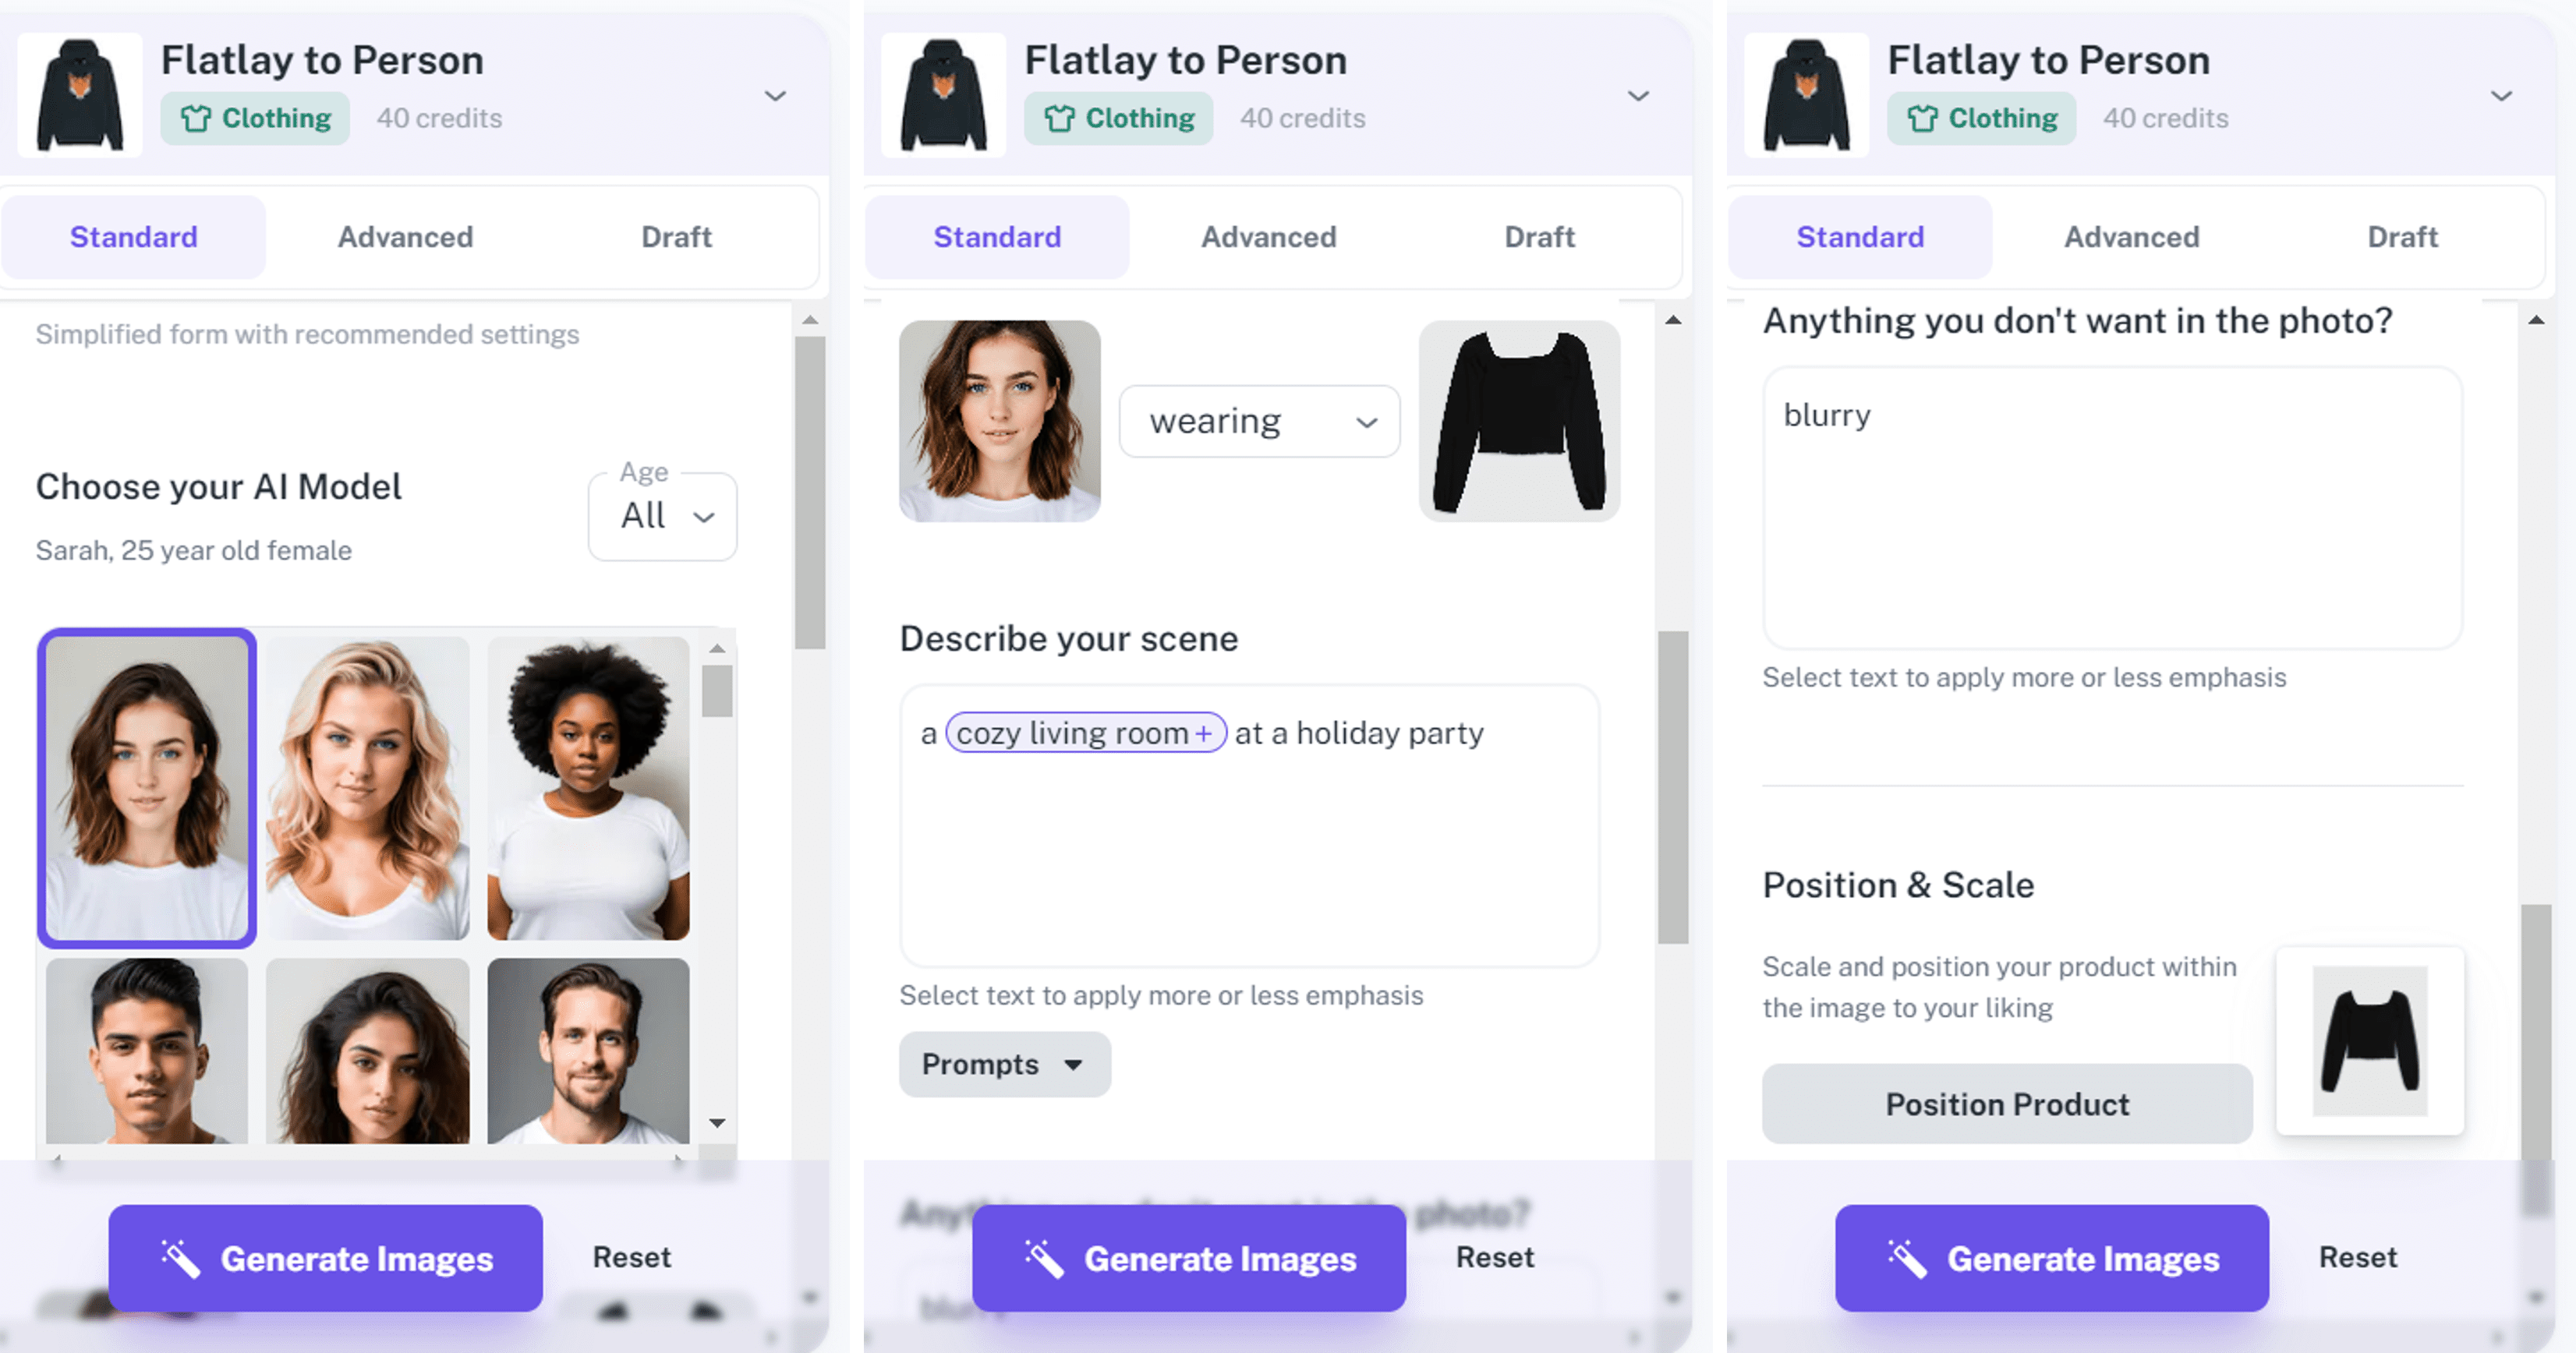
그 중 Booth.ai 내 Flatlay to Person 기능을 통해 AI 패션 모델을 만들기 위해선 무슨 작업이 필요한 지 확인해보겠습니다.

image.png(사실 기능이 정말 많아요. 다 필요한 것인지는 모르겠지만요...)

Flatlay to Person 은 바닥에 놓고 의상을 찍은 사진을 모델이 입고 촬영한 사진으로 변환해 생성해주는 기능입니다.

부스에이아이.png

크게 과정을 살펴보면 의상 종류 선택 - AI 모델 선택 - 동작/장면 묘사 - 기타 설정(네거티브 프롬프트, 의상 위치 설정) 순입니다.

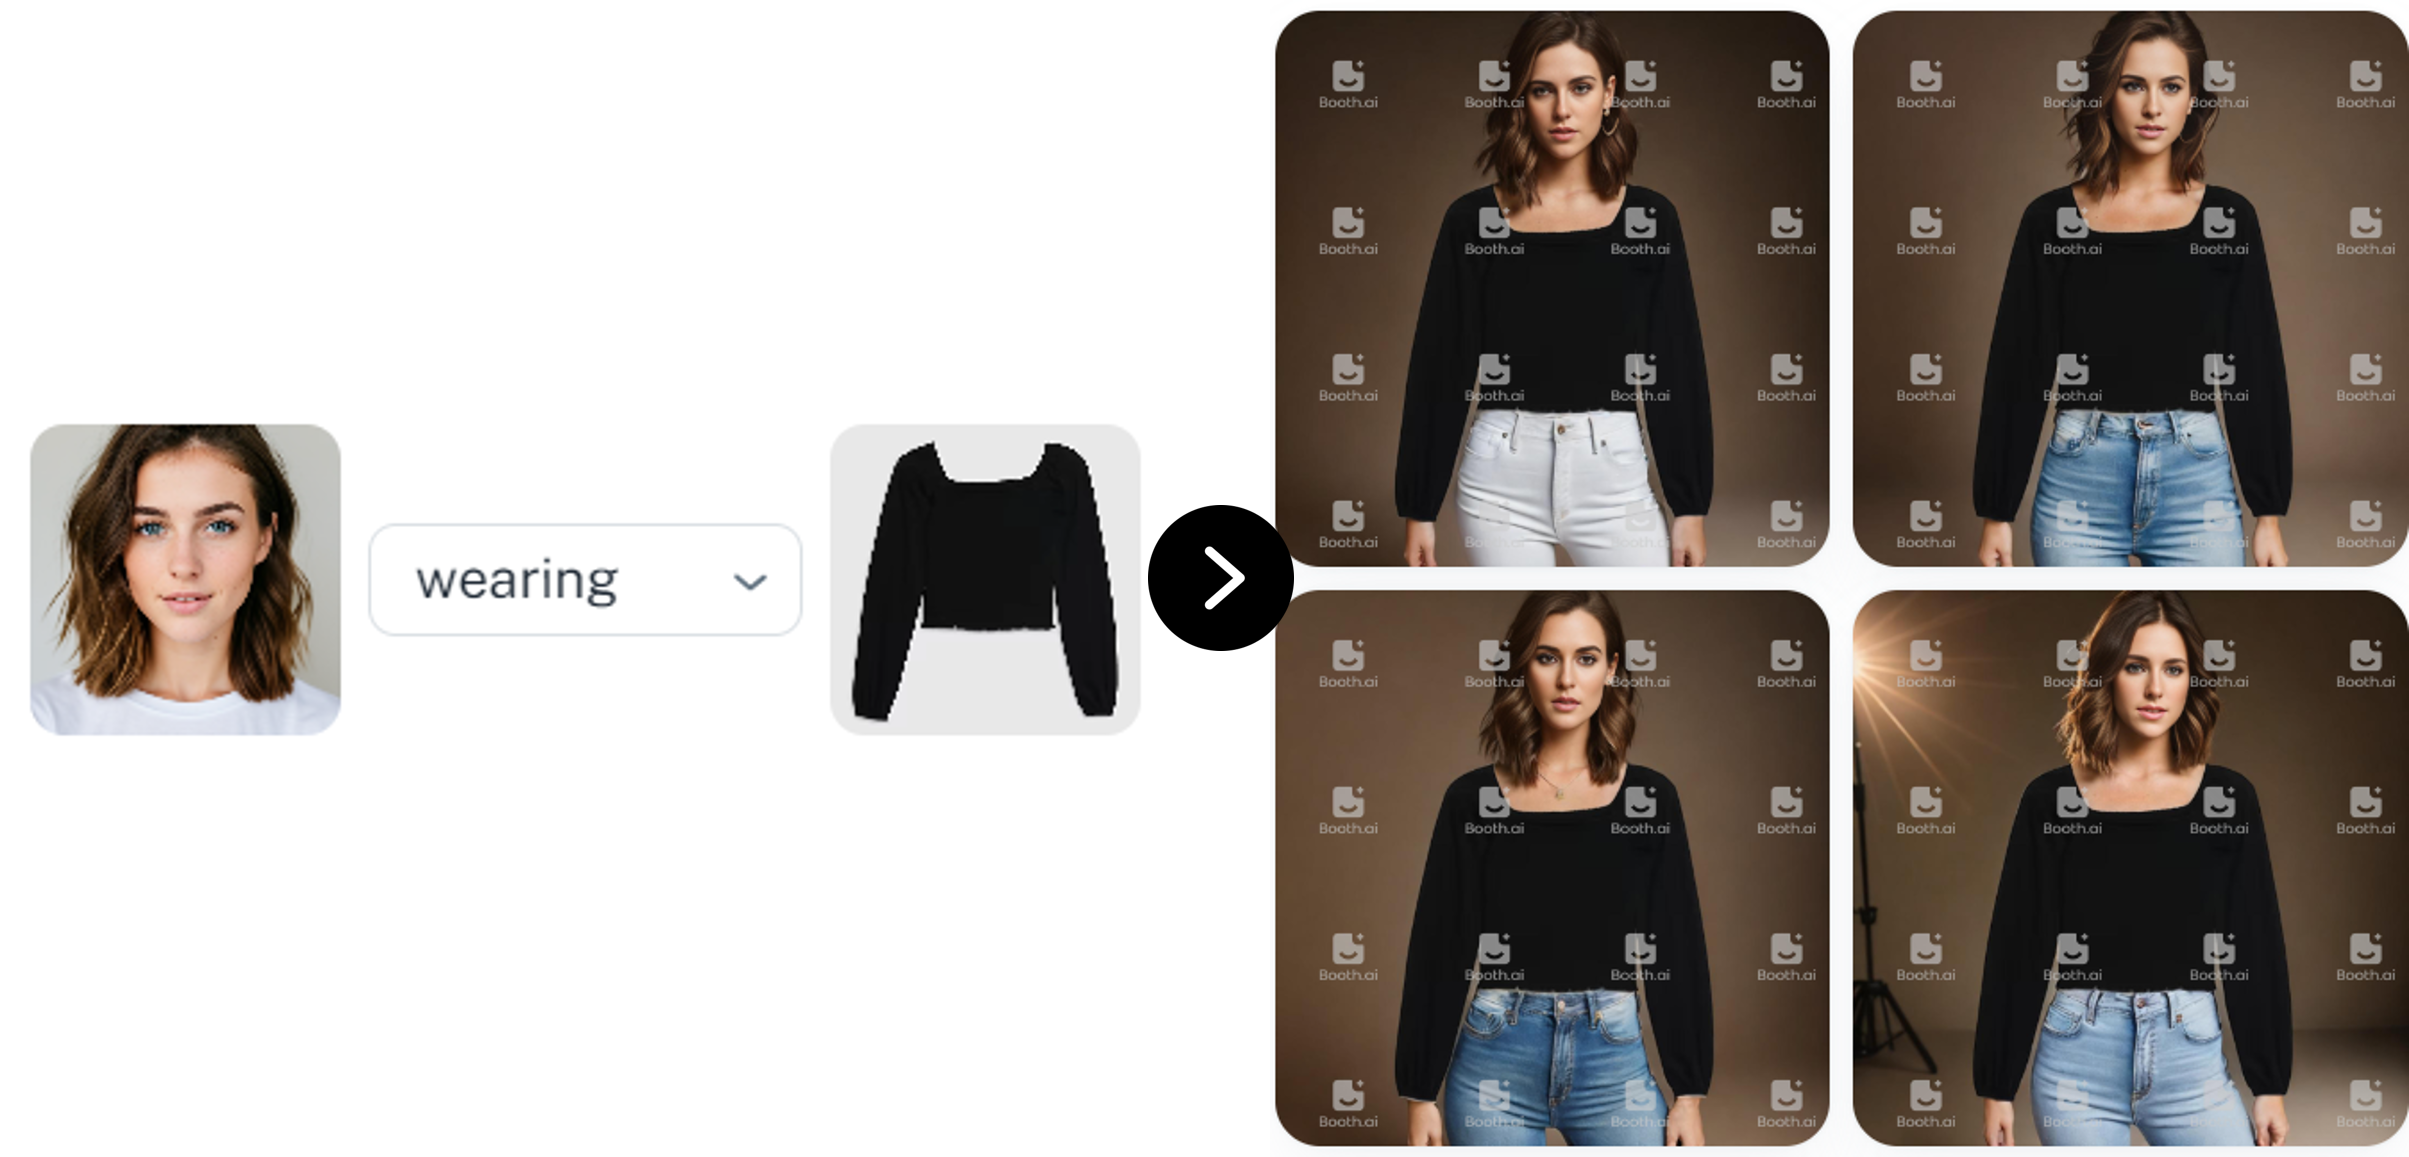
그리고 위 내용대로 설정 시 만들어지는 이미지는 다음과 같습니다.

부스에이아이_결과.png(뭔가가 30초 이내로 나오기는 했습니다... 무료라 워터마크가 있습니다)

✅ 사실 여기서 이미지 AI 를 잘 아는 사람이라면, 3가지 기능을 사용한 것을 알 수 있습니다.

  • 인물을 묘사하는 것은 LoRA (가중치, weight)

  • 장면을 묘사하는 것은 프롬프트 (prompt), 장면에 넣지 말아야 하는 것은 네거티브 프롬프트 (negative prompt)

  • 의상의 크기를 조정하거나 위치를 조정하는 것은 아웃페인팅(Outpainting) 또는 컨트롤넷(ControlNet)

이 바로 그것이죠.

그렇다면 직접 만들어 볼 수는 없을까요? 🤔

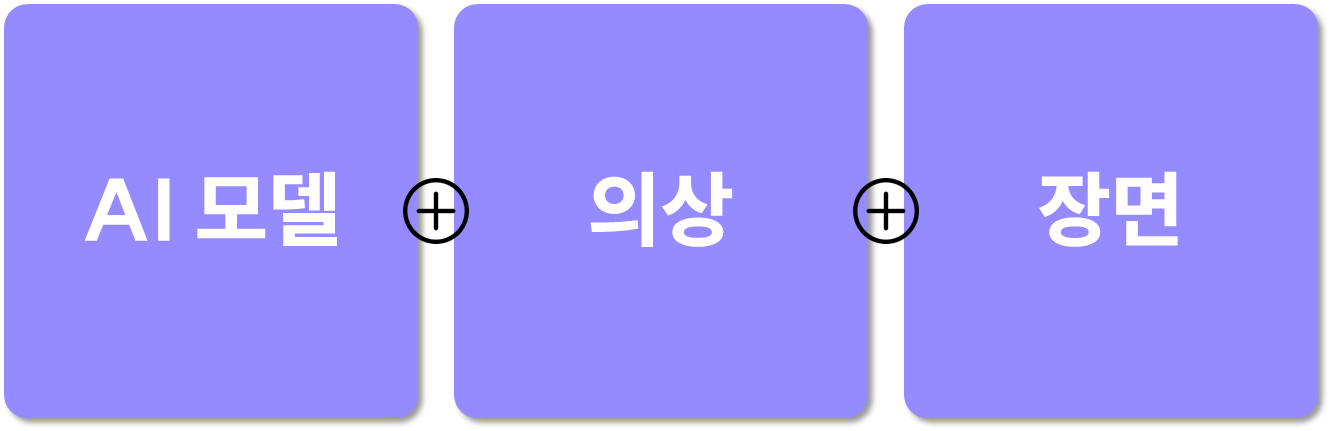
Booth.ai 에서 모델 컷 1장을 생성하기 위해 필요했던 것은 다음과 같습니다.

image.png

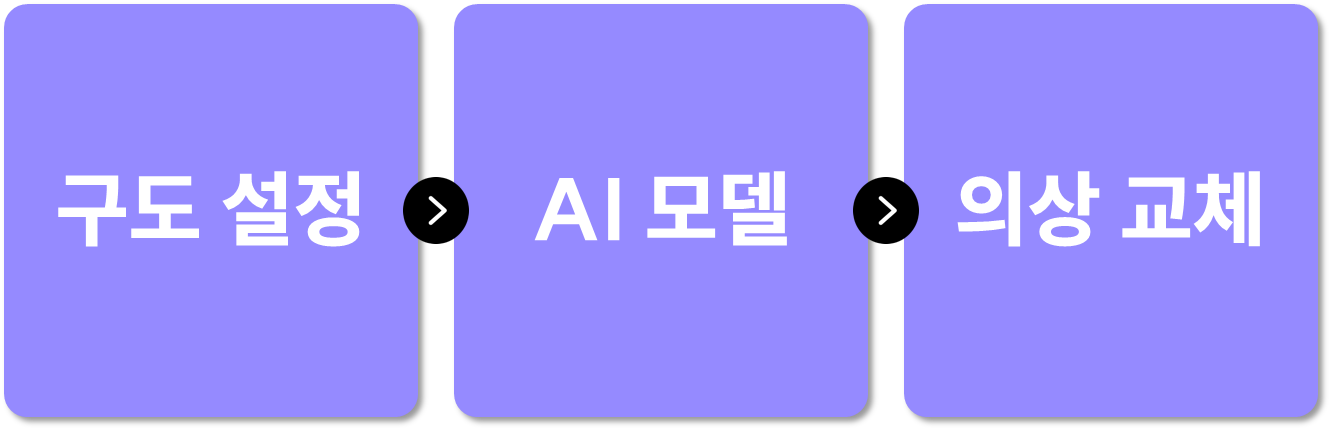
그렇지만 저는 1) AI 모델에 제한을 두고 싶지 않았고, 2) 의상의 위치나 구도가 고정되면 부자연스러워 보일 것이라 생각했습니다. 그래서 다음과 같은 작업 과정을 거쳤습니다.

image.png즉,

  1. 우선 원하는 구도를 미리 확정합니다.

  2. 그리고 해당 구도와 원하는 장면 스타일에 맞추어 AI 모델이 들어간 사진을 제작합니다.

  3. 마지막으로 모델 컷에 활용할 의상을 입혀줍니다.

어떻게 보면 모델에 의상을 입혀주는 과정의 순서가 뒤로 밀린 것을 제외하고는 실제 작업 과정과 동일한 것이죠.

그리고 그 결과는 아래와 같습니다.

완성 예시_1.png완성 예시_2.png완성 예시_3.png

2편에서 실제 작업 과정 만을 담은 내용으로 돌아오겠습니다.

이미지 AI 모델이 궁금하시다면 언제든 연락주세요!
이정민 (스모어톡, tonylee@smoretalk.io)
플라멜 Flamel v0.1

프롬프트 엔지니어링이 필요 없는 가장 쉬운 검색형 이미지 생성 서비스

19
2
이정민

이정민

(인터뷰 중) 인터뷰에서 알게 된 사실 3가지 💡

1차 베타를 성공적으로 마친 이미지 어시스턴트, 플라멜을 특정한 유즈 케이스 또는 워크플로우를 위한 프로덕트 (근거-링크) 로 만들고자 인터뷰를 진행중입니다

컴퓨터로 화상 회의하는 남자.pngMade with 플라멜 (👉 테스터 등록하기)

생성 AI, 이전에는 Web3 를 보면 고객들의 세부적인 문제를 검증하는 것이 사실 잘 안 이루어졌습니다. 근본적으로 새로운 세상이 열려, 소비자가 문제를 인식하는 것 자체에서 어려움이 많았기 때문입니다.

올해 초, 시드 투자를 유치한 스타트업의 면을 보면 특정 고객을 위한 문제 해결 보다는 특정 시장의 문제를 해결하기 위한 팀이 많이 보이는 것이 눈에 띕니다.

스모어톡도 이미지 시장, 그리고 이미지 생성 모델의 문제에 주목해 MVP를 시도했고, 페르소나를 한정하지 않은 고객 인터뷰를 통해 플라멜을 만들었고, 만족스러운 베타 테스트 결과를 확보했습니다.

그런데 특정 사용자 군에서 이용률이 높은 것을 확인했고, 이 분들을 위한 피쳐를 찾는 것이 중요하다고 생각했습니다. 그래서 오랜만에 다시 팀이 설정한 페르소나 내 잠재 고객분들을 만나 인터뷰를 진행하고 있습니다.

그리고 느낀 것을 3가지로 요약해 정리합니다.

사람들 이야기를 듣는 것은 재밌다. 그리고 재밌어 해야 인터뷰도 효과적으로 진행된다.

창업을 하고 사실 사람들을 많이 만나지만, 개인적인 이야기를 들을 수 있는 시간은 많지 않았습니다. 그런 점에서 제가 일해보지 않은 영역에서 경험을 쌓으신 분들의 이야기를 들으니 흥미롭더라고요. 재밌다 보니까 자연스럽게 공감하는 리액션을 많이 하게 되었는데, 인터뷰 종료 전 추가적으로 열심히 보충 답변을 해주셔서 인사이트를 더 많이 얻을 수 있었습니다.

보상을 바라고 인터뷰를 하지 않는다. 지인은 더 그렇다.

타 커뮤니티에도 허락 하에 인터뷰 요청 글을 게시했는데, 15분 포커스 그룹 인터뷰 참여 치고는 보상(5,000원 기프티콘)이 저렴하다 라는 댓글을 받게 되었습니다.

맞는 말씀이시더라고요. 저는 질문의 깊이(내부적인 내용을 공유하는 정도)와 개수에 맞추어 잠깐이면 나쁘지는 않겠다 라는 생각이 있었는데 오산이었습니다.

그래서 인터뷰를 참여해주신 분들께 죄송스러웠고 감사했습니다. 그런데 모든 분들이 보상이 아니라 정말 팀의 아이템을 도와주고 싶어서, 그리고 본인의 문제를 풀고 싶어 참여하셨다고 말씀을 주셨습니다. (당연히 플라멜 사용 권한을 드릴 예정입니다)

지인은 더 그렇습니다. 위 두 개의 이유와 더불어 저를 도와주고 싶었던 것에서 시작한 것도 있기 때문에 관련해서 주변 아는 사람을 연결해주려고 하는 지인 분들이 많이 계셨습니다. 평소에 정말 잘 살아야 겠다는 생각을 하게 되는 순간이었죠.

하나의 문제 내에 이해 관계자가 정말 많다

같은 직업이어도 어떤 규모의 회사에 속해 있는지, 같은 회사 내에서도 어떤 직업을 가지고 있는 지에 따라 일이 진행되는 과정은 천차만별이었습니다. 당연히 플라멜에 기대하는 역할에 대해서도 다양한 의견을 주시더라고요. 인터뷰를 먼저 진행하고, 마무리 멘트로 만들고자 하는 서비스에 대해 이야기하면 많은 피드백을 받을 수 있을 것입니다.

이미지 작업을 쉽게 만들어 주자 에서 시작되었지만, 이미지 작업이라는 하나의 워크플로우 내에는 다양한 사람들이 관여가 되기 때문에 문제를 정렬하고, 문제를 해결하는 유니크 피쳐를 개발하는 것이 위 글에서 맨 처음에 언급한 특정한 유즈 케이스 또는 워크플로우를 위한 프로덕트를 만드는 데 도움이 될 것이라 생각하게 되었습니다.

그래서 추가적으로 5분의 이야기를 더 듣고 싶습니다.

  1. 마케터, 디자이너, 기획자인 분

  2. 또는 광고업에서 근무한 경험 보유 또는 현재 근무 중인 분

  3. 또는 디자인 에이전시에서 근무한 경험 보유 또는 현재 근무 중인 분

  4. 또는 이미지 어시스턴트가 필요하다고 생각하는 분

라면 아래 링크에서 15분을 예약해주시면 감사드리겠습니다.
(아니면 댓글로 남겨주시면 직접 연락드릴게요!!!)

플라멜 Flamel v0.1

프롬프트 엔지니어링이 필요 없는 가장 쉬운 검색형 이미지 생성 서비스

8
2
이정민

이정민

(☕ 1잔씩 하세요) 마케터, 디자이너, 기획자 10분 모십니다

이미지 어시스턴트 플라멜의 성장을 위해
마케터, 디자이너, 기획자 10분께 15분의 인터뷰를 부탁드립니다. 🙏

안녕하세요,
누구나 쉽게 사용 가능한 이미지 어시스턴트 플라멜을 만들고 있는 스모어톡 이정민입니다.
(플라멜이 궁금하시다면 👉 링크)

1차 클로즈 베타를 마친 이후,
플라멜의 고도화를 위해서 실제 마케팅, 디자인 분야 현업에 계신 분들을 대상으로 인터뷰를 부탁드리고자 합니다.

인터뷰는 구글 미트를 통해 9/14(목), 9/15(금) 에 진행할 예정입니다.

15분 길이의 인터뷰에 참여해주시는 경우, 스타벅스 라떼 1잔 (5,000원) 기프티콘을 드립니다.

(당연히 플라멜 서비스 오픈 시 혜택을 제공해드릴 수도 😆)

👇👇👇 아래 센드타임 링크를 통해 시간을 예약해주세요!

  • 본 10분 인터뷰는 과제를 내어주신 한양대학교 창업지원단을 통한 후원으로 진행됩니다.

  • 플라멜을 어떻게 사용하는 지 궁금하시다면 👉 링크

방에서 인터뷰하고 있는 기자.pngMade with 플라멜 (👉 테스터 등록하기)

플라멜 Flamel v0.1

프롬프트 엔지니어링이 필요 없는 가장 쉬운 검색형 이미지 생성 서비스

13
0
이정민

이정민

[스모어톡의 손을 잡아준 사람들] 'Global & Tech' 포스텍홀딩스

붉은 빛이 감도는 공장에서 컨테이너 벨트를 따라 철판이 돈이 되고 로봇이 되는 모습이 보인다, 일러스트  -24727.png

23' 상반기 스타트업 투자 금액은 70% 감소. 창업가가 마주한 현실입니다.

하지만 냉혹한 현실을 마주한 스모어톡의 손을 잡아 준 두 곳의 기관이 있습니다.

오늘은 이전 포스팅에 이어 다른 한 곳에 대한 설명을 드려볼까 합니다.

바로 포스텍홀딩스(포항공과대학교기술지주) 입니다.

--

3줄 요약

  1. 포스텍홀딩스는 포항공대가 100% 출자한 대학 AC.

    지역 및 대학 인프라 활용한 초기 투자에 집중하는 액셀러레이터.
    참고로 포항공과대학교가 위치한 경북도의 지역뉴딜펀드를 조성하기도 했습니다.

  2. 포스코와 연계하여 다양한 사업 지원 프로그램 연결.
    심지어는 글로벌 행사까지 참여해볼 수도 있습니다.
    서비스 운영에 필요한 교육 및 서울창업허브와 연계한 사업비 지원, 심지어는 CES, 스타트업 월드컵 등에 참여할 기회까지!

  3. 매번 "지금까지 잘해주고 있습니다" 를 차분히 말씀해주시는 선배 같은 투자사.

    그래서 9월 10일 자정에 마감하는 제26회 포스코 아이디어 마켓 플레이스. 지원 안하실 건가요? (링크 또는 QR 스캔)

--

세 번의 미팅, 하나의 결론

첫 번째 커피챗, 대화를 통해 따뜻함을 건네다

작년 5월, 스모어톡 팀은 카이스트 창업경진대회인 E*5 KAIST에 참여하던 중 우연히 포스텍홀딩스 정인오 팀장님의 연락을 받게 됩니다. 좋은 창업팀을 찾고자 다양한 팀을 보고 싶은 것이 이유였습니다. 사실 좋은 창업팀이라기에 스모어톡은 멘탈케어 시장 내 고객의 니즈를 찾고자 AI 대신 스스로가 챗봇이 된 예비 창업팀에 불과했습니다. (링크)

그런데 그 때부터 팀에 대한 응원과 아이템에 대한 공감을 말씀해주시더라고요. 따뜻한 말이 팀에 도움이 되는 것은 아닐 수도 있으나, 거절에 익숙한 창업팀에 위안이 되어주는 느낌을 받았습니다. 커피챗 막바지에는 직업으로서 투자에 대한 관점과 함께 사적인 얘기를 하기까지 무던하게 대화를 진행해주시는 점이 인상 깊었습니다.

두 번째 커피챗, 공감을 통해 따뜻함을 건네다

정주영창업경진대회 참여가 한창이었던 8월에도 팀장님과 다시 커피챗을 진행했습니다. 아이템에 대한 기획을 처음 보여드렸던 시간이었던 것 같습니다. 그리고 정리되지 않은 관련 아이디어를 쏟아내는 우를 범했습니다. 그런데, 그 때도 아이템에 대한 문제보다는 본인의 경험에서 비롯된 공감, 아이디어를 검증할 방법에 대해 같이 고민해주셨습니다.

세 번째 미팅,이해를 통해 따뜻함을 건네다

작년 12월 아이템 피봇(pivot)을 결정하게 되면서, 팀장님께 '아이템을 바꾸었고 해당 아이템으로 PMF 찾아보겠다, 그리고 생성 AI로 이 문제를 풀기 위해선 프롬프트 변환 기술이 필요하다' 라고 말씀드렸습니다. 이후 팀장님께서 주신 답변에서 놀랐습니다. '타 서비스를 사용 해봤고, 어떤 점에서 팀의 주장에 대해 이해한다' 라는 실제 유저의 반응, 그리고 기술 경쟁력에 대한 분석을 투자사에서 처음으로 전달 받았기 때문입니다. 챗GPT가 한국 뉴스에 오르내리기 시작한 것이 1월 말이었기 때문에, 생성 AI의 문제에 대해 소개하는 것이 사실 쉬운 일은 아니었습니다. 생성 AI도 무언가 싶었던 시기였으니까요. 미팅 외 시간에 기술에 대해 분석함과 동시에, 창업팀을 아이템에 대한 전문가로 인정해주시기 때문에 가능한 일이었습니다.

이후 4월, 스모어톡은 제25회 포스코 아이디어 마켓 플레이스에 지원했고, 앞선 세번의 개별적인 미팅 및 프로그램 준비의 결과는 시드 투자 유치 였습니다.

image.png

Global 🌏 No.1 Tech Accelerator 🚀

말로만 외치지 않는 투자사의 비전

사실 모든 투자사, 또는 저희 같은 기업이 거창한 목표를 말하곤 합니다. 그런데 목표가 단순히 하나의 문장에 그친다면 의미가 바랠 것입니다. 포스텍홀딩스는 관계사 포스코와의 연계를 통해 글로벌 프로그램 참가를 지원 할 뿐만 아니라 딥테크 TIPS 등 기술창업팀에 대한 후속 지원에 열정을 쏟고 있습니다.

스모어톡이 6월 포스코 IMP 합격 발표 이후 3개월 간 소개 받은 프로그램은 다음과 같습니다. (참고로 프로그램 소개는 합격과 전혀 관계가 없음을 알려드립니다)

  • CES 2024 포스코-포스텍 공동관 (한국 CES 지원 프로그램 중 가장 많은 지원 제공)

  • 2023 IFA NEXT 'Global Business Challenge' 통합 전시 부스 (지원하지 않음, 서비스 개발에 전념 위함)

  • 2023 스타트업 월드컵

  • 포항공과대학교 SES 인턴십 프로그램

  • 체인지업 패밀리 라운드테이블 (대기업-스타트업 협업)

  • 베네핏 파트너사 행사 제공

    • AWS

    • 구글 클라우드

    • 슈퍼코더

    • ZUZU

    • 법무법인 이후

  • (Wow!) 그 외 포스코 그룹에 요청하고 싶은 니즈 조사

적어보니까 정말 많네요. 기회를 받는 것도 중요하지만, 말 그대로 기회에 대한 시작을 지원해주는 것이지 좋은 결과로 이어지는 것은 스타트업에 달린 일이기 때문에 스모어톡을 포함한 많은 포스텍홀딩스 포트폴리오사가 기술 고도화 및 글로벌 시장 진입에 노력을 하는 것 같습니다.

실제로 저희 팀의 예시를 들어보면,

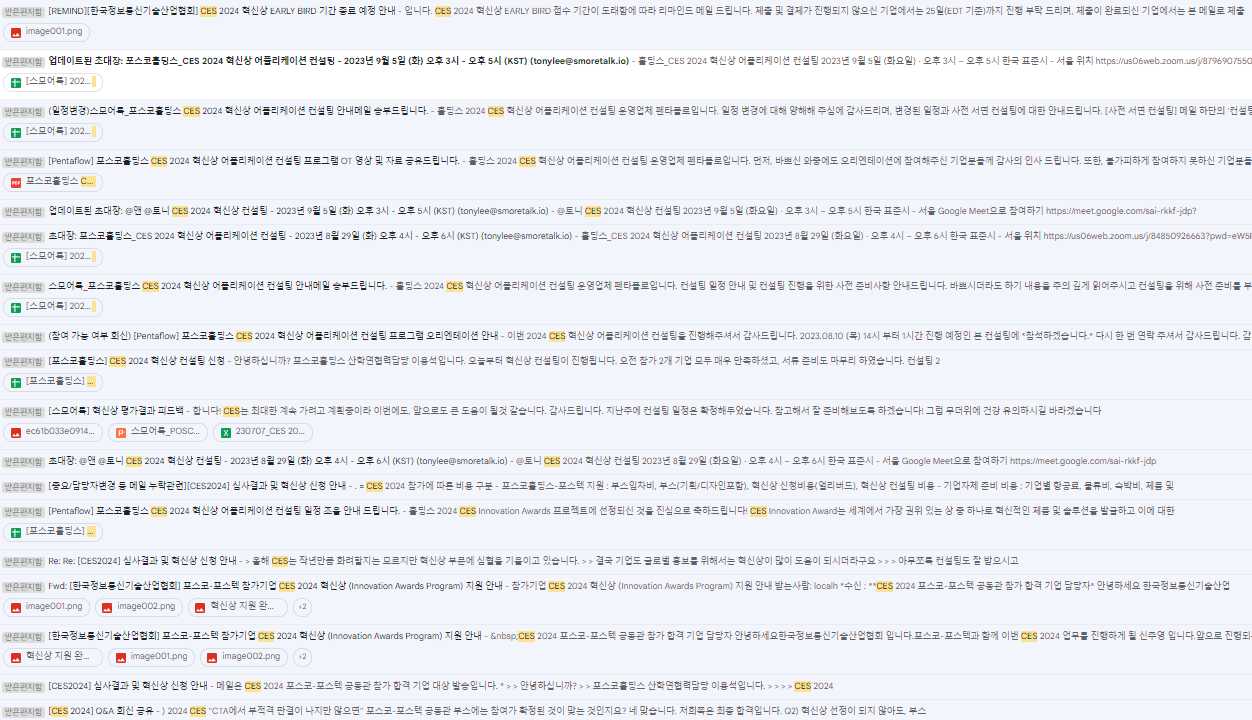
아래 이미지는 스모어톡의 CES 2024 지원 시 받았던 평가입니다. 아이디어와 이를 설명하는 방식은 좋았지만, 글로벌 진출의 관점에서는 준비가 더 필요하다는 평가를 받았습니다.

image.png그런데 막상 기회를 받게 되니 글로벌 진출 준비를 하게 되더라고요.
아래 이미지처럼 다양한 추진 기관의 컨설팅을 통한 서비스 소개 전략 수립 및 사이트 및 비디오 수정을 통해 글로벌 시장에서의 접점을 늘리고 있습니다. 해당 과정 이후 She Loves Tech, KOREA-JAPAN Startup Connect Plus 등에서 외국 고객, 바이어, 투자사와 미팅을 확보하게 되었습니다.

image.png이처럼 포스텍홀딩스의 포트폴리오사가 되면서 투자사의 방향성이 스타트업에 전달되는 과정에 대해 많은 인사이트를 느끼게 되었던 것 같습니다. (스모어톡의 글로벌 웹사이트가 궁금하다면 링크)
image.png

제26회 포스코 아이디어 마켓 플레이스가 모집중입니다

지난 8월 14일 부터 9월 10일 자정(매우 중요!)까지 포스코 지원, 포스텍홀딩스 운영으로 진행되는 대기업 최초 사외 스타트업 발굴 육성 프로그램, 포스코 아이디어 마켓 플레이스가 26기 참여 기업을 모집 중에 있습니다.

전 산업 분야 예비창업자 및 창업 3년 미만 스타트업 을 대상으로,
위에서 언급했던 내용과 더불어 창업 전주기에 대해 다양한 지원이 제공됩니다. 리스트로 정리해드릴게요.

  • 최대 5억원 투자, TIPS 프로그램 연계, 서울경제진흥원 연계 사업화/글로벌 진출 지원금(1천만원 이상)

  • 포스코 그룹사 협업

  • 체인지업 그라운드 및 서울창업허브 공덕 입주 우대

  • 법무법인 오피스 아워, 파트너사 연계 지원 등의 베네핏

  • 스타트업 월드컵 POSCO IMP 지역 예선 참가권

  • 테크크런치 디스럽트 참가 지원

  • CES 참가 지원


지난 세 번의 만남에서는 대화, 공감, 이해를 통해 창업팀을 따뜻하게 받아주셨다면, 이제는 더 큰 꿈을 꿀 수 있게 지원해주고 계신 포스텍홀딩스에 다시 한 번 감사의 말씀을 드리고,
제26회 IMP에서도 열정적인 팀이 한국을 넘어 세계를 향해 꿈을 꾸는 도전에 나서기를 기대하겠습니다.

(포스코 아이디어 마켓 플레이스 지원에 대한 내용이 궁금하다면 링크)

p.s. 본 프로그램과 관련한 내용이 궁금하시다면 tonylee@smoretalk.io 나 디스콰이엇 커피챗으로 연락 주세요. 가장 편한 이미지 어시스턴트, 플라멜과 관련해 문의주셔도 좋습니다 :)

플라멜 Flamel v0.1

프롬프트 엔지니어링이 필요 없는 가장 쉬운 검색형 이미지 생성 서비스

7
1