Yoon Jeong Choi
반갑습니다^~^
AI 관련 프로젝트들을 함께 공유하며 최신 기술들을 직접 활용할 수 있도록 배워가는 클럽입니다. 온라인 뿐만 아니라 오프라인 정기 모임을 통해 스타트업 파운더들, 빌더들, 학생들이 함께 모여 서로 인사하고 아이디어를 키워갈 수 있는 클럽이 될 예정입니다.
가이드라인
["클럽 신청 전 디스콰이엇 프로필(이력, 스킬, 관심 토픽)을 꼭 작성해주셔야먄 클럽 가입이 승인됩니다. ","만들고 있는 프로덕트도 있다면 프로필에 올려주세요. ","클럽 승인이 되면 오픈카톡방에 초대해드리겠습니다.","AI 활용 사례와 실제로 활용하기 위해 만드는 법까지 공유할 예정입니다.","정기 오프라인 모임과 세미나들을 열 예정입니다."]
Yoon Jeong Choi
반갑습니다^~^
김정래
제가 만든 챗봇 링크입니다.
https://carillon-legal-chatbot.streamlit.app/
데모라 streamlit에 올렸습니다.
그래서 제가 만든게 뭐냐면,
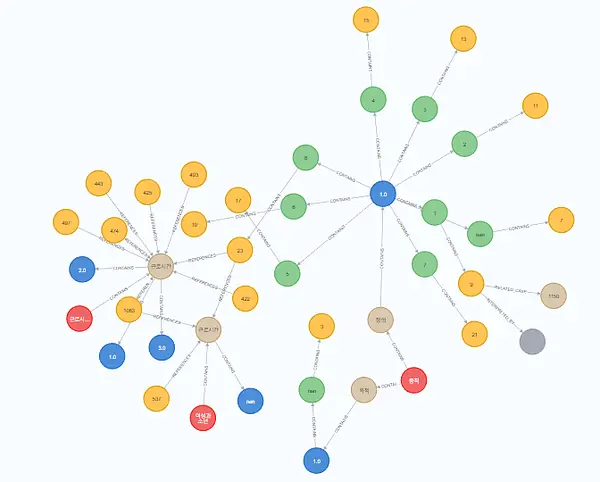
1. 근로기준법과 관련 행정해석, 판례를 graph db 넣은 후
2. 유저의 질문과 관련된 데이터를 graph db에서 뽑아낸 뒤에
3. 이를 바탕으로 유저에게 답해주는 챗봇입니다.
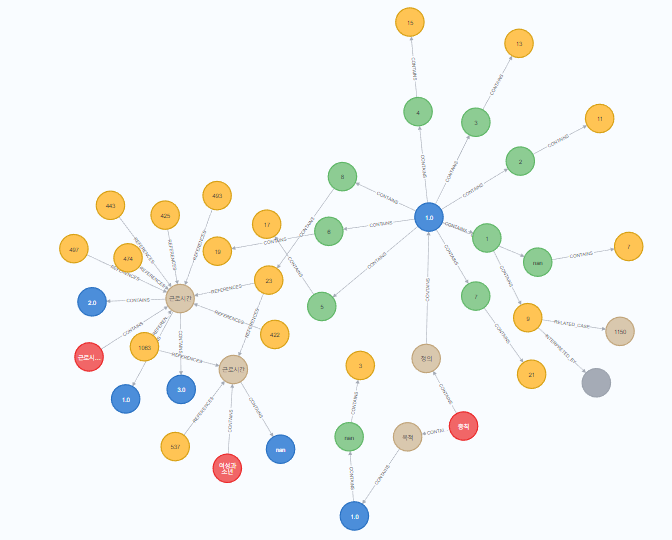
아래 이미지처럼 법과 관련된 판례, 행정해석들을 서로 연결하여 저장했습니다. 그리고 유저가 질문을 하면 아래 그래프에서 법과 그 법과 연결된 판례 및 행정해석을 뽑아낸 후 프롬프트에 해당 내용을 추가합니다. 쉽게 오픈북 테스트를 보는 챗봇라고 보시면 됩니다. 유저가 낸 문제를 책(graph db)에서 찾아서 유저가 낸 문제의 맞는 형태로 답변을 줍니다.
넣은 판례 데이터가 해고, 휴가, 근로계약 쪽이라 이 부분과 관련해서 물어보면 잘 답변해줍니다.
추천 질문
1. 최근에 일을 못한다고 갑자기 짤렸는데, 어떻게 해야 하나요?
2. 병원이 영업정지를 당했는데, 영업정지 오기로 했던 간호사에게 휴업수당을 줘야 하나요? 그 간호사는 한번도 일하지 않았습니다.
3. 지각했다고 휴가를 뺏었는데 말이 되는건가요?
네이버지식인 예시(해당 링크)
질문 : 해고시기와 해고사유에 관하여 이메일(e-mail)로 통지를 받았어요. 유효한 해고로 볼 수 있을까요?
챗봇 답변 :
따라서, 이메일로 해고 통지를 받은 경우라도 다음 조건이 충족되면 유효한 해고로 인정될 수 있습니다.
1. 이메일에 해고사유와 해고시기가 명확히 기재되어 있을 것.
2. 근로자가 이메일을 수신하여 그 내용을 알고 있을 것.
만약 이러한 조건이 충족된다면, 이메일에 의한 해고 통지는 유효한 서면 통지로 간주될 수 있습니다. 관련 판례는 여기에서 확인할 수 있습니다.
지식인답변(대한법률구조공단) :
따라서 단지 이메일로만 통지를 받았다는 사유만으로 해고가 무효로 되는 것이 아니라 구체적인 사정을 따져보아 근로자가 해고시기와 해고사유에 대해서 알 수 있었던 경우로 인정되는 때에는 유효한 방식의 해고로 인정될 수 있다고 보아야 합니다.
(지식인의 자세한 답변은 위 링크에서 볼 수 있습니다.)
만들면서 느낀 점
LLM 성능이 좋아지면서 graph db에서 데이터를 검색하는 명령어를 LLM이 잘 만들어낸다. gpt-3.5에서는 안됐었는데, gpt-4 부터는 매우 잘해줍니다.
Graph db + vector similarity 를 활용한 Graphrag 는 성능이 좋지만 비용이 비싸다(gpt-4o 기준으로 1번 검색에 100원정도 들었던거 같아요)
Graph db를 LLM이 만들어도 되지만, 직접 만들면 성능이 더 좋습니다.
Graph database(그래프 데이터베이스)
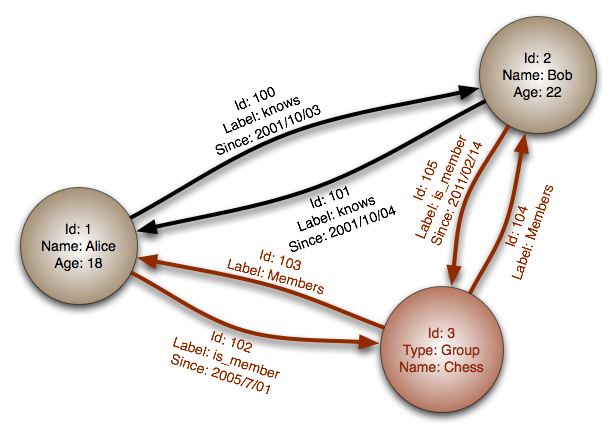
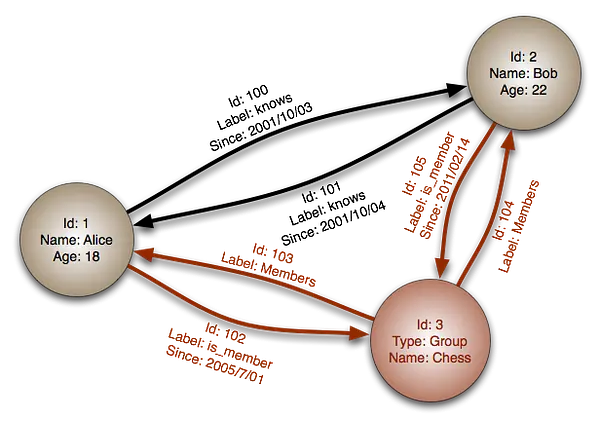
기존 데이터베이스는 엑셀처럼 데이터를 표 형태로 저장한다면, graph db는 마인드맵처럼 정보들을 점(node) 형태로 저장하고, 그 점들의 관계를 연결하는 형태의 데이터베이스입니다.
아래 예시 이미지처럼 Alice와 Bob이라는 점을 만들고, 둘이 서로 2001/10/03부터 알고 지냈다는 관례를 만들어 저장합니다.
An example of a Labeled-property graph<by Ole Mussmann, wikipedia>
궁금한게 있으시면, 편하게 물어봐주세요. 사실 저도 잘 모르기 때문에 뻔뻔하게 답변드릴 수 있습니다 :)
챗봇은 법률상담이나 예측 등 법률사무를 하지 않습니다. 결과는 단순 참고용으로만 사용하시고, 정확한 상담은 변호사에 문의하시기 바랍니다.
정종학
세상 간단한 LLM의 원리 (Llama3 오픈소스 살펴보기)
LLM을 ChatGPT와 Claude.ai 와 같은 클라이언트 서비스로 이용만 해왔지 돌아가는 원리나 내부 구조를 알지 못했는데요.
최근에 아래의 영상을 보게 되며 생각보다 간단하구나 (영상이 정말 쉽게 잘 설명을 해주고 있었습니다) 라는 생각을 하며, 최근 메타가 공개하며 이슈가된 Llama3의 오픈 소스를 살펴 보았습니다. 영상의 설명 처럼 생각보다 간단하게 파일들이 구성되어 있었습니다.
Llama3 코드는 Python으로 작성되었고, run 파일 몇개와 140GB에 달하는 파라메터를 다운 받을 수 있게 하는 shell 파일로 구성되어 있었습니다. 정말 세상 간단했군..? 그러나 그것을 커스텀하고 원하는 결과의 아웃풋을 만들어 내는 것은 간단하지는 않겠죠? :D
코드의 결과물이라 할 수 있는 Application들이 결국에 인풋(요청)과 아웃풋(응답)으로 동작 하는 파일들의 집합체인 것은 어떻게 보면 세상 간단하네 라고 할 수도 있는데요.
저희 모카클래스의 웹과 모바일 앱도 결국엔 파일들(몇개는 아니고 LLM 보다는 훨씬 많은데요. LLM의 파일 수는 생각보다 적었고, GPU를 통한 학습의 결과물인 파라메터 파일의 크기가 아주 큰편입니다. OpenAI가 GPU 운영으로 왜 그렇게 많은 비용이 드는지 영상을 통해 이해 할 수 있었습니다.)의 구성으로 인풋(요청)에 따른 아웃풋(응답)을 내어 주는 기계에 불과? 하다고도 할 수 있습니다.
그 동안 원리도 모른채 손쉽게 이용만 했었던 LLM 서비스들의 원리와 내부 구조를 위 영상으로 일부 이해해 볼 수 있었습니다.
LLM의 기본 구조:
대형 언어 모델은 두 개의 파일로 구성됨: 파라미터 파일과 실행 코드
파라미터 파일은 모델의 '지식'을 담고 있는 숫자들의 집합
실행 코드는 이 파라미터를 사용해 텍스트를 생성하는 프로그램
예: LLama 2의 70B 모델은 140GB 크기의 파라미터 파일을 가짐
훈련 과정:
사전 훈련 (Pre-training): • 인터넷에서 수집한 대량의 텍스트 데이터 사용 (약 10 테라바이트) • 6,000개의 GPU를 사용해 약 12일 동안 훈련 • 비용은 약 20억 달러 소요 • 목표는 인터넷 텍스트를 '압축'하여 모델의 파라미터로 변환
미세 조정 (Fine-tuning): • 특정 작업이나 스타일에 맞게 모델을 조정 • 고품질의 Q&A 형식 데이터 사용 (약 100,000개 문서) • 인간 레이블러들이 작성한 데이터로 훈련 • 사전 훈련에 비해 상대적으로 저렴하고 빠름
LLM의 작동 원리:
기본적으로 다음 단어를 예측하는 작업 수행
주어진 문맥을 바탕으로 가장 확률이 높은 다음 단어 선택
이 과정을 반복하여 전체 텍스트 생성
단순해 보이는 이 작업이 실제로는 세상에 대한 광범위한 지식 요구
모델 성능 향상:
'스케일링 법칙': 더 많은 데이터와 더 큰 모델로 성능 향상
파라미터 수(n)와 훈련 데이터 양(d)이 주요 변수
성능은 이 두 변수의 예측 가능한 함수
현재 추세는 계속해서 더 큰 모델과 더 많은 데이터 사용하는 것
LLM의 능력:
도구 사용: • 인터넷 검색, 계산기, 코드 실행 등 외부 도구 활용 가능 • 복잡한 작업을 여러 단계로 나누어 해결
멀티모달 처리: • 텍스트뿐만 아니라 이미지, 오디오 등 다양한 형태의 입력 처리 가능 • 이미지 생성, 음성 인식 및 생성 등의 기능 통합
미래 발전 방향:
시스템 1과 시스템 2 사고 구현: • 빠르고 직관적인 사고(시스템 1)와 느리고 분석적인 사고(시스템 2) 구현 • 복잡한 문제 해결을 위한 '사고 시간' 부여 가능성
자기 개선 능력: • AlphaGo처럼 자체적으로 성능을 향상시키는 방법 모색 • 언어 모델에 적합한 '보상 함수' 개발 필요
사용자 맞춤화: • 특정 작업이나 도메인에 특화된 모델 개발 • GPT 앱 스토어 등을 통한 맞춤형 모델 제공
보안 문제:
탈옥 공격 (Jailbreaking): • 모델의 윤리적 제한을 우회하여 부적절한 내용 생성 유도 • 역할 놀이, 인코딩된 메시지 등 다양한 방법 사용
프롬프트 인젝션: • 악의적인 지시를 숨겨 모델의 행동 조작 • 이미지나 문서에 숨겨진 지시로 개인 정보 유출 가능성
데이터 포이즈닝: • 훈련 데이터에 악의적인 정보를 삽입하여 모델 오작동 유도 • 특정 트리거 단어나 구문에 반응하도록 모델 조작
영상은 LLM을 새로운 컴퓨팅 패러다임으로 소개하며, 그 잠재력과 함께 직면한 도전 과제들을 상세히 설명합니다. Andrej Karpathy는 이 기술의 현재 상태와 미래 발전 방향, 그리고 관련된 윤리적, 보안적 문제들에 대해 포괄적인 시각을 제공합니다.
Jae Shin
안녕하세요 반갑습니다
유투브를 통해 가입하게 되었습니다
저는 건축설계를 하다가 지금은 시설물 설계를 하고있습니다. 주변에서 인공지능 애기를 많이하여 궁금해서 찾아보다가 가입하게되었습니다
유서경 Quartz
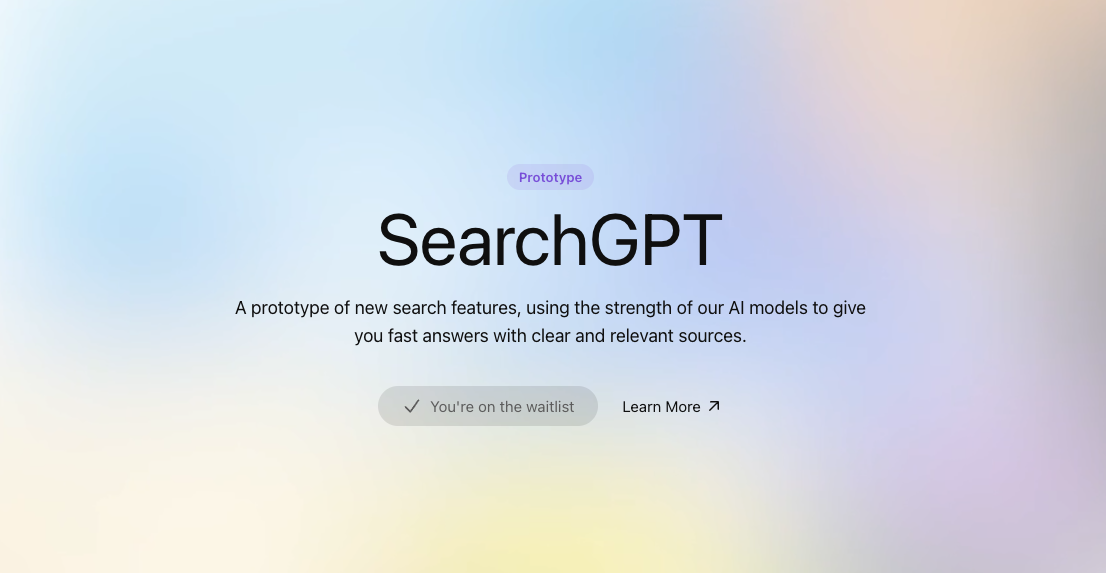
Open AI에서 SearchGPT waitlist를 받고 있습니다. 아직 프로토타입 형태이지만 실시간 출처를 기반으로 대화 형태의 검색을 할 수 있다고 하네요. UX는 Perplexity와 비슷할 것으로 예상한다고 합니다.
팀에 속해있는 계정은 waitlist로 등록이 안되는 것 같네요. 저는 다른 개인 계정으로 등록해두었습니다 ㅎㅎ
Liner를 사용한 영상 요약본을 함께 공유드려요.
이 영상은 OpenAI가 SearchGPT라는 새로운 검색 엔진을 출시한다는 소식을 다루고 있습니다. 이 발표는 Google과 같은 기존 검색 엔진 기업들에게 큰 영향을 미치고 있으며, AI 기반 검색의 미래와 그 잠재적 영향에 대한 논의를 불러일으키고 있습니다.
OpenAI의 새로운 검색 엔진 발표
[0:14] OpenAI가 검색 사업에 진출한다고 블로그 포스트를 통해 발표했습니다.
[0:25] 현재 검색 제품의 프로토타입 버전을 테스트 중이며, 사용자들은 대기자 명단에 등록할 수 있습니다.
[0:51] 이 검색 엔진은 실시간 결과와 소스를 제공하며, 출판사 및 웹사이트와 협력하여 정보에 대한 적절한 접근과 인용을 보장합니다.
시장 반응과 경쟁 구도
[1:14] OpenAI의 검색 사업 진출 소식에 Google 주식이 2% 이상 하락했습니다.
[1:21] Microsoft(OpenAI의 주요 투자자)도 Bing 검색 엔진에 유사한 기능을 발표했습니다.
[1:32] Alphabet(Google 모회사)은 최근 실적 발표에서 AI 검색 제품에 대해 언급했지만, 수익성에 대한 구체적인 정보는 제공하지 않았습니다.
AI 검색의 미래와 도전 과제
[1:52] AI가 검색 산업에 미치는 영향에 대한 우려가 현실화되고 있습니다.
[2:22] 과거 Microsoft의 AI 챗봇 도입 사례를 언급하며, 실제 시장 점유율 변화는 미미했음을 지적합니다.
[2:55] AI 기술의 발전과 함께 검색 시장의 경쟁이 더욱 치열해질 것으로 예상됩니다.
기술 분배와 시장 지배력
[3:22] OpenAI는 이미 Apple과 제휴를 통해 ChatGPT를 iPhone에 탑재하고 있습니다.
[3:41] Google은 이미 많은 기기와 플랫폼에서 기본 검색 엔진으로 설정되어 있어, 시장 지배력을 유지하고 있습니다.
[4:18] OpenAI의 검색 엔진은 아직 테스트 단계이며, 성공을 위해서는 효과적인 배포 전략이 필요할 것으로 보입니다.
Justin Lee
안녕하세요. 배우러 왔습니다. 감사합니다.
고진우
프롬프트는
"우주여행사 웹사이트 만들어줘. 목숨걸고 가야하는 우주여행"
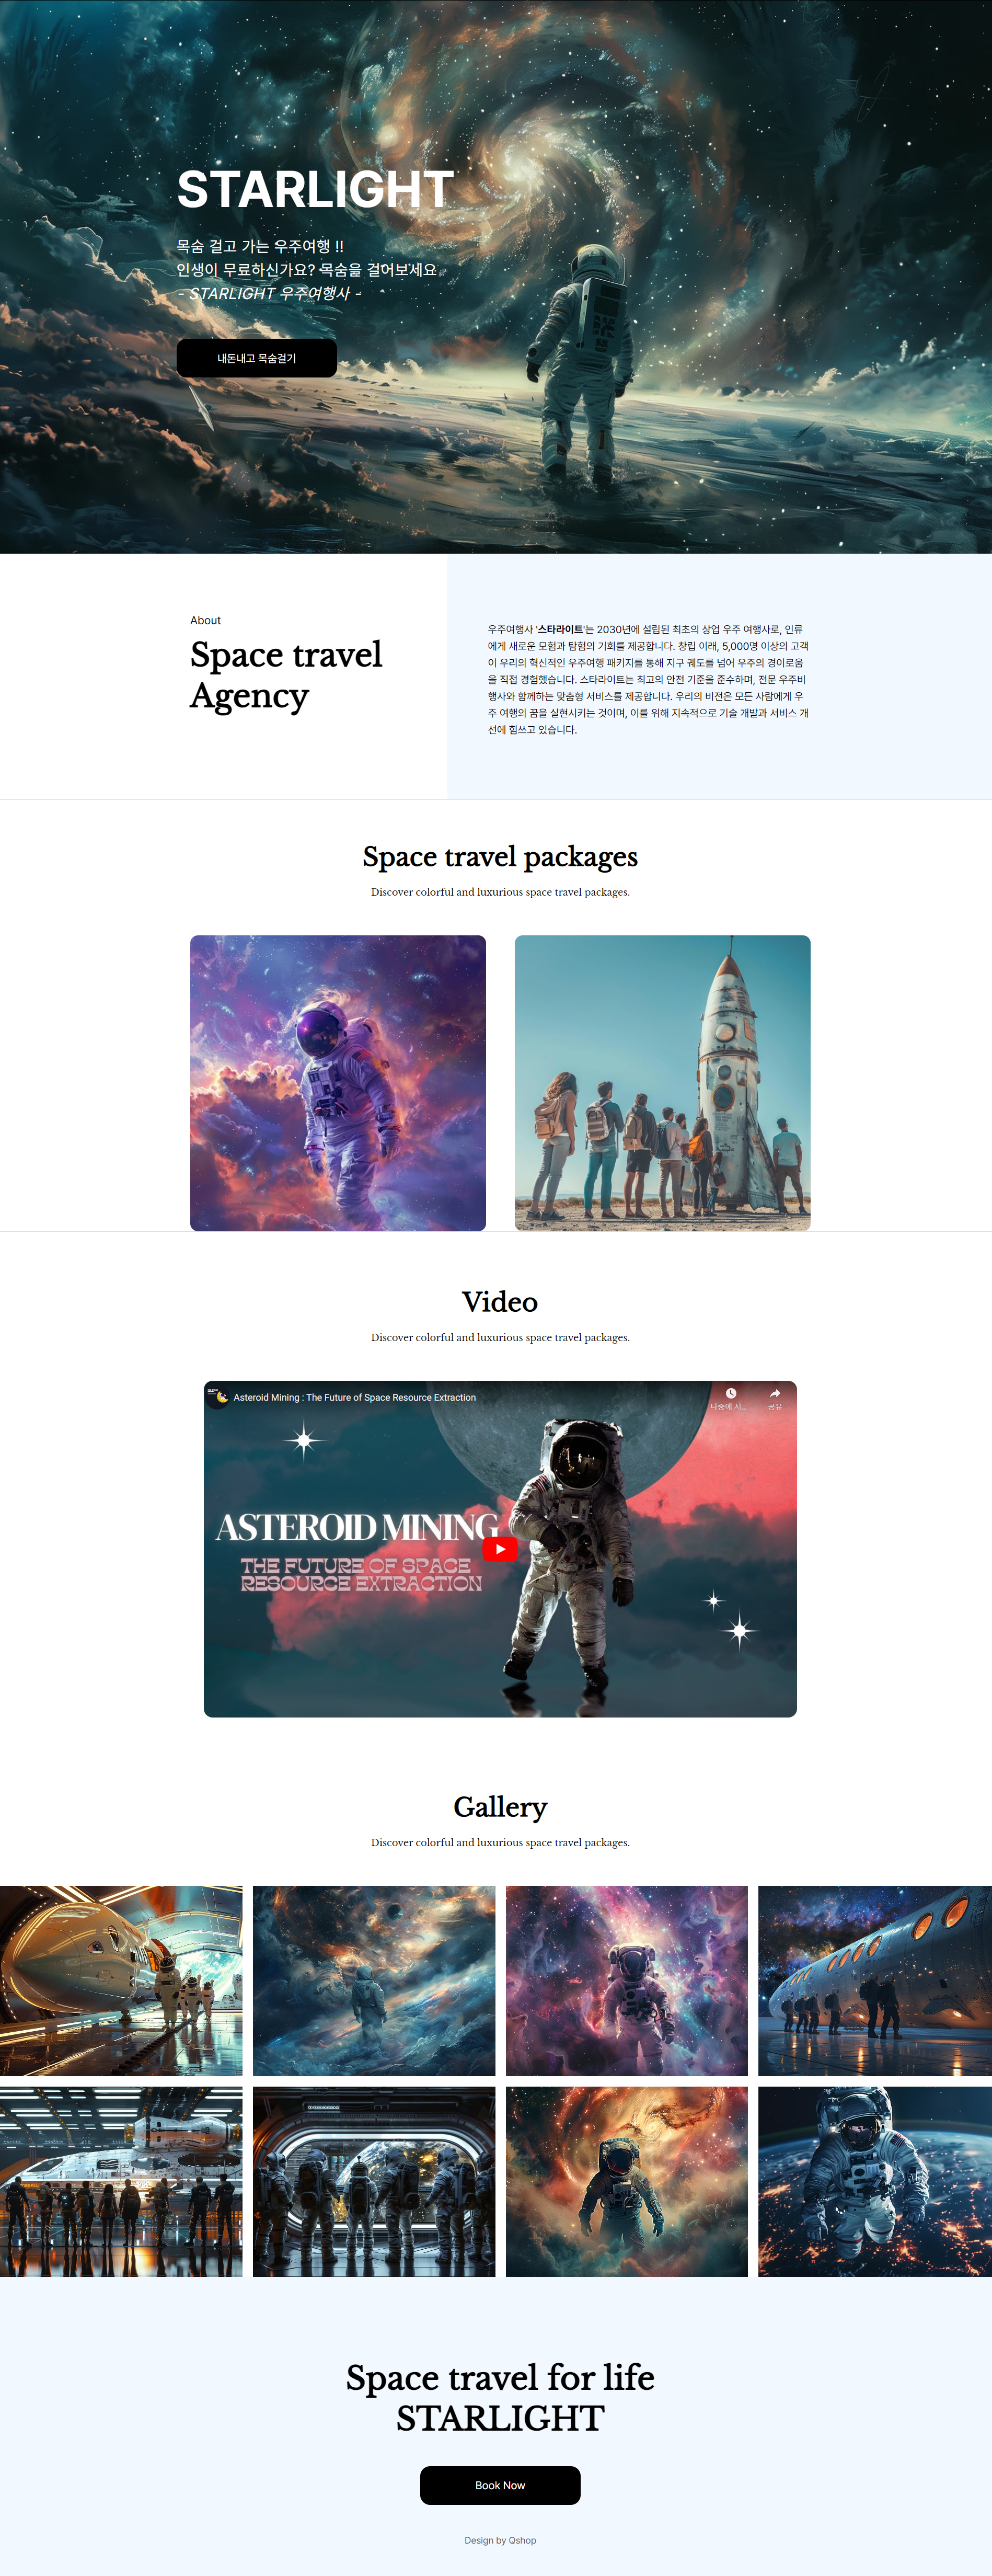
아직 알파 버전입니다.
곧 베타 버전 런칭예정입니다. 오픈되면 디콰에 글 올릴께요 😄
임세진
안녕하세요, 휴튼의 엔지니어 임세진입니다.
최근에 gpt-4o-mini 가 공개되면서, 휴튼의 맞춤형 질문생성에서 백본이 되는 모델을 업데이트 했습니다.
가격의 측면에서도 우수하지만, 생성되는 질문의 퀄리티 측면에서 상당히 우수해지더군요..
외부 모델에 의존해야 하는 단점이 아직 존재하지만, 달리 말하면 외부 모델이 발전할수록 서비스의 퀄리티가 올라간다는 의미가 됩니다. 그리고 질문 생성에 있어서 대체할 수 있는 모델들도 충분히 있어서 risk 측면에서도 오히려 괜찮다는 생각이 들더군요.
하드 트레이닝 #1
현재 휴튼은 프롬프트 버전 관리를 자체적으로 하고 있습니다. 아직은 조악한 형태이지만, 추후에는 원하는 결과물에 맞는 프롬프트를 추천해주는 자체적인 서비스도 만들 수 있을 것 같습니다.
하드 트레이닝 #2
외부 모델의 의존성을 줄이기 위해 성능이 딱히 좋지 않은 Decoder model 기반의 모델에서도 작동하는 질문 생성 pipeline을 구축하고 있습니다. 달리 말하면, 외부 모델이 좋아지면 경쟁력 있는 질문 생성 결과물을 얻어낼 수 있다는 의미입니다.
하드 트레이닝 #3
휴튼에서는 요즘 공감하는 질문을 생성하기 위한 시도들을 하고 있습니다. 다양한 방식으로 프롬프트를 제작하여 테스트해보고 있습니다.
휴튼
나도 몰랐던 나를 알아가는 질문들
이승민
안녕하세요, 저는 기계공학 전공을 하고 감속기 제조업 기술연구소에서 일하며 현재는 프로젝트 관리, 정부과제 위주로 업무를 수행하고 있습니다.
취미로 파이썬을 공부했고, 지금은 자바 기반의 백엔드 공부를 하고 있습니다.
개인적으로 생산성 향상을 위해 다양한 툴을 사용해보던 중 ai를 통해 제 취향에 맞는 것을 개발하고 싶어 다양한 분들의 조언을 얻고자 가입했습니다!
잘 부탁드립니다!!
조형준
미래 생성형 AI기술을 활용해서 1인 크리에이터가 되고자 하는 직장입니다.
이번에 GPTS책도 구매했습니다. 많은 지도 편달 바랍니다.
오프라인 모임이 있다면 참석하고 싶습니다. 열린소통카톡방에도 참여 요청 드렸습니다.
감사합니다.
류영환Yeong Hwan Ryu
코딩 배우기 시작한 의사압니다.
유튜브 보고 들어왔습니다. 잘부탁드립니다.
김갑성
안녕하세요? 10X AI 클럽에 조인하게 되어 기쁨니다.
저도 가까운 미래에 가능한 많은 분에게 AI를 이해하고, 잘 활용할 수 있는 사람들만이 살아남을 수 있도록
Pay It Forward 약속 드립니다.
이정민
책을 읽다 검색해서 가입하게 되었습니다. Disquiet라는 것도 처음 알게 되었네요. 활발히 교류하고싶습니다. 파이팅!!
박면규
유튜브를 통해 10X AI CLUB 을 알게되어 참여해 봅니다.
김정래
내가 가진 데이터로 AI 챗봇이 만들어지나? - [Gemini API + Rag]
비용 : 무료
준비물 : Gemini 계정, 챗봇에 넣을 텍스트 데이터
예상시간 : 10분 내외?
안녕하세요.
오랜만에 글을 씁니다. 마지막 글로부터 8개월 만이네요. 디스콰이엇에 쓴 글들 덕분에 AI에 대한 자문이 많이 들어왔습니다. 덕분에 정신없이 AI를 만들고 보니 어느새 8개월이 지났네요. 디스콰이엇에 무한한 감사 인사를 드립니다.
AI에 대한 자문을 하면서, 비싼 비용과 어려운 난이도로 인해 실제 업무에 AI를 적용하지 못하는 분들을 많이 봤었습니다. 심지어 가볍게라도 AI 테스트를 해보고 싶지만, 이마저도 어려워하시는 분들이 많았습니다. 그래서 이러한 분들을 위해서 싸게 그리고 쉽게 써볼 수 있는 챗봇 AI 코드를 소개할까 합니다.
AI 챗봇이 어느 정도 성능을 보이는지, 자기가 가지고 있는 데이터로 AI 챗봇을 만들 수 있는지 궁금하신 분들께서 따라 하시면 좋을 거 같습니다. 해당 글에서 사용하는 기술은 RAG 기법 중, Dense Retrieval이라는 기술입니다. AI에게 문서를 주고, 해당 문서 내용을 바탕으로 답변을 하도록 하는 기술입니다.
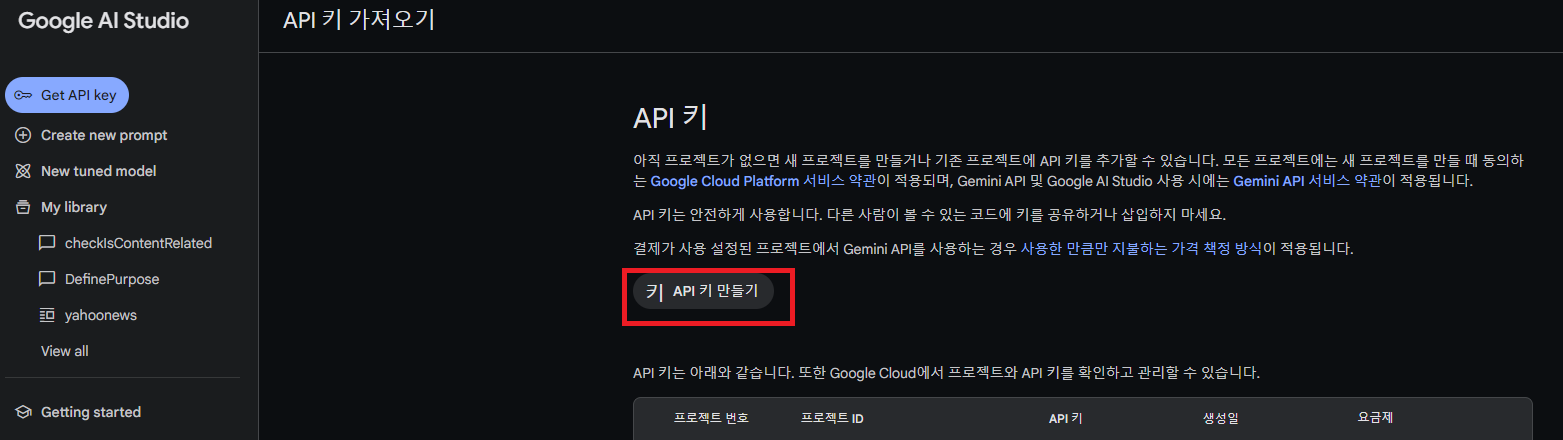
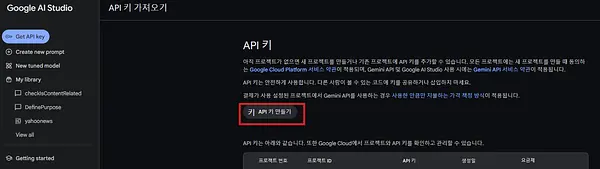
https://ai.google.dev/gemini-api
Gemini 사용 이유
- 성능 좋은 gemini-1.5-flash api를 무료로 제공해 준다.
- 속도 향상을 위해 유료 버전으로 바꿔도 매우 저렴하다.
- Embedding 모델로 OpenAI를 쓰면 더 빠르고 좋은데, OpenAI api를 가져오라고 하면 매우 귀찮기 때문에 gemini 하나만 쓸 예정입니다.
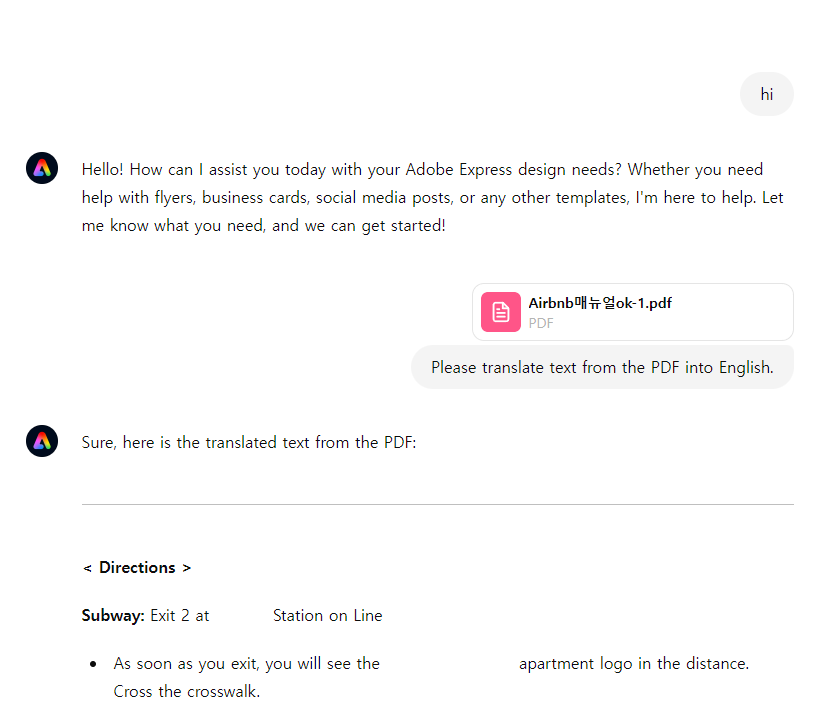
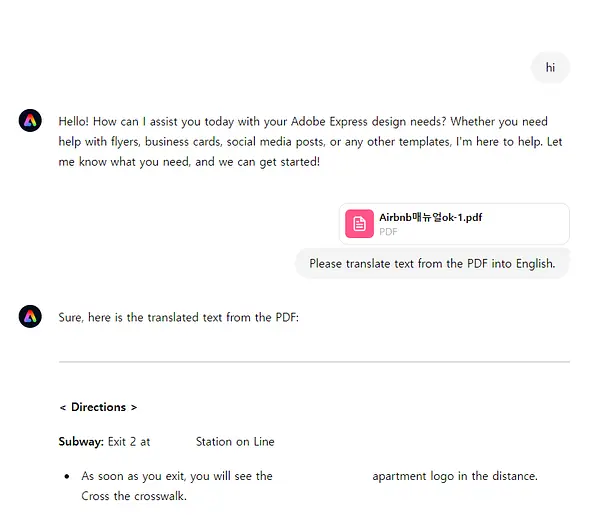
여러 gpt 모델 중 아래 adobe-express가 pdf를 제일 잘 읽고, 번역도 깔끔하게 해줍니다.
https://chatgpt.com/g/g-pcoHeADVw-adobe-express
openai 회원가입만 해도 무료로 사용하실 수 있습니다.
번역하는 이유
- 한글을 그대로 밀어 넣으면 성능이 제대로 안 나옵니다.
- 한글은 영어보다 Token을 많이 잡아먹기 때문에, 영어로 번역하여 사용하는 것이 여러모로 유리합니다.
저는 Cornell 고양이 건강 센터의 자료를 가지고 만들 예정입니다. 모든 데이터를 넣으면 속도가 느려서, 행동 문제(Behavioral Issues) 부분만 넣을 예정입니다.
* 무료버전일 경우, 워드 파일 기준 10페이지 이하로 테스트하는 것을 추천드립니다.
위에서 번역해 준 내용을 메모장에 저장합니다. pdf로 만들어도 상관없습니다.
여러 개를 넣어도 상관없습니다.
다만 그만큼 느려집니다.
* gemini는 똑같은 말을 반복하면 작동을 멈추는 이슈가 있습니다. 그래서 데이터를 이쁘게 넣어도 에러가 날 수 있습니다.
* 제가 최대한 간단하게 만들다 보니 조금 안 이쁠 수 있습니다.
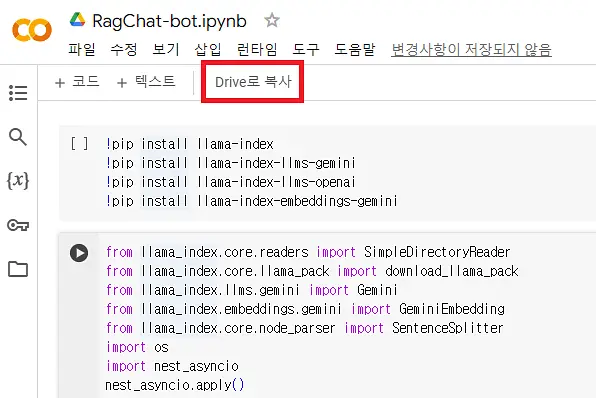
코렙 링크 :
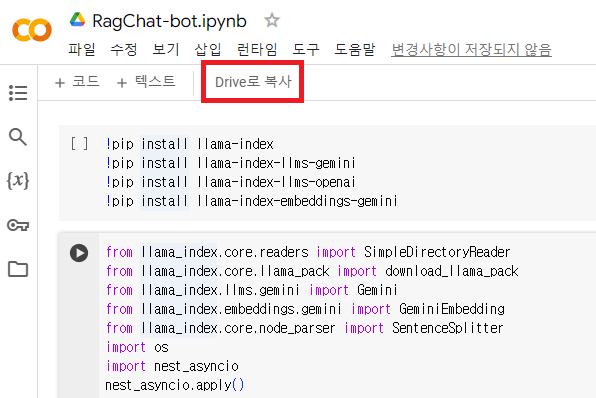
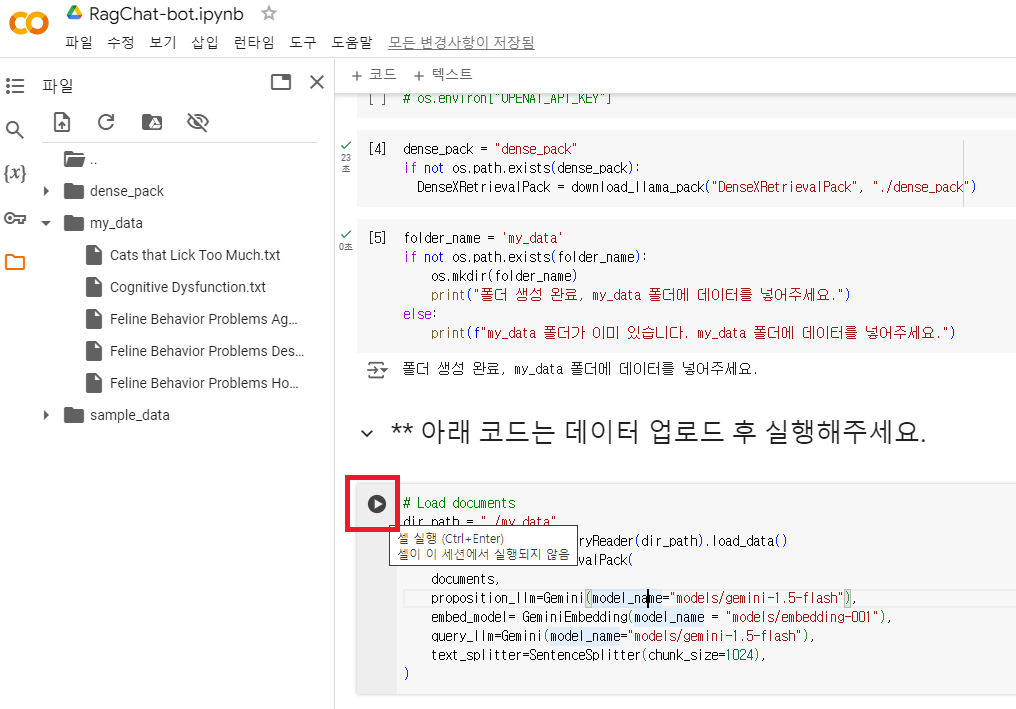
1) 드라이브로 복사 클릭
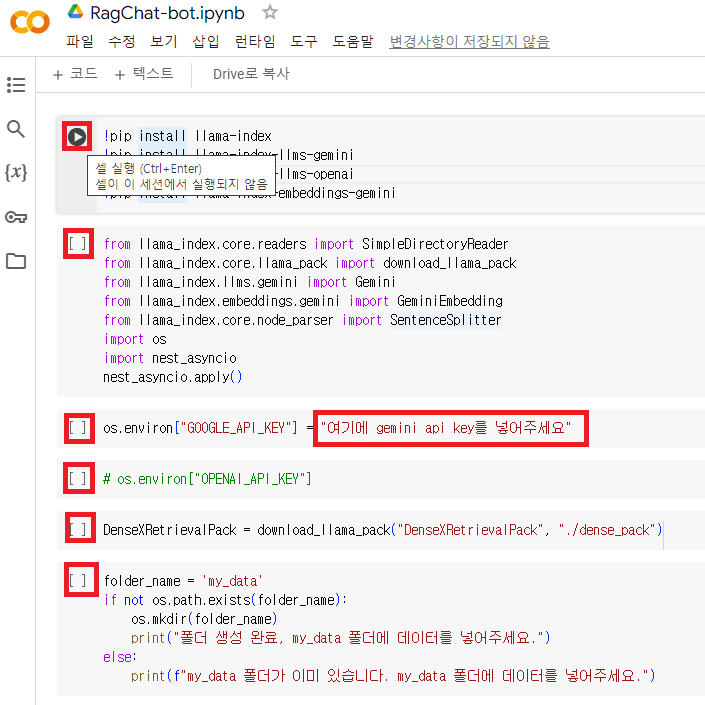
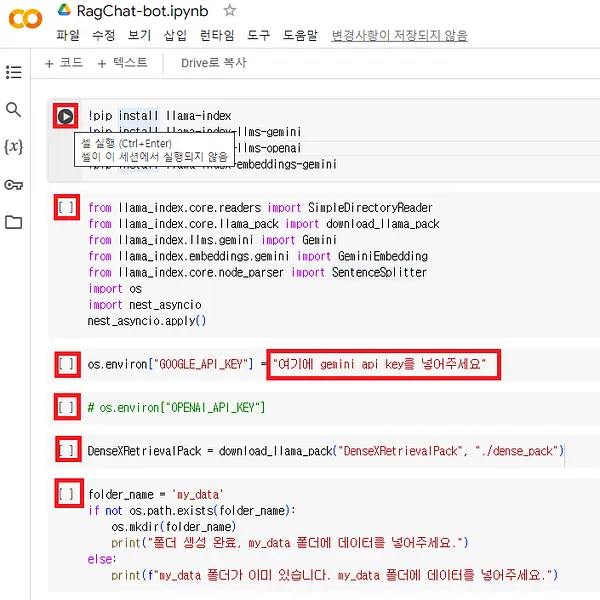
2) Gemini api key를 넣은 후에 my_data 폴더에 데이터를 넣어주라는 문구가 나올 때까지 실행 버튼을 쭉 죽 눌러주세요. 세션 다시 시작 멘트가 나오는데, 세션 다시 시작 버튼을 누르신 후에, 처음부터 다시 실행 버튼을 누르시면 됩니다.
ex) os.environ["GOOGLE_API_KEY"] = "12345678910"
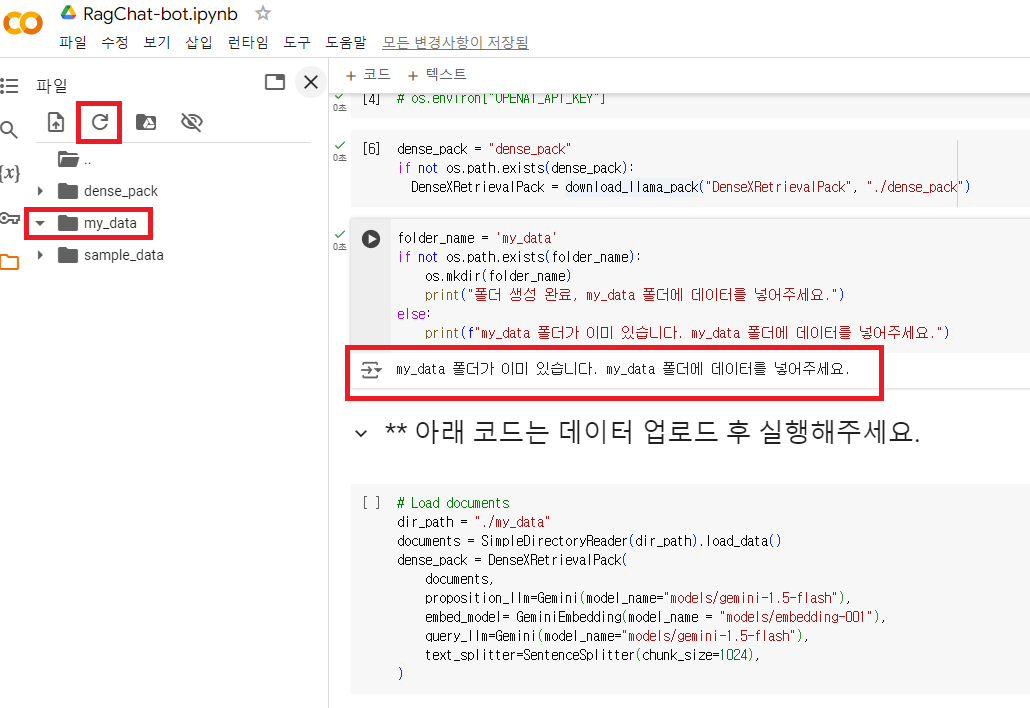
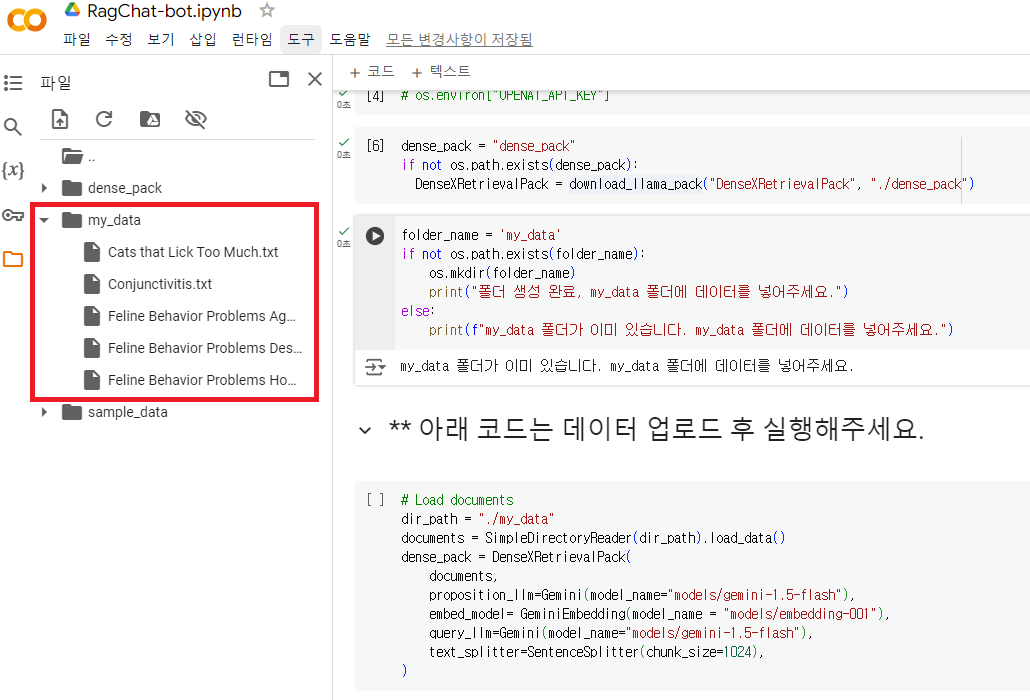
3) my_data 폴더가 생성 완료되면, 왼쪽 폴더 버튼을 누른 후 my_data에 앞에서 만든 데이터를 넣어주세요. 파일을 드래그해서 폴더에 파일을 넣으시면 됩니다.
- 안 보이면, 새로고침 버튼을 눌러주세요
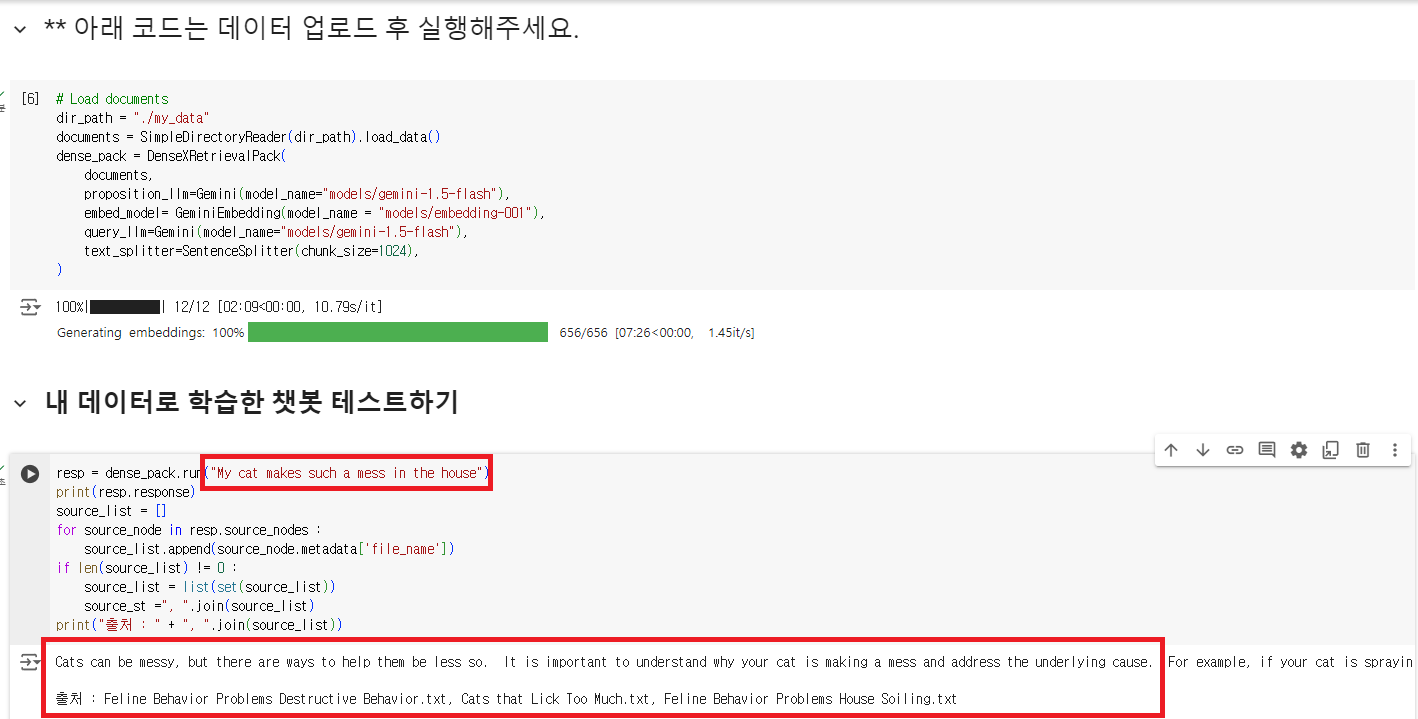
4) 이제 챗봇에게 data를 학습 시키는 코드입니다. 이어서 코드를 실행하세요. 학습 속도가 느리다 싶으시면, OpenAI api key를 입력하시고, embed_model을 지우시면 됩니다. 기본 설정이 OpenAI로 되어 있어서 코드에서 embed_model부분만 지우면 바로 적용됩니다. 최대한 무료로 간단하게 하려고 Gemini만 쓰다 보니 속도가 다소 느립니다.
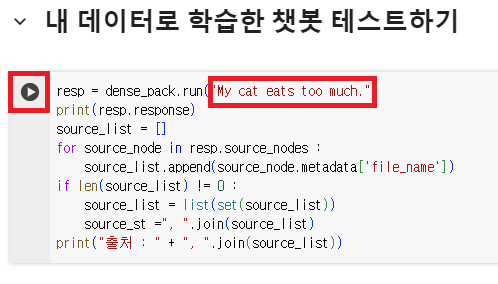
5) 학습이 완료되면, 질문을 넣고 코드를 실행해 보세요.
- 학습이 영어로 되어 있기 때문에, 되도록 영어로 번역해서 넣는 것이 더 좋은 결과치를 보여줍니다.
- 위 데이터는 워드 기준 약 30페이지 정도 되는 데이터입니다. 학습에 약 10분 정도 걸렸네요.
6) 다른 질문도 넣어서 테스트해 보세요.
- 질문만 바꿔서 넣은 후에 다시 실행 버튼을 누르시면 됩니다.
이상 내 데이터로 ai챗봇을 만드는 방법이었습니다.
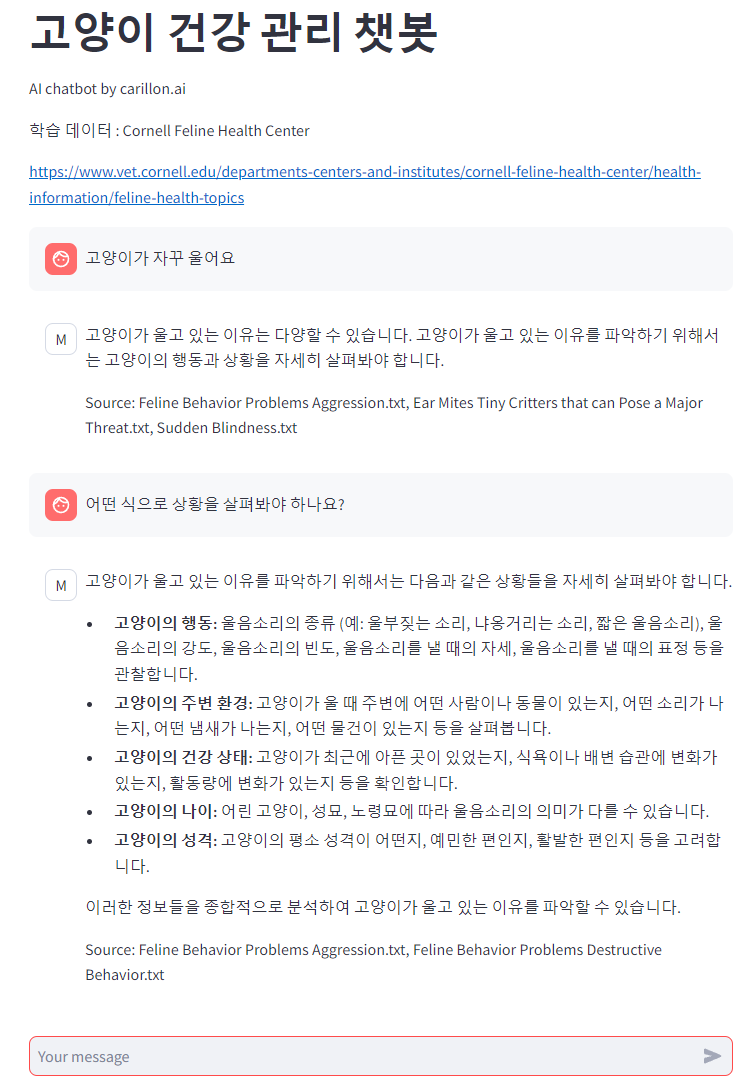
내 학습 데이터를 가지고 이것저것 테스트해 본 후 오 꽤 괜찮다 싶으면, 이제 챗봇을 만들면 되는데요, streamlit이라는 서비스를 이용하여 아래 링크처럼 매우 간단한 챗봇도 만드실 수 있습니다.
* gemini는 규제가 많아서, "고양이가 똥을 싸요?","고양이가 당뇨가 있나요?"와 같은 몇몇 질문은 자체적으로 막아버립니다.. ㅠㅠ
데모 링크 : https://aichatbot-test-carillon.streamlit.app/
AI를 활용한 서비스에 대해 이야기를 나누고 싶으시면 언제든 환영입니다.
jucheol kim
책 보고 따라하다가, 재미있어서 가입했습니다. 업무 자동화해서 생각할 시간을 갖고 싶네요
Daniel Shin
유튜브 구독하고 영상만 보다가 가입하게 됐습니다
21 ejola
개발자인데 AI 관련 제품을 만들고 싶습니다
Kwon Park
인공지능에 관심이 많은 교사입니다. 학교에서 인공지능을 활용하려고 노력 중이고 많이 배우려고 왔어요. 잘 부탁드립니다.
김현우
일단 뭔지 몰라요 일단 하는 성격이라 들어왔습니다.