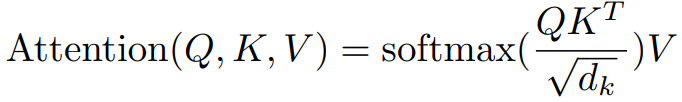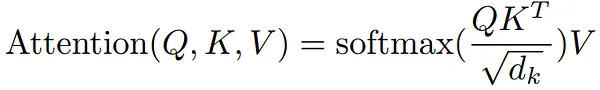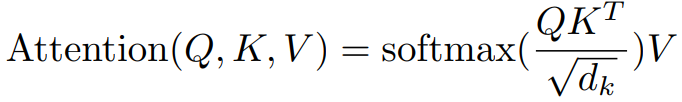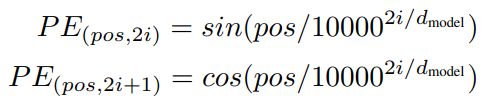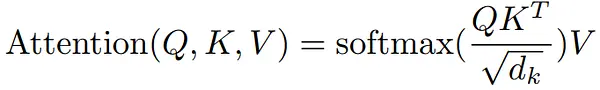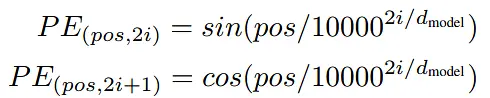10X AI Club

10X AI Club

AI 관련 프로젝트들을 함께 공유하며 최신 기술들을 직접 활용할 수 있도록 배워가는 클럽입니다. 온라인 뿐만 아니라 오프라인 정기 모임을 통해 스타트업 파운더들, 빌더들, 학생들이 함께 모여 서로 인사하고 아이디어를 키워갈 수 있는 클럽이 될 예정입니다.

공개 912 멤버

가이드라인

["클럽 신청 전 디스콰이엇 프로필(이력, 스킬, 관심 토픽)을 꼭 작성해주셔야먄 클럽 가입이 승인됩니다. ","만들고 있는 프로덕트도 있다면 프로필에 올려주세요. ","클럽 승인이 되면 오픈카톡방에 초대해드리겠습니다.","AI 활용 사례와 실제로 활용하기 위해 만드는 법까지 공유할 예정입니다.","정기 오프라인 모임과 세미나들을 열 예정입니다."]

Cailyn Yong

Cailyn Yong

[HRZ Ventures 허진호 VC] GPT wrapper 말고 10년 후의 미래를 생각해야한다

HRZ Ventures의 허진호 대표님과 오늘 커피챗을 하며 제가 그동안 고민하고 있던 질문들에 대한 답을 얻어내고 너무 값진 인사이트들을 배운 것 같아 여러분과 공유합니다.

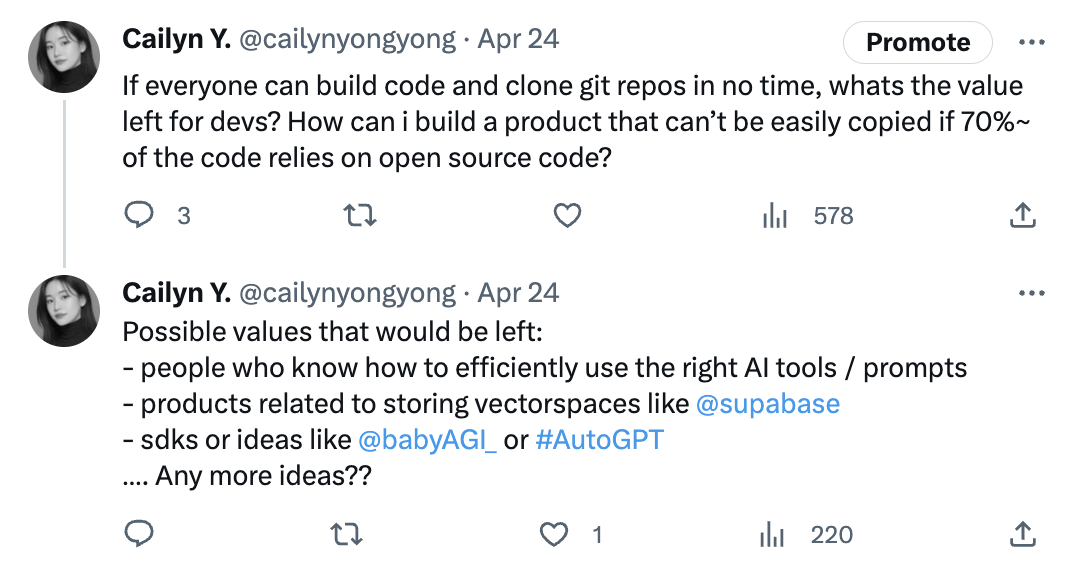
저의 전 글에서 어떤 고민들을 갖고 있었는지 확인할 수 있습니다:

가장 큰 질문들은

  1. 누구나 따라할 수 있게끔 모든 코드가 오픈소스 되어있다면 내 스타트업 제품은 단순히 GPT wrapper가 되는거 아닌가? Foundation model들에게 의존하고 있는거라면 기술적 우위가 없는거 아닌가?

  2. 내가 현재 만들고 있는 프로젝트를 api를 제공해주는 OpenAI, 뤼튼 같은 곳들 혹은 Runway, Stable Diffusion, Zapier 같은 곳들이 똑같이 만든다면 살아남을 수 있을까?

결론부터 말하자면, 스타트업은 기술적 우위를 가질 수 없습니다. 애초에 기술적 우위를 갖는다는게 포인트가 아닙니다.

현재 단계에서 스타트업은 다른 거대 B2B SaaS 기업이 이미 구축하고 있는 고객과 인프라의 moat를 이길 수가 없습니다. 업무자동화 툴, 혹은 챗봇을 만들었다 하더라도 이미 훨씬 앞서나가고 있는 기업이 이런 툴들을 만들고 배포한다면 게임 끝입니다.

하지만 제가 앞서 전 포스트에서도 말했듯이, "api를 제공해주는 곳, 혹은 큰 기업들은 거시적인 관점에서 사업 개발을 한다는 것, 즉 일반인들이 실제로 자신의 업무 환경에 쓸만한 툴들은 직접 만들어주지 않는 다는 점" 때문에 현 시점에서는 당장의 수익을 볼 수 있을 것입니다.

모든 기업들은 2-3년 안에 기업의 이익과 효율성을 위해 "비즈니스의 AI화," 즉 자동화 AI 툴들을 무조건적으로 도입할 것입니다. 이를 위한 AI 컨설팅, 노코드 툴, 앱/서비스 구축을 해주는 곳들도 이미 폭발적으로 늘어나고 있죠.

그렇다면 스타트업은 여기서 그치지 않고 이 2-3년 윈도우 내에서 살아남을 방법을 찾아야합니다.

이런 툴들을 만들어주는 에이전시가 되는걸로 끝날 것이냐, 아님 이를 통해 자신만의 moat를 쌓고 롱텀으로 바라보며 next Google, Amazon, Apple이 될것이냐 선택해야 합니다.

그렇다면 결국 누가 살아남을 것인가? 방법은 다양합니다.

  1. 가장 기본적으로 인프라와 api를 제공해주는 곳들: OpenAI, Langchain, Hugging Face, Pinecone, Stability, Cohere

  2. 기존에 자신의 서비스에 AI를 입히는 곳: Adobe Premiere Pro, VSCode Copilot, etc.

  3. AI-native: AI를 통해 생겨난 완전히 새로운 서비스와 비즈니스 모델

허진호 VC가 가장 집중적으로 바라보고 있는 곳은 AI-native 스타트업들입니다.

허진호 VC에 대한 소개를 간략히 하자면, 이 분은 94년에 최초의 인터넷접속서비스사업자인 아이네트 설립하며 한국 인터넷 대중화에 앞장서서 기여한 분입니다.

90년대에 닷컴버블이 일어나면서 Yahoo!부터 Hotmail, Amazon, Netscape, Ebay와 같은 곳들이 엄청나게 생겨나기 시작했습니다.

인터넷이 1995-6년 처음 만들어지고 배포되면서 Google, Naver와 같은 곳들은 2000년 전후반으로 나타나다가, 10년이 지난 후 Facebook, Youtube, Netflix, Shopify가 생기며 웹 기술을 활용한 최고의 아웃풋들이 나타난거죠.

모바일이 2008년 처음 나오고 나서 10년 후에는 어떤 곳들이 나왔을까요? 한국에서는 카카오톡, 토스, 쿠팡, 당근과 같은 곳들이 발생하기 시작합니다.

현재 AI 기술은 정확히 처음 인터넷/웹이 생겼을때, 처음 모바일이 나왔을때와 같습니다.

그렇기에 지금은 GPT wrapper와 같은 앱들은 당연히 생겨날 수 밖에 없습니다.

하지만 99%는 죽을거고, 살아남기 위해서는 툴로 고객을 유입한 다음 그걸 통해서 네트워크, 커뮤니티를 만들어서 자신만의 moat를 키우는 것입니다.

그렇기 때문에 저희는 10년 후에 AI에 의해 우리의 삶이 어떻게 변화될건지 항상 생각해야합니다.

AI-native 스타트업은 AI 덕분에 가능해진 완전히 새로운 유형의 제품/서비스를 뜻합니다.

Google이 웹이 생겨난 이후 광고주들이 키워드를 구매하면 광고가 게재되도록 하는 비즈니스 모델을 누가 예상할 수 있었을까요?

즉 AI 기술에 의해 앞으로 10년 내에는 이렇게 우리가 지금 단계에서는 상상할수도 없는 제품/서비스들이 너무 당연하게 자리잡고 있을 것이고, 이런 방향으로 계속 실험하며 나아가는 곳들이 살아남을 것 같습니다.

아예 처음부터 나에게 personalized된 컴퓨터가 나올수도 있고, 내 핸드폰에는 나를 위해 어떤 업무도 다 해결해줄 수 있는 fully autonomous siri가 나올수도 있습니다.

기존에 불가능했던 사업 모델들을 새로운 기술 덕분에 어떻게 바뀌게 되었는지 그런 흐름을 따라가야합니다.

예를 들어, 기존에는 우리가 누군가와 함께 차를 탄다는 상상도 못했었지만 우버가 태어났고, 우리는 우리가 알지도 못하는 누군가의 집에서 숙박한다는 것을 상상하지 못했지만 에어비앤비가 나타났습니다. 지금은 온라인상에서 우리가 잘 알지도 못하는 크리에이터에게 별풍선을 쏴주며 수익을 내주고 있죠.

AI 시대에서는 정말 상상하지도 못한 변화들이 일어날 것 같습니다.

스타트업은 그렇기에 최대한 계속 제품/서비스들을 만들어보고, 시장과 부딪히며 실패해보고 배워나가야 합니다.

뭐라도 해야합니다.

뭐라도 하면 다음 단계로 갈 수 있을 것입니다.

허진호 VC의 Two Cents 웹사이트를 공유합니다. 꼭 다들 읽어보세요! 정말 많이 배울 수 있습니다 :

29
9
임세진

임세진

LLM 스터디 #4

LLM 스터디를 하면서 개괄적으로 파악한 내용

우선 CNN이나 RNN 기반일 때까지만 해도 메모리 문제로 인해 정확한 대용량 언어 처리가 불가능 했습니다. 입력 시퀀스를 하나의 벡터 표현으로 압축해서 사용했는데, 이로 인해 정보 손실이 발생했던 것으로 추측됩니다. 그러나 Transformer 모델이 등장하고 나서 실질적으로 LLM이 가능해진 것으로 생각됩니다.

또한 Transformer 모델은 Attention Mechanism만으로 기존의 CNN, RNN 의존도를 없애려고 했습니다. 따라서 RNN으로 파악했던 언어의 위치 정보를 Positional Encoding이 대신하게 된 것이죠. 그리고 기존의 Attention Mechanism과 동일하게 언어 사이의 관계 및 중요도를 Attention Value로 기술을 합니다. 토큰들의 위치 정보(via Positional Encoding)와 매 출력 마다 집중해서 참고해야 할 입력 토큰들(via Attention Mechanism)로부터 입력된 토큰들의 시퀀스 다음에 올 토큰이 무엇인지 예측을 하게 됩니다.

다시 정리해보자면.... (스킵하셔도 됩니다)

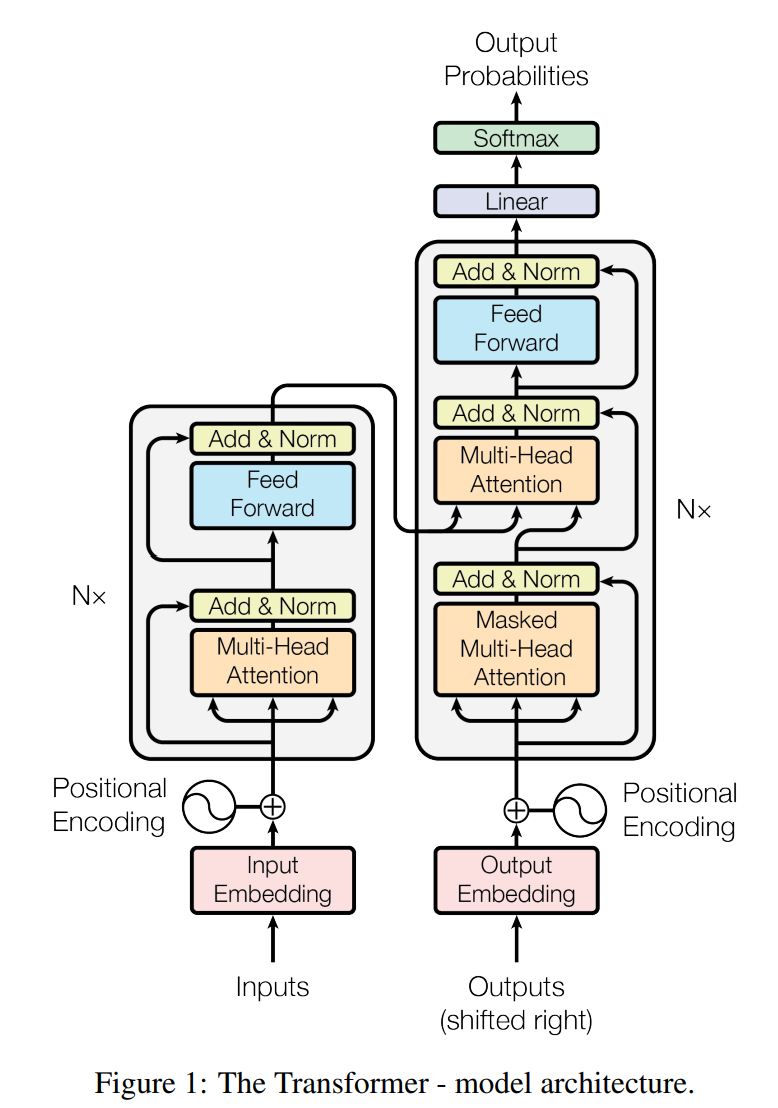
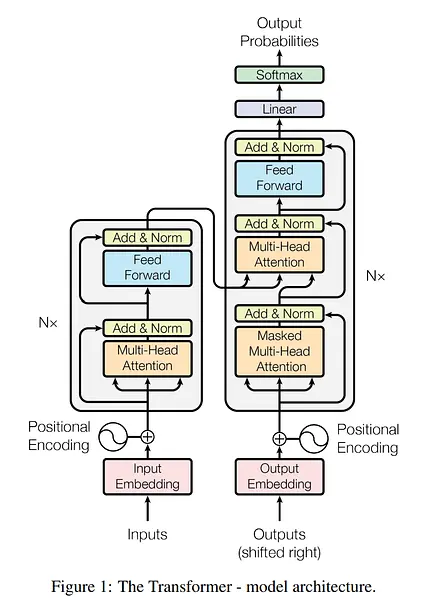
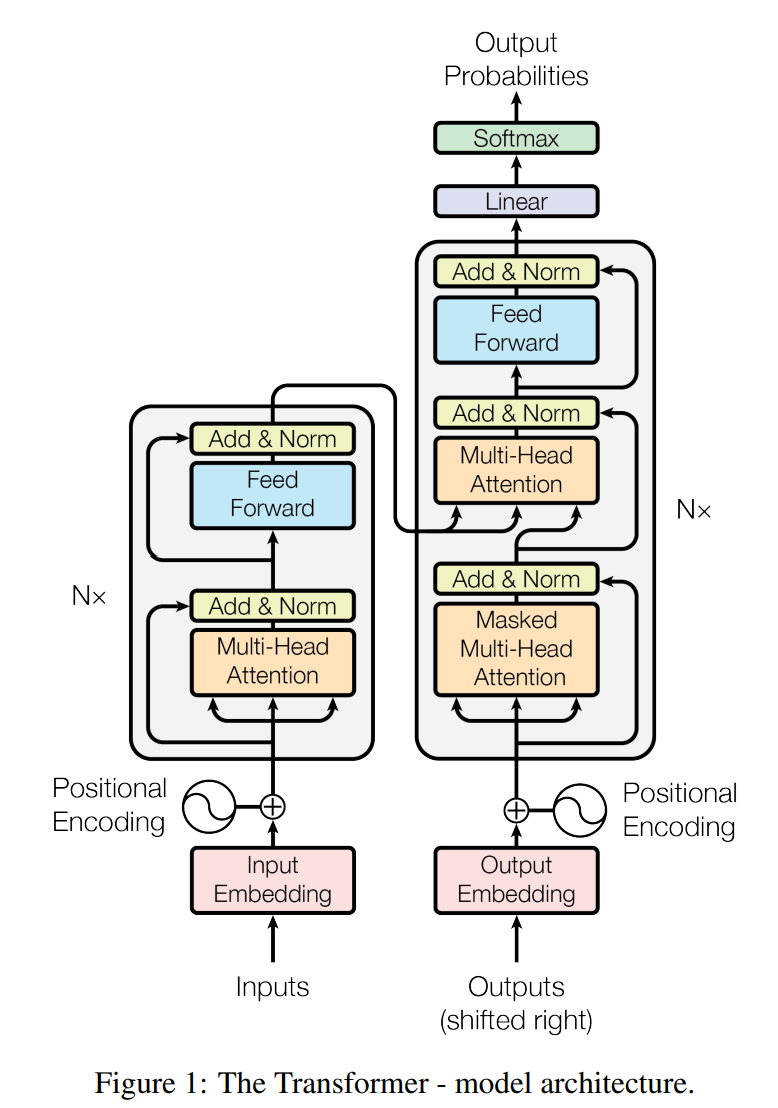
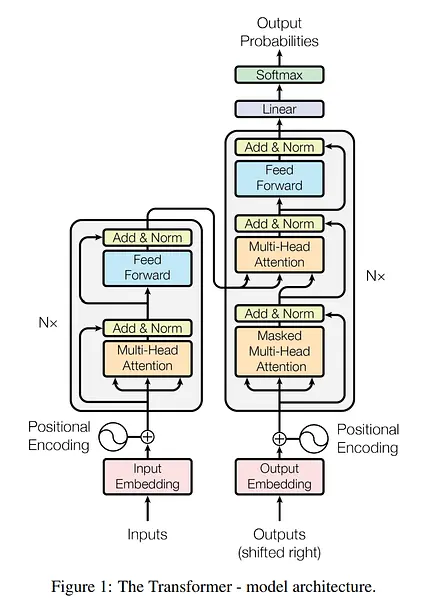
Transformer Model 모식도 입니다.

Transformer Model.png

좌측이 Encoder, 우측이 Decoder입니다.

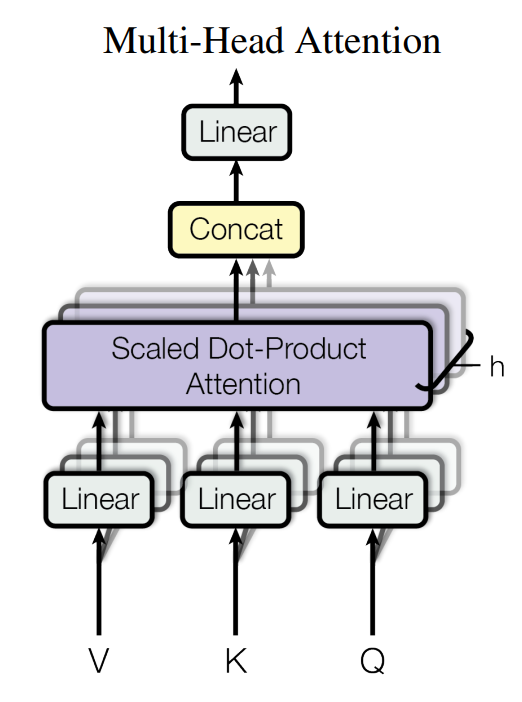
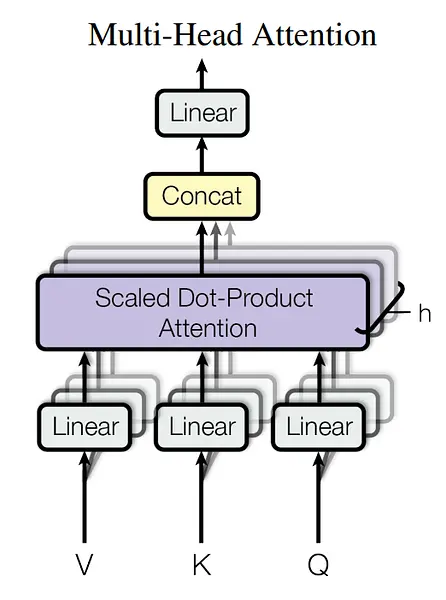
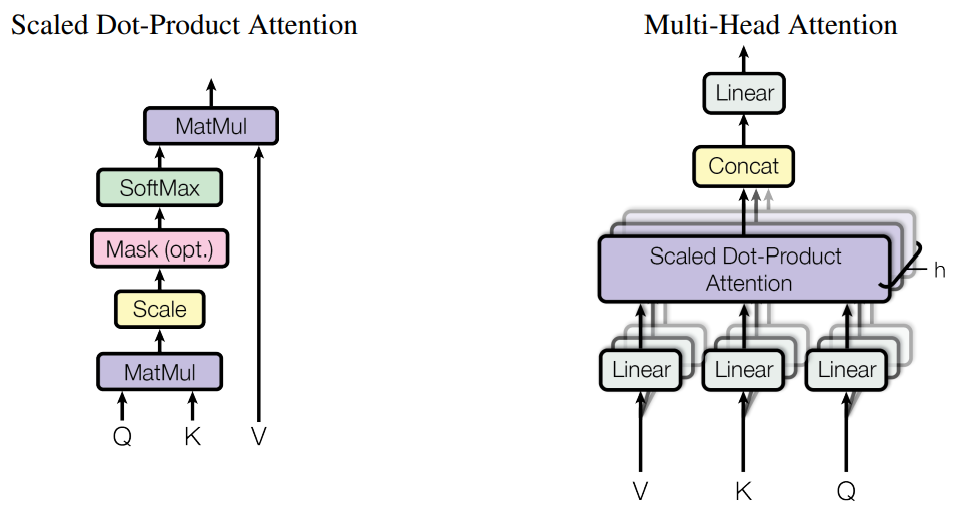
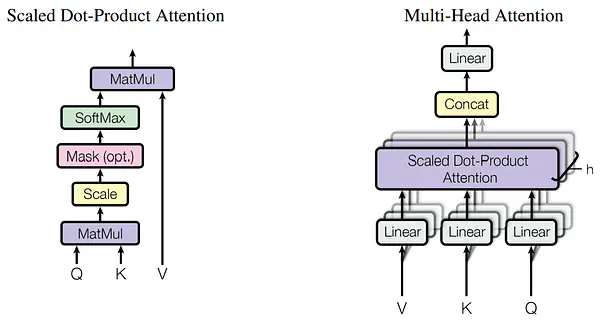
Multi-Head Attention 모식도입니다.

multi_head_attentioin.png

Encoder에서 Key, Value, Query 값은 각각 의미하는 바는 다음과 같습니다.

Key: 입력 시퀀스의 tokenize된 수치 (입력된 문장의 단어들을 위치 벡터로 라벨링)를 64차원으로 변환 (d_model=512, num_head=8이기 때문)

Value: Key와 동일한 값

Query: Key와 동일한 값

Attention Value Matrix:

Scaled_dot_product_formula.png

Decoder에서의 Masked Self Attention에서 Key, Value, Query 값의 의미는 다음과 같습니다.

Key: 출력 시퀀스의 tokenize된 수치 (입력된 문장의 단어들을 위치 벡터로 라벨링)를 64차원으로 변환 (d_model=512, num_head=8이기 때문)
Value: Key와 동일한 값
Query: Key와 동일한 값
Attention Value Matrix

Decoder에서의 Self Attention에서 Key, Value, Query 값의 의미는 다음과 같습니다.

Key: Encoder에서 Attention Value Matrix
Value: Encoder에서 Attention Value Matrix
Query: Decoder에서 Attention Value Matrix

이상... 크게 특별할 건 없었던 LLM 스터디를 일단락 지어보도록 하겠습니다..(꾸벅)

다양한 산업들에서 Transformer 모델을 활용하여 다양한 Task들이 비교적 손쉽게(?) 처리될 수 있으리라 기대됩니다.

< 참고 논문 >

Attention Is All You Need

https://arxiv.org/pdf/1706.03762.pdf

6
1
백승윤

백승윤

Code Llama 논문을 정리해보았습니다.

그저께 Meta에서 Code Llama 모델을 release하였는데요. OpenAI 의존성 없이 Code Llama 를 가지고 재밌는 서비스들이 많이 나오게 될 것 같습니다. Code Llama 논문 리뷰를 해봤는데 이 모델에 대해 궁금하신 점들을 해소하는데 도움이 되었으면 좋겠습니다 :)

7
2
Cailyn Yong

Cailyn Yong

스타트업이 AI 산업에서 살아남는 법

Screenshot 2023-08-26 at 10.14.07 PM.png

최근 들어 가장 많이 고민하는 점들에 대해 적고자 합니다.

4월부터 여러 랭체인/AI 사이드프로젝트들을 하면서 들었던 생각들입니다.

  1. 개발자라면 누구나 손쉽게 리소스 documentation을 읽고 오픈소스된 모델/코드로 이런 프로젝트들을 만들 수 있는데, 내 프로젝트는 이 상황에서 어떻게 기술적 우위를 가질 수 있을것인가?

  2. 누구나 만들 수 있고 차별성이 없다면 실제로 수익을 내고 있는 프로젝트들은 몇개나 되는가? 이때까지만 해도 찾지 못했고, 그저 유저에게 좋고 재밌는 앱들 위주로 나옴. 하지만 일회성 아이디어들이 대부분이었고 돈을 지불하면서까지 쓸만한 아이디어는 없었다. 현재 수익을 내고 있는 곳들은 큰 foundation model들을 갖고 있는 애들, 혹은 api를 제공해주는 곳들임.

  3. 내가 현재 만들고 있는 프로젝트를 api를 제공해주는 OpenAI, 뤼튼 같은 곳들 혹은 Runway, Stable Diffusion, Zapier 같은 곳들이 똑같이 만든다면 살아남을 수 있을까?

따라서 스타트업의 입장에서는 어떤 방식으로 접근해야할지 생각을 해봐야 합니다.

현재 단계에서 가장 큰 기회는 사람들이 이런 방대한 양의 리소스가 있음에도 불구하고 배울 시간이 나지 않아서, 진입장벽이 높다 생각해서, 아님 그만큼 이런 정보에 노출되지 않아서 막상 많이 쓰지 않는다는 것입니다.

두번째 기회는 api를 제공해주는 곳, 혹은 큰 기업들은 거시적인 관점에서 사업 개발을 한다는 것, 즉 일반인들이 실제로 자신의 업무 환경에 쓸만한 툴들은 직접 만들어주지 않는 다는 것입니다.

그렇다면 10X AI Club을 왜 개설하게 됐는지에 대해 얘기를 하자면,

정보의 격차가 존재하지 않음에도 불구하고, 몇 시간만 투자하면 자신의 삶을 훨씬 효율적으로 살아갈 수 있도록 바꿀 수 있음에도 불구하고 시간이 나지 않아서, 혹은 새로운 것을 배우는 것에 대해 선뜻 나서지지 않는 분들 위해 만들었습니다.

몇년 안에 인공지능은 저희 삶 속에 알게 모르게 엄청나게 스며들 것입니다.

저는 이런 미래에 대비하고자 꾸준히 배우고 있고, 더 많은 사람들이 알았으면 하는 바람이 큽니다.

정말로 모두가 AI에 대해 제대로 알고, 자신이 직접 어떻게 활용할 수 있는지 알아갈 수 있었으면 좋겠습니다.

얼른 컨텐츠 더 만들러 총총...

18
3
Cailyn Yong

Cailyn Yong

Fountain: GPT4를 활용한 실리콘밸리 고용 플랫폼

안녕하세요, 10X AI Club Cailyn입니다.

오늘은 B2B SaaS를 제공하고 있는 기업 중에서 AI를 활용하고 있는 Fountain이라는 기업을 소개합니다.

최근에 Fountain이라는 곳을 EO 영상으로도 접하게 되고 Keith Ryu 대표님의 창업 스토리를 알아가면서 요즘 기업들에서는 어떻게, 어떤 AI tool들을 쓰고 있는지 궁금해서 더 알아봤습니다.

Fountain에 대해서 먼저 간략히 소개를 하자면, 시간제로 일하는 분들을 위한 고용 플랫폼입니다. 개발자, 디자이너 프리랜서보다는 물류 센터, retail 산업에서 종사하고 있는 시간제 생산직을 빠르게 채용해야 하는 Uber 같은 곳들이 사용하는 SaaS인거죠.

Keith가 찾은 PMF은 이런 생산직군을 필요로 하는 곳들에서 사람은 빨리, 더 많이 채용해야하는데 그 채용 과정이 너무 오래 걸린다는 점이었습니다.

이 PMF를 통해 지금은 Series C, 총 $218.9M 투자를 받았습니다.

Fountain AI

그렇다면 지금 Fountain은 AI tool들을 어떻게 활용하고 있을까요?

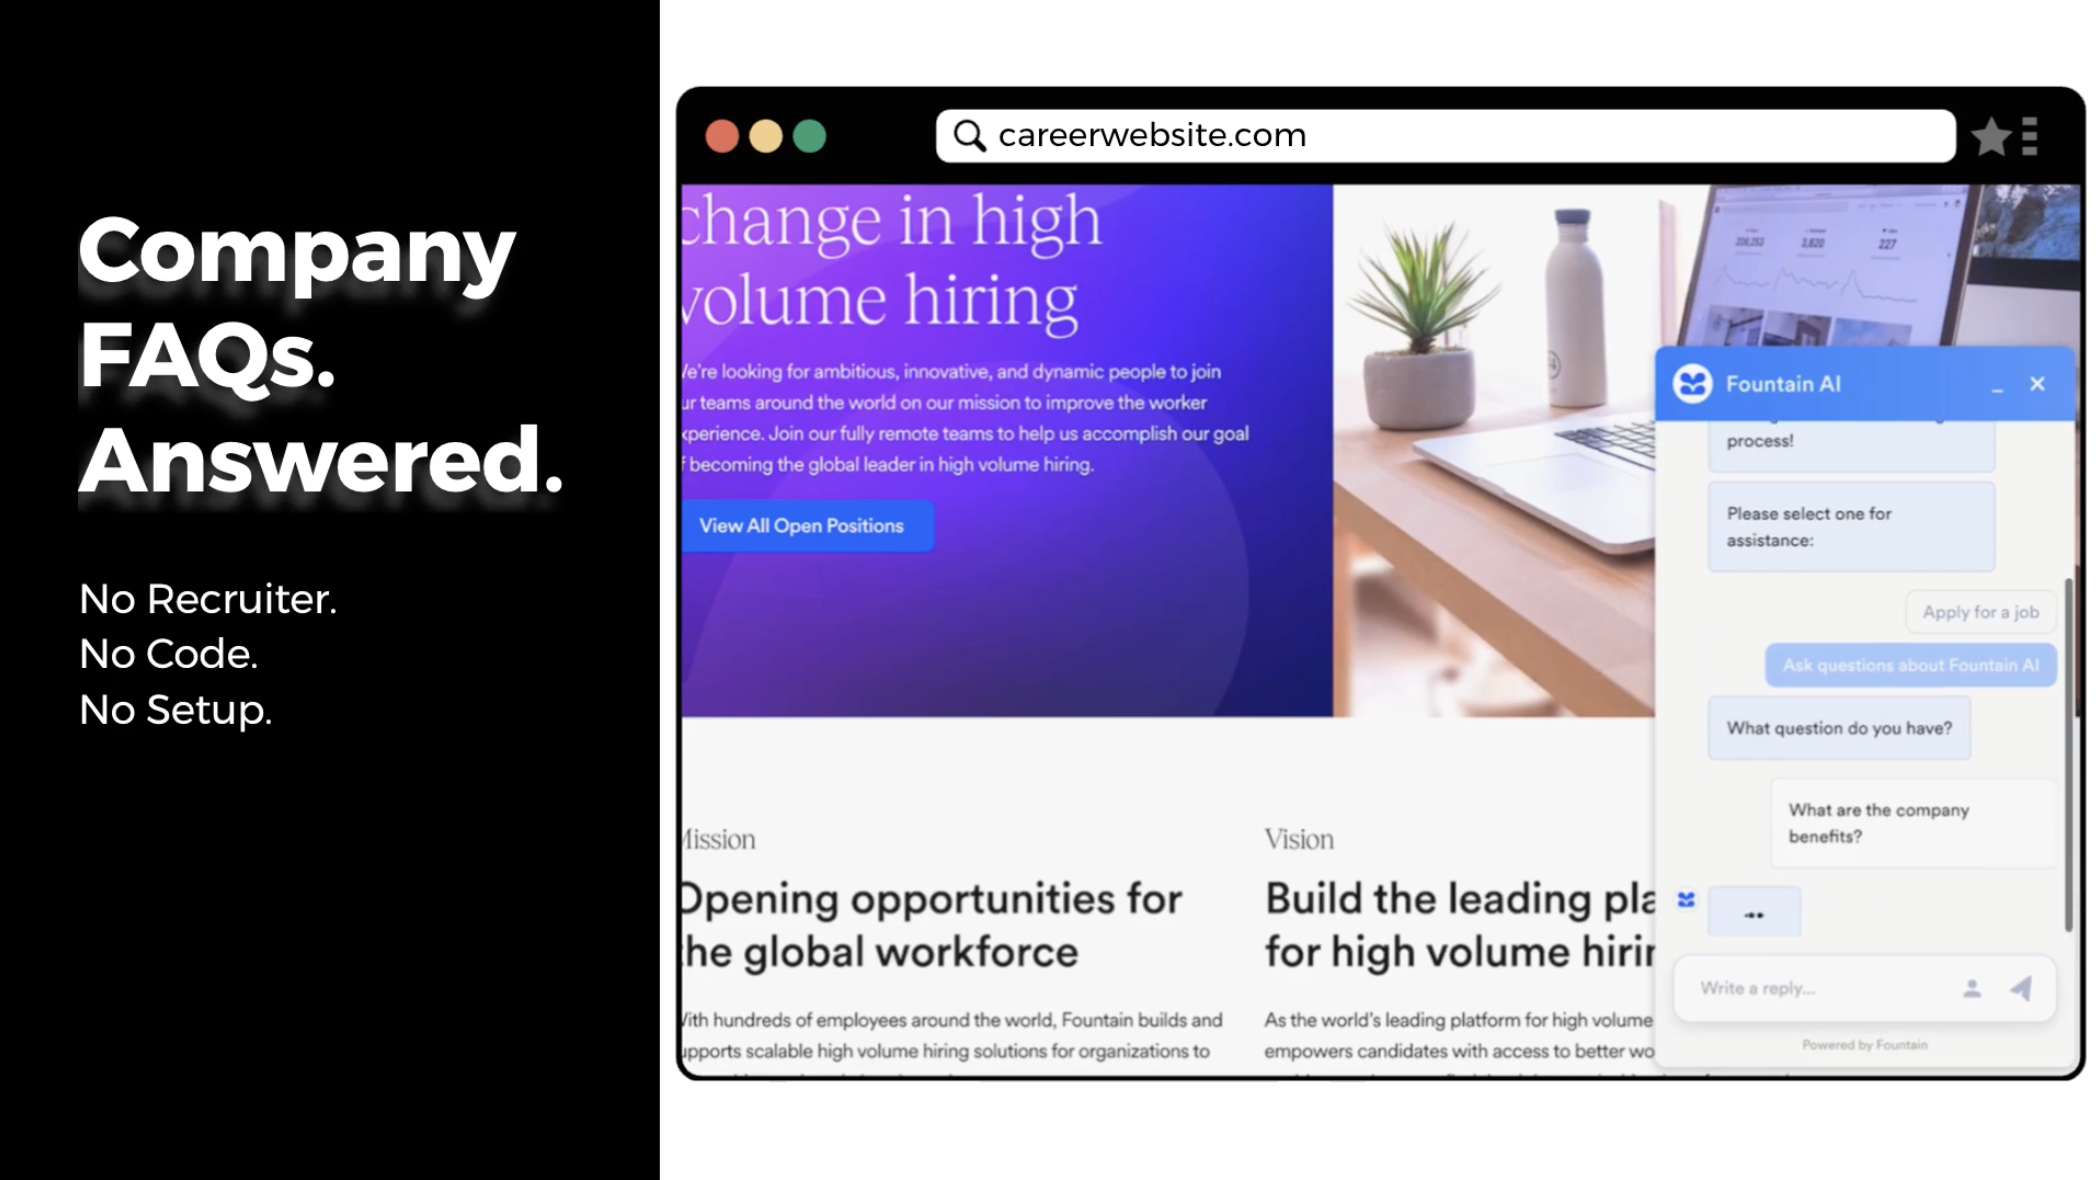
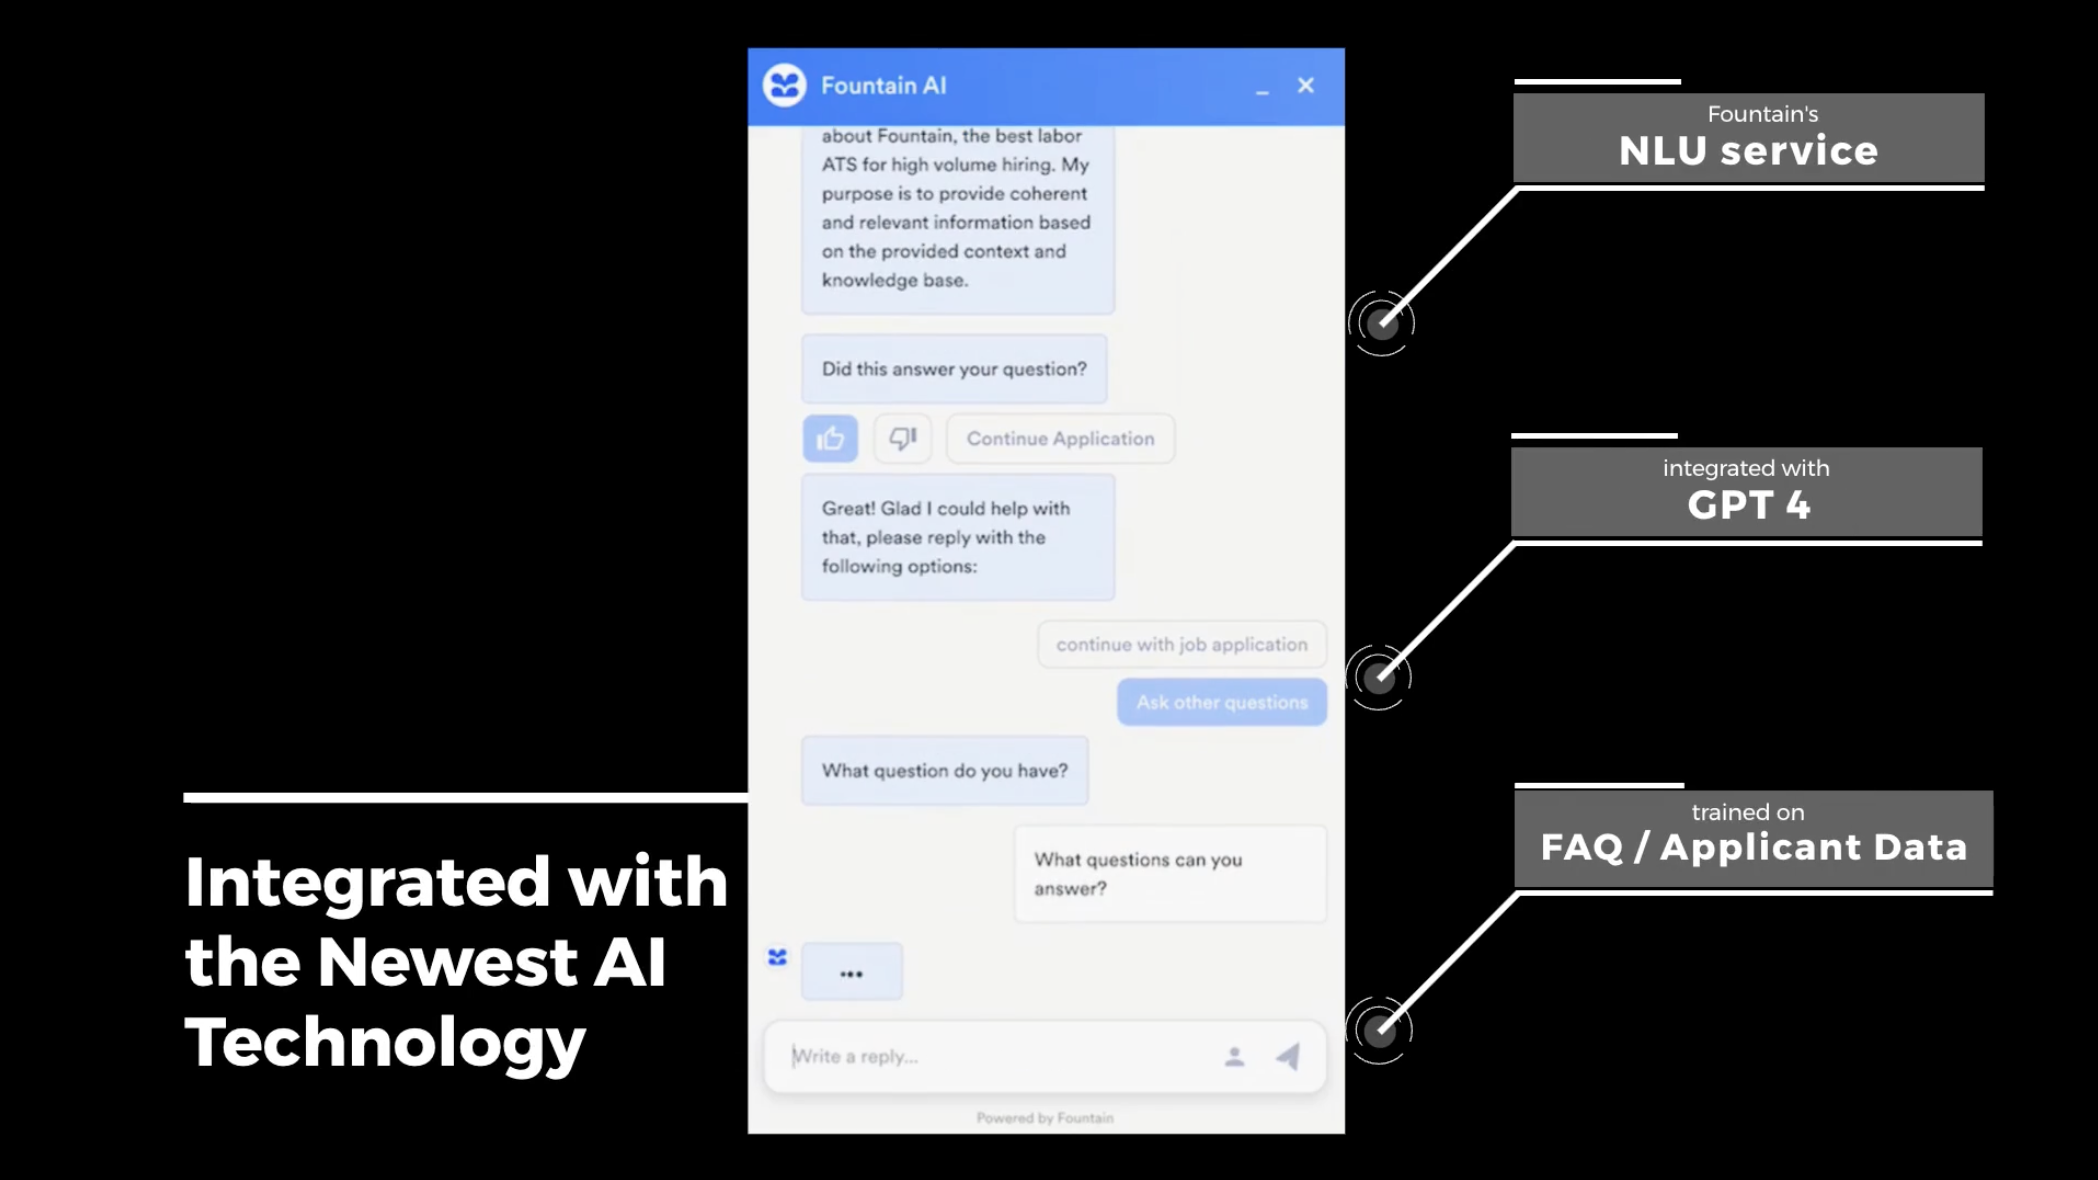
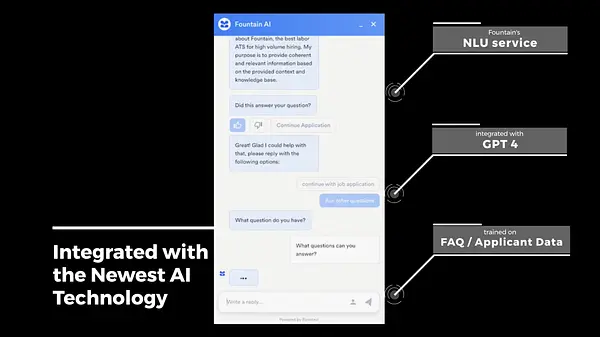
Fountain에서는 Fountain AI라는 툴을 공개했는데, GPT4를 활용한 conversational AI입니다.

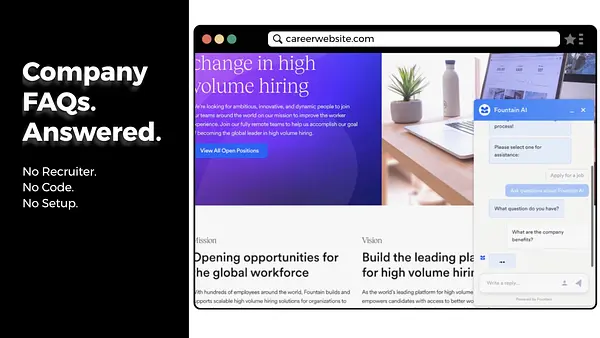
이런 채용 과정을 더더욱 빠르고 효율적으로 개선하고자 챗봇을 만들었는데요, HR 사람 없이도 채용하고자 하는 기업의 정보들을 학습시킨 다음 GPT4가 스스로 유저의 질문에 대답할 수 있도록 만들었습니다.

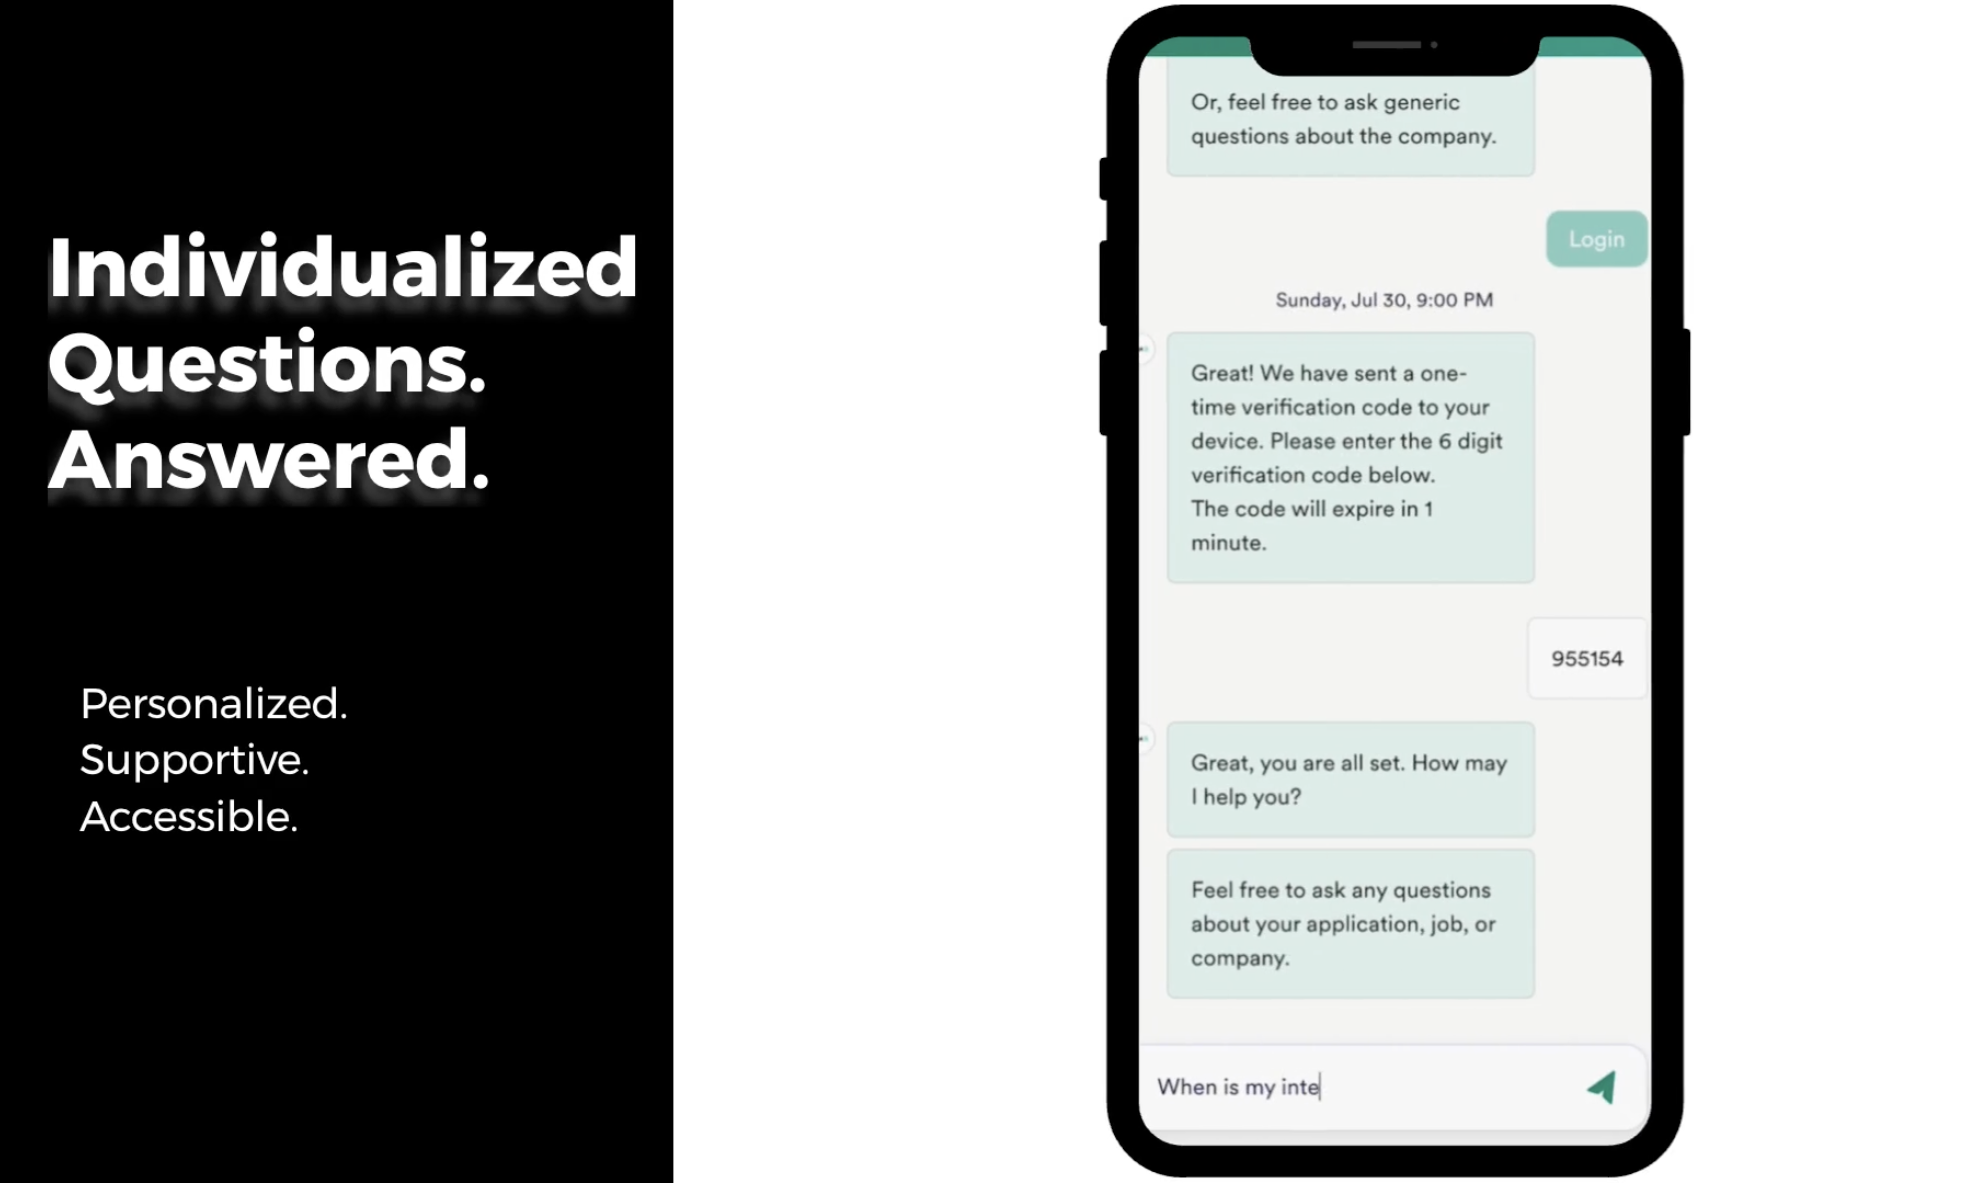
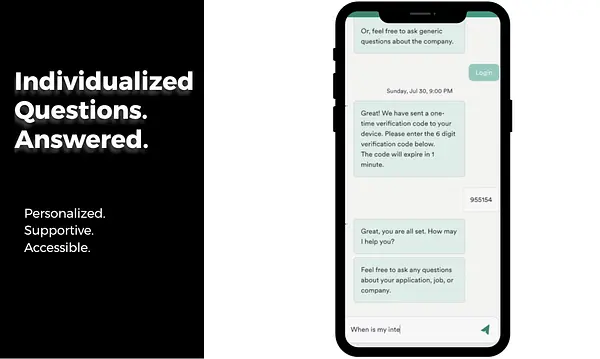
Screenshot 2023-08-24 at 7.30.50 PM.pngGPT4와 LLM을 써서 만들었다면 당연히 지원자 맞춤 personalization도 가능하겠죠?

Screenshot 2023-08-24 at 7.31.08 PM.png조금 더 파인튜닝하기 위해 LLM에게 기존의 지원자 정보나 평상시에 가장 많이 물어봤던 질문들에 대한 데이터를 학습시켰다면 더더욱 Fountain의 취지에 맞는 대화형 AI 챗봇을 만들 수 있었을겁니다.

Screenshot 2023-08-24 at 7.34.58 PM.png사실 창업을 할때 처음 랜딩페이지를 만들고나서 가장 중요한건 실제로 랜딩페이지를 방문한 유저들과 바로바로 소통을 하며 rentention rate를 높이는 것이라고 생각합니다.

저도 창업을 하면서 뼈저리게 느꼈던 건 한번 그 과정에서 잠재고객을 잃으면 영원히 잃는거라고 생각을 했고, 이걸 방지하고자 랜딩페이지에 챗봇을 올렸던 적이 있습니다.

저는 바로 고객과 소통을 하고 싶은데, 제가 로봇이 아닌 이상 24시간 내내 지켜보면서 답장을 하기엔 불가능이라고 생각을 했죠.

이런 과정을 자동화하고자 저는 미리 챗봇 템플릿에 고객들이 물어볼만한 질문들을 몇가지 예상한 다음 답변들을 바로 보낼 수 있도록 썼습니다.

하지만 이것또한 일일이 쓰는데에 시간을 많이 잡아먹었고, 내가 예상하지 못한 질문을 유저가 하면 그쪽에서 하염없이 기다리는 방법밖에 없는 일이 발생되기 마련이었습니다.

이걸 해결해주는건 바로 이런 GPT4를 탑재한 챗봇이라고 믿습니다.

실제로 chat api를 제공해주는 샌드버드에서는 역시나 발빠르게 이러한 기능을 제공해주고 있습니다. ChatGPT AI bot으로, 이런 질문/답변 템플렛을 작성하지 않아도 기존에 학습한 데이터를 토대로 GPT가 바로바로 답변을 생성할 수 있도록 하는거죠. https://sendbird.com/products/chatgpt-integration

이 AI 챗봇들을 통해 나오는 활용 사례들과 효과들은

  • 빠르게 랜딩페이지 잠재 고객과 대화하고 rentention rate 높이기

  • 반복적인 온보딩 과정들 자동화하기

로 볼 수 있을 것 같습니다.

그렇다면 내 스타트업을 위한 이런 대화형 AI 챗봇은 실제로 어떻게 만드는 걸까요? 이건 저의 다음 포스트에서 직접 개발 과정들을 공유하며 누구나 만들어 볼 수 있도록 하겠습니다 :)

오늘도 글 읽어주셔서 감사하고 10X AI Club 많은 관심 부탁드리겠습니다. 🙂

17
5
임세진

임세진

LLM 스터디 #3

트랜스포머 모델 아키텍쳐

Transformer Model.png

1. Inputs & Outputs

  • 입력 시퀀스: (x_1, ..., x_n)

  • Encoder 결과물(hidden layer): (z_1, ..., z_n)

  • 출력 시퀀스: (y_1, ..., y_m)

  • 위의 트랜스포머 모델에서 좌측이 Encoder, 우측이 Decoder에 해당됨

2. Multi-Head Attention

attention.png

Scaled Dot-Product Attention

  • Q: 쿼리 값(문장 속 낱말들을 임베딩 한 결과), K: key 값(낱말들에 대한 정보를 제공하는 값) , V: value 값(key 값의 의미를 수치 값으로 갖고 있음)

  • keys의 차원: d_k

  • values의 차원: d_v

  • 각 토큰을 임베딩하는 차원: d_model (d_model 차원의 vector로 문자들을 구분할 수 있다.)

  • h: 평행한 어텐션 레이어 개수

이 연구 논문에서는 d_k = d_v = d_model / h = 64, h = 8로 두었다. (d_model = 512)

Scaled Attention을 수식으로 간단하게 표기 :

Scaled_dot_product_formula.png

3. Positional Encoding

PE.png

  • Positional Encoding을 통해 문자들의 위치를 d_model 차원의 좌표(위치 벡터)로 변환하여 표현할 수 있다.

  • 그리고 해당 위치에 있는 문자가 바뀌어도 Positional Encoding의 결과물은 바뀌지 않는다. (위치에만 종속되어 있는 값이다)

  • pos: 시퀀스 내의 임의의 토큰의 위치

  • i: d_model 차원 이하의 차원

https://arxiv.org/pdf/1706.03762.pdf

12
4
Hyunje Kim

Hyunje Kim

안녕하세요, HeyAI를 만들고 있는 예비 메이커 입니다 ㅎㅎ

저는 EveryAI라는 팀에서 HeyAI라는 AI추천 알고리즘 서비스를 만들려고 하는 예비 메이커에요! 제 첫글이지만, AI 사용에 관한 설문조사를 공유하려고 해요! 창업자와 예비 창업자들이 모여있는 이곳에서 AI 사용 빈도 및 수준에 대해 알아보기 위해서인거죠.

선택적으로 응답할 수 있는 짧은 설문지로 구성되어 있으며, 응답 시간은 약 5분 정도 소요됩니다. 아래 링크를 클릭하여 설문 조사에 참여해주세요!

이번 설문 조사 결과를 통해 여러분들이 어느 정도로 AI 기술을 활용하는지 파악할 수 있을 것 같아서 너무 기대돼요.

응답 주신 내용은 개인 정보 보호 및 분석 목적으로만 사용되며, 식별 가능한 개인 정보는 외부로 유출되지 않음을 안내드립니다.

많은 분들의 적극적인 참여 부탁드릴게요! 만일 질문이나 문제가 있다면 언제든 연락 주세요.

감사합니다!

9
0
고상혁

고상혁

ChatGPT SEO 특화 플러그인으로 상위노출 글쓰기

문제의식

  1. 오랫동안 운영하는 개인 블로그(브런치)가 낮은 조회수를 기록하면서, 사람들의 입맛에 맞는 글쓰기에 어려움을 느낌

  2. 글을 쓸 때 초안만 있으면 빠르게 글을 쓰지만, 초안을 작성하는데 어려움을 느낌

    1. (초안 작성이 힘들어서 귀찮아서 글쓰기를 자주 미룸)

SEO 글쓰기 시 장점

  1. SEO에 대해서 전혀 모르는 저로써, 전문마케터가 사용하는 SEO를 어느정도 흉내낼 수 있음

  2. 상당히 자세한 초안을 작성해주기 때문에, 글 작성시간을 평균 4시간에서 1시간으로 감소하였음

GPT Plugin Setting

먼저, Plugin Store에서 다음 2개의 App을 다운로드 : SEO Assistant, SEO.app

우리는 해당 플러그인의 사용법을 잘 모르기때문에, 이를 GPT에게 물어본다! 그럼 다음과 같이 사용방법 및 장단점을 빠르게 분석해준다.

본문내용 작성

  1. 먼저 내용작성에 활용할 ‘목표 키워드’를 SEO Assistant Plugin을 활용해서 찾음

  2. 여기에 내가 쓰고싶은 글의 내용을 간략히 설명하였음! 또한 해당 글의 경우 이미 글의 제목을 정해놓은 상태여서, 해당 제목을 미리 GPT에게 설명해주었음

  1. GPT가 뽑아준 ‘목표키워드’ 중에서 가장 내가 쓰고싶은 주제와 맡는 키워드를 선택

  2. 이후, 주요내용을 작성하기위해 전체적인 개요에 어떠한 글을 참조하면 좋을지에 대해 각각 약간의 설명 및 링크를 전달해줌

첫 결과도 꽤 만족스럽지만, 해당 내용 중 마음에 들지않는 부분은 GPT와 계속 핑퐁하며 수정하면 다음과 같은 결과 도출

이제 해당 개요를 들고와서, 글을 작성하기 시작했습니다. 해당 글은 초안으로 활용했고, 이를 덧붙이고 수정하는 작업에 소요시간은 약 1시간 정도 걸렸네요!

결론

  1. GPT 도움을 받으면 정말 퀄리티있는 글을 무한으로 작성가능하다!

  2. 마케터 친구에게 물어보니, 마케팅 에이전시 차려서 회사 홍보 글 대신 작성해줘도 되겠다 평을 받음!

10
1
장영운

장영운

이미지를 넣으면 이야기를 만들어주는 AI

허깅페이스에는 신기한 AI들이 많이 올라옵니다.
저같은 비개발자도 간단히 체험해 볼 수 있는 재미있는 AI를 발견해서 공유합니다.

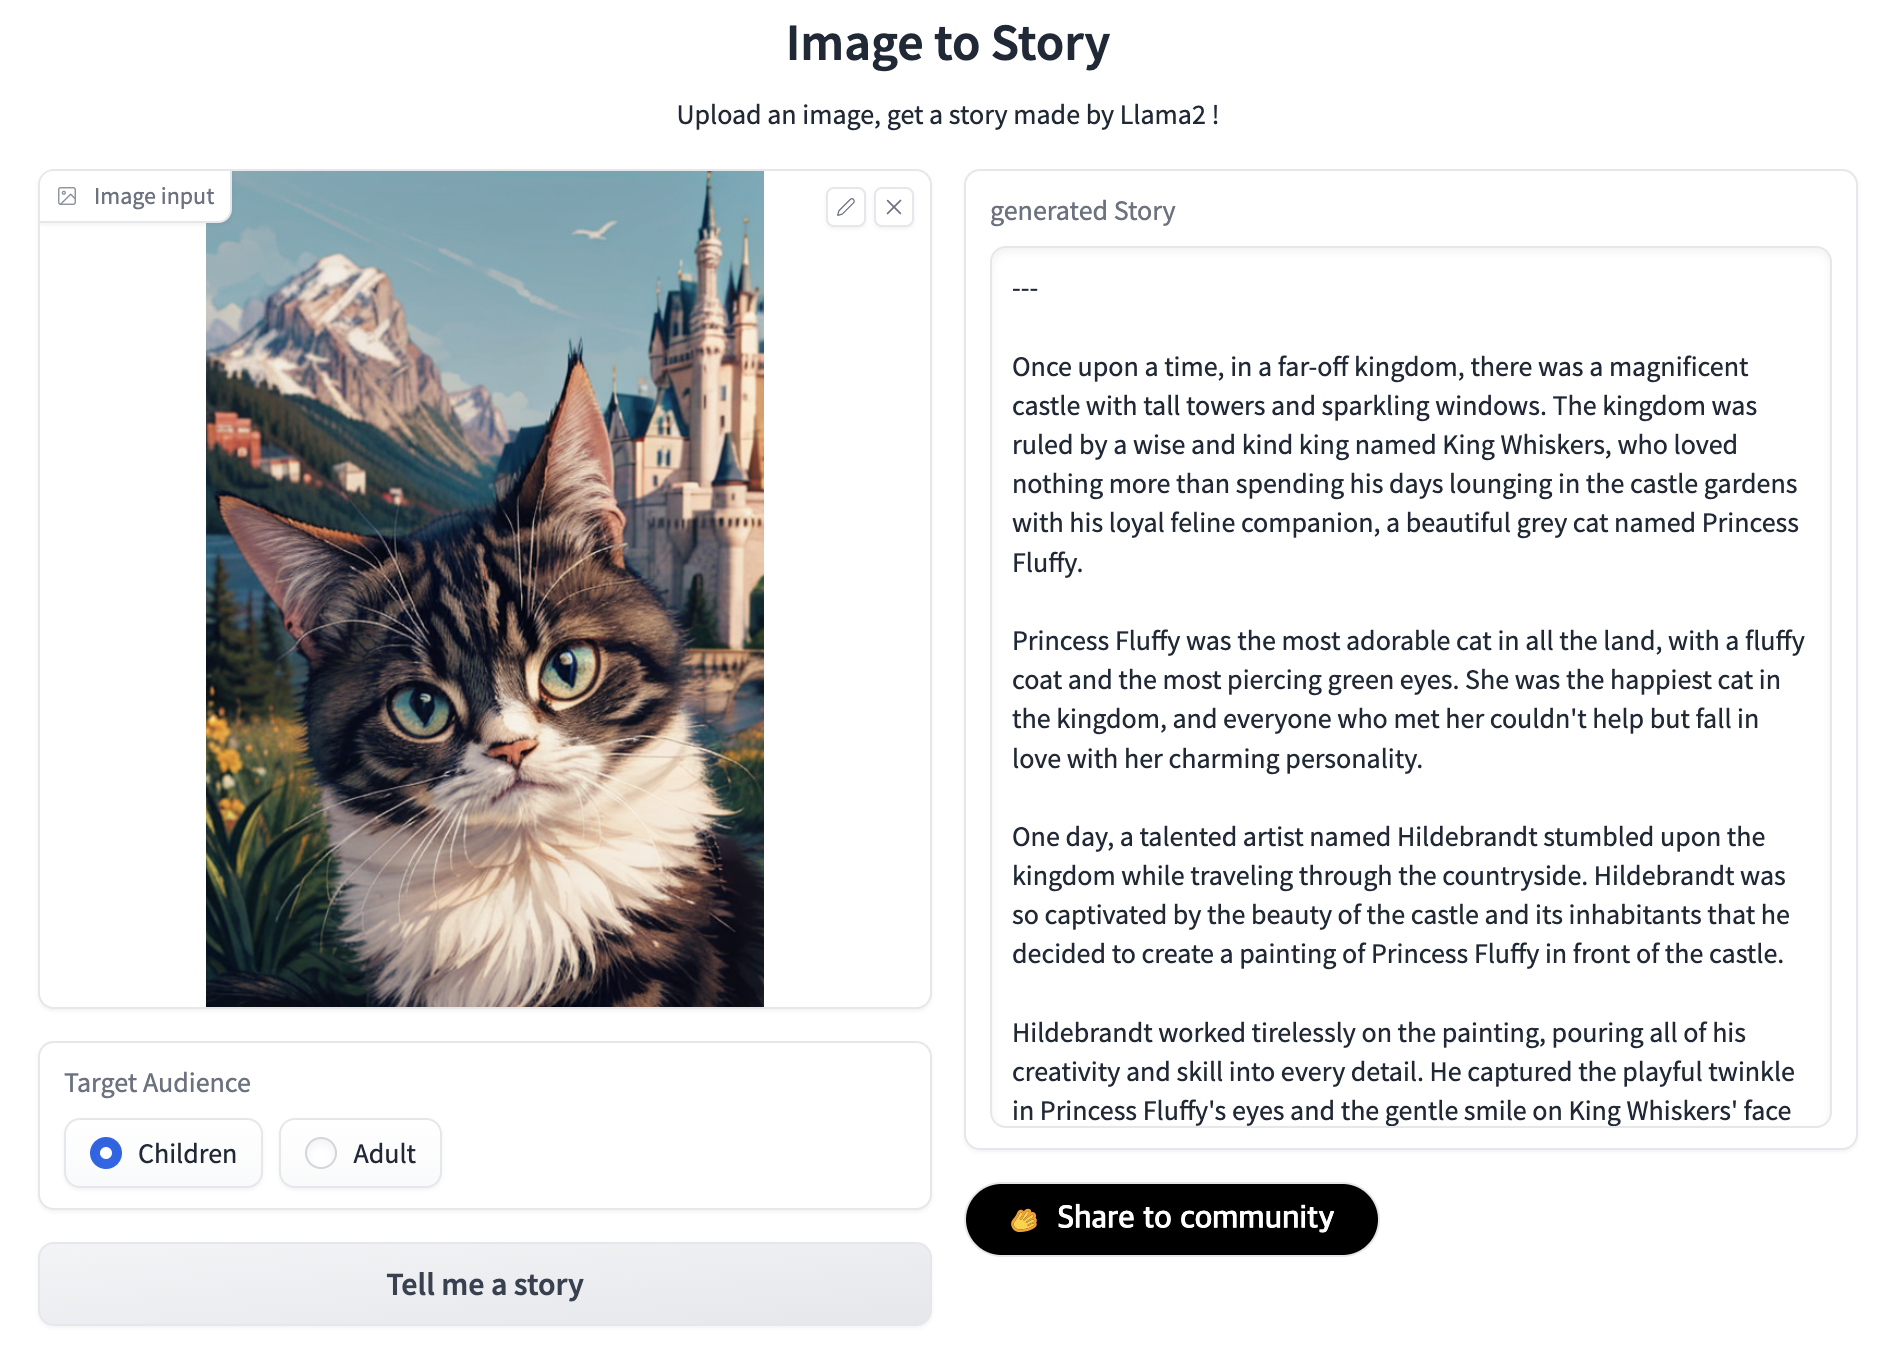
이미지를 입력하면 그에 어울리는 이야기를 만들어주는 AI 인데요.

제가 생성한 귀여운 고양이 이미지를 입력해보겠습니다.

스크린샷 2023-08-22 오전 9.33.43.png

고양이가 주인공인 아이들을 위한 짧은 동화를 만들어줬네요.

🔗여기에서 경험해볼 수 있습니다.

10
12
김정래

김정래

10분 내로 끝낼 수 있는 AI 커버곡 만들기

최근 유튜브에 보시면 AI 커버곡들이 많아졌죠?

몇 달전 경량화된 모델이 나오면서 누구나 쉽게 커버곡을 만들 수 있게 되었기 때문이죠.

모델 설명이나 이론 이런 것보다 일반인들에게 필요한 것은 어떻게 사용하냐죠.

그래서 정말 쉽게 AI 커버곡 만드는 과정을 입문자 관점에서 설명드릴게요.

딱 속는 셈 치고 10분만 투자해 보세요.

사실 무슨 노래로 만들어 볼까 하는 고민이 가장 오래 걸리고 나머지 과정들은 금방 끝납니다.

1. 커버곡 선택하기(선택에 따라 2~10분)

음원사이트를 통해서 노래를 구합니다. 저 같은 경우는 유튜브 음원을 추출해서 사용합니다.

- 코러스나 에코가 없는 노래일수록 결과물이 좋습니다. 랩은 추천하지 않습니다.

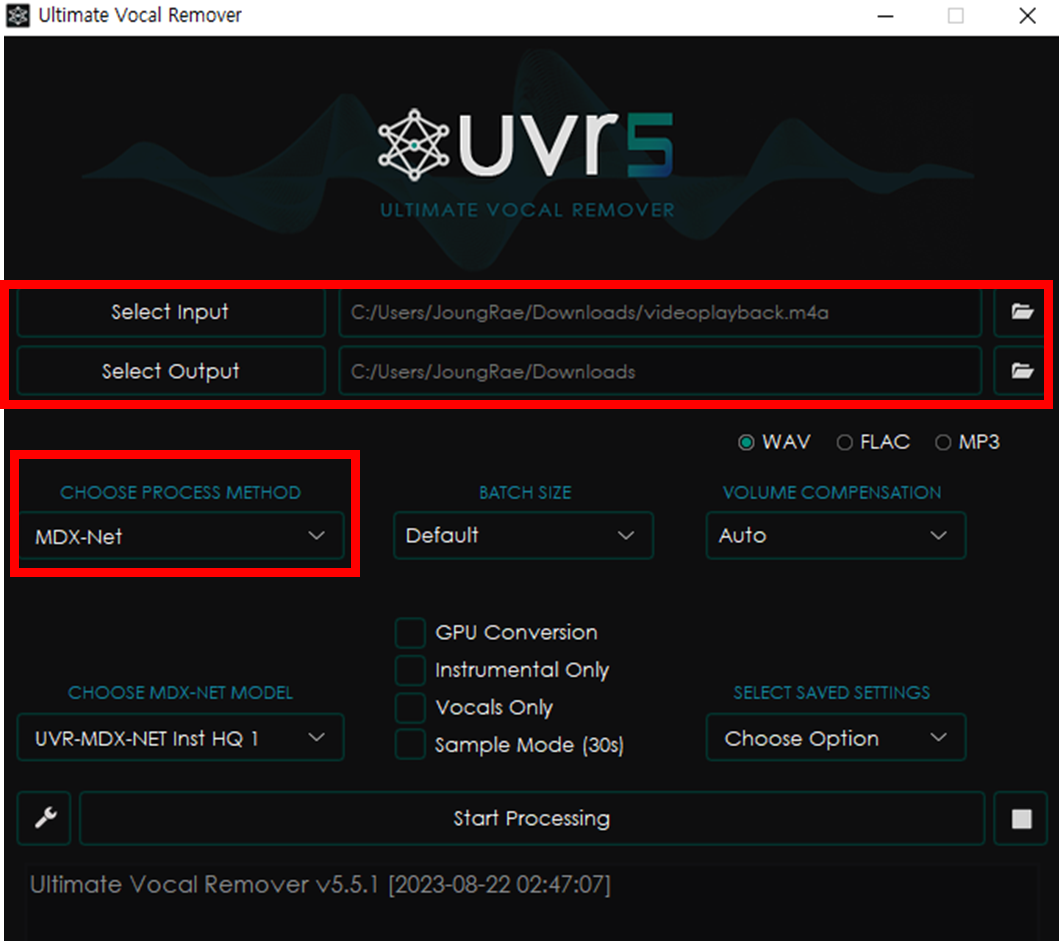
2. MR과 목소리 나누기(컴퓨터 사양에 따라 1~5분)

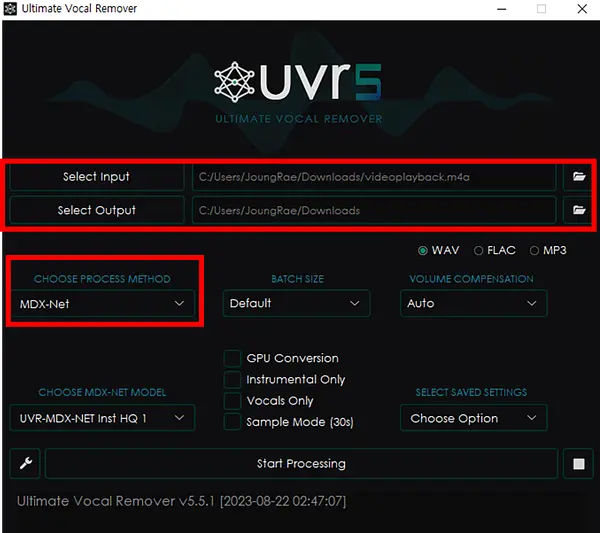
무료로 목소리와 MR을 나눠주는 "Ultimate Vocal Remover v5"를 사용해서 목소리와 MR을 나눠줍니다.

Input 파일과 결과물 저장할 폴더 그리고 Method를 선택해 줍니다.

- AI 커버곡 퀄리티에 가장 큰 영향을 미치는 것이 이 부분입니다. 깔끔하게 목소리만 추출해야 결과물이 정말 좋게 나옵니다. 하지만 우리는 입문자기 때문에 이 부분은 넘어갑니다.

image.png

3. 목소리 모델 찾기(선택에 따라 1~10분)

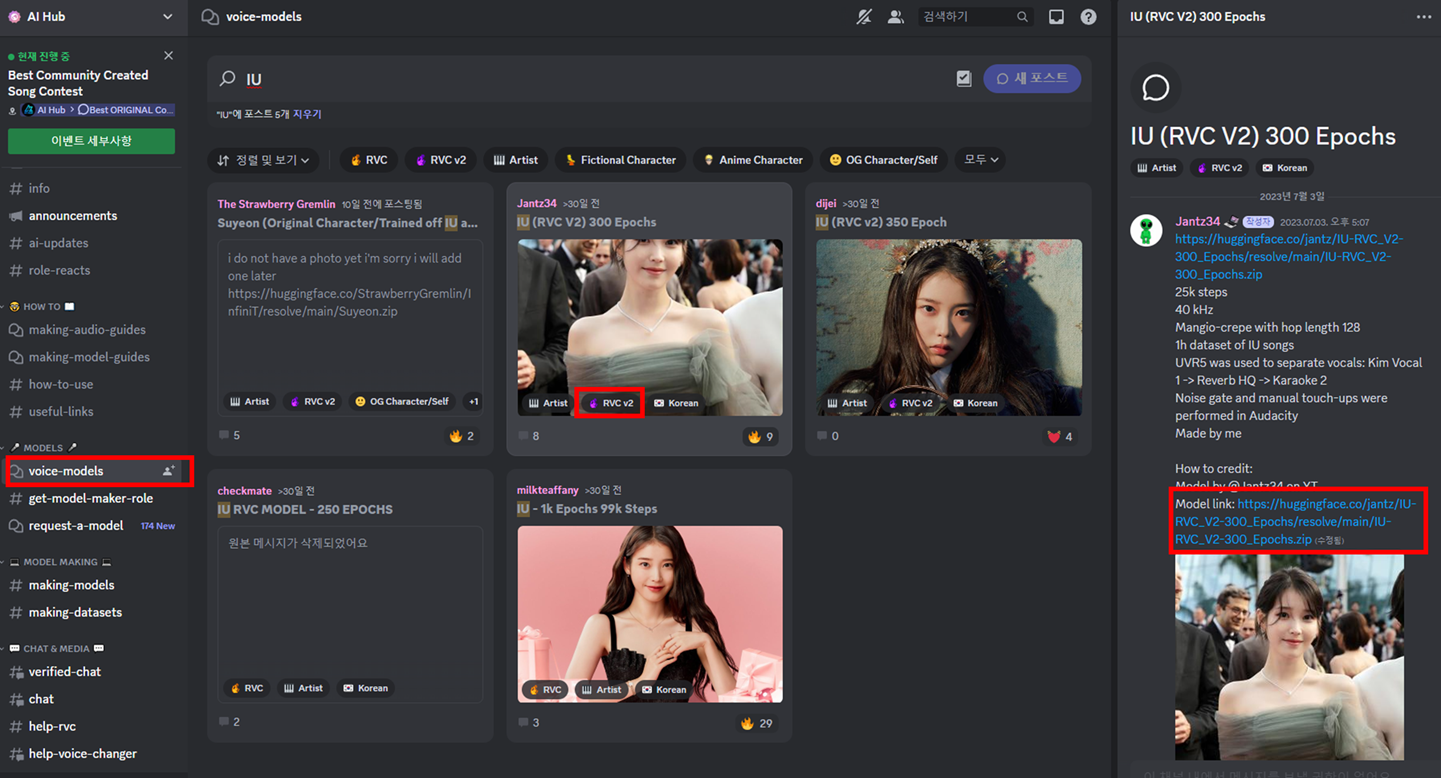
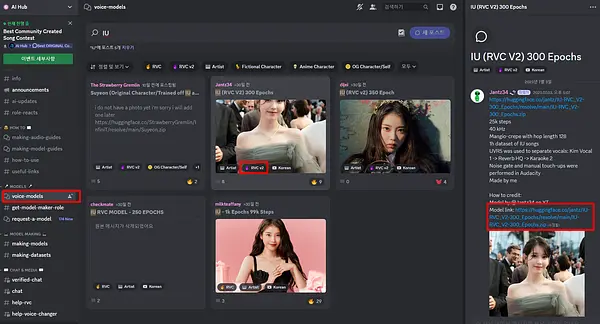
여기까지 끝내면 정말 8부 능선은 넘어간 겁니다. 아래 디스코드 채널에 접속하여 voice-models를 클릭합니다. 그리고 원하는 목소리를 찾습니다. RVC v2 태그가 된 모델만 사용하세요. 모델을 클릭하면 이미지처럼 오른 편에 글이 뜨는데 여기서 Model link 부분만 복사합니다.

https://discord.gg/aihub

image.png

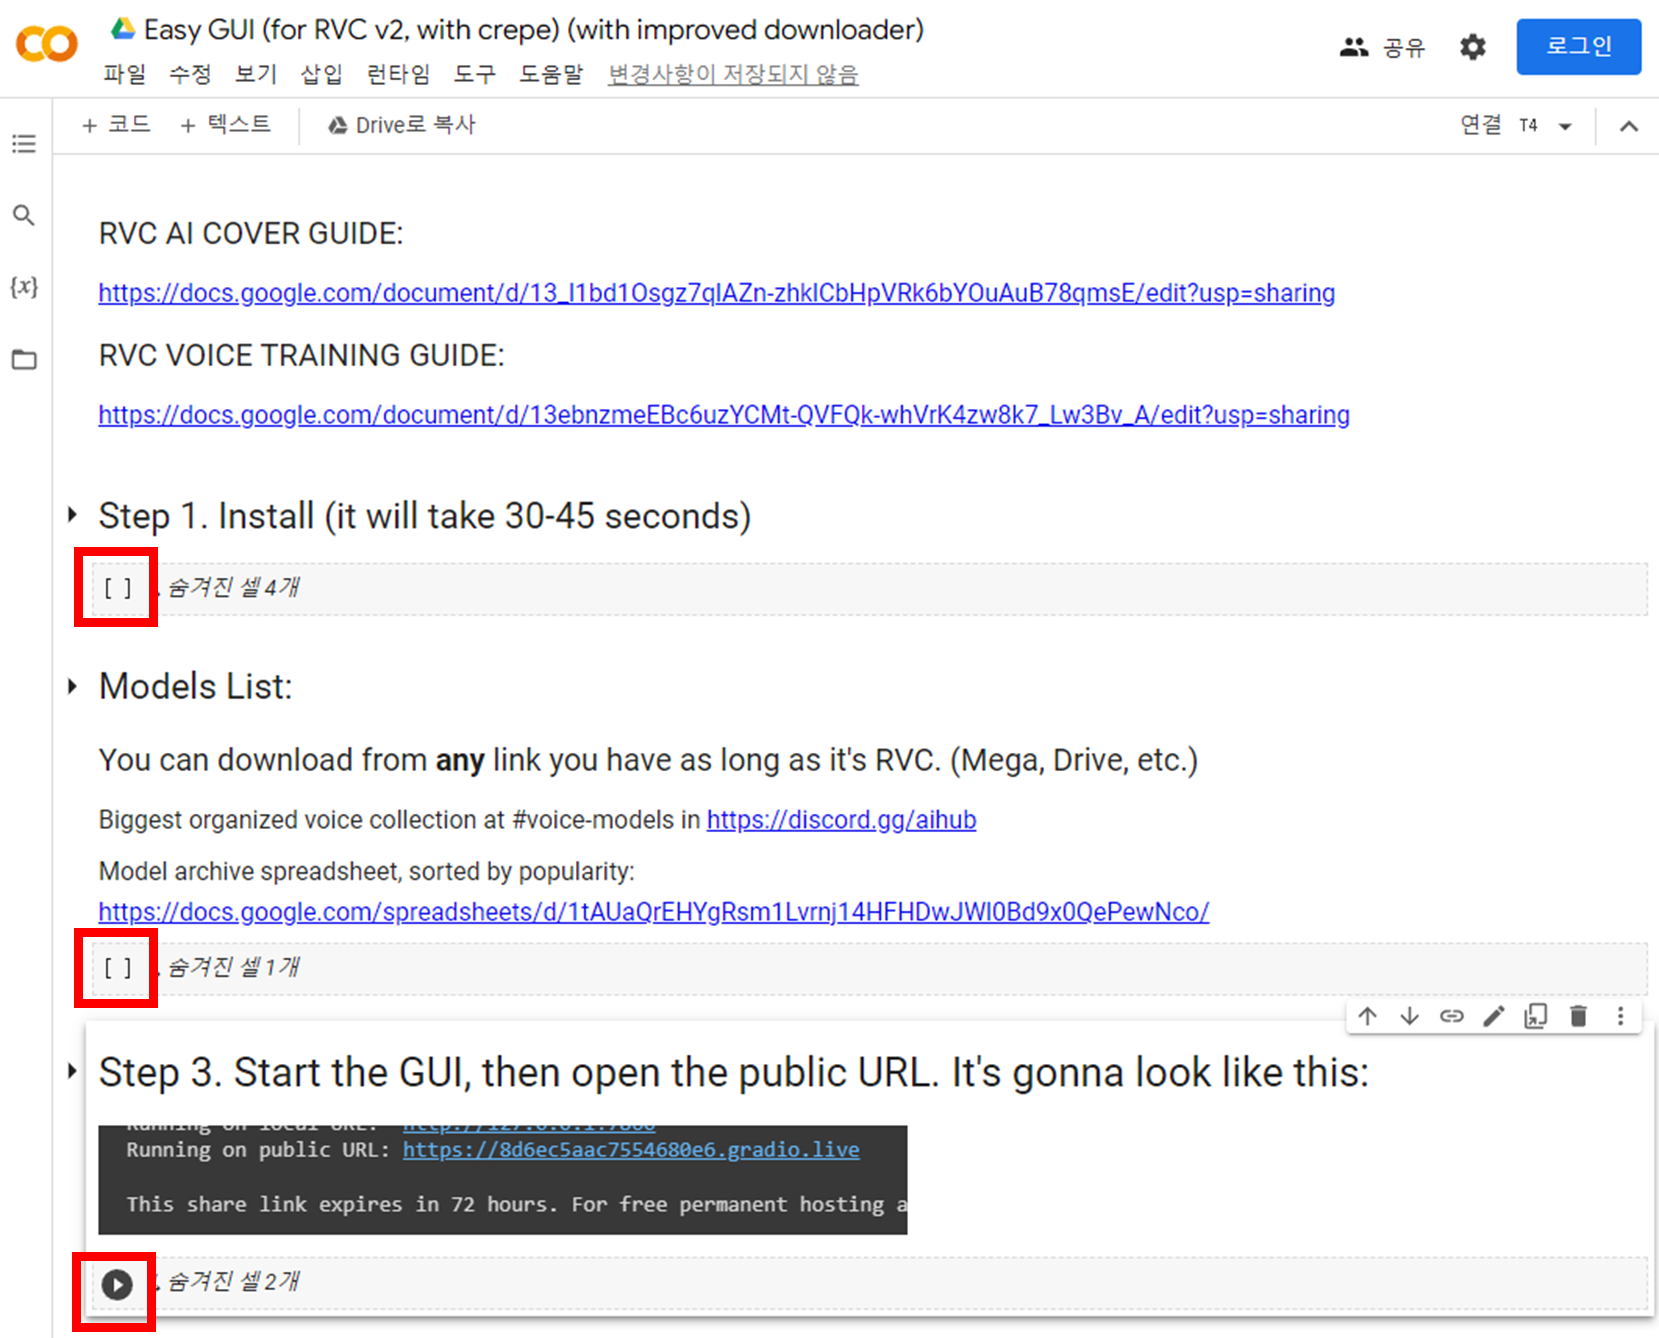
4. 코랩을 사용합니다. (2분)

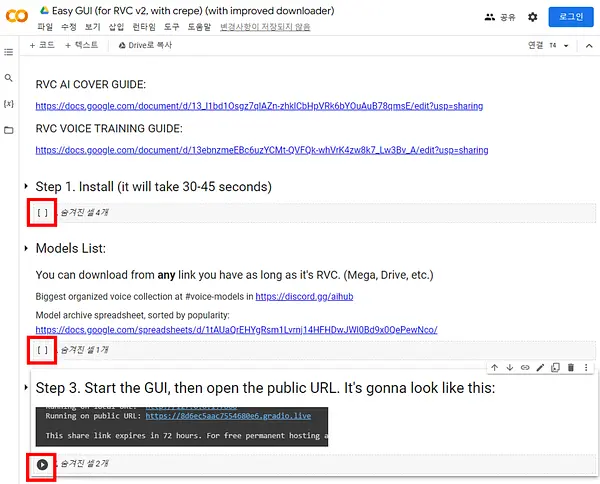
영어가 엄청 나와 어지럽지만 매우 쉽습니다. 재생 버튼 3개만 순차적으로 눌러주세요. 아래 이미지처럼 재생 버튼이 안 보여도 저기 표시된 부분을 클릭하시면 됩니다.

https://colab.research.google.com/drive/1Gj6UTf2gicndUW_tVheVhTXIIYpFTYc7?usp=sharing

image.png

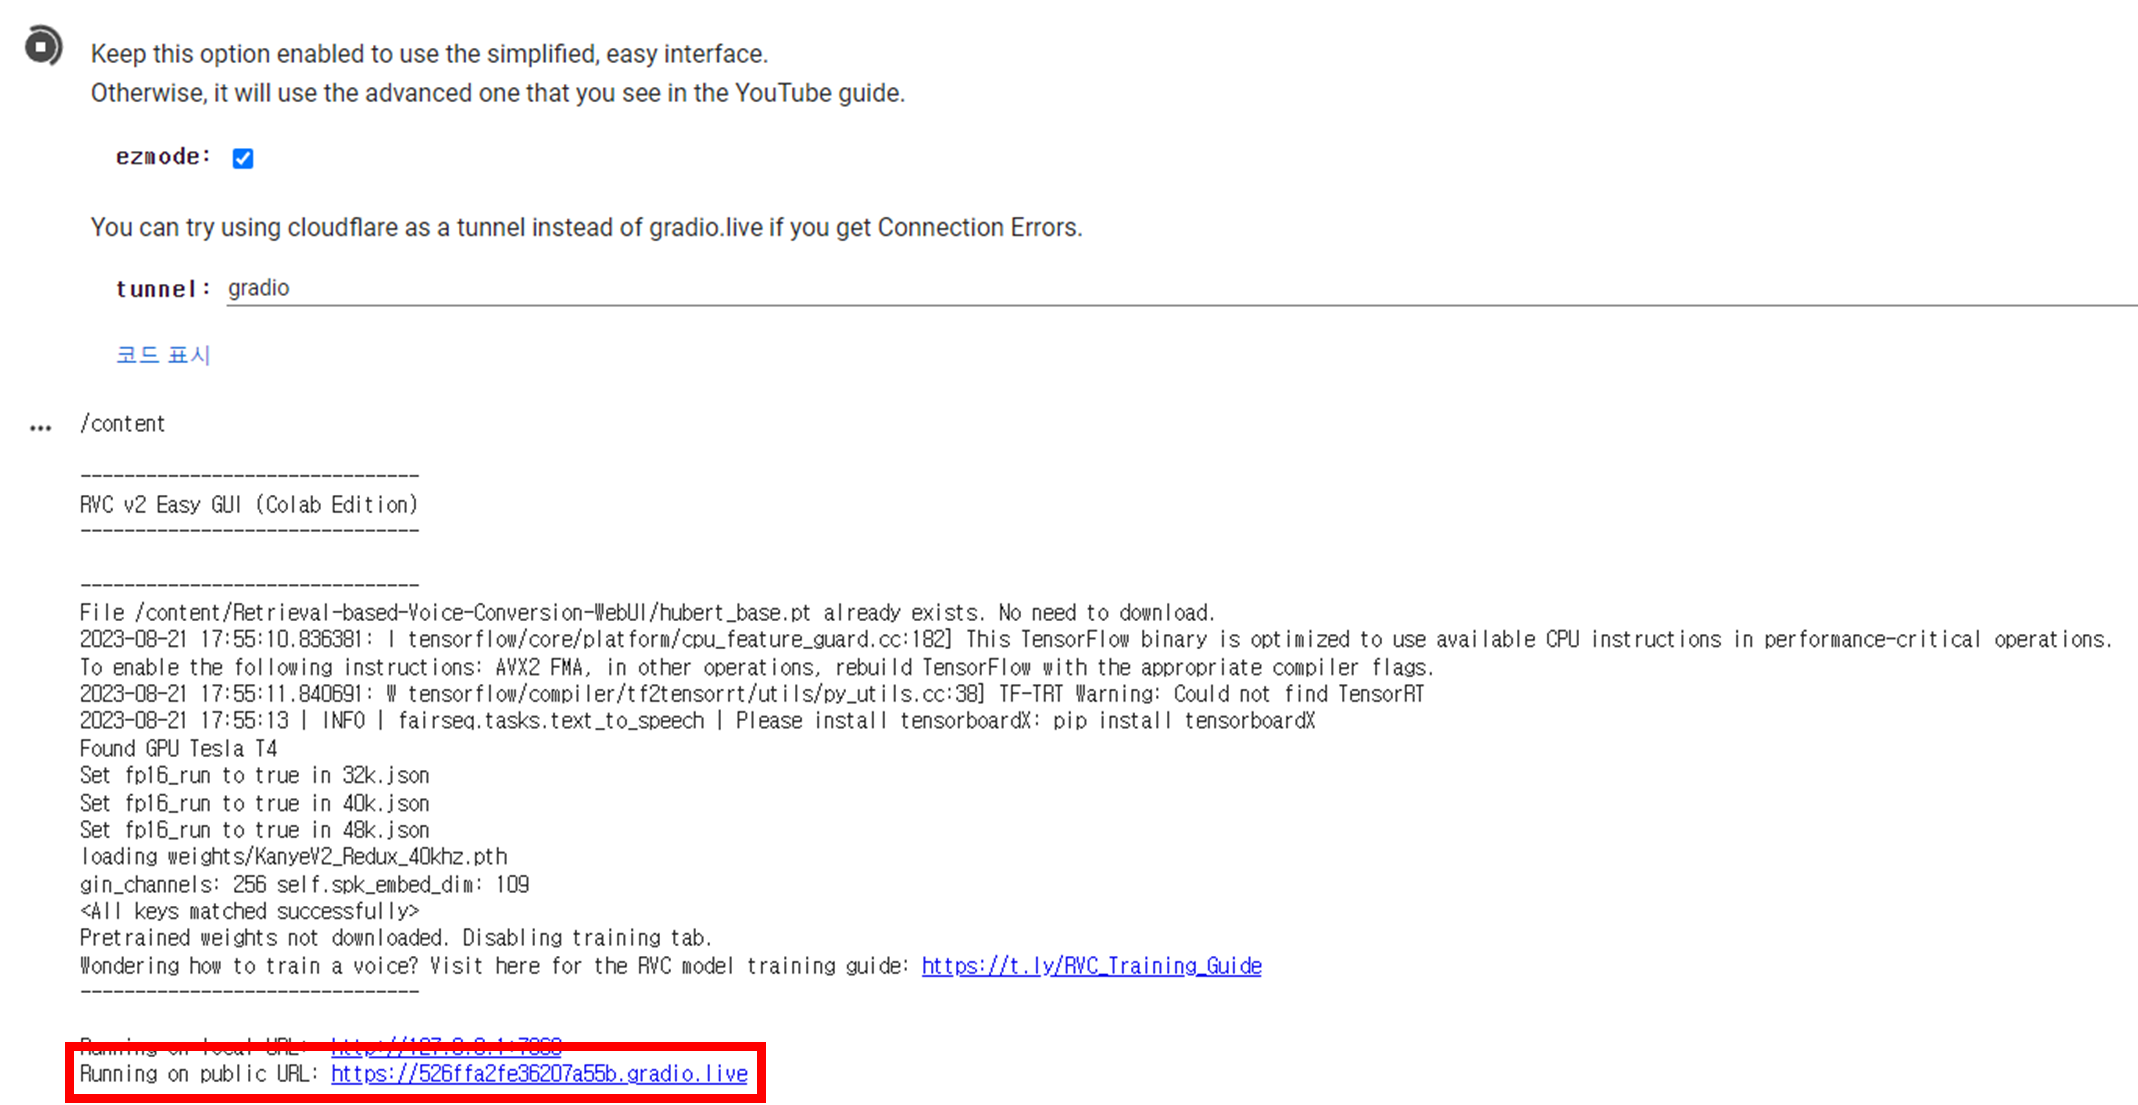
5. WebUI를 실행(0분)

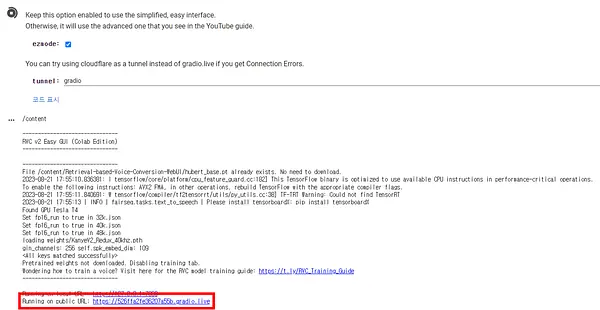
3번 째 재생 버튼을 클릭하면 아래 이미지처럼 URL이 하나 나옵니다. 이 URL을 클릭하시면 새 창이 뜨면서 AI 노래를 만들 수 있는 페이지로 넘어가집니다.

image.png

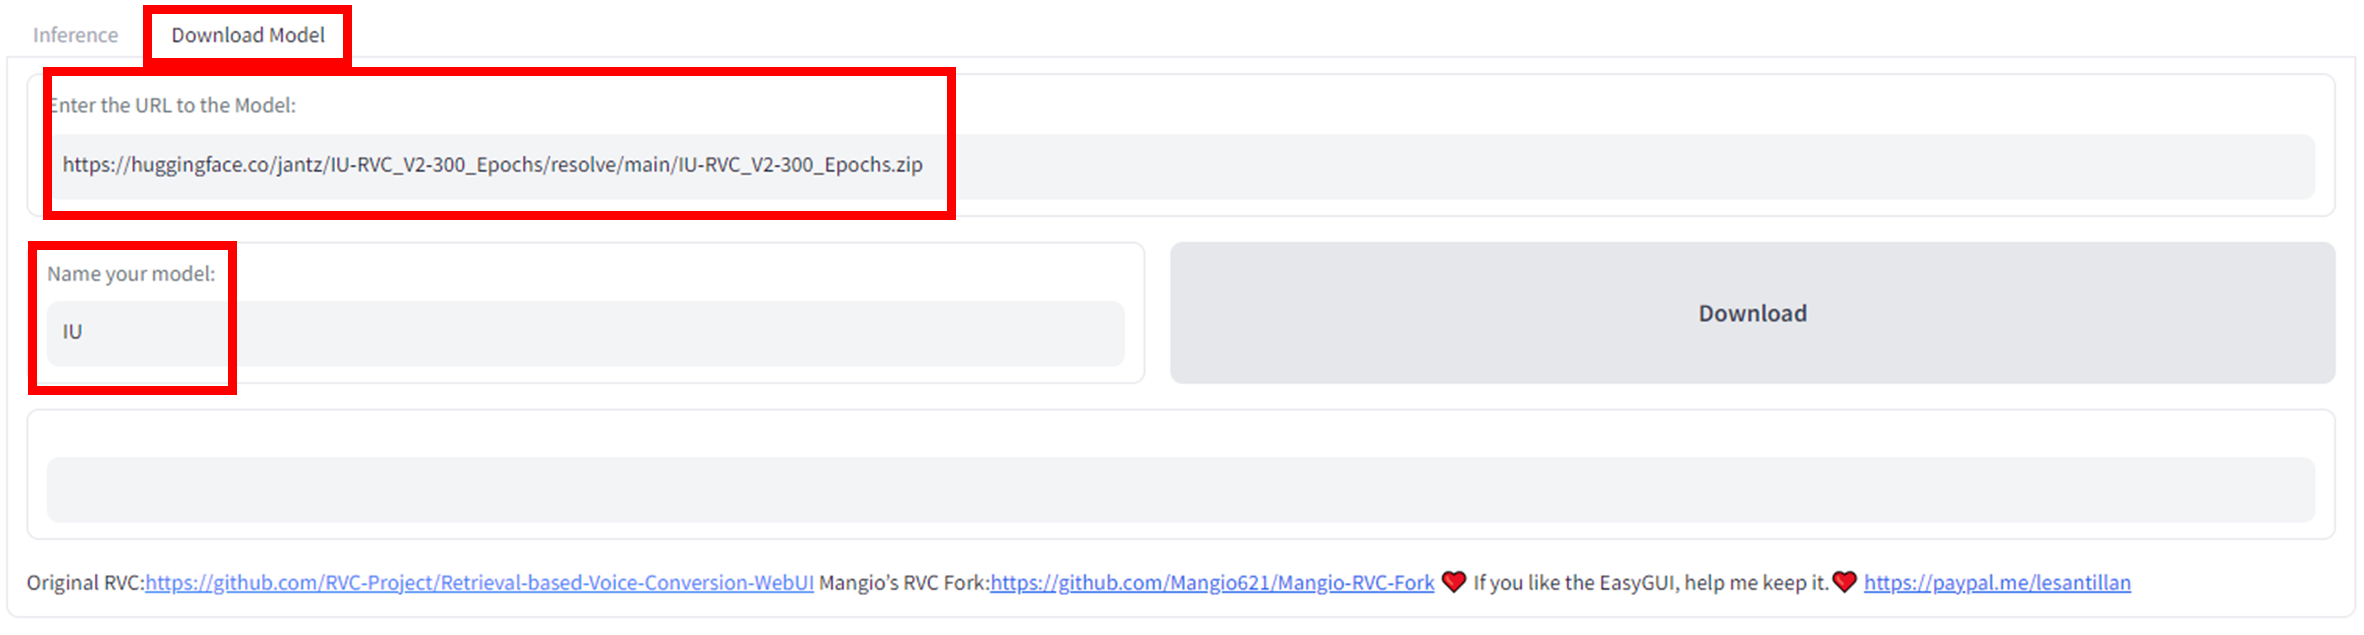
6. 목소리 모델 다운받기(30초)

3번에서 복사한 model link 부분을 입력하고, 모델 이름을 적당히 적습니다.

image.png

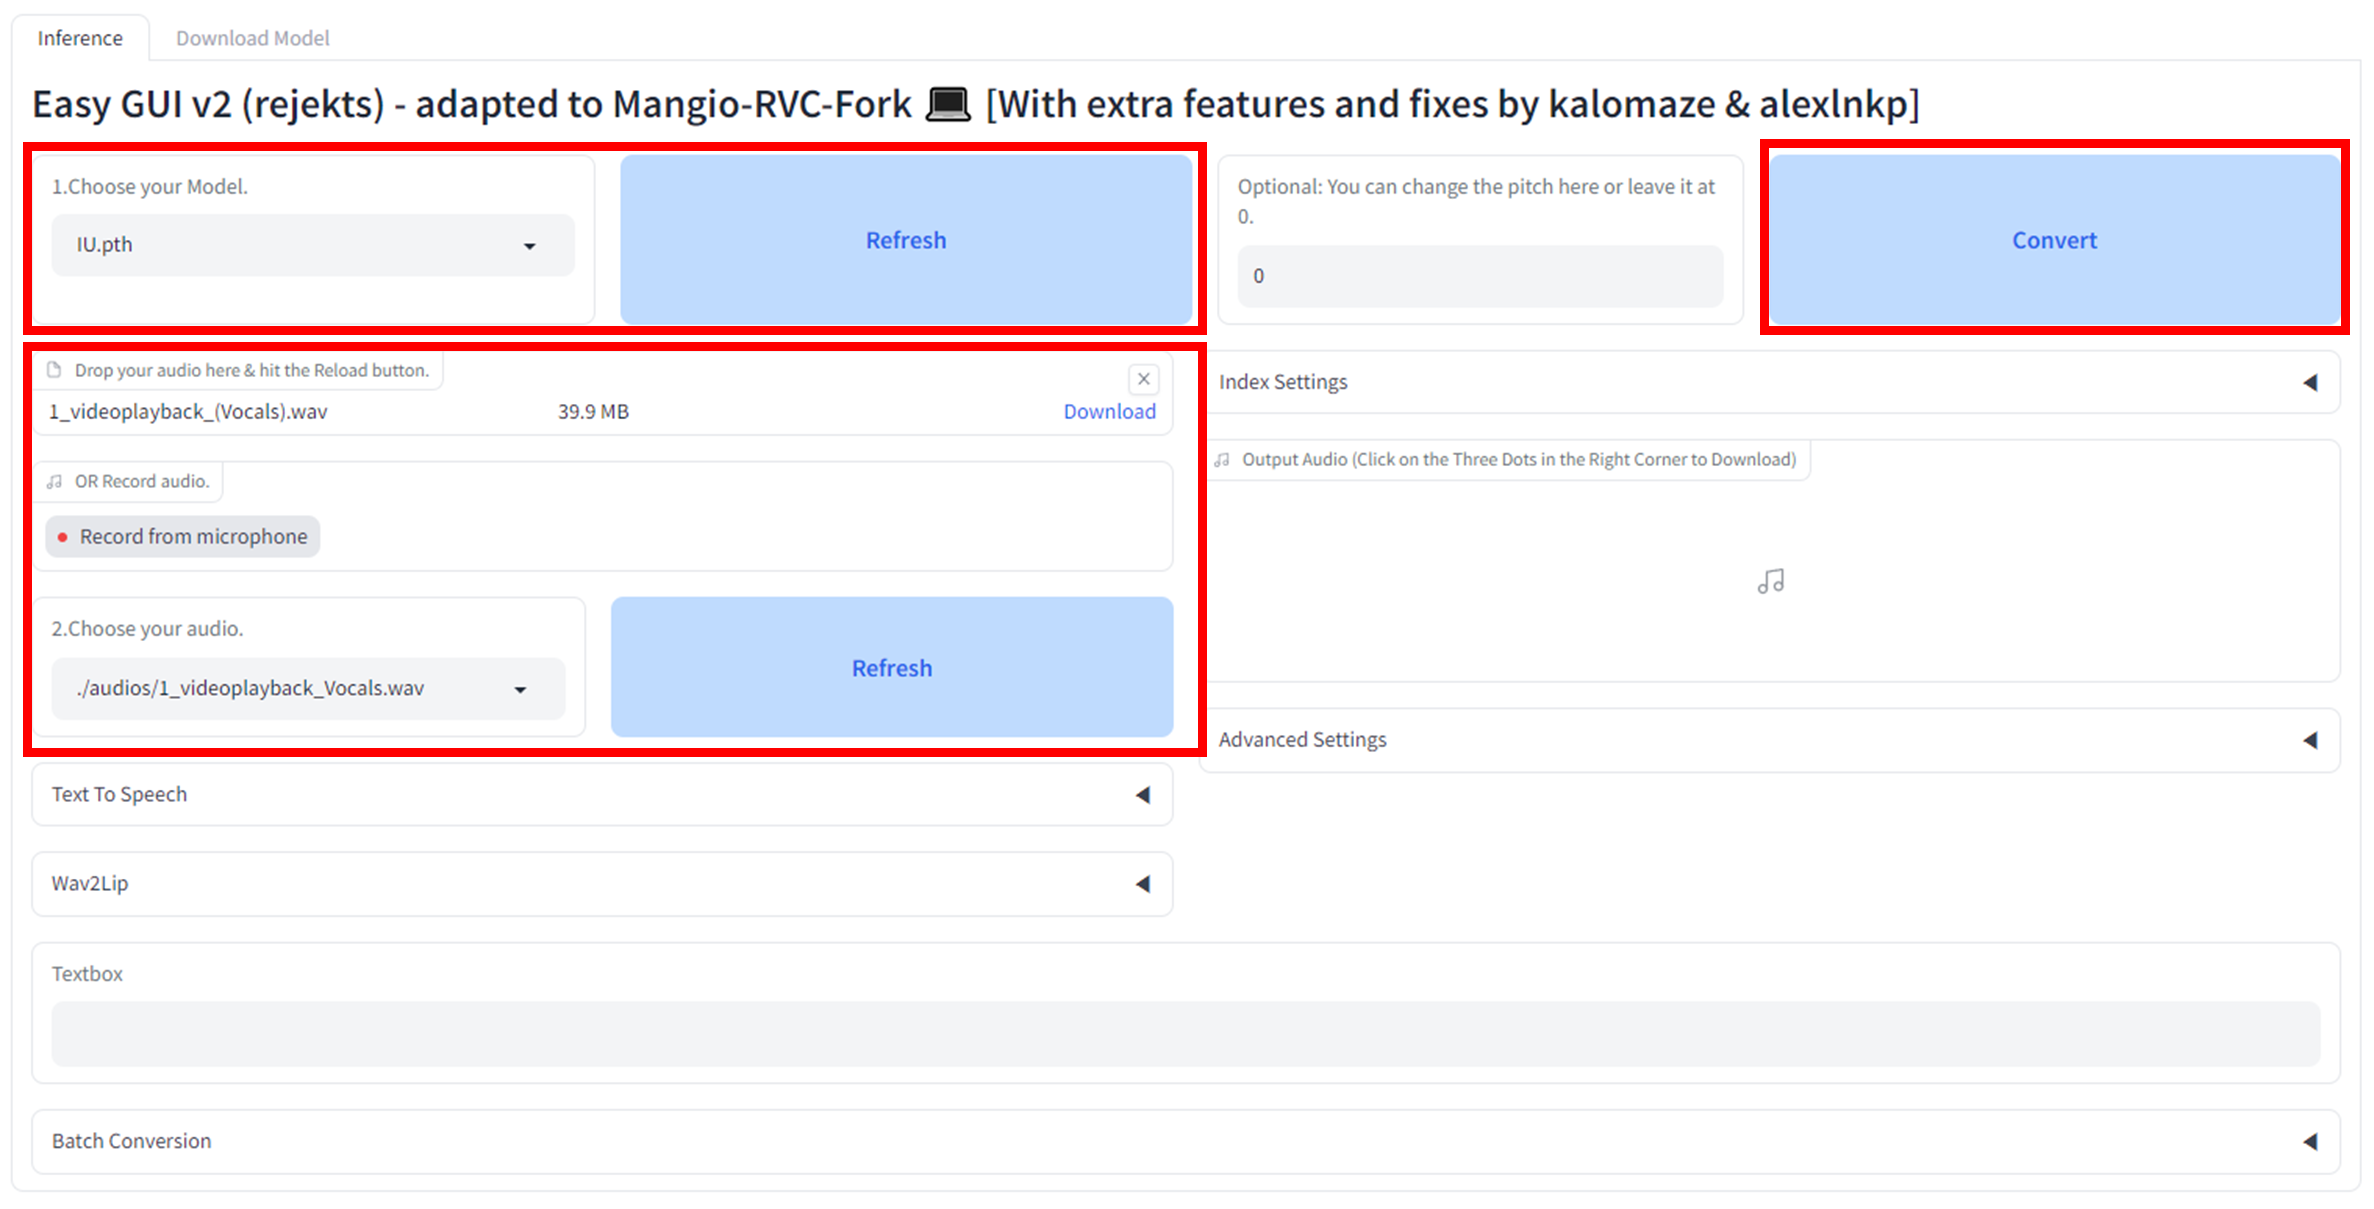
7. 이제 추론 합시다.(1분)

모델을 다운 받았으면,

1) model을 선택

2) 2번에서 만든 목소리 파일을 업로드한 후 선택. 모델과 음성 파일이 보이지 않으면 refresh 버튼을 누릅니다.

3) 음성파일까지 업로드가 되었다면, Convert를 누릅니다.

image.pngimage.png

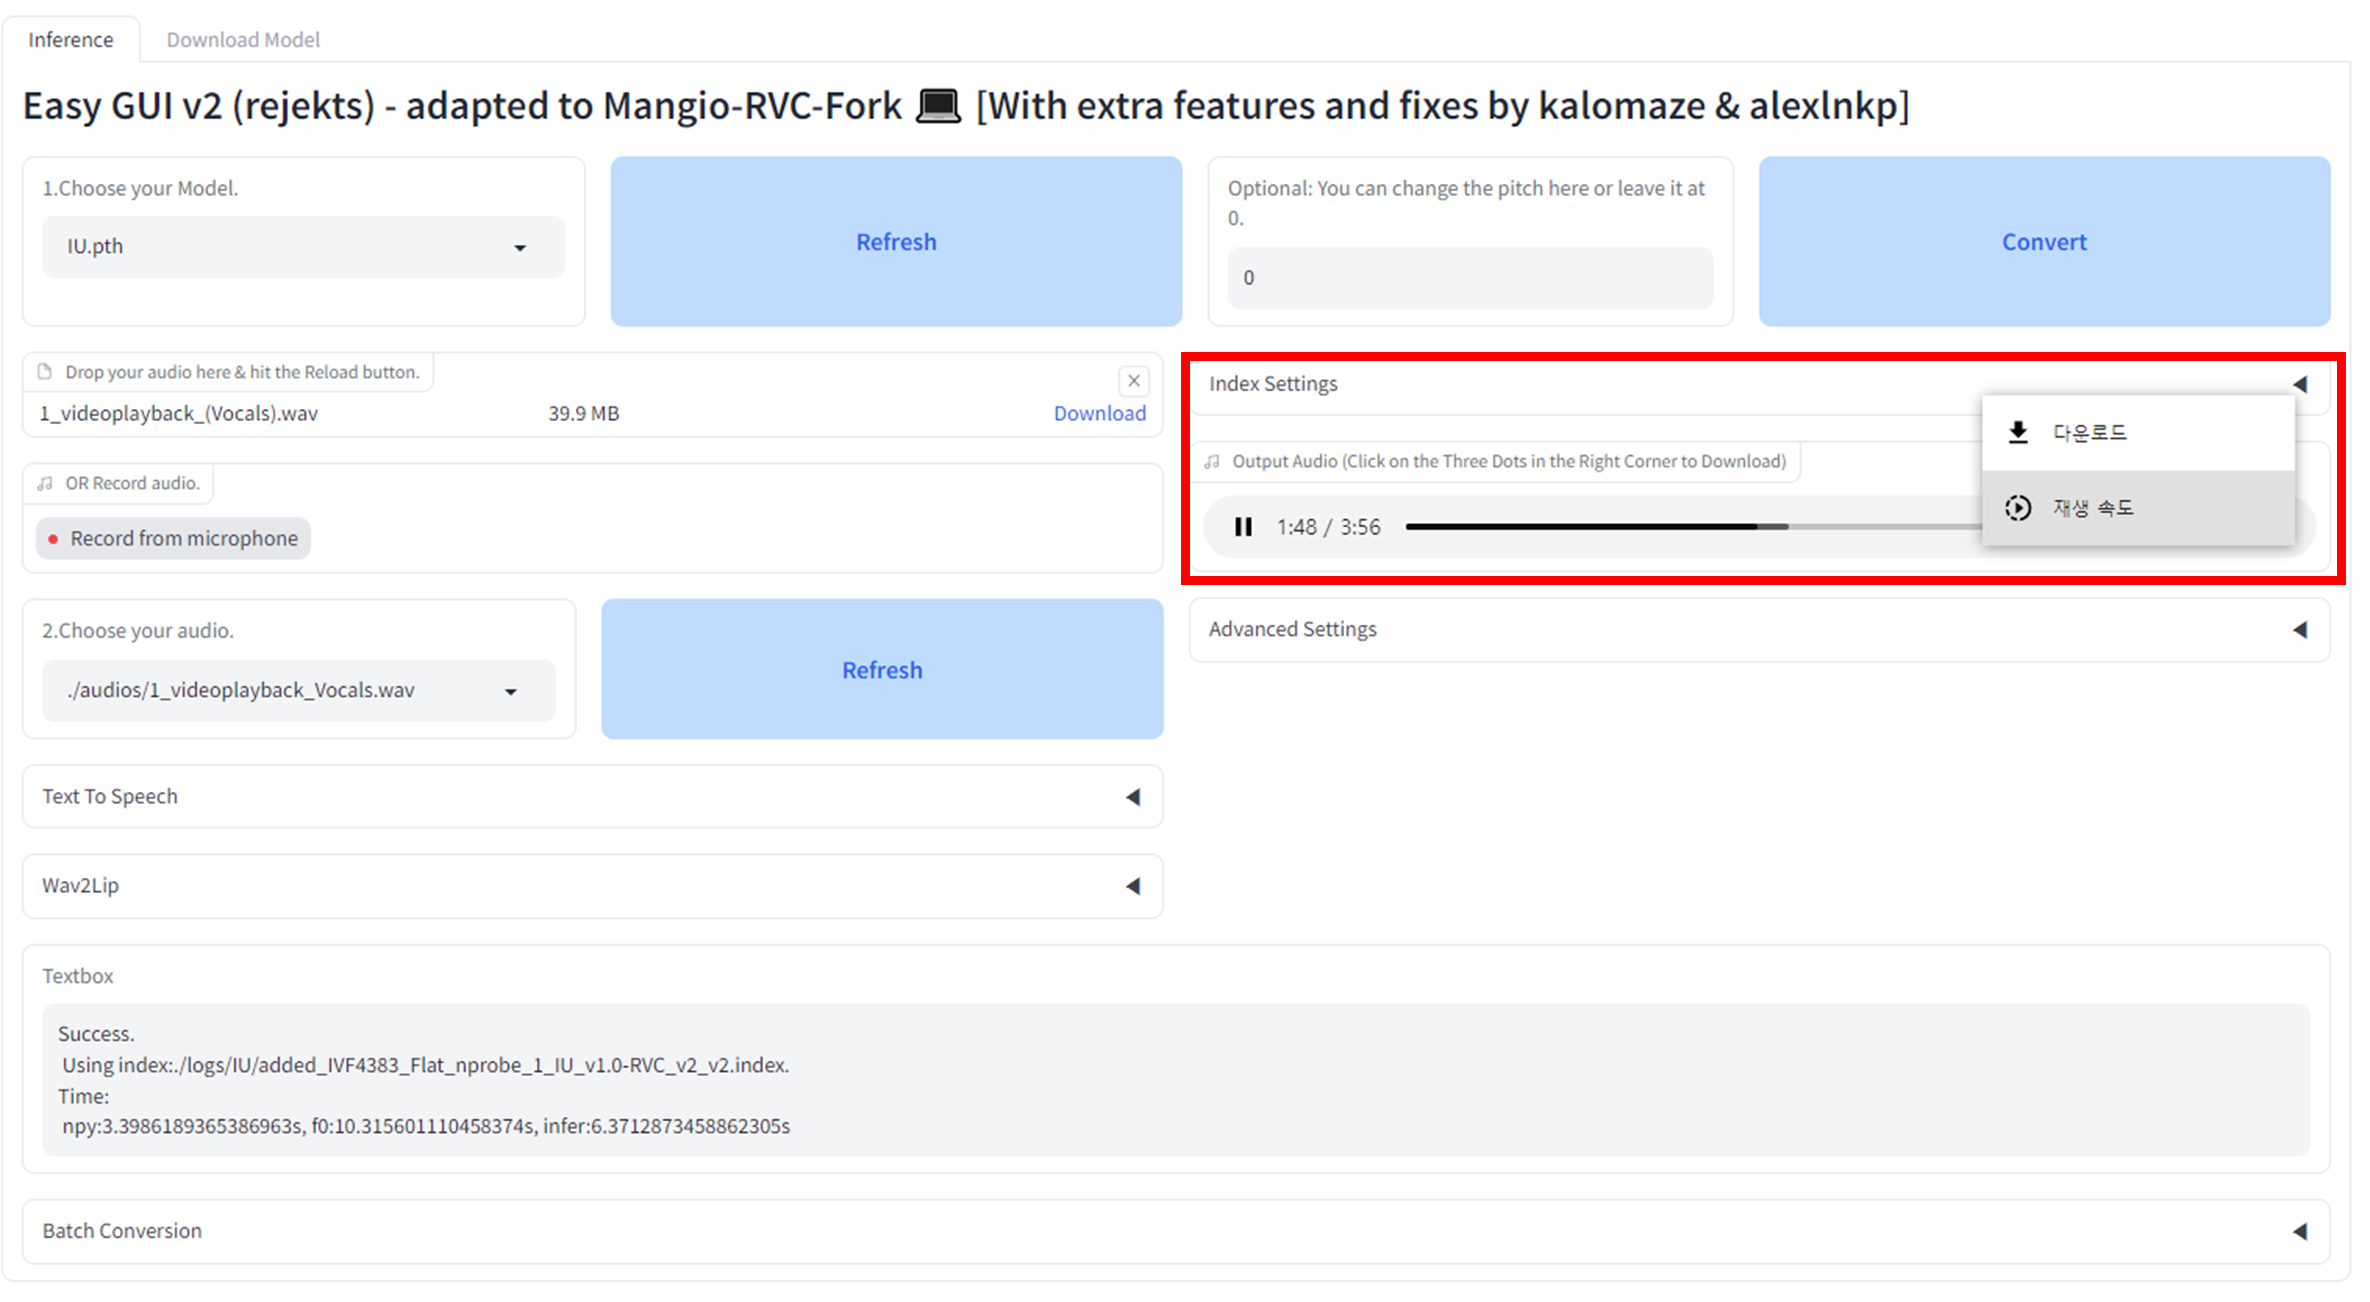
8. AI 커버곡 생성 끝!!!!(30초)

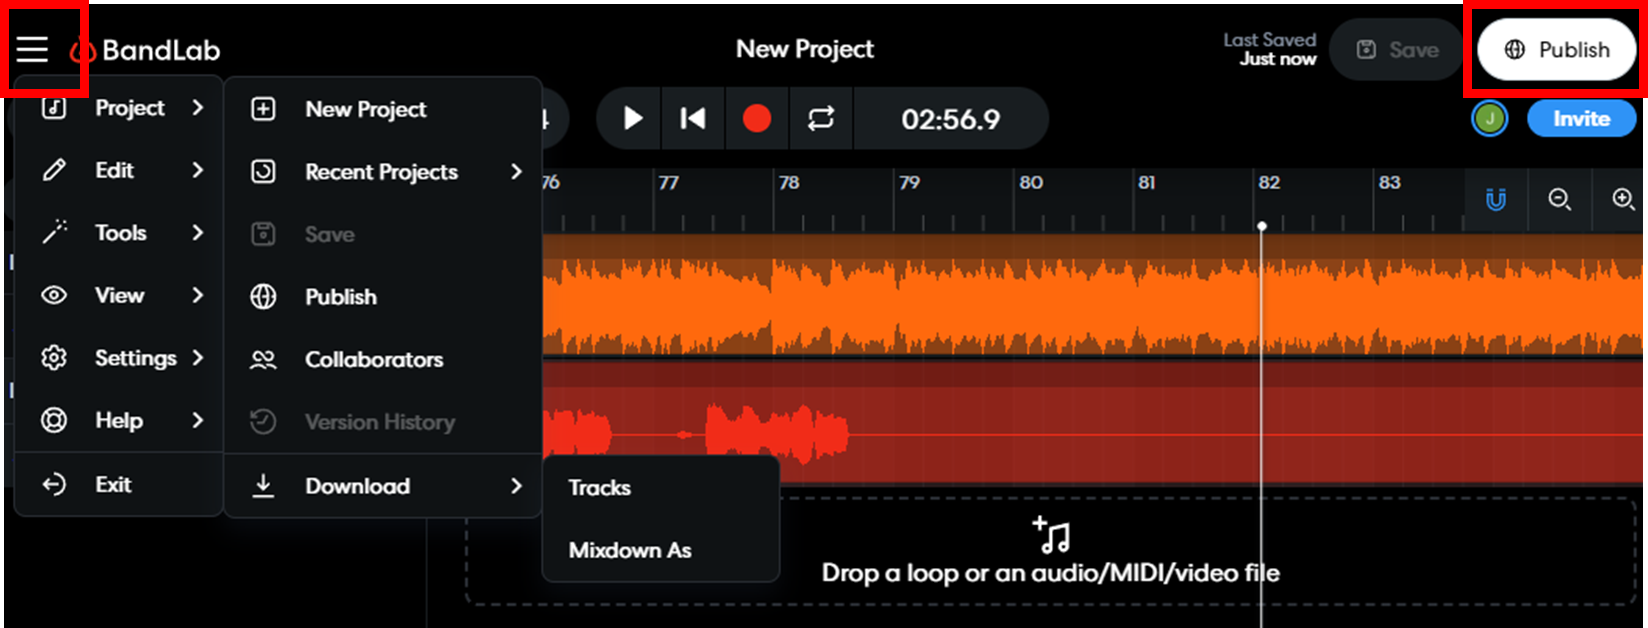
이제 AI 결과물을 MR과 합쳐봅니다. 생성된 AI 결과물을 다운받습니다. 음성 합칠 수 있는 서비스(저는 주로 bandlab을 이용합니다)에 들어가서 AI 목소리와 MR을 합친 후 파일을 저장합니다. (bandlab에서는 오른 쪽상단의 Publish를 누른 후에 설정 탭에서 Project->Download->Mixdown As를 클릭하세요.)

https://www.bandlab.com/studio

이렇게 하면 멋진 노래가 뙇하고 나오게 됩니다.!!!

image.png

저작권이나 뭐 이런 문제가 있을 거 같아서 파일은 업로드하지 못하지만 생각보다 노래가 정말 잘 나온답니다.

이러한 입문 과정이 익숙해지면

2번 과정에서 목소리 파일을 더 깔금하게 깎는 걸 연습하게 되고,

3번 과정에서 본인이 직접 원하는 인물의 목소리 모델을 만들게 되고,

8번 과정에서 보다 정교한 후처리를 통해 더 깔끔한 노래를 만들게 됩니다.

19
14
Cailyn Yong

Cailyn Yong

[Part 3] 2시간 안에 업무 자동화 AI Agent 만들기: 구글 검색 기능

AI Agent 만들기의 마지막 파트입니다.

Part 1: 전체 프로그램 셋업, OpenAI API 연결, Vector Store 연결

Part 2: 커스텀 LLM 체인 직접 만들고나서 실행하기

Part 3: Agent가 나 대신 실제 구글 검색하는 기능 만들기

SerpAPI key 받아오기

저번 파트에서 성공적으로 코드를 수행했다면 이제 AI 에이전트가 업무를 하기 위해 먼저 to-do list를 만들고 태스크 중 중요도가 높은 태스크부터 진행할 것입니다.

하지만 실제 구글 검색을 통해서 모은 자료가 아니기 때문에 정보가 정확하지 않고 hallucination 결과값들을 내뱉을 수 있습니다.

이번 파트에서는 이를 방지하고자 Google SerpAPI라는 것을 써서 에이전트가 실제 웹과 연결되어 구글링을 할 수 있도록 할 것입니다.

웹 검색을 하기 위해서는 Part 1에서 OpenAI를 쓰기 위해 OpenAI API secret key를 받은것처럼 SerpAPI key를 받아야합니다.

https://serpapi.com/ 여기로 가서 계정을 만든 다음, 옆에 API Dashboard라는 곳에서 Api key 버튼을 누르고 API key를 만드세요. OpenAI API key와 마찬가지로 이걸 복사해서 코드에 붙여넣을 겁니다.

import os
os.environ["OPENAI_API_KEY"] = " "
os.environ["SERPAPI_API_KEY"] = " "

기존 코드의 두번째 줄 바로 밑에 os.environ[”SERPAPI_API_KEY”] = “” 를 복붙하고 “ “ 사이에 방금 만든 SerpAPI key를 붙여넣으세요.

Part 1에서 나왔듯이 저희는 구글 검색을 가능하게 하려면 알맞는 모듈들을 불러와야합니다.

from collections import deque
from typing import Dict, List, Optional, Any

from langchain import LLMChain, OpenAI, PromptTemplate
from langchain.embeddings import OpenAIEmbeddings
from langchain.llms import BaseLLM
from langchain.vectorstores.base import VectorStore
from pydantic import BaseModel, Field
from langchain.chains.base import Chain

from langchain.vectorstores import FAISS
from langchain.docstore import InMemoryDocstore

기존의 모듈 코드(위 코드) 밑에 아래 코드를 붙여넣습니다.

from langchain.agents import ZeroShotAgent, Tool, AgentExecutor
from langchain import OpenAI, SerpAPIWrapper, LLMChain

이제 구글 검색이 가능한 LLM 체인을 만들겁니다.

Part 2에서 세번째 체인인 class ExecutionChain(LLMChain)은 현재 구글 검색이 불가능합니다. (아래 코드)

class ExecutionChain(LLMChain):
    """Chain to execute tasks."""

    @classmethod
    def from_llm(cls, llm: BaseLLM, verbose: bool = True) -> LLMChain:
        """Get the response parser."""
        execution_template = (
            "You are an AI who performs one task based on the following objective: {objective}."
            " Take into account these previously completed tasks: {context}."
            " Your task: {task}."
            " Response:"
        )
        prompt = PromptTemplate(
            template=execution_template,
            input_variables=["objective", "context", "task"],
        )
        return cls(prompt=prompt, llm=llm, verbose=verbose)

그래서 이 코드를 아래 코드로 대체할 것입니다.

todo_prompt = PromptTemplate.from_template(
    "You are a planner who is an expert at coming up with a todo list for a given objective. Come up with a todo list for this objective: {objective}"
)
todo_chain = LLMChain(llm=OpenAI(temperature=0), prompt=todo_prompt)
search = SerpAPIWrapper()
tools = [
    Tool(
        name="Search",
        func=search.run,
        description="useful for when you need to answer questions about current events",
    ),
    Tool(
        name="TODO",
        func=todo_chain.run,
        description="useful for when you need to come up with todo lists. Input: an objective to create a todo list for. Output: a todo list for that objective. Please be very clear what the objective is!",
    ),
]

prefix = """You are an AI who performs one task based on the following objective: {objective}. Take into account these previously completed tasks: {context}."""
suffix = """Question: {task}
{agent_scratchpad}"""
prompt = ZeroShotAgent.create_prompt(
    tools,
    prefix=prefix,
    suffix=suffix,
    input_variables=["objective", "task", "context", "agent_scratchpad"],
)

이 코드로 대체할 건데요, 기존의 코드와 이 새로운 코드랑 비교를 해봅시다.

가장 먼저 코드의 첫줄을 보면 todo_prompt가 있습니다. 이건 기존 코드의 프롬프트 템플릿과 똑같은 기능을 해주고 있습니다. 하지만 prompt의 내용이 바꼈는데요, 기존에는 그저 ‘태스크를 컨텍스트에 맞게 실행해라’였다면 이번에는 조금 더 구체적으로 먼저 todo list을 만들으라고 하네요.

이 템플릿을 기반으로 저희는 todo_chain을 다음 줄에서 만듭니다.

세번째 줄에 있는 search = SerpAPIWrapper()는 저희가 처음에 불러온 SerpAPI 검색 기능을 쓰기 위해 셋업을 해놓는 것입니다.

재미있게도 저희는 todo_chain이 쓰면 좋을만한 툴들을 만들어주고 이걸 적절한 상황에서 각 툴을 알맞게 쓸 수 있도록 할 수 있습니다.

tools = [ … ] 코드 블록을 보면 저희는 크게 두가지 툴, “Search” tool과 “TODO” tool을 만든 것을 볼 수 있습니다.

Search tool은 실제 구글 검색을 하면서 정확한 정보를 불러와야할때 쓰는 툴이 되는거고, TODO tool은 todo list을 만들어야 할때 쓰이는 툴이 되는 것입니다.

마지막으로 기존의 코드와 비슷한 코드 부분은 prefix = “…” 부터 prompt = ZeroShotAgent까지의 코드입니다. 여기서는 이제 만든 todo list을 기반으로 태스크를 하나씩 실행하게끔 하는 Agent을 만든겁니다.

거의 다 왔습니다.

기존 코드에서 바꿔야 할 부분이 몇가지 더 있습니다.

@classmethod
    def from_llm(
        cls, llm: BaseLLM, vectorstore: VectorStore, verbose: bool = False, **kwargs
    ) -> "BabyAGI":
        """Initialize the BabyAGI Controller."""
        task_creation_chain = TaskCreationChain.from_llm(llm, verbose=verbose)
        task_prioritization_chain = TaskPrioritizationChain.from_llm(
            llm, verbose=verbose
        )
        execution_chain = ExecutionChain.from_llm(llm, verbose=verbose)
        return cls(
            task_creation_chain=task_creation_chain,
            task_prioritization_chain=task_prioritization_chain,
            execution_chain=execution_chain,
            vectorstore=vectorstore,
            **kwargs,
        )

위 코드를 아래 코드와 같이 대체합니다.

@classmethod
    def from_llm(
        cls, llm: BaseLLM, vectorstore: VectorStore, verbose: bool = False, **kwargs
    ) -> "BabyAGI":
        """Initialize the BabyAGI Controller."""
        task_creation_chain = TaskCreationChain.from_llm(llm, verbose=verbose)
        task_prioritization_chain = TaskPrioritizationChain.from_llm(
            llm, verbose=verbose
        )
        llm_chain = LLMChain(llm=llm, prompt=prompt)
        tool_names = [tool.name for tool in tools]
        agent = ZeroShotAgent(llm_chain=llm_chain, allowed_tools=tool_names)
        agent_executor = AgentExecutor.from_agent_and_tools(
            agent=agent, tools=tools, verbose=True
        )
        return cls(
            task_creation_chain=task_creation_chain,
            task_prioritization_chain=task_prioritization_chain,
            execution_chain=agent_executor,
            vectorstore=vectorstore,
            **kwargs,
        )

기존 코드에서 만들었던 세번째 체인, execution_chain = ExecutionChain.from_llm(llm, verbose=verbose) 코드 대신 저희가 만든 구글 검색 기능이 가능한 ZeroShotAgent으로 바꿔줘야합니다.

return cls (…) 부분에서 execution_chain=execution_chain도 execution_chain=agent_executor로 대체합니다.

llm_chain = LLMChain(llm=llm, prompt=prompt)
tool_names = [tool.name for tool in tools]
agent = ZeroShotAgent(llm_chain=llm_chain, allowed_tools=tool_names)
agent_executor = AgentExecutor.from_agent_and_tools(
    agent=agent, tools=tools, verbose=True
)

새롭게 추가된 코드를 좀 더 자세히 들여다보면, tool_names에서 저희가 만든 두가지 툴들, Search tool과 TODO tool을 둘다 쓸 수 있도록 루프를 돌고 있습니다.

agent = ZeroShotAgent(llm_chain=llm_chain, allowed_tools=tool_names) 이 코드에서는 llm_chain 기반, 저희가 만든 두개의 툴 기반으로 ZeroShotAgent를 만든다는 것입니다.

그러고 다음 줄, agent_executor 에서는 이 agent를 실행한다는 코드입니다.

마지막으로 Part 2에서 만들었던 BabyAGI Controller 부분에서 아래 코드를 찾으세요.

class BabyAGI(Chain, BaseModel):
    """Controller model for the BabyAGI agent."""

    task_list: deque = Field(default_factory=deque)
    task_creation_chain: TaskCreationChain = Field(...)
    task_prioritization_chain: TaskPrioritizationChain = Field(...)
    execution_chain: ExecutionChain = Field(...)
    task_id_counter: int = Field(1)
    vectorstore: VectorStore = Field(init=False)
    max_iterations: Optional[int] = None

여기서도 저희가 처음에 만들었던 세번째 execution 체인 대신 새롭게 만든 구글 검색 기능 체인으로 대체해줘야합니다. 그래서 execution_chain: ExecutionChain = Field(...) 코드를 execution_chain: AgentExecutor = Field(...) 코드로 바꿔주세요.

그럼 아래 코드와 같이 생겼습니다.

class BabyAGI(Chain, BaseModel):
    """Controller model for the BabyAGI agent."""

    task_list: deque = Field(default_factory=deque)
    task_creation_chain: TaskCreationChain = Field(...)
    task_prioritization_chain: TaskPrioritizationChain = Field(...)
    execution_chain: AgentExecutor = Field(...)
    task_id_counter: int = Field(1)
    vectorstore: VectorStore = Field(init=False)
    max_iterations: Optional[int] = None

테스트해보기!

이제 실제로 구글 검색 기능이 되는지 테스트 해보겠습니다.

파일을 돌리기 위해서는 Part 1에서 만든 가상환경 안에 들어가 있어야합니다.

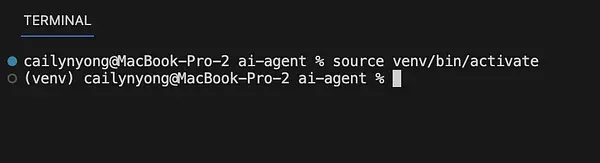
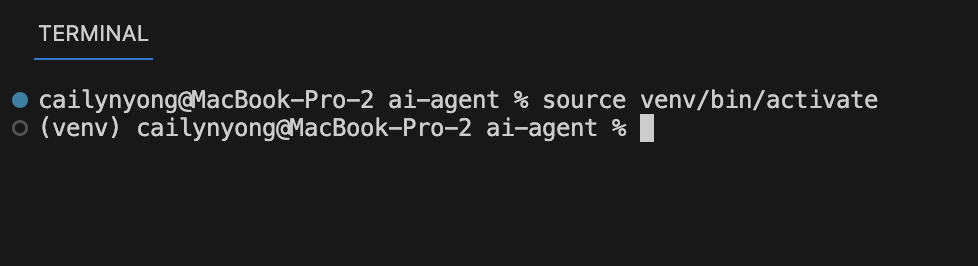
가상 환경 안에 들어와있다면 아래 사진처럼 뜹니다. 만약 들어와있지 않다면 터미널에서 source venv/bin/activate을 입력하고 엔터를 누르세요.

Screenshot 2023-08-21 at 4.32.23 PM.png다음 저희는 serpAPI를 쓰기 위해 다운로드해야하는 패키지가 있습니다. 터미널에 pip install google-search-results를 입력해주세요.

이제 python agent.py 를 입력하면 코드가 돌려집니다.

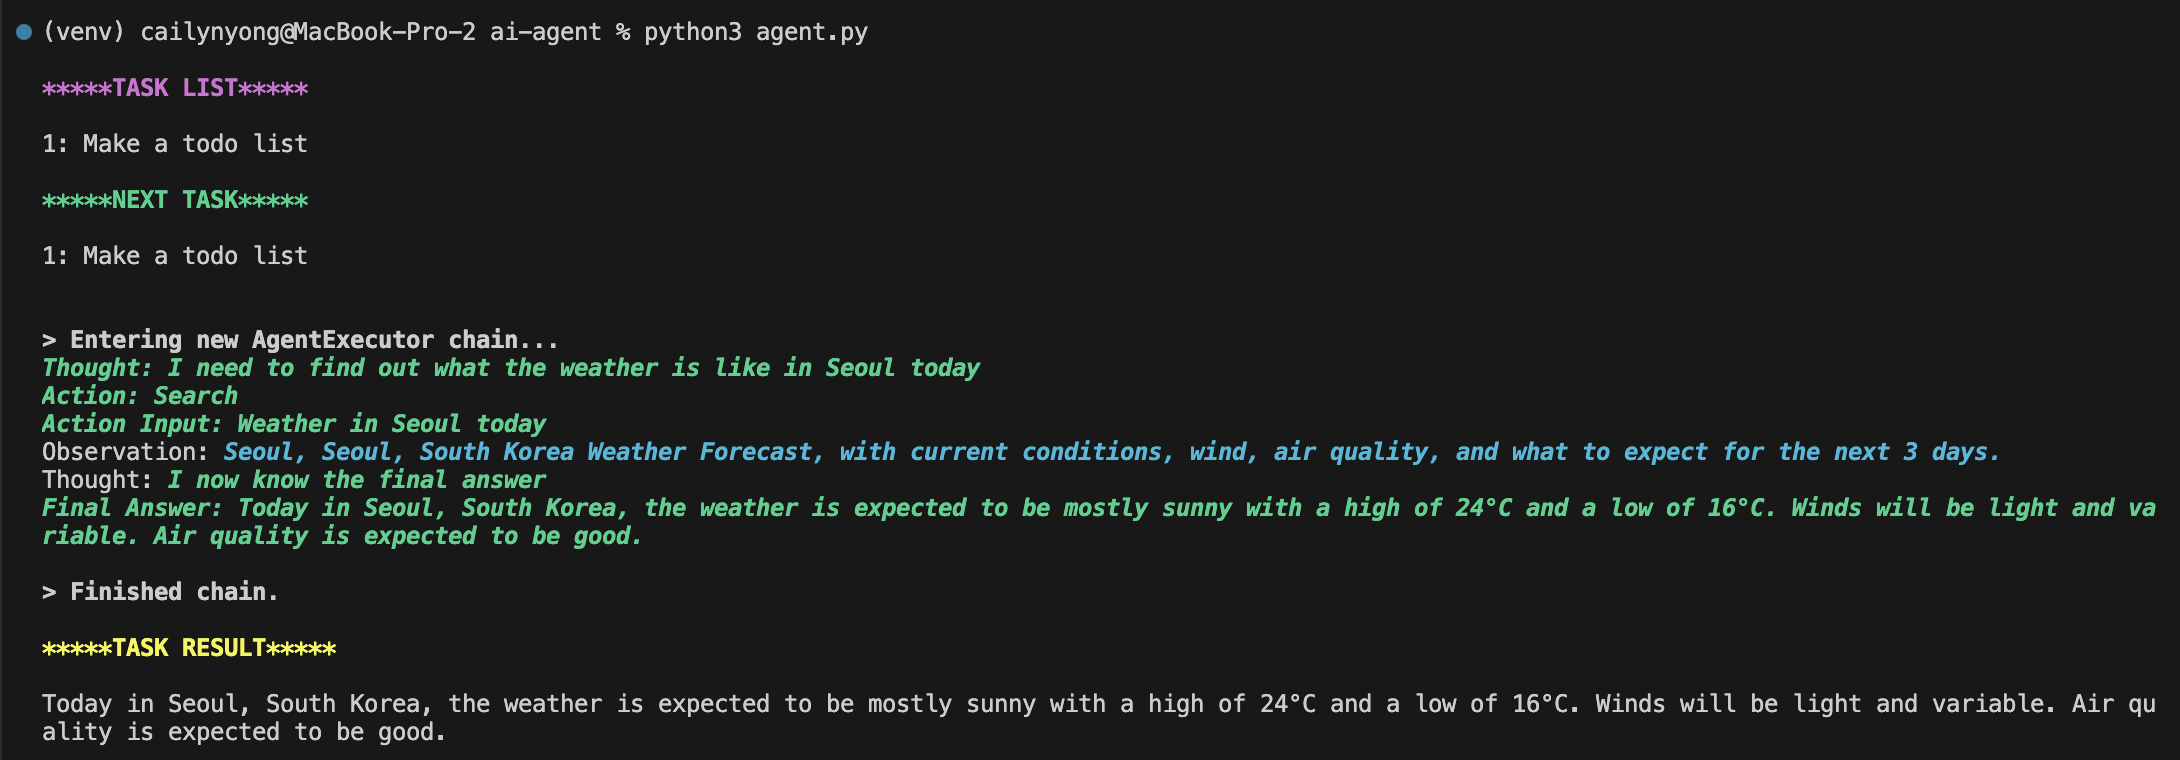
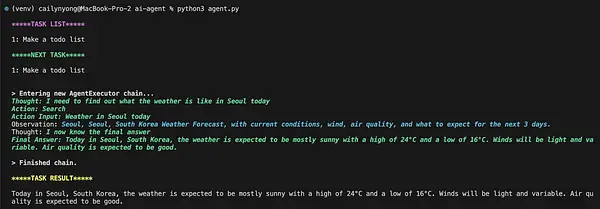
첫번째 결과값으로 오늘 서울의 날씨를 구글에서 검색을 했고, 결과값으로 ”오늘의 날씨는 화창하며 최저 기온은 16도, 최고 기온은 24도입니다. 바람은 약하고 대기질 지수가 낮습니다.”가 나왔습니다.

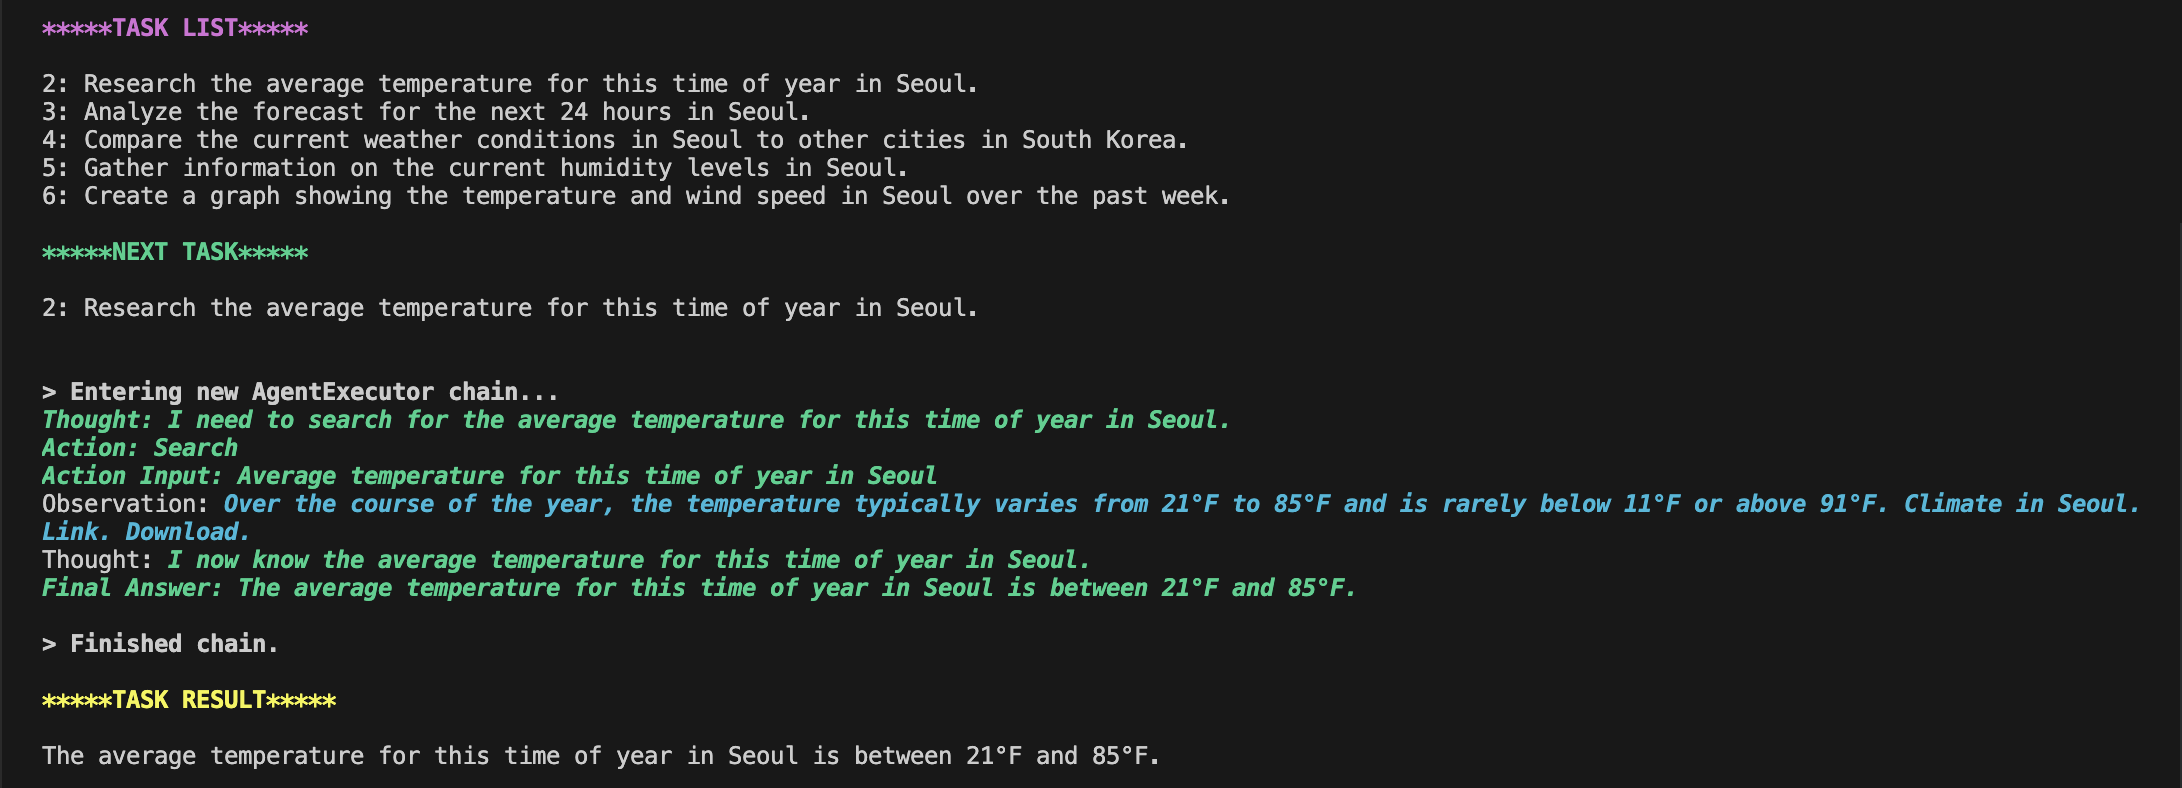
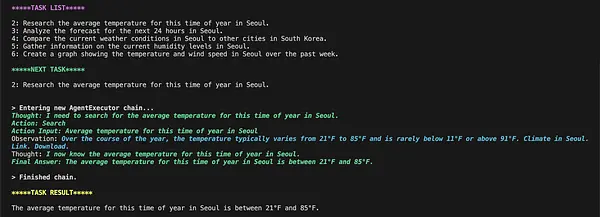
Screenshot 2023-08-21 at 4.35.36 PM.png두번째 태스크를 돌리면 8월달에 서울의 평균 기온이 -6도에서 30도 사이라는 결과값이 나왔는데, 별로 정확하진 않네요. 아무래도 hallucination이 발생한 것 같습니다.

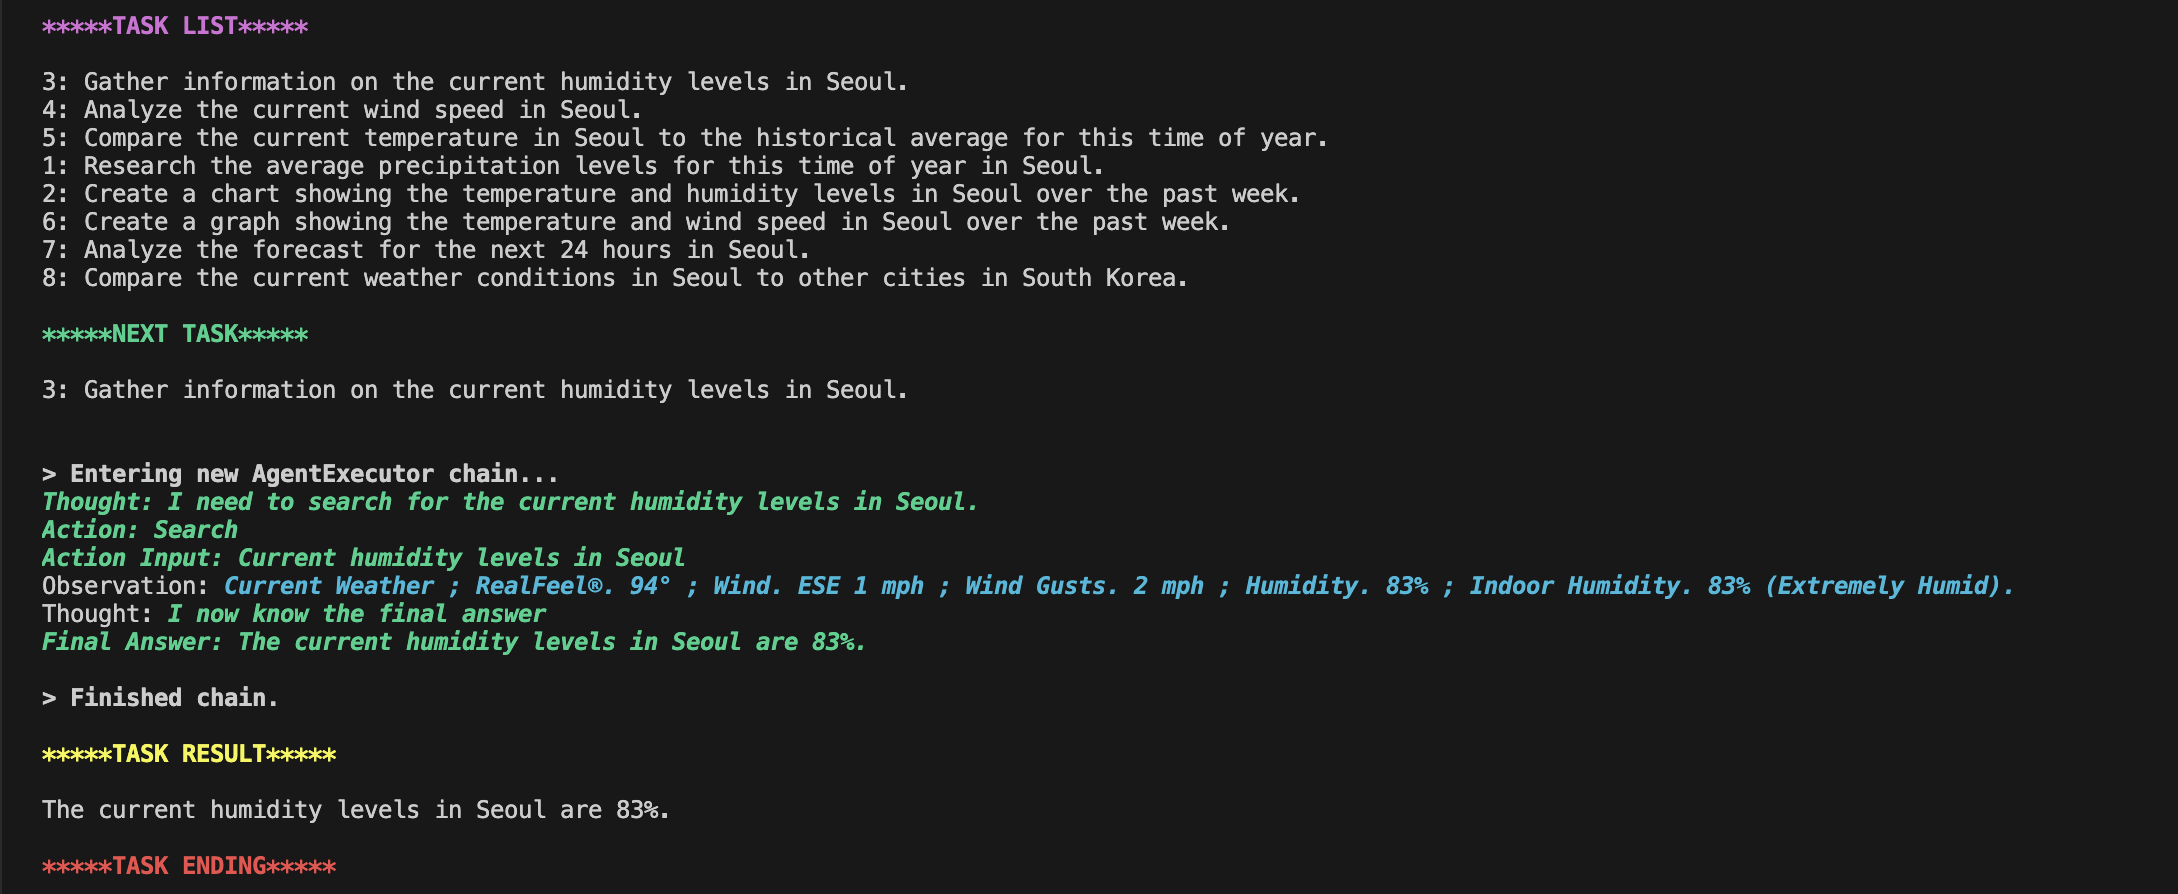
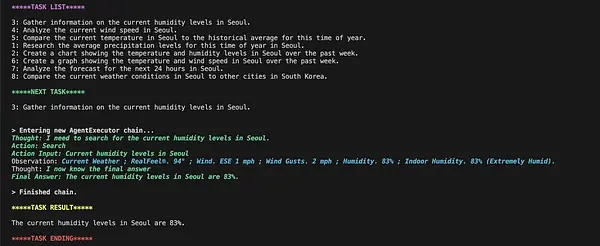
Screenshot 2023-08-21 at 4.35.48 PM.png마지막 태스크로 서울의 현재 습도를 검색한 결곽로 83% 정도의 습도, extremely humid라는 결과값이 나왔습니다.

Screenshot 2023-08-21 at 4.35.59 PM.png

Part 3 마무리

이로써 Part 3가 마무리되었습니다!

SerpAPI에서는 구글 검색 뿐만 아니라 네이버 검색, 구글 지도, 유투브 검색 기능 등 정말 다양한 API를 제공하고 있으니 SerpAPI 사이트에서 documentation을 확인하면서 써보세요 :)

오늘 저희가 만들었던 agent와 같이 비슷한 구조로 만드시면 됩니다.

"Write a weather report for Seoul today”라는 프롬트 대신 “conduct Facebook market analysis”라는 프롬트도 해보면서 코드를 돌려보세요! 생각보다 재미있는 결과값들이 나옵니다. ㅎㅎ

오늘도 긴 글 읽어주셔서 감사합니다. 문제가 생기거나 코드가 잘 이해되지 않는 부분이 있으면 언제든지 포스트에 댓글로 달아주시거나 저한테 커피챗으로 연락주세요.

15
3
Cailyn Yong

Cailyn Yong

[Part 2] 2시간 안에 업무 자동화 AI Agent 만들기: LLM 체인 직접 써보기

Part 1에 이이서 오늘은 Part 2를 올립니다.

Part 1: 전체 프로그램 셋업, OpenAI API 연결, Vector Store 연결

Part 2: 커스텀 LLM 체인 직접 만들고나서 실행하기

Part 3: Agent가 나 대신 실제 구글 검색하는 기능 만들기

LLM 체인 만들기

Part 1에서 기본적인 것들이 연결됐으니 이제 실제 LLM 체인을 만들어볼거에요.

일단 저희가 만들 AI agent가 어떻게 작동되냐면, 먼저 유저가 “페이스북 시장 조사 좀 해줘”라고 하면 이 업무를 하기 위해 해야할 태스크들을 리스트업합니다. 그 다음 태스크별로 실행을 하고 결과값을 생성합니다.

이를 하기 위해서는 3개의 체인이 활용됩니다.

  1. 태스크를 생성하고 리스트에 추가하는 체인

  2. 태스크 중 중요도 높은 태스크부터 처리하게끔 관리하는 체인

  3. 각 태스크를 실제로 실행하는 체인

First LLM Chain

유저 프롬트에 맞게 태스크를 생성하고 리스트에 추가하는 첫번째 체인 코드입니다.

class TaskCreationChain(LLMChain):
    """Chain to generates tasks."""

    @classmethod
    def from_llm(cls, llm: BaseLLM, verbose: bool = True) -> LLMChain:
        """Get the response parser."""
        task_creation_template = (
            "You are a task creation AI that uses the result of an execution agent"
            " to create new tasks with the following objective: {objective},"
            " The last completed task has the result: {result}."
            " This result was based on this task description: {task_description}."
            " These are incomplete tasks: {incomplete_tasks}."
            " Based on the result, create new tasks to be completed"
            " by the AI system that do not overlap with incomplete tasks."
            " Return the tasks as an array."
        )
        prompt = PromptTemplate(
            template=task_creation_template,
            input_variables=[
                "result",
                "task_description",
                "incomplete_tasks",
                "objective",
            ],
        )
        return cls(prompt=prompt, llm=llm, verbose=verbose)

여기서 코드를 일일이 이해할 필요는 없고, 크게 어떻게 작동되는지만 알면 됩니다.

일단 맨 처음에 TaskCreationChain이라는 클래스를 생성했고, 이 클래스를 호출했을때 업무 자동화를 하기 위한 명령 템플릿이 task_creation_template에 작성돼있습니다.

말그대로 LLM 체인에게 이렇게 해라 라고 명시하는 겁니다.

task_creation_template = ( … )에 작성돼있는 텍스트를 보면, “너는 태스크를 생성하는 AI이고 태스크 별로 실행까지 하는 에이전트야. 내가 입력하는 {objective}에 맞게 태스크를 생성하고, 가장 최근에 실행된 태스크의 결과값은 {result}에 저장하고, 태스크에 관한 설명은 {task_description}에 저장될거야. 아직 실행되지 않은 태스크들은 {incomplete_tasks}에 저장해. 결과값을 통해 아직 실행되지 않은 태스크들을 실행하고 결과값들은 배열 형태로 정리해줘”라고 써져 있습니다.

이런 프롬트 템플릿은 제가 원하는대로 언제든지 바꿀 수 있습니다. 직접 코드로 개발을 하지 않아도 정말 텍스트로 AI에게 명령하는거죠.

다음 코드 줄에서는 이 task_creation_template을 prompt라는 곳에 저장하고, 인풋은 “result”, “task_description”, “incomplete_tasks”, “objective”이라는 것을 확인할 수 있습니다.

코드를 복붙하고 나면 이렇게 생겼습니다.
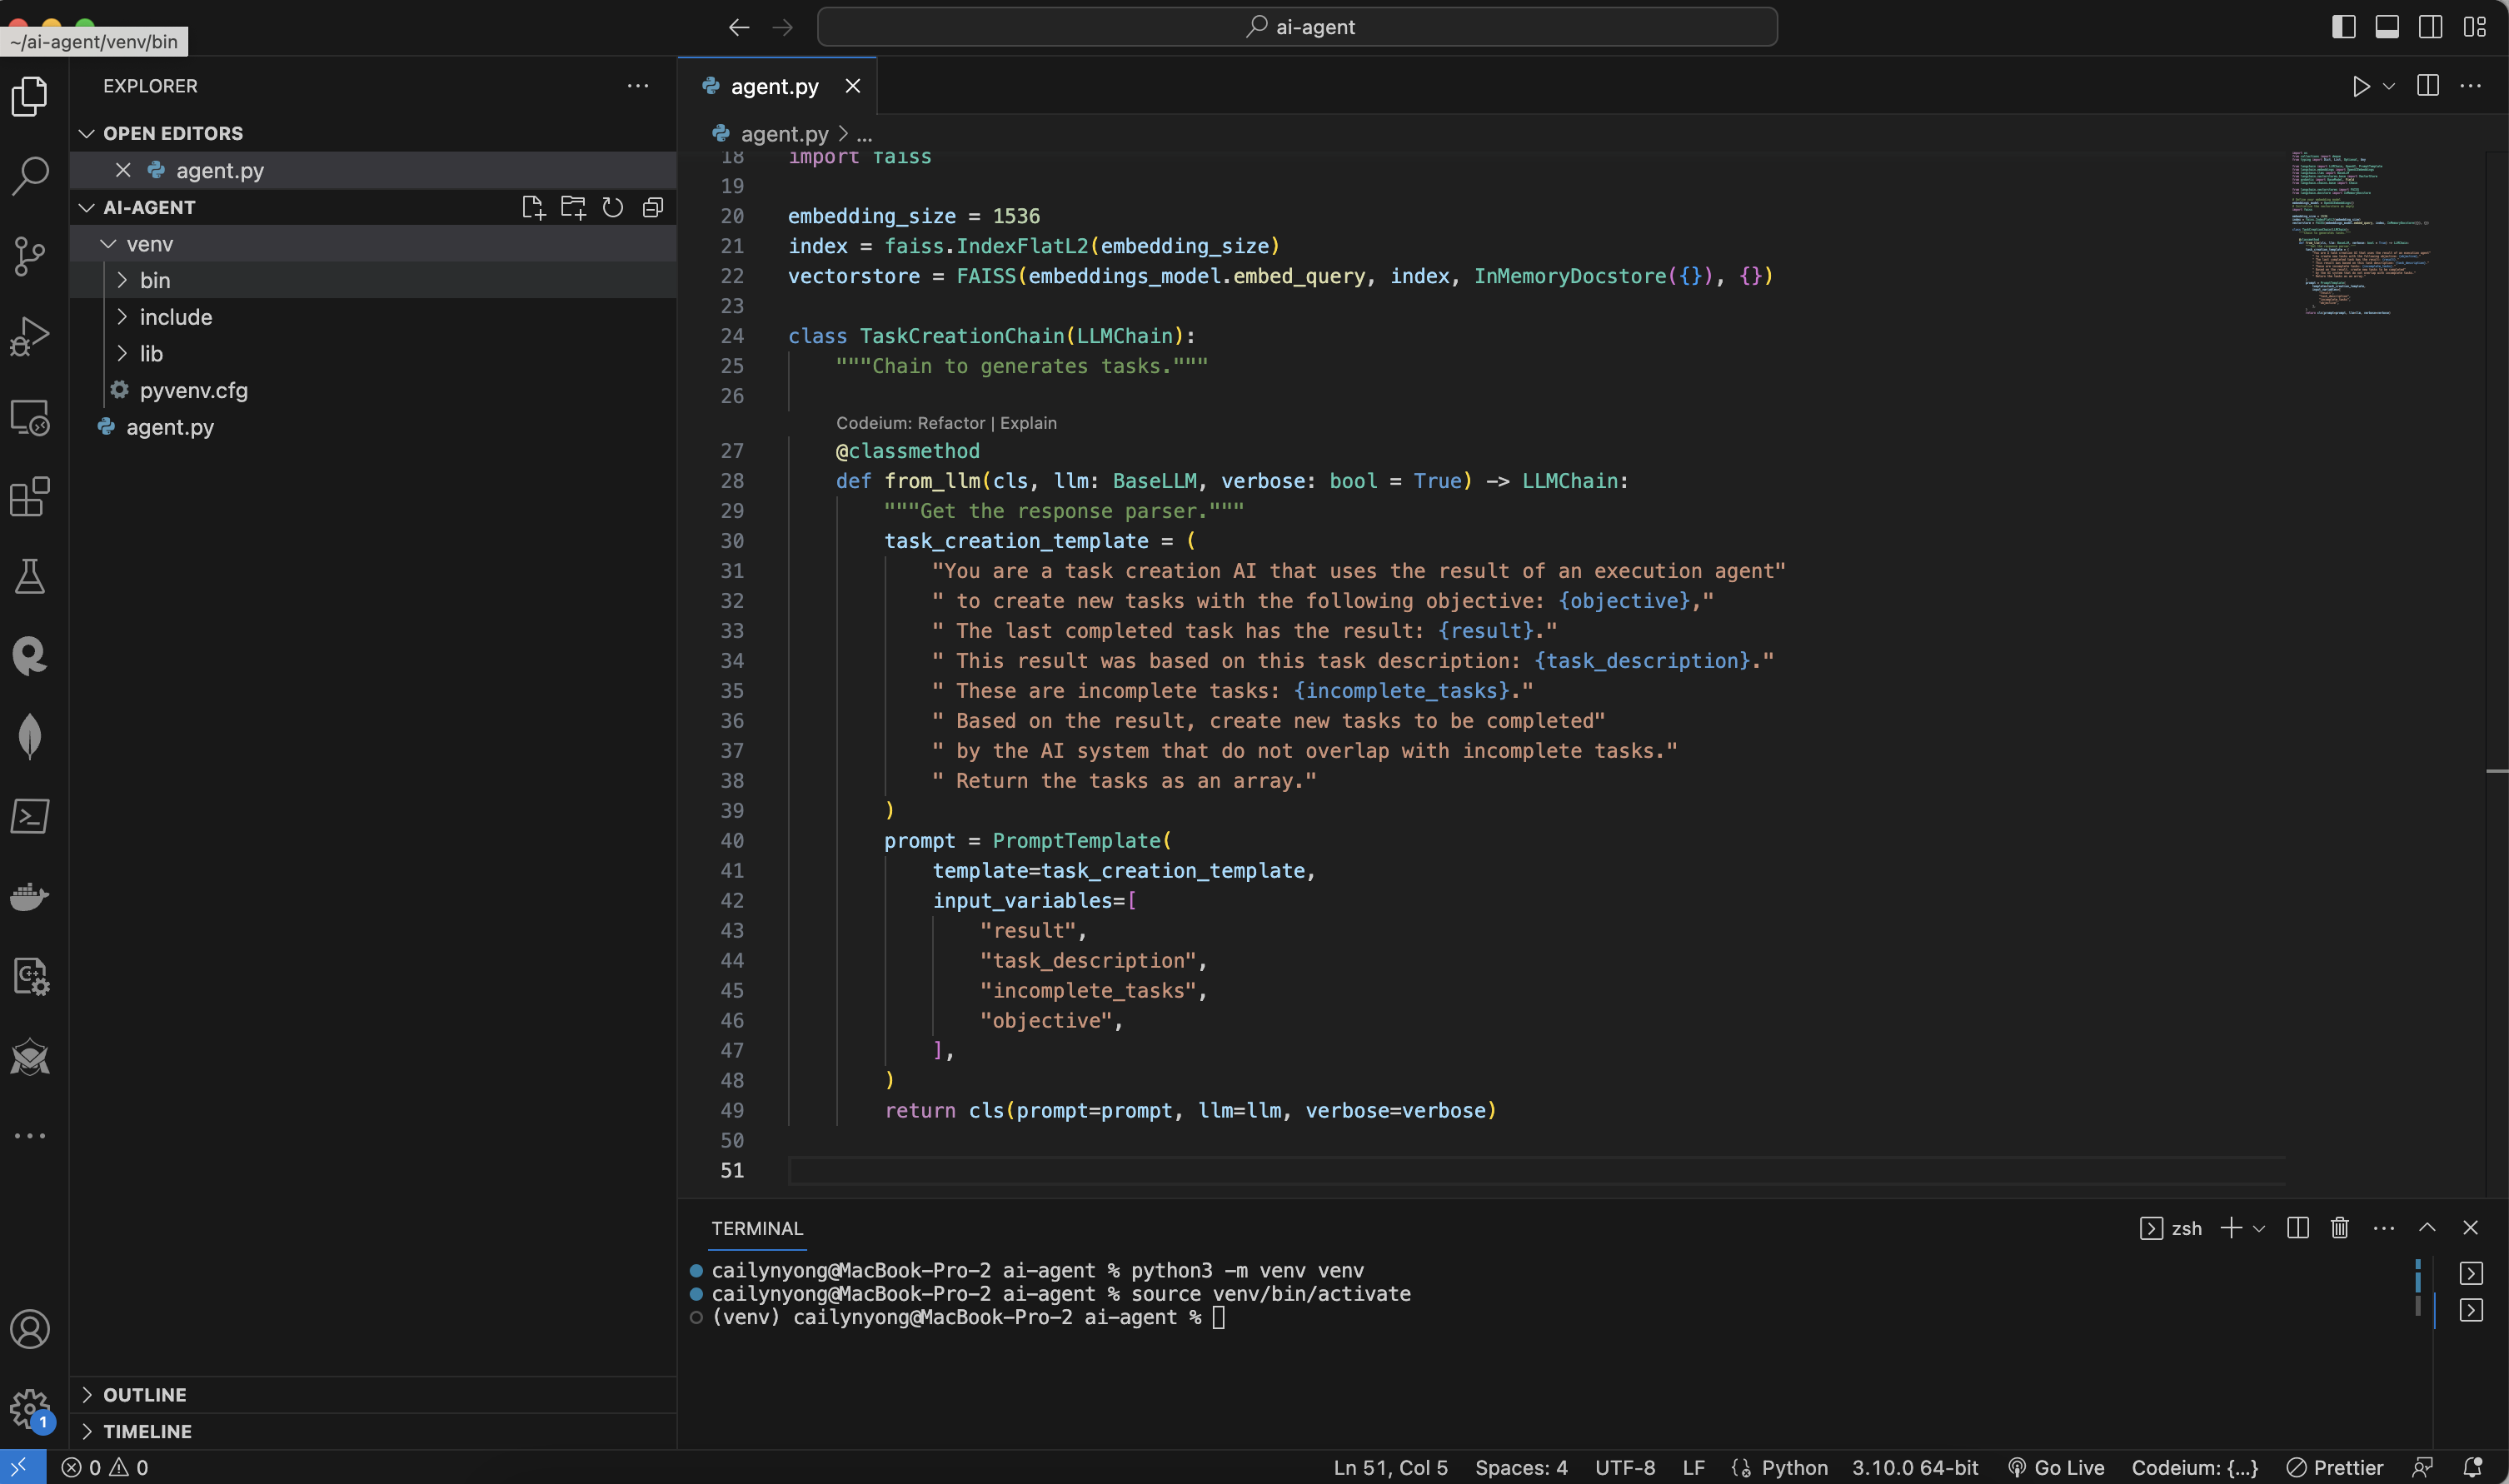
Screenshot 2023-08-16 at 5.37.29 PM.pngSecond LLM Chain

다음은 태스크 중 중요도 높은 태스크들을 먼저 실행하게끔 관리하는 두번째 체인 코드입니다.

class TaskPrioritizationChain(LLMChain):
    """Chain to prioritize tasks."""

    @classmethod
    def from_llm(cls, llm: BaseLLM, verbose: bool = True) -> LLMChain:
        """Get the response parser."""
        task_prioritization_template = (
            "You are a task prioritization AI tasked with cleaning the formatting of and reprioritizing"
            " the following tasks: {task_names}."
            " Consider the ultimate objective of your team: {objective}."
            " Do not remove any tasks. Return the result as a numbered list, like:"
            " #. First task"
            " #. Second task"
            " Start the task list with number {next_task_id}."
        )
        prompt = PromptTemplate(
            template=task_prioritization_template,
            input_variables=["task_names", "next_task_id", "objective"],
        )
        return cls(prompt=prompt, llm=llm, verbose=verbose)

첫번째 체인과 아주 비슷한 형식이죠?

이번에 task_prioritization_template에는 “너는 {task_names} 태스크들 중에서 중요도 높은 태스크부터 실행되도록 순번을 관리하는 AI야. 최종 {objective} 목표를 염두하면서 순번 관리를 해줘. 태스크들 중 어떤것도 지우지 말고 결과값은 리스트 형태로 보여줘: “#. 첫번째 태스크, #. 두번째 태스크”. 태스크 리스트는 태스크 숫자 아이디로 {next_task_id} 시작해줘.” 라고 써져 있습니다.

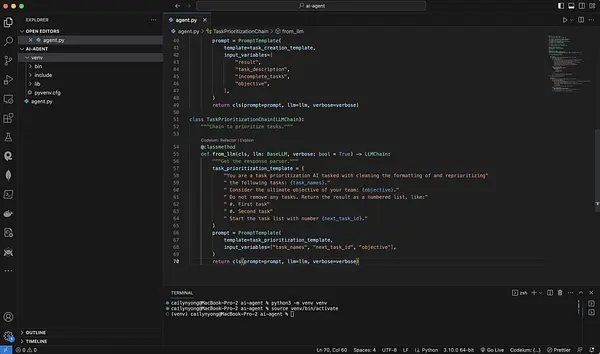
첫번째 체인 코드 밑에 또 복붙하세요.
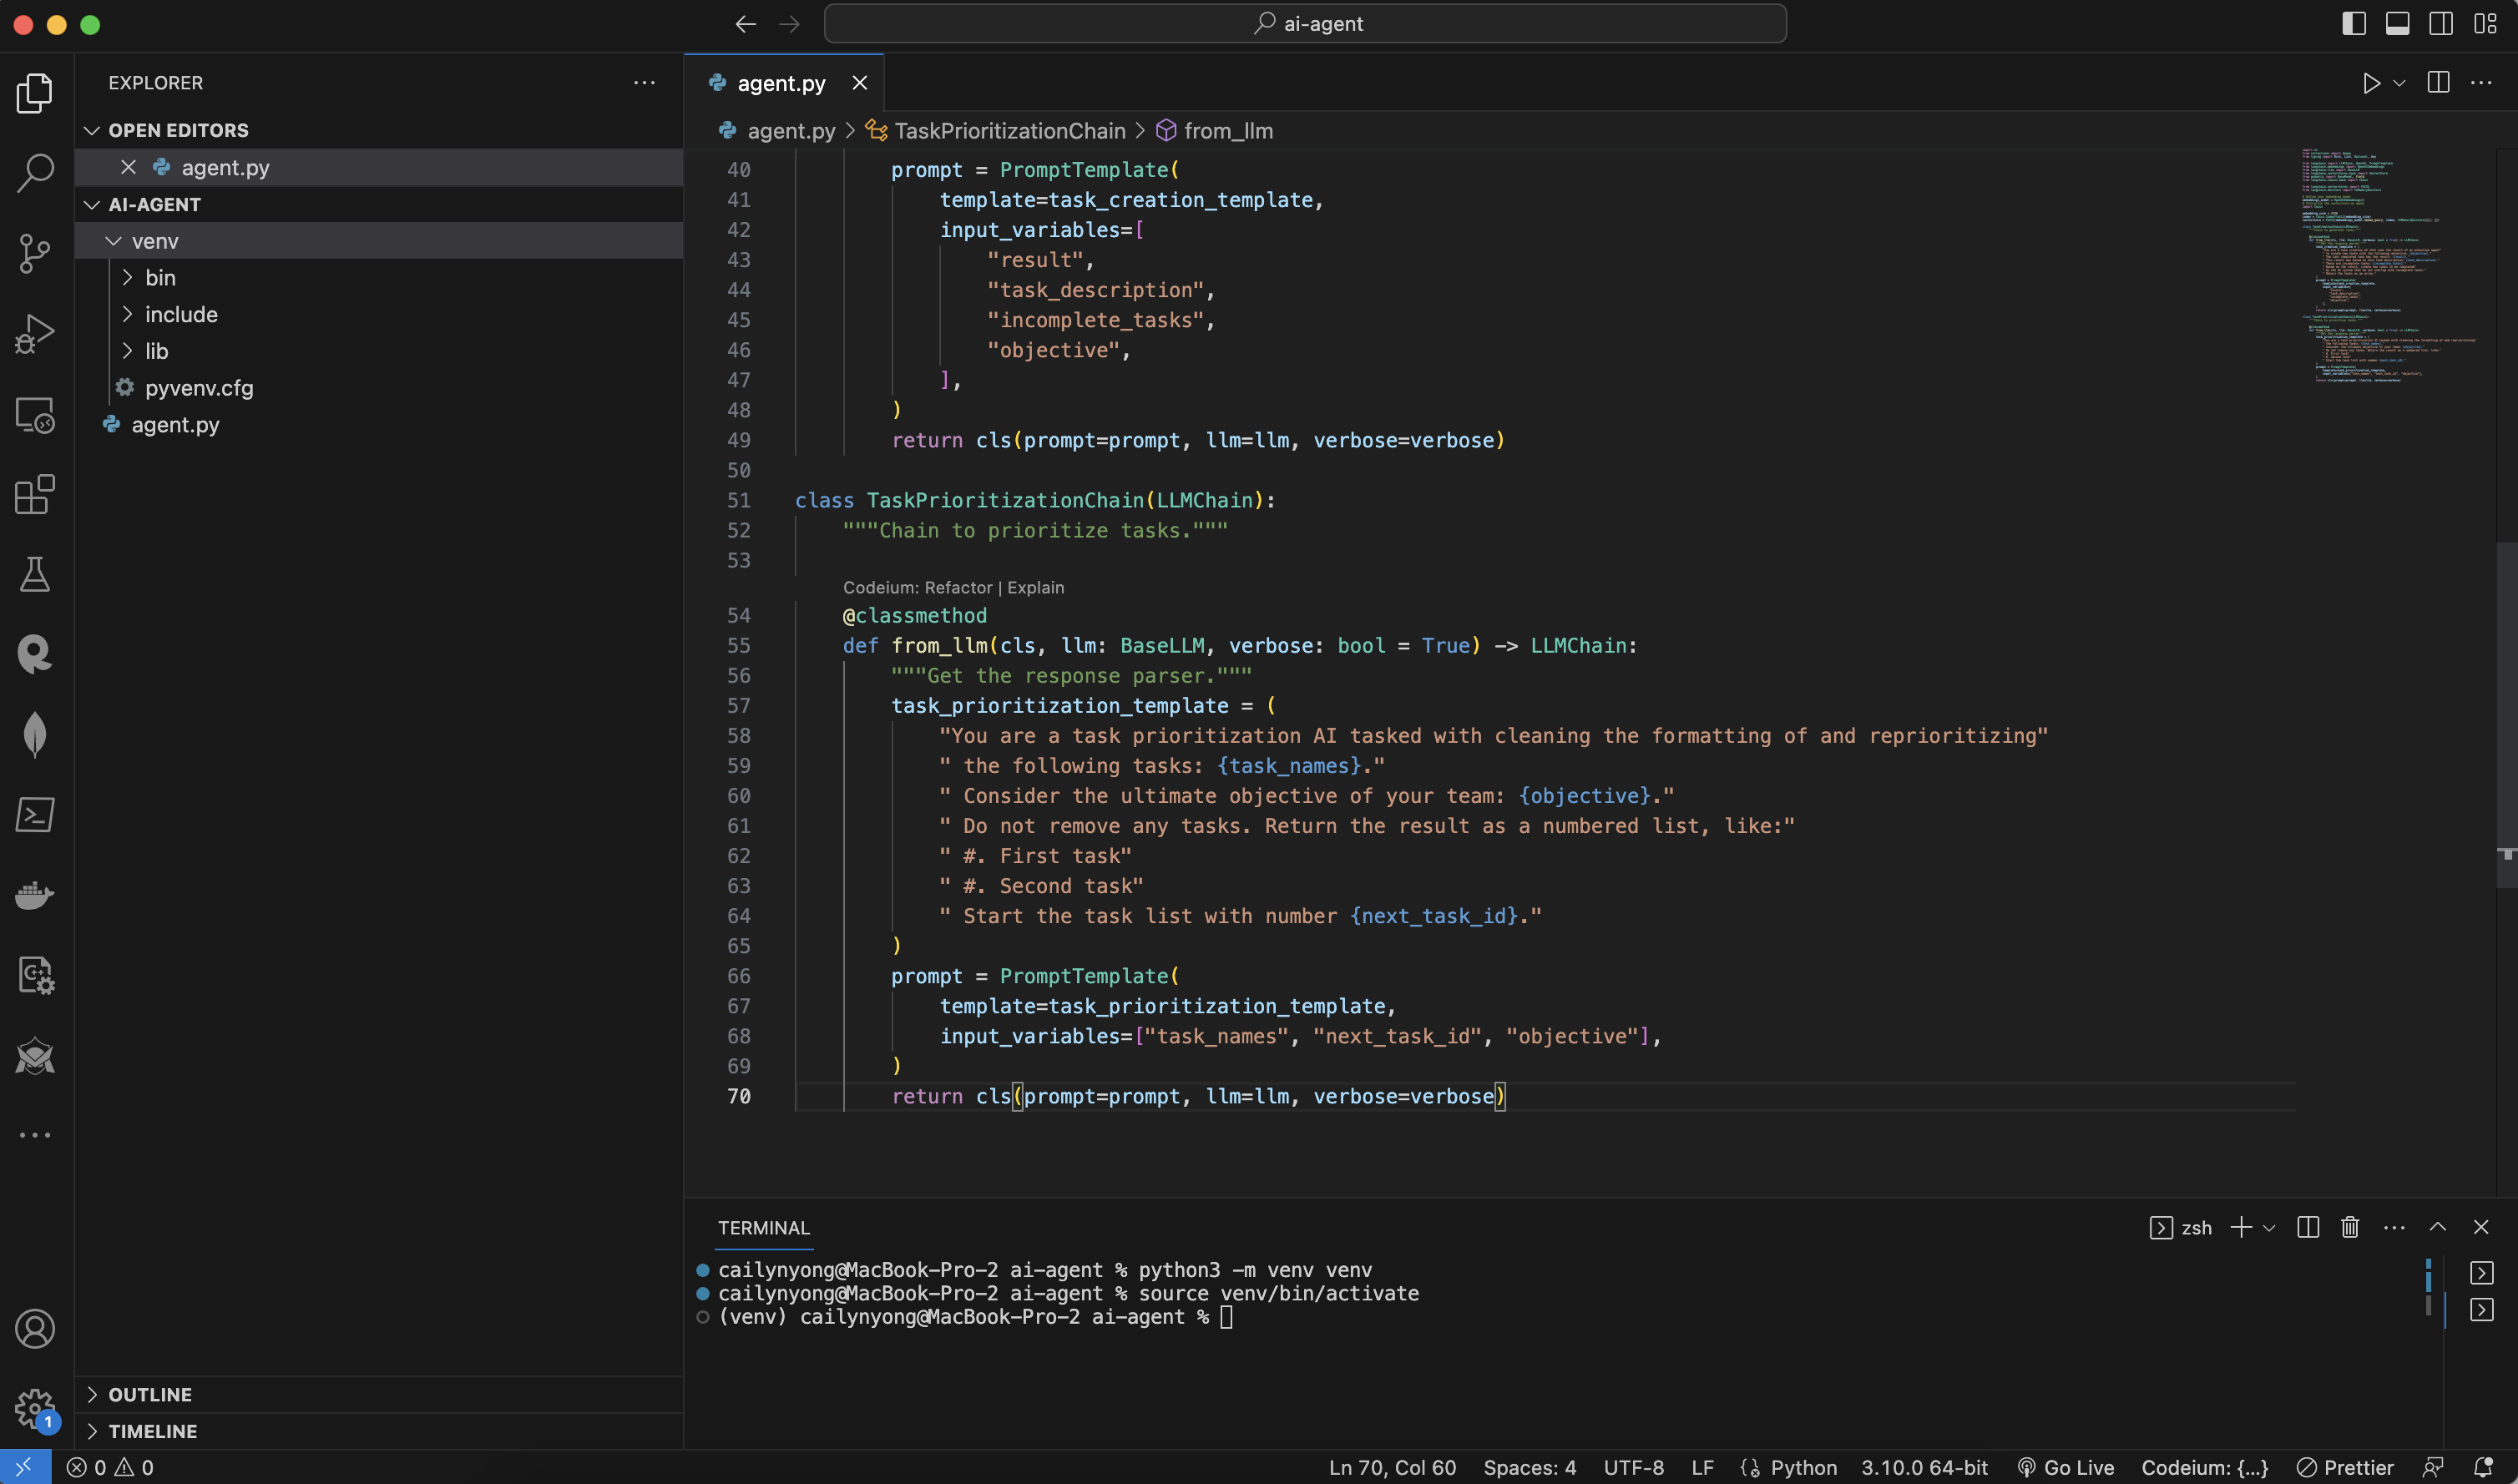
Screenshot 2023-08-16 at 5.45.40 PM.pngThird LLM Chain

이제 마지막 체인, 실제 태스크를 실행하게끔 하는 체인 코드입니다.

class ExecutionChain(LLMChain):
    """Chain to execute tasks."""

    @classmethod
    def from_llm(cls, llm: BaseLLM, verbose: bool = True) -> LLMChain:
        """Get the response parser."""
        execution_template = (
            "You are an AI who performs one task based on the following objective: {objective}."
            " Take into account these previously completed tasks: {context}."
            " Your task: {task}."
            " Response:"
        )
        prompt = PromptTemplate(
            template=execution_template,
            input_variables=["objective", "context", "task"],
        )
        return cls(prompt=prompt, llm=llm, verbose=verbose)

여기서 템플릿에는 “너는 큰 목표 {objective}에 맞게 한 개의 태스크를 실행하는 AI야. 전에 실행 완료된 태스크들의 {context}를 생각하면서 태스크를 실행하도록 해. 너의 태스크: {task}.”라고 써져있습니다.

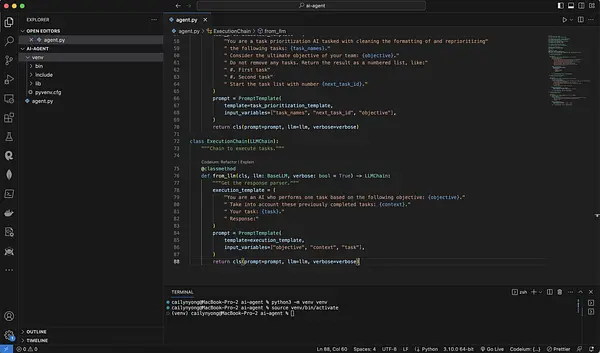
마찬가지로 코드를 두번째 체인 코드 밑에 복붙하세요.
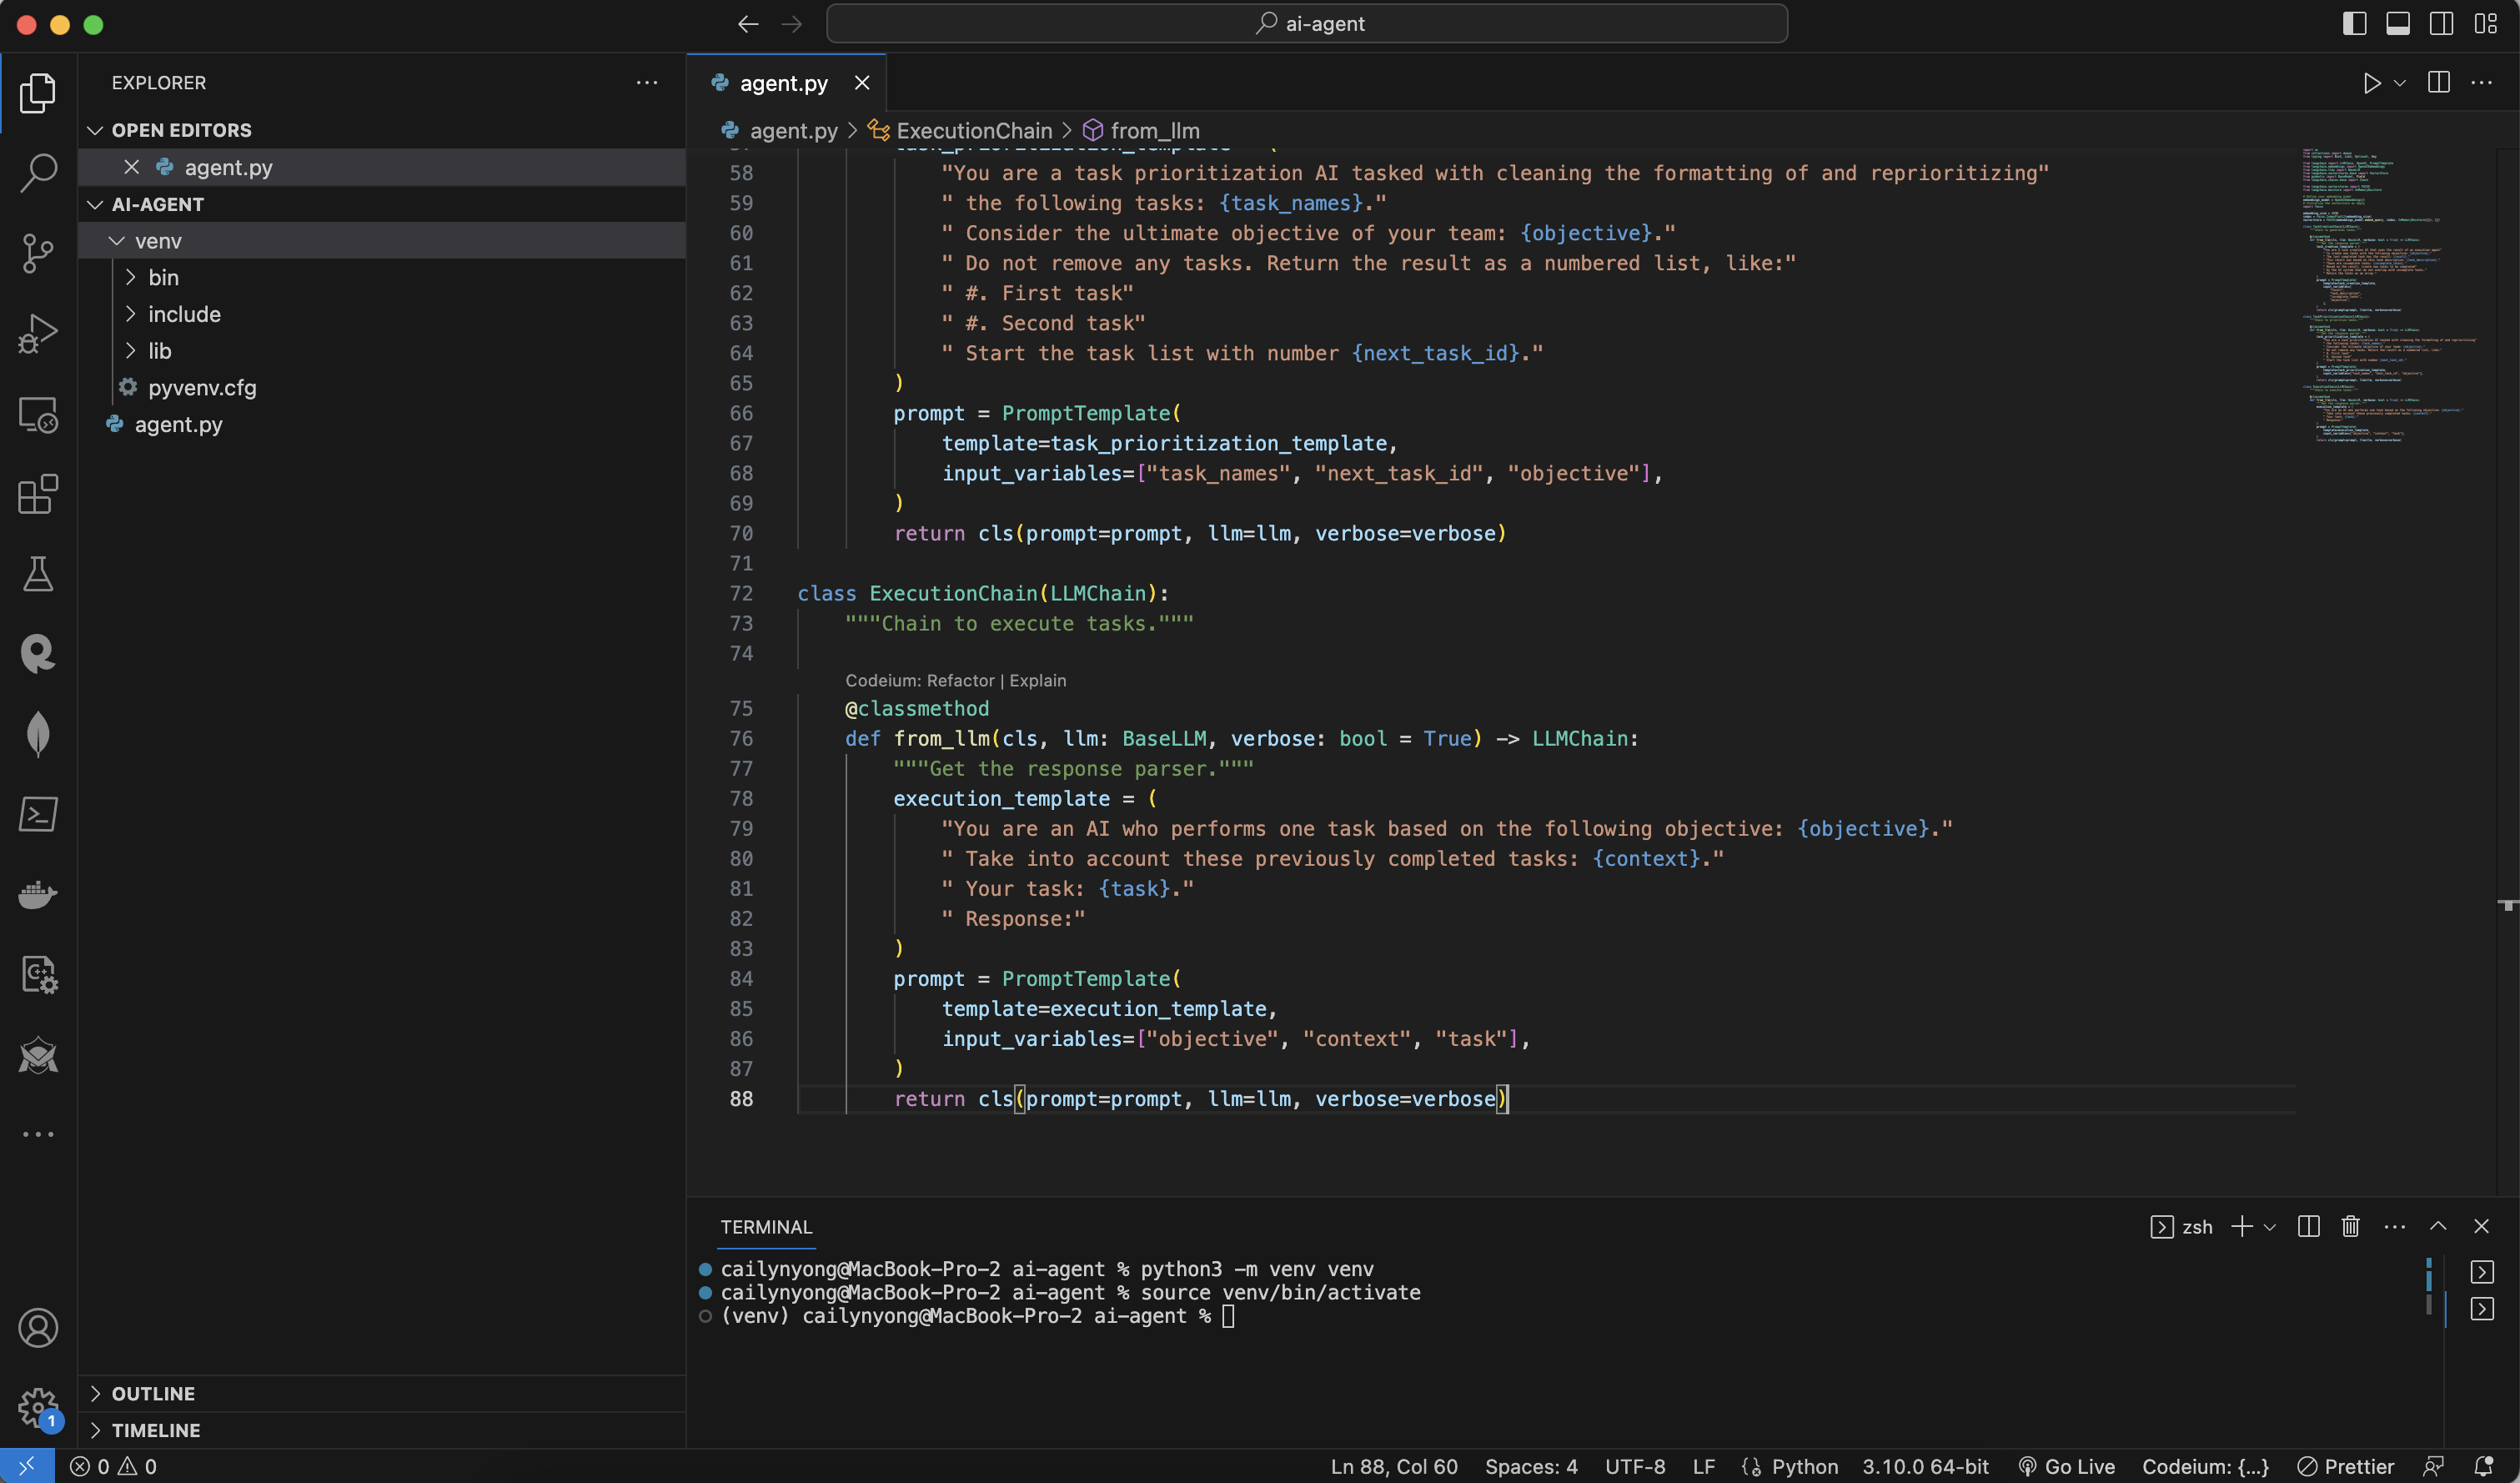
Screenshot 2023-08-16 at 5.48.17 PM.pngBabyAGI Controller

이제 BabyAGI 컨트롤러를 만들 차례입니다. 위에서 만든 세 개의 체인들을 활용해서 유저가 인풋을 주면 그 인풋에 맞게 자동으로 태스크들을 생성하고 처리하게끔 만들어야 합니다.

def get_next_task(
    task_creation_chain: LLMChain,
    result: Dict,
    task_description: str,
    task_list: List[str],
    objective: str,
) -> List[Dict]:
    """Get the next task."""
    incomplete_tasks = ", ".join(task_list)
    response = task_creation_chain.run(
        result=result,
        task_description=task_description,
        incomplete_tasks=incomplete_tasks,
        objective=objective,
    )
    new_tasks = response.split("\\n")
    return [{"task_name": task_name} for task_name in new_tasks if task_name.strip()]

위 코드는 1) 처음에 에이전트가 해야할 태스크 리스트업을 했을때 첫 태스크를 완료하고 난 뒤 아직 실행되지 않은 다음 태스크를 불러오고, 2) 나머지 미완료 태스크들을 다시 생성 + 리스트업하기 위해 첫번째 태스크 생성 체인을 불러오는 코드입니다.

def prioritize_tasks(
    task_prioritization_chain: LLMChain,
    this_task_id: int,
    task_list: List[Dict],
    objective: str,
) -> List[Dict]:
    """Prioritize tasks."""
    task_names = [t["task_name"] for t in task_list]
    next_task_id = int(this_task_id) + 1
    response = task_prioritization_chain.run(
        task_names=task_names, next_task_id=next_task_id, objective=objective
    )
    new_tasks = response.split("\\n")
    prioritized_task_list = []
    for task_string in new_tasks:
        if not task_string.strip():
            continue
        task_parts = task_string.strip().split(".", 1)
        if len(task_parts) == 2:
            task_id = task_parts[0].strip()
            task_name = task_parts[1].strip()
            prioritized_task_list.append({"task_id": task_id, "task_name": task_name})
    return prioritized_task_list

위 코드는 저희가 만든 두번째 태스크 순번 관리 체인을 실행하기 위한 코드입니다.

def _get_top_tasks(vectorstore, query: str, k: int) -> List[str]:
    """Get the top k tasks based on the query."""
    results = vectorstore.similarity_search_with_score(query, k=k)
    if not results:
        return []
    sorted_results, _ = zip(*sorted(results, key=lambda x: x[1], reverse=True))
    return [str(item.metadata["task"]) for item in sorted_results]

def execute_task(
    vectorstore, execution_chain: LLMChain, objective: str, task: str, k: int = 5
) -> str:
    """Execute a task."""
    context = _get_top_tasks(vectorstore, query=objective, k=k)
    return execution_chain.run(objective=objective, context=context, task=task)

마지막으로 _get_top_tasks는 가장 첫번째 순서인 태스크를 불러오는 거고, execute_task는 저희가 세번째로 만든 태스크 실행하는 체인을 불러와서 첫번째 순서 태스크부터 실행하게끔 하는 코드입니다.

이 모든 코드를 순서대로 복붙하세요. 그럼 아래 이미지처럼 생겼습니다.
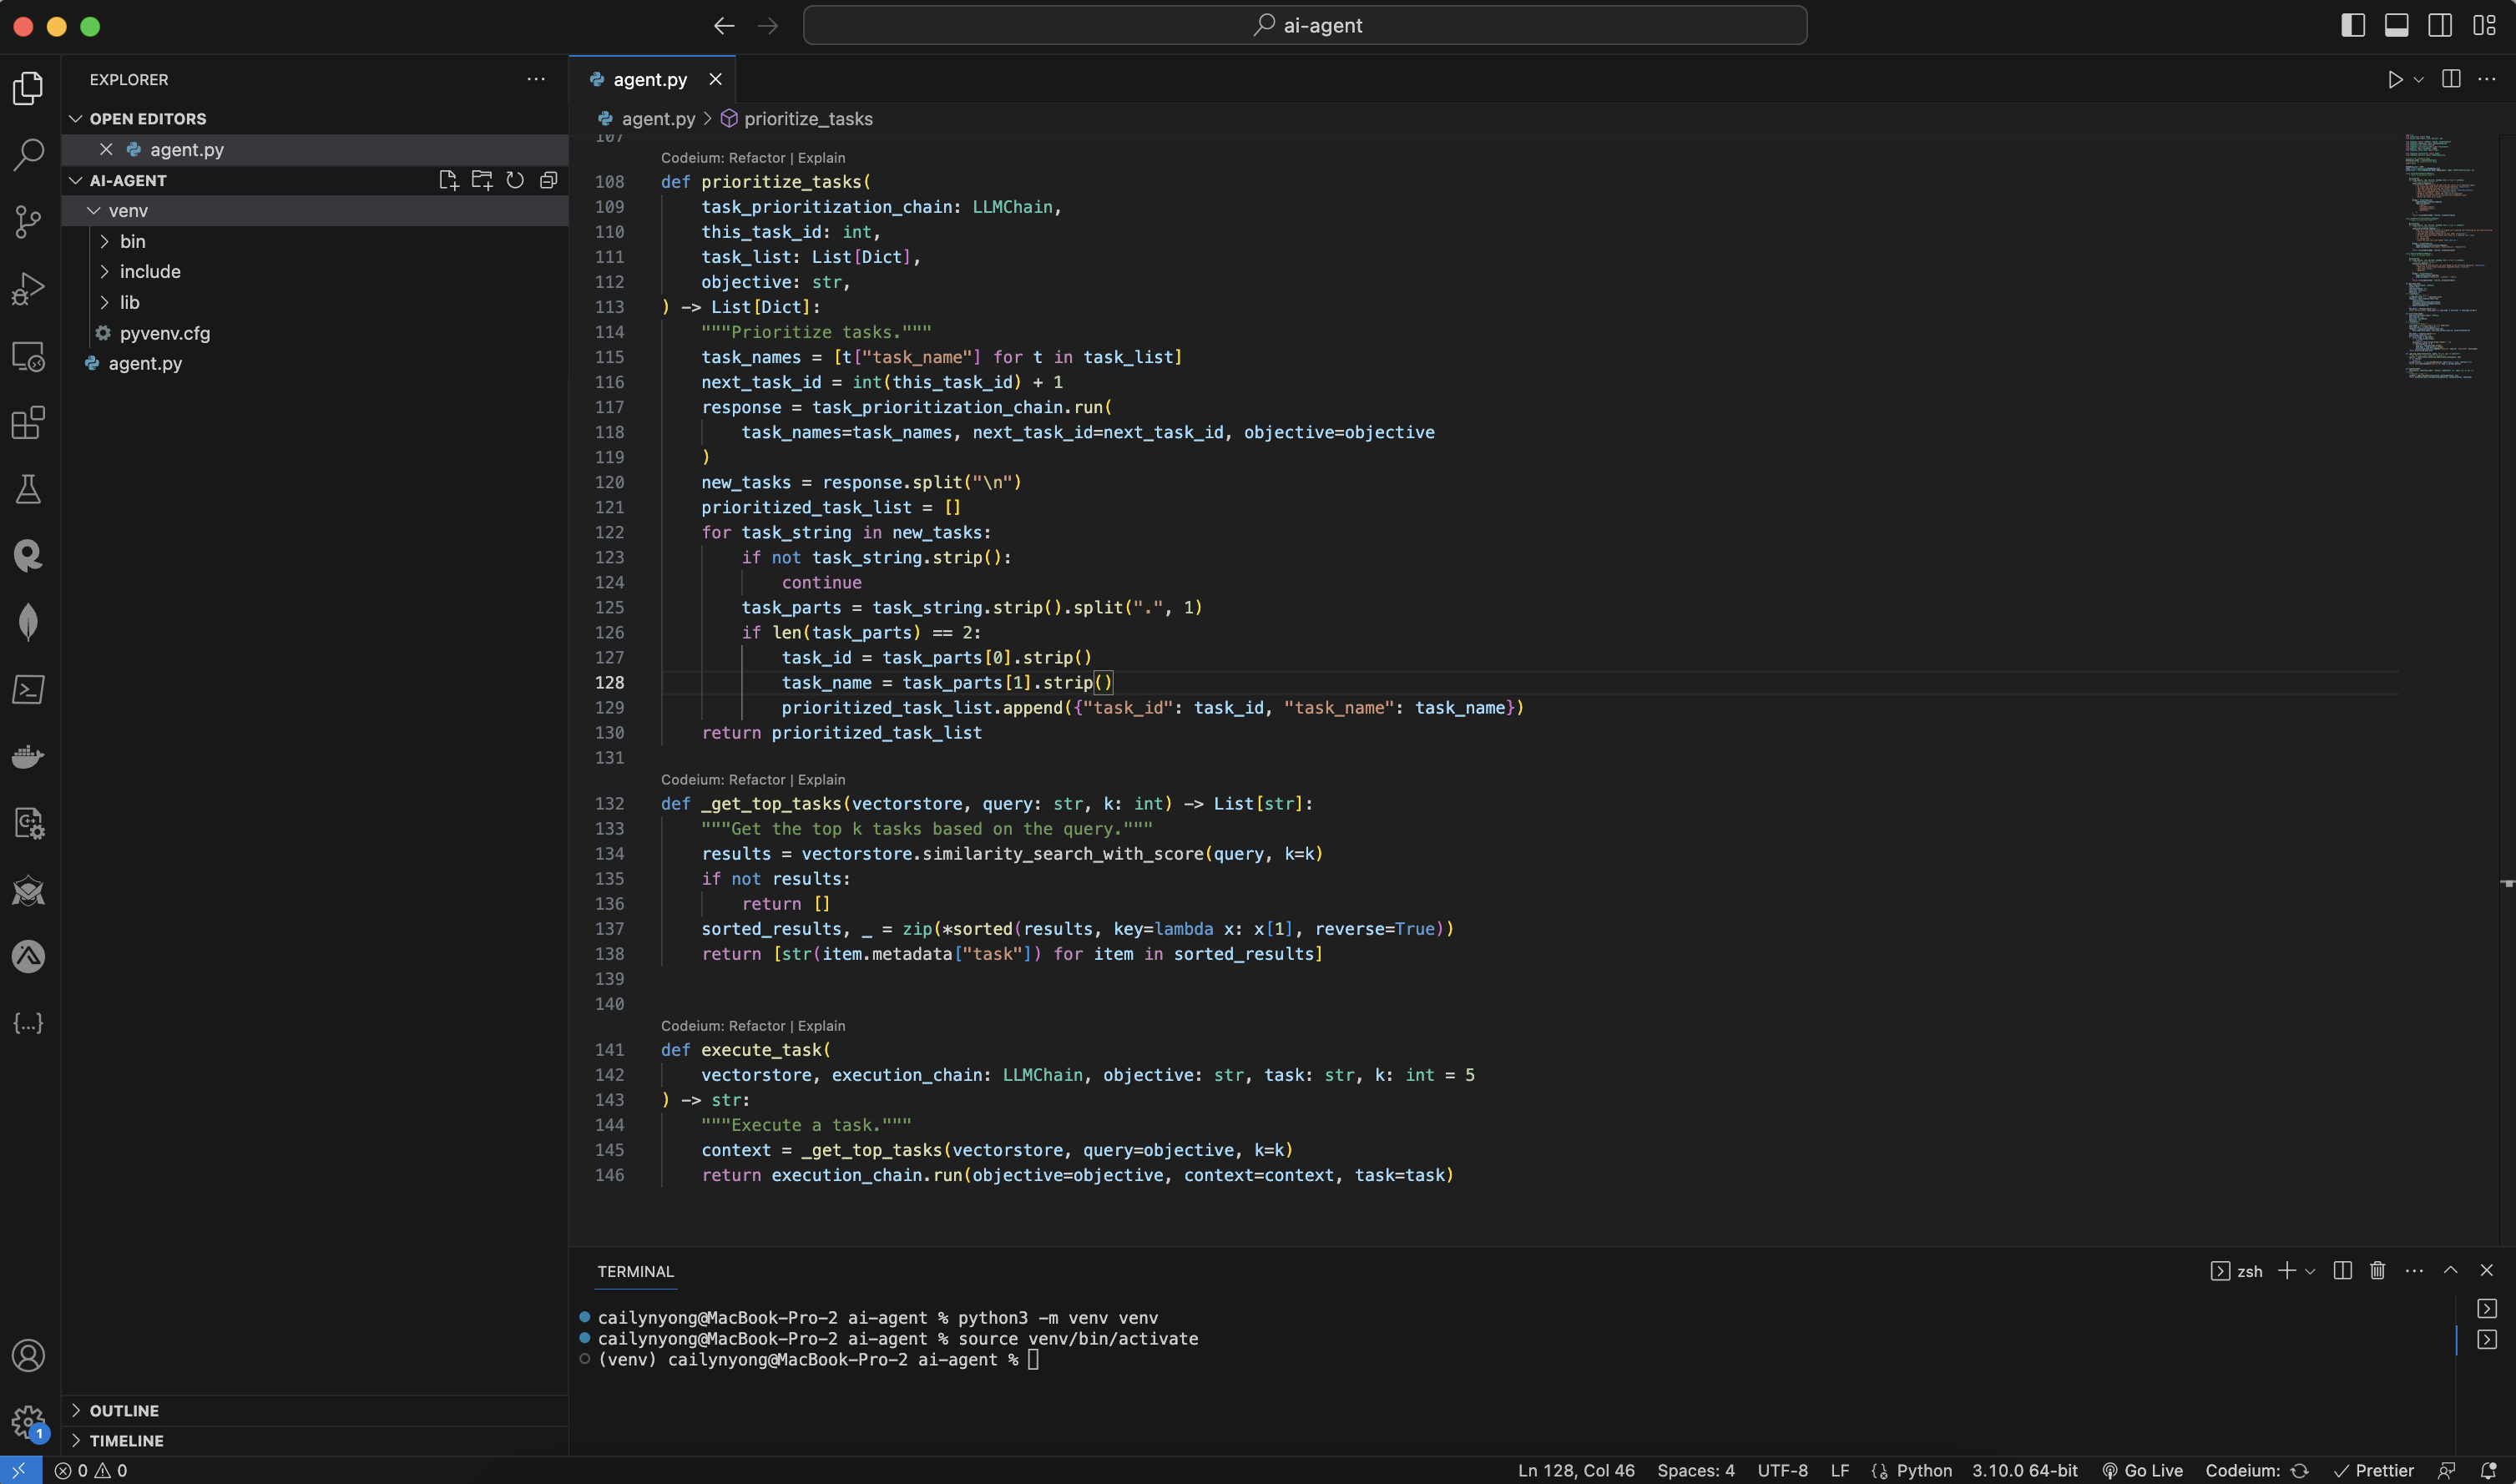
Screenshot 2023-08-16 at 6.01.24 PM.png이제 정말 거의 다왔습니다.

여태까지 만든 모든 코드 블록들을 저희 AI Agent가 적절하게 쓸 수 있도록 짜집기 해줄거에요.

여기서 class BabyAGI 코드 블록이 실질적으로 AI Agent의 역할을 한다고 생각하시면 됩니다.

class BabyAGI(Chain, BaseModel):
    """Controller model for the BabyAGI agent."""

    task_list: deque = Field(default_factory=deque)
    task_creation_chain: TaskCreationChain = Field(...)
    task_prioritization_chain: TaskPrioritizationChain = Field(...)
    execution_chain: ExecutionChain = Field(...)
    task_id_counter: int = Field(1)
    vectorstore: VectorStore = Field(init=False)
    max_iterations: Optional[int] = None

    class Config:
        """Configuration for this pydantic object."""

        arbitrary_types_allowed = True

    def add_task(self, task: Dict):
        self.task_list.append(task)

    def print_task_list(self):
        print("\033[95m\033[1m" + "\n*****TASK LIST*****\n" + "\033[0m\033[0m")
        for t in self.task_list:
            print(str(t["task_id"]) + ": " + t["task_name"])

    def print_next_task(self, task: Dict):
        print("\033[92m\033[1m" + "\n*****NEXT TASK*****\n" + "\033[0m\033[0m")
        print(str(task["task_id"]) + ": " + task["task_name"])

    def print_task_result(self, result: str):
        print("\033[93m\033[1m" + "\n*****TASK RESULT*****\n" + "\033[0m\033[0m")
        print(result)

    @property
    def input_keys(self) -> List[str]:
        return ["objective"]

    @property
    def output_keys(self) -> List[str]:
        return []

    def _call(self, inputs: Dict[str, Any]) -> Dict[str, Any]:
        """Run the agent."""
        objective = inputs["objective"]
        first_task = inputs.get("first_task", "Make a todo list")
        self.add_task({"task_id": 1, "task_name": first_task})
        num_iters = 0
        while True:
            if self.task_list:
                self.print_task_list()

                # Step 1: Pull the first task
                task = self.task_list.popleft()
                self.print_next_task(task)

                # Step 2: Execute the task
                result = execute_task(
                    self.vectorstore, self.execution_chain, objective, task["task_name"]
                )
                this_task_id = int(task["task_id"])
                self.print_task_result(result)

                # Step 3: Store the result in Pinecone
                result_id = f"result_{task['task_id']}_{num_iters}"
                self.vectorstore.add_texts(
                    texts=[result],
                    metadatas=[{"task": task["task_name"]}],
                    ids=[result_id],
                )

                # Step 4: Create new tasks and reprioritize task list
                new_tasks = get_next_task(
                    self.task_creation_chain,
                    result,
                    task["task_name"],
                    [t["task_name"] for t in self.task_list],
                    objective,
                )
                for new_task in new_tasks:
                    self.task_id_counter += 1
                    new_task.update({"task_id": self.task_id_counter})
                    self.add_task(new_task)
                self.task_list = deque(
                    prioritize_tasks(
                        self.task_prioritization_chain,
                        this_task_id,
                        list(self.task_list),
                        objective,
                    )
                )
            num_iters += 1
            if self.max_iterations is not None and num_iters == self.max_iterations:
                print(
                    "\033[91m\033[1m" + "\n*****TASK ENDING*****\n" + "\033[0m\033[0m"
                )
                break
        return {}

    @classmethod
    def from_llm(
        cls, llm: BaseLLM, vectorstore: VectorStore, verbose: bool = False, **kwargs
    ) -> "BabyAGI":
        """Initialize the BabyAGI Controller."""
        task_creation_chain = TaskCreationChain.from_llm(llm, verbose=verbose)
        task_prioritization_chain = TaskPrioritizationChain.from_llm(
            llm, verbose=verbose
        )
        execution_chain = ExecutionChain.from_llm(llm, verbose=verbose)
        return cls(
            task_creation_chain=task_creation_chain,
            task_prioritization_chain=task_prioritization_chain,
            execution_chain=execution_chain,
            vectorstore=vectorstore,
            **kwargs,
        )

이 코드는 굉장히 긴데 겁먹을 필요 없구요, 그저 단계별로 결과값이 어떻게 프린트될지 예쁘게 formatting해주는 코드입니다. 코드를 자세히 보시면 Step 1, Step 2, Step 3, Step 4가 있습니다.

  • Step 1: 첫번째 태스크 불러오기

  • Step 2: 태스크 실행하기 (저희가 만들었던 세번째 체인, 태스크 실행하는 체인이 여기서 쓰입니다)

  • Step 3: 결과값을 Vector Store에 저장하기 (처음에 만들었던 vector store 기억하시죠? 여기에 저장되는 겁니다)

  • Step 4: 새로운 태스크들을 생성하고 중요도 높은 순으로 순번 관리하기 (저희가 만든 첫번째 체인 (태스크 생성 체인)과 두번째 체인 (순번 관리 체인)이 여기서 쓰입니다)

코드를 그대로 복붙하면 아래 이미지처럼 생겼습니다.
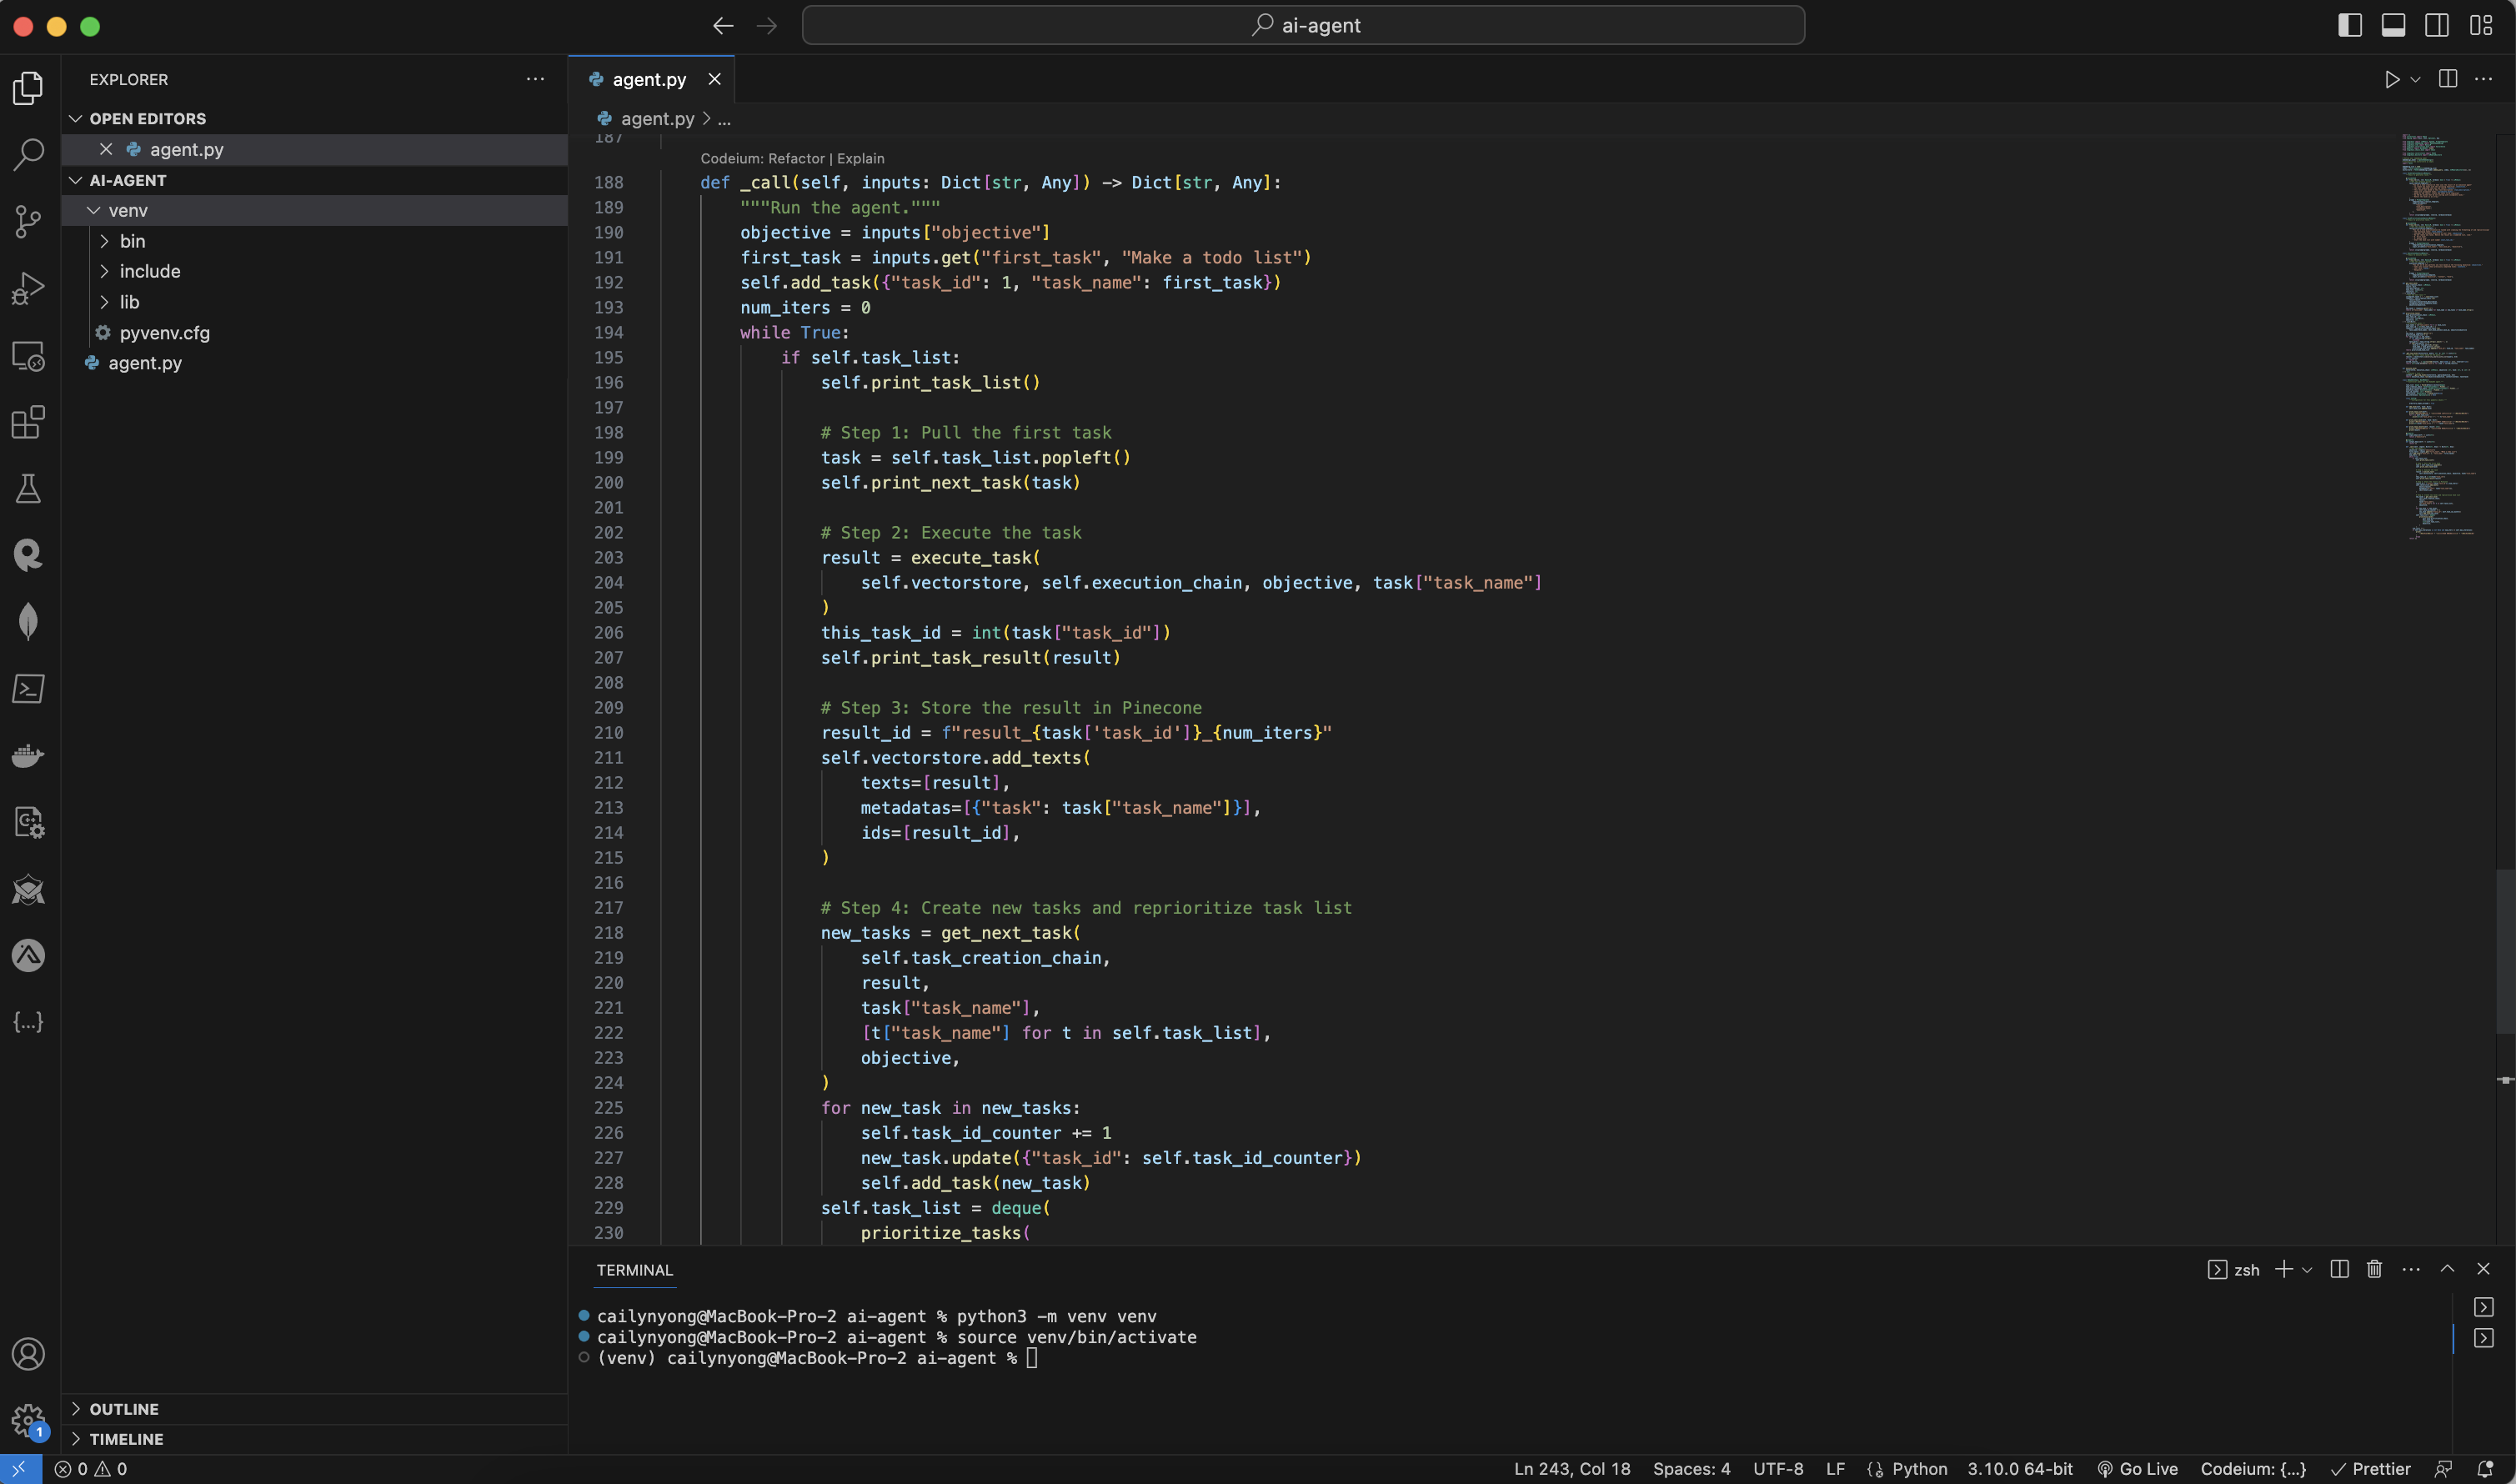
Screenshot 2023-08-16 at 6.09.05 PM.png테스트해보기!!

OBJECTIVE = "Write a weather report for Seoul today"

llm = OpenAI(temperature=0)

# Logging of LLMChains
verbose = False
# If None, will keep on going forever
max_iterations: Optional[int] = 3
baby_agi = BabyAGI.from_llm(
    llm=llm, vectorstore=vectorstore, verbose=verbose, max_iterations=max_iterations
)

baby_agi({"objective": OBJECTIVE})

마지막으로 위 코드를 복붙합니다. OBJECTIVE는 유저 인풋입니다. AI Agent에게 어떤 업무를 시키고 싶은지에 따라 텍스트로 작성하면 됩니다.

저는 “서울의 날씨 리포트를 작성해줘”라는 인풋을 주었습니다.

여기서 max_iterations는 몇번의 루프를 돌건지 제한을 두는 것입니다. 지금은 3번의 루프만 돌게끔 해놨고, 만약 지정을 하지 않는다면 무한대로 루프가 돌아갈 것입니다.

복붙했다면 터미널에 python agent.py 명령어를 실행합니다. 이제 AI Agent가 자동으로 일을 하기 시작할겁니다!!

첫번째 태스크인 "todo list 만들기"를 실행한 결과입니다. 제가 "서울의 날씨 리포트를 써줘"라고 해서 이 업무를 하기 위해 만든 태스크 리스트입니다. 리포트를 작성하기 위해 1. 현재 서울의 온도, 2. 오늘 날씨 변화, 3. 습도, 4. 바람 속도와 방향, 5. UV index, 6. 미세먼지 인덱스 등을 리스트업 했습니다.
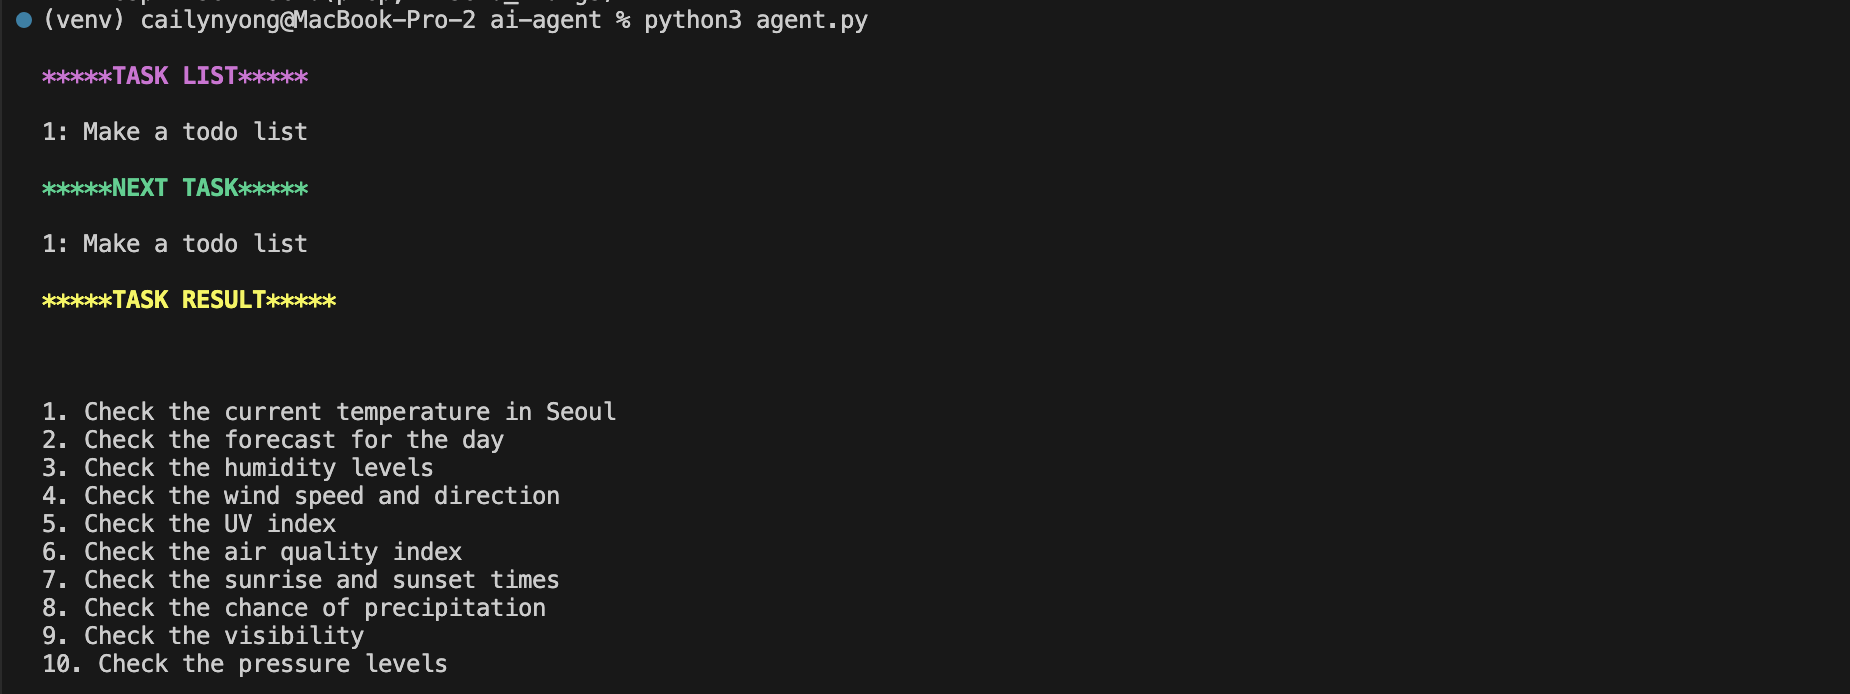
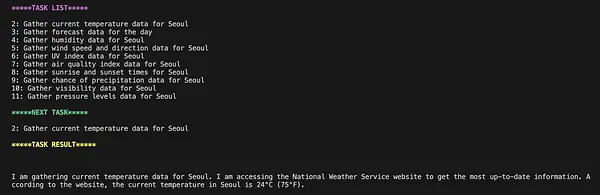
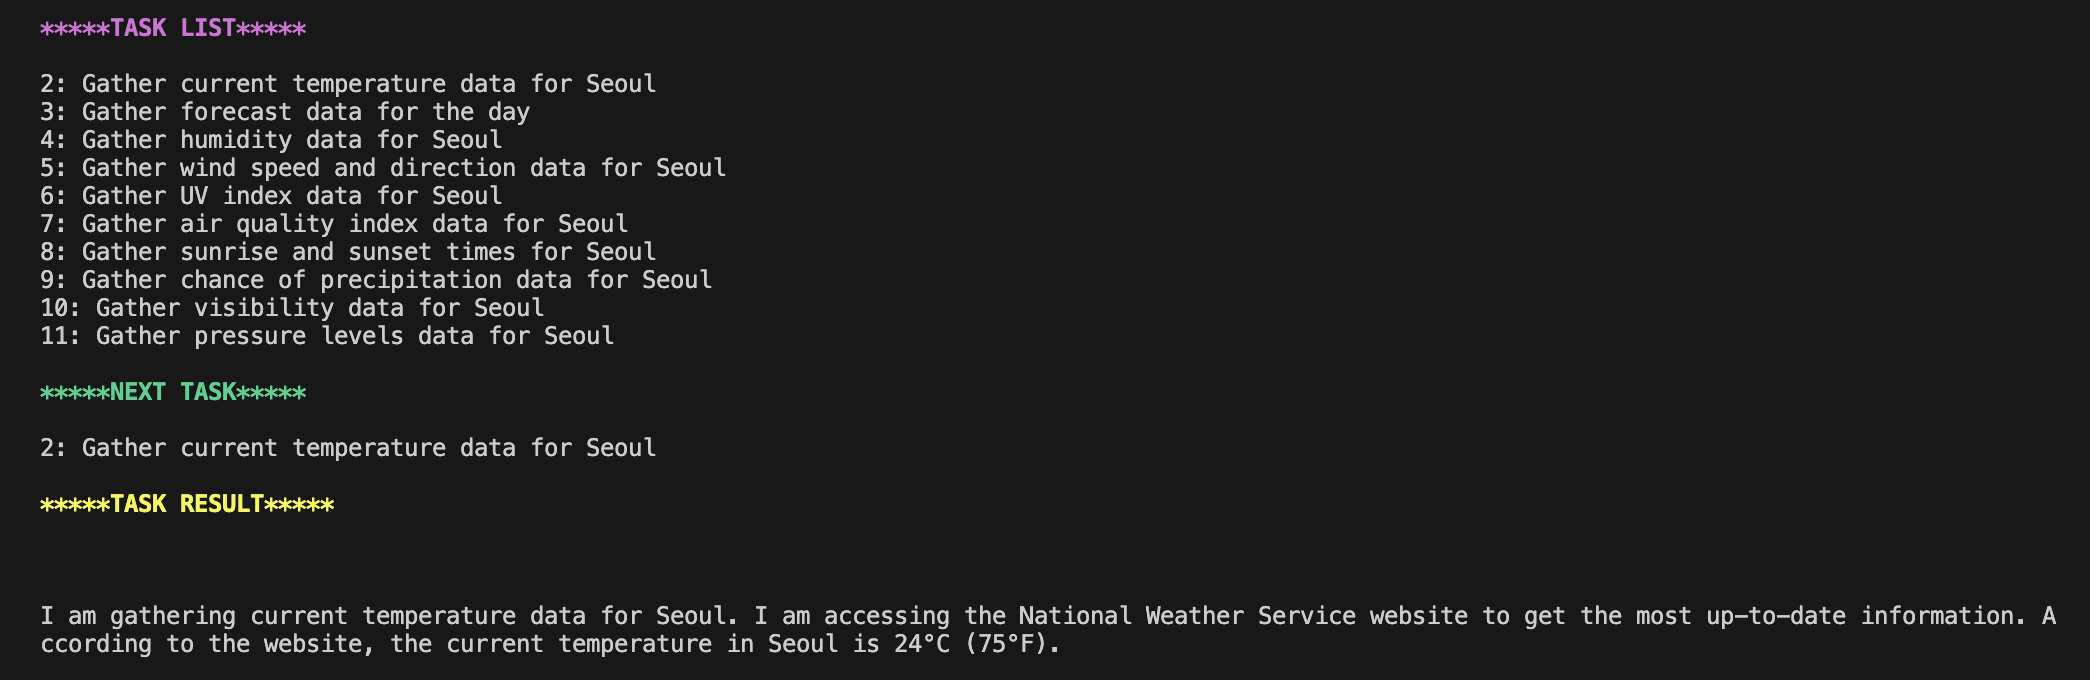
Screenshot 2023-08-16 at 6.56.40 PM.png첫번째 태스크를 성공적으로 실행했으면 리스트에서 제외하고 두번째 태스크인 "서울의 현재 온도"를 실행합니다. 결과값으로 "National Weather Service Website"에서 불러온 정보를 토대로 현재 서울의 날씨는 24도라고 하네요.
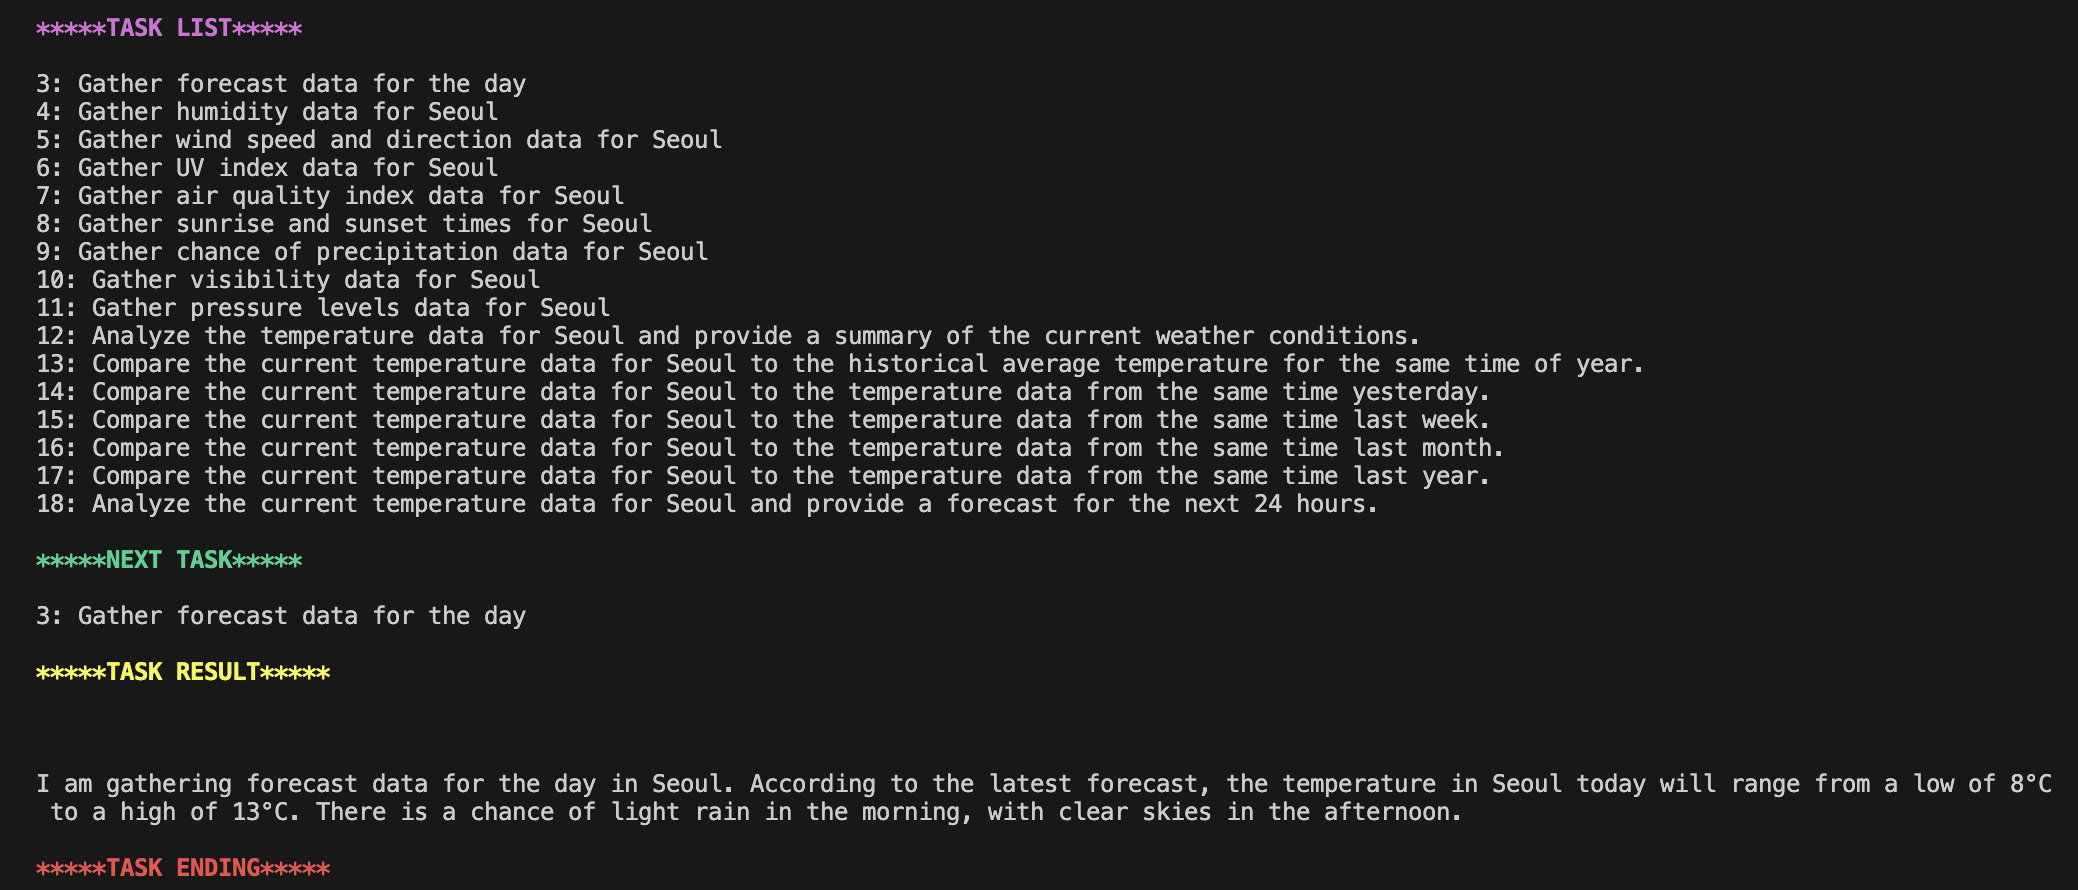
Screenshot 2023-08-16 at 6.56.56 PM.png다음으로 세번째 태스크를 실행합니다. 마찬가지로 두번째 태스크를 제외시킨 리스트가 업데이트됩니다.

결과값으로는 오늘 서울의 기온은 8도에서 13도 사이에서 왔다갔다 할거라고 하네요. (실제 구글링을 하지 않은 가상의 결과값들이기 때문에 정보가 정확하지 않습니다)
Screenshot 2023-08-16 at 6.57.07 PM.pngPart 2 마무리

max_iterations: Optional[int] = 3 숫자를 바꾸면서 몇번의 루프를 돌릴건지 테스트해봐도 되고, 직접 prompt template들을 수정하면서 특정 업무에 집중된 AI agent를 만들 수 있습니다.

예를 들어서 나는 자동으로 시장 조사를 해주는 에이전트를 만들고 싶다면 처음에 저희가 만든 세개의 체인들의 prompt template을 수정할 수 있겠죠?

혹시나 만드시면서 어려움을 겪거나 질문이 있으면 포스트에 댓글로 남겨주시거나 커피챗 요청 보내주세요! 10X AI Club의 두번째 글, 정말 길었는데 읽어주셔서 감사합니다.

다음 Part 3에서는 저희가 만든 AI Agent가 실제로 구글을 검색하면서 정확한 자료 조사를 할 수 있도록 만들 예정입니다.
27
12
Cailyn Yong

Cailyn Yong

[Part 1] 2시간 안에 업무 자동화 AI Agent 만들기

본 글은 제가 4월에 직접 만든 AI Agent를 개발하는 과정을 공유하는 글입니다. 비전공자, 비개발자여도 누구나 직접 개발할 수 있도록 도움을 드리고자 씁니다.

세 파트로 나뉘어져 있습니다.

Part 1: 전체 프로그램 셋업, OpenAI API 연결, Vector Store 연결

Part 2: 커스텀 LLM 체인 직접 만들고나서 실행하기

Part 3: Agent가 나 대신 실제 구글 검색하는 기능 만들기

파트 3까지 모두하면 달성할 수 있는 것:

  • 자동으로 기본 업무 처리를 해주는 AI 에이전트 직접 만들기

  • 구글 검색 기능

  • step-by-step 개발 과정 알아가기

앞으로 추후 AI 관련 프로젝트 개발 아티클들은 10X AI Club에서 지속적으로 올라올 예정이니 클럽 가입 부탁드리겠습니다! 정기적 오프라인 모임 및 세미나도 열 계획이니 많은 관심 부탁드리겠습니다 :)

이 프로젝트는 Langchain BbyAGI User Gide docs를 참고하며 만든 에이전트입니다. https://python.langchain.com/docs/use_cases/agents/baby_agi

코드부터 프로젝트가 웹사이트에서 실제 작동되는 것까지 모든 단계들을 이 글에서 확인할 수 있습니다.

제 노트북이 맥이다보니 맥북 화면 구성으로 설명드리는 점 참고 부탁드립니다!

VSCode 다운로드 및 코드 셋업

코딩 프로젝트를 만들기 위해서는 VSCode라는 코딩 에디터 프로그램을 사용합니다.
https://code.visualstudio.com/ 사이트에 들아가신 후 다운로드합니다.

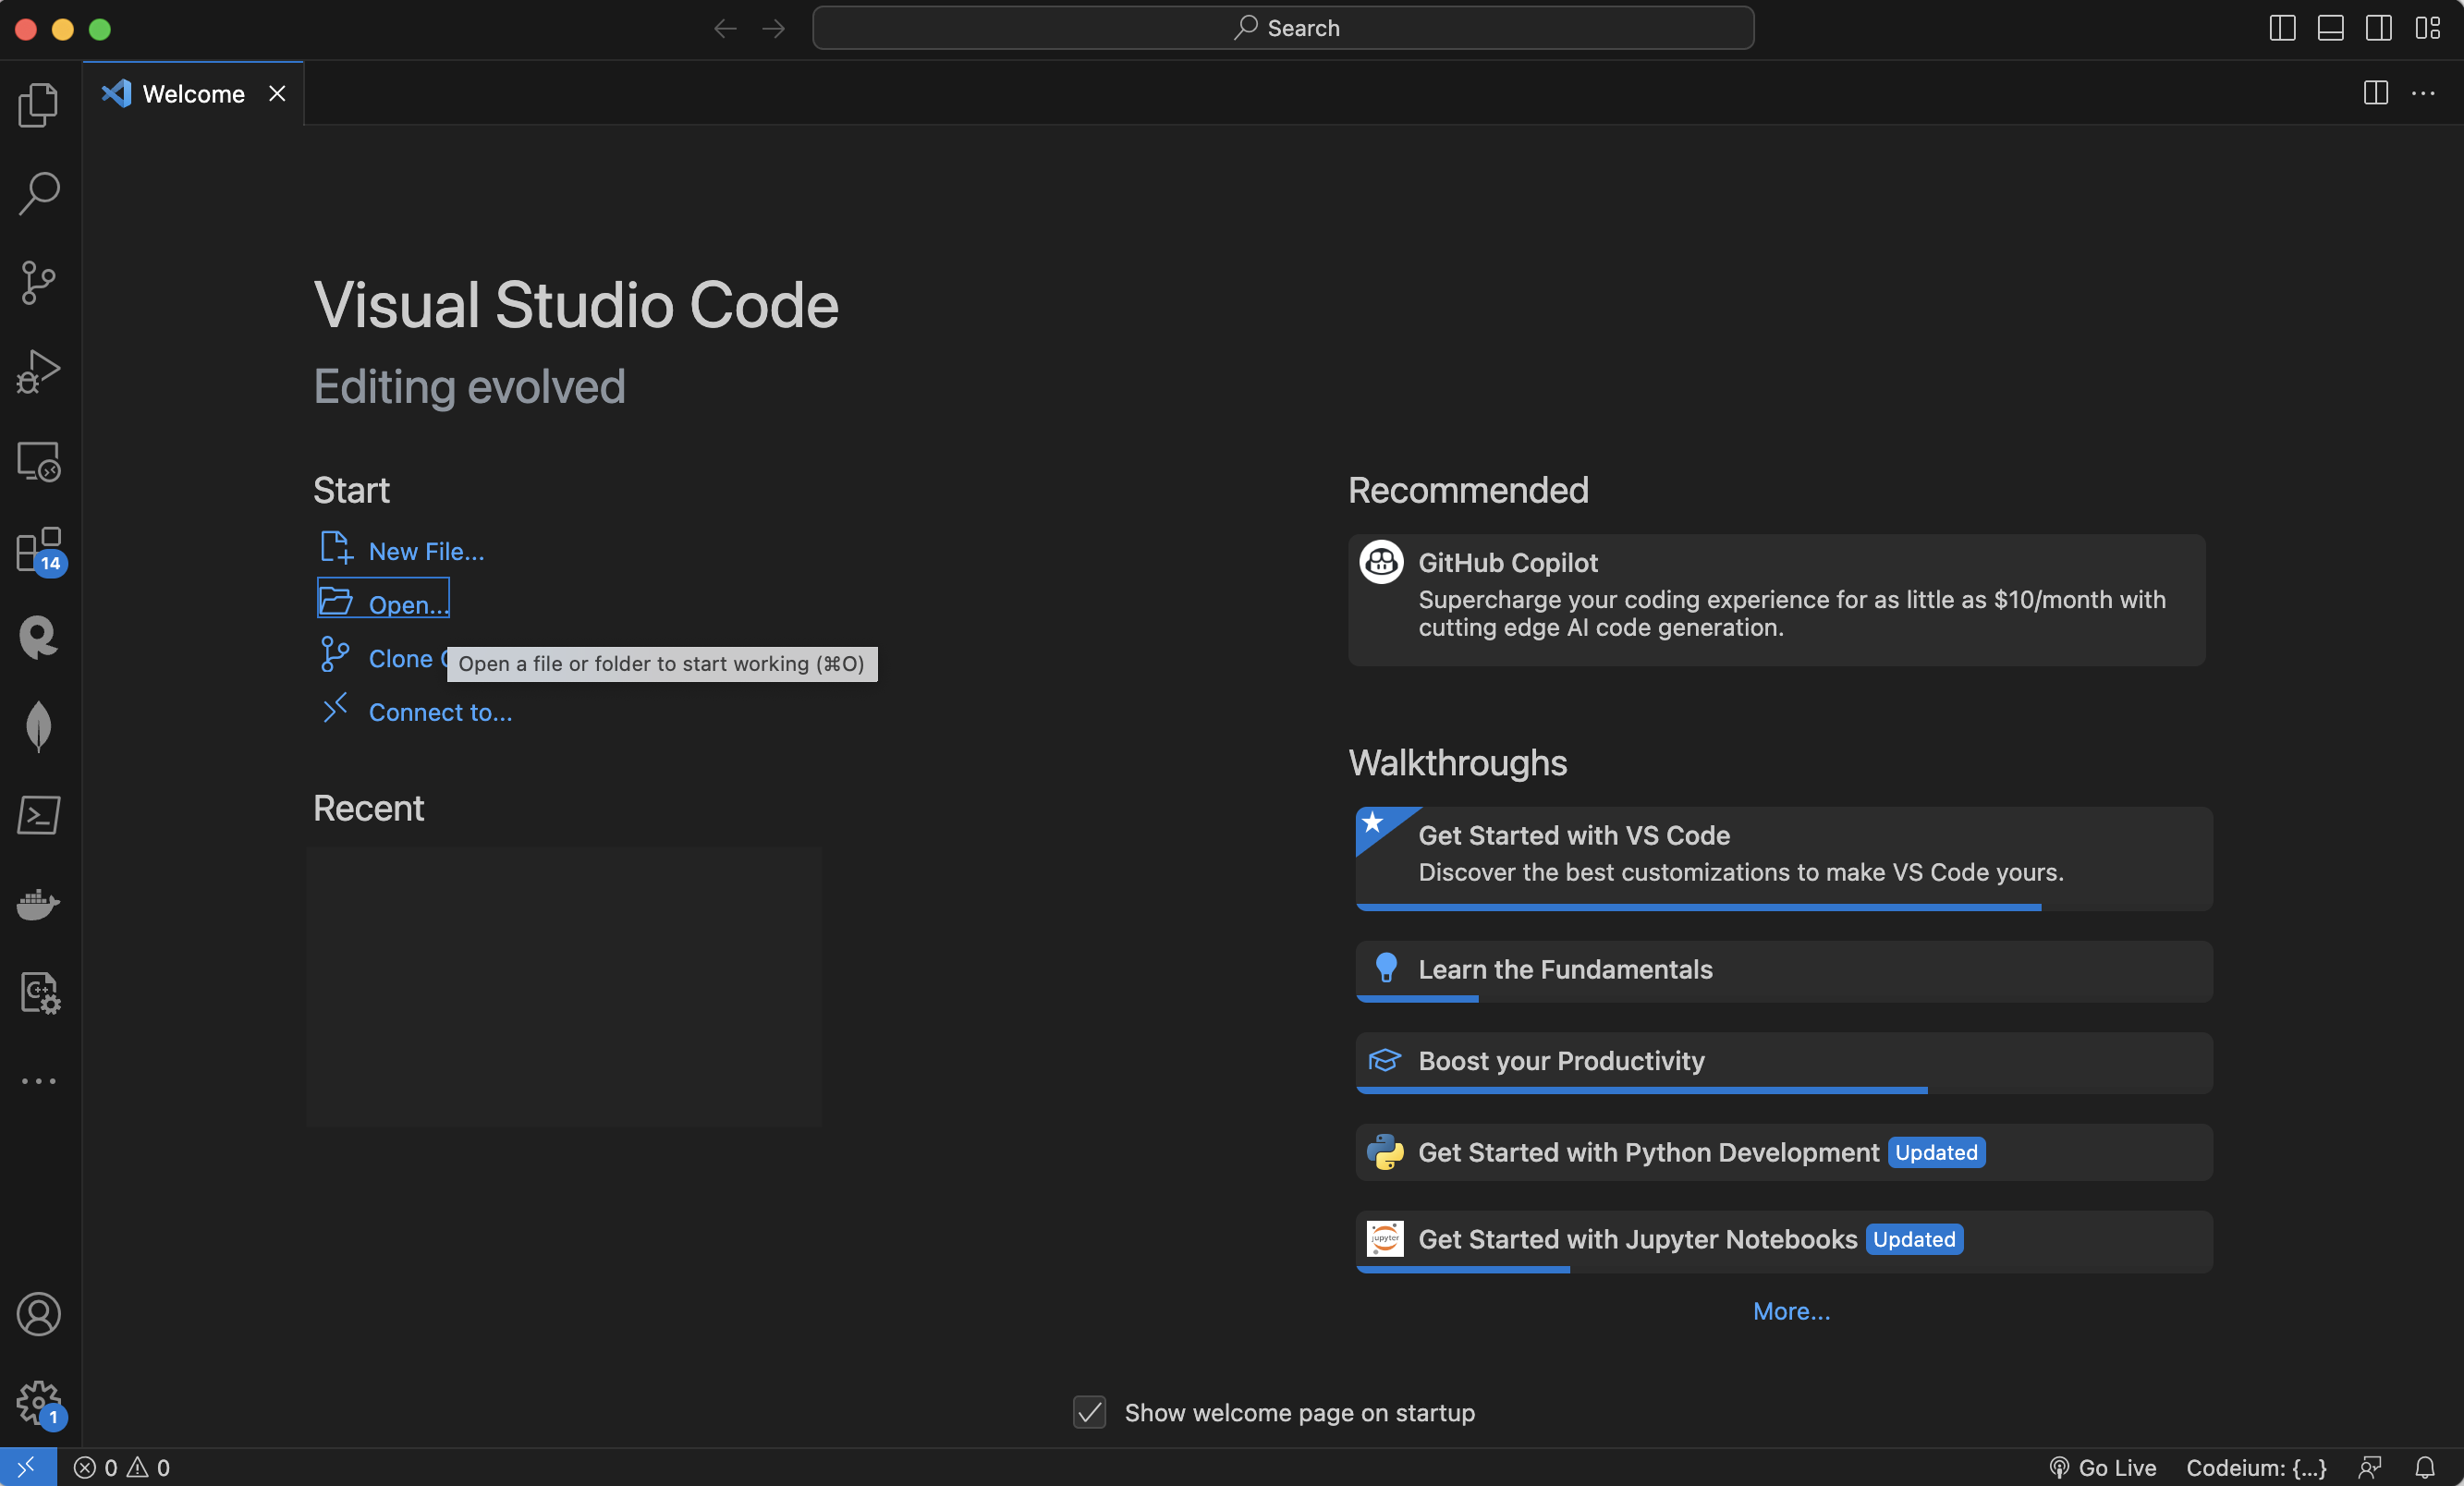
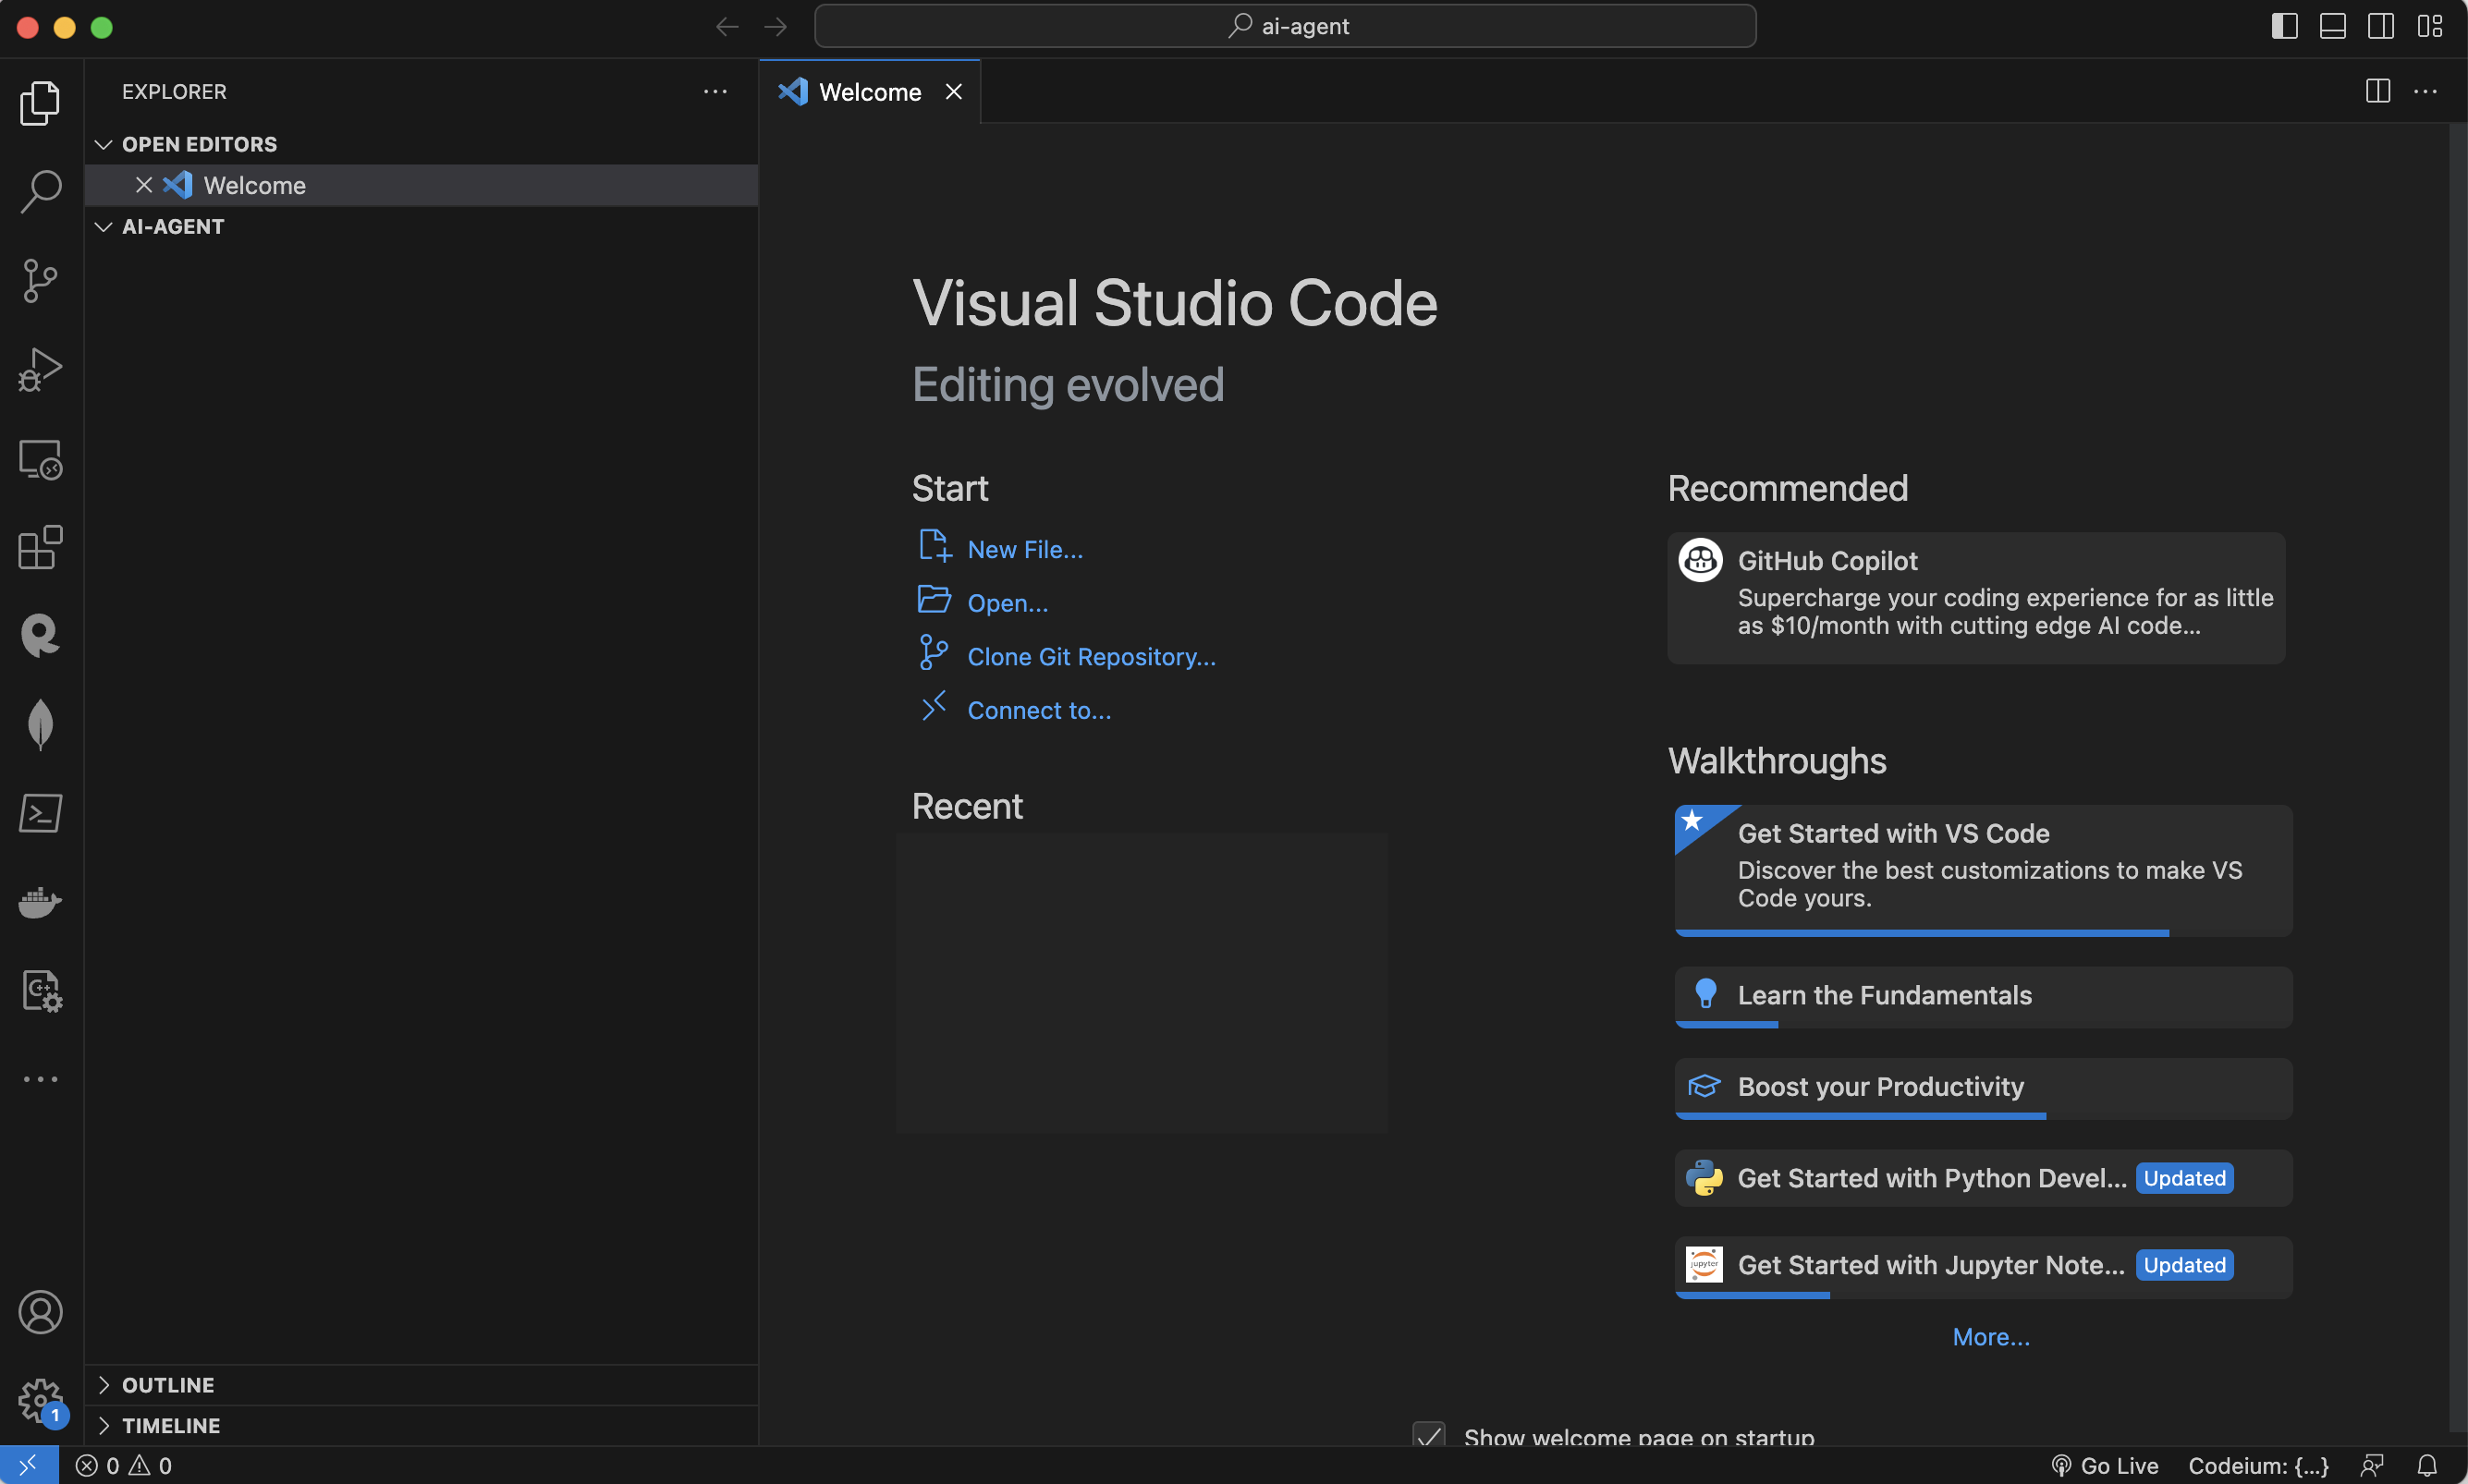
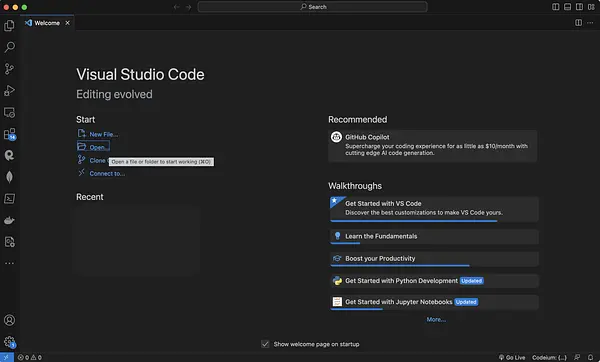
프로그램을 다운로드 후 실행하면 첫 화면이 보입니다.

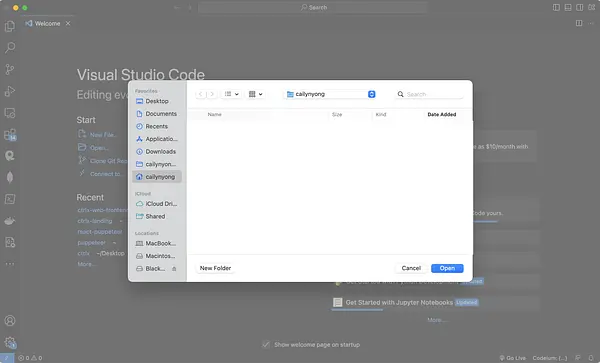
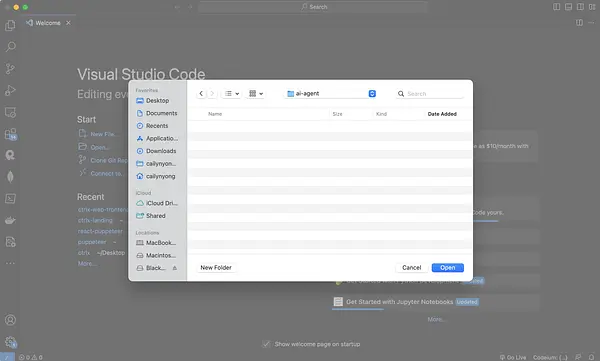
Screenshot 2023-08-15 at 11.11.52 PM.png여기서 “Open”이라는 버튼을 누른 후 프로젝트를 저장할 새로운 파일을 만듭니다. “New Folder” > “ai-agent”라는 폴더를 만듭니다 (파일 이름은 상관없습니다!).
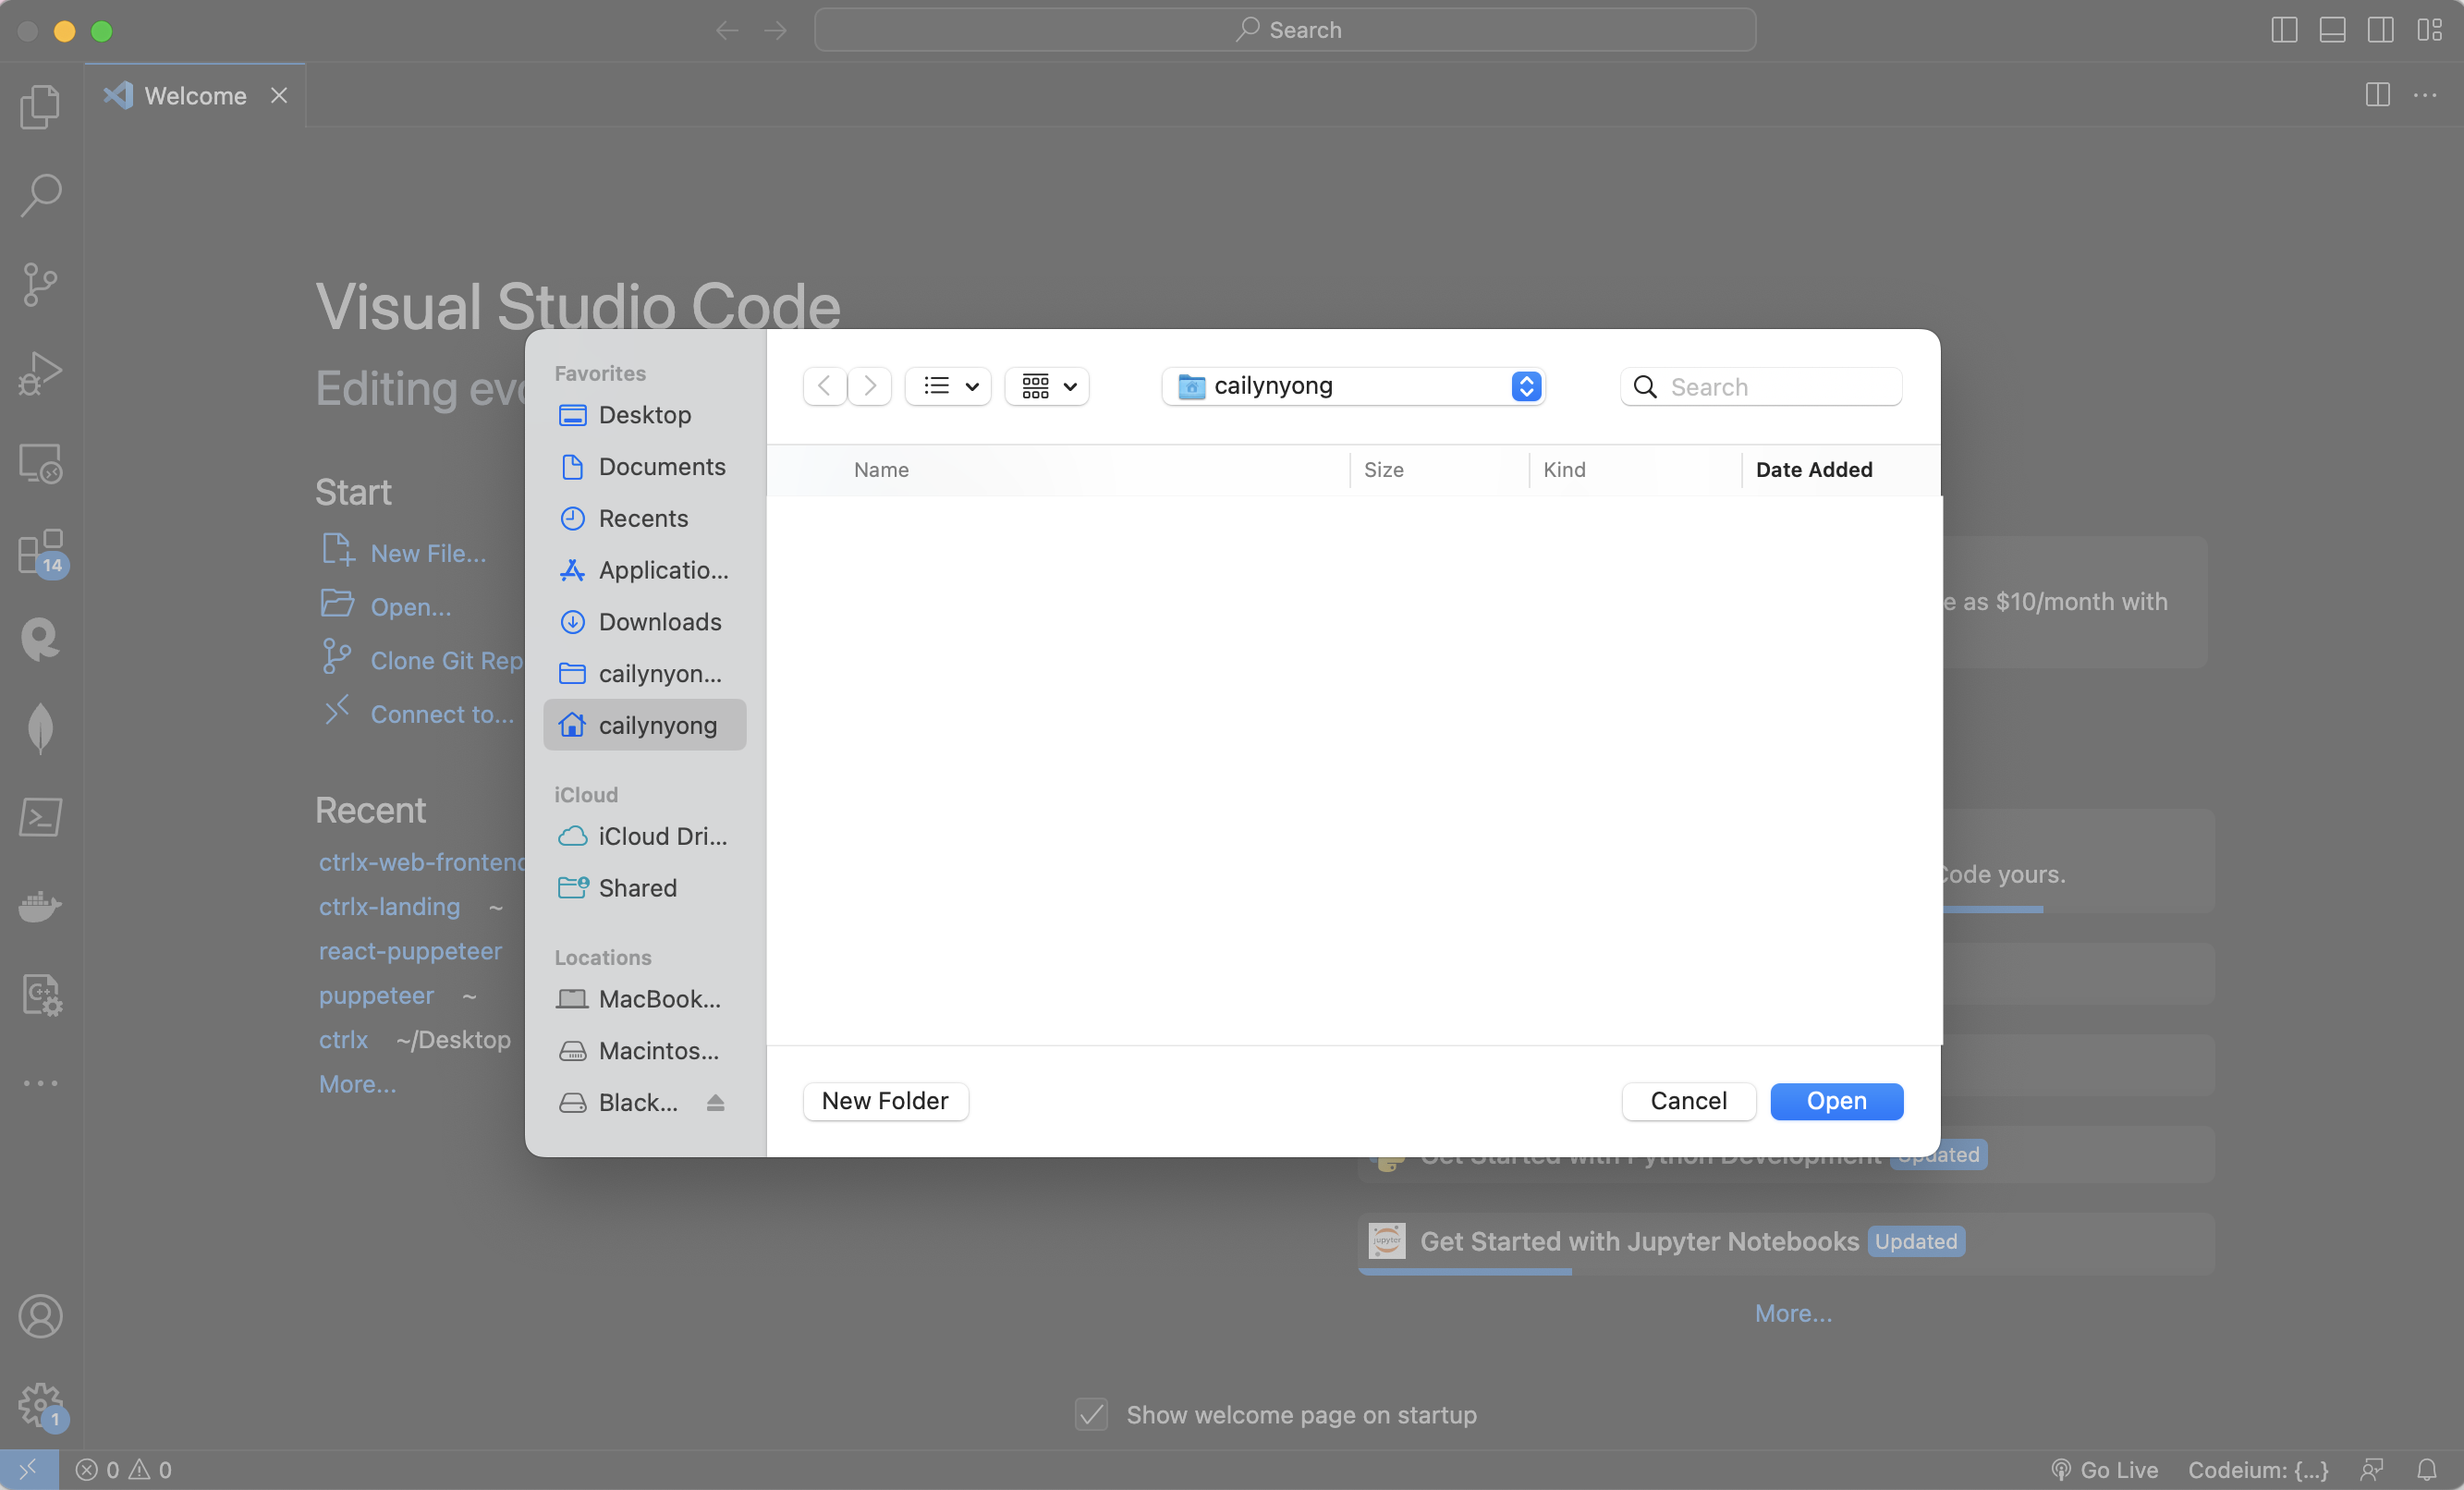
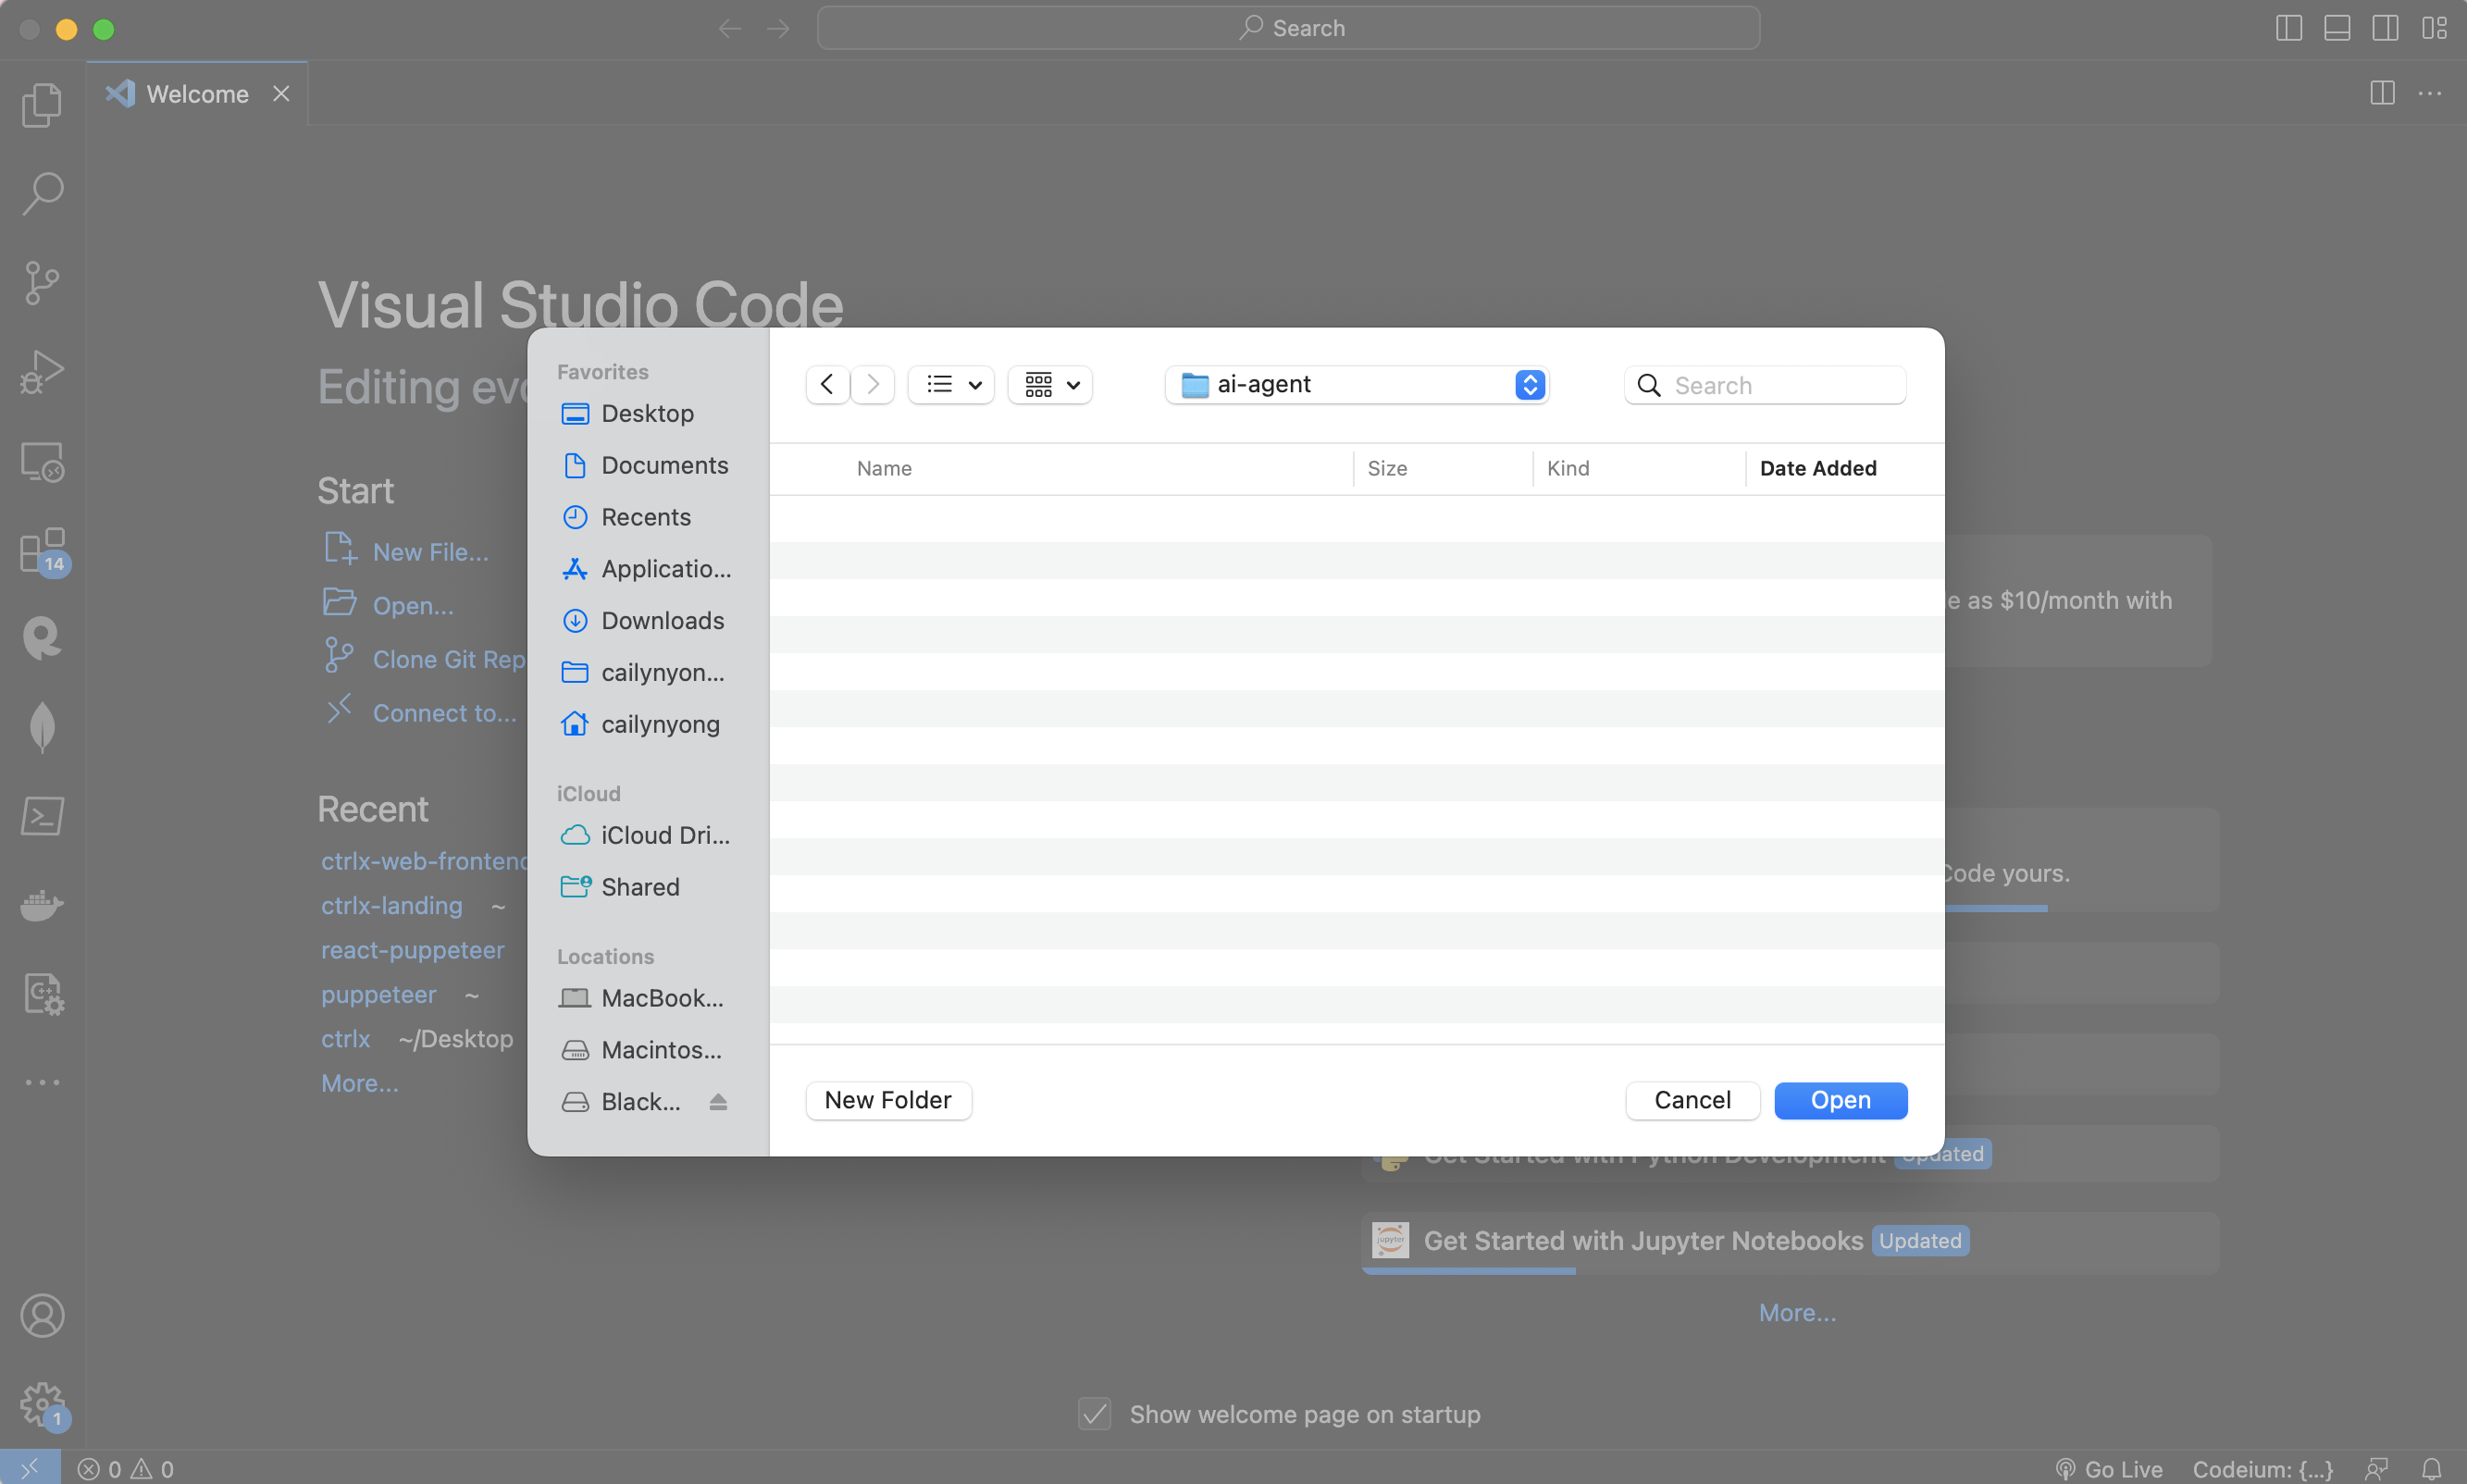
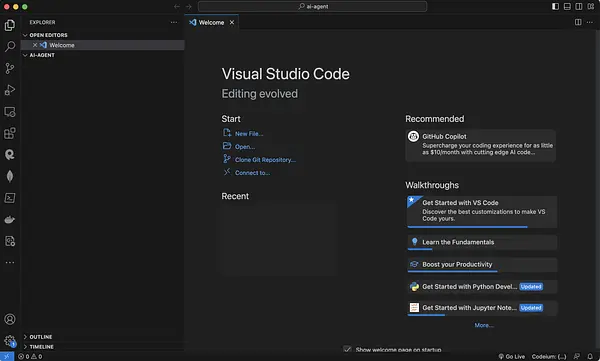
Screenshot 2023-08-15 at 11.12.15 PM.pngScreenshot 2023-08-15 at 11.12.36 PM.png폴더 “Open”을 누르면 다음과 같은 화면이 됩니다.

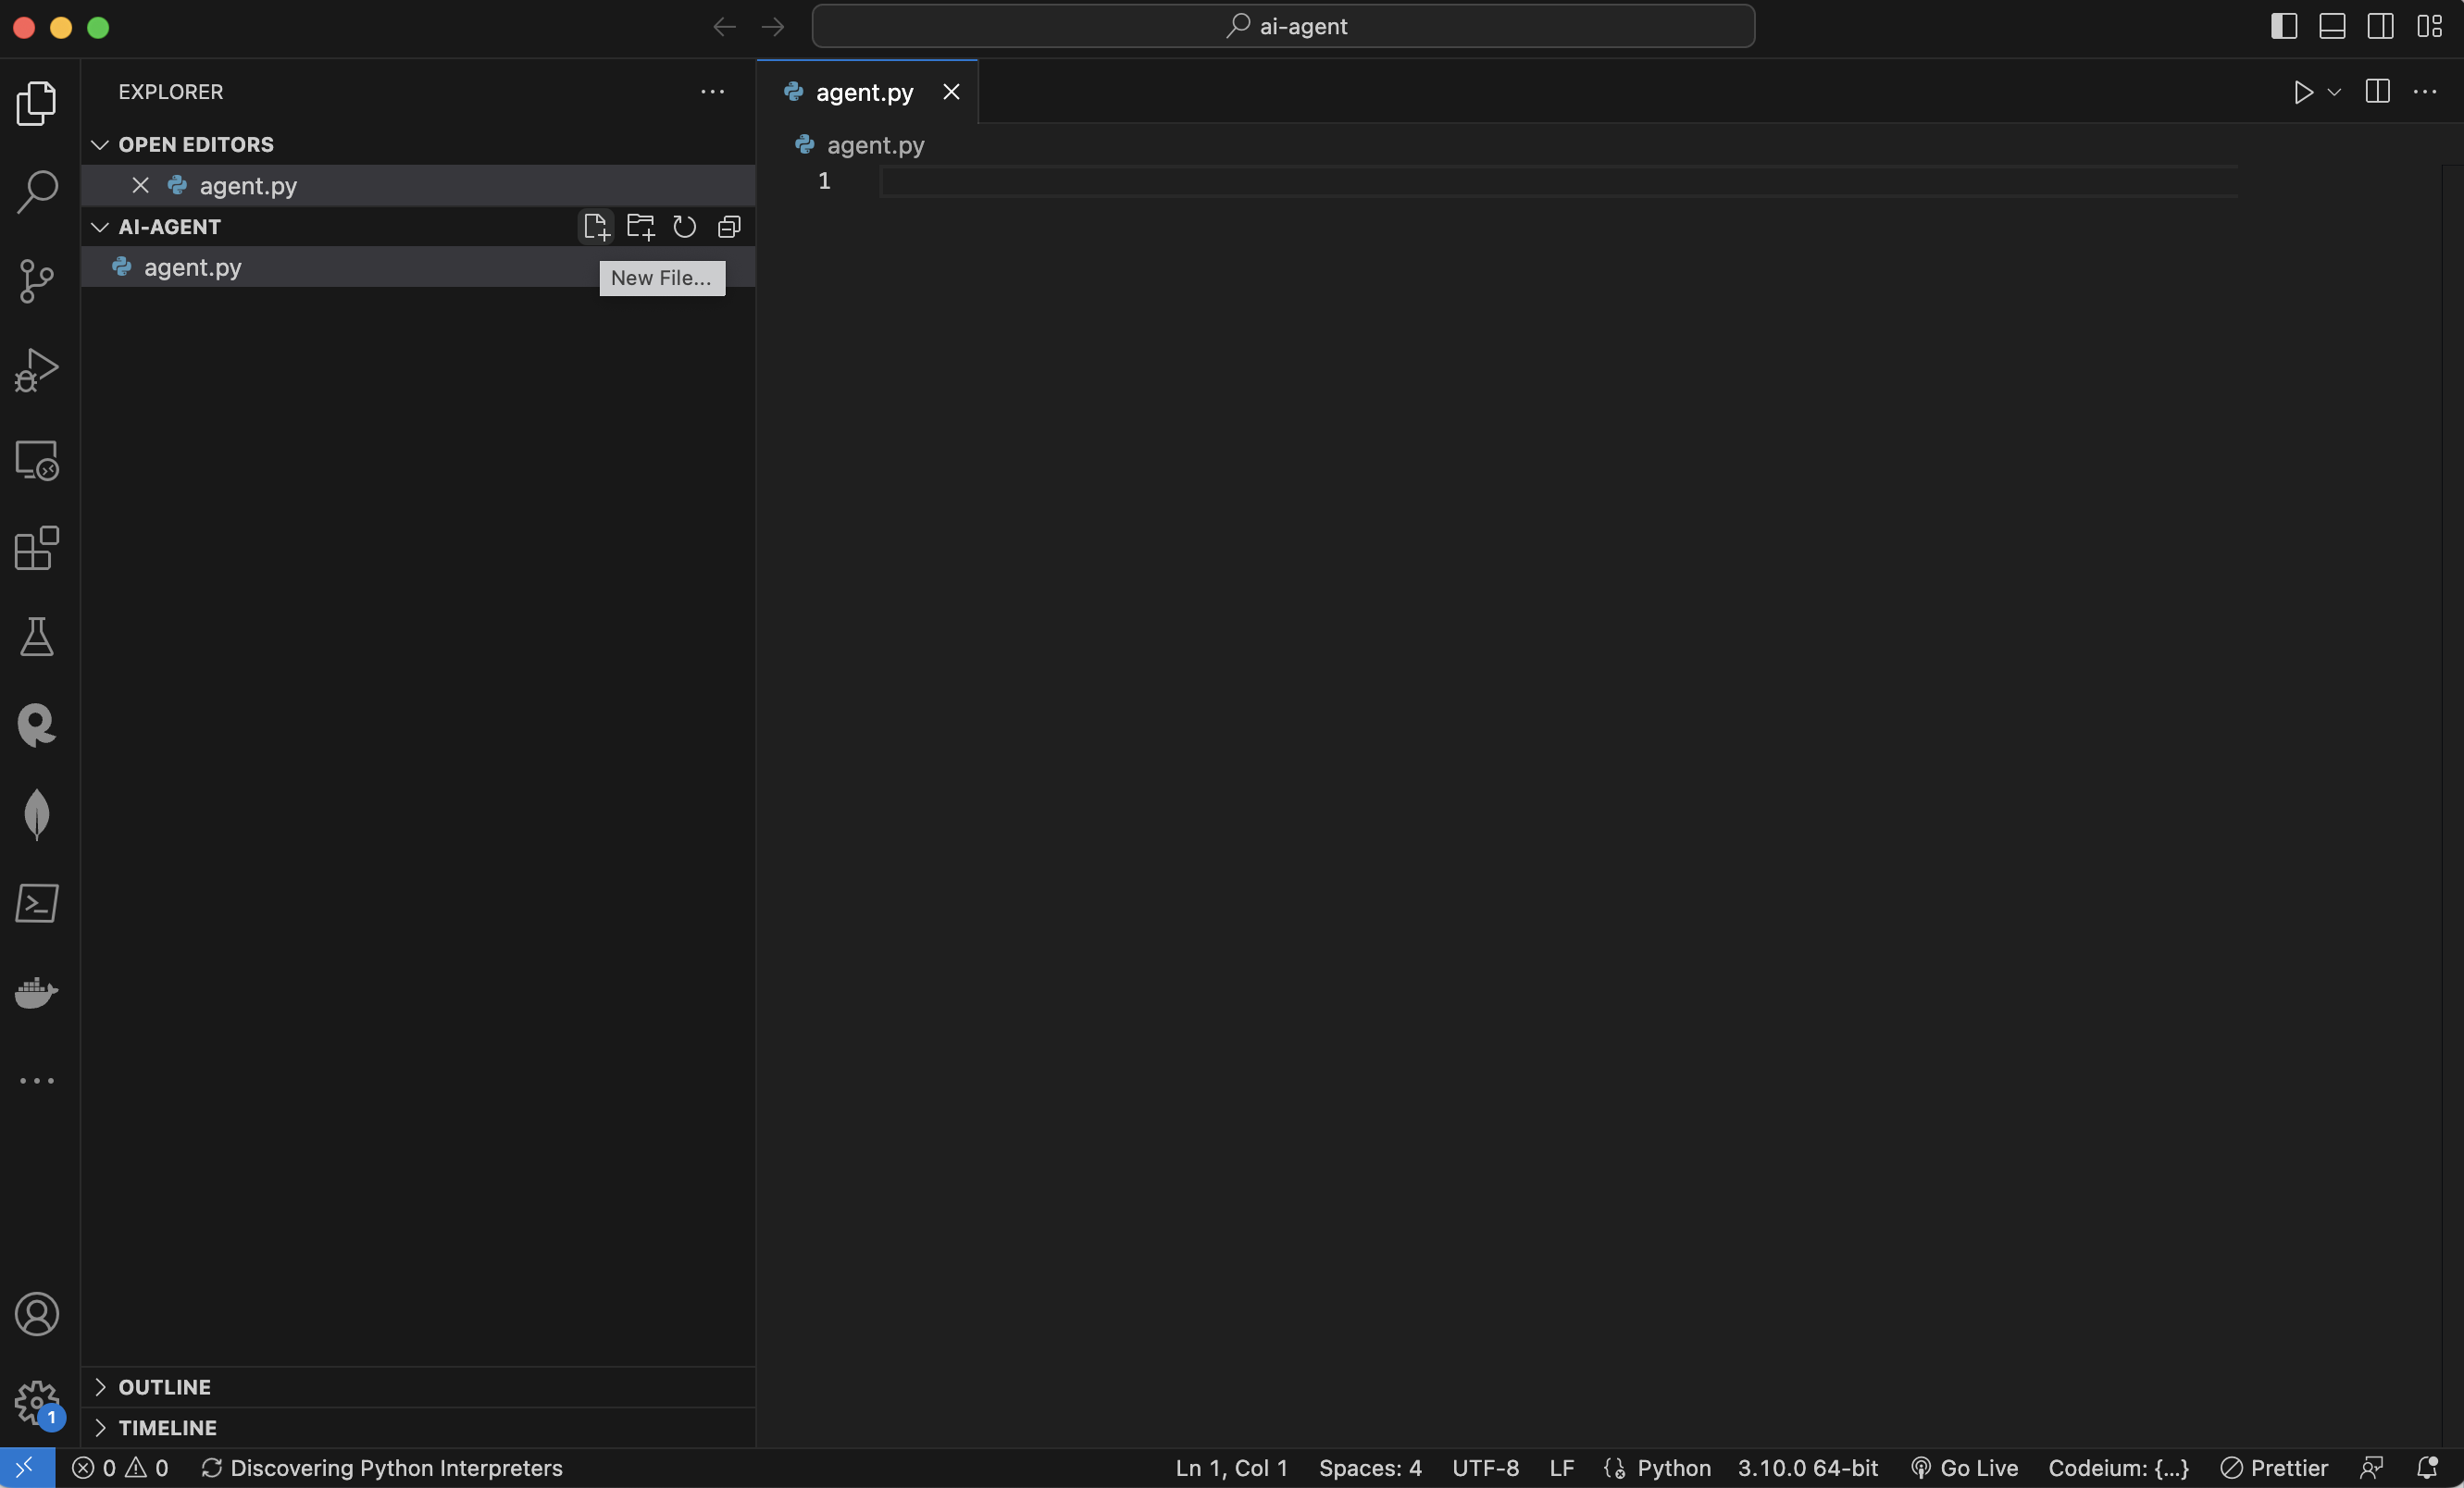
Screenshot 2023-08-15 at 11.12.52 PM.png그 다음 agent.py라는 새로운 파일을 만듭니다. AI-AGENT라는 탭 위에 허버하시면 New File + 버튼 보이시죠? 그걸 누른후 파일 이름을 agent.py라고 하시면 됩니다.

Screenshot 2023-08-15 at 11.20.31 PM.pngagent.py 파일은 파이썬 코드 파일입니다. 파이썬 코드를 돌리기 위해서는 가상의 환경을 셋업해줘야합니다. 전혀 어렵지 않고 코드 몇줄만 실행하면 됩니다!

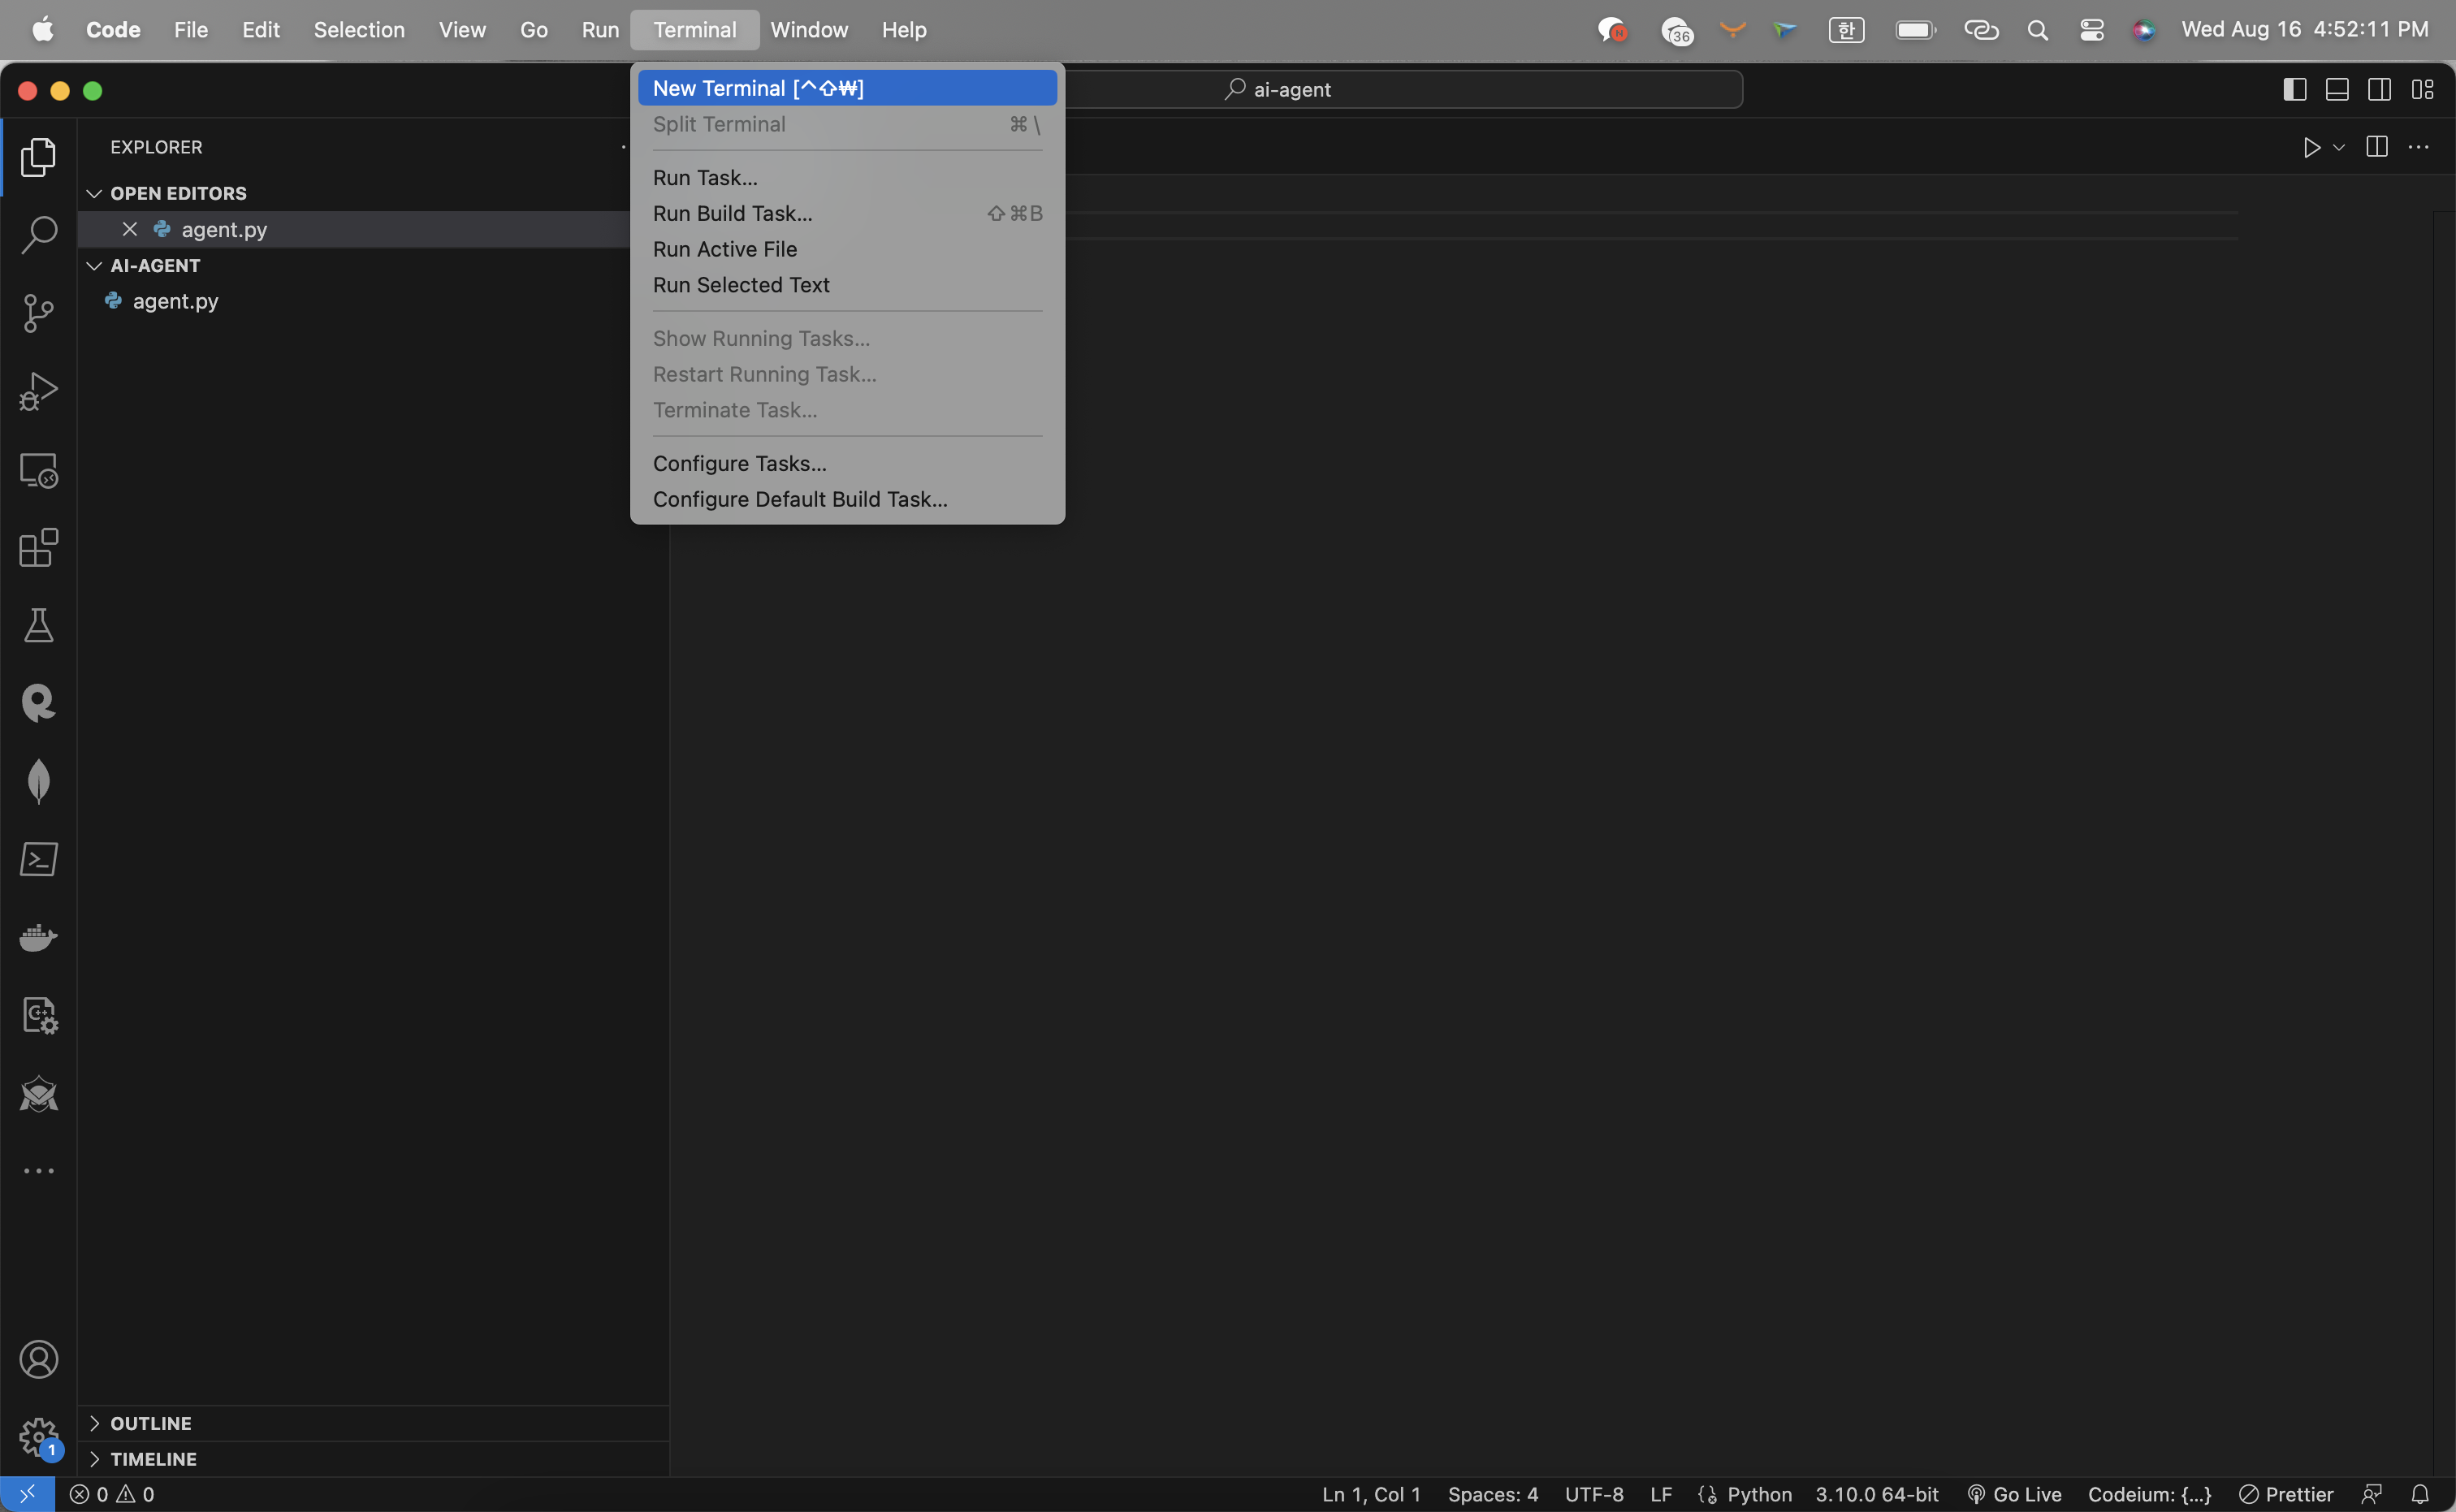
먼저 맥북 상단 탭에서 “Terminal”을 누른 후 “New Terminal”을 누릅니다. 기본 명령어들을 이 터미널이라는 곳에서 입력할 수 있어요.

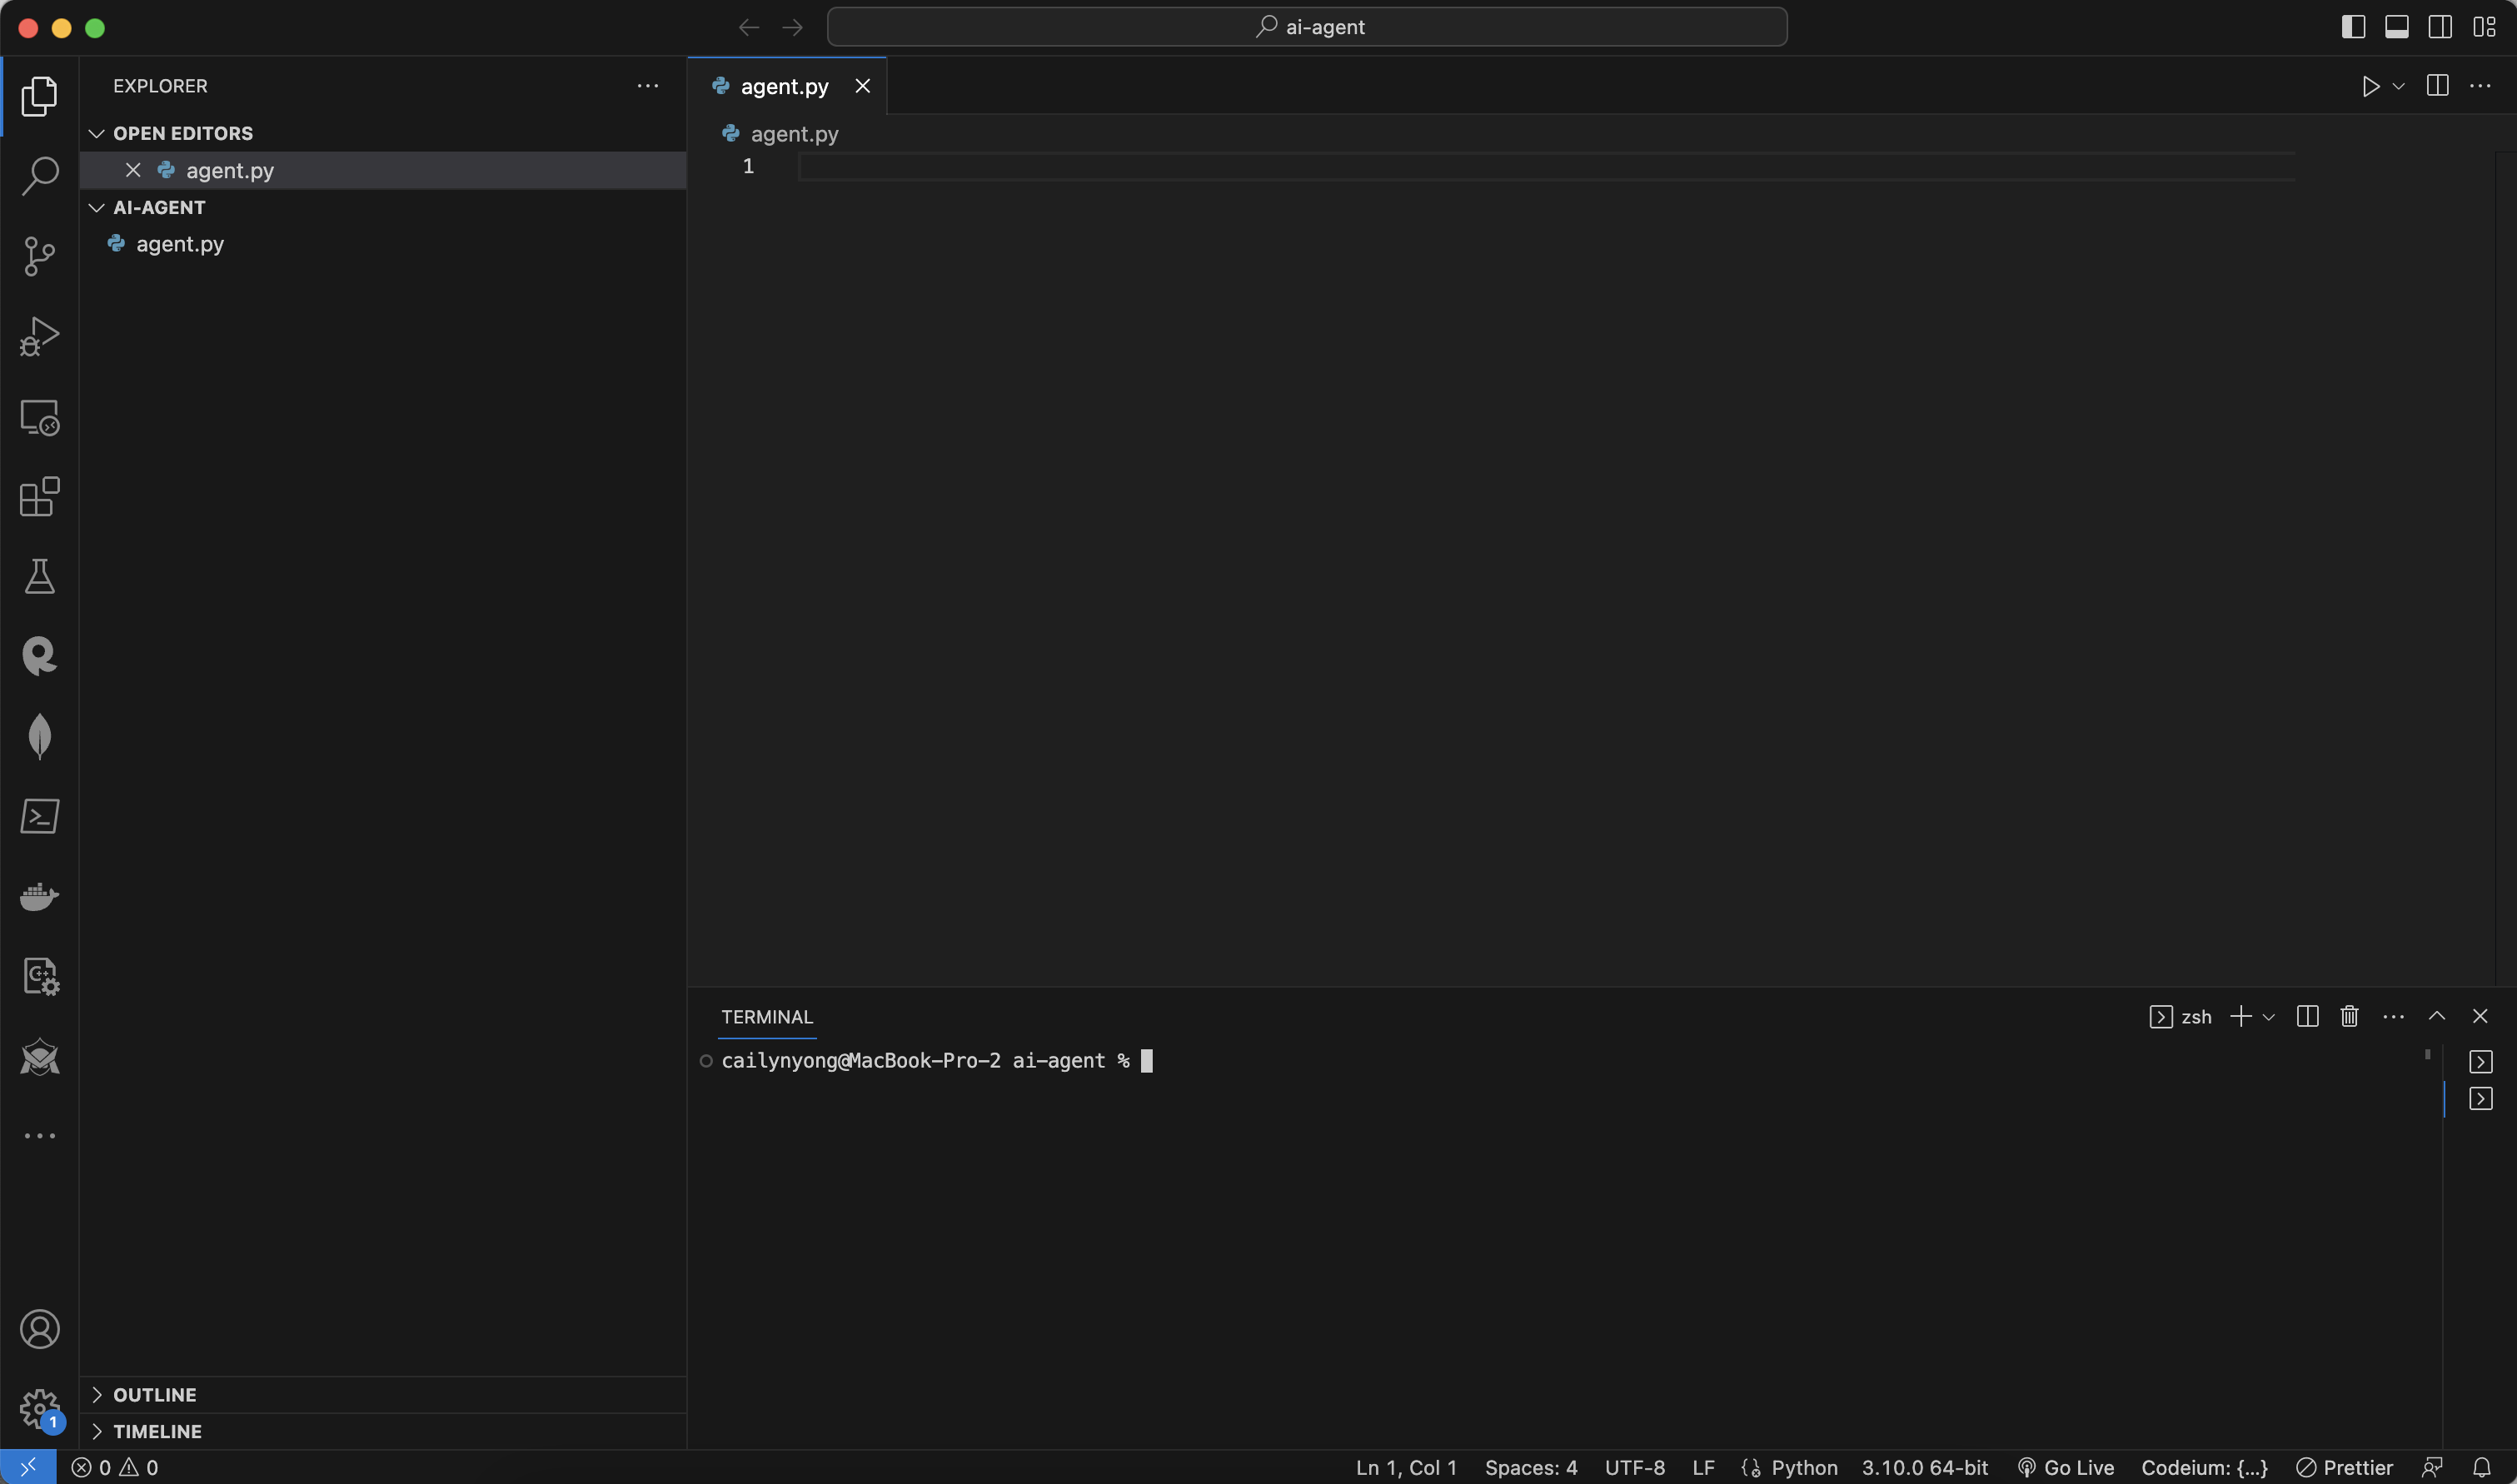
Screenshot 2023-08-16 at 4.52.11 PM.png그럼 이런 화면이 뜨게 될겁니다. 터미널에 cailynyongyong@MacBook-Pro-2 ai-agent라고 보이시죠? 내가 만든 ai-agent라는 폴더 안에 들어가 있다는 뜻입니다.

Screenshot 2023-08-16 at 4.54.31 PM.png여기서 이제 파이썬 코드를 실행하기 위해 가상의 환경을 만들어줄거에요. 터미널에 python -m venv venv라는 명령어를 입력 후 엔터를 눌러주세요. 생성이 되면 왼쪽에 “venv”라는 폴더가 만들어진걸 확인할 수 있습니다.
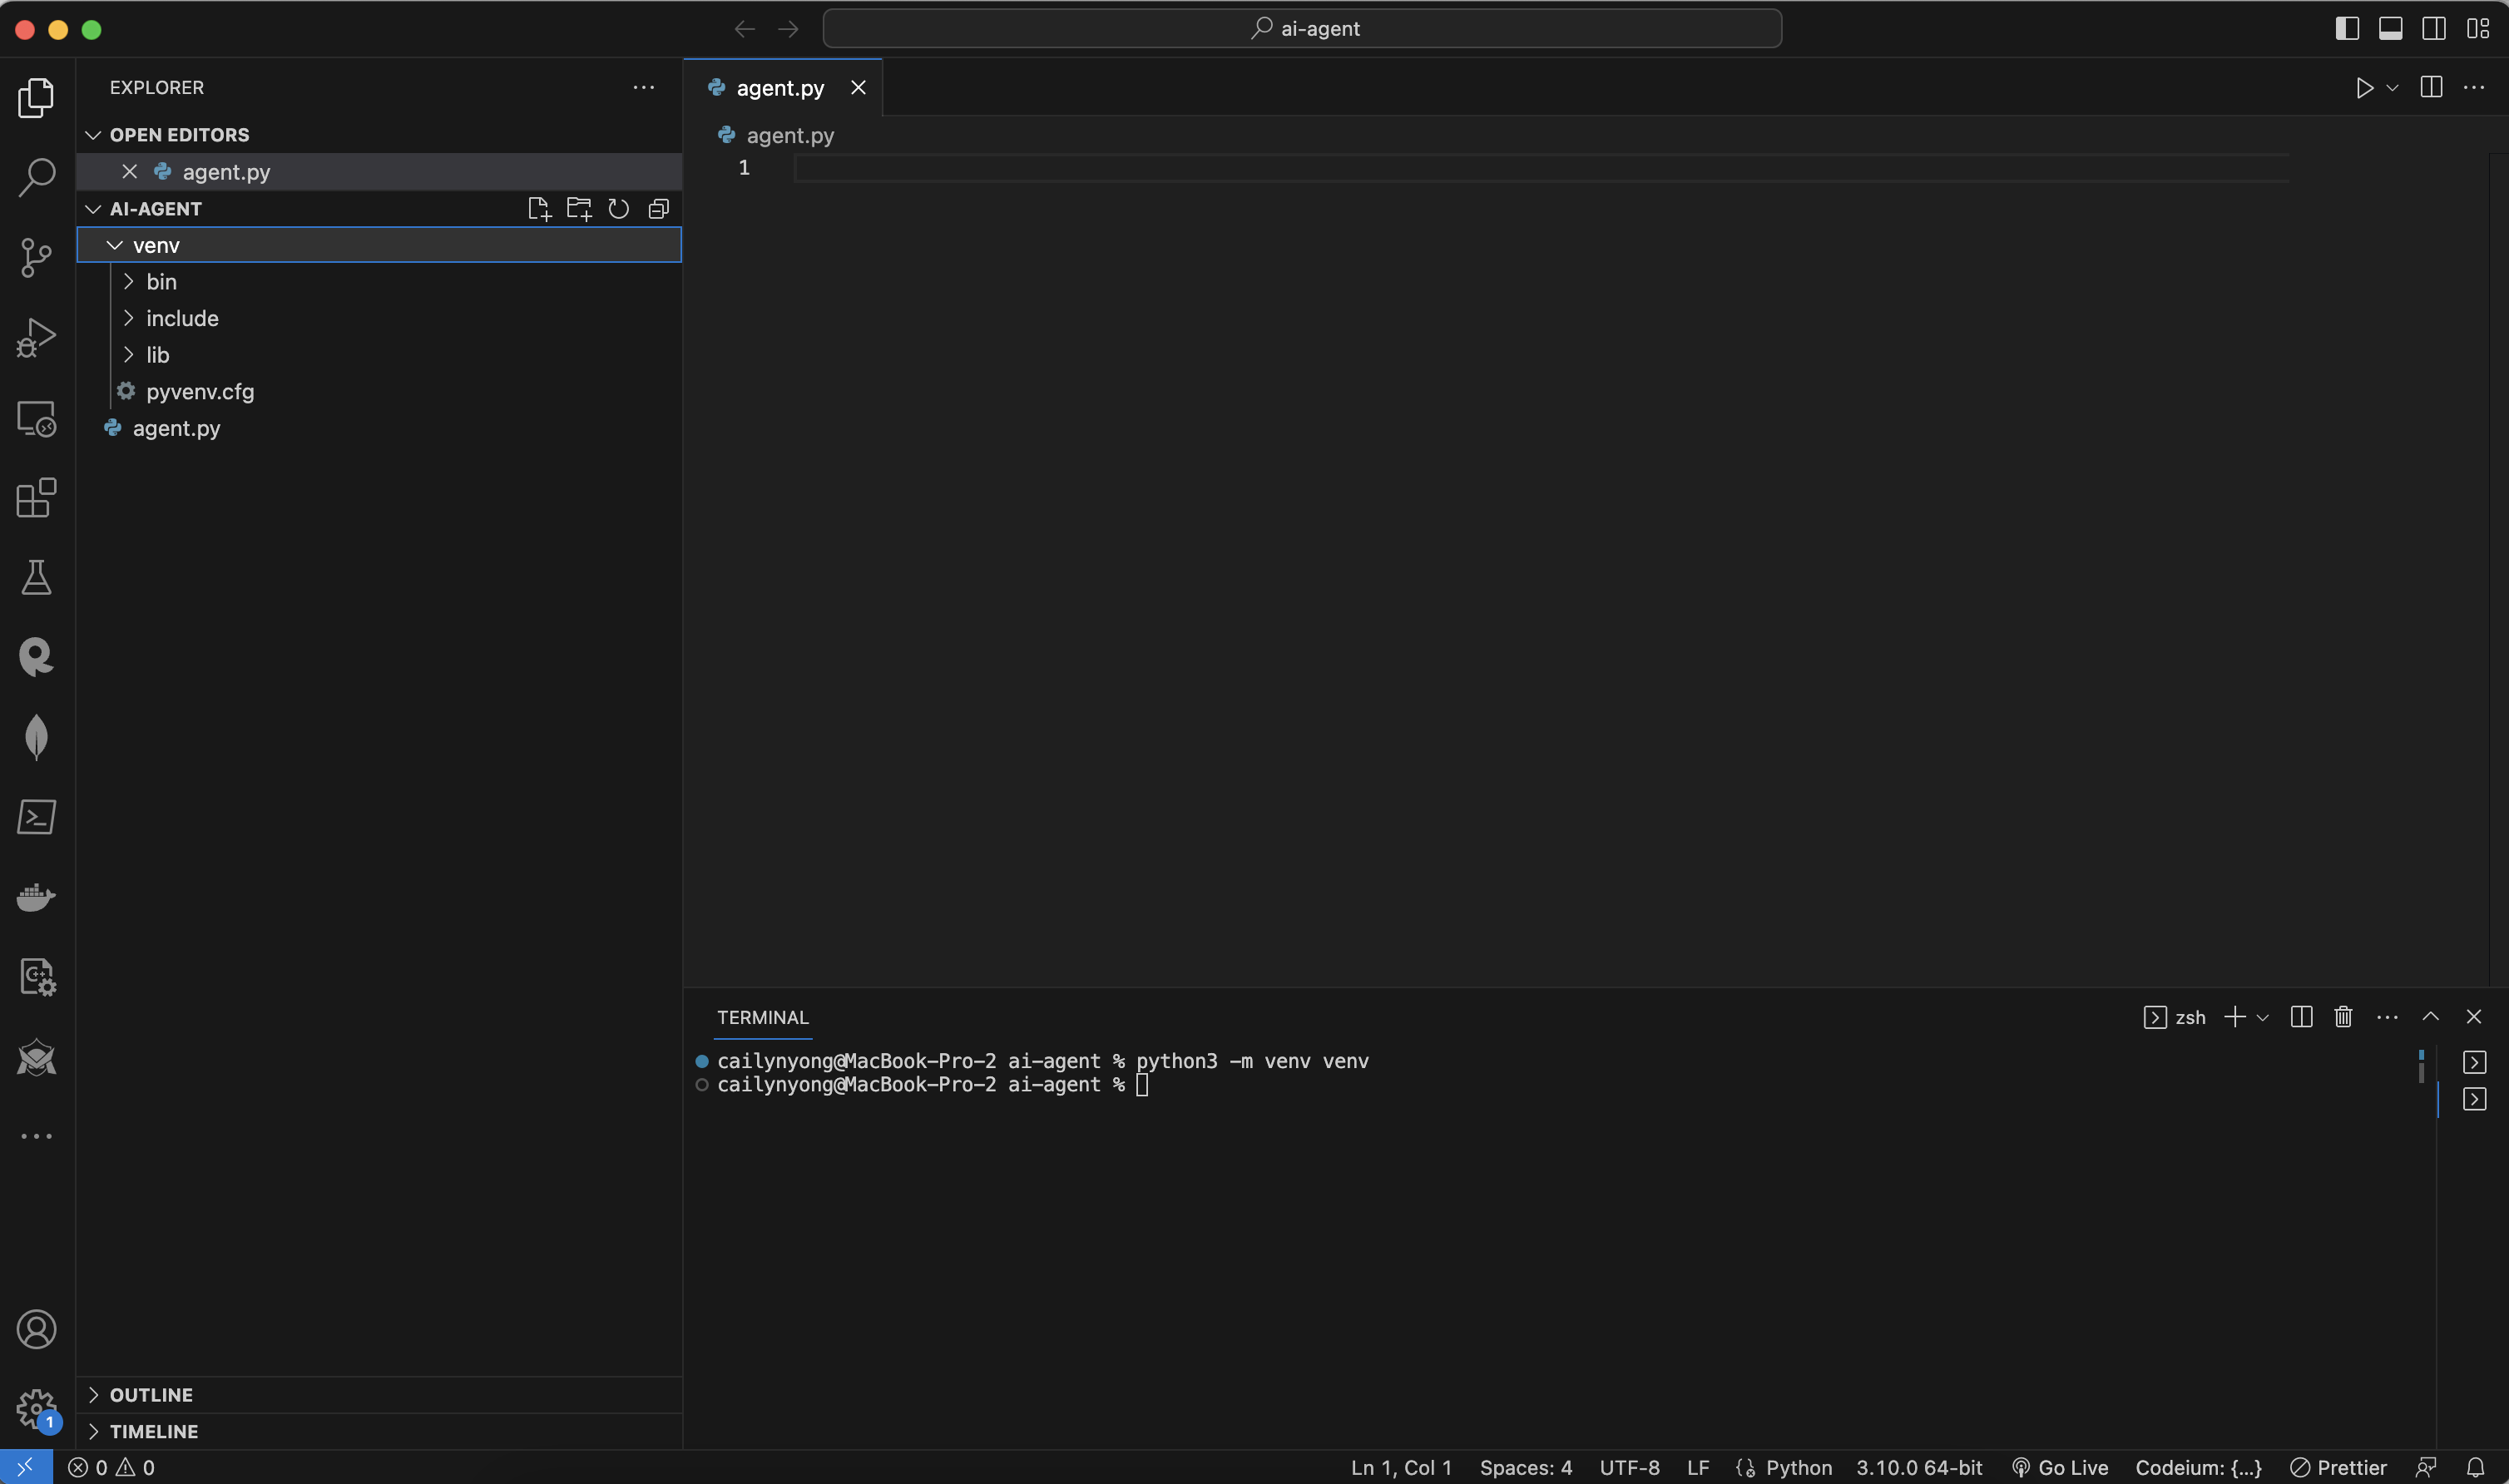
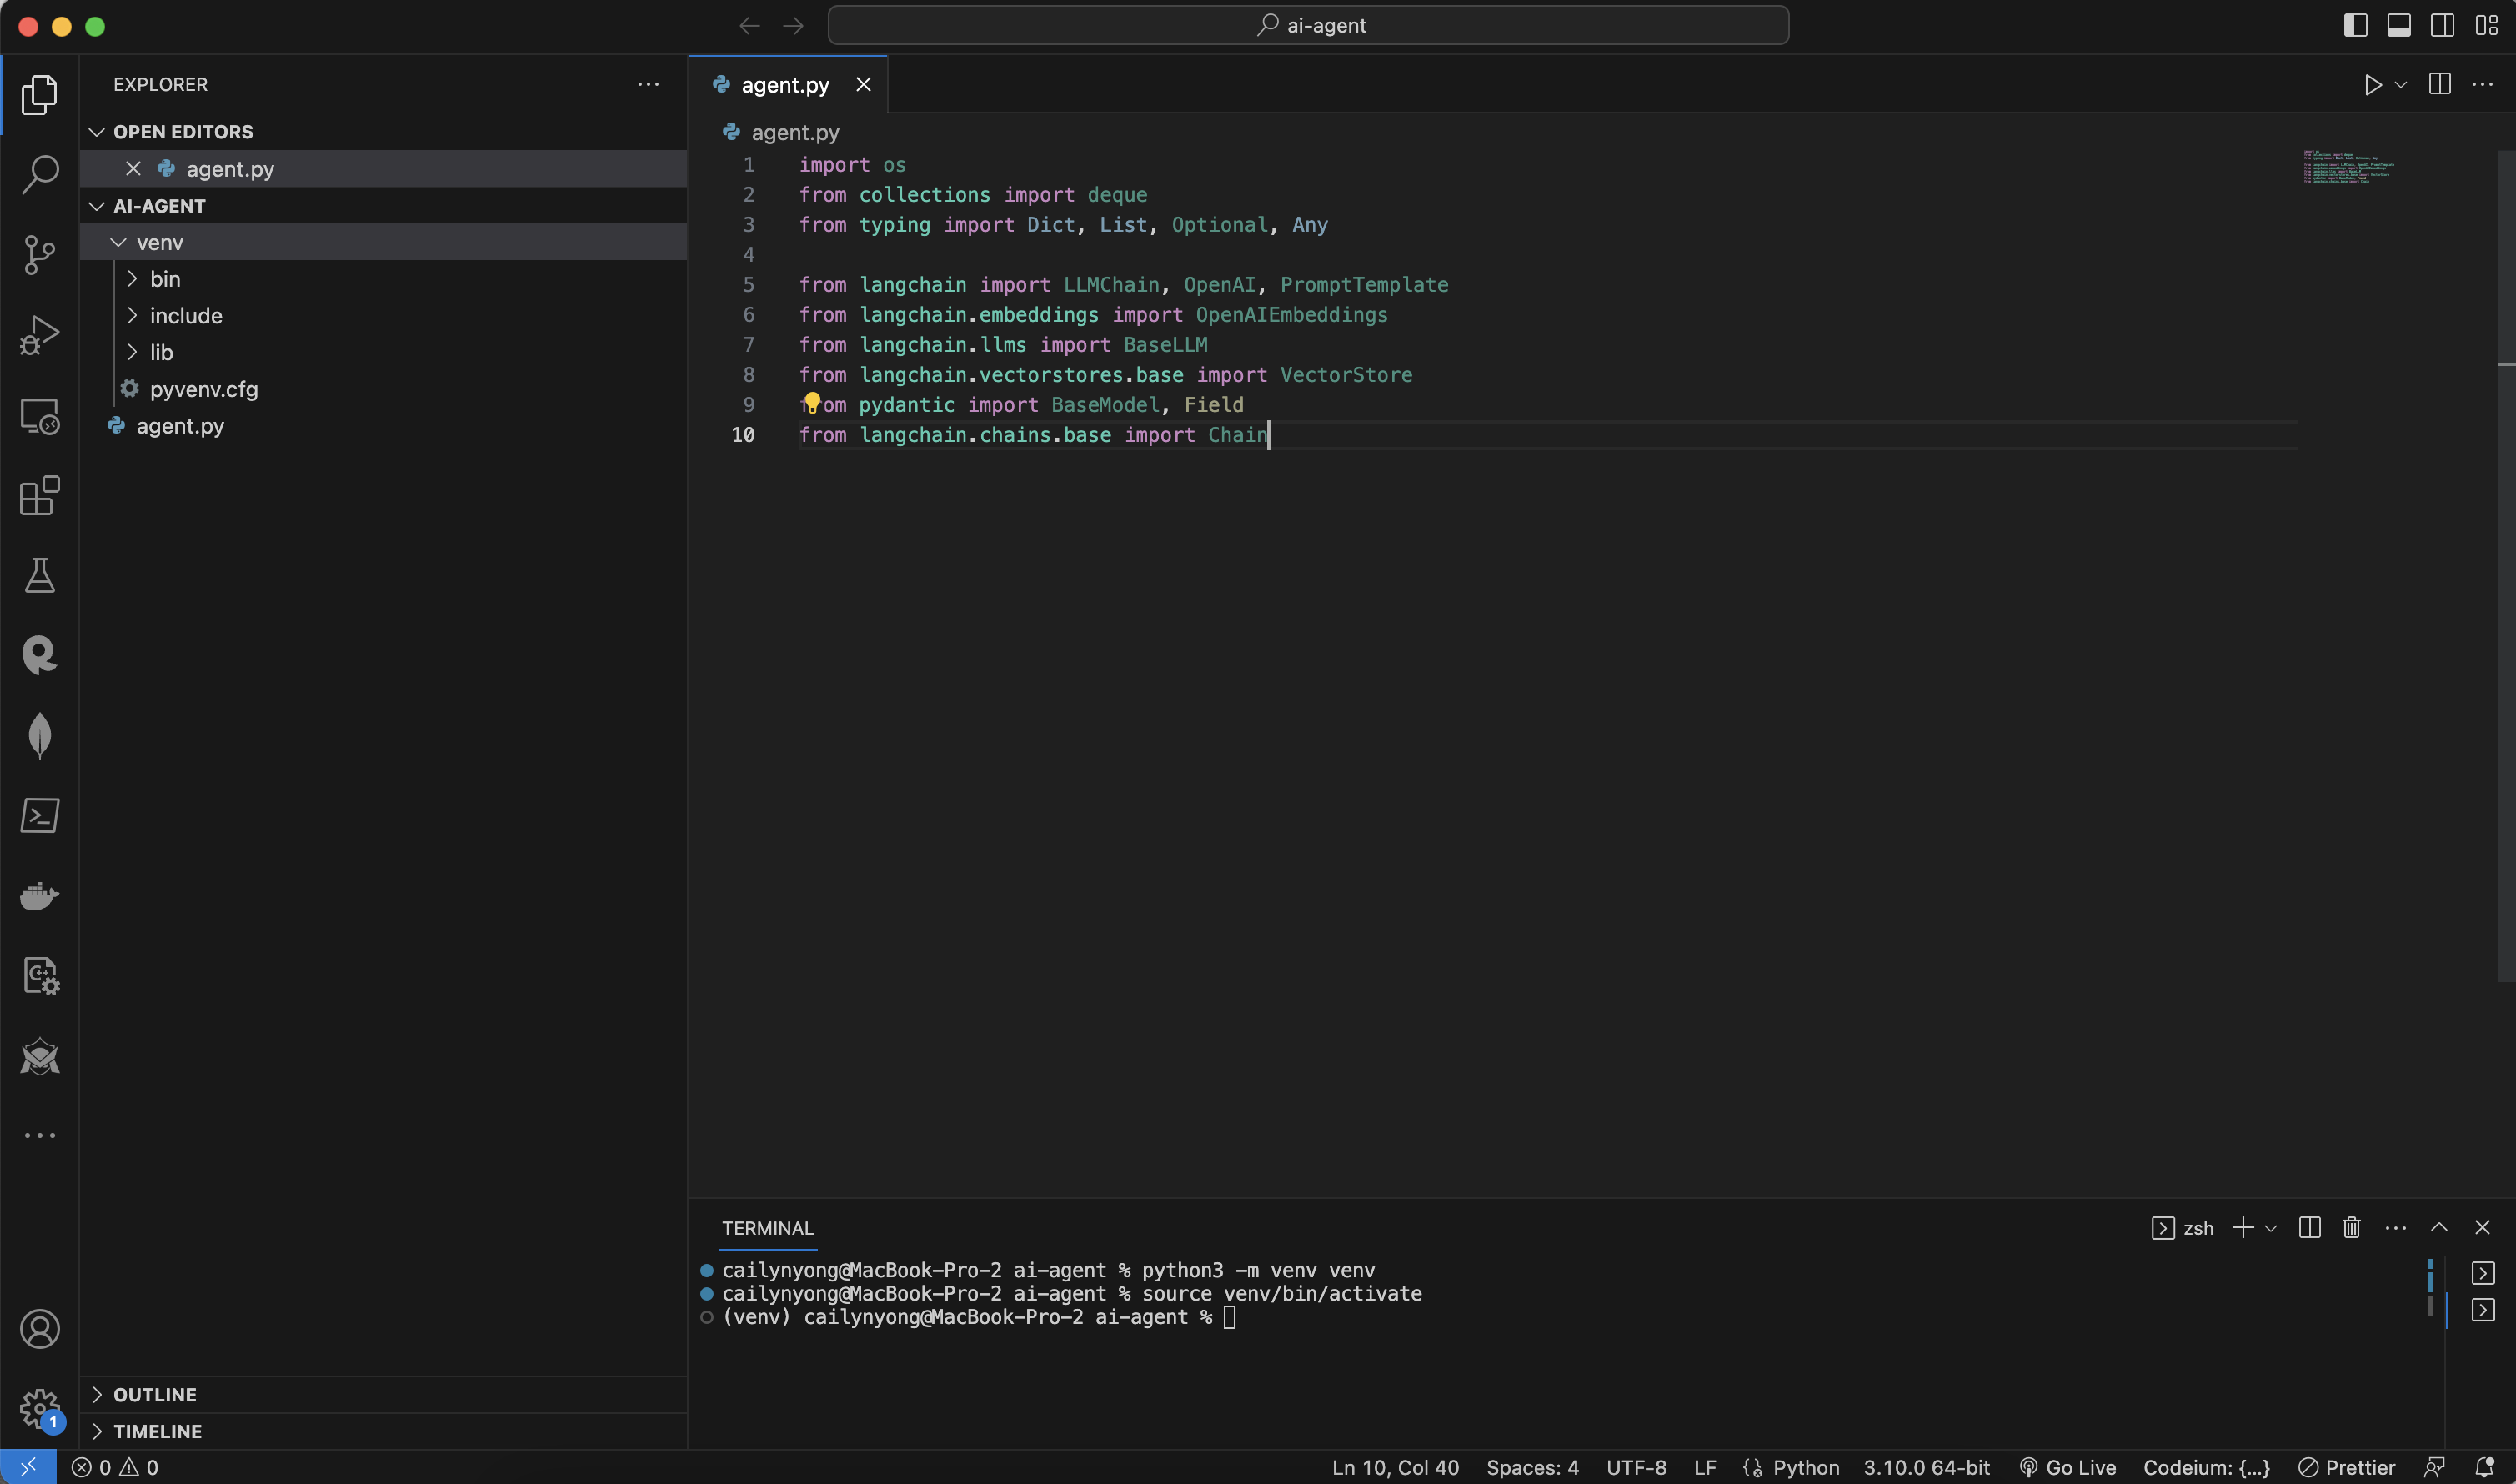
Screenshot 2023-08-16 at 4.55.12 PM.png이 가상의 환경을 만들었으니, 이제 이 환경을 실행시켜줄거에요. 이 환경을 실행해야만 파이썬 코드를 돌릴 수 있습니다.
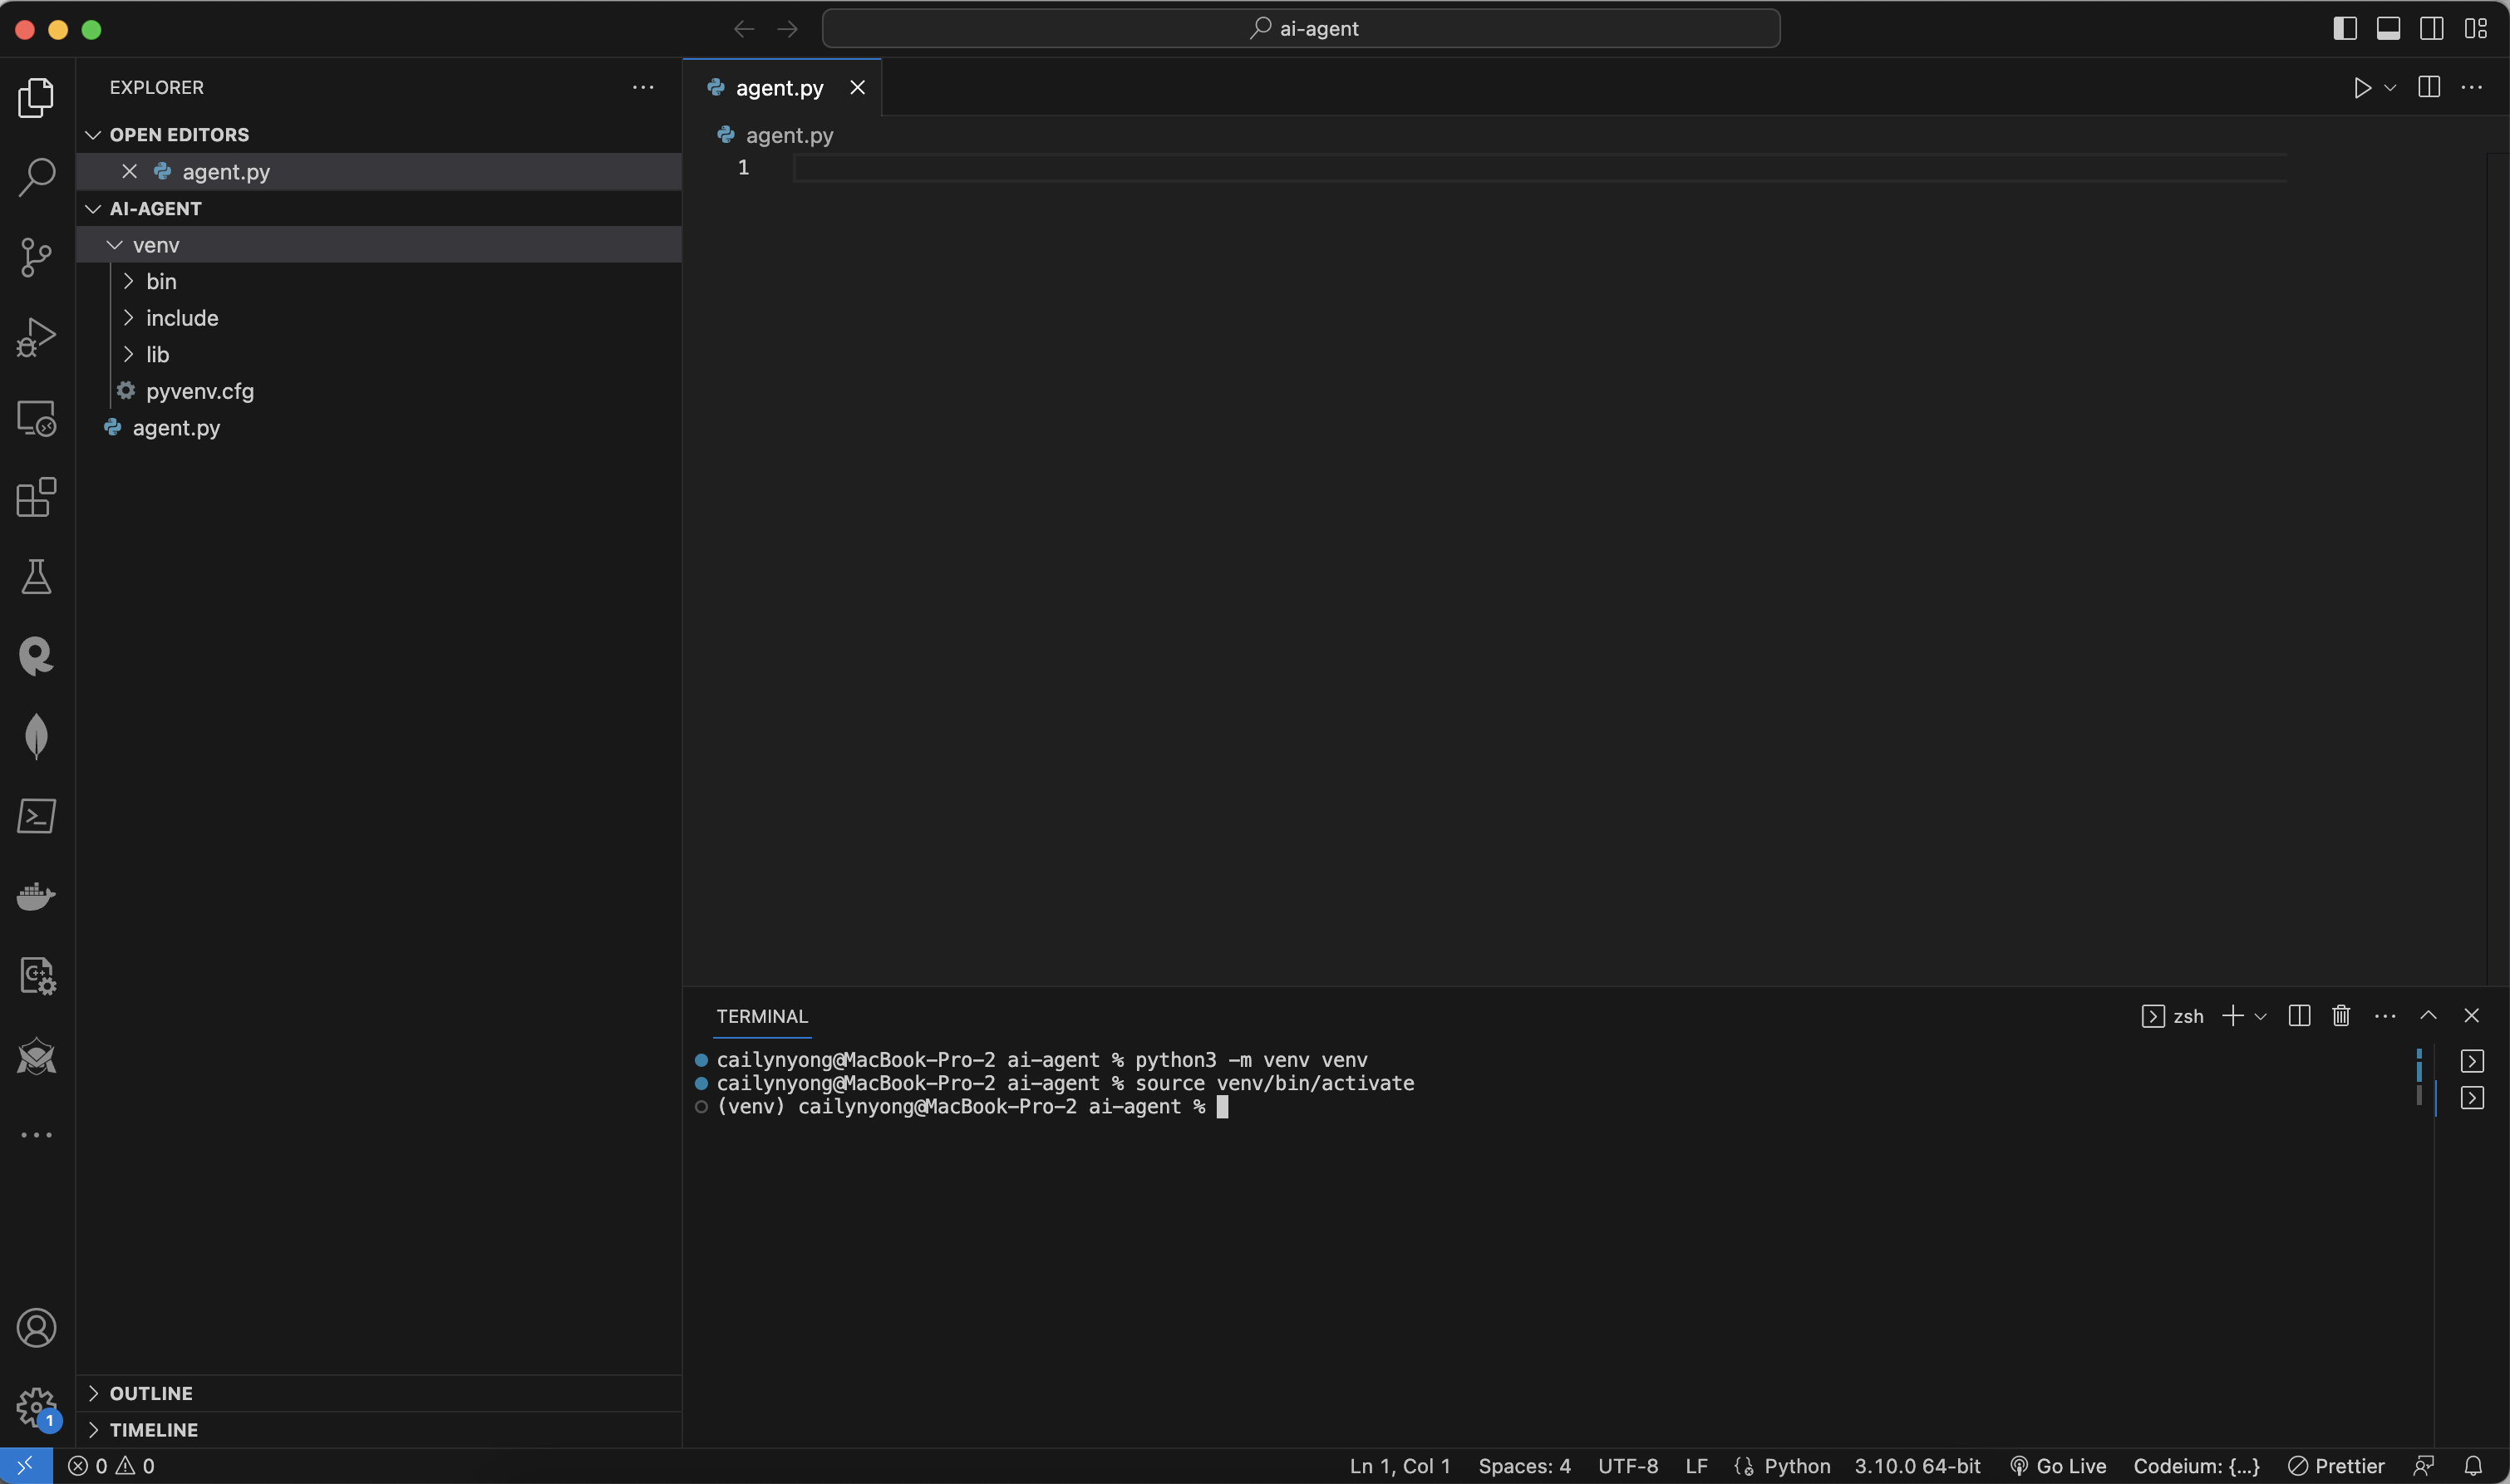
터미널에 source venv/bin/activate라는 명령어를 입력해주세요.

Screenshot 2023-08-16 at 4.55.29 PM.png그럼 성공적으로 터미널에 (venv) cailynyongyong@MacBook-Pro-2 ai-agent 라는게 뜹니다. 가상 환경에 들어왔다는 뜻입니다.

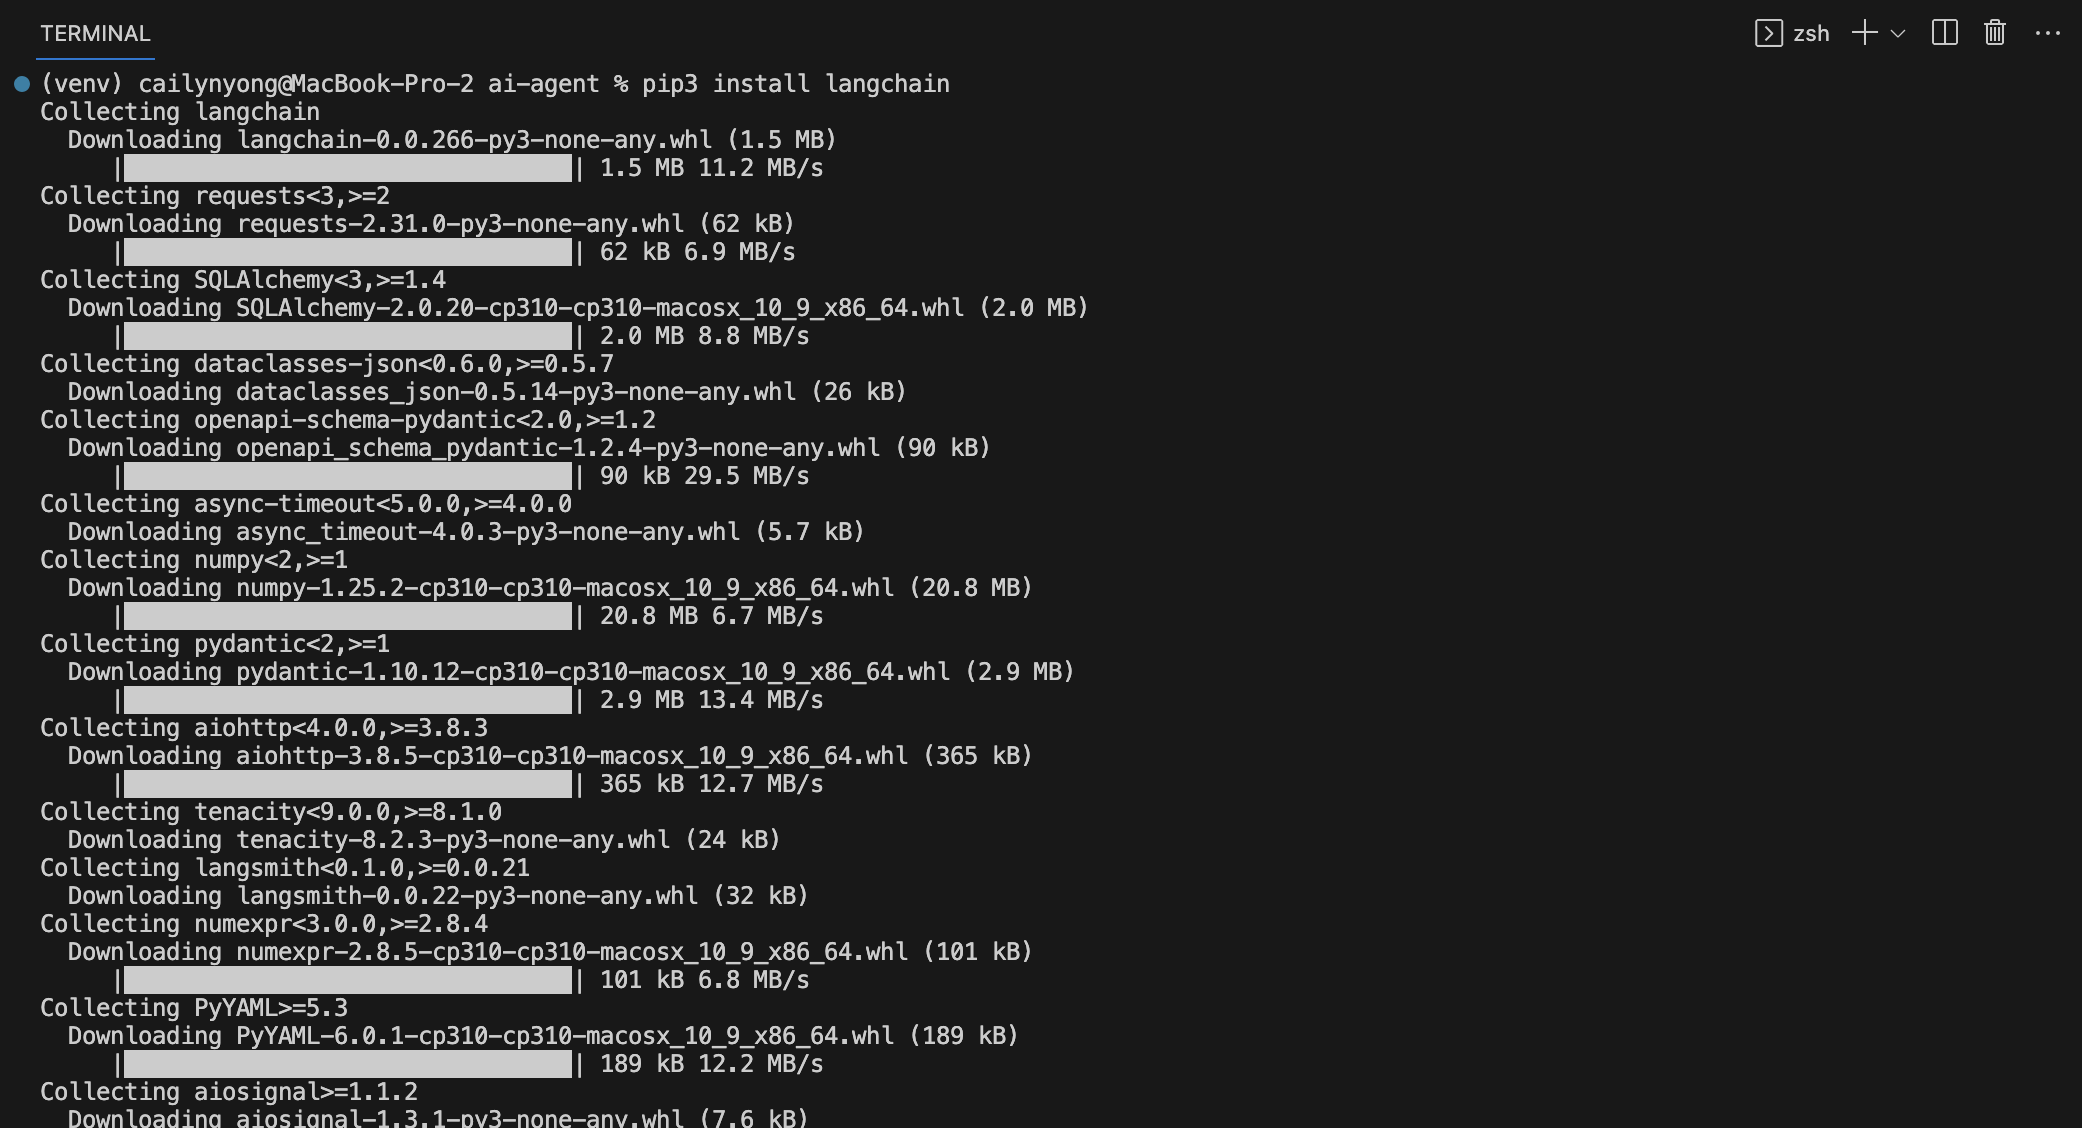
다음으로 터미널에 다음의 명령들을 순서대로 실행합니다.

pip install langchain
pip install openai
pip install faiss-cpu > /dev/null
pip install tiktoken

예를 들어 pip install langchain을 실행하면 다음과 같이 다운로드가 진행되는게 보일겁니다.

Screenshot 2023-08-16 at 6.24.23 PM.png이제 코드를 작성해봅시다!

OpenAI API key 연결, Vector Store 연결

이제 본격적으로 에이전트를 코딩하기 위한 모든 셋업을 할겁니다. 한번에 다 이해 못해셔도 괜찮으니, 코드를 그대로 복붙하시면서 일단 해보는걸 추천드립니다! 저도 그렇게 배웠거든요 ㅎㅎ

처음에는 에이전트를 만들기 위해 필요한 툴들을 불러와야 해요. 이걸 module, 혹은 library라고 푸릅니다. 항상 개발을 할때에는 프로젝트에 필요한 적절한 모듈들을 불러옵니다. 레고처럼 필요한 부품들만 갖고와서 맞추는 것 처럼요.

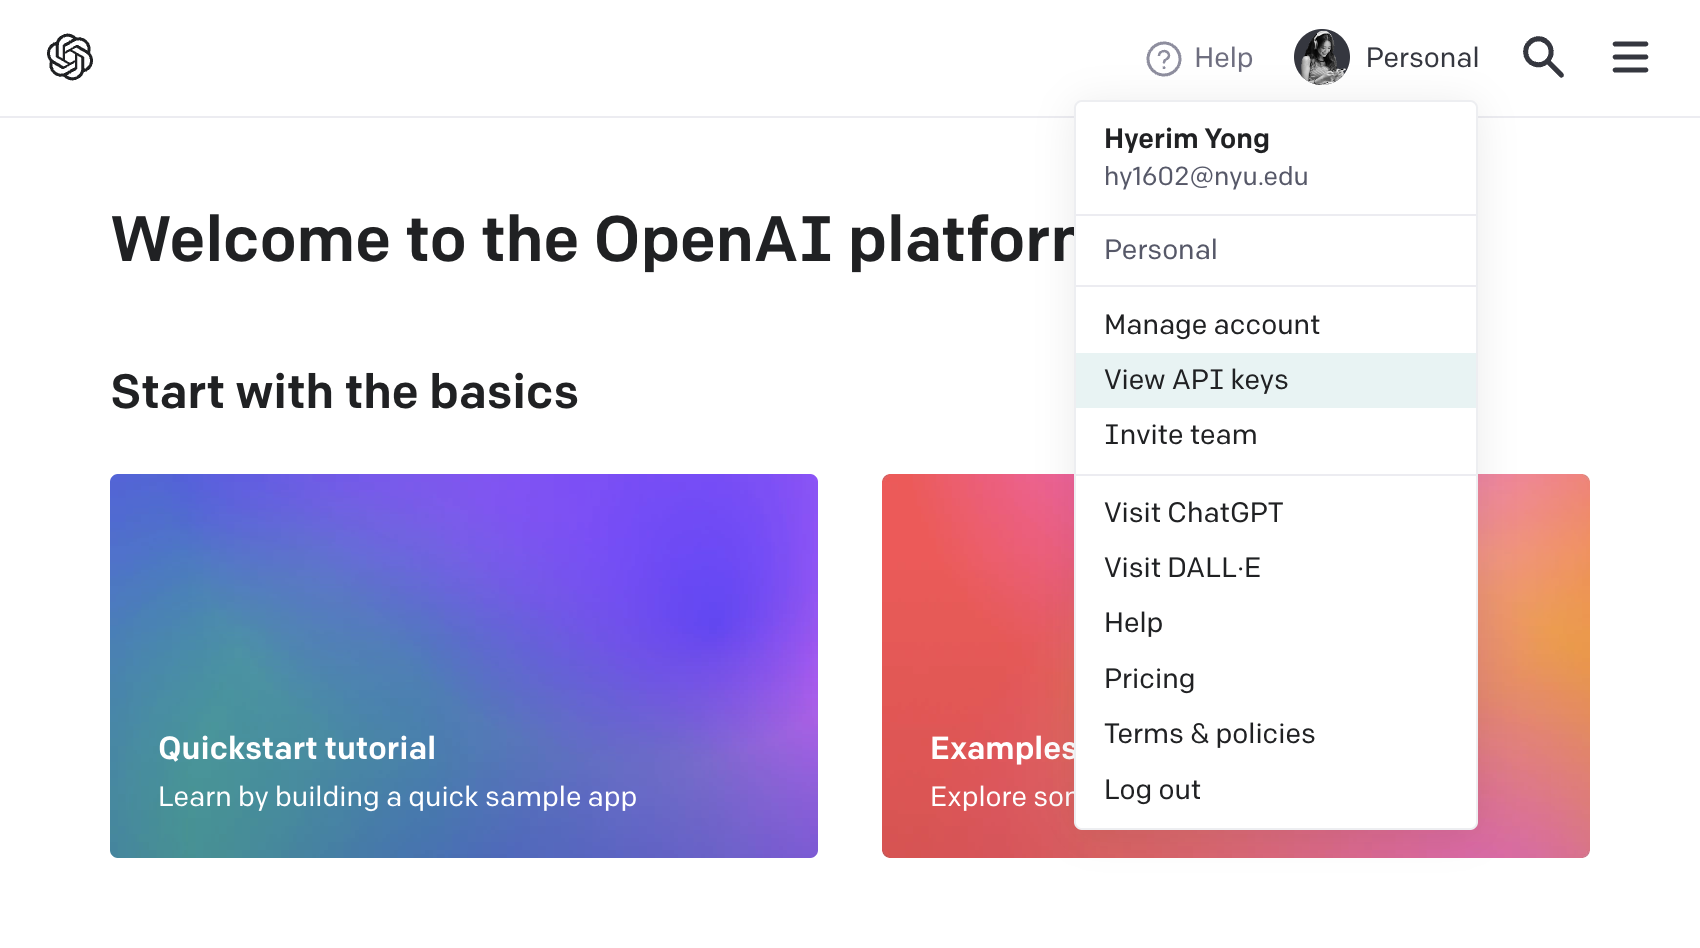
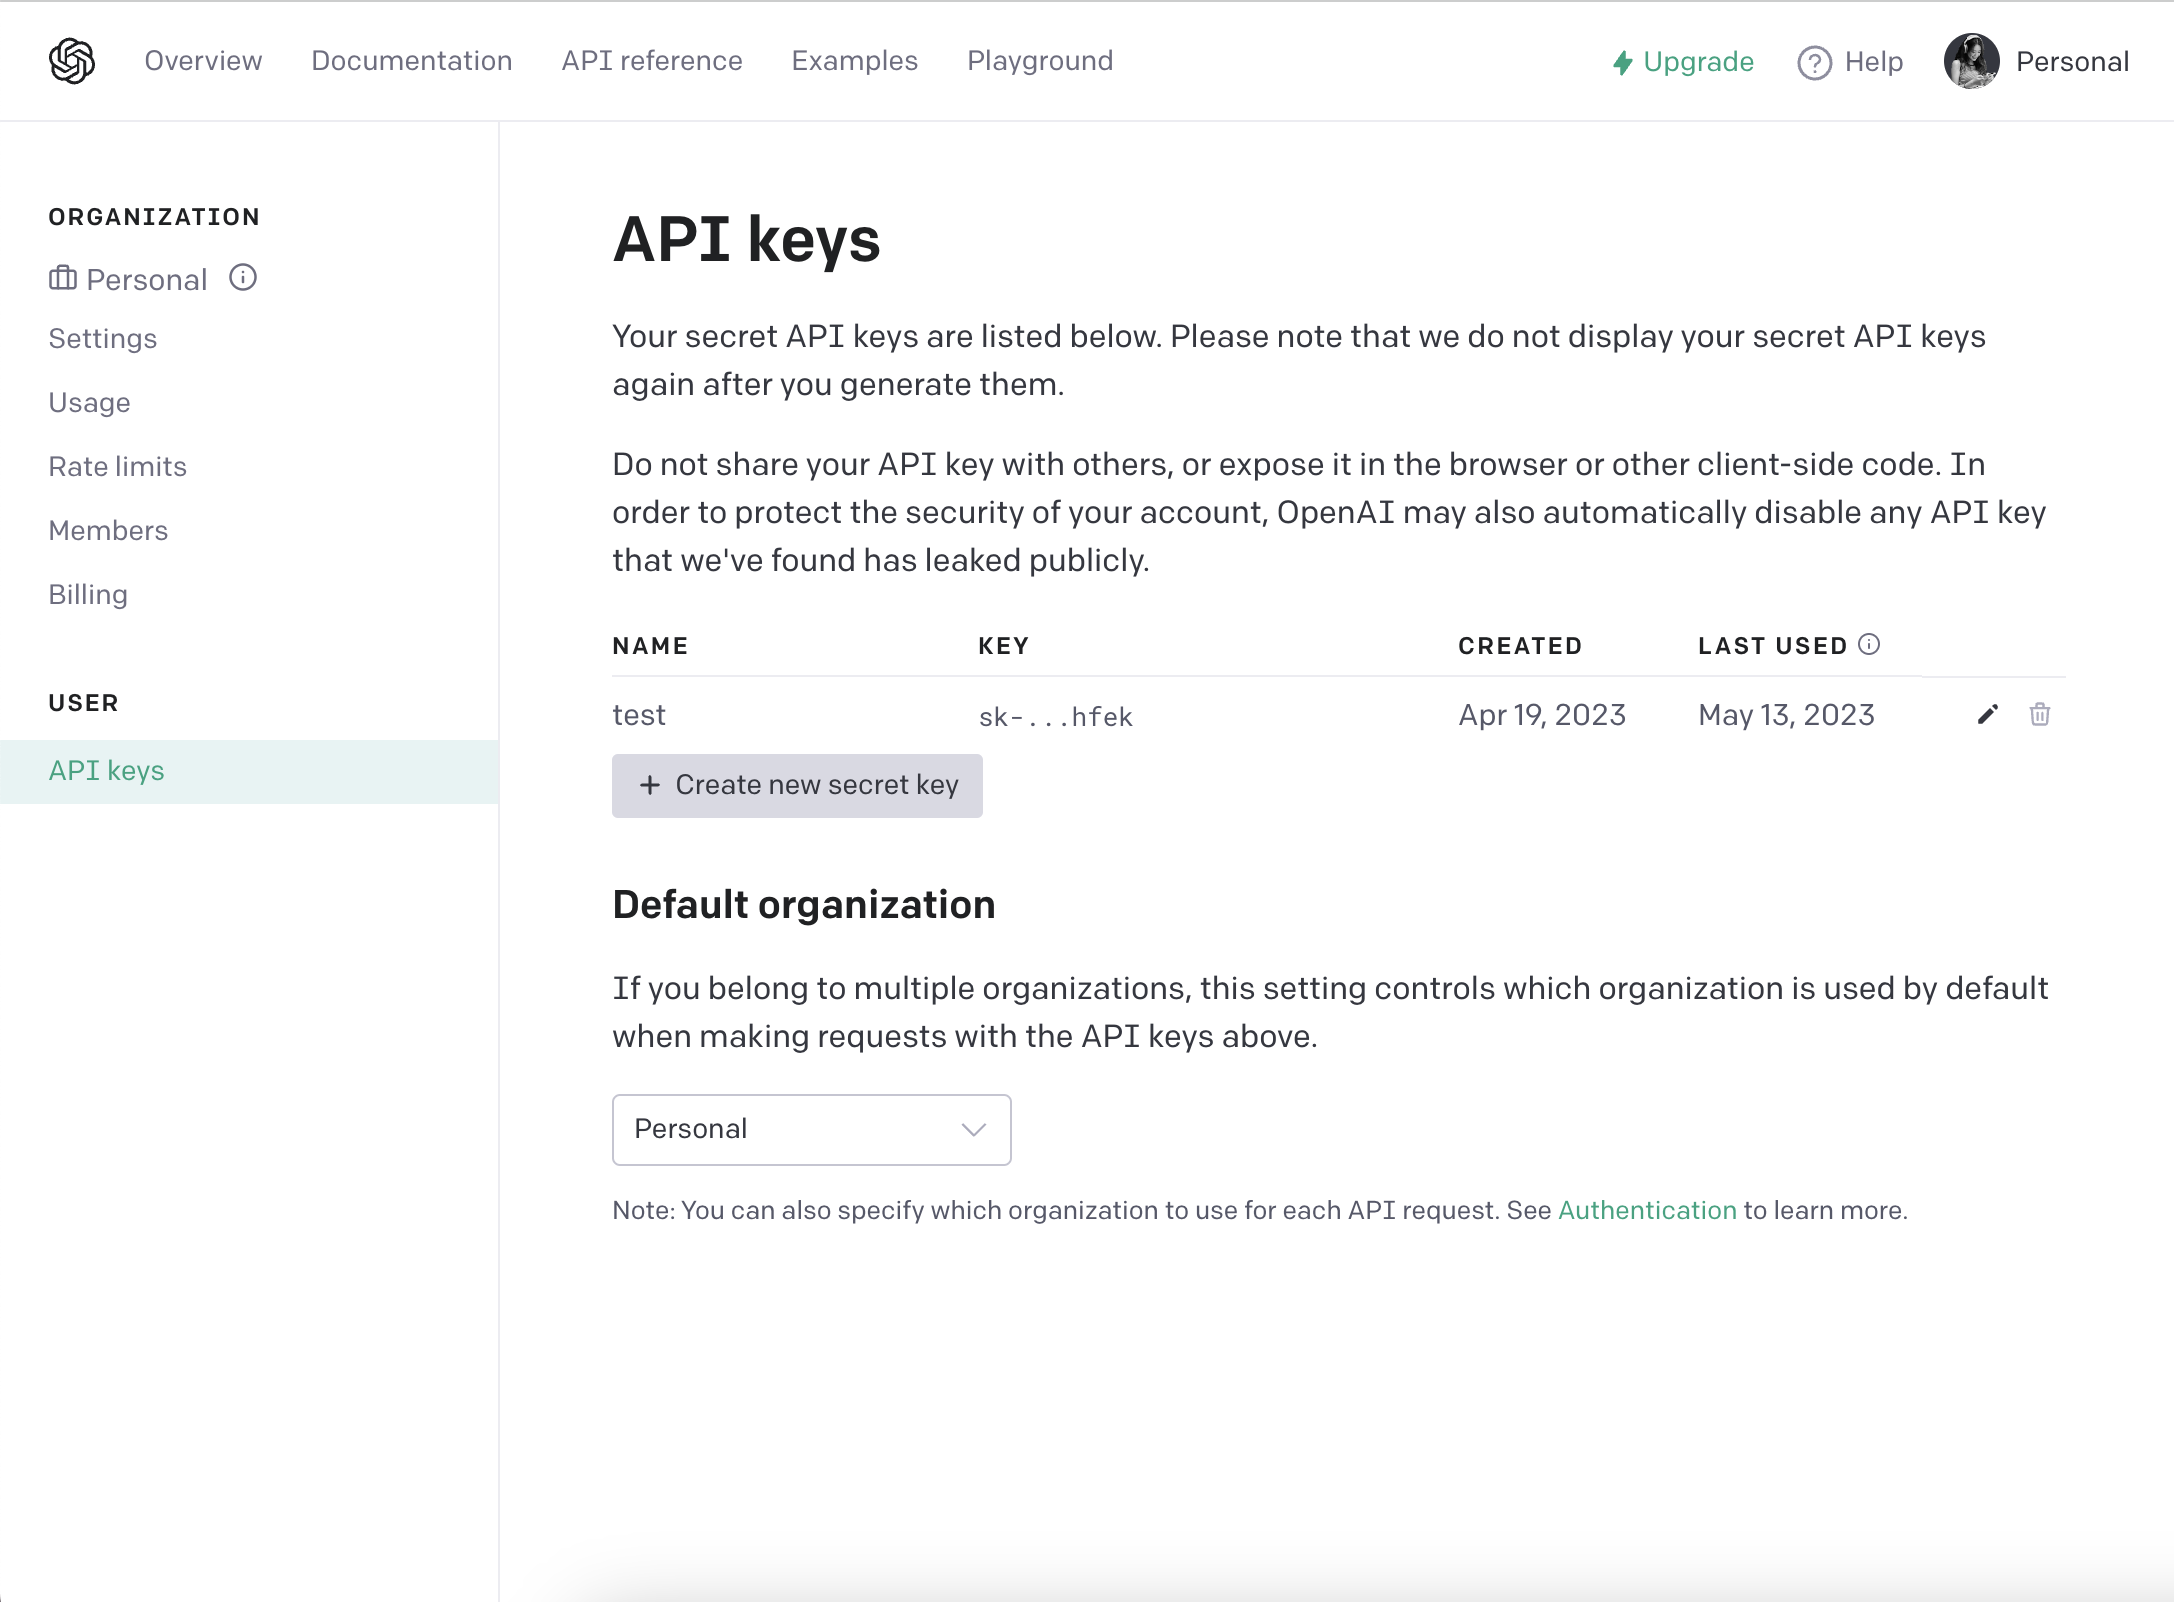
저희는 OpenAI의 모듈들을 쓸거여서 OpenAI API Key라는 것을 써야합니다. OpenAI 웹사이트에서 계정을 만든 후 https://platform.openai.com/overview 이 곳에 들어갑니다. 상단 오른쪽에서 Personal 버튼 위에 허버하고 View API Keys를 눌러주세요.

Screenshot 2023-08-16 at 6.27.59 PM.png이 페이지에 들어오면 “Create new secret key”를 누르세요.
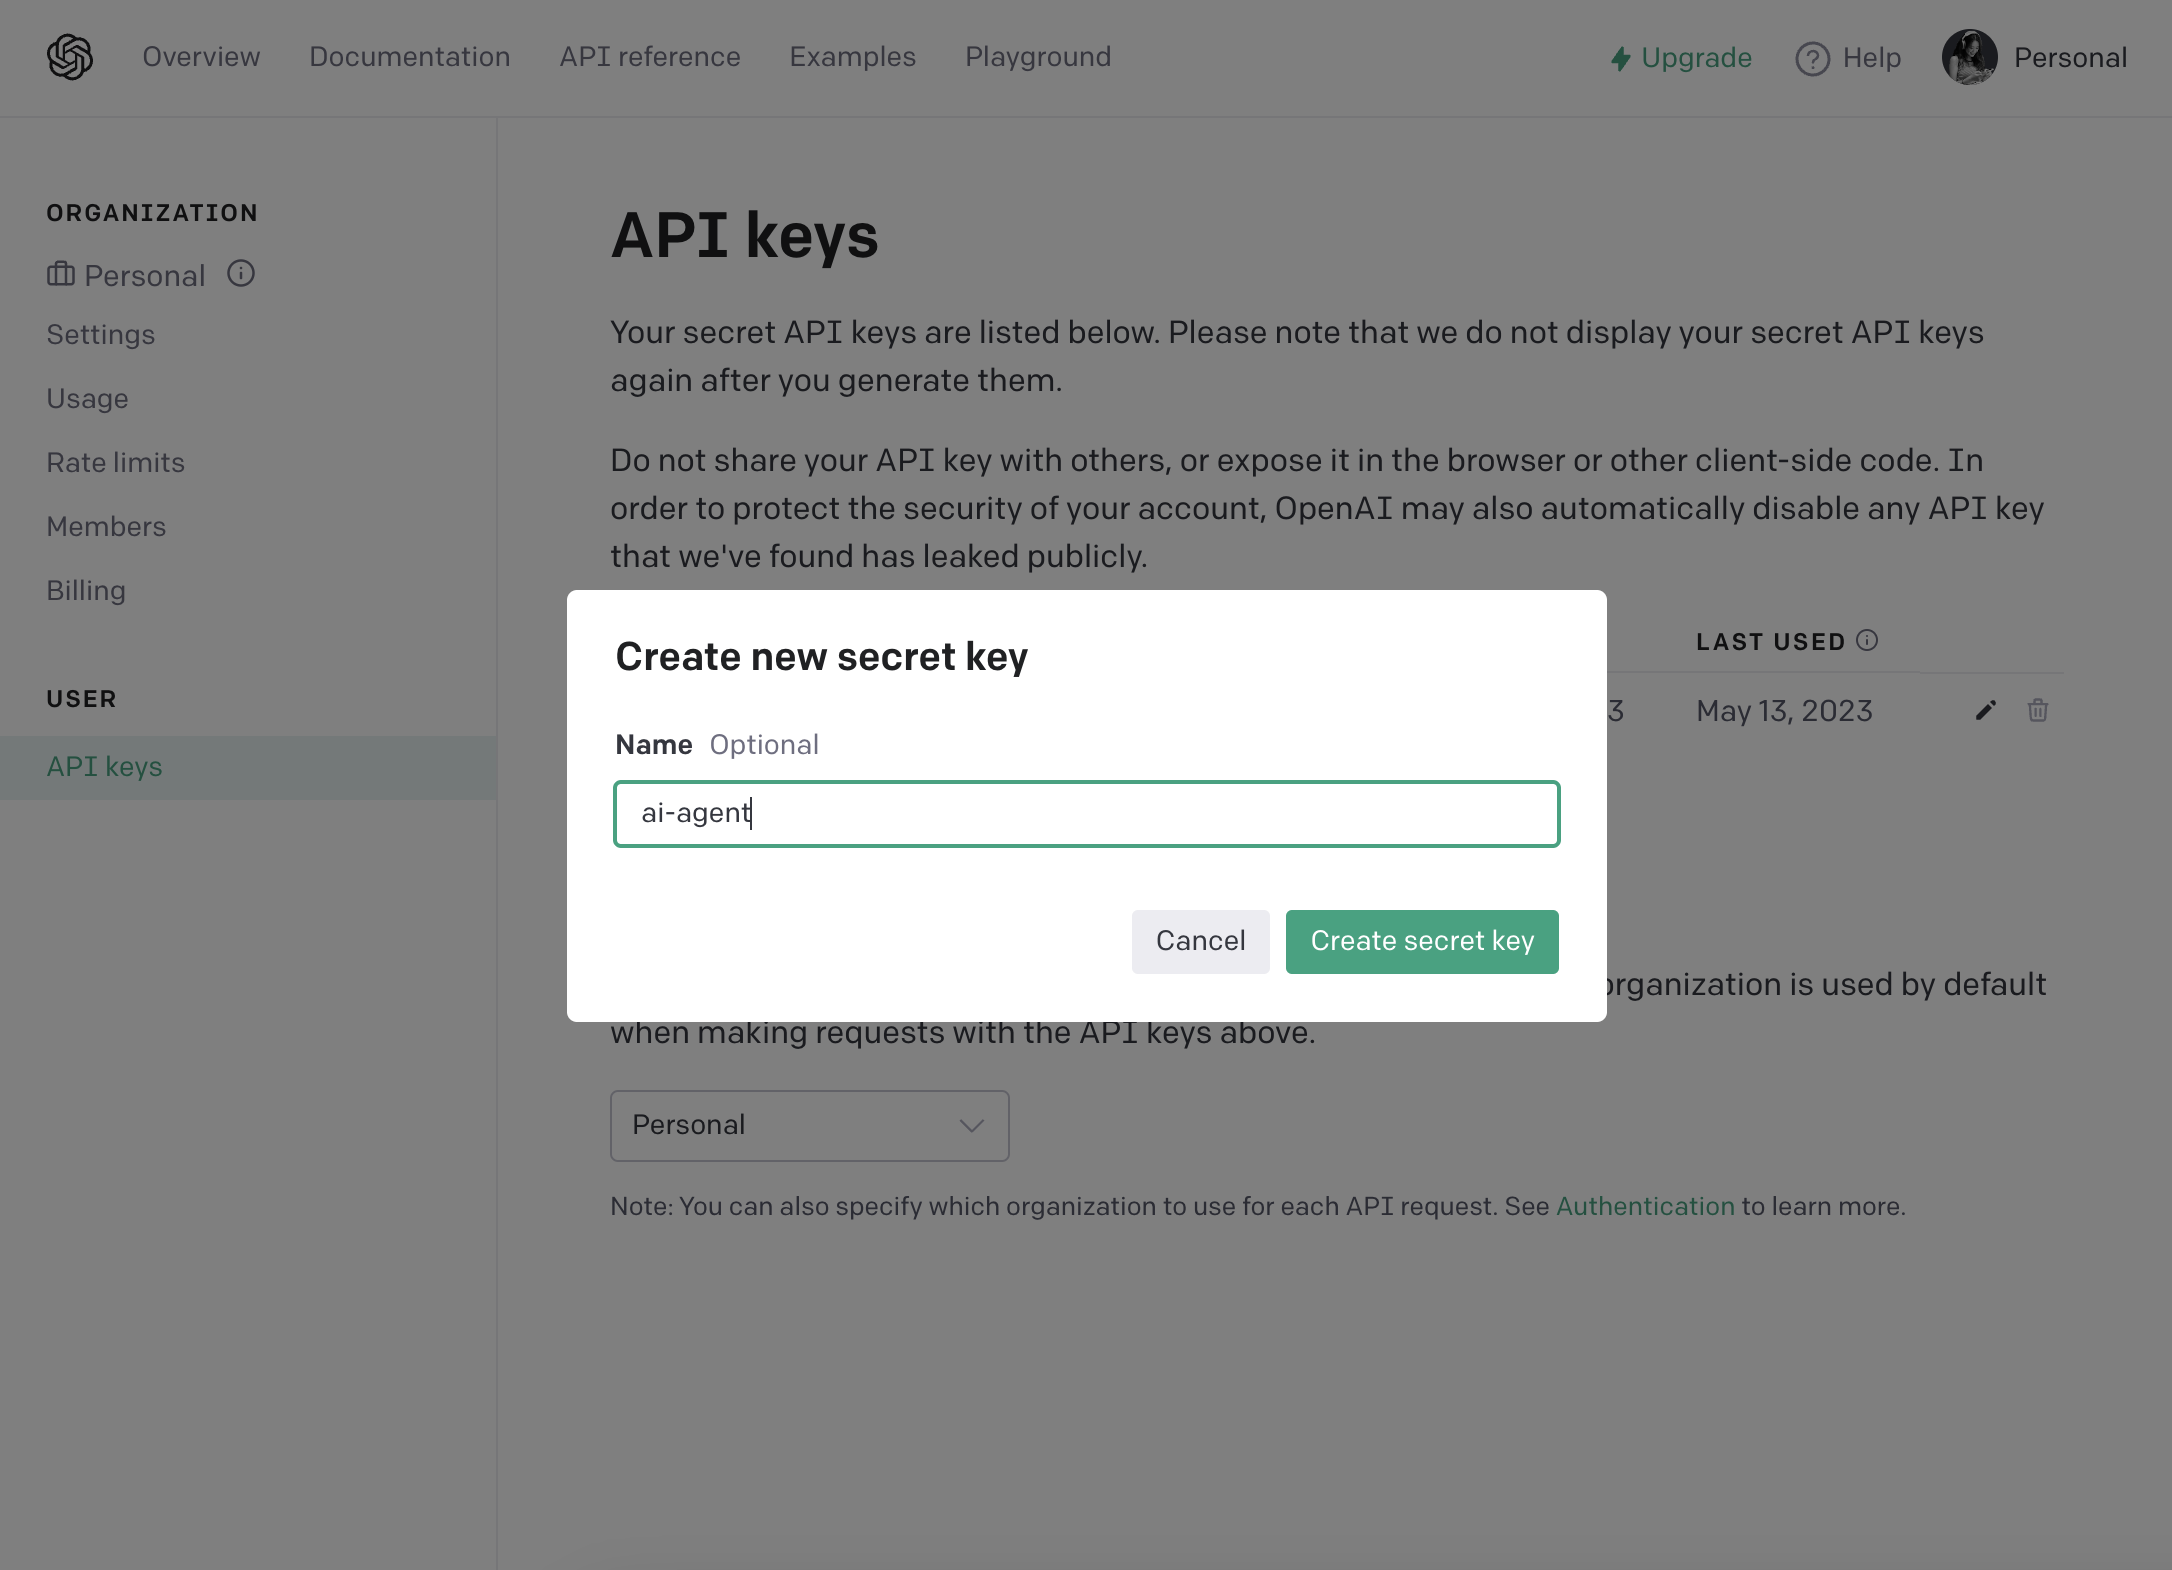
Screenshot 2023-08-16 at 6.29.57 PM.pngai-agent라는 이름으로 만들고 초록색 버튼을 누르세요. 버튼을 누르면 새로운 secret key가 생성되는데, 바로 복사해서 다른 곳에 저장해두세요. 다시 열어서 볼 수 없거든요. 이 키는 꼭 다른 사람과 공유하지 마세요! 일종의 OpenAI 비밀번호입니다.
Screenshot 2023-08-16 at 6.30.09 PM.png이 키를 이제 어디다가 쓸거냐, 밑에 코드 두번째 줄에 os.environ[”OPENAI_API_KEY”] = “ “ 보이시죠? “ “ 안에 방금 복사한 secret key를 넣습니다.

import os
os.environ["OPENAI_API_KEY"] = " "
from collections import deque
from typing import Dict, List, Optional, Any

from langchain.llms import OpenAI
from langchain.chains import LLMChain
from langchain.prompts import PromptTemplate
from langchain.embeddings import OpenAIEmbeddings
from langchain.llms import BaseLLM
from langchain.vectorstores.base import VectorStore
from pydantic import BaseModel, Field
from langchain.chains.base import Chain

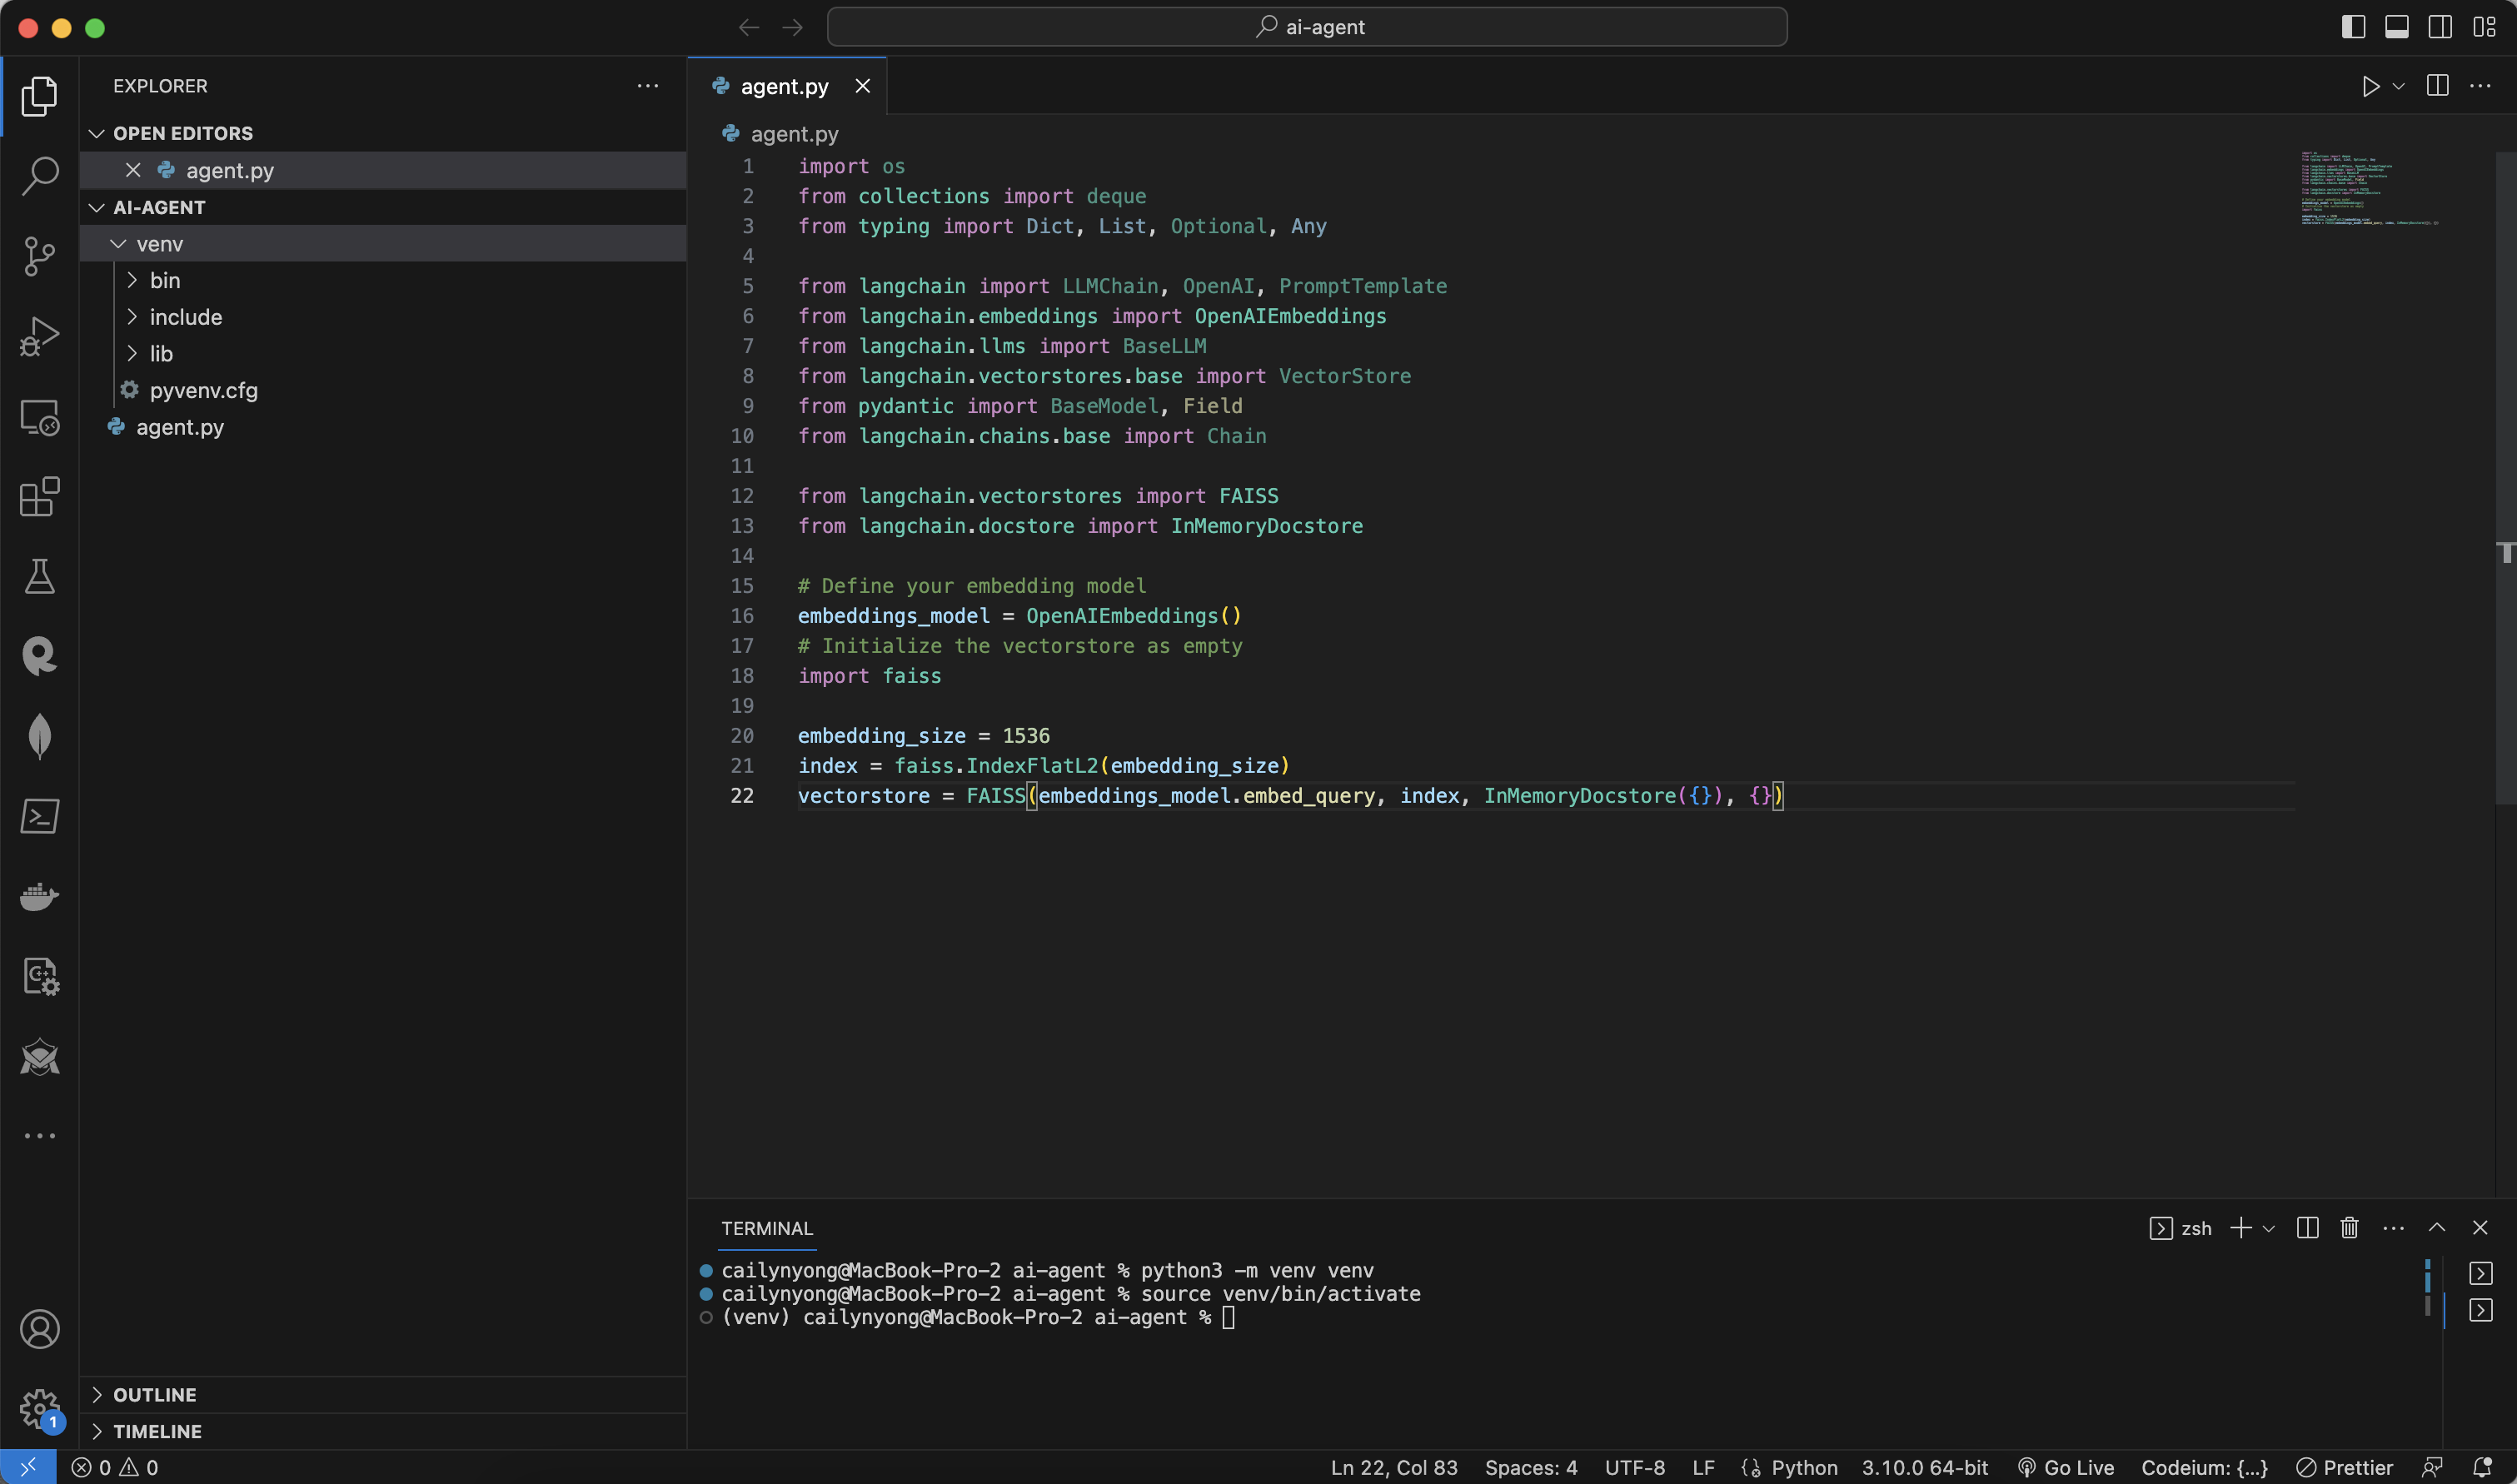
이 코드를 그대로 복사해서 agent.py에 붙입니다.

Screenshot 2023-08-16 at 5.03.43 PM.png각 줄별로 어떤 것을 뜻하는지 이해하기보다는, ‘아 이 에이전트를 만들기 위해서는 이런 모듈들을 불러와야하는구나’라고 알기만 하면 됩니다. 기본적으로 우리는 랭체인을 써서 LLM 체인을 직접 커스터마이징해서 쓸거기 때문에 from langchain import LLMChain, OpenAI 라는 코드가 있습니다. 이 말은 langchain이라는 곳에서 LLMChain, OpenAI 모듈들을 불러와서 쓸거다 라는 뜻이죠.
Vector Store 셋업

다음 스텝은 Vector Store라는 것을 쓰기 위해 추가적으로 불러와야할 모듈들이 있습니다. Vector Store라는 것은 커스텀 LLM을 쓸 때 효율적으로 데이터를 저장하고 불러올 수 있는 공간을 마련해주는 것입니다.

저희는 FAISS라는 Vector Store를 쓸거에요.

from langchain.vectorstores import FAISS
from langchain.docstore import InMemoryDocstore

필요한 모듈들을 불러옵니다. 복사해서 agent.py에 붙여넣으세요.

다음 이 vector store를 내 코드와 연결시키기 위해 이 코드를 작성합니다.

# Define your embedding model
embeddings_model = OpenAIEmbeddings()
# Initialize the vectorstore as empty
import faiss

embedding_size = 1536
index = faiss.IndexFlatL2(embedding_size)
vectorstore = FAISS(embeddings_model.embed_query, index, InMemoryDocstore({}), {})

Vector embedding은 텍스트, 이미지, 오디오와 같은 숫자가 아닌 데이터들을 컴퓨터가 알아듣기 쉽게 숫자화한 형태입니다. 이 embedding들이 vector store에 저장되는거구요.

저희는 embedding model을 OpenAIEmbeddings()라는 모델을 쓸겁니다.

그 다음 vector store를 초기 셋업합니다.

  • import faiss: faiss 벡터 스토어 불러오기

  • embedding_size = 1536: embedding size를 1536으로 합니다.

  • index = faiss.IndexFlatL2(embedding_size): faiss에 이 사이즈로 셋업을 할거라고 알려줍니다.

  • vectorstore = FAISS(embeddings_model.embed_query, index, InMemoryDocstore({}), {}): 이런 기초 작업들을 거친 후 맨 마지막 줄에서 vectorstore를 성공적으로 셋업합니다.

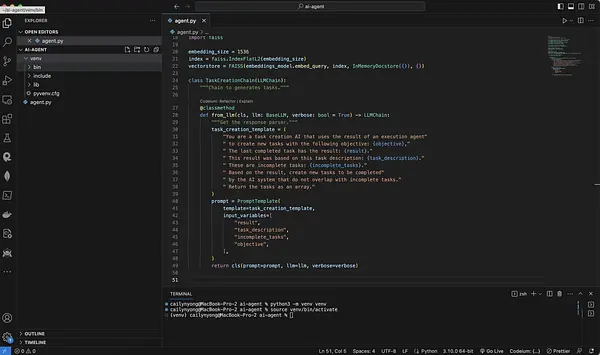
다 복붙하면 코드는 이렇습니다.

Screenshot 2023-08-16 at 5.19.58 PM.pngPart 1 마무리

이로써 Part 1은 끝났습니다! 전체적인 셋업을 했으니 이제 다음 파트에서는 직접 커스텀 LLM 체인들을 만들어줄거에요.

하면서 어려움을 겪었거나 질문이 있으시면 포스트에 댓글 남겨주시거나 커피챗 요청주세요. 그 외 앞으로 올라왔으면 하는 AI 주제들이 있으면 댓글 남겨주세요!

10X AI Club의 첫번째 글 읽어주셔서 감사합니다.

더 많은 AI 사이드프로젝트들의 개발 방법에 대해 배우고 싶다면 10X AI University 신청을 해주세요!

https://dis.qa/bQCLPw

40
26