임세진

임세진님의 아티클

임세진

임세진

빠르고 정확한 선택은 정말 어렵다

스타트업은 늘 생존에 집중해야 한다고 생각해요.

실제로, 생존확률과 신기록 돌파 확률은 이론 상 거의 동일하게 취급이 돼요.

그러기 위해서는 정말 빠르고 정확한 수많은 운영적, 기술적 판단들이 필요하게 돼요.

예전에는 정확한 판단에 집중을 했어요. 이정도로 많은 선택이 주어지기 전에는요.

정말 많은 선택 상황이 오면 빠른 판단을 하되 정확도는 떨어질 수 밖에 없어요.

판단의 정확도는 우선 빠른 판단 하에 회고를 통해 정정되어야 하는 부분이 되어버렸어요.

예를 들어, AI 모델을 사용할 때도 여러 모델을 결합해서 쓸지, 하나의 모델로 해결하는게 나을 지, 데이터는 충분히 있는지, 존재하는 데이터 특성이 현재 우리 서비스에 적합한지, 등 고려해야 할 게 정말 많더군요..

이외에도 데이터 분석을 위해 필요한 항목들이 무엇이 있는지, 이 데이터 분석이 어떤 부분을 개선하기 위해 필요한건지, 등

수많은 고민과 선택의 순간들에 있어서 삐끗하면 생존확률과 신기록 돌파 가능성이 낮아짐을 잊지 않기를 바래보며 글을 남겨봅니다.

2
2
임세진

임세진

가려움이 없는 가려움추적기 개발자

안녕하세요.

저는 가려움 증상이 없는 가려움추적기 테크 리드입니다.

결국 제대로 된 서비스를 만들기 위해서는 고객의 고충을 이해하고 있어야 한다고 생각합니다. 그러나, 저는 안타깝게도 고객의 고충을 충분히 이해할 수 없는 상황입니다. 그렇다고 그 고통스러운 가려움을 제가 직접 겪는 것은 피하고 싶습니다.

제가 가려움추적기 팀에 합류한 뒤로 틈이 나면 대체 어떻게 가려움 증상에 공감을 하는 것이 진정한 공감과 가까워질 수 있을까 고민을 해보고 있습니다.

현재까지 고민해본 결과는 다음과 같습니다.

  1. 내가 겪고 있는 최대의 아픔과 비교해볼 것

  2. 최대의 아픔을 기억하면서 가려움 증상을 앓고 있는 고객들과 최대한 소통해볼 것

  3. 가려움 증상을 해소하는 데 있어서 개발적인 측면에서 어떤 디테일한 것들이 있을지 고민해볼 것

결국 서비스를 개발한다는 것의 의미는 어찌보면 이타적인 행위이고 숭고한 행위라고 생각을 하고 있습니다. 더욱 더 공감하는 개발자가 되어야겠습니다.

2
0
임세진

임세진

경쟁력 있는 AI 제품이 되기 위해서

안녕하세요. 딜랏의 테크니컬 리더 임세진입니다.

시간이 지날수록 AI 자체 기술을 보유한 기업들의 입지가 확고해지고 있는 것 같습니다. 그리고 수많은 AI 기술들이 실제 서비스에 사용하기 쉽게 개발되고 있죠.

수많은 스타트업들을 포함한 기업들이 이런 AI 빅테크 기업들보다 이미 AI 기술력 개발 시작이 뒤쳐진 시점에서 앞으로 무엇을 해야하는가에 대한 질문이 나올 수 있습니다. 좌절감은 덤으로 생길 수도 있어요.

그래서 더더욱 AI 서비스를 만들고 싶다고 개발을 시작하는 것이 아니라, 만들고 싶은 서비스가 있고 과연 그 서비스에 AI가 필요한가?에 대한 접근 방법이 중요해지는 것 같습니다.

자체적인 사용자들의 생태계가 이미 구축이 되어 있는 경우면 AI 도입을 검토하기 전에 최종적으로 이 서비스 생태계의 미래의 모습을 그려보고, 그 미래의 모습에 AI가 꼭 있어야만 하는지 검토하는 것이 좋아보입니다.

AI 기술의 활용은 정말 중요한 것 같습니다. 하지만 기업의 자원이 만만치 않게 소모되기 때문에 적절하게 AI를 적용해야 하는 부분들을 최적화해서 활용하는 것이 중요한 것 같습니다.

가려움추적기

생성형 인공지능(AI) 기술을 접목한 '환경데이터 기반 초개인화 가려움증 완화 및 예보 솔루션'

5
0
임세진

임세진

가려움 원인을 찾아서

가벼운 인사말

안녕하세요. 임세진입니다.

얼마 전까지 휴튼 소속으로만 글을 올렸었는데, 어느덧 딜랏에 합류하게 되어 가려움의 원인을 파헤치고 있어요. 하는 업무 내용은 휴튼과 딜랏과 크게 다르지는 않은 것 같아요. 문제를 풀기 위해서 골머리를 싸매는 것도 같구요.

저는 휴튼을 통해 만나뵐 수도 있고, 딜랏을 통해 만나뵐 수도 있어요. 언제든지 관련 문의 사항은 커피챗 주세요!

딜랏이 풀고자 하는 문제

bomi_run.gif[딜랏 자체 디자인 - 열심히 달려가는 스타트업의 모습이라고 생각돼요!]

딜랏은 환경 문제로부터 파생된 여러 문제들을 풀고자 하는 팀이에요. 주변 환경의 급격한 변화, 및 환경 오염으로 인해 점점 사람들에게 피부질환들이 많이 발생하고 있어요. 그리고 원인이 불분명한 가려움 문제들도 점점 많아지고 있죠. 딜랏에서는 원인을 파악하기 어려운 가려움 문제를 결국 꾸준한 "관리"를 통해 해결할 수 있다고 생각하고 있어요.

어떻게 관리해야 하는가?

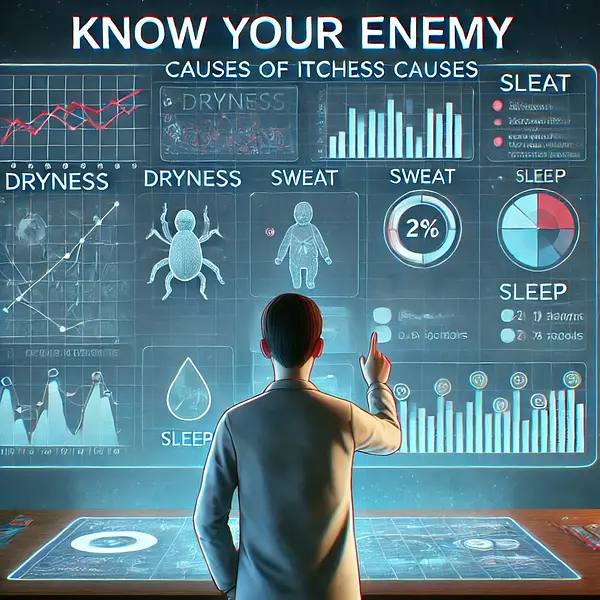
DALL·E 2024-10-22 17.00.18 - An animation-style visual representation showing a person analyzing causes of itchiness based on data, surrounded by visual elements like charts, grap.webp[아래 오는 문단에 대해 ChatGPT-4o로 생성한 이미지]

우선, 사용자의 꾸준한 기록을 바탕으로 가려움의 요인이 될 만한 요소들을 시각화해서 보여주는 것이 좋다고 생각하고 있어요. 지피지기 백전불패라는 말이 있듯이, "너(가려움)를 알고 나(가려움 원인)를 알면, 적어도 (가려움에게) 지지는 않는다."일 것이라는 생각이 들어요. 따라서, 간단한 데이터 분석을 기반으로 사용자가 한눈에 가려움 요인을 파악할 수 있는 것에 대해 고민을 하고 있어요.

잠시 재미있는 실험 데이터를 보실까요?

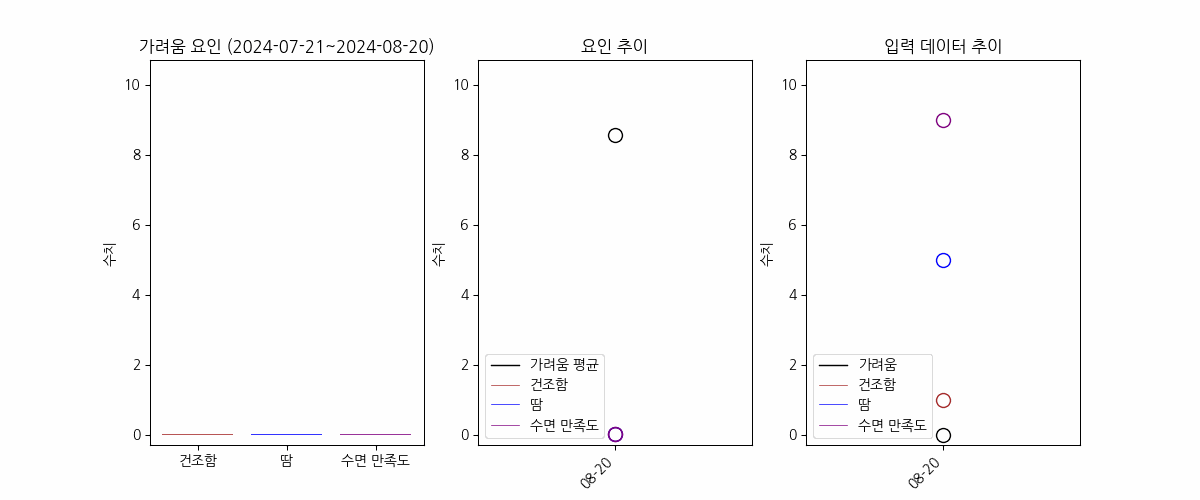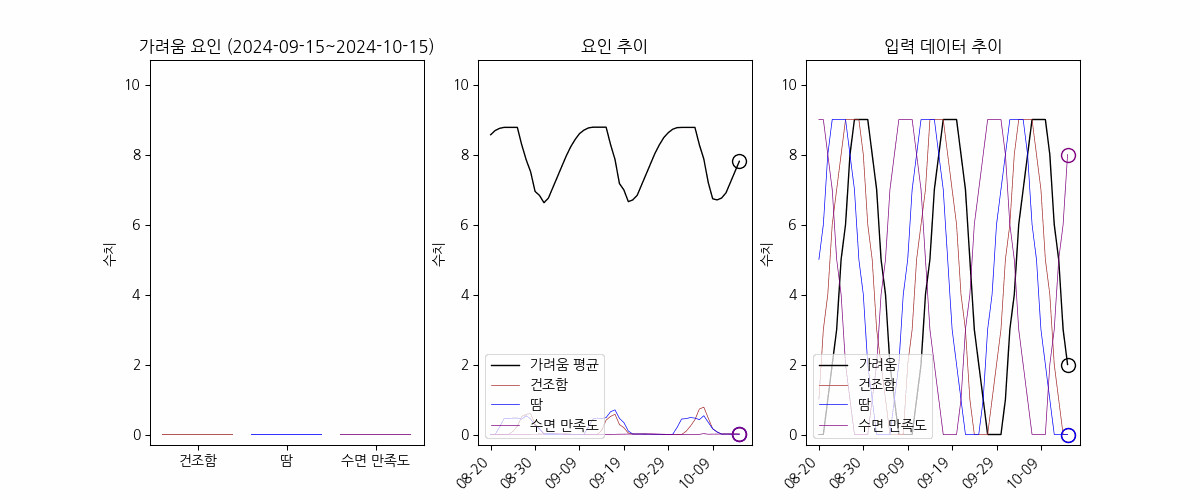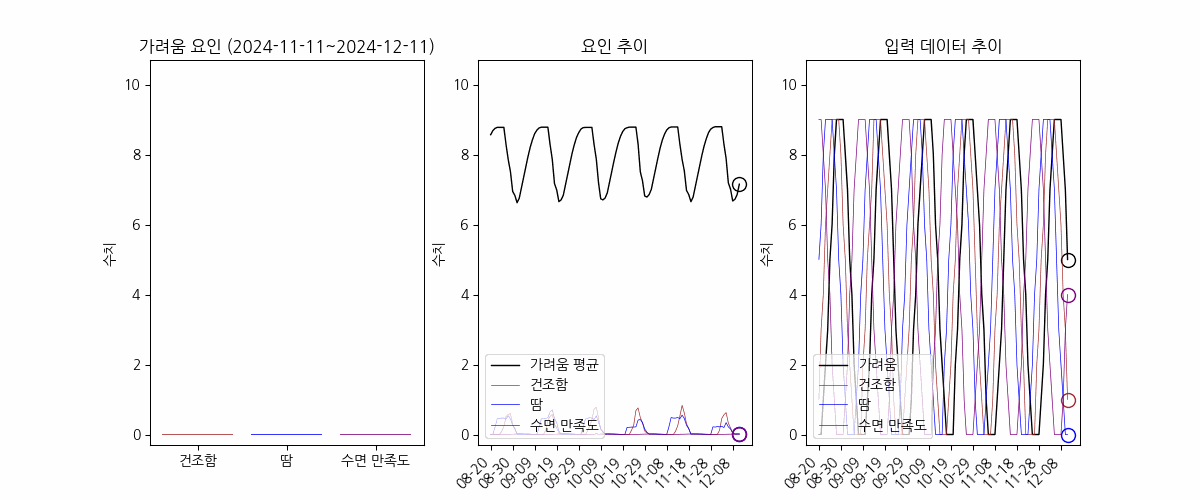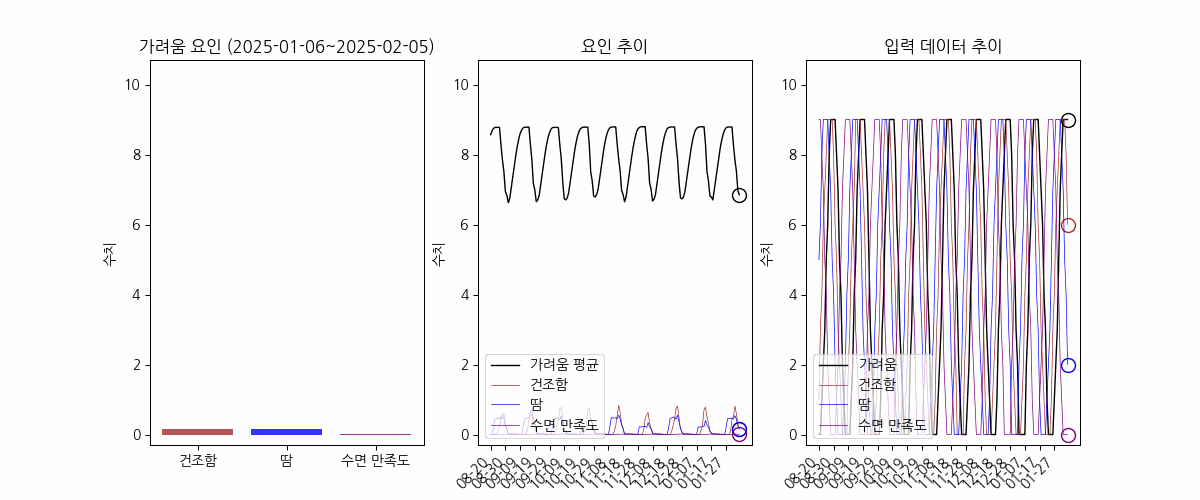
ItchFactor_IR (1).gif

  • 가장 우측에 오는 차트는("입력 데이터 추이") 가상의 사용자가 하루에 2회씩 주기 함수 형태로 입력한 데이터를 시간이 지남에 따라 보여주고 있어요.

  • 가운데 오는 차트는("요인 추이") 간단한 데이터 분석을 기반으로 가려움 수치에 영향을 주는 요인들의 중요도를 시간이 지남에 따라 보여주고 있어요.

  • 가장 좌측에 오는 차트는("가려움 요인") 요인 추이에서 가려움의 요인이 되는 "건조함", "땀", "수면 만족도"만 따로 막대 차트로 뽑아서 시각화한 자료예요.

    차트의 이해를 돕기 위해 간단하게만 설명을 추가 드리면,

    가려움 수치의 증가 직전에 건조함 수치의 증가가 있었고 그 바로 전에 땀 수치의 증가가 있었죠.

    따라서 상식적으로만 생각해보면, 건조함 요인이 가장 주된 요인이 되고, 그 다음으로 땀이 가려움의 요인이 될 것이라는 것을 알 수 있어요.

    수면 만족도의 경우에는, 수면 만족도가 높을수록 가려움 수치 증가에 반대로 영향이 줄 것이라는 가설이에요. 따라서 가려움 수치 증가 전에 수면 만족도 수치 증가가 있었음에도, 거의 요인으로 잡히지 않고 있어요.

마지막 인사말

저희 딜랏은 가려움을 위해 고생하시는 분들이 많다는 것을 알기에, 더욱 문제 해결에 집중하고 있어요.

더욱 몰입하고 더욱 집중하여 많은 분들의 가려움을 해결하는 팀이 될 수 있도록 노력할게요! 많관부~!

*** 추신 ***

최근 딜랏에서는 가려움 문제에 공감하며, 같이 고민하고 문제를 풀어나갈 "경력 디자이너" 분과 "신입 앱개발자" 분을 모시려고 하고 있어요. 자세한 내용은 커피챗으로 문의 주시면, 빠른 답장을 드리도록 하겠습니다! 감사합니다.

가려움추적기

생성형 인공지능(AI) 기술을 접목한 '환경데이터 기반 초개인화 가려움증 완화 및 예보 솔루션'

4
0
임세진

임세진

Values of Hanam 오프라인 네트워킹 1차 후기

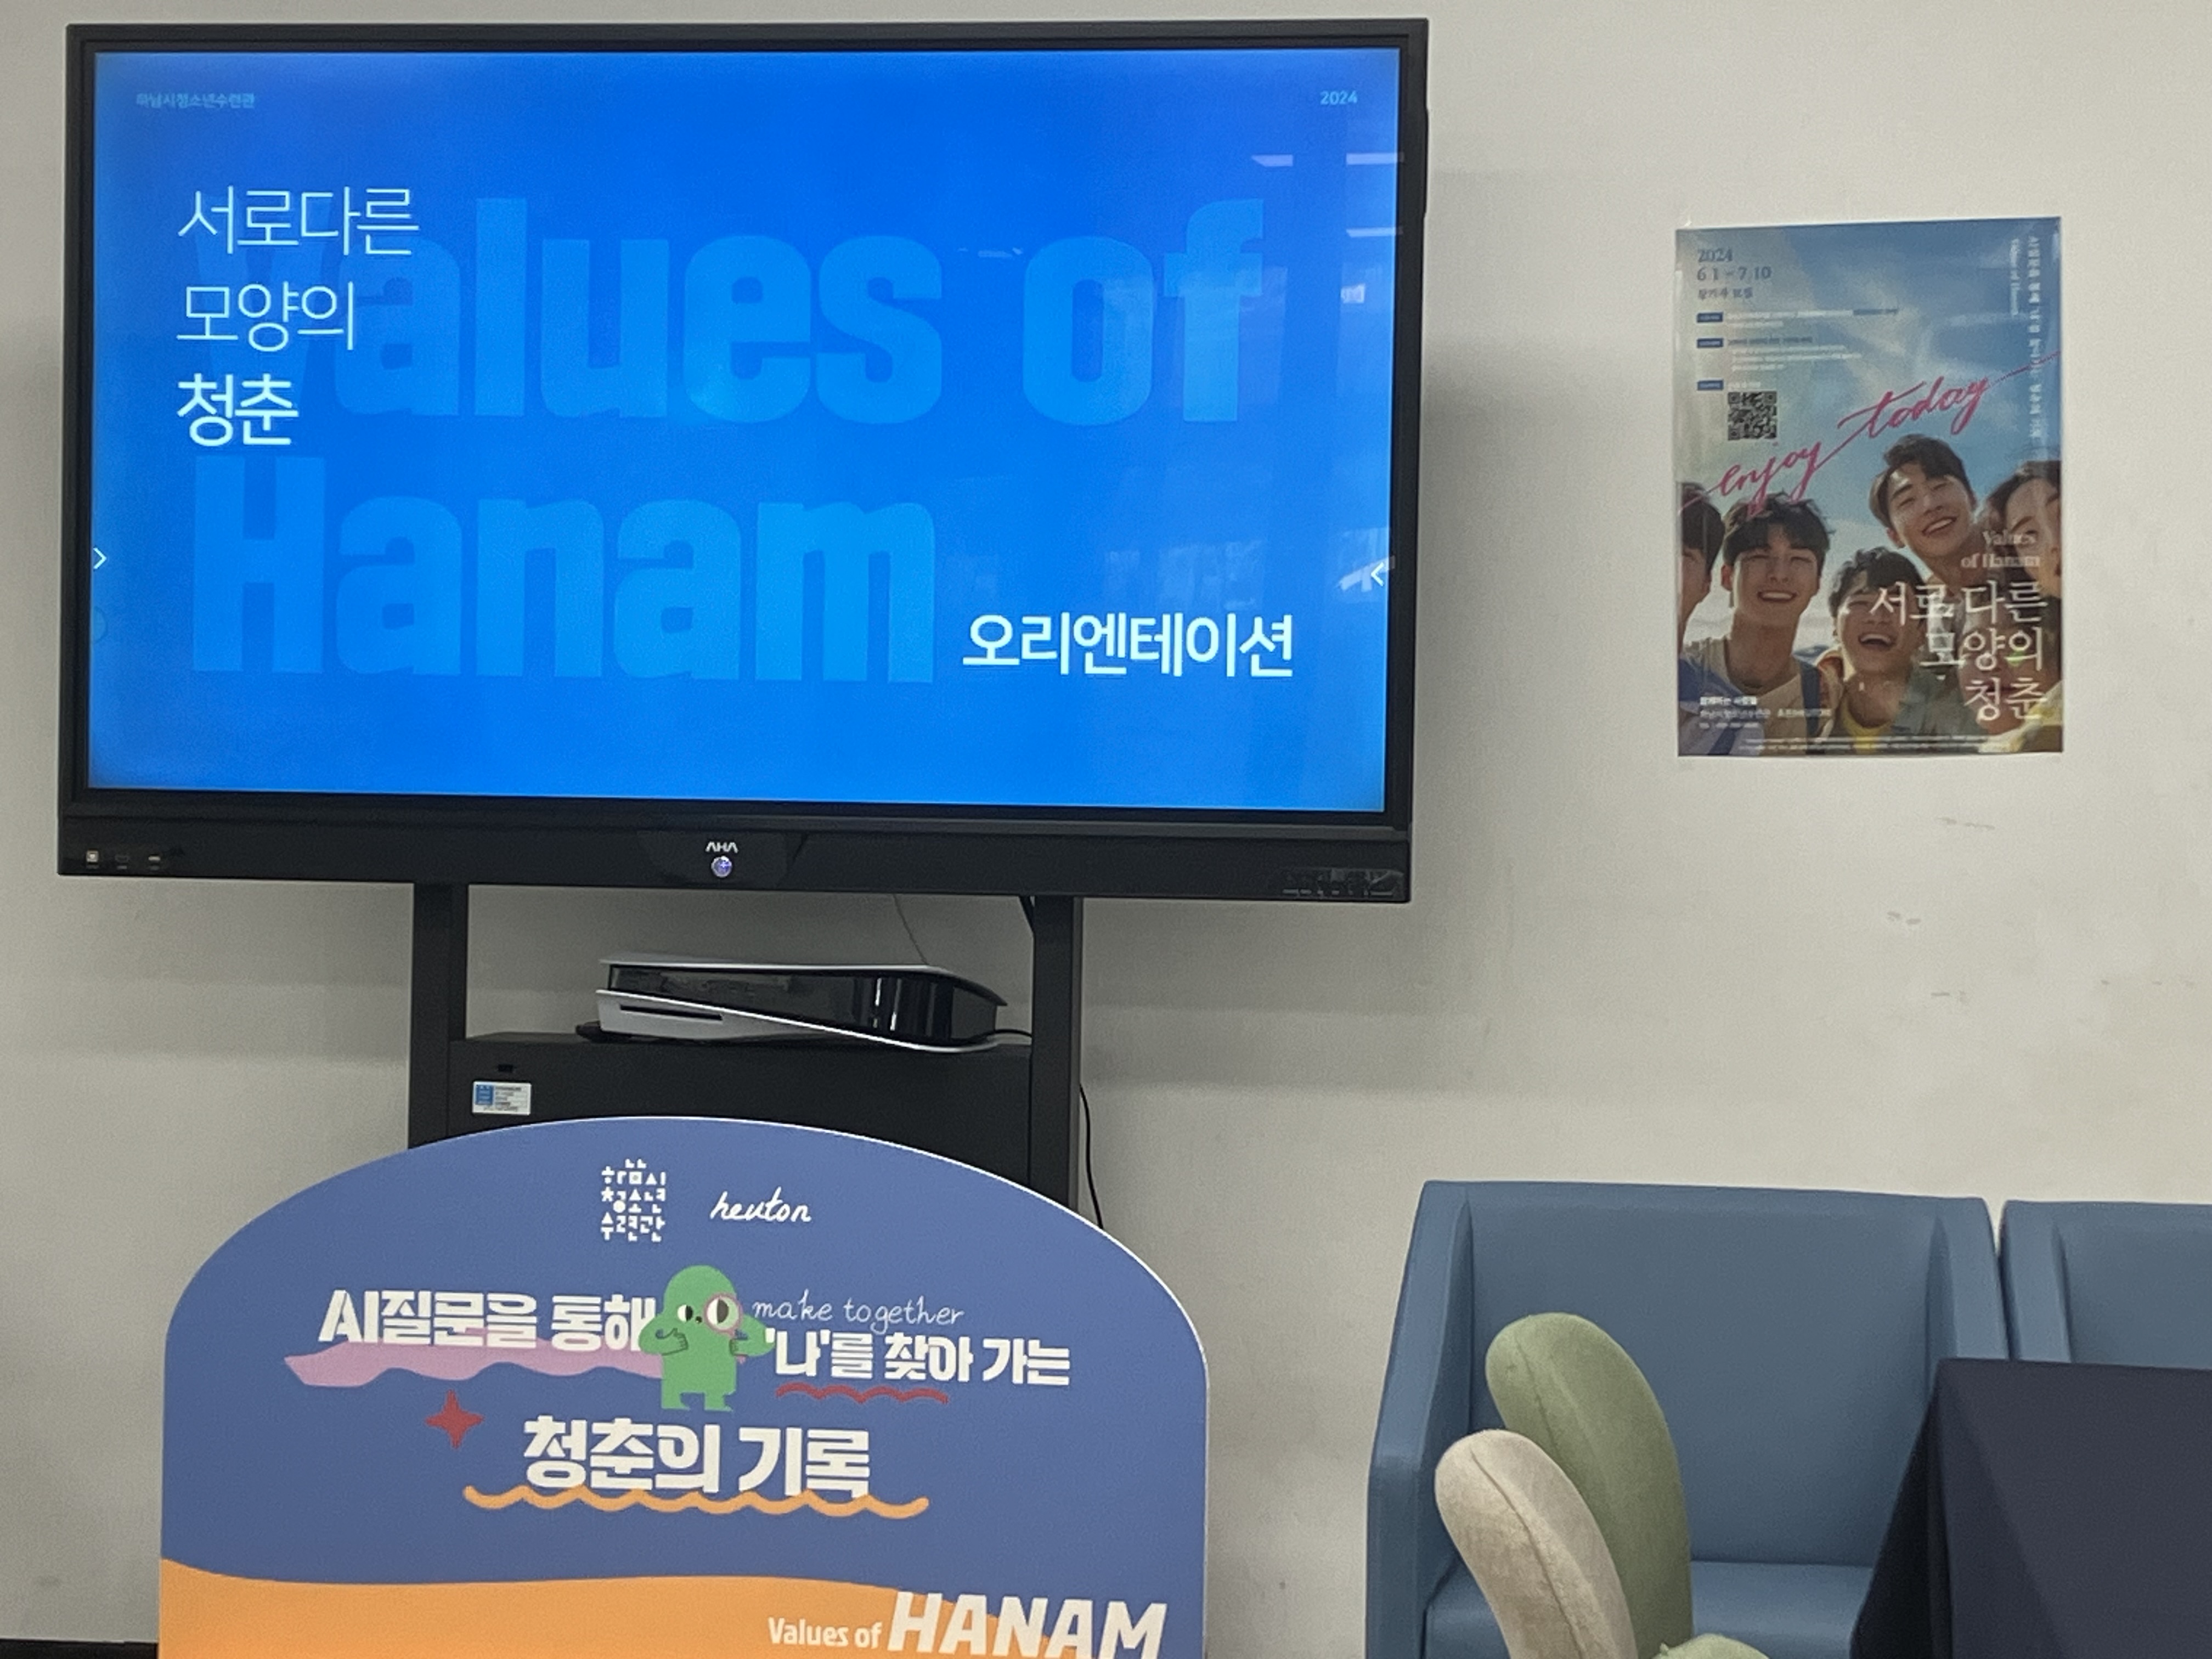
오늘은 하남시 청소년수련관에서 주최하는 Values of Hanam의 2차(마지막) 오프라인 네트워킹이 있는 날입니다.

휴튼은 하남시 청소년수련관과 MOU를 체결하고 지난달부터 Values of Hanam이라는 프로그램을 진행하고 있습니다.

오늘 공유해드릴 내용은 조금 늦긴 했지만, 7월 20일 (토)에 있었던 Values of Hanam 1차 오프라인 네트워킹에 대한 내용 및 후기입니다.

프로그램 주최 및 운영은 하남시청소년수련관에서 진행이 되었고, 외부 사회자 분이 별도로 진행을 해주셨습니다.

프로그램의 주요 골자는 고민거리가 많은 청년들의 고민을 서로 공유하고 나누자는 것이었습니다.

처음에는 간단한 자기소개와 주어진 주제를 선택해서 대답해보는 시간을 가지면서 서로에 대해 알아가는 시간을 가졌던 것 같아요.

그 뒤로는 각자가 가져온 애장품들을 교환하는 시간이 있었어요. 이 파트가 신선하고 좋았던 것 같아요!

하지만, 제가 개인적으로 정말 좋았던 시간은 조별로 앉아서 각자의 고민을 말하고 그것에 대한 조원들이 피드백을 텍스트로 남겨주는 것이었어요. (피드백 쪽지는 아직도 소중하게 간직하고 있어요!)

IMG_3181.jpeg

졸지에 빈약한 후기가 된 것 같지만... 오늘 있을 네크워킹 행사에 대한 후기는 빠방하게 준비해오겠습니다.. 벌써 기대가 되네요! (두근두근, 세근세근...)

휴튼

나도 몰랐던 나를 알아가는 질문들

4
0
임세진

임세진

휴튼의 하드 트레이닝

안녕하세요, 휴튼의 엔지니어 임세진입니다.

최근에 gpt-4o-mini 가 공개되면서, 휴튼의 맞춤형 질문생성에서 백본이 되는 모델을 업데이트 했습니다.

가격의 측면에서도 우수하지만, 생성되는 질문의 퀄리티 측면에서 상당히 우수해지더군요..

외부 모델에 의존해야 하는 단점이 아직 존재하지만, 달리 말하면 외부 모델이 발전할수록 서비스의 퀄리티가 올라간다는 의미가 됩니다. 그리고 질문 생성에 있어서 대체할 수 있는 모델들도 충분히 있어서 risk 측면에서도 오히려 괜찮다는 생각이 들더군요.

하드 트레이닝 #1

현재 휴튼은 프롬프트 버전 관리를 자체적으로 하고 있습니다. 아직은 조악한 형태이지만, 추후에는 원하는 결과물에 맞는 프롬프트를 추천해주는 자체적인 서비스도 만들 수 있을 것 같습니다.

하드 트레이닝 #2

외부 모델의 의존성을 줄이기 위해 성능이 딱히 좋지 않은 Decoder model 기반의 모델에서도 작동하는 질문 생성 pipeline을 구축하고 있습니다. 달리 말하면, 외부 모델이 좋아지면 경쟁력 있는 질문 생성 결과물을 얻어낼 수 있다는 의미입니다.

하드 트레이닝 #3

휴튼에서는 요즘 공감하는 질문을 생성하기 위한 시도들을 하고 있습니다. 다양한 방식으로 프롬프트를 제작하여 테스트해보고 있습니다.

휴튼

나도 몰랐던 나를 알아가는 질문들

9
2
임세진

임세진

의구심

나온 지 조금 되긴 했지만, 후쿠하라 마사히로의 Philosophical Thinking (철학 수업)이라는 책을 읽고 있다. 생각보다 글은 별로 없어서 정말 빨리 읽히는 책이다.

철학적인 사고 과정을 하기 위해서는 "아니요"라는 대답이 필요하다고 한다. 그리고 끊임 없는 의구심을 가져야 한다고 한다. 이를 제품에 적용시켜 보면, 제품이 성장할 여지를 찾아볼 수도 있을 것 같다.

휴튼에서 개인적으로 드는 가장 큰 의구심 두 개.

  1. 휴튼을 이용하면 실질적인 삶의 개선에 도움이 되는가?

  2. 실질적인 삶의 개선이 이뤄지는 것을 유저가 확인할 수 있는 방법이 있는가?

어쩌면, 데일리 스크럼에서 1일 1 의구심을 제시하는 것을 의무화해도 좋을지도...?

휴튼

나도 몰랐던 나를 알아가는 질문들

4
0
임세진

임세진

말투 변환 모델의 응용

안녕하세요. 휴튼팀의 AI 엔지니어 임세진입니다.

휴튼의 미션은 좋은 질문을 통해 각자의 내면 문제를 해결하는 것입니다.

좋은 질문을 위해 라이프 코칭이라는 기술도 공부하고, 기술적으로도 어떻게 좋은 질문을 생성할지 고민을 많이 하고 있습니다.

휴튼 팀에서 사용하고 있는 기술 중에 bart 모델로 GPT가 생성한 질문 내용을 한번 더 정제하는 기술이 있습니다. 아직 공부가 부족해 foundation model을 직접 만든 것은 아니고, Hugging face에 공개된 text2text generation 모델을 기반으로 데이터를 fine tuning하여 개발을 했습니다.

처음에는 말투 변환만 GPT 말투에서 휴튼 팀의 리더인 영준님의 말투로 바꾸자는 시도에서 시작했습니다. 그래서 초창기에는 영준님의 데이터를 수집하느라 영준님이 고생을 많이 했어요 (무한 감사)ㅋㅋㅋ

생각 외로 말투 변환 성능이 좋아서 조금 더 딥한 시도를 하게 됩니다. 말투 변환의 범위를 확장시킨 것이죠. 한국어 문맥상 어색한 부분도 수정하고, 의미 전달이 불분명한 부분들도 수정했어요. 아무래도 질문의 의미가 명확해야 사용자가 더욱 명쾌한 답변을 쓸 수 있기 때문이죠. 하지만, 아직 모델 성능이 80~90% 남짓으로 보여서 더욱 고민을 하고 있어요.

프롬프트 전처리 단계에서 해당 모델을 사용해서 맞춤형 프롬프트를 리턴하게 하는 것은? 과 같은 고민도 진행중이에요.

휴튼

나도 몰랐던 나를 알아가는 질문들

4
0
임세진

임세진

어떤 AI가 사람들에게 거부감을 일으키지 않을까요? (고민 중)

안녕하세요, 휴튼에서 AI 엔지니어를 담당하고 있는 임세진입니다.

저는 항상 어떤 질문이 좋은 질문이고, 어떤 질문이 형편없는 질문인 지에 대해 고민을 하고 있습니다.

초창기 맞춤형 질문에서는 답변 네트워크를 구축하여 심도 깊은 질문 생성을 하도록 개발을 했습니다. 그랬더니 시간이 지날수록 질문의 주제가 고여버리는 문제가 발생하더군요..

최근에 휴튼이 V2로 개편했습니다. 맞춤형 질문도 키워드 기반으로 질문이 생성되고, 글을 작성하면 키워드 추출을 하여 키워드 클라우드를 생성해줍니다. 사용자는 원하는 키워드를 기반으로 질문을 받아볼 수 있게 되었죠.

휴튼 V2로 넘어오면서 조금 더 근본적인 고민을 했던 것 같습니다. 과연 AI가 던져주는 질문이 사람이 던져주는 질문보다 더 의미가 있을까?

나름 이 고민에 대한 답변을 떠올려봤습니다.

AI가 던져주는 질문과 사람이 던져주는 질문의 가장 큰 차이는 뒷 배경의 유무 인 것 같습니다. 즉, AI는 그저 AI일 뿐이지만, 사람의 경우에는 그 사람이 살아온 인생이라는 뒷 배경이 존재합니다. 그리고 그것이 질문을 받는 입장에서 더 매력적으로 느낄 여지가 있다고 생각했죠.

그래서 여기에서 조금 더 생각을 해봤습니다. 뒷 배경이 있는 AI는 어떨까? 그런 AI가 생성한 질문이 사람이 생성한 질문과 차이가 없으려면 어떻게 해야 할까?

오히려 AI가 사람 흉내를 내기 보다는 AI가 AI 자체로서 존재해야 더 거부감을 일으키지 않을 것 같다는 생각도 드네요..

휴튼

나도 몰랐던 나를 알아가는 질문들

10
4
임세진

임세진

Numpy

사실, 이제는 python을 사용하는 분들에게는 numpy가 정말 많이 사용되어서 친숙하고 익숙하죠.

정말 어떻게 보면 별거 아니지만, 제가 처음 numpy를 접했을 적 추억을 회상하는 느낌으로 numpy가 python에서 왜 중요한지 정리해 볼게요.

제가 알기로는 numpy를 거쳐서 하는 연산의 속도는 python 속도가 아니라, C언어 코드에 근접하는 속도라고 알고 있어요. (제가 처음 python을 접할 당시에는 프로그램이 돌아가는 속도가 C언어로 짠 코드 >> python으로 짠 코드 였어요.)

따라서, 단순히 list 안에 들어있는 성분을 찾을 때도, python 기본 코드로 for loop을 돌리는 것보다, numpy의 indexing 기능들을 이용하는 것이 더 빠르죠. (지금도 그런지는 모르겠지만요)

그리고 기본적으로 행렬 연산도 numpy 연산이 더 간편하고 빨라서 어찌 보면 tensor의 기본적인 사용법이 numpy에서 시작했다고 해도 과언이 아닐 거에요.

제가 예전에 정리해본 많이 사용하는 numpy 기본 코드들이에요.

import numpy as np                   # numpy 모듈을 불러오기


a = [i for i in range(10)]           # 임의의 리스트 생성
a_np = np.array(a)                   # 생성한 리스트를 numpy 자료형으로 만듦
result = (a_np[1:]+a_np[:-1])/2.0    # numpy 연산을 수행
print(result)

a = [i for i in range(10)]
b = [10-i for i in range(10)]
a_np = np.array(a)
b_np = np.array(b)

result = a_np + b_np                 # numpy 연산을 수행
print(result)

a = [0.0 for _ in range(10)]
a_np = np.array(a)

for i in range(10):
	b = [j for j in range(10)]
	b_np = np.array(b)
	a += b                             # numpy 연산을 수행

print(a)

a = [i for i in range(10)]
a = np.array(a)

b = np.arange(10)

print(a, b)

a = [0.0 for _ in range(10)]
a = np.array(a)

b = np.zeros(10)

print(a, b)

a = np.arange(10)
idx = a==5
print(a[idx])

a = np.arange(10)
search = np.array([1, 2, 3])
mask= np.isin(search, a)
print(a[mask])
7
0
임세진

임세진

석사 과정 스토리 #2

첫 겨울 방학

경제 물리 연구 주제 및 방향성 정리

어쩌다가... 주식 관련 공모전에 간접(?) 참가하게 되면서 Bipartite Network로 투자 회사들의 주식 거래 상위 종목들을 추천해주는 모델을 고안했다. 의외로, 여기에 Network Diffusion을 적용하니 성과가 잘나와서 본선 진출까지 하게 됐다. (하지만 결과적으로 떨어졌다.)

이 때, 딥러닝 모델을 사용한 게 아니라, 네트워크 이론에 있는 내용만 사용한 것이라 연구 주제로 채택을 해도 될 것 같다는 생각이 들었다. (특히 실제로 성과가 나쁘지 않았으므로, 연구적인 의미도 있을 것이라 생각이 되었다.)

하지만, 결국 기본적인 물리량을 정의 하는 것이 너무 까다로워서 결국 다른 주제를 잡게 되었다...

굉장한 애증의 관계이자, 지금의 나를 있게 만든(?) Record Statistics...(신기록 경신 통계)

사실 이런 통계가 있다는 것도 이 연구실 와서 처음 알게 되었다. 그만큼 정말로 잘 알려지지 않은 주제인 것 같다. (그리고 많은 사람들이 궁금해 하지도 않을 것 같다.)

나는 이 연구 주제 덕분에 정말 고통스러운 석사 2기를 보내기 시작했다.. (아픈 만큼 성숙하더라..)

To be continued..

1
0
임세진

임세진

석사 과정 스토리 #1

프롤로그

당분간 정말로 별거는 아니지만, 제가 석사 4기 (2년) 동안 있었던 일들에 대해 간단하게 정리해보고자 해요.

정말 지루하고 재미없을 수도 있지만, 재미있게 봐주시길 바랍니다~ㅎㅎ

석사 1기

다시 보니 네트워크 이론에 대한 기본적인 공부

석사 1기 때는 연구 주제를 제대로 잡기 위해서 몸부림쳤던 것 같다. 그러는 과정 속에서 많다면 많은 것들을 습득했던 것 같다.

제일 힘들었던 점은 1주일에 한 번 씩 있는 랩미팅과 처음 해보는 실험 조교에 적응하는 것이었다.

정말 지금 와서 생각해보면, 랩미팅 정말 대충 준비했던 것 같다. 사실 그 때 당시에는 발표를 하기 위해 어떤 것을 준비해야 하는지 조차 몰랐던 것 같다.

당연히, 매주 랩미팅은 고통의 연속이었다. 내가 발표를 했지만, 무슨 발표를 하는지 본인도 몰랐다! 마치 혼돈과 카오스처럼.. 듣는 사람도 혼돈이었고 발표하는 내 머릿속도 카오스였다!

그러나, 연구 주제를 찾기 위해 여러 시도들은 꾸준히 하고 있었다. 다양한 네트워크 모형들을 C언어로 구축했다. (N-dimensional Square Lattice, Erdos-Renyi Random Network, Barabasi-Albert Network, Static Network)

Breadth First Search 알고리즘이 Network Burning에 사용된다고 해서 C언어로 구현해 놨다. (언젠가 써 먹겠지라는 생각으로 구현했지만, 결국 안 썼다~)

Axelrod 모형이라고, 문화 전파 모형이 있는데, 이 모형을 C언어 기반으로 구현했다.

간단하게 말하면, A, B, C라는 사람이 있을 때, 각 사람의 넷플릭스 시청 시간, 치킨 선호도, 알코올 주량을 각각 상,중,하로 매길 수 있을 것이다.

A는 B, C와 친구인데, B, C의 넷플릭스 시청 시간과 치킨 선호도 알코올 주량이 전부 유사하다고 하자. A는 B, C와 치킨 선호도만 다르다고 하자.

고전적인 Axerlrod 모형에 따르면, A는 B, C의 치킨 선호도의 영향을 받아 결국 전체의 특성들이 같아지게 수렴한다고 한다.

하지만, 이는 정말로 비현실적이다. 따라서 졸업하신 연구실 형 중에 조금 현실적인 내용을 반영해서 사람마다 문화 수용에 배타적인 경향이 있을 수도 있다는 것을 반영하여 연구를 하신 분이 있다! (이것도 구현은 해봤다. 정말 재미있게도, 이 모델은 하나의 문화 특성으로 수렴하지 않는다. 여러 문화 특성 그룹들이 나타났다가 사라지기도 하고 그런다!)

Majority Vote 모형도 구현해봤다.

이것도 Axelrod 모형과 유사한 모형이다. 문화 특성이 하나밖에 없고, 상, 하 밖에 없다고 생각하면 된다. 이름과 걸맞게 주변 사람들의 다수결을 따라 의견이 바뀌는 모형이다.

Multistate Majority Vote 모형도 구현해봤다.

이것은 Axelrod 모형과 Majority Vote 모형 사이 그 어딘가에 위치해 있다. 문화 특성은 하나밖에 없지만, 상, 중, 하 등 여러 상태가 존재할 수 있다.

Scaling Theory에 대한 기본적인 공부도 했다.

기본적으로, 네트워크에서 일어나는 다양한 현상들은 네트워크의 크기(노드의 개수, 점의 개수)에 의존적이다. 따라서 일반적으로는 네트워크 크기를 바꿔가면서 현상들을 관찰한다. 그리고 그랬을 때 크기와 관측 결과 간의 관계 식을 발견하는 과정에서 Scaling Theory가 사용된다. (너무 대충 설명했다)

대강 이 정도 했다. 그러나, 정말 하고 싶은 연구 주제는 결국 찾지 못했다고 한다...

To be continued..
3
0
임세진

임세진

2023년도 회고

2023년도 회고

2023년은 저에게 정말 다양한 선택이 있었던 한 해였어요. 그리고 그 선택 속에서 제가 어떤 사람인지 정말 정확하게 들여다 볼 수 있었어요. 제가 들여다 본 저의 적나라한 모습은, 제가 엄청난 기회주의자라는 것. 저는 기회주의자를 포장할 생각은 없어요. 결국 제가 직면한 저의 가장 큰 단점으로 받아들이기로 결심했어요. 단점을 인지하고 품을 때, 비로소 그 단점을 개선할 여지가 생길 수 있기 때문이죠.

제가 휴튼 팀에 소속해 있는 것은 어찌 보면 저의 단점이 발휘된 결과물 중에 하나라고 생각이 들어요. 저는 이전에 다니던 회사를 퇴사하고, 휴튼에 곧바로 합류를 했어요. 휴튼에서 일 할 때 만큼은 제가 원하던 가치 있는 일을 할 수 있었어요. 그렇지만, 저의 단점이 추가적으로 발휘되어, 다른 탄탄한 기업들로 눈이 돌아가기 시작했어요. 현실적으로 안정적인 생활을 하고 싶었기 때문이죠.

결국, 그 유혹을 참지 못하고 탄탄한 기업들에 지원도 해보고 패배하는 경험만 겪었어요. 기회주의자의 말로인 셈이죠.

좋은 기회를 잡는 것이 맞는지, 좋은 기회가 오더라도 현재 하는 일이 더 가능성이 있으면 그것을 하는 것이 맞는지, 이 두 가지 가치에서 제가 늘 충돌하는 이유는 기본적으로 저는 호기심이 많아서 새로운 일을 좋아하기 때문인 것 같아요.

어느샌가 휴튼을 위해 고민하는 시간이 줄어들고, 저 스스로에 대해 고민하는 시간이 늘어난 모습을 발견했죠.

하지만, 저에 대해 고민을 면밀히 하던 끝에, 뭐가 됐던 결국 저는 휴튼이 아니여도 결국 휴튼이 추구하는 일을 하게 될 것만 같더군요.

그 이유는, 제가 살면서 해결하고 싶은 정말 중요하게 생각하는 문제들이 있는데, 그 문제들 중에 환경 문제를 제외하고는 휴튼이 거의 해결해줄 수 있을 것이라는 생각이 들었어요.

결과적으로, 되는 데까지 휴튼에 더 몰입을 할 생각이에요. 어떤 방식으로 휴튼에 기여를 할 지, 무엇을 기여할 수 있을 지 충분한 고민을 하고 적용해나가는 2024년도 한 해가 되기를 희망해요.

기회주의라는 키워드가 2023년도 한 해를 정말 힘들게 했어요. 기회주의라는 것이 참 해석하기 어려운 어휘이긴 하지만, 아전인수 식의 기회주의보다는 객관적으로 누가 봐도 기회인 것을 포착하고 싶다는 생각이 들었던 2023년도 한 해였던 것 같아요.

등잔 밑이 어둡다는 말이 있다시피, 항상 정말로 중요한 것은 내 곁에 있음을 잊지 말기를

3
0
임세진

임세진

OpenAI API 적절한 timeout, max_retries 수치 찾기

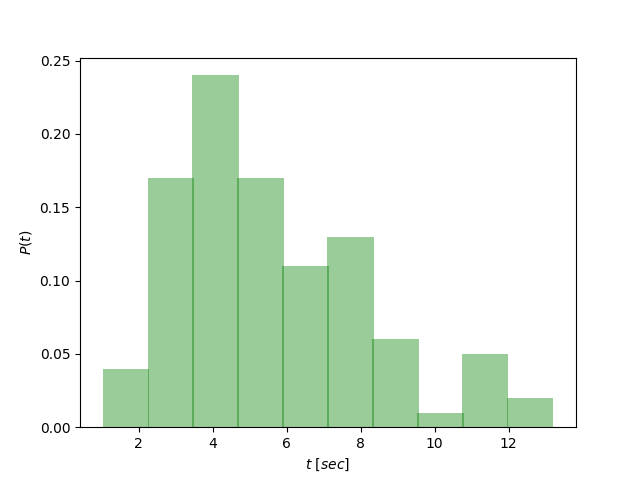
우선 테스트 프롬프트는 "간단하게 과일들을 주인공으로 해서 작문해볼래?"로 작성했어요.

총 100번 응답 시간을 측정해서 분포를 살펴봤구요(측정 횟수는 다다익선이겠죠), timeout을 변경해가면서 테스트해보면 각자 프롬프트에 맞는 timeout 수치를 찾아낼 수 있겠죠?

max_retries는 충분한 정도라고 생각되는 5로 고정했어요.

from openai import OpenAI
import time
from tqdm import tqdm
import matplotlib.pyplot as plt
import numpy as np

client = OpenAI(api_key="API-KEY")

tries = 100
req_times = []
for _ in tqdm(range(tries)):
    start = time.time()
    client.with_options(max_retries=5, timeout=40).chat.completions.create(
        messages=[
            {
                "role": "assistant",
                "content": "간단하게 과일들을 주인공으로 해서 작문해볼래?",
            }
        ],
        model="gpt-3.5-turbo-1106",
    )
    end = time.time()
    req_times.append(end-start)

hist, bins = np.histogram(req_times)
bins = (bins[1:] + bins[:-1]) / 2.0
hist = hist / np.sum(hist)

plt.bar(bins, hist, color="green", alpha=0.4, width=1.25)
plt.xlabel(r"$t\ [sec]$")
plt.ylabel(r"$P(t)$")
plt.savefig("histogram.png")
plt.show()
histogram (1).png

분포를 살펴보시면 요청 시간이 생각보다 짧다는 것을 알 수 있어요. timeout을 더 줄여서 측정한 뒤에 적절한 timeout을 찾는 것이 중요하다고 생각되네요.

휴튼

나도 몰랐던 나를 알아가는 질문들

4
0
임세진

임세진

OpenAI API 사용법 간략한 소개

OpenAI API 속 기능들

  1. 일반적인 사용법

    from openai import OpenAI
    
    client = OpenAI(
        # defaults to os.environ.get("OPENAI_API_KEY")
        api_key="My API Key",
    )
    
    chat_completion = client.chat.completions.create(
        messages=[
            {
                "role": "user",
                "content": "Say this is a test",
            }
        ],
        model="gpt-3.5-turbo",
    )

Async 방식으로 요청 시

import asyncio
from openai import AsyncOpenAI

client = AsyncOpenAI(
    # defaults to os.environ.get("OPENAI_API_KEY")
    api_key="My API Key",
)


async def main() -> None:
    chat_completion = await client.chat.completions.create(
        messages=[
            {
                "role": "user",
                "content": "Say this is a test",
            }
        ],
        model="gpt-3.5-turbo",
    )


asyncio.run(main())
  1. 실시간 Stream 방식으로 요청 시

    1. Sync

      from openai import OpenAI
      
      client = OpenAI()
      
      stream = client.chat.completions.create(
          model="gpt-4",
          messages=[{"role": "user", "content": "Say this is a test"}],
          stream=True,
      )
      for chunk in stream:
          if chunk.choices[0].delta.content is not None:
              print(chunk.choices[0].delta.content)
    2. Async

    하단 URL에서 보실 수 있어요~

이 외에도 다양한 기능들이 있어요~

Nested params와 같이 출력 양식을 정해주는 것도 있구요.

from openai import OpenAI

client = OpenAI(api_key="API-KEY")
completion = client.chat.completions.create(
    messages=[
        {
            "role": "user",
            "content": "Can you generate an example json object describing a fruit?",
        }
    ],
    model="gpt-3.5-turbo-1106",
    response_format={"type": "json_object"},
)
completion.choices[0].message.content

timeout, max_tries 등과 같이 API에 response 관련된 요청 사항을 넘겨줄 수도 있어요.

from openai import OpenAI

# Configure the default for all requests:
client = OpenAI()

# Or, configure per-request:
client.with_options(max_retries=5, timeout=60).chat.completions.create(
    messages=[
        {
            "role": "user",
            "content": "How can I get the name of the current day in Node.js?",
        }
    ],
    model="gpt-3.5-turbo",
)

위의 요청 내용은 매 try 마다 timeout 60초의 제한 시간을 부여하고, 60초 안에 답변 생성이 되지 않으면 max_retries인 최대 5회까지만 생성 시도를 하라는 뜻이에요. (기본 max_retries 값은 2라고 하네요.)

이 두 조합을 적절하게 잘 배합해서 사용하면 원하는 시간 내로 API 요청에 대한 답변을 받아볼 수 있어요. (응답이 오기까지 무기한 기다리지 않아도 된다는 말이죠.)

프롬프트에 따라 적절한 timeout과 max_retries 값은 달라질 것 같으니, 각자 서비스에 맞는 파라미터 값들을 찾아내는 것이 필요할 것 같아 보여요.

휴튼

나도 몰랐던 나를 알아가는 질문들

13
0
임세진

임세진

놀이의 관점

휴튼 AI의 질문 퀄리티 외에도 유료 멤버십 전환율 및 유료 멤버십 유지율을 높이는 방안으로 뭐가 있을지 생각해봤어요. 그러다가 문득, 능동적인 놀이라는 것에 집중하게 되었어요.

오늘 제가 공유해드릴 내용은 능동적인 놀이의 중요성이에요.

제가 생각해본 능동적인 놀이의 정의는, 사용자가 직접 참여하고 대상과 소통하고 시간을 재미있고 보람차게 보내는 행위라고 생각해요.

비슷한 카테고리이지만, 능동적 놀이가 아닌 것과 능동적 놀이인 것의 사례를 들려드리고자 해요.

  1. 능동적 놀이가 아닌 것: 독서(R), 능동적 놀이인 것: 게시판(CRUD)

  2. 능동적 놀이가 아닌 것: 음악 감상(R), 능동적 놀이인 것: 작곡 및 연주(CRUD)

...

CRUD는 Create, Read, Update, Delete의 약자에요.

어디까지나 제 개인적인 소견이지만,

앞으로 LLM을 이용한 AI 개발의 방향과도 연결되는 내용인데요,

최근에 OpenAI에서 발표한 내용만 봐도, 단순 AI가 생성한 글을 읽고 AI와 소통하는 서비스는 앞으로 미래가 불투명해진 것 같아요.
각 사업마다 철학이 묻어 나고, 그 철학 속에서 사용자들이 그 철학을 가장 잘 습득할 수 있는 "능동적 놀이"가 있을 때, 그 "능동적 놀이"를 더욱 재미있게 즐길 수 있는 요소로 AI가 사용되어야 할 것 같다는 생각이 드네요.

다들 개발하고 고민하시느라 고생이 많으시겠지만, 누군가에게는 도움이 되었으면 좋겠어요.

휴튼

나도 몰랐던 나를 알아가는 질문들

10
0
임세진

임세진

휴튼 AI의 역할

얼마 전에 팀 내부에서 했던 세미나 내용의 일부를 공유해보고자 합니다.

휴튼 질문 패키지에서 휴튼 AI의 역할은 무엇일까요?

우선 기본적으로 휴튼 질문 패키지에서는 일주일에 한 번씩 3개에서 5개의 질문을 생성합니다. 휴튼 AI는 이 질문 생성을 전적으로 담당하고 있죠.

여기에서 휴튼 AI의 역할을 알아내기 위해서는 휴튼 AI의 존재 의의에 대해 먼저 알아야 합니다.

"사람들이 왜 하필 휴튼 질문 패키지를 쓸까?"라는 질문에 답을 할 수 있어야 하죠.

사람의 추가 질문과 휴튼 AI의 후속 질문이 갖는 이점에 대해 생각해 봤습니다.

  1. 사람이 모든 사용자의 질문을 퀄리티 높게 생성하는 데에는 물리적인 한계가 존재할 수밖에 없다.

  2. 질문을 생성하는 사람이 모르는 내용의 답변일 경우에 사람이 추가 질문을 생성하기가 어려워진다.

따라서 개인 맞춤형 질문은 사람이 아닌 AI 기술에 의해 이뤄져야 한다는 것을 미루어 짐작할 수 있죠.

그렇다면 여기에서 휴튼 AI의 역할은 무엇일까요? 다른 프롬프트들과 다른 점이 무엇일까요?

휴튼 AI를 개발하면서 질문을 어떻게 생성해야 하는 지에 대해 많이 고민했고, 현재도 고민 중입니다. 현재까지 고민한 내용을 정리하면,

  1. 최대한 간결하고 알아보기 쉽게

  2. 담백하고 의미가 명확하게 전달 되게

  3. 정중한 듯 하지만 너무 딱딱하지는 않게

  4. 번역체가 아닌 최대한 자연스러운 대화체로

  5. 서술형이 아닌, 질문의 형태로

  6. 사용자의 답변에서 휴튼이 의도하는 바에 따라

현재 최대한 이런 방식을 고수하면서 질문 생성을 하도록 개발을 진행하고 있습니다.

휴튼 팀은 AI 기술에 전적으로 의존하는 것이 아니라, 휴튼 철학을 AI에 녹여내고자 했어요. 따라서 6번에 있는, 휴튼이 의도하는 바에 따라서 질문 생성을 하는 것이 굉장히 중요합니다.

휴튼은 휴튼 사용자 모두가 각자 내면을 들여다 보는 데 도움을 주고 싶어요.

본인이 일어난 사건들 기반으로 인지를 하지 못한 것들을 인지 시켜주고 싶어요. 본인이 인지는 했지만, 기억에서 잊혀진 것을 찾는 데 도움을 주고도 싶죠.

더 나아가서 내면에 깊숙이 자리 잡아서 전혀 알아채지 못했던 것들을 알게 해주고 싶어요.

앞으로 어떻게 대처해야 하는지 충분한 고민의 기회도 주고 싶죠.

아직은 이런 것들을 정확하게 구현하는 데 다소 어려움이 있지만, 더욱 발전하고 앞으로 나아갈 거에요.

휴튼 질문 패키지 많이 이용해주세요~!

휴튼

나도 몰랐던 나를 알아가는 질문들

11
1
임세진

임세진

Record Statistics #1

제 석사 연구 주제인 Record Statistics (신기록 경신 통계)에 대해서 얘기를 해보고자 합니다.

우선 신기록 경신이 무엇인지 알기 위해서는 신기록 경신에 대한 명확한 정의부터 필요합니다.

신기록 경신은 말 그대로, 여태까지 등장한 최고/최저 값보다 더 높은/낮은 값이 등장하면 일어납니다.

예를 들어서 {1, 5, 0, 6, 1, -2, 8, 10}이 시간 순서대로 일어난 시계열이라고 할 때, 신기록을 경신한 횟수는 몇 번일까요?

Upper Record Number (상승하는 신기록 경신 횟수): 5회 (1, 5, 6, 8, 10)

Lower Record Number (하락하는 신기록 경신 횟수): 3회 (1, 0, -2)

라고 할 수 있습니다.

별 게 없어 보이지만, 이 정의로부터 Record Statistics가 시작이 됩니다.

Record Statistics에서 관심을 갖는 대상은 주로 Record Number (신기록 경신 횟수)입니다. 하지만 통계라는 이름에 걸맞게 이론적 기반으로 Average Record Number (신기록 경신 횟수의 기댓값)을 구해내죠.

Record Statistics에서 사용되는 데이터는 연구 대상의 동일한 기간에서 시계열들을 포함합니다.

예를 들어, 서울시의 강수량 데이터가 연구 대상인 경우에, 서울시 안에 포함된 지자체들의 강수량 시계열 데이터들이 사용된다는 것이죠. (그래야 통계를 알아낼 수 있겠죠?) Average Record Number를 구하는 방법은 이러한 지자체들의 강수량 데이터에서 각각의 Record Number가 있을텐데 이들의 평균 값을 계산하면 됩니다.

이는 데이터 속에서 Record Statistics를 찾는 방법입니다. 하지만, 이렇게 구한 Average Record Number가 어떤 의미를 갖는 지에 대해서는 알지 못하므로 분석하기가 어렵습니다.

해당 분야 연구자들은 여러 Random walk 모델들에서 Record Statistics가 어떻게 되는지 이론 기반으로 연구를 했습니다. 이렇게 구한 이론적 기반들을 통해 해당 데이터가 어떤 Random walk 모델을 따르는지 구하는 것이 연구의 주된 방향입니다.

이론적인 기반에 사용되는 내용들을 수식이 너무 다양하고 많아서 한번에 설명을 드리긴 어려울 것 같습니다..

이론적인 Average Record Number를 구하는 과정 속에서 사용되는 다른 변수들로는 Survival Probability와 First Passage Probability 등이 있습니다.

다음 시간에 이 둘에 대해 자세히 다뤄보도록 하겠습니다.

감사합니다.

5
0
임세진

임세진

원하는 결과물을 얻어내기까지...(언제 쯤 완벽해질까..)

저는 휴튼의 질문 패키지의 질문을 던져주는 휴튼 AI를 개발 및 업그레이드를 하고 있습니다.

질문 패키지가 출시된 지 어느덧 3~4주차에 접어들었습니다.

휴튼 AI를 개발하면서 느낀 점은, 질문 패키지의 매력 포인트(?)는 아무리 봐도 제가 전혀 생각지 못했던 질문을 던지며 저를 고민에 빠지게 하는 것이라고 생각이 되었습니다. 사람이 던지는 질문보다 때로는 더 예리한 질문을 던지기도 하는 것, 그리고 그 질문과 답변하는 것들이 쌓이고 쌓여서 답변자가 나름의 해답을 찾는 것이라고 생각했습니다.

최근 저는 질문 패키지를 통해 사용자가 어떻게 더 빨리 심도 깊은 고민에 빠질지 저도 고민에 빠져있습니다 ㅎㅎ...

이를 위해 매일 여러 실험들을 하고 있습니다. 예전 보다는 실험 결과들이 다소 만족스럽지만, 아직 갈 길이 먼 것 같습니다....이만 저는 다시 휴튼 AI를 괴롭히러 가보겠습니다 ㅎㅎㅎ

휴튼

나도 몰랐던 나를 알아가는 질문들

3
0
임세진

임세진

길을 안다는 것

인생에는 여러 갈림길이 있다.

그렇지만, 대부분 내가 지금 어디에 놓여있는지 잘 알지 못한다.

현재 내가 처한 상황과 나의 상태, 이 두 개가 모두 객관화 되어있어야 비로소 어디에 놓여있는지 대강이나마 파악이 가능하다. 객관화 이후에 주변 사람들의 조언에 귀를 기울여야 정확한 파악이 가능하긴 하다.

현재 나의 상황과 입지 등을 알고 있다는 것은 본인이 앞으로 무엇을 해야 할 지에 대한 기본적인 가이드라인이 되고는 한다.

우선적으로 내가 처한 상황과 나의 상태 이 둘 중에는 나의 상태부터 객관화 하는 것이 더 쉬운 것 같다. 나의 상태부터 돌아보기 시작하면, "내가 대체 왜 이런 상태일까?"를 고민하게 된다. 그러면 분명히 내가 처한 상황을 자연스럽게 파악할 수 있게 된다.

내가 처한 상황까지 파악하게 되면, "그래서 앞으로 내가 뭘 해야 하지?"라는 고민을 하게 된다. 과거에 대해 고민을 하던 끝에 미래에 대한 고민과 미래 대비를 할 수 있게 되는 셈이다.

다만, 가장 주의 해야할 점은"내가 대체 왜 이런 상태일까?"에 대한 원인을 과거 혹은 최대한 현재 시점의 나한테서 찾아야지, 더 과거로 거슬러 올라가기 시작하면 과거의 늪에 빠져서 헤어 나오기 힘들어진다.

예를 들어, "내가 지금 내가 원하는 일을 하지 못한 이유는 대학교를 잘못 들어갔기 때문이다. 또한 대학교를 잘못 들어간 이유는 고등학교 3학년 때 공부를 안 했기 때문이고, 고등학교 3학년 때 공부를 안한 이유는..." 과 같은 고민을 하는 것은 당장 때려 치워야 한다.

올바른 고민의 방향은 "내가 지금 내가 원하는 일을 하지 못한 이유는, 현재 내가 처한 상황 떄문이야. 현재 내가 처한 상황은..."으로 고민을 하는 것이 조금 더 발전적인 고민의 방향이라는 것이다.

평상시에 이런 고민을 습관화 한 사람이라면, 과거의 그 시점의 내가 어떤 상태인지를 금방 파악할 수 있게 될 것이다. 그러나 많은 사람들이 이런 고민에 습관화 되어있지 않다. 본인도 기록이라는 행위를 하기 시작하고 나서 비로소 이러한 고민과 고민거리들에 대한 정리가 습관화 되었다.

이전에 제대로 마무리 짓지 못한 고민은 분명히 미래에도 일어난다. 고민은 계속 하라고 있는 것이 아니다.

6
0