3주차 파드 인공지능 스터디(PARDAI) 회고
안녕하세요, 파드의 기획파트(PM) 팀원 김정훈 학생입니다!
PARD 에선 다양한 스터디를 진행중인데, 저는 5주차 동안 개발, 기획, 디자인 파트에서 협업하는 6분의 학생들과 인공지능 스터디에 참여하고 있어요. (다음주차가 마지막입니다ㅠ 시간이 참 빠릅니다)
이번에는 지난주 수요일 진행되었던 파드 인공지능 스터디의 개인적인 회고를 진행하였습니다.
이번 3주차의 경우는 앱 파트장이신 진서 님, 기획 파트의 예은 님, 앱 파트의 재인 님께서 발표를 해주셨어요, ㅎㅎ
AI 이미지 인식 | 진서 님
(요약)
- 딥러닝의 발전으로 AI 이미지 인식 기술의 수준이 정확도에서 사람을 앞섰다.
- 그러나 실전에 활용되기에는 한계가 있었다.
- 최근 AI 이미지 인식 기술은 이러한 한계를 극복하기 위한 방향으로 진행되고 있다.
- 이 방향은 사실 최근 딥러닝 기술 동향과도 일치한다.
- 인공지능 자체의 개발과 연구도 중요하지만, 각 산업 영역에 실전적으로 적용하기 위한 현실적 문제를 해결하는 것 역시 중요하다.
(생각)
(용어 주의)
명령의 목적을 명확히 주면, 사람보다 더 우수한 성능을 보이기 때문에 인공지능이 쓸 만하다. 하지만 그렇지 않은 경우, end to end 단에서 견고한 성능을 보여주기는 힘들다. 최근의 ai 인식 기술은 이러한 한계를 극복하기 위한 방향으로 진행되고 있다고 하는데, 결국은 어떤 수학 구조를 가져다 쓰느냐의 문제이고, 최근에 공부(귀동냥) 하여 알아낸 사실로는 알려진 symmetric group 들 간의 호환성을 고려하여 모델을 빌딩해야 한다는 점이 있었다. (실제로 트랜스 포머의 경우, inner product로서 dot product 를 사용하면 안 되는데 dot product 를 그대로 사용하고 있어서 미분기하 사이드에서 말이 안 되는 선택을 하고 있던 것임을 알 수 있었다. )
그러한 면에서 추가적으로, 4~5년 전부터 인공지능 필드는 이미 잘 하는 사람도 너무 많고 진입장벽이 낮은 필드란 생각을 갖고 있었는데 잘만 하면 생각보다 연구자들이 할 것이 아주 많이 남아 있다는 생각이 들었다.
또 한 가지 더 첨언하자면, 진서 님이 강조한 도메인 지식의 중요성은 역시나 예외 없이 맞말인 부분이었다. NLP에서 단어들의 공간을 vector space over R^n으로 치환하여 생각한다는 것은 사실 말이 안 되는 일이라는 센스에서 이해가 된다. 왜냐면 특정 단어 뒤에 반드시 다음 단어가 뒤따라 온다는 것과 단순히 rimannian space 에 대응 시킨다는 것은 큰 비약이고, 우리 뇌는 실제로 그러한 방식으로 말할 때 단어들을 꺼내오지 않기 때문이다.
그러니까,, 어떤 면에서 chatgpt가 지금의 성능을 내고 있는 것은 다시금 뒷목잡고 놀랄 만한 이슈임은 맞지만, 정리하면 적어도 다음의 두 가지 측면에서 큰 defeat이 있는 것이다.
- 단어들 간의 관계, 단어들 간의 공간 사이의 엄격한 규칙을 찾아낼 수 있는 자가 있는가? (도메인 지식을 가진 학자들 중에)(그 전에 단어들 간의 거리 측정이 가능한 말이기는 한가에 대한 질문이 먼저지만.)
- 뇌공학자 혹은 수리생물학자들 중 단어 뭉탱이와 단어 뭉탱이 사이의 연결을 어떻게 연결 짓는지 규명할 수 있는 사람이 있는가? (딥러닝은 회귀식들의 모음이지 않은가.)(물론 목적함수도 놓고, 제약조건도 놓고 하기 때문에 통계학 안에서의 수학들이 필요하긴 하지만 말이다)
AI 가 인간을 넘어서는 순간이 언제올까? | 재인 님
(요약)
ChatGPT를 활용하면 돈을 많이 벌 수 있다.
인공지능이 하는 일은 근사한 값을 찾아내는 것이다.
오리지널이 실종된다.
ChatGPT의 할루시네이션이 왜 나타나는지 정확히 알 방법이 없다 그래서 명확한 해결책도 없다
효과적인 자율 병사를 만들려면 보조 목표를 만들 수 있는 능력을 줘야 한다.
(생각)
CHATGPT 에 대한 말들은 작년 12월 초부터 봇물 터지듯 쏟아졌었는데, 올해 초반부까지도 그러한 정서에 편승했었다. 호기심에 물어본 엑셀 코드와 파이썬 코드들에 말이 되도록, 그리고 꽤 상세하고 길게 답안들을 생성해내는 것을 보고 놀랍기도 하고 지금까지 뭘 배웠나 하고 현타도 왔었다. 하지만, 근래 드는 생각은 생성 모델은 명확한 한계가 있다는 것이다. chatgpt가 하는 것은 여느 ml 모델들이 하듯(실체는 통계학) 패턴을 인식하는 것이지, 추론하는 것이 아니기 때문이다. 그리고 여기서의 추론은 인과성을 함의한다.
물론 causality learning을 포함해서 베이지안 학파로부터 출발해 2~3년 전부터 스타트업 업계나 데이터 분석 직무의 직장인들 사이에서 활발하게 인과 추론에 대한 스터디도 열리고 관심이 쏟아졌던 것은 맞다.
그럼 DL 방법들이 베이지안이 아니냐? 그건 아니다. 귀 동냥하였기로, 또 직접 보았기로는 DL은 베이즈 정리를 사용한다. 하지만 이번에도 역시, 진서 님의 요약에 대한 생각에서와 마찬가지로 비정형 데이터에 대한 도메인 지식이 제대로 반영되지 않았기 때문이라는 생각이 든다.
여기서 반기를 들만한 의견은, 알파폴드나 imagenet과 같은 예시다. 둘 모두 도메인 지식 출중한 학계에서의 성능보다 혁신에 가까운 성능을 가져다 준 사례들인데, 도메인 지식이 우선이라고? 하는 물음은 자연스럽다.
그런 면에서, 그만큼 도메인 지식 - 인공지능 지식 을 함께 깊이 있게 가져가는 연구자들이 해볼 일이 많겠다는 생각이 든다.
LCNC와 GPT기반 시리 만들기 | 예은 님
(요약)
생성형 AI가 로우코드/노코드 분야에 미칠 긍정적 영향
로우코드 도구에 대한 장벽 낮추기
새로운 유형의 개발 플랫폼의 도래
siri 에 open ai api key를 넣어보는 실습
(생각)
예은 님의 발표를 들으면서는, 노정석 대표님이 예전에 페이스북에 공유하셨던 자료가 떠올랐다. chatgpt 출시 후 2달 정도 흘렀을 때 나왔던 자료인데, 자료의 요지는 결국은 tesla와 같이 end to end로 서비스하는 역량이 없다면 결국은 API를 활용하는 회사들일 것이라는 것이었다. 당시 트위터엔 이미 생성형 ai 기반 스타트업의 실체를 까보면 api 임을 희롱하는 듯한 성격의 밈이 나돌고 있었는데, 과거를 포함해 현재까지 모두가 알고 있던 일이 아닌가 싶다.
그럼에도, 아이디어가 좋은 서비스들은 살아남을 것이라는 점이 자료의 두번째 요지였다. (그리고 그러한 서비스는 플랫폼 대기업에 귀속될 것이란 예측이 함께 있었다)
여기서 내가 생각해볼 수 있는 것은 크게 두 가지다.
하나는,
만약 내가 아이디어가 좋은 서비스를 기획 중이라면 ‘정말’ 아이디어가 좋은 것을 넘어 수많은 api 기반 프로덕트들이 제공하지 못할 새로운 가치를 제공할 수 있어야 한다는 사실이고
둘째는,
아이디어가 좋더라도 개발 과정이 애자일하고 현명해야 한다는 것이다. (모두가 각종 매체를 통해 구경했듯이 API 사용은 진입장벽이 낮은 일이니 경쟁자가 아주 많다)
정리하면, 실은 인공지능 스터디 조성을 꾀한 욕망은 앞서 꼬집은 ‘좋은 아이디어’ 몇 개를 미리 추려낸 뒤 PARD의 구성원들과 함께 개발가능한 일인지, 얼마나 좋은 아이디어인지 각을 미리 재보는 행위에 있었다.
잘 되고 있었는지는 모르겠지만, (세상에 공짜는 없다, 고민의 깊이가 필요한 시점ㅎ)
앞으로 다가오는 숏커톤과 롱커톤, 그리고 그 중간에 있을 아이디어 피칭 데이 전까지 성실히 고민해보아야 하겠다!
-읽어주셔서 감사드립니다-

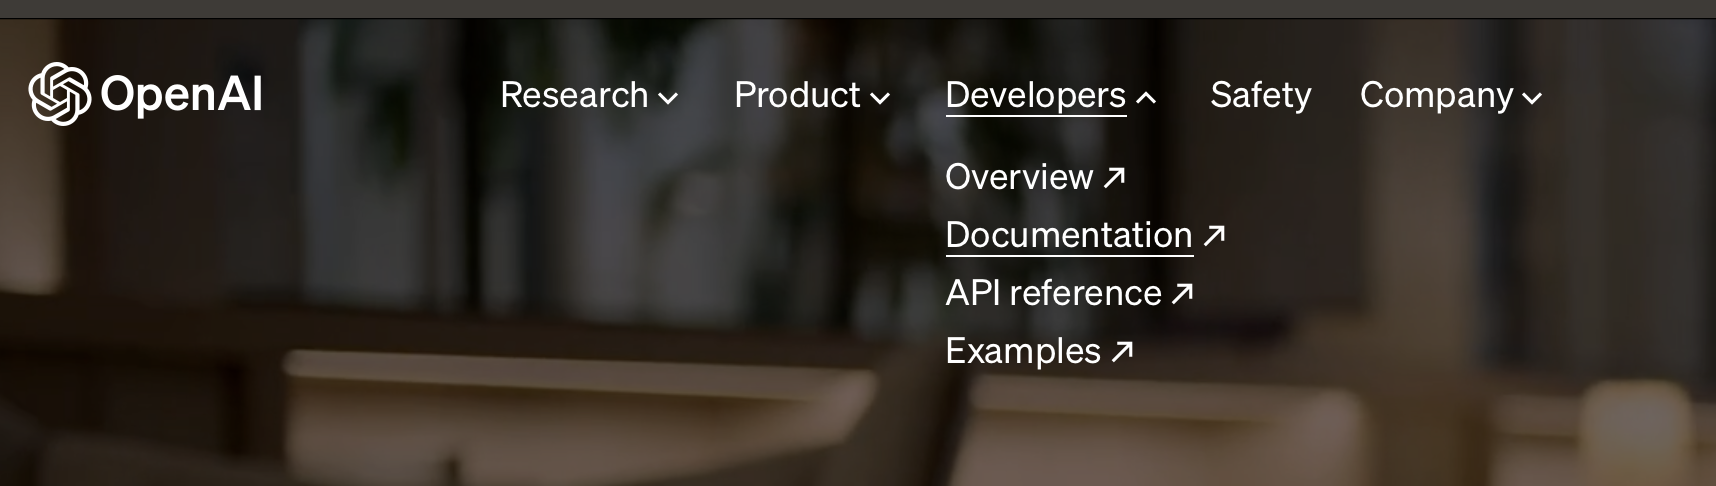
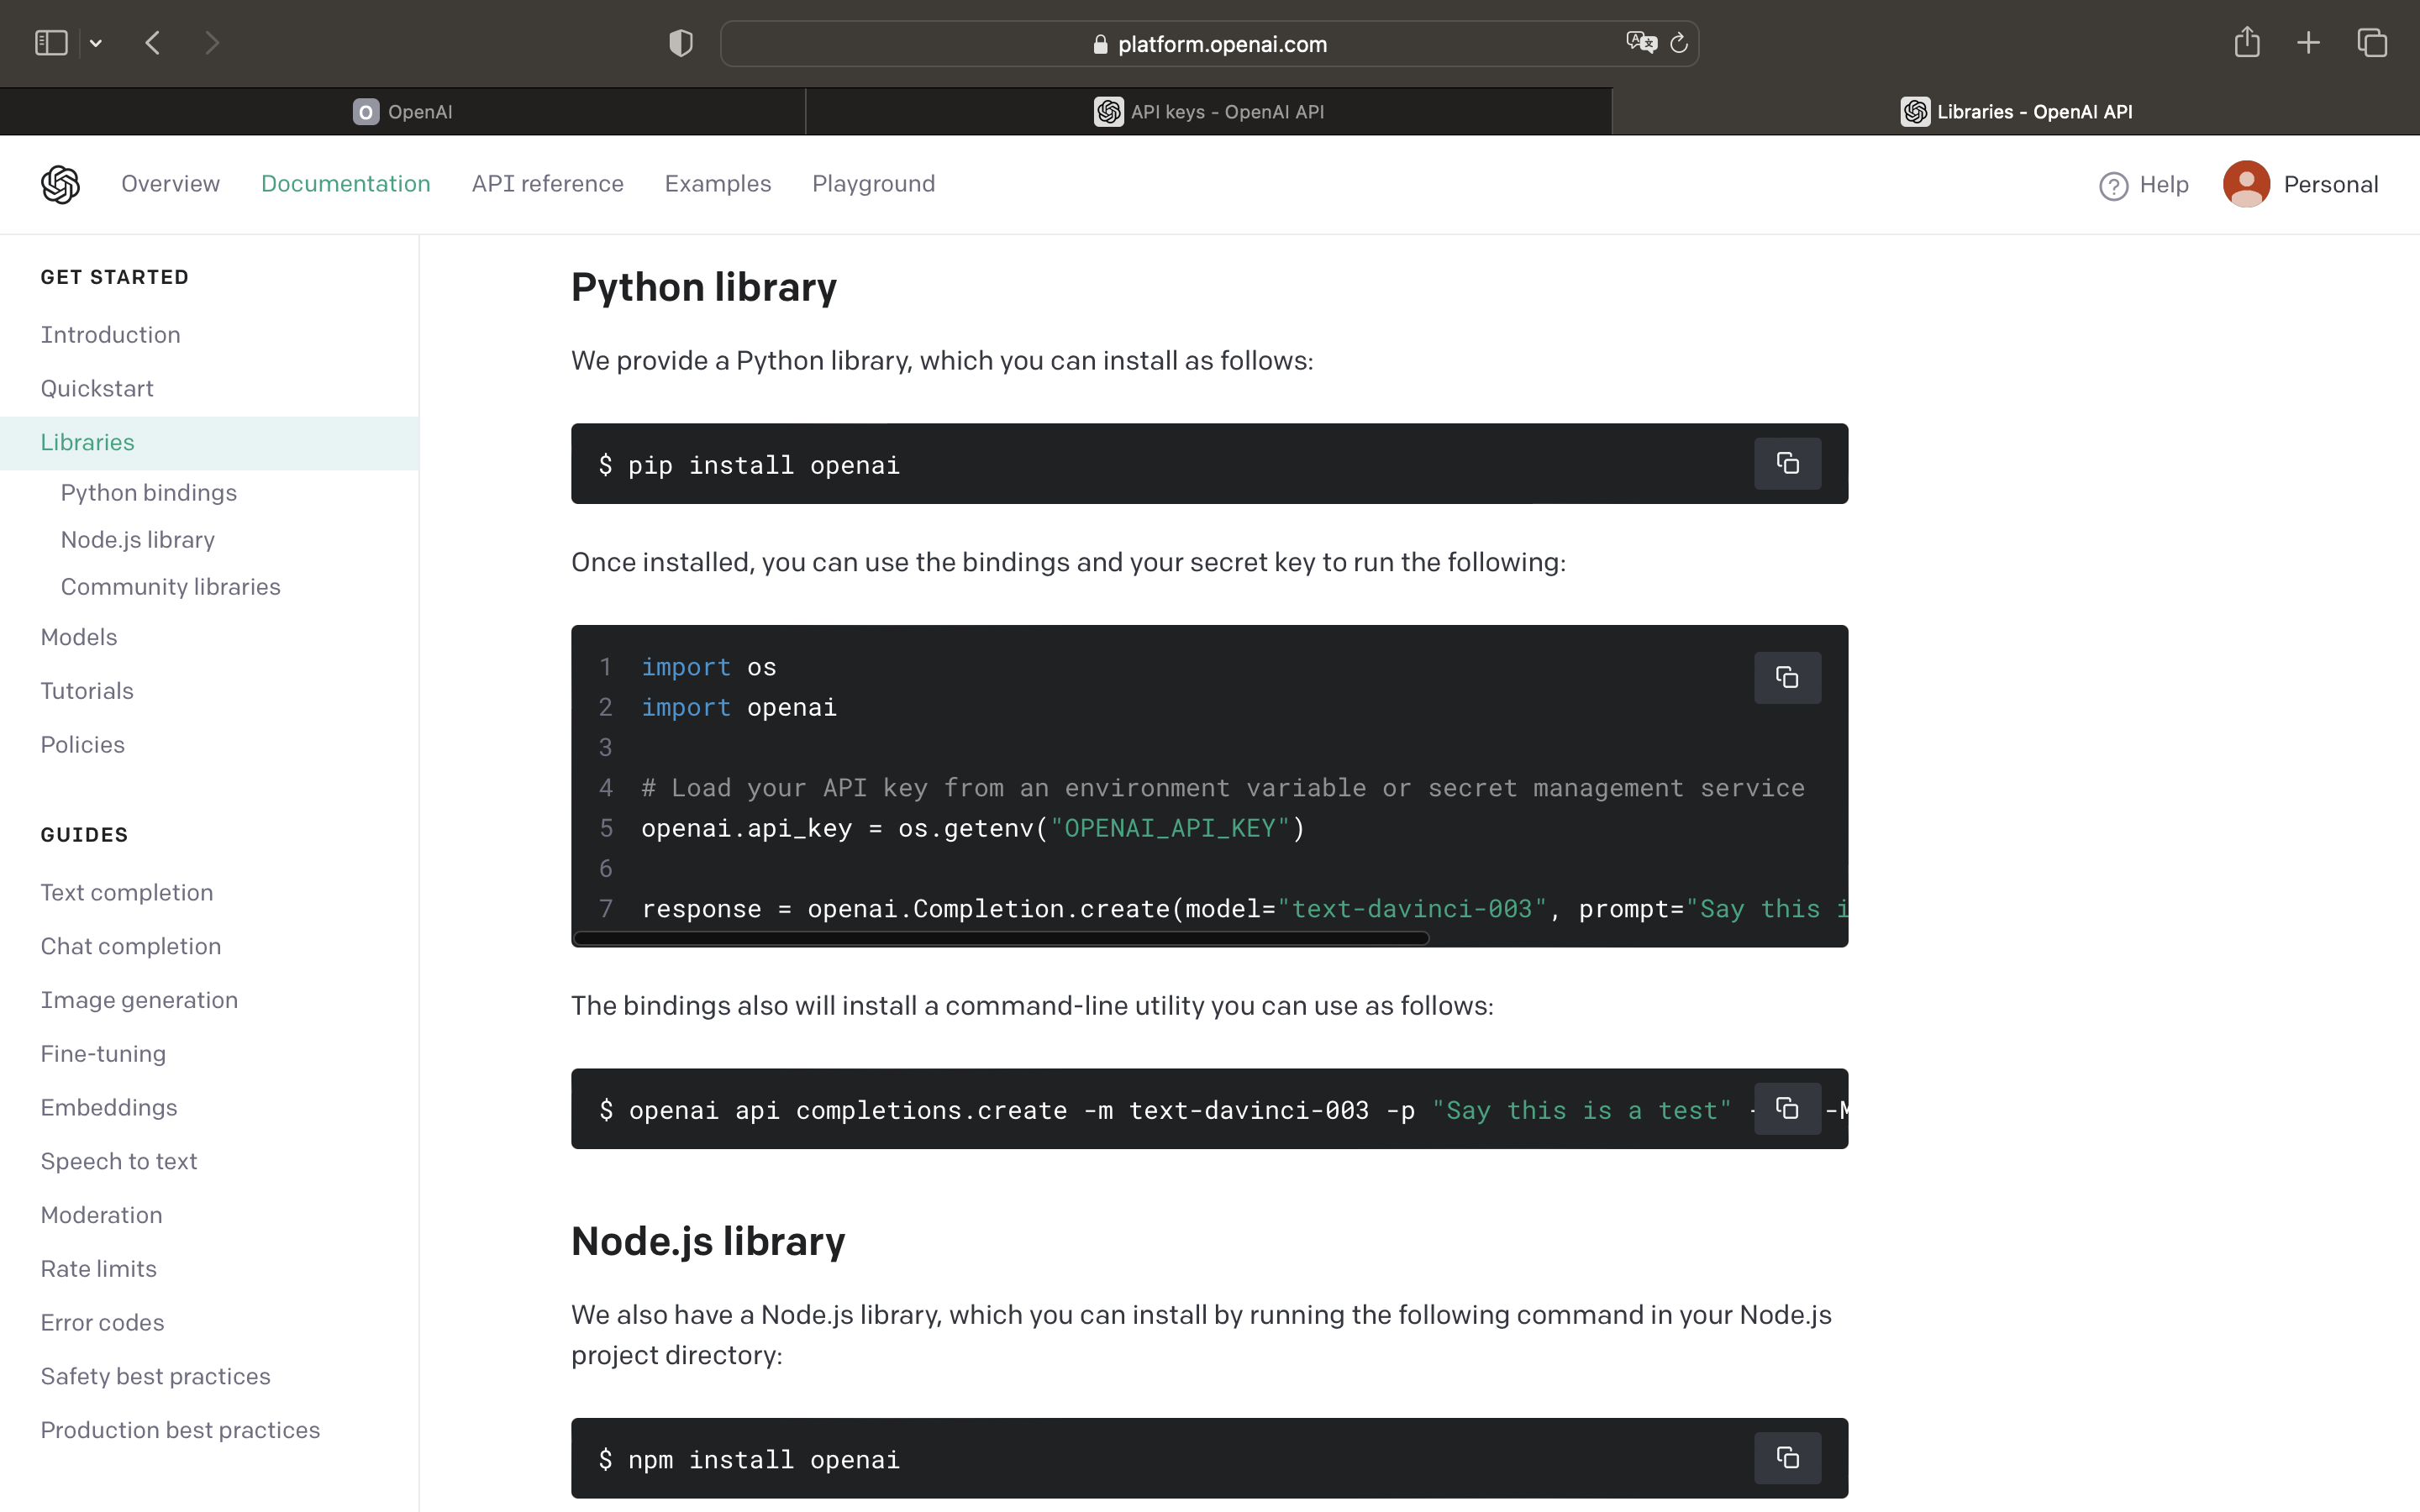
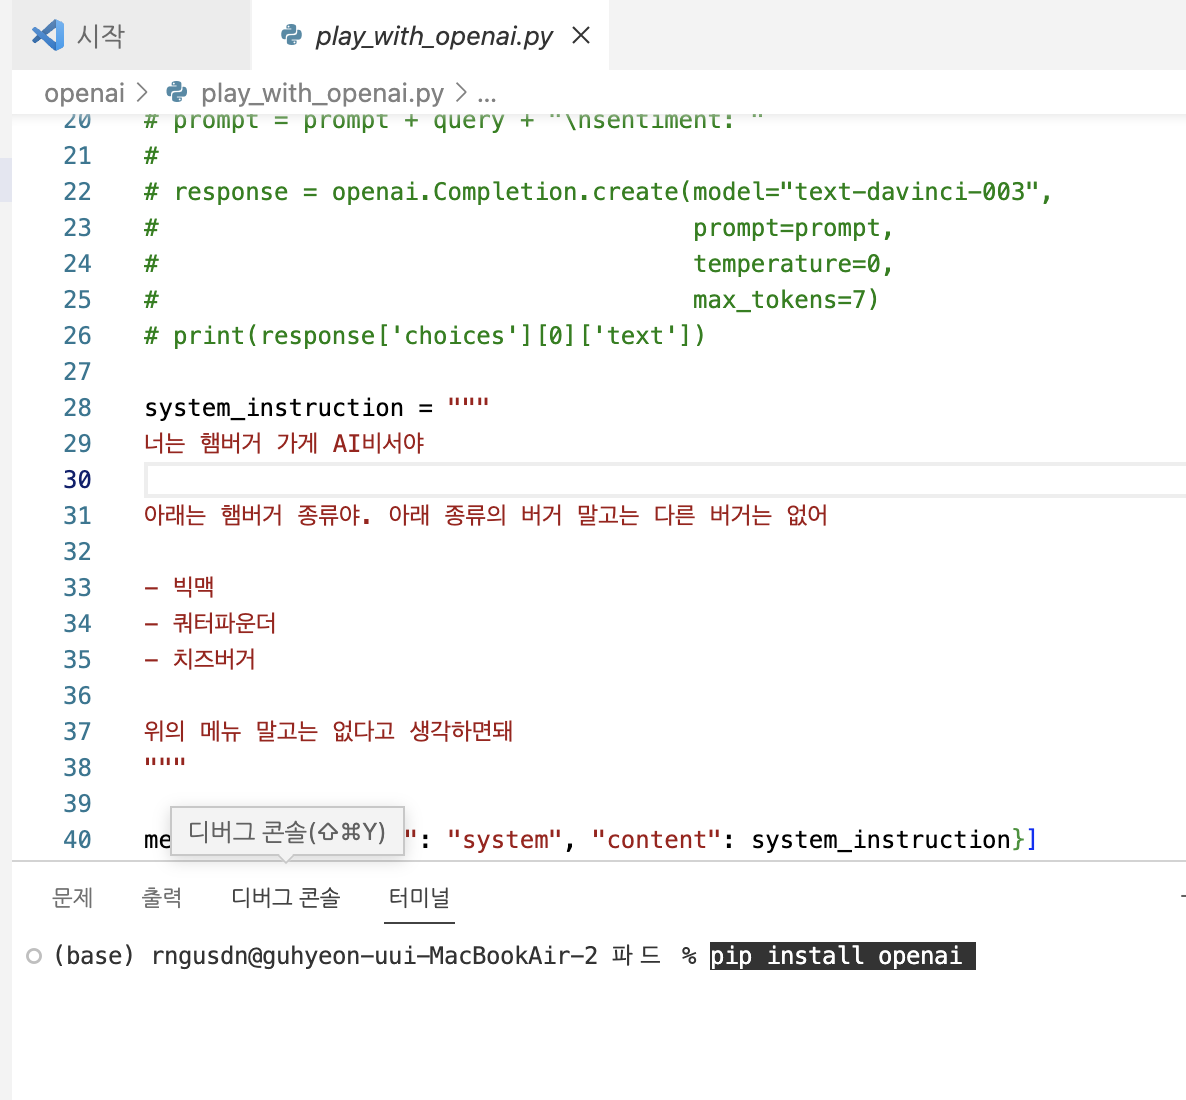
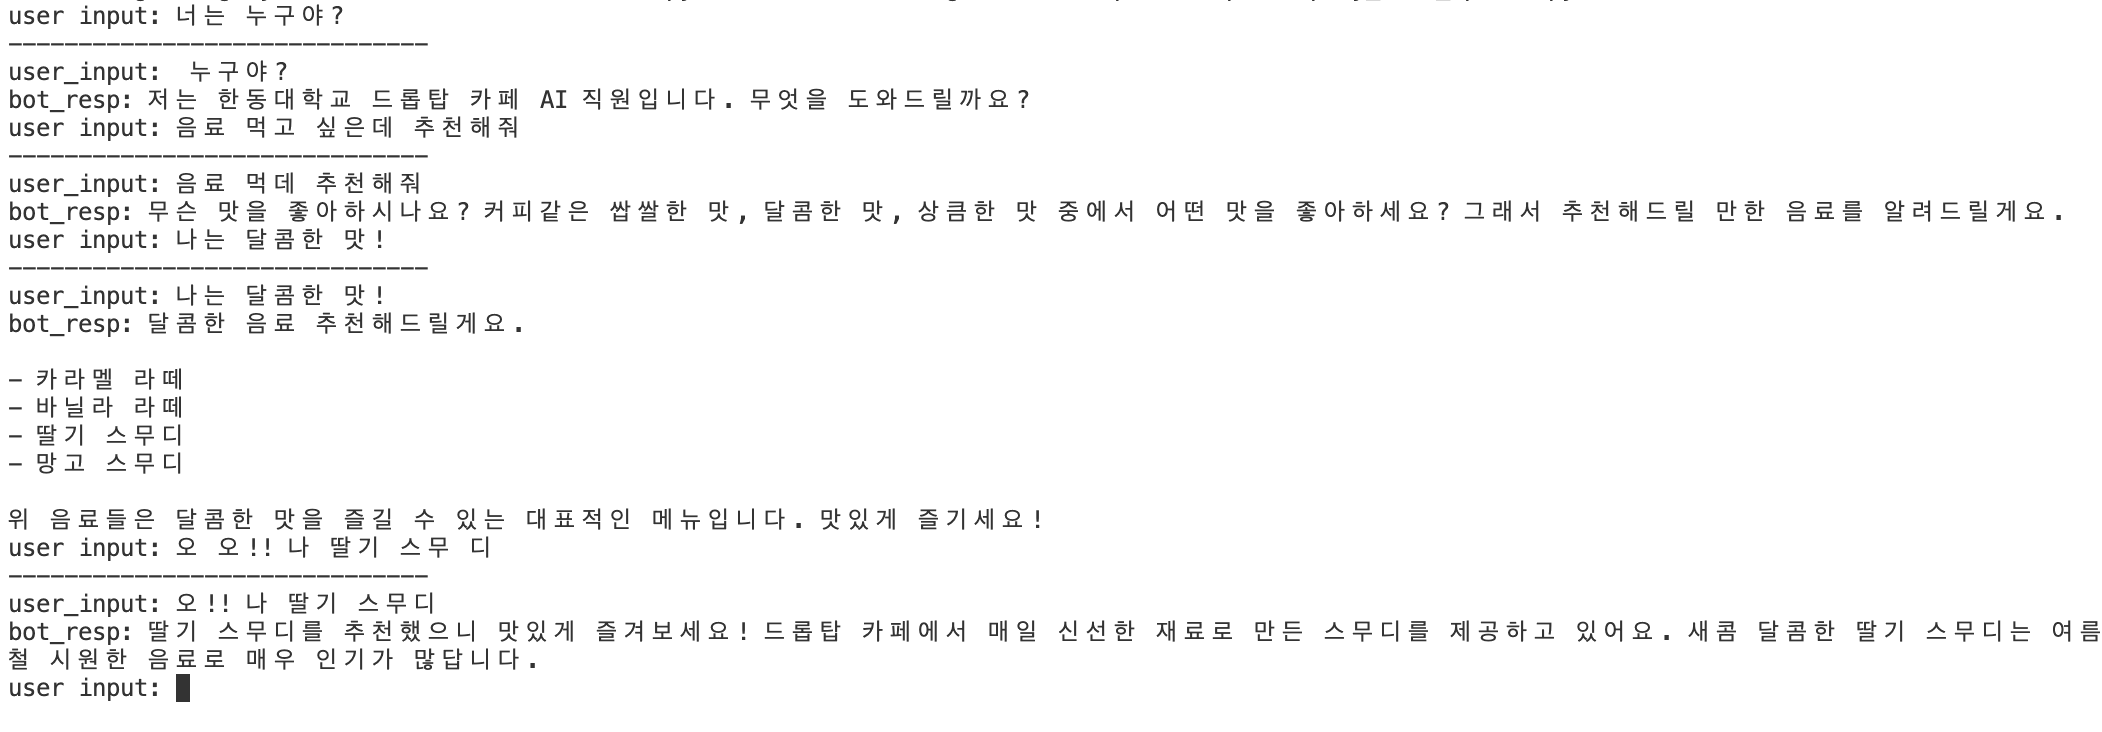
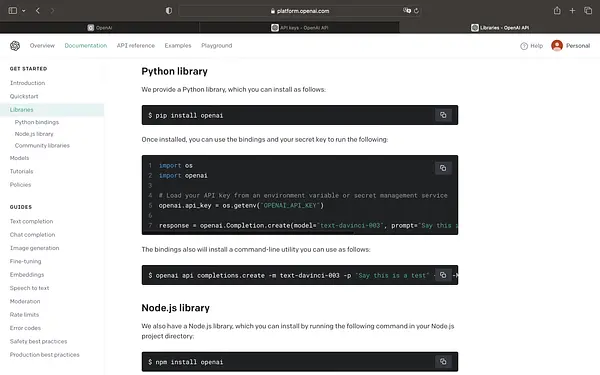
 사진 출처: Publy